Skip to content

9회 · 최대가능도 · 노트

5 가능도로 검정하기 — Wilks, Wald, Rao ​

역사 Neyman과 Pearson(1928)은 두 가설의 가능도의 비로 검정을 만들자고 제안했다. Wilks(1938)는 그 비의 로그에 −2-2를 곱하면 큰 표본에서 χ2\chi^2 분포를 따른다는 것을 보였다. Wald(1943)는 추정값과 귀무가설 값의 거리로, Rao(1948)는 귀무가설에서의 점수로 검정을 만들었다. 세 검정은 큰 표본에서 같은 결론을 내지만, 작은 표본과 계산의 편의에서 다르다.

5.1 세 검정 ​

H0:θ=θ0H_0:\theta=\theta_0를 검정한다. 로그가능도 곡선 하나에서 세 가지 거리를 잴 수 있다(그림 5.1).

정의 5.1 (가능도비 · Wald · 점수 통계량) 

ΛLR=2[ℓ(θ^)−ℓ(θ0)],W=nI(θ^) (θ^−θ0)2,R=ℓ′(θ0)2nI(θ0).\Lambda_{\mathrm{LR}}=2\bigl[\ell(\hat\theta)-\ell(\theta_0)\bigr],\qquad W=nI(\hat\theta)\,(\hat\theta-\theta_0)^2,\qquad R=\frac{\ell'(\theta_0)^2}{nI(\theta_0)} .

가능도비는 두 점의 높이의 차, Wald는 두 점의 가로 거리(를 곡률로 잰 것), 점수는 귀무가설 점에서의 기울기다.
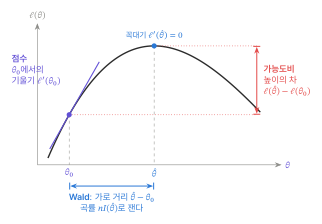
그림 5.1. 세 검정의 기하. 로그가능도 ℓ(θ)에서 가능도비는 꼭대기와 θ_0의 높이 차, Wald는 θ̂와 θ_0의 가로 거리, 점수는 θ_0에서의 접선의 기울기를 잰다. 로그가능도가 이차식이면 셋은 같다.
그림 5.1 세 검정의 기하. 로그가능도 ℓ(θ)\ell(\theta)에서 가능도비는 꼭대기와 θ0\theta_0의 높이 차, Wald는 θ^\hat\theta와 θ0\theta_0의 가로 거리, 점수는 θ0\theta_0에서의 접선의 기울기를 잰다. 로그가능도가 이차식이면 셋은 같다.

정리 5.2 (Wilks의 정리) 정리 3.1의 조건 아래 H0:θ=θ0H_0:\theta=\theta_0가 참이면

ΛLR=2[ℓ(θ^n)−ℓ(θ0)] →D χ2(1),\Lambda_{\mathrm{LR}}=2\bigl[\ell(\hat\theta_n)-\ell(\theta_0)\bigr]\ \xrightarrow{D}\ \chi^2(1),

그리고 WW와 RR도 χ2(1)\chi^2(1)로 분포수렴하며 세 통계량의 차는 →P0\xrightarrow{P}0이다.

증명 전략 이번에는 ℓ\ell을 θ^n\hat\theta_n 둘레에서 Taylor 전개한다 [T8]. ℓ′(θ^n)=0\ell'(\hat\theta_n)=0이므로 1차항이 사라지고, 가능도비는 “곡률 × 거리의 제곱”이 된다. 세 통계량을 모두 I(θ0) n(θ^n−θ0)2I(\theta_0)\,n(\hat\theta_n-\theta_0)^2으로 바꿔 비교한다.

  1. θ^n\hat\theta_n과 θ0\theta_0 사이의 θn∗∗\theta_n^{**}가 있어

    ℓ(θ0)=ℓ(θ^n)+12(θ0−θ^n)2ℓ′′(θn∗∗).\ell(\theta_0)=\ell(\hat\theta_n)+\tfrac12(\theta_0-\hat\theta_n)^2\ell''(\theta_n^{**}) .
    Taylor, ℓ′(θ^n)=0\ell'(\hat\theta_n)=0 [T8]
  2. 따라서

    ΛLR=[−n−1ℓ′′(θn∗∗)]⋅[n(θ^n−θ0)]2.\Lambda_{\mathrm{LR}}=\bigl[-n^{-1}\ell''(\theta_n^{**})\bigr]\cdot\bigl[\sqrt n(\hat\theta_n-\theta_0)\bigr]^2 .
    1
  3. 첫 인수는 →PI(θ0)\xrightarrow{P}I(\theta_0)이다.정리 3.1의 증명 4 5

  4. 둘째 인수는 N(0,1/I(θ0))\N(0,1/I(\theta_0))의 제곱으로, 곧 1I(θ0)χ2(1)\tfrac1{I(\theta_0)}\chi^2(1)로 분포수렴한다.정리 3.1, 7회 연습 2.4

  5. Slutsky 정리로 ΛLR→DI(θ0)⋅1I(θ0)χ2(1)=χ2(1)\Lambda_{\mathrm{LR}}\xrightarrow{D}I(\theta_0)\cdot\tfrac1{I(\theta_0)}\chi^2(1)=\chi^2(1)이다.7회 정리 4.2

  6. W=I(θ^n)⋅n(θ^n−θ0)2W=I(\hat\theta_n)\cdot n(\hat\theta_n-\theta_0)^2이고 I(θ^n)→PI(θ0)I(\hat\theta_n)\xrightarrow{P}I(\theta_0)이므로 같은 극한이다. R=(n−1/2ℓ′(θ0))2/I(θ0)R=\bigl(n^{-1/2}\ell'(\theta_0)\bigr)^2/I(\theta_0)은 정리 3.1의 증명 3으로 χ2(1)\chi^2(1)이다.연속사상, Slutsky

  7. 정리 3.1의 증명 1에서 n−1/2ℓ′(θ0)=n(θ^n−θ0)(I(θ0)+oP(1))n^{-1/2}\ell'(\theta_0)=\sqrt n(\hat\theta_n-\theta_0)\bigl(I(\theta_0)+o_P(1)\bigr)이다. 그러므로 세 통계량은 모두 I(θ0) n(θ^n−θ0)2+oP(1)I(\theta_0)\,n(\hat\theta_n-\theta_0)^2+o_P(1)이고, 서로의 차는 →P0\xrightarrow{P}0이다.OP⋅oP=oPO_P\cdot o_P=o_P [T8]

조건 확인 1은 θ^n\hat\theta_n이 가능도 방정식의 근이어야 쓸 수 있다. θ0\theta_0가 모수공간의 경계에 있으면 θ^n\hat\theta_n이 경계에 붙어 ℓ′(θ^n)≠0\ell'(\hat\theta_n)\ne0일 수 있고, 극한도 χ2(1)\chi^2(1)이 아니다(6.3절의 may, 연습 6.3). 7에서 n(θ^n−θ0)2n(\hat\theta_n-\theta_0)^2이 확률적으로 유계라는 것은 4에서 나온다.

7회 7.4절에서 g′(θ)=0g'(\theta)=0이면 극한이 χ2\chi^2가 된다고 했다. 로그가능도의 꼭대기에서 기울기가 0이기 때문에 가능도비가 정규가 아니라 χ2\chi^2인 것이다.

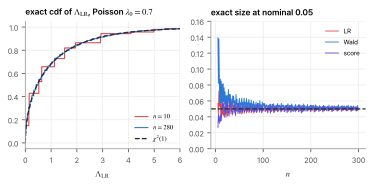
극한은 얼마나 빨리 오는가? Poisson이면 ∑Xi∼Poi(nλ0)\sum X_i\sim\mathrm{Poi}(n\lambda_0)이므로 세 검정의 실제 크기를 시뮬레이션 없이 정확히 계산할 수 있다(그림 5.2). λ0=0.7\lambda_0=0.7, 공칭 크기 0.05일 때 n=10n=10이면 가능도비 0.057, Wald 0.087, 점수 0.034이고, n=280n=280이면 0.050, 0.051, 0.049다. Wald는 분산을 λ^\hat\lambda로 추정하므로, λ^\hat\lambda가 작게 나온 표본에서 통계량이 부풀어 너무 자주 기각한다. 점수 검정은 H0H_0의 분산 λ0\lambda_0을 쓰므로 그런 일이 없다.

그림 5.2. 왼쪽: λ_0=0.7인 Poisson에서 Λ_LR의 정확한 분포함수와 χ²(1)(점선). 오른쪽: 공칭 0.05인 세 검정의 정확한 크기. 이산분포라서 톱니 모양이고, n이 커지면 모두 0.05로 모인다.
그림 5.2 왼쪽: λ0=0.7\lambda_0=0.7인 Poisson에서 ΛLR\Lambda_{\mathrm{LR}}의 정확한 분포함수와 χ2(1)\chi^2(1)(점선). 오른쪽: 공칭 0.05인 세 검정의 정확한 크기. 이산분포라서 톱니 모양이고, nn이 커지면 모두 0.05로 모인다.

증명 없이 쓰는 사실 (여러 모수의 Wilks) θ∈Rp\boldsymbol\theta\in\R^p이고 H0H_0가 rr개의 독립인 제약(예: θ1=⋯=θr=0\theta_1=\cdots=\theta_r=0)이면, 정칙조건 아래 2[ℓ(θ^)−ℓ(θ^0)]→Dχ2(r)2\bigl[\ell(\hat{\boldsymbol\theta})-\ell(\hat{\boldsymbol\theta}_0)\bigr]\xrightarrow{D}\chi^2(r)이다(θ^0\hat{\boldsymbol\theta}_0는 H0H_0 아래의 MLE). 자유도는 “자유로운 모수의 수의 차이”다. 8회의 Fisher의 자유도와 같은 셈이다. 다항분포에서 H0H_0의 점수 통계량은 정확히 Pearson의 X2X^2이고, 가능도비는 G=2∑Olog⁡OEG=2\sum O\log\tfrac OE다(연습 5.2).

5.2 구간으로 뒤집기 ​

8회 정리 3.5의 쌍대성으로 세 검정은 세 구간을 준다. Wald 구간은 θ^±z/nI(θ^)\hat\theta\pm z/\sqrt{nI(\hat\theta)}(따름정리 3.2), 가능도비 구간은 {θ:2[ℓ(θ^)−ℓ(θ)]≤χ1,α2}\{\theta:2[\ell(\hat\theta)-\ell(\theta)]\le\chi^2_{1,\alpha}\}, 점수 구간은 {θ:R(θ)≤χ1,α2}\{\theta:R(\theta)\le\chi^2_{1,\alpha}\}이다. 비율의 점수 구간이 8회의 Wilson 구간이다. Wald 구간만 언제나 θ^\hat\theta에 대해 대칭이고, 가능도비 구간은 모수를 바꿔도(예: λ\lambda와 log⁡λ\log\lambda) 같은 구간을 준다는 장점이 있다(연습 5.3).

예제 5.3 (기병대의 세 검정) 14개 군단 280군단–해에서 λ^=0.70\hat\lambda=0.70이다. Fisher가 쓴 10개 군단의 값 λ0=0.61\lambda_0=0.61을 검정하면(정보 nI(λ)=n/λnI(\lambda)=n/\lambda)

통계량pp95% 구간
Wald1.802=3.241.80^2=3.240.072[0.602, 0.798][0.602,\ 0.798]
가능도비3.553.550.060[0.607, 0.803][0.607,\ 0.803]
점수1.932=3.721.93^2=3.720.054[0.609, 0.805][0.609,\ 0.805]

n=280n=280에서도 세 pp-값이 0.05 근처에서 갈린다. 경계에 가까운 결론은 검정의 선택에 민감하다. Poisson의 로그가능도는 오른쪽으로 꼬리가 길어서 Wald 구간(대칭)이 두 구간보다 왼쪽에 있다.

연습문제

연습 5.1 (Poisson의 세 통계량 ★) Poisson에서 ΛLR=2n[xˉlog⁡xˉλ0−(xˉ−λ0)]\Lambda_{\mathrm{LR}}=2n\bigl[\bar x\log\tfrac{\bar x}{\lambda_0}-(\bar x-\lambda_0)\bigr], W=n(xˉ−λ0)2xˉW=\tfrac{n(\bar x-\lambda_0)^2}{\bar x}, R=n(xˉ−λ0)2λ0R=\tfrac{n(\bar x-\lambda_0)^2}{\lambda_0}임을 보이고 예제 5.3의 수치를 확인하라.

풀이

ℓ(λ)=nxˉlog⁡λ−nλ\ell(\lambda)=n\bar x\log\lambda-n\lambda이므로 Λ=2n[xˉlog⁡xˉλ0−(xˉ−λ0)]\Lambda=2n[\bar x\log\tfrac{\bar x}{\lambda_0}-(\bar x-\lambda_0)]. I=1/λI=1/\lambda이므로 W=nxˉ(xˉ−λ0)2W=\tfrac n{\bar x}(\bar x-\lambda_0)^2, ℓ′(λ0)=n(xˉλ0−1)\ell'(\lambda_0)=n(\tfrac{\bar x}{\lambda_0}-1)이므로 R=n2(xˉ−λ0)2/λ02n/λ0=n(xˉ−λ0)2λ0R=\tfrac{n^2(\bar x-\lambda_0)^2/\lambda_0^2}{n/\lambda_0}=\tfrac{n(\bar x-\lambda_0)^2}{\lambda_0}. n=280n=280, xˉ=0.7\bar x=0.7, λ0=0.61\lambda_0=0.61이면 Λ=3.55\Lambda=3.55, W=3.24W=3.24, R=3.72R=3.72.

연습 5.2 (GG 통계량 ★★) 다항분포에서 H0:p=p0H_0:\mathbf p=\mathbf p^0의 가능도비가 G=2∑jNjlog⁡Njnpj0G=2\sum_jN_j\log\tfrac{N_j}{np^0_j}임을 보이고, log⁡(1+u)≈u−u22\log(1+u)\approx u-\tfrac{u^2}2로 G≈X2G\approx X^2임을 보여라. 점수 통계량이 정확히 X2X^2임도 보여라.

풀이

H1H_1의 MLE는 p^j=Nj/n\hat p_j=N_j/n이므로 Λ=2∑Njlog⁡Nj/npj0=G\Lambda=2\sum N_j\log\tfrac{N_j/n}{p^0_j}=G. Nj=Ej(1+uj)N_j=E_j(1+u_j)로 쓰면 ∑Ejuj=0\sum E_ju_j=0이고 G=2∑Ej(1+uj)log⁡(1+uj)≈2∑Ej(1+uj)(uj−uj22)≈∑Ejuj2=X2G=2\sum E_j(1+u_j)\log(1+u_j)\approx2\sum E_j(1+u_j)(u_j-\tfrac{u_j^2}2)\approx\sum E_ju_j^2=X^2. 점수 검정은 ℓ′(p0)\ell'(\mathbf p^0)와 정보 행렬로 만든 이차형식이고, 제약 ∑pj=1\sum p_j=1을 반영해 계산하면 ∑(Nj−npj0)2npj0\sum\tfrac{(N_j-np^0_j)^2}{np^0_j}, 곧 Pearson의 X2X^2가 정확히 나온다.

연습 5.3 (가능도비 구간의 불변성 ★★) η=g(θ)\eta=g(\theta) (gg 단조)로 모수를 바꾸면 가능도비 구간은 정확히 gg로 옮겨지지만 Wald 구간은 그렇지 않음을 보여라. 기병대 자료에서 log⁡λ\log\lambda의 Wald 구간을 지수로 되돌려 λ\lambda의 Wald 구간과 비교하라.

풀이

가능도비 구간 {θ:ℓ(θ)≥ℓ(θ^)−12χ1,α2}\{\theta:\ell(\theta)\ge\ell(\hat\theta)-\tfrac12\chi^2_{1,\alpha}\}은 가능도의 높이로만 정해지므로 η=g(θ)\eta=g(\theta)로 바꿔도 같은 점들의 집합, 곧 gg로 옮긴 구간이다. Wald 구간은 η^±z/nI∗\hat\eta\pm z/\sqrt{nI^*}로 새 척도에서 대칭이므로 되돌리면 비대칭이 된다. 기병대: log⁡λ\log\lambda의 Wald 구간 log⁡0.7±1.96/280⋅0.7\log0.7\pm1.96/\sqrt{280\cdot0.7}을 되돌리면 [0.609, 0.805][0.609,\ 0.805]로, λ\lambda의 Wald [0.602, 0.798][0.602,\ 0.798]보다 가능도비 [0.607, 0.803][0.607,\ 0.803]에 가깝다.

연습 5.4 (Wilks의 시뮬레이션 ★) Poi(2)\mathrm{Poi}(2), n=50n=50에서 ΛLR\Lambda_{\mathrm{LR}}을 10만 번 시뮬레이션해 평균이 1에 가깝고 P(Λ>3.84)≈0.05P(\Lambda>3.84)\approx0.05임을 노트북으로 확인하라.

풀이

10만 번의 시뮬레이션에서 평균은 1.00, P(Λ>3.84)P(\Lambda>3.84)는 0.05를 조금 넘는다. ∑Xi∼Poi(100)\sum X_i\sim\mathrm{Poi}(100)이므로 시뮬레이션 없이 정확히 계산할 수도 있다(5.1절). 평균 1.002, 크기 0.0517이다.

이 회차에서 읽은 절 0개 · 회차 차례