Skip to content

9회 · 최대가능도 · 노트

7 부숴보기 — 초효율과 너무 많은 모수 ​

7.1 Hodges의 초효율 추정량 (1951) ​

Cramér–Rao 한계는 불편추정량의 것이고, MLE의 점근 효율은 “어떤 추정량도 점근분산이 1/I1/I보다 작을 수 없다”처럼 들린다. Joseph Hodges는 1951년 그렇지 않다는 예를 만들었다(Le Cam 1953이 발표했다).

예제 7.1 (한 점에서만 이기는 추정량) Xi∼iidN(θ,1)X_i\iid\N(\theta,1)이고

Tn={Xˉn,∣Xˉn∣≥n−1/4,0,∣Xˉn∣<n−1/4T_n=\begin{cases}\bar X_n,&|\bar X_n|\ge n^{-1/4},\\0,&|\bar X_n|<n^{-1/4}\end{cases}

라 하자. θ≠0\theta\ne0이면 ∣Xˉn∣→∣θ∣>0|\bar X_n|\to|\theta|>0이므로 결국 Tn=XˉnT_n=\bar X_n이고 n(Tn−θ)→DN(0,1)\sqrt n(T_n-\theta)\xrightarrow{D}\N(0,\allowbreak 1), 곧 MLE와 같다. 그런데 θ=0\theta=0이면 P(∣Xˉn∣<n−1/4)=P(∣Z∣<n1/4)→1P(|\bar X_n|<n^{-1/4})=P(|Z|<n^{1/4})\to1이므로 Tn=0T_n=0이 되어 n Tn→P0\sqrt n\,T_n\xrightarrow{P}0, 점근분산이 0이다. 한계 1/I=11/I=1보다 작다.

대가는 어디에 있는가? θ\theta가 0에 가깝지만 0이 아니면, 예를 들어 θ=n−1/4\theta=n^{-1/4} 근처이면 TnT_n은 자주 0으로 잘못 끌려가 큰 오차를 낸다. 평균제곱오차를 nn배 한 위험 nEθ(Tn−θ)2nE_\theta(T_n-\theta)^2의 최댓값은 n=100n=100에서 5.6, n=10,000n=10{,}000에서 69로, nn과 함께 끝없이 커진다(그림 7.1). 한 점에서 이긴 만큼 그 근처에서 크게 진다. Le Cam(1953)은 이런 초효율이 일어나는 점의 집합이 측도 0임을 보였고, Hájek(1970)의 수렴 정리와 국소 점근 최소최대 정리는 “근처의 모든 θ\theta를 함께 볼 때” MLE가 최선임을 정확히 말한다. 수축 추정(16회)은 이 생각을 다른 방향에서 다시 만난다.
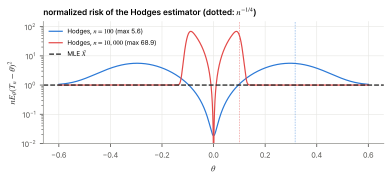
그림 7.1. Hodges 추정량의 정규화한 위험 nE_θ(T_n-θ)² (n=100, 10,000). 점선은 MLE의 위험 1. 0에서는 MLE를 이기지만 |θ|≈n^-1/4 근처에서 크게 지고, 그 봉우리는 n이 클수록 높아진다.
그림 7.1 Hodges 추정량의 정규화한 위험 nEθ(Tn−θ)2nE_\theta(T_n-\theta)^2 (n=100n=100, 10,00010{,}000). 점선은 MLE의 위험 1. 0에서는 MLE를 이기지만 ∣θ∣≈n−1/4|\theta|\approx n^{-1/4} 근처에서 크게 지고, 그 봉우리는 nn이 클수록 높아진다.

7.2 받침이 모수에 의존하면 ​

U(0,θ)\mathrm U(0,\theta)의 MLE X(n)X_{(n)}은 (R1)을 깬다. 그 결과는 나쁘지 않고 오히려 좋다. n(θ−X(n))→DExpn(\theta-X_{(n)})\xrightarrow{D}\mathrm{Exp} (평균 θ\theta)로(7회 예제 2.2(b)), 오차가 1/n1/\sqrt n이 아니라 1/n1/n의 속도로 준다. 정규 극한도, Cramér–Rao 한계도, Wilks의 χ2\chi^2도 이런 “비정칙” 모형에는 맞지 않는다. 8회의 독일 전차 문제와 15회의 부트스트랩의 실패가 같은 구조다.

7.3 모수가 자료와 함께 늘어나면 — Neyman–Scott (1948) ​

예제 7.2 (일치하지 않는 MLE) nn명에게서 두 번씩 측정한다: Xi1,Xi2∼iidN(μi,σ2)X_{i1},\allowbreak X_{i2}\iid\N(\mu_i,\allowbreak \sigma^2), i=1,…,ni=1,\dots,n. 사람마다 평균 μi\mu_i가 다르고 측정 오차 σ2\sigma^2는 같다. 모수는 n+1n+1개이고, MLE는 μ^i=Xˉi\hat\mu_i=\bar X_i,

σ^2=12n∑i∑j=12(Xij−Xˉi)2=14n∑i(Xi1−Xi2)2 →P σ22.\hat\sigma^2=\frac1{2n}\sum_i\sum_{j=1}^2(X_{ij}-\bar X_i)^2=\frac1{4n}\sum_i(X_{i1}-X_{i2})^2\ \xrightarrow{P}\ \frac{\sigma^2}2 .

n→∞n\to\infty에서 MLE가 참값의 절반으로 간다. 각 μi\mu_i가 자료 두 개로만 추정되어 정보가 쌓이지 않기 때문이다. 정리 3.1은 모수의 수가 고정되어 있다고 가정했다. 10회는 각 μi\mu_i를 보이지 않는 확률변수로 바꿔 EM으로 이 문제(“귀찮은 모수”가 많은 경우)를 풀고, 16회의 계층모형이 같은 생각을 Bayes의 언어로 다시 쓴다.

연습문제

연습 7.1 (Hodges의 위험 ★★) θ=0\theta=0에서 nE0Tn2=E[Z2;∣Z∣≥n1/4]nE_0T_n^2=E\bigl[Z^2;|Z|\ge n^{1/4}\bigr] (Z∼N(0,1)Z\sim\N(0,1))임을 보이고 이것이 0으로 감을 보여라. θn=c n−1/4\theta_n=c\,n^{-1/4} (0<c<10<c<1)이면 nE(Tn−θn)2→∞nE(T_n-\theta_n)^2\to\infty임을 보여라.

풀이

θ=0\theta=0이면 nXˉ=Z\sqrt n\bar X=Z이고 Tn=Xˉ1{∣Z∣≥n1/4}T_n=\bar X1\{|Z|\ge n^{1/4}\}이므로 nETn2=E[Z2;∣Z∣≥n1/4]→0nET_n^2=E[Z^2;|Z|\ge n^{1/4}]\to0. θn=cn−1/4\theta_n=cn^{-1/4}이면 nXˉ=nθn+Z=cn1/4+Z\sqrt n\bar X=\sqrt n\theta_n+Z=cn^{1/4}+Z이고 ∣Xˉ∣<n−1/4  ⟺  ∣c+Zn−1/4∣<1|\bar X|<n^{-1/4}\iff|c+Zn^{-1/4}|<1의 확률이 1로 가므로 대부분 Tn=0T_n=0이고 nE(Tn−θn)2≈nθn2=c2n→∞nE(T_n-\theta_n)^2\approx n\theta_n^2=c^2\sqrt n\to\infty.

연습 7.2 (균등분포의 MLE의 속도 ★) P(n(θ−X(n))>x)=(1−xnθ)n→e−x/θP\bigl(n(\theta-X_{(n)})>x\bigr)=(1-\tfrac x{n\theta})^n\to e^{-x/\theta}를 확인하고, MLE를 n+1nX(n)\tfrac{n+1}nX_{(n)}으로 고치면 치우침이 사라짐을 보여라.

풀이

P(n(θ−X(n))>x)=P(X(n)<θ−xn)=(1−xnθ)n→e−x/θP(n(\theta-X_{(n)})>x)=P(X_{(n)}<\theta-\tfrac xn)=(1-\tfrac x{n\theta})^n\to e^{-x/\theta}. EX(n)=nθn+1EX_{(n)}=\tfrac{n\theta}{n+1}이므로 n+1nX(n)\tfrac{n+1}nX_{(n)}은 불편이다.

연습 7.3 (Neyman–Scott의 고침 ★★) 예제 7.2에서 Di=Xi1−Xi2∼N(0,2σ2)D_i=X_{i1}-X_{i2}\sim\N(0,\allowbreak 2\sigma^2)만 쓰면 μi\mu_i가 사라진다. DiD_i들의 가능도로 만든 MLE 12n∑Di2\tfrac1{2n}\sum D_i^2가 일치함을 보여라. (조건부 또는 주변 가능도의 생각이다.)

풀이

Di∼iidN(0,2σ2)D_i\iid\N(0,2\sigma^2)의 가능도는 μi\mu_i를 포함하지 않는다. 2σ22\sigma^2의 MLE는 1n∑Di2\tfrac1n\sum D_i^2이므로 σ^2=12n∑Di2→PED22=σ2\hat\sigma^2=\tfrac1{2n}\sum D_i^2\xrightarrow{P}\tfrac{E D^2}2=\sigma^2. 예제의 MLE의 두 배다. 귀찮은 모수를 없앤 가능도로 추정하면 일치한다.

이 회차에서 읽은 절 0개 · 회차 차례