Skip to content

9회 · 최대가능도 · 노트

3 최대가능도 추정량의 점근정규성 ​

역사 Edgeworth(1908)는 가능도를 최대로 하는 추정량이 큰 표본에서 가장 작은 분산을 가진다는 것을 거의 증명했지만, 그의 글은 읽히지 않았다. Fisher(1922)는 통계학의 수학적 기초에서 일치성, 효율, 충분성이라는 말을 만들고 최대가능도 추정량이 “효율적”이라고 주장했다. 엄밀한 증명은 Cramér(1946)의 교과서가 정리했다. 그 증명의 뼈대가 아래의 정리다.

정리 3.1 (MLE의 점근정규성) 정칙조건 아래 0<I(θ0)<∞0<I(\theta_0)<\infty이고 θ^n\hat\theta_n이 가능도 방정식의 일치하는 근(정리 1.6)이면

n (θ^n−θ0) →D N(0, 1I(θ0)).\sqrt n\,(\hat\theta_n-\theta_0)\ \xrightarrow{D}\ \N\Bigl(0,\ \frac1{I(\theta_0)}\Bigr).

증명 전략 가능도 방정식 ℓ′(θ^n)=0\ell'(\hat\theta_n)=0을 θ0\theta_0 둘레에서 Taylor 전개해 n(θ^n−θ0)\sqrt n(\hat\theta_n-\theta_0)를 분자와 분모의 비로 쓴다 [T8]. 분자는 중심극한정리로, 분모는 대수의 법칙으로 다루고 Slutsky 정리로 합친다.

  1. θ^n\hat\theta_n과 θ0\theta_0 사이의 θn∗\theta_n^*가 있어

    0=ℓ′(θ^n)=ℓ′(θ0)+(θ^n−θ0)ℓ′′(θ0)+12(θ^n−θ0)2ℓ′′′(θn∗).0=\ell'(\hat\theta_n)=\ell'(\theta_0)+(\hat\theta_n-\theta_0)\ell''(\theta_0)+\tfrac12(\hat\theta_n-\theta_0)^2\ell'''(\theta_n^*) .
    Taylor, (R3) [T8]
  2. 정리하면

    n(θ^n−θ0)=n−1/2 ℓ′(θ0)−n−1ℓ′′(θ0)−12(θ^n−θ0) n−1ℓ′′′(θn∗).\sqrt n(\hat\theta_n-\theta_0)=\frac{n^{-1/2}\,\ell'(\theta_0)}{-n^{-1}\ell''(\theta_0)-\tfrac12(\hat\theta_n-\theta_0)\,n^{-1}\ell'''(\theta_n^*)} .
    1
  3. 분자: ℓ′(θ0)=∑is(Xi;θ0)\ell'(\theta_0)=\sum_is(X_i;\theta_0)는 평균 0, 분산 I(θ0)I(\theta_0)인 iid의 합이므로 n−1/2ℓ′(θ0)→DN(0,I(θ0))n^{-1/2}\ell'(\theta_0)\xrightarrow{D}\N(0,\allowbreak I(\theta_0))이다.정리 2.2, 중심극한정리(7회 정리 3.1)

  4. 분모의 첫 항: −n−1ℓ′′(θ0)-n^{-1}\ell''(\theta_0)는 평균이 I(θ0)I(\theta_0)인 iid의 평균이므로 →PI(θ0)\xrightarrow{P}I(\theta_0)이다.정리 2.2, Khinchin(7회 정리 1.6)

  5. 분모의 둘째 항: θn∗\theta_n^*가 (R5)의 근방 안에 있는 사건 위에서 ∣n−1ℓ′′′(θn∗)∣≤n−1∑iM(Xi)→PEM<∞|n^{-1}\ell'''(\theta_n^*)|\le n^{-1}\sum_iM(X_i)\xrightarrow{P}EM<\infty이다. 여기에 θ^n−θ0→P0\hat\theta_n-\theta_0\xrightarrow{P}0을 곱하므로 둘째 항은 →P0\xrightarrow{P}0이다.(R5), 정리 1.6, 7회 정리 2.5 [T8]

  6. 분모는 →PI(θ0)>0\xrightarrow{P}I(\theta_0)>0이고, 극한은 1I(θ0)N(0,I(θ0))=N(0,1/I(θ0))\tfrac1{I(\theta_0)}\N(0,\allowbreak I(\theta_0))=\N(0,\allowbreak 1/I(\theta_0))이다.Slutsky, 7회 정리 4.2

조건 확인 1의 전개는 ℓ\ell이 세 번 미분가능해야 하고(R3), 5는 θn∗\theta_n^*가 (R5)의 근방에 있어야 쓸 수 있다. ∣θn∗−θ0∣≤∣θ^n−θ0∣|\theta_n^*-\theta_0|\le|\hat\theta_n-\theta_0|이므로 일치성(정리 1.6)이 그 사건의 확률이 1로 감을 준다. 2에서 분모가 0인 사건의 확률은 4 5로 0으로 가므로 극한에 영향이 없다. 3은 0<I(θ0)<∞0<I(\theta_0)<\infty를 쓴다.

정리는 MLE의 분산이 근사적으로 1nI(θ0)\tfrac1{nI(\theta_0)}, 곧 Cramér–Rao 한계라고 말한다. 큰 표본에서 MLE보다 정확한 (불편에 가까운) 추정량은 없다. 이것을 점근 효율이라 한다. 그 대가로 정칙조건이 필요하고, 7절에서 그것이 깨지는 경우를 본다.

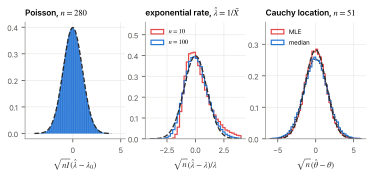
정규 근사가 얼마나 빨리 맞는지는 모형에 따라 다르다(그림 3.1). 기병대와 같은 n=280n=280, λ0=0.7\lambda_0=0.7의 Poisson에서는 거의 정규다. 지수분포의 비율 λ^=1/Xˉ\hat\lambda=1/\bar X는 n=10n=10에서 오른쪽으로 크게 치우쳐 있다. 1/x1/x가 볼록해서 Eλ^=nn−1λE\hat\lambda=\tfrac n{n-1}\lambda로 위로 치우치기 때문이다(연습 1.1).

그림 3.1. MLE의 표본분포와 정리 3.1의 정규 극한(점선). 왼쪽: Poisson, n=280 (정확한 분포; 막대 높이는 밀도로 맞췄다). 가운데: 지수분포의 비율, n=10과 100. 오른쪽: Cauchy 위치, n=51의 MLE와 표본중앙값, 그리고 극한 N(0,2)(점선)와 N(0,π²/4)(점).
그림 3.1 MLE의 표본분포와 정리 3.1의 정규 극한(점선). 왼쪽: Poisson, n=280n=280 (정확한 분포; 막대 높이는 밀도로 맞췄다). 가운데: 지수분포의 비율, n=10n=10과 100100. 오른쪽: Cauchy 위치, n=51n=51의 MLE와 표본중앙값, 그리고 극한 N(0,2)\N(0,2)(점선)와 N(0,π2/4)\N(0,\pi^2/4)(점).

따름정리 3.2 (대표본 구간과 함수) 

  1. (a)

    II가 연속이면 θ^n±zα/2/nI(θ^n)\hat\theta_n\pm z_{\alpha/2}\big/\sqrt{nI(\hat\theta_n)}은 근사 100(1−α)%100(1-\alpha)\% 구간이다. nI(θ^n)nI(\hat\theta_n) 대신 관측 정보 −ℓ′′(θ^n)-\ell''(\hat\theta_n)를 써도 된다.

  2. (b)

    gg가 미분가능하고 g′(θ0)≠0g'(\theta_0)\ne0이면 n(g(θ^n)−g(θ0))→DN(0, g′(θ0)2/I(θ0))\sqrt n\bigl(g(\hat\theta_n)-g(\theta_0)\bigr)\xrightarrow{D}\N\bigl(0,\allowbreak \ g'(\theta_0)^2/I(\theta_0)\bigr).

증명 전략 (a)는 I(θ^n)→PI(θ0)I(\hat\theta_n)\xrightarrow{P}I(\theta_0)를 Slutsky 정리로 정리 3.1에 붙이고 8회 정리 2.4를 쓴다. 관측 정보는 정리 3.1의 증명 4 5를 θ^n\hat\theta_n에서 되풀이한다. (b)는 델타 방법이다 [T8]. 단계별 증명은 연습 3.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

예제 3.3 (Cauchy 위치의 MLE와 중앙값) 표준 Cauchy 위치모형에서 I=12I=\tfrac12이므로 MLE의 점근분산은 2n\tfrac2n이다. 표본중앙값은 π24n=2.47n\tfrac{\pi^2}{4n}=\tfrac{2.47}n(8회 예제 1.5)이므로 중앙값의 효율은 22.47=0.81\tfrac{2}{2.47}=0.81이다. n=51n=51에서 nVar⁡n\Var는 MLE 2.11(시뮬레이션), 중앙값 2.62(순서통계량의 밀도로 정확히 계산)로 극한값 2와 2.47보다 조금 크지만, 비는 0.81 그대로다(그림 3.1). Cauchy에서 평균은 아예 쓸 수 없지만(7회) MLE는 중앙값보다도 낫다. 가능도는 “먼 관측의 무게를 줄이는” 방법을 모형에서 스스로 찾는다. 점수 2u1+u2\tfrac{2u}{1+u^2}가 ∣u∣|u|가 크면 0으로 가기 때문이다. Bernoulli(1778)가 원했던 것이 이것이었다.

증명 없이 쓰는 사실 (여러 모수) θ∈Rp\boldsymbol\theta\in\R^p이면 Fisher 정보는 행렬 I(θ)jk=E[sjsk]=−E[∂2log⁡f∂θj∂θk]I(\boldsymbol\theta)_{jk}=E[s_js_k]=-E\bigl[\tfrac{\partial^2\log f}{\partial\theta_j\partial\theta_k}\bigr]이고, 같은 정칙조건 아래 n(θ^n−θ0)→DNp(0,I(θ0)−1)\sqrt n(\hat{\boldsymbol\theta}_n-\boldsymbol\theta_0)\xrightarrow{D}\N_p\bigl(\mathbf 0,\allowbreak I(\boldsymbol\theta_0)^{-1}\bigr)이다. 증명은 위와 같고 테일러 전개를 벡터로 한다. 정규 (μ,σ2)(\mu,\sigma^2)이면 I=diag(1σ2,12σ4)I=\mathrm{diag}\bigl(\tfrac1{\sigma^2},\allowbreak \tfrac1{2\sigma^4}\bigr)이고, 감마(α,β)(\alpha,\beta)이면 I=(ψ′(α)1/β1/βα/β2)I=\smat{\psi'(\alpha)&1/\beta\\1/\beta&\alpha/\beta^2}이다(ψ′\psi'는 trigamma 함수). 다른 모수를 모를 때 한 모수의 점근분산은 I−1I^{-1}의 대각성분이고, 이것은 다른 모수를 알 때의 1/Ijj1/I_{jj}보다 크거나 같다.

연습문제

연습 3.1 (Poisson의 구간 ★) 기병대 자료(n=280n=280, λ^=0.70\hat\lambda=0.70)로 따름정리 3.2의 95% 구간을 구하라. e−λe^{-\lambda}의 구간은?

풀이

0.70±1.960.70/280=[0.602, 0.798]0.70\pm1.96\sqrt{0.70/280}=[0.602,\allowbreak \ 0.798]. e−λe^{-\lambda}는 단조이므로 끝점을 옮기면 [e−0.798,e−0.602]=[0.450, 0.548][e^{-0.798},\allowbreak e^{-0.602}]=[0.450,\allowbreak \ 0.548]. 델타 방법으로는 0.497±1.96⋅0.497⋅0.050=[0.448, 0.545]0.497\pm1.96\cdot0.497\cdot0.050=[0.448,\allowbreak \ 0.545]로 거의 같다.

연습 3.2 (관측 정보 ★★) Cauchy 위치모형에서 곡률 J(θ)=−ℓ′′(θ)=∑2(1−ui2)(1+ui2)2J(\theta)=-\ell''(\theta)=\sum\tfrac{2(1-u_i^2)}{(1+u_i^2)^2} (ui=xi−θu_i=x_i-\theta)는 θ\theta에 따라 음수가 될 수 있음을 보여라(예제 4.3의 골짜기). 극대점인 θ^\hat\theta에서는 왜 음수일 수 없는가? 참값에서 J(θ0)J(\theta_0)의 기댓값은 n2\tfrac n2이다.

풀이

∣ui∣>1|u_i|>1인 관측은 음의 항을 준다. θ\theta가 관측들에서 멀리 떨어져 대부분의 ∣ui∣|u_i|가 1보다 크면 합이 음수가 된다. 예제 4.3의 골짜기 θ=7.53\theta=7.53에서는 J=−0.48J=-0.48이다. 한편 θ^\hat\theta가 극대점이면 2계 필요조건으로 ℓ′′(θ^)≤0\ell''(\hat\theta)\le0, 곧 J(θ^)≥0J(\hat\theta)\ge0이다. 그래서 관측 정보 J(θ^)J(\hat\theta)로 만든 구간(따름정리 3.2(a))은 엄격한 극대점(J(θ^)>0J(\hat\theta)>0)이면 언제나 정의된다. 기댓값은 한 관측에 E2(1−U2)(1+U2)2=12E\tfrac{2(1-U^2)}{(1+U^2)^2}=\tfrac12 (연습 2.1의 계산).

연습 3.3 (감마의 모양 모수 ★★★) 감마(α,β)(\alpha,\beta)의 정보 행렬을 유도하고 β\beta를 모를 때 α^\hat\alpha의 점근분산이 αn(αψ′(α)−1)\tfrac{\alpha}{n(\alpha\psi'(\alpha)-1)}임을 보여라. α=2\alpha=2이면 6.90n\tfrac{6.90}n이다(ψ′(2)=π26−1\psi'(2)=\tfrac{\pi^2}6-1).

풀이

log⁡f=−log⁡Γ(α)−αlog⁡β+(α−1)log⁡x−xβ\log f=-\log\Gamma(\alpha)-\alpha\log\beta+(\alpha-1)\log x-\tfrac x\beta에서 ∂2∂α2=−ψ′(α)\tfrac{\partial^2}{\partial\alpha^2}=-\psi'(\alpha), ∂2∂α∂β=−1β\tfrac{\partial^2}{\partial\alpha\partial\beta}=-\tfrac1\beta, ∂2∂β2=αβ2−2xβ3\tfrac{\partial^2}{\partial\beta^2}=\tfrac\alpha{\beta^2}-\tfrac{2x}{\beta^3}이고 EX=αβEX=\alpha\beta이므로 I=(ψ′(α)1/β1/βα/β2)I=\smat{\psi'(\alpha)&1/\beta\\1/\beta&\alpha/\beta^2}. (I−1)11=α/β2ψ′(α)α/β2−1/β2=ααψ′(α)−1(I^{-1})_{11}=\tfrac{\alpha/\beta^2}{\psi'(\alpha)\alpha/\beta^2-1/\beta^2}=\tfrac\alpha{\alpha\psi'(\alpha)-1}. α=2\alpha=2이면 ψ′(2)=0.6449\psi'(2)=0.6449이므로 20.2899=6.90\tfrac2{0.2899}=6.90.

연습 3.4 (정규의 두 모수 ★★) N(μ,σ2)\N(\mu,\sigma^2)의 정보 행렬이 대각임을 보이고, 그것이 6회의 Xˉ⊥S2\bar X\perp S^2와 어떻게 어울리는지 말하라.

풀이

∂2log⁡f∂μ∂σ2=−X−μσ4\tfrac{\partial^2\log f}{\partial\mu\partial\sigma^2}=-\tfrac{X-\mu}{\sigma^4}의 기댓값이 0이므로 비대각 성분이 0이다. 극한에서 μ^\hat\mu와 σ^2\hat\sigma^2은 무상관인 결합정규, 곧 독립이다(5회 정리 B). 정규 표본에서는 이것이 극한이 아니라 정확히 성립한다는 것이 6회의 Student 정리다.

연습 3.5 (대표본 구간과 함수: 증명 ★★ 유도형) 따름정리 3.2를 다음 순서로 증명하라.

  1. (a)

    II가 연속이면 I(θ^n)→PI(θ0)I(\hat\theta_n)\xrightarrow{P}I(\theta_0)임을 연속사상 정리로 보이고, Slutsky 정리로 nI(θ^n) (θ^n−θ0)→DN(0,1)\sqrt{nI(\hat\theta_n)}\,(\hat\theta_n-\theta_0)\xrightarrow{D}\N(0,\allowbreak 1)을 얻어라.

  2. (b)

    (a)에서 구간이 θ0\theta_0를 포함할 확률이 1−α1-\alpha로 감을 보여라(8회 정리 2.4).

  3. (c)

    평균값 정리로 ℓ′′(θ^n)=ℓ′′(θ0)+(θ^n−θ0)ℓ′′′(θ~n)\ell''(\hat\theta_n)=\ell''(\theta_0)+(\hat\theta_n-\theta_0)\ell'''(\tilde\theta_n)으로 쓰고, 정리 3.1의 증명 4 5를 되풀이해 −n−1ℓ′′(θ^n)→PI(θ0)-n^{-1}\ell''(\hat\theta_n)\xrightarrow{P}I(\theta_0)를 보여라.

  4. (d)

    따름정리의 (b)를 델타 방법(7회 정리 4.4)으로 보이고, 정리 1.3로 g(θ^n)g(\hat\theta_n)이 g(θ)g(\theta)의 MLE임을 확인하라.

풀이

(a) g(t)=I(t)g(t)=\sqrt{I(t)}는 θ0\theta_0에서 연속이고 θ^n→Pθ0\hat\theta_n\xrightarrow{P}\theta_0이므로 연속사상 정리(7회)로 I(θ^n)→PI(θ0)\sqrt{I(\hat\theta_n)}\xrightarrow{P}\sqrt{I(\theta_0)}이다. 정리 3.1로 nI(θ0)(θ^n−θ0)→DN(0,1)\sqrt{nI(\theta_0)}(\hat\theta_n-\theta_0)\xrightarrow{D}\N(0,\allowbreak 1)이고, Slutsky 정리로 여기에 I(θ^n)/I(θ0)→P1\sqrt{I(\hat\theta_n)/I(\theta_0)}\xrightarrow{P}1을 곱해도 극한은 같다. (b) 구간이 θ0\theta_0를 포함하는 사건은 {∣nI(θ^n)(θ^n−θ0)∣≤zα/2}\{|\sqrt{nI(\hat\theta_n)}(\hat\theta_n-\theta_0)|\le z_{\alpha/2}\}이다. (a)와 극한분포의 연속성으로 그 확률은 P(∣Z∣≤zα/2)=1−αP(|Z|\le z_{\alpha/2})=1-\alpha로 간다(8회 정리 2.4). (c) 평균값 정리로 ℓ′′(θ^n)=ℓ′′(θ0)+(θ^n−θ0)ℓ′′′(θ~n)\ell''(\hat\theta_n)=\ell''(\theta_0)+(\hat\theta_n-\theta_0)\ell'''(\tilde\theta_n)이고 θ~n\tilde\theta_n은 θ^n\hat\theta_n과 θ0\theta_0 사이에 있다. 정리 3.1의 증명 4로 −n−1ℓ′′(θ0)→PI(θ0)-n^{-1}\ell''(\theta_0)\xrightarrow{P}I(\theta_0)이고, 5와 같이 ∣n−1ℓ′′′(θ~n)∣≤n−1∑M(Xi)|n^{-1}\ell'''(\tilde\theta_n)|\le n^{-1}\sum M(X_i)가 확률적으로 유계이며 θ^n−θ0→P0\hat\theta_n-\theta_0\xrightarrow{P}0이므로 둘째 항은 →P0\xrightarrow{P}0이다. (d) 델타 방법(7회 정리 4.4)을 정리 3.1의 극한 N(0,1/I(θ0))\N(0,1/I(\theta_0))에 쓰면 n(g(θ^n)−g(θ0))→DN(0,g′(θ0)2/I(θ0))\sqrt n(g(\hat\theta_n)-g(\theta_0))\xrightarrow{D}\N(0,\allowbreak g'(\theta_0)^2/I(\theta_0))이다. 정리 1.3로 g(θ^n)g(\hat\theta_n)은 g(θ)g(\theta)의 MLE이다.

이 회차에서 읽은 절 0개 · 회차 차례