
테마
노트북 · 11회 · 충분성
충분성 자료를 줄이는 법
| 강의노트 | 11_sufficiency_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 11_sufficiency_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Newcomb(1882)의 빛의 통과 시간 (MASS newcomb) · von Bortkiewicz의 프로이센 기병대 (vcd VonBort) · 독일 전차 문제 (시뮬레이션) |
| 선수 지식 | 1–10회 (3회 반복기댓값·전분산 공식, 6회 Student 정리, 8회 독일 전차, 9회 Fisher 정보·Cramér–Rao) |
여는 질문. 관측의 흩어짐을 재는 방법은 둘이다. 평균에서 벗어난 거리의 평균(평균편차)과, 제곱의 평균의 제곱근(표준편차)이다. 천문학자 Eddington은 평균편차가 낫다고 했고, 젊은 Fisher는 표준편차가 낫다고 했다. 누가 옳았나?
이번 회차의 지도
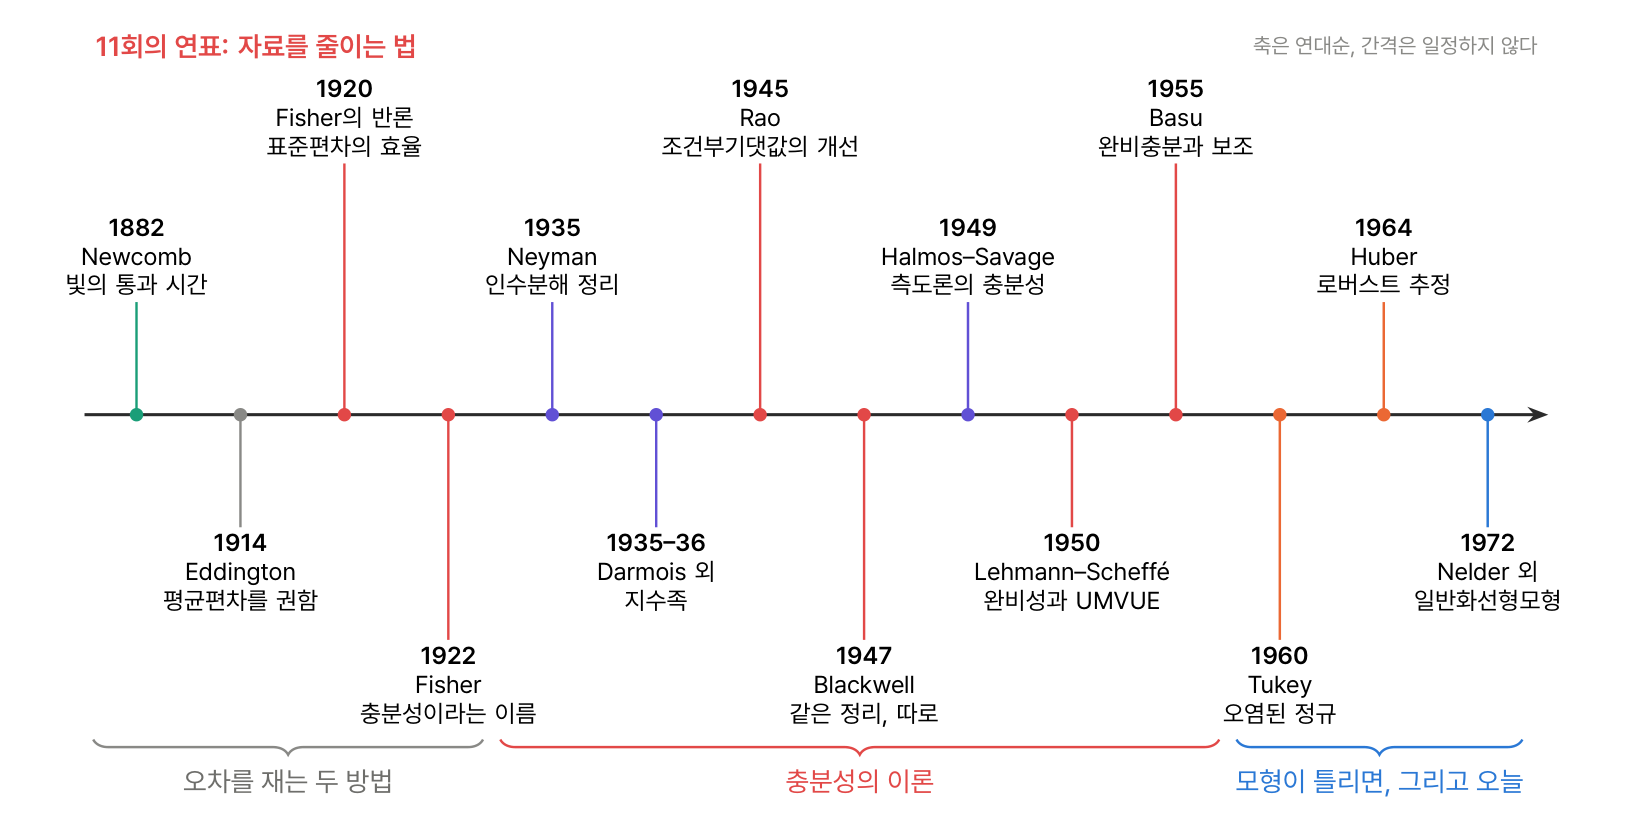
학습 목표
- 충분통계량이 주어질 때 자료의 조건부분포가 모수를 잊는 것을 시뮬레이션으로 확인하고, 충분통계량이 Fisher 정보를 보존함을 수치로 본다.
- Rao–Blackwell화를 구현해 , 독일 전차, , 정규 꼬리확률에서 분산이 줄어드는 것을 잰다.
- 완비성을 수치로 확인하고(삼각 연립방정식, 두 점의 반례), UMVUE와 MLE의 평균제곱오차를 비교한다.
ExpFamily클래스로 로그분배함수의 미분이 평균·분산·정보임을 확인하고, MLE가 충분통계량의 적률 맞추기임을 본다.- Basu의 정리를 시뮬레이션으로 보고, Eddington과 Fisher의 논쟁을 Newcomb의 자료와 Tukey의 오염 정규로 재현한다.
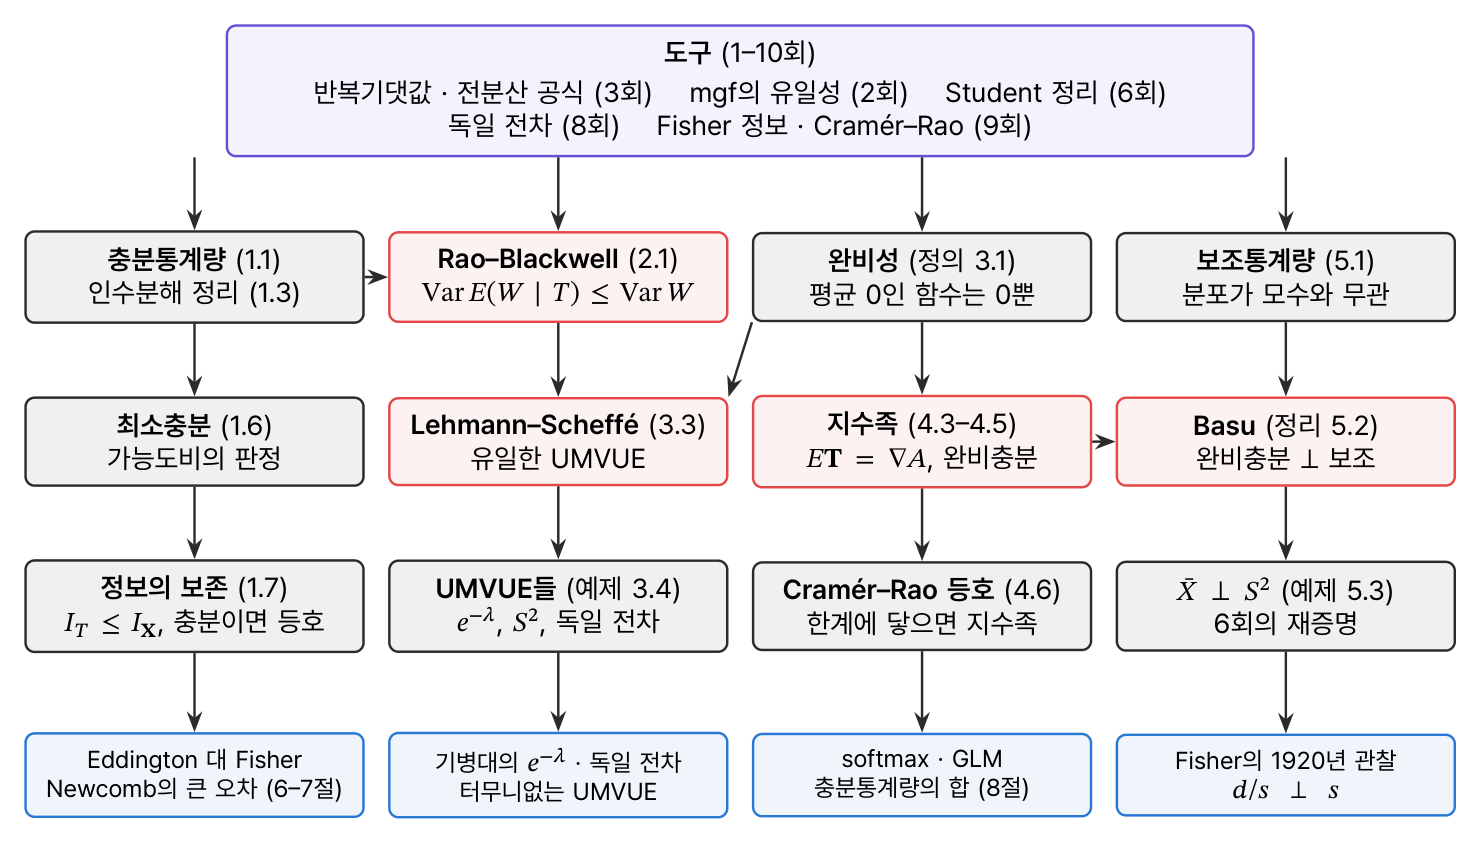
정리 지도
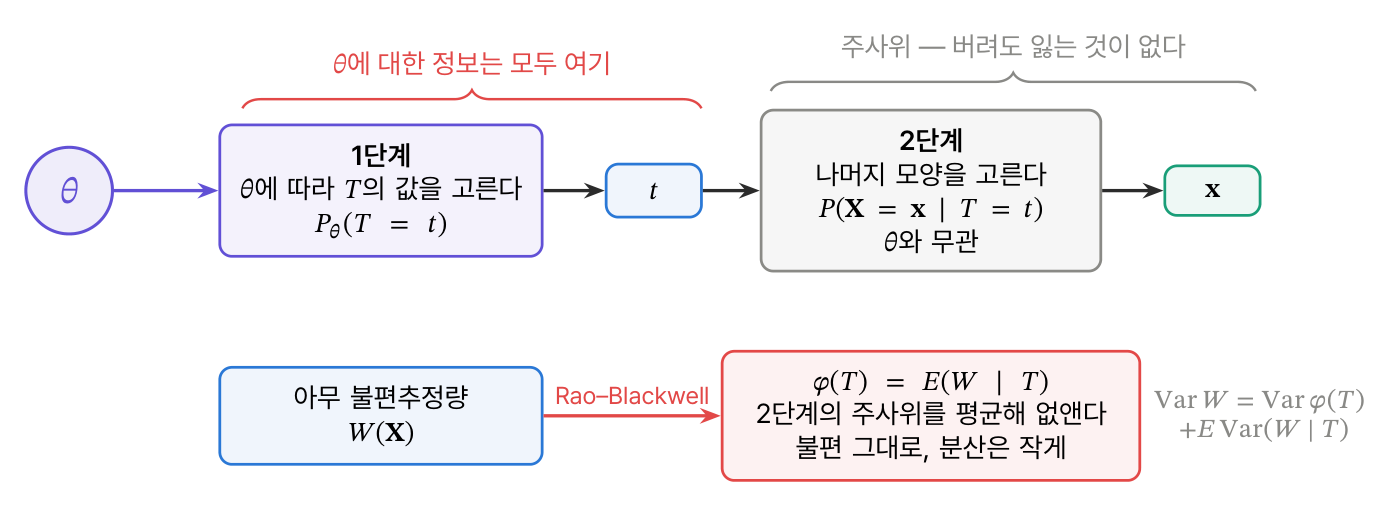
충분성의 그림
0. 설정
python
%matplotlib inline
import math
from itertools import product
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, special, stats

SEED = 1920
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

vb = load_rdata("VonBort", "vcd")
T_ALL, N_ALL = int(vb.deaths.sum()), len(vb)
print(f"기병대: {N_ALL} 군단–해, 죽은 병사 {T_ALL}명")
text
기병대: 280 군단–해, 죽은 병사 196명1. 충분통계량
정의 1.1 의 분포가 와 무관 · 예제 1.2 Bernoulli·Poisson · 정리 1.3 인수분해 · 예제 1.4 충분통계량 찾기 · 정의 1.5 · 정리 1.6 최소충분과 가능도비의 판정 · 명제 1.7 , 충분이면 등호.
정의를 그대로 확인한다. 작은 에서 모든 자료 를 나열하고, 가 주어질 때의 조건부확률을 두 개의 다른 에서 계산해 같은지 본다.
python
def conditional_table(pmf_joint, xs, T, thetas):
    """정의 1.1: 모든 x 에 대해 P(X = x | T = T(x)) 를 θ 마다 계산"""
    out = {}
    for th in thetas:
        p = np.array([pmf_joint(x, th) for x in xs])
        t = np.array([T(x) for x in xs])
        pt = {tv: p[t == tv].sum() for tv in np.unique(t)}
        out[th] = p / np.array([pt[tv] for tv in t])
    return out

# (a) Bernoulli, n = 4, T = Σx
xs_b = list(product([0, 1], repeat=4))
bern = lambda x, p: np.prod([p if xi else 1 - p for xi in x])
tab_b = conditional_table(bern, xs_b, sum, [0.2, 0.7])
# (b) Poisson, n = 3, T = Σx (0..6 까지 나열)
xs_p = [x for x in product(range(7), repeat=3) if sum(x) <= 6]
pois = lambda x, l: np.prod([stats.poisson.pmf(xi, l) for xi in x])
tab_p = conditional_table(pois, xs_p, sum, [0.5, 2.0])
multi = np.array([stats.multinomial.pmf(x, sum(x), [1 / 3] * 3) for x in xs_p])
# 충분하지 않은 통계량: Bernoulli 에서 T' = x1 이면 조건부분포가 p 에 의존한다
tab_bad = conditional_table(bern, xs_b, lambda x: x[0], [0.2, 0.7])
report({"예제 1.2 (a): Bernoulli — Σx 가 주어지면 모든 배치가 같은 확률 1/C(n,t), p 에 무관": np.allclose(tab_b[0.2], tab_b[0.7])
            and np.allclose(tab_b[0.2], [1 / math.comb(4, sum(x)) for x in xs_b]),
        "예제 1.2 (b) · 연습 1.1: Poisson — Σx 가 주어지면 다항 M(t; 1/n, …), λ 에 무관": np.allclose(tab_p[0.5], tab_p[2.0]) and np.allclose(tab_p[0.5], multi),
        "정의 1.1: 충분하지 않은 x1 로 조건을 걸면 p 가 남는다": not np.allclose(tab_bad[0.2], tab_bad[0.7])})
text
  ✓  예제 1.2 (a): Bernoulli — Σx 가 주어지면 모든 배치가 같은 확률 1/C(n,t), p 에 무관
  ✓  예제 1.2 (b) · 연습 1.1: Poisson — Σx 가 주어지면 다항 M(t; 1/n, …), λ 에 무관
  ✓  정의 1.1: 충분하지 않은 x1 로 조건을 걸면 p 가 남는다
python
# 정리 1.6 · 연습 1.3–1.4: 최소충분의 판정 — 가능도비가 θ 에 무관한가
thetas = np.linspace(-3, 3, 13)
def ratio_free(logf, x, y):
    r = np.array([logf(x, t) - logf(y, t) for t in thetas])
    return np.ptp(r) < 1e-9

norm_ll = lambda x, th: np.sum(stats.norm.logpdf(x, th[0], th[1]))
x = np.array([1.0, 2.0, 4.0]); y_same = np.array([4.0, 1.0, 2.0])           # 순서만 다름
# 정규: 합과 제곱합이 같으면 (값이 달라도) 비가 모수에 무관 — x 와 합 7, 제곱합 21 이 같은 다른 점을 만든다
y_moment = np.array([7 / 3 + 0.5 * math.sqrt(2.0), 7 / 3 - 0.5 * math.sqrt(2.0), 7 / 3])
scale = math.sqrt((np.sum(x**2) - 7**2 / 3) / np.sum((y_moment - 7 / 3) ** 2))
y_moment = 7 / 3 + scale * (y_moment - 7 / 3)
norm_free = all(ratio_free(lambda v, t: norm_ll(v, (t, s)), x, y_moment) for s in (0.5, 1, 2)) and \
            np.ptp([norm_ll(x, (m, s)) - norm_ll(y_moment, (m, s)) for m in thetas for s in (0.5, 1, 2)]) < 1e-9
cauchy_ll = lambda v, t: np.sum(stats.cauchy.logpdf(v, t))
report({"정리 1.6: 정규 — 합과 제곱합이 같은 두 자료는 가능도비가 (μ, σ) 에 무관": abs(y_moment.sum() - 7) < 1e-12 and abs(np.sum(y_moment**2) - 21) < 1e-12 and norm_free,
        "연습 1.4: Cauchy — 순서만 다르면 비가 상수, 값이 다르면 θ 에 의존": ratio_free(cauchy_ll, x, y_same) and not ratio_free(cauchy_ll, x, y_moment)})
text
  ✓  정리 1.6: 정규 — 합과 제곱합이 같은 두 자료는 가능도비가 (μ, σ) 에 무관
  ✓  연습 1.4: Cauchy — 순서만 다르면 비가 상수, 값이 다르면 θ 에 의존
python
# 명제 1.7 · 연습 1.5: 통계량의 정보 — 충분하면 다 보존, 아니면 잃는다
# (a) N(θ, 1) 하나에서 부호 T = 1{X > 0}: I_T(0) = 2/π
p_ = lambda t: stats.norm.cdf(t)
h = 1e-5
dp = (p_(h) - p_(-h)) / (2 * h)
I_sign = dp**2 / (p_(0) * (1 - p_(0)))
# (b) Poisson(λ), n = 5: T = ΣX 의 정보 = 자료 전체의 정보 n/λ,  X1 하나는 1/λ,  max(X) 는 그 사이
lam, n = 1.3, 5
def info_of_stat(pmf_t, support, lam, h=1e-5):
    """I_T(λ) = Σ_t (∂_λ p(t; λ))² / p(t; λ)"""
    p0 = np.array([pmf_t(t, lam) for t in support])
    dp = (np.array([pmf_t(t, lam + h) for t in support]) - np.array([pmf_t(t, lam - h) for t in support])) / (2 * h)
    keep = p0 > 1e-300
    return np.sum(dp[keep] ** 2 / p0[keep])
I_sum = info_of_stat(lambda t, l: stats.poisson.pmf(t, n * l), range(0, 80), lam)
I_x1 = info_of_stat(lambda t, l: stats.poisson.pmf(t, l), range(0, 40), lam)
pmf_max = lambda t, l: stats.poisson.cdf(t, l) ** n - stats.poisson.cdf(t - 1, l) ** n
I_max = info_of_stat(pmf_max, range(0, 40), lam)
print(f"부호의 정보 {I_sign:.4f} (2/π = {2 / math.pi:.4f});  Poisson n = 5: ΣX {I_sum:.4f}, max {I_max:.4f}, X1 {I_x1:.4f}  (n/λ = {n / lam:.4f})")
report({"연습 1.5: 부호의 정보 = 2/π = 0.637 (전체의 64%)": abs(I_sign - 2 / math.pi) < 1e-6,
        "명제 1.7: 충분통계량 ΣX 의 정보 = n/λ (전부 보존)": abs(I_sum - n / lam) < 1e-5,
        "명제 1.7: 충분하지 않은 통계량은 정보를 잃는다 (X1 < max < ΣX)": I_x1 < I_max < I_sum})
text
부호의 정보 0.6366 (2/π = 0.6366);  Poisson n = 5: ΣX 3.8462, max 2.1807, X1 0.7692  (n/λ = 3.8462)
  ✓  연습 1.5: 부호의 정보 = 2/π = 0.637 (전체의 64%)
  ✓  명제 1.7: 충분통계량 ΣX 의 정보 = n/λ (전부 보존)
  ✓  명제 1.7: 충분하지 않은 통계량은 정보를 잃는다 (X1 < max < ΣX)
📝 연습 1.1–1.5 (강의노트): Poisson의 조건부분포, 인수분해, 이동한 균등분포, Cauchy의 순서통계량, 부호가 담는 정보.
2. Rao–Blackwell — 조건을 걸면 좋아진다
정리 2.1 는 불편, (전분산 공식) · 예제 2.2 : · 예제 2.3 독일 전차: · 예제 2.4 : .
python
# 예제 2.2 · 연습 2.1: e^{−λ} — 지시함수 하나에서 (1 − 1/n)^T 로
lam, n = 0.7, 20
X = rng.poisson(lam, (N_SIM, n)); T = X.sum(1)
W = (X[:, 0] == 0).astype(float)
phi = (1 - 1 / n) ** T
# E(W | T = t) 를 시뮬레이션으로 직접: T 의 값마다 W 의 평균
emp = pd.Series(W).groupby(T).mean()
formula = (1 - 1 / n) ** emp.index.to_numpy()
cnt = pd.Series(W).groupby(T).size()
big = cnt.to_numpy() > 2000
var_exact = math.exp(-2 * lam) * (math.exp(lam / n) - 1)
cr = lam * math.exp(-2 * lam) / n
vb_umvue = (1 - 1 / N_ALL) ** T_ALL
print(f"분산: W {W.var():.4f} → φ(T) {phi.var():.5f} (정확히 {var_exact:.5f}, 비 {W.var() / phi.var():.1f});  Cramér–Rao 한계 {cr:.5f}")
print(f"기병대: UMVUE (279/280)^196 = {vb_umvue:.4f},  MLE e^(−0.7) = {math.exp(-T_ALL / N_ALL):.4f},  관측 비율 {np.mean(vb.deaths == 0):.3f}")
report({"정리 2.1 (a): E(W | T = t) 의 경험적 값 = (1 − 1/n)^t (도수가 큰 t 에서 4 se 안)":
            all(within(e_, f_, math.sqrt(f_ * (1 - f_) / c_)) for e_, f_, c_ in zip(emp.to_numpy()[big], formula[big], cnt.to_numpy()[big])),
        "정리 2.1 (b): 둘 다 불편": within(W.mean(), math.exp(-lam), W.std() / math.sqrt(N_SIM)) and within(phi.mean(), math.exp(-lam), phi.std() / math.sqrt(N_SIM)),
        "예제 2.2 · 연습 2.1: 분산 0.250 → 0.0088 (28분의 1), 정확한 식 e^{−2λ}(e^{λ/n} − 1)": abs(phi.var() / var_exact - 1) < 0.02 and abs(W.var() / phi.var() - 28.4) < 1,
        "연습 2.1: Cramér–Rao 한계보다 크지만 비 (e^{λ/n}−1)/(λ/n) 는 1 에 가깝다": var_exact > cr and abs(var_exact / cr - (math.exp(lam / n) - 1) / (lam / n)) < 1e-12,
        "예제 2.2: 기병대의 UMVUE 0.4960": abs(vb_umvue - 0.4960) < 5e-5})
text
분산: W 0.2500 → φ(T) 0.00879 (정확히 0.00878, 비 28.4);  Cramér–Rao 한계 0.00863
기병대: UMVUE (279/280)^196 = 0.4960,  MLE e^(−0.7) = 0.4966,  관측 비율 0.514
  ✓  정리 2.1 (a): E(W | T = t) 의 경험적 값 = (1 − 1/n)^t (도수가 큰 t 에서 4 se 안)
  ✓  정리 2.1 (b): 둘 다 불편
  ✓  예제 2.2 · 연습 2.1: 분산 0.250 → 0.0088 (28분의 1), 정확한 식 e^{−2λ}(e^{λ/n} − 1)
  ✓  연습 2.1: Cramér–Rao 한계보다 크지만 비 (e^{λ/n}−1)/(λ/n) 는 1 에 가깝다
  ✓  예제 2.2: 기병대의 UMVUE 0.4960
python
# 예제 2.3 · 연습 2.2: 독일 전차 — 적률법에 최댓값으로 조건을 걸면 8회의 N̂
N, k = 300, 5
S = np.array([rng.choice(N, k, replace=False) + 1 for _ in range(100_000)])
M = S.max(1); W_t = 2 * S.mean(1) - 1; phi_t = (k + 1) / k * M - 1
emp_t = pd.Series(W_t).groupby(M).agg(["mean", "std", "size"])
emp_t = emp_t[emp_t["size"] > 800]
ok_cond = all(within(r["mean"], (k + 1) / k * m - 1, r["std"] / math.sqrt(r["size"])) for m, r in emp_t.iterrows())
# 연습 2.2: M = m 이 주어지면 나머지 k−1 개의 각 원소는 {1, …, m−1} 위에서 균등 → 평균 m/2
m0 = 250
rest = np.sort(S[M == m0], axis=1)[:, :-1]
print(f"sd: 2X̄ − 1 = {W_t.std():.1f}, (k+1)/k·M − 1 = {phi_t.std():.1f};  M = {m0} 일 때 나머지의 평균 {rest.mean():.2f} (m/2 = {m0 / 2})")
report({"예제 2.3: E(2X̄ − 1 | M = m) = (k+1)/k·m − 1 (도수가 큰 m 마다 4 se 안)": ok_cond,
        "예제 2.3: 표준편차 77 → 50": abs(W_t.std() - 77) < 1 and abs(phi_t.std() - 50.4) < 1,
        "연습 2.2: M = m 이면 나머지의 평균 = m/2": within(rest.mean(), m0 / 2, rest.std() / math.sqrt(rest.size))})
text
sd: 2X̄ − 1 = 77.1, (k+1)/k·M − 1 = 50.5;  M = 250 일 때 나머지의 평균 125.68 (m/2 = 125.0)
  ✓  예제 2.3: E(2X̄ − 1 | M = m) = (k+1)/k·m − 1 (도수가 큰 m 마다 4 se 안)
  ✓  예제 2.3: 표준편차 77 → 50
  ✓  연습 2.2: M = m 이면 나머지의 평균 = m/2
python
# 예제 2.4 · 연습 2.3: p² 와 정규 꼬리확률의 Rao–Blackwell 화
p, n = 0.3, 12
B = rng.random((N_SIM, n)) < p; T = B.sum(1)
W2, phi2 = (B[:, 0] & B[:, 1]).astype(float), T * (T - 1) / (n * (n - 1))
# 연습 2.3: N(θ, 1) 에서 P(X ≤ c) = Φ(c − θ)
theta, c, n = 0.0, 1.0, 10
Xn = rng.normal(theta, 1, (N_SIM, n))
Wn = (Xn[:, 0] <= c).astype(float); phin = stats.norm.cdf((c - Xn.mean(1)) / math.sqrt((n - 1) / n))
print(f"p²: 분산 {W2.var():.4f} → {phi2.var():.5f};  Φ(1): 분산 {Wn.var():.4f} → {phin.var():.5f}, 평균 {phin.mean():.4f} (참값 {stats.norm.cdf(c):.4f})")
report({"예제 2.4: T(T−1)/(n(n−1)) 는 p² 의 불편추정량, 분산이 훨씬 작다": within(phi2.mean(), p**2, phi2.std() / math.sqrt(N_SIM)) and phi2.var() < W2.var() / 5,
        "연습 2.3: Φ((c − X̄)/√((n−1)/n)) 는 불편, 분산 0.134 → 0.006": within(phin.mean(), stats.norm.cdf(c), phin.std() / math.sqrt(N_SIM)) and phin.var() < Wn.var() / 20})
text
p²: 분산 0.0824 → 0.00694;  Φ(1): 분산 0.1340 → 0.00611, 평균 0.8415 (참값 0.8413)
  ✓  예제 2.4: T(T−1)/(n(n−1)) 는 p² 의 불편추정량, 분산이 훨씬 작다
  ✓  연습 2.3: Φ((c − X̄)/√((n−1)/n)) 는 불편, 분산 0.134 → 0.006
표 읽기. 세 예 모두 같은 일이 일어났다. 관측 하나나 둘만 쓰는 엉성한 불편추정량에 충분통계량으로 조건을 걸면, 불편성은 그대로 두고 분산만 수십분의 일로 줄어든다. 줄어든 몫이 전분산 공식의 , 곧 "2단계의 주사위"(그림)가 만든 흔들림이다.
📝 연습 2.1–2.4 (강의노트): 분산의 계산, 전차의 조건부 평균, 정규의 꼬리확률, 볼록 손실.
3. 완비성과 Lehmann–Scheffé — 가장 좋은 불편추정량
정의 3.1 · 예제 3.2 이항·Poisson·균등의 최댓값은 완비, 은 아니다 · 정리 3.3 완비충분통계량의 불편 함수 = 유일한 UMVUE · 예제 3.4 , , , 독일 전차.
완비성은 "선형 연립방정식의 해가 0뿐인가"로 숫자로 확인할 수 있다. 은 에 대해 선형이기 때문이다.
python
# 연습 3.3: 독일 전차의 M 은 완비 — E_N g(M) = 0 (N = k, …, k+L) 은 하삼각 연립방정식, 해는 0 뿐
k, L = 5, 40
Ns = np.arange(k, k + L)
A = np.array([[math.comb(m - 1, k - 1) / math.comb(N, k) if m <= N else 0.0 for m in Ns] for N in Ns])
tank_complete = np.allclose(np.tril(A), A) and np.all(np.diag(A) > 0) and np.linalg.matrix_rank(A) == L
# 연습 3.1: Poisson 은 μ > 0 전체에서 완비지만, μ ∈ {1, 2} 두 점이면 g = (1, −3/2, 1) 이 반례
g = np.array([1.0, -1.5, 1.0])
two_point = [np.sum(g * stats.poisson.pmf([0, 1, 2], mu)) for mu in (1.0, 2.0)]
other = [np.sum(g * stats.poisson.pmf([0, 1, 2], mu)) for mu in (0.5, 3.0)]
# 예제 3.2 (d): U(θ, θ+1) 의 범위는 보조 → (X_(1), X_(n)) 은 완비가 아니다
R = {}
for th in (0.0, 5.0):
    U = rng.uniform(th, th + 1, (100_000, 6)); R[th] = U.max(1) - U.min(1)
print(f"Poisson 두 점의 반례: E g = {np.round(two_point, 12)} (μ = 1, 2) 이지만 μ = 0.5, 3 에서는 {np.round(other, 4)}")
report({"연습 3.3: 전차의 M — 하삼각, 대각이 양수, 해는 0 뿐 (완비)": tank_complete,
        "연습 3.1: 정의역이 두 점이면 Poisson 도 완비가 아니다": np.allclose(two_point, 0) and not np.allclose(other, 0),
        "예제 3.2 (d): U(θ, θ+1) 의 범위의 분포는 θ 에 무관 (KS)": stats.ks_2samp(R[0.0], R[5.0]).pvalue > 0.01})
text
Poisson 두 점의 반례: E g = [-0.  0.] (μ = 1, 2) 이지만 μ = 0.5, 3 에서는 [0.2274 0.0498]
  ✓  연습 3.3: 전차의 M — 하삼각, 대각이 양수, 해는 0 뿐 (완비)
  ✓  연습 3.1: 정의역이 두 점이면 Poisson 도 완비가 아니다
  ✓  예제 3.2 (d): U(θ, θ+1) 의 범위의 분포는 θ 에 무관 (KS)
python
# 정리 3.3 · 예제 3.4 · 연습 3.2 · 3.4: UMVUE 들의 불편성과 분산
n, R_ = 8, N_SIM
U = rng.uniform(0, 3.0, (R_, n)); M = U.max(1)
B = rng.random((R_, n)) < 0.3; T = B.sum(1)
Z = rng.normal(0, 2, (R_, n))
cands = {   # (추정량 표본, 참값)
    "U(0,θ): (n+1)/n·X_(n) → θ": ((n + 1) / n * M, 3.0),
    "U(0,θ): (n+2)/n·X_(n)² → θ²": ((n + 2) / n * M**2, 9.0),
    "Bernoulli: T(n−T)/(n(n−1)) → p(1−p)": (T * (n - T) / (n * (n - 1)), 0.21),
    "정규: S² → σ²": (Z.var(1, ddof=1), 4.0),
}
rows = {k_: dict(mean=v.mean(), truth=t, se=v.std() / math.sqrt(R_)) for k_, (v, t) in cands.items()}
print(pd.DataFrame(rows).T.round(4).to_string())
# 경쟁하는 불편추정량보다 분산이 작다: U(0,θ) 에서 2X̄ (적률법) 대 (n+1)/n·X_(n)
var_mom, var_umvue = (2 * U.mean(1)).var(), ((n + 1) / n * M).var()
report({"예제 3.4 · 연습 3.2 · 3.4: 모두 불편 (4 se 안)": all(within(r["mean"], r["truth"], r["se"]) for r in rows.values()),
        "정리 3.3: U(0,θ) 에서 UMVUE 의 분산 θ²/(n(n+2)) < 적률법 2X̄ 의 θ²/(3n)": abs(var_umvue / (9 / (n * (n + 2))) - 1) < 0.02 and var_umvue < var_mom})
text
                                       mean  truth      se
U(0,θ): (n+1)/n·X_(n) → θ            2.9996   3.00  0.0008
U(0,θ): (n+2)/n·X_(n)² → θ²          8.9982   9.00  0.0041
Bernoulli: T(n−T)/(n(n−1)) → p(1−p)  0.2097   0.21  0.0002
정규: S² → σ²                          4.0008   4.00  0.0048
  ✓  예제 3.4 · 연습 3.2 · 3.4: 모두 불편 (4 se 안)
  ✓  정리 3.3: U(0,θ) 에서 UMVUE 의 분산 θ²/(n(n+2)) < 적률법 2X̄ 의 θ²/(3n)
python
# 3.2절의 주의: UMVUE 는 불편추정량 중 최선일 뿐 — Poisson 의 e^{−λ}, n = 20 에서 MLE 의 평균제곱오차가 더 작다
lam, n = 0.7, 20
t = np.arange(0, 200); pt = stats.poisson.pmf(t, n * lam); tau = math.exp(-lam)
umvue_vals, mle_vals = (1 - 1 / n) ** t, np.exp(-t / n)
mse = lambda v: np.sum(pt * (v - tau) ** 2)
bias_mle = np.sum(pt * mle_vals) - tau
print(f"정확한 계산: UMVUE 의 평균제곱오차(=분산) {mse(umvue_vals):.5f},  MLE {mse(mle_vals):.5f} (치우침 {bias_mle:+.4f})")
def mse_ratio(l):
    """MLE 의 평균제곱오차 / UMVUE 의 분산 (정확한 합)"""
    pt_ = stats.poisson.pmf(t, n * l); tau_ = math.exp(-l)
    return np.sum(pt_ * (np.exp(-t / n) - tau_) ** 2) / np.sum(pt_ * ((1 - 1 / n) ** t - tau_) ** 2)

lam_cross = optimize.brentq(lambda l: mse_ratio(l) - 1, 0.3, 2.0)
print(f"MLE/UMVUE 비: λ = 0.1 → {mse_ratio(0.1):.3f}, 0.7 → {mse_ratio(0.7):.3f}, 2 → {mse_ratio(2.0):.3f};  뒤집히는 곳 λ ≈ {lam_cross:.2f}")
report({"3절 주의: n = 20, λ = 0.7 에서 MLE 의 평균제곱오차 0.00872 < UMVUE 의 0.00878": abs(mse(umvue_vals) - 0.00878) < 5e-6 and abs(mse(mle_vals) - 0.00872) < 5e-6,
        "3절 주의: MLE 는 위로 0.009 치우쳤다": abs(bias_mle - 0.0086) < 5e-4,
        "3절 주의: λ 가 0.83 보다 크면 UMVUE 가 이긴다 — 어느 쪽도 늘 이기지 않는다": mse_ratio(0.1) < 1 < mse_ratio(2.0) and abs(lam_cross - 0.83) < 0.005})
text
정확한 계산: UMVUE 의 평균제곱오차(=분산) 0.00878,  MLE 0.00872 (치우침 +0.0086)
MLE/UMVUE 비: λ = 0.1 → 0.957, 0.7 → 0.992, 2 → 1.071;  뒤집히는 곳 λ ≈ 0.83
  ✓  3절 주의: n = 20, λ = 0.7 에서 MLE 의 평균제곱오차 0.00872 < UMVUE 의 0.00878
  ✓  3절 주의: MLE 는 위로 0.009 치우쳤다
  ✓  3절 주의: λ 가 0.83 보다 크면 UMVUE 가 이긴다 — 어느 쪽도 늘 이기지 않는다
📝 연습 3.1–3.4 (강의노트): Poisson의 완비성, 균등의 UMVUE, 전차의 완비성, Bernoulli의 분산.
4. 지수족
정의 4.1 · 예제 4.2 자연모수로 쓰기 · 정리 4.3 , · 따름정리 4.4 정보 , 로그가능도는 오목, MLE는 · 정리 4.5 완비충분 · 정리 4.6 Cramér–Rao의 등호 ⟹ 지수족.
로그분배함수 하나만 주면 평균, 분산, 정보, MLE까지 모두 나오는 클래스를 만든다.
python
class ExpFamily:
    """정의 4.1: 자연모수꼴 지수족. A(η) 만 주면 수치미분으로 평균 · 공분산 · 정보, Newton 으로 MLE"""
    def __init__(self, name, A, T, sampler, h=1e-5):
        self.name, self.A, self.T, self.sampler, self.h = name, A, T, sampler, h

    def grad(self, eta):
        eta = np.atleast_1d(np.asarray(eta, float)); E = np.eye(len(eta)) * self.h
        return np.array([(self.A(eta + e) - self.A(eta - e)) / (2 * self.h) for e in E])

    def hess(self, eta):
        eta = np.atleast_1d(np.asarray(eta, float)); E = np.eye(len(eta)) * 1e-4
        return np.array([(self.grad(eta + e) - self.grad(eta - e)) / 2e-4 for e in E])

    def mle(self, x, eta0, iters=60):
        """따름정리 4.4 (c): 충분통계량의 평균을 ∇A 와 맞춘다. 로그가능도 η·T̄ − A(η) 는 오목이지만
        Newton 걸음이 자연모수 공간 밖으로 나갈 수 있으므로, 공간 안에서 가능도가 늘 때까지 걸음을 반으로 줄인다"""
        tbar = self.T(x).mean(0)
        ll = lambda e: e @ tbar - self.A(e)
        eta = np.atleast_1d(np.asarray(eta0, float))
        for _ in range(iters):
            step = -np.linalg.solve(self.hess(eta), self.grad(eta) - tbar)
            with np.errstate(invalid="ignore", divide="ignore"):
                while not np.isfinite(ll(eta + step)) or ll(eta + step) < ll(eta):
                    step = step / 2
            eta = eta + step
        return eta

fams = {
    "Bernoulli": (ExpFamily("Bernoulli", lambda e: np.log1p(np.exp(e[0])), lambda x: x[:, None].astype(float),
                            lambda e, n: (rng.random(n) < special.expit(e[0])).astype(float)), [special.logit(0.3)], [0.0]),
    "Poisson": (ExpFamily("Poisson", lambda e: np.exp(e[0]), lambda x: x[:, None].astype(float),
                          lambda e, n: rng.poisson(np.exp(e[0]), n)), [math.log(0.7)], [0.0]),
    "정규": (ExpFamily("정규", lambda e: -e[0] ** 2 / (4 * e[1]) - 0.5 * np.log(-2 * e[1]), lambda x: np.column_stack([x, x**2]),
                      lambda e, n: rng.normal(-e[0] / (2 * e[1]), math.sqrt(-1 / (2 * e[1])), n)), [5 / 4, -1 / 8], [0.0, -0.5]),
    "감마": (ExpFamily("감마", lambda e: special.gammaln(e[0] + 1) - (e[0] + 1) * np.log(-e[1]), lambda x: np.column_stack([np.log(x), x]),
                      lambda e, n: rng.gamma(e[0] + 1, -1 / e[1], n)), [1.0, -1 / 1.5], [0.0, -1.0]),
}
checks = {}
for name, (fam, eta, eta0) in fams.items():
    x = fam.sampler(np.array(eta, float), 400_000)
    Tx = fam.T(x)
    mean_ok = np.allclose(fam.grad(eta), Tx.mean(0), rtol=0.01, atol=2e-3)
    cov_ok = np.allclose(fam.hess(eta), np.atleast_2d(np.cov(Tx.T)), rtol=0.03, atol=2e-3)
    eta_hat = fam.mle(x[:5000], eta0)
    checks[f"정리 4.3: {name} — ∇A = 평균, ∇²A = 공분산 (시뮬레이션과 대조)"] = mean_ok and cov_ok
    checks[f"따름정리 4.4 (c): {name} — 적률 맞추기 MLE 가 참값 근처 (n = 5000)"] = np.allclose(eta_hat, eta, atol=0.12)
# 감마의 MLE 는 scipy 와 같은가 (모양 α = η1 + 1)
xg = fams["감마"][0].sampler(np.array([1.0, -1 / 1.5]), 3000)
eta_g = fams["감마"][0].mle(xg, [0.0, -1.0])
checks["따름정리 4.4 (c): 감마의 적률 맞추기 = scipy.stats.gamma.fit (9회 예제 4.4)"] = abs(eta_g[0] + 1 - stats.gamma.fit(xg, floc=0)[0]) < 1e-4
# 연습 4.2: Poisson 의 모든 누적량 = λ  (A 의 고계 미분이 모두 e^η)
lam = 0.7; kk = np.arange(0, 60); pk = stats.poisson.pmf(kk, lam)
m = [np.sum(pk * kk**j) for j in range(1, 5)]
k3 = m[2] - 3 * m[1] * m[0] + 2 * m[0] ** 3
k4 = m[3] - 4 * m[2] * m[0] - 3 * m[1] ** 2 + 12 * m[1] * m[0] ** 2 - 6 * m[0] ** 4
checks["연습 4.2: Poisson 의 3·4차 누적량 = λ"] = abs(k3 - lam) < 1e-10 and abs(k4 - lam) < 1e-10
report(checks)
text
✓ 정리 4.3: Bernoulli — ∇A = 평균, ∇²A = 공분산 (시뮬레이션과 대조)text
  ✓  따름정리 4.4 (c): Bernoulli — 적률 맞추기 MLE 가 참값 근처 (n = 5000)
  ✓  정리 4.3: Poisson — ∇A = 평균, ∇²A = 공분산 (시뮬레이션과 대조)
  ✓  따름정리 4.4 (c): Poisson — 적률 맞추기 MLE 가 참값 근처 (n = 5000)
  ✓  정리 4.3: 정규 — ∇A = 평균, ∇²A = 공분산 (시뮬레이션과 대조)
  ✓  따름정리 4.4 (c): 정규 — 적률 맞추기 MLE 가 참값 근처 (n = 5000)
  ✓  정리 4.3: 감마 — ∇A = 평균, ∇²A = 공분산 (시뮬레이션과 대조)
  ✓  따름정리 4.4 (c): 감마 — 적률 맞추기 MLE 가 참값 근처 (n = 5000)
  ✓  따름정리 4.4 (c): 감마의 적률 맞추기 = scipy.stats.gamma.fit (9회 예제 4.4)
  ✓  연습 4.2: Poisson 의 3·4차 누적량 = λ
python
# 연습 4.1 · 4.4 · 정리 4.6 · 연습 4.3: 감마의 A, softmax, Cramér–Rao 의 등호
gam = fams["감마"][0]; a, b = 2.0, 1.5
g_ = gam.grad([a - 1, -1 / b]); H_ = gam.hess([a - 1, -1 / b])
J = np.diag([1.0, 1 / b**2])                                      # (α, β) → (η1, η2) 의 야코비
I_ab = J.T @ H_ @ J
# softmax: ∇A = softmax, ∇²A = diag(p) − ppᵀ (특이)
cat = ExpFamily("범주", lambda e: special.logsumexp(e), None, None)
eta3 = np.array([1.0, 0.0, -1.0]); p3 = special.softmax(eta3)
# 정리 4.6: Poisson 의 X̄ 는 한계에 닿고, e^{−λ} 의 UMVUE 는 닿지 않는다 (연습 2.1)
n, lam = 20, 0.7
report({"연습 4.1: 감마의 ∇A = (ψ(α) + log β, αβ)": np.allclose(g_, [special.digamma(a) + math.log(b), a * b], atol=1e-6),
        "연습 4.1: 감마의 정보 행렬 (α, β) = Jᵀ ∇²A J (9회 연습 3.3)": np.allclose(I_ab, [[special.polygamma(1, a), 1 / b], [1 / b, a / b**2]], atol=1e-4),
        "연습 4.4: ∇A = softmax, ∇²A = diag(p) − ppᵀ, 1 이 영공간에": np.allclose(cat.grad(eta3), p3, atol=1e-8) and np.allclose(cat.hess(eta3), np.diag(p3) - np.outer(p3, p3), atol=1e-5)
            and np.allclose((np.diag(p3) - np.outer(p3, p3)) @ np.ones(3), 0),
        "정리 4.6 · 연습 4.3: X̄ 의 분산 = λ/n (한계), (1−1/n)^T 의 분산 > λe^{−2λ}/n": abs(lam / n - 1 / (n / lam)) < 1e-15 and math.exp(-2 * lam) * (math.exp(lam / n) - 1) > lam * math.exp(-2 * lam) / n})

eta = np.linspace(-6, 6, 300); pp = special.expit(eta)
fig, axes = plt.subplots(1, 3, figsize=(12, 3.2))
axes[0].plot(eta, np.log1p(np.exp(eta)), color=C["theta"]); axes[0].set_title("A(η) = log(1 + e^η): convex")
axes[1].plot(eta, pp, color=C["stat"]); axes[1].set_title("A'(η) = E T = p")
axes[2].plot(eta, pp * (1 - pp), color=C["key"]); axes[2].set_title("A''(η) = Var T = I(η)")
for ax in axes: ax.set_xlabel("η (log-odds)")
plt.tight_layout(); plt.show()
text
  ✓  연습 4.1: 감마의 ∇A = (ψ(α) + log β, αβ)
  ✓  연습 4.1: 감마의 정보 행렬 (α, β) = Jᵀ ∇²A J (9회 연습 3.3)
  ✓  연습 4.4: ∇A = softmax, ∇²A = diag(p) − ppᵀ, 1 이 영공간에
  ✓  정리 4.6 · 연습 4.3: X̄ 의 분산 = λ/n (한계), (1−1/n)^T 의 분산 > λe^{−2λ}/n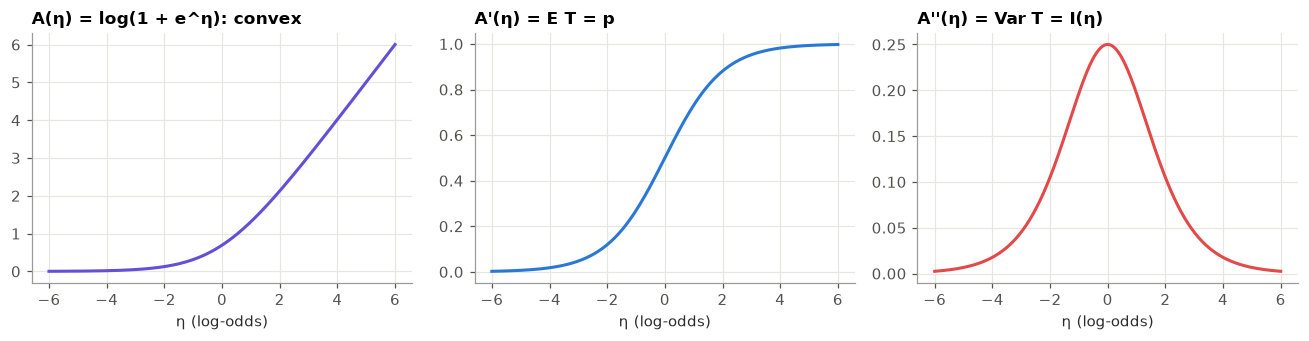
그림 읽기. Bernoulli의 로그분배함수 하나에서 평균(로지스틱 함수)과 분산·정보()가 미분으로 나온다. 정보는 로그 오즈가 0일 때(동전이 공정할 때) 가장 크다. 확률이 0이나 1에 가까우면 한 번의 관측이 로그 오즈에 대해 알려 주는 것이 적다.
📝 연습 4.1–4.4 (강의노트): 감마의 로그분배함수, Poisson의 누적량, 한계에 닿는 함수, softmax.
5. 보조통계량과 Basu의 정리
정의 5.1 분포가 와 무관한 통계량 · 정리 5.2 (Basu 1955) 완비충분 보조 · 예제 5.3 (6회 정리 2.2(b)의 재증명) · 예제 5.4 Fisher의 1920년 관찰 · 예제 5.5 감마와 균등.
독립성을 상관계수 하나로 판정하면 부족하다. 두 통계량을 각각 사분위로 나눈 분할표의 독립성 검정(8회 따름정리 5.2)으로 본다.
python
def independent(a, b, bins=4):
    """사분위로 나눈 분할표의 χ² 독립성 검정 p-값 (8회 따름정리 5.2)"""
    qa = np.quantile(a, np.linspace(0, 1, bins + 1)[1:-1]); qb = np.quantile(b, np.linspace(0, 1, bins + 1)[1:-1])
    tab = pd.crosstab(np.digitize(a, qa), np.digitize(b, qb)).to_numpy()
    return stats.chi2_contingency(tab)[1]

n, R = 10, 40_000
Xn = rng.normal(5, 2, (R, n)); Xe = rng.exponential(2, (R, n)); Xu = rng.uniform(0, 3, (R, n)); X0 = rng.normal(0, 2, (R, n))
d0, s0 = np.abs(X0).mean(1), np.sqrt((X0**2).mean(1))                 # μ = 0 을 알 때의 평균편차와 RMS
pv = {
    "예제 5.3: 정규 X̄ ⊥ S²": independent(Xn.mean(1), Xn.var(1, ddof=1)),
    "예제 5.4: Fisher 1920 — 정규(μ=0) 에서 d/s ⊥ s": independent(d0 / s0, s0),
    "예제 5.5 (a): 지수 ΣX ⊥ X1/ΣX": independent(Xe.sum(1), Xe[:, 0] / Xe.sum(1)),
    "예제 5.5 (b): 균등 X_(n) ⊥ X_(1)/X_(n)": independent(Xu.max(1), Xu.min(1) / Xu.max(1)),
}
dep = independent(Xe.mean(1), Xe.var(1, ddof=1))                       # 지수: X̄ 와 S² 는 독립이 아니다
print({k: round(float(v), 3) for k, v in pv.items()}, f"\n지수 표본의 X̄ 와 S²: p = {dep:.1e}, 상관 {np.corrcoef(Xe.mean(1), Xe.var(1, ddof=1))[0, 1]:.2f}")
# 연습 5.1 · 5.2: Basu 로 기댓값의 비를 계산
r_u = (Xu.min(1) / Xu.max(1)).mean(); r_e = (Xe.min(1) / Xe.sum(1)).mean()
report({**{k + " (χ² p > 0.001)": v > 0.001 for k, v in pv.items()},
        "주의: 지수 표본에서는 X̄ 와 S² 가 강하게 의존 (p < 1e-10)": dep < 1e-10,
        "연습 5.1: E[X_(1)/X_(n)] = 1/n": within(r_u, 1 / n, (Xu.min(1) / Xu.max(1)).std() / math.sqrt(R)),
        "연습 5.2: E[X_(1)/ΣX] = 1/n² (지수)": within(r_e, 1 / n**2, (Xe.min(1) / Xe.sum(1)).std() / math.sqrt(R))})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
for ax, Xs, title, col in [(axes[0], Xn[:2000], "normal: X̄ ⊥ S² (Basu)", C["stat"]), (axes[1], Xe[:2000], "exponential: dependent", C["key"])]:
    ax.scatter(Xs.mean(1), Xs.var(1, ddof=1), s=4, alpha=0.4, color=col)
    ax.set_xlabel("X̄"); ax.set_ylabel("S²"); ax.set_title(title)
plt.tight_layout(); plt.show()
text
{'예제 5.3: 정규 X̄ ⊥ S²': 0.605, '예제 5.4: Fisher 1920 — 정규(μ=0) 에서 d/s ⊥ s': 0.2, '예제 5.5 (a): 지수 ΣX ⊥ X1/ΣX': 0.824, '예제 5.5 (b): 균등 X_(n) ⊥ X_(1)/X_(n)': 0.443}text
지수 표본의 X̄ 와 S²: p = 0.0e+00, 상관 0.70text
  ✓  예제 5.3: 정규 X̄ ⊥ S² (χ² p > 0.001)
  ✓  예제 5.4: Fisher 1920 — 정규(μ=0) 에서 d/s ⊥ s (χ² p > 0.001)
  ✓  예제 5.5 (a): 지수 ΣX ⊥ X1/ΣX (χ² p > 0.001)
  ✓  예제 5.5 (b): 균등 X_(n) ⊥ X_(1)/X_(n) (χ² p > 0.001)
  ✓  주의: 지수 표본에서는 X̄ 와 S² 가 강하게 의존 (p < 1e-10)
  ✓  연습 5.1: E[X_(1)/X_(n)] = 1/n
  ✓  연습 5.2: E[X_(1)/ΣX] = 1/n² (지수)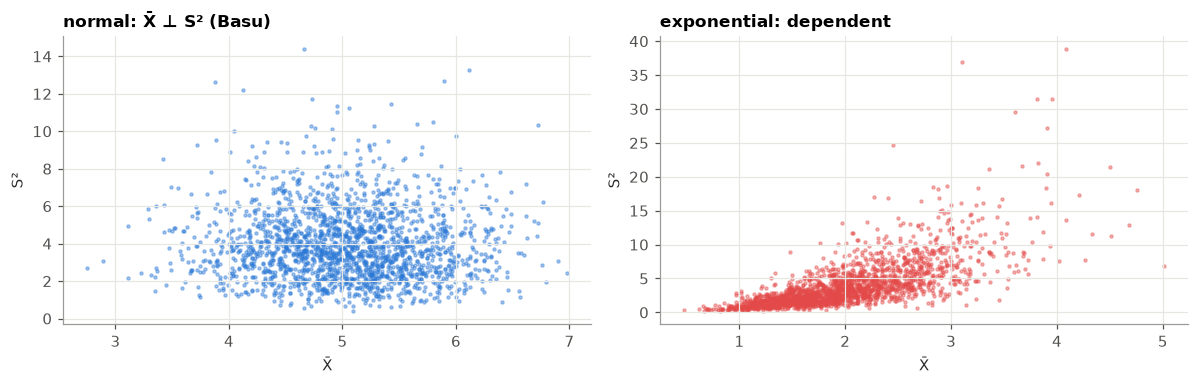
그림 읽기. 정규 표본의 구름은 어느 쪽으로도 기울지 않는다. 지수분포 표본은 평균이 크면 분산도 크다. 지수분포에서 는 척도의 완비충분통계량이지만 은 보조가 아니다(척도에 따라 변한다). Basu를 쓰려면 처럼 척도에 불변인 양을 써야 한다.
📝 연습 5.1–5.3 (강의노트): 균등분포의 비, 지수분포의 간격, 정규의 표준화된 잔차.
6. 데이터로 — Fisher의 계산과 Newcomb의 빛
명제 6.1 정규에서 평균편차의 효율 · 예제 6.2 Newcomb(1882): 큰 오차 두 개 · 예제 6.3 기병대의 세 추정량.
python
# 명제 6.1 · 연습 6.1: 1920 년의 계산 — log s 와 log d 의 분산의 비
n = 100
Z = rng.standard_normal((100_000, n))
ls = np.log(Z.std(1, ddof=1)); ld = np.log(np.abs(Z - Z.mean(1, keepdims=True)).mean(1))
ratio_sim = ls.var() / ld.var()
EabsZ = 2 * integrate.quad(lambda z: z * stats.norm.pdf(z), 0, np.inf)[0]          # 대칭이므로 양쪽의 두 배
VabsZ = 1 - EabsZ**2
print(f"시뮬레이션 (n = 100): 분산의 비 {ratio_sim:.4f};  극한 1/(π − 2) = {1 / (math.pi - 2):.4f};  n·Var(log d) = {n * ld.var():.3f} (π/2 − 1 = {math.pi / 2 - 1:.3f}), n·Var(log s) = {n * ls.var():.3f} (1/2)")
report({"연습 6.1: E|Z| = √(2/π), Var|Z| = 1 − 2/π, 비 π/2 − 1": abs(EabsZ - math.sqrt(2 / math.pi)) < 1e-10 and abs(VabsZ / EabsZ**2 - (math.pi / 2 - 1)) < 1e-10,
        "명제 6.1: 점근분산 π/2 − 1 과 1/2, 효율 0.876 (n = 100 에서 약 0.88)": abs(n * ld.var() / (math.pi / 2 - 1) - 1) < 0.03 and abs(n * ls.var() / 0.5 - 1) < 0.03 and abs(ratio_sim - 0.876) < 0.01})
text
시뮬레이션 (n = 100): 분산의 비 0.8799;  극한 1/(π − 2) = 0.8760;  n·Var(log d) = 0.578 (π/2 − 1 = 0.571), n·Var(log s) = 0.509 (1/2)
  ✓  연습 6.1: E|Z| = √(2/π), Var|Z| = 1 − 2/π, 비 π/2 − 1
  ✓  명제 6.1: 점근분산 π/2 − 1 과 1/2, 효율 0.876 (n = 100 에서 약 0.88)
python
# 예제 6.2 · 연습 6.3: Newcomb 의 66 번 — 큰 오차 두 개가 표준편차를 두 배로
nw = load_rdata("newcomb", "MASS").dat.to_numpy(float)
c_md = math.sqrt(math.pi / 2)
def scale_pair(x):
    return x.std(ddof=1), c_md * np.abs(x - x.mean()).mean()
s_all, d_all = scale_pair(nw); keep = nw > 0; s_64, d_64 = scale_pair(nw[keep])
def boot_ratio(x, B=20_000, gen=np.random.default_rng(1882)):
    idx = gen.integers(0, len(x), (B, len(x))); bs = x[idx]
    return np.log(bs.std(1, ddof=1)).var() / np.log(np.abs(bs - bs.mean(1, keepdims=True)).mean(1)).var()
br_all, br_64 = boot_ratio(nw), boot_ratio(nw[keep])
ss = np.sum((nw - nw.mean()) ** 2); share = np.sum((nw[~keep] - nw.mean()) ** 2) / ss
print(f"n = {len(nw)}: 평균 {nw.mean():.2f}, 중앙값 {np.median(nw):.0f}, 가장 작은 값 {np.sort(nw)[:3]}")
print(f"표준편차 {s_all:.2f} → {s_64:.2f} (두 값을 빼면),  √(π/2)·d {d_all:.2f} → {d_64:.2f};  부트스트랩 Var(log s)/Var(log d) {br_all:.2f} → {br_64:.2f};  두 값이 제곱합의 {share:.0%}")
report({"예제 6.2: 표준편차 10.75 → 5.08, √(π/2)·d 6.80 → 4.90": np.allclose([s_all, s_64, d_all, d_64], [10.75, 5.08, 6.80, 4.90], atol=0.005),
        "예제 6.2 · 연습 6.3: 부트스트랩 비 2.48 (평균편차가 안정) → 0.78 (정규 이론 쪽)": abs(br_all - 2.48) < 0.05 and abs(br_64 - 0.78) < 0.05,
        "연습 6.3: −44 와 −2 두 값이 제곱합의 76%": abs(share - 0.76) < 0.01})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
axes[0].hist(nw, bins=np.arange(-46, 42, 2), color=C["data"], alpha=0.6, edgecolor="white")
axes[0].set_xlabel("passage time − 24,800 ns"); axes[0].set_title("Newcomb 1882: two wild observations")
gen = np.random.default_rng(7); idx = gen.integers(0, len(nw), (20_000, len(nw))); bs = nw[idx]
axes[1].hist(np.log(bs.std(1, ddof=1)), bins=60, density=True, histtype="step", color=C["stat"], label="log s")
axes[1].hist(np.log(np.abs(bs - bs.mean(1, keepdims=True)).mean(1)), bins=60, density=True, histtype="step", color=C["key"], label="log d")
axes[1].set_title("bootstrap: s jumps with the outliers"); axes[1].legend()
plt.tight_layout(); plt.show()
text
n = 66: 평균 26.21, 중앙값 27, 가장 작은 값 [-44.  -2.  16.]
표준편차 10.75 → 5.08 (두 값을 빼면),  √(π/2)·d 6.80 → 4.90;  부트스트랩 Var(log s)/Var(log d) 2.48 → 0.78;  두 값이 제곱합의 76%
  ✓  예제 6.2: 표준편차 10.75 → 5.08, √(π/2)·d 6.80 → 4.90
  ✓  예제 6.2 · 연습 6.3: 부트스트랩 비 2.48 (평균편차가 안정) → 0.78 (정규 이론 쪽)
  ✓  연습 6.3: −44 와 −2 두 값이 제곱합의 76%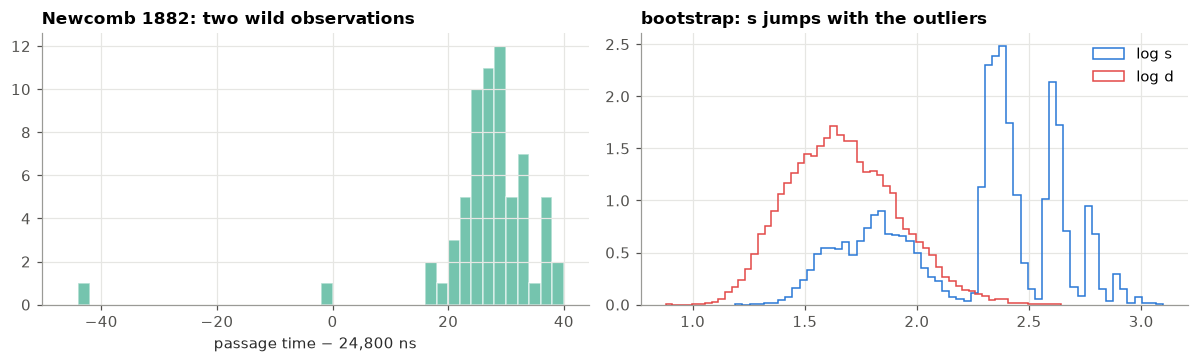
python
# 예제 6.3: 기병대의 세 추정량과 표준오차
lam_hat = T_ALL / N_ALL
p_obs = np.mean(vb.deaths == 0)
est = dict(UMVUE=(1 - 1 / N_ALL) ** T_ALL, MLE=math.exp(-lam_hat), observed=p_obs)
se = dict(UMVUE=math.sqrt(math.exp(-2 * lam_hat) * (math.exp(lam_hat / N_ALL) - 1)), observed=math.sqrt(p_obs * (1 - p_obs) / N_ALL))
print({k: round(v, 4) for k, v in est.items()}, {k: round(v, 3) for k, v in se.items()})
report({"예제 6.3: 0.4960, 0.4966, 0.514": np.allclose(list(est.values()), [0.4960, 0.4966, 0.514], atol=5e-4),
        "예제 6.3: 표준오차 — 관측 비율 0.030, UMVUE 0.025; 차이 0.018 은 표준오차보다 작다": abs(se["observed"] - 0.030) < 5e-4 and abs(se["UMVUE"] - 0.025) < 5e-4 and p_obs - est["UMVUE"] < se["observed"]})
text
{'UMVUE': 0.496, 'MLE': 0.4966, 'observed': np.float64(0.5143)} {'UMVUE': 0.025, 'observed': 0.03}
  ✓  예제 6.3: 0.4960, 0.4966, 0.514
  ✓  예제 6.3: 표준오차 — 관측 비율 0.030, UMVUE 0.025; 차이 0.018 은 표준오차보다 작다
📝 연습 6.1–6.3 (강의노트): 평균편차의 적률, Laplace 오차에서는, Newcomb의 부트스트랩.
7. 부숴보기 — 큰 오차와 터무니없는 UMVUE
명제 7.1 (Tukey 1960) 오염 정규 에서 이면 평균편차가 이긴다 · 예제 7.2 의 UMVUE · 7.3절 의 불편추정량은 없다.
python
# 명제 7.1 · 연습 6.2 · 7.1: 대칭분포에서 log s 대 log d 의 점근 효율 — 적률만으로
def are_md_sd(m2, m4, nu1):
    return ((m4 / m2**2 - 1) / 4) / (m2 / nu1**2 - 1)

def contaminated(eps, k=3.0):
    return dict(m2=1 + (k * k - 1) * eps, m4=3 * ((1 - eps) + eps * k**4), nu1=math.sqrt(2 / math.pi) * ((1 - eps) + eps * k))

table = {eps: are_md_sd(**contaminated(eps)) for eps in (0, 0.001, 0.002, 0.01, 0.05, 0.1)}
eps_star = optimize.brentq(lambda e: are_md_sd(**contaminated(e)) - 1, 1e-5, 0.1)
grid = np.logspace(-4, 0, 2000); vals = [are_md_sd(**contaminated(e)) for e in grid]
# 시뮬레이션으로도: ε = 0.05, n = 200
g = np.random.default_rng(1960); n, R = 200, 40_000
Zc = np.where(g.random((R, n)) < 0.05, 3, 1) * g.standard_normal((R, n))
sim = np.log(Zc.std(1, ddof=1)).var() / np.log(np.abs(Zc - Zc.mean(1, keepdims=True)).mean(1)).var()
laplace = are_md_sd(m2=2.0, m4=24.0, nu1=1.0)                         # b = 1: EX² = 2, EX⁴ = 24, E|X| = 1
print({k: round(v, 3) for k, v in table.items()}, f"  ε* = {eps_star:.4f};  최대 {max(vals):.3f} (ε = {grid[np.argmax(vals)]:.3f});  시뮬레이션 (ε = 0.05) {sim:.2f};  Laplace {laplace:.2f}")
report({"명제 7.1: 표 0.876, 0.948, 1.016, 1.439, 2.035, 1.903": np.allclose(list(table.values()), [0.876, 0.948, 1.016, 1.439, 2.035, 1.903], atol=5e-4),
        "명제 7.1 · 연습 7.1: ε = 0.0018 에서 1 을 넘는다, 최대는 ε ≈ 0.05 근처": abs(eps_star - 0.00175) < 1e-4 and 0.03 < grid[np.argmax(vals)] < 0.08,
        "명제 7.1: 시뮬레이션 (ε = 0.05, n = 200) 1.9 — 극한 2.04 보다 조금 작지만 1 을 크게 넘는다": abs(sim - 2.035) < 0.15 and sim > 1.5,
        "연습 6.2: Laplace 오차에서 평균편차의 효율 1.25": abs(laplace - 1.25) < 1e-12})
text
{0: 0.876, 0.001: 0.948, 0.002: 1.016, 0.01: 1.439, 0.05: 2.035, 0.1: 1.903}   ε* = 0.0018;  최대 2.038 (ε = 0.055);  시뮬레이션 (ε = 0.05) 1.92;  Laplace 1.25
  ✓  명제 7.1: 표 0.876, 0.948, 1.016, 1.439, 2.035, 1.903
  ✓  명제 7.1 · 연습 7.1: ε = 0.0018 에서 1 을 넘는다, 최대는 ε ≈ 0.05 근처
  ✓  명제 7.1: 시뮬레이션 (ε = 0.05, n = 200) 1.9 — 극한 2.04 보다 조금 작지만 1 을 크게 넘는다
  ✓  연습 6.2: Laplace 오차에서 평균편차의 효율 1.25
python
# 예제 7.2 · 연습 7.2 · 7.3: 터무니없는 UMVUE, 그리고 불편추정량이 없는 경우
kk = np.arange(0, 150)
def mse_pair(lam):
    p = stats.poisson.pmf(kk, lam); tau = math.exp(-2 * lam)
    return np.sum(p * ((-1.0) ** kk - tau) ** 2), np.sum(p * (np.exp(-2 * kk) - tau) ** 2)
unbiased = all(abs(np.sum(stats.poisson.pmf(kk, l) * (-1.0) ** kk) - math.exp(-2 * l)) < 1e-12 for l in (0.3, 0.7, 2.0))
mu, mm = mse_pair(0.7)
# 연습 7.2: n 개이면 (1 − 2/n)^T, n = 2 이면 1{T = 0}
n_ok = all(abs(np.sum(stats.poisson.pmf(kk, n * 0.7) * (1 - 2 / n) ** kk) - math.exp(-1.4)) < 1e-12 for n in (1, 2, 3, 10))
# 연습 7.3: 이항의 E g(K) 는 p 의 n 차 다항식 — 무작위 g 로 만든 평균이 정확히 다항식으로 맞춰진다
n = 6; g_ = rng.normal(size=n + 1)
ps = np.linspace(0.01, 0.99, 50)
Eg = np.array([np.sum(g_ * stats.binom.pmf(np.arange(n + 1), n, p)) for p in ps])
coef = np.polyfit(ps, Eg, n)
poly_exact = np.max(np.abs(np.polyval(coef, ps) - Eg)) < 1e-10
print(f"λ = 0.7: UMVUE (−1)^X 의 평균제곱오차 {mu:.3f} (1 − e^(−4λ) = {1 - math.exp(-2.8):.3f}),  MLE e^(−2X) {mm:.3f}")
report({"예제 7.2: (−1)^X 는 e^{−2λ} 의 불편추정량": unbiased,
        "예제 7.2: 평균제곱오차 0.94 대 0.29": abs(mu - 0.939) < 5e-4 and abs(mm - 0.295) < 5e-4,
        "연습 7.2: n 개이면 (1 − 2/n)^T 가 불편 (n = 1, 2, 3, 10)": n_ok,
        "연습 7.3: 이항의 E g(K) 는 p 의 n 차 다항식 (그래서 1/p 는 불편추정할 수 없다)": poly_exact})

lams = np.linspace(0.01, 3, 200); mses = np.array([mse_pair(l) for l in lams])
fig, ax = plt.subplots(figsize=(8, 3.2))
ax.plot(lams, mses[:, 0], color=C["key"], label="UMVUE (−1)^X"); ax.plot(lams, mses[:, 1], color=C["stat"], label="MLE e^(−2X)")
ax.set_xlabel("λ"); ax.set_title("estimating e^(−2λ) from one Poisson count: mean squared error"); ax.legend()
plt.tight_layout(); plt.show()
text
λ = 0.7: UMVUE (−1)^X 의 평균제곱오차 0.939 (1 − e^(−4λ) = 0.939),  MLE e^(−2X) 0.295
  ✓  예제 7.2: (−1)^X 는 e^{−2λ} 의 불편추정량
  ✓  예제 7.2: 평균제곱오차 0.94 대 0.29
  ✓  연습 7.2: n 개이면 (1 − 2/n)^T 가 불편 (n = 1, 2, 3, 10)
  ✓  연습 7.3: 이항의 E g(K) 는 p 의 n 차 다항식 (그래서 1/p 는 불편추정할 수 없다)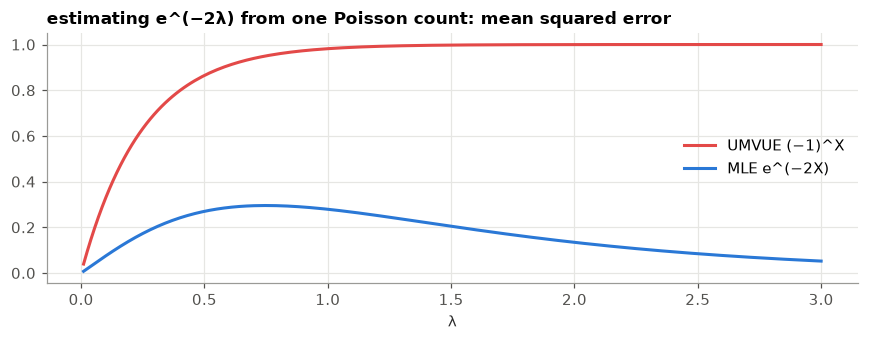
📝 연습 7.1–7.3 (강의노트): 오염 정규의 효율, 관측이 개이면, 불편추정량이 없다.
8. Beautiful insights — 조건부 Monte Carlo와 softmax
8.1절 Rao–Blackwell화 = 분산 줄이기 · 8.2절 softmax , 교차엔트로피의 기울기 · 8.3절 충분통계량은 더해진다.
python
# 8.1절 · 연습 8.1: 조건부 Monte Carlo — P(Z1 + Z2 > 3)
truth = stats.norm.sf(3 / math.sqrt(2))
Z = rng.standard_normal((1_000_000, 2))
naive = (Z.sum(1) > 3).astype(float); cmc = stats.norm.sf(3 - Z[:, 0])
vr = naive.var() / cmc.var()
print(f"참값 {truth:.5f};  지시함수 평균 {naive.mean():.5f}, 조건부 평균 {cmc.mean():.5f};  분산의 비 {vr:.1f}")
# 8.2절 · 연습 8.2: 교차엔트로피의 logit 기울기 = softmax − 원-핫
eta = np.array([1.0, 0.0, -1.0]); y = 1                                  # 정답은 둘째 범주 (0부터 세면 1)
ce = lambda e: special.logsumexp(e) - e[y]
grad_num = optimize.approx_fprime(eta, ce, 1e-7)
grad_th = special.softmax(eta) - np.eye(3)[y]
report({"8.1절: 조건부 Monte Carlo 는 불편이고 분산이 약 7분의 1": within(cmc.mean(), truth, cmc.std() / 1000) and within(naive.mean(), truth, naive.std() / 1000) and abs(vr - 6.9) < 0.3,
        "연습 8.2: 교차엔트로피의 기울기 = p − e_y = (0.665, −0.755, 0.090), 성분의 합 0": np.allclose(grad_num, grad_th, atol=1e-6) and np.allclose(grad_th, [0.665, -0.755, 0.090], atol=5e-4) and abs(grad_th.sum()) < 1e-12})
text
참값 0.01695;  지시함수 평균 0.01701, 조건부 평균 0.01697;  분산의 비 7.0
  ✓  8.1절: 조건부 Monte Carlo 는 불편이고 분산이 약 7분의 1
  ✓  연습 8.2: 교차엔트로피의 기울기 = p − e_y = (0.665, −0.755, 0.090), 성분의 합 0
python
# 8.3절: 충분통계량은 더해진다 — 자료를 10 개의 기기에 나눠 요약만 모아도 MLE 가 같다
x_all = rng.gamma(2.0, 1.5, 50_000)
shards = np.array_split(x_all, 10)
summaries = [(len(s), s.sum(), np.log(s).sum()) for s in shards]           # 기기마다 (n, Σx, Σ log x) 만 보낸다
n_tot = sum(s[0] for s in summaries); S1 = sum(s[1] for s in summaries); S2 = sum(s[2] for s in summaries)
def gamma_mle_from_sums(n, sx, slogx):
    """9회 예제 4.4 의 방정식 log α − ψ(α) = log x̄ − mean(log x) 를 요약만으로"""
    s = math.log(sx / n) - slogx / n
    a = (3 - s + math.sqrt((s - 3) ** 2 + 24 * s)) / (12 * s)
    for _ in range(30):
        a -= (math.log(a) - special.digamma(a) - s) / (1 / a - special.polygamma(1, a))
    return a, sx / n / a
a_fed, b_fed = gamma_mle_from_sums(n_tot, S1, S2)
a_sp, _, b_sp = stats.gamma.fit(x_all, floc=0)
print(f"요약을 더한 MLE: α = {a_fed:.5f}, β = {b_fed:.5f};  전체 자료로 scipy: α = {a_sp:.5f}, β = {b_sp:.5f}")
report({"8.3절: 기기별 충분통계량의 합만으로 전체 자료의 MLE 를 그대로 얻는다": abs(a_fed - a_sp) < 1e-4 and abs(b_fed - b_sp) < 1e-4})
text
요약을 더한 MLE: α = 1.99821, β = 1.51291;  전체 자료로 scipy: α = 1.99821, β = 1.51291
  ✓  8.3절: 기기별 충분통계량의 합만으로 전체 자료의 MLE 를 그대로 얻는다
📝 연습 8.1–8.2 (강의노트): 조건부 Monte Carlo, 교차엔트로피의 기울기.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 충분성 (1.1–1.7) | 조건부분포가 를 잊는다(Bernoulli·Poisson), 가능도비의 판정(정규·Cauchy), 통계량의 정보 | 1절 |
| Rao–Blackwell (2.1–2.4) | (분산 28분의 1, 기병대 0.4960), 독일 전차 (77 → 50), , 정규 꼬리확률 | 2절 |
| 완비성 (3.1–3.4) | 전차의 하삼각 연립방정식, Poisson 두 점의 반례, UMVUE들의 불편성, MLE와의 평균제곱오차 (λ ≈ 0.83에서 뒤집힘) | 3절 |
| 지수족 (4.1–4.6) | ExpFamily: = 평균, = 공분산, 적률 맞추기 MLE, softmax, 감마의 정보 행렬 |
4절 |
| Basu (5.1–5.5) | 분할표 로 독립성, , 지수 표본의 반례, 기댓값의 비 | 5절 |
| 데이터 (6) | 효율 0.876, Newcomb의 큰 오차 두 개(부트스트랩 비 2.48 → 0.78), 기병대의 세 추정량 | 6절 |
| 부숴보기 (7) | Tukey의 , , | 7절 |
| 오늘 (8) | 조건부 Monte Carlo (분산 7분의 1), 교차엔트로피의 기울기, 충분통계량의 합 | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 충분성 | 1.1 ★ · 1.2 인수분해 ★ · 1.3 이동한 균등 ★★ · 1.4 Cauchy ★★ · 1.5 부호의 정보 ★★ · 1.6 통계량의 정보 증명 ★★ (유도형) | 1절 |
| 2 Rao–Blackwell | 2.1 분산 ★★ · 2.2 전차 ★★ · 2.3 정규 꼬리 ★★ · 2.4 볼록 손실 ★★ | 2절 |
| 3 완비성 | 3.1 Poisson ★★ · 3.2 균등 ★★ · 3.3 전차의 완비성 ★★★ · 3.4 Bernoulli ★ | 3절 |
| 4 지수족 | 4.1 감마 ★ · 4.2 누적량 ★ · 4.3 한계에 닿는 함수 ★★ · 4.4 softmax ★★ · 4.5 지수족의 가능도 증명 ★ · 4.6 Cramér–Rao의 등호 증명 ★★ (유도형) | 4절 |
| 5 Basu | 5.1 ★ · 5.2 지수의 간격 ★★ · 5.3 표준화된 잔차 ★★ | 5절 |
| 6 데이터 | 6.1 ★ · 6.2 Laplace ★★ · 6.3 Newcomb ★ · 6.4 평균편차의 효율 증명 ★★ (유도형) | 6–7절 |
| 7 부숴보기 | 7.1 오염 정규 ★★ · 7.2 개이면 ★★ · 7.3 불편추정량이 없다 ★★ · 7.4 오염 정규의 효율 증명 ★★ (유도형) | 7절 |
| 8 오늘 | 8.1 조건부 MC ★ · 8.2 교차엔트로피 ★ | 8절 |
다음 회 (12회) — 최적 검정과 결정 (1928 → 1956). 이번 회차는 가장 좋은 추정량을 찾았다. 12회는 가장 좋은 검정을 찾는다. Neyman–Pearson 보조정리(1933)는 크기를 고정하고 검정력을 최대화하는 검정이 가능도비로 기각하는 검정임을 보인다. 지수족처럼 가능도비가 충분통계량에 대해 단조이면 그 검정이 모든 대립가설에서 동시에 최선이 된다(Karlin–Rubin). Fisher와 Neyman의 평생의 논쟁, Wald의 축차검정과 결정이론이 그 위에 섰다.
10. 워크북 검산
워크북(11_sufficiency_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A3a", "2/15")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(2/15,0.1333)나 식의 문자열("1/(exp(lam)-1)")로 넣는다. 소문항은"A2b"처럼 번호 뒤에 붙인다. 는lam으로 쓴다(lambda는 파이썬의 예약어다). 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 조건부확률과 기댓값이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A3a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A3a A3b A4a A4b A5a A5b A6a A6b A6c A7a A7b A8 A9 A10a A10b A10c A11a A11b A12 A13 A14a A14b C3d D1c D1d D2b D2d D2e D3c D3d D4d
A3a: 아직 답을 넣지 않았다. 예: check('A3a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None,
    "A4a": None, "A4b": None, "A5a": None, "A5b": None, "A6a": None, "A6b": None, "A6c": None,
    "A7a": None, "A7b": None, "A8": None, "A9": None, "A10a": None, "A10b": None, "A10c": None,
    "A11a": None, "A11b": None, "A12": None, "A13": None, "A14a": None, "A14b": None,
    "C3d": None,
    "D1c": None, "D1d": None, "D2b": None, "D2d": None, "D2e": None, "D3c": None, "D3d": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 조건부확률은 조건 사건이 일어난 표본만 남겨서 잰다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A1b() |
A1(b) Poisson의 조건부분포 | , 인 표본만 남긴다 |
sim_A2a() |
A2(a) 의 UMVUE 값 | , 인 표본만 남긴다 |
sim_A5a() |
A5(a) 전차의 Rao–Blackwell화 | , , 인 표본만 남긴다 |
sim_A8() |
A8 지수 표본의 | 지수분포 |
sim_A9() |
A9 균등 표본의 | 균등분포 |
sim_D2d() |
D2(d) | , 인 표본만 남긴다 |
python
def _cond_mean(values, keep):
    v = values[keep]
    return v.mean(), v.std(ddof=1) / np.sqrt(len(v))


def sim_A1b(n_rep=400_000, lam=1.2):
    x = rng.poisson(lam, size=(n_rep, 3))
    keep = x.sum(axis=1) == 4
    hit = (x[:, 0] == 2) & (x[:, 1] == 1) & (x[:, 2] == 1)
    return _cond_mean(hit.astype(float), keep)


def sim_A2a(n_rep=400_000, lam=1.5):
    x = rng.poisson(lam, size=(n_rep, 4))
    keep = x.sum(axis=1) == 6
    return _cond_mean((x[:, 0] == 0).astype(float), keep)


def sim_A5a(n_rep=100_000, N=70, k=4):
    serial = rng.random((n_rep, N)).argsort(axis=1)[:, :k] + 1
    keep = serial.max(axis=1) == 60
    return _cond_mean(2 * serial.mean(axis=1) - 1, keep)


def sim_A8(n_rep=400_000):
    x = rng.exponential(2.0, size=(n_rep, 4))
    r = x.max(axis=1) / x.sum(axis=1)
    return r.mean(), r.std(ddof=1) / np.sqrt(n_rep)


def sim_A9(n_rep=400_000):
    x = np.sort(rng.random((n_rep, 5)), axis=1)
    r = x[:, 1] / x[:, 4]
    return r.mean(), r.std(ddof=1) / np.sqrt(n_rep)


def sim_D2d(n_rep=400_000, lam=0.7):
    x = rng.poisson(lam, size=(n_rep, 10))
    keep = x.sum(axis=1) == 7
    return _cond_mean((x[:, 0] == 1).astype(float), keep)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A1b(), "A1b")
assert _close(sim_A2a(), "A2a")
assert _close(sim_A5a(), "A5a")
assert _close(sim_A8(), "A8")
assert _close(sim_A9(), "A9")
assert _close(sim_D2d(), "D2d")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))