Skip to content

11회 · 충분성 · 노트

1 충분통계량 ​

역사 Fisher(1922)는 통계학의 수학적 기초에서 통계량이 “자료가 모수에 대해 주는 정보를 모두 담으면” 충분하다고 정의했다. 그가 쓴 판정법은 “통계량을 알면 자료의 나머지 조건부분포가 모수와 무관하다”였다. 이것을 가능도의 모양으로 바꾼 인수분해 정리는 Fisher가 예에서 쓰던 것을 Neyman(1935)이 일반적으로 증명했고, Halmos와 Savage(1949)가 측도론의 언어로 완성했다.

1.1 정의와 인수분해 정리 ​

정의 1.1 (충분통계량) 통계량 T=T(X)T=T(\X)가 주어질 때 X\X의 조건부분포가 θ\theta에 의존하지 않으면 TT를 θ\theta의 충분통계량이라 한다.

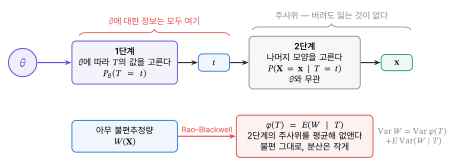
정의는 자료를 두 단계로 만들어 보면 읽힌다. 자연은 먼저 θ\theta에 따라 TT의 값을 고른다. 그 다음 X\X의 나머지 모양은 θ\theta와 무관한 확률로, 마치 주사위를 굴리듯 정해진다. 두 번째 단계는 θ\theta에 대해 아무것도 알려 주지 않으므로, TT만 보관하고 나머지를 버려도 잃는 것이 없다(그림 1.1).

그림 1.1. 충분성의 그림. 자료를 두 단계로 만든다. 1단계에서 θ가 T의 값을 정하고, 2단계는 θ와 무관한 주사위로 나머지 모양을 정한다. 아래: Rao–Blackwell(2절)은 2단계의 주사위를 평균해 없애 분산을 줄인다.
그림 1.1 충분성의 그림. 자료를 두 단계로 만든다. 1단계에서 θ\theta가 TT의 값을 정하고, 2단계는 θ\theta와 무관한 주사위로 나머지 모양을 정한다. 아래: Rao–Blackwell(2절)은 2단계의 주사위를 평균해 없애 분산을 줄인다.

예제 1.2 (조건부분포가 모수를 잊는다) (a) Xi∼iidX_i\iid Bernoulli(p)(p), T=∑XiT=\sum X_i이면 P(X=x∣T=t)=pt(1−p)n−t(nt)pt(1−p)n−t=(nt)−1P(\X=\x\mid T=t)=\tfrac{p^t(1-p)^{n-t}}{\binom nt p^t(1-p)^{n-t}}=\binom nt^{-1}. 성공 tt번의 자리는 모든 배치가 같은 확률이다. (b) Xi∼iidX_i\iid Poisson(λ)(\lambda), T=∑XiT=\sum X_i이면 X∣T=t\X\mid T=t는 다항분포 M(t;1n,…,1n)\mathrm{M}(t;\tfrac1n,\allowbreak \dots,\allowbreak \tfrac1n)이다(연습 1.1). 사건 tt개가 nn칸에 고르게 무작위로 떨어진다. 어느 경우든 pp나 λ\lambda가 사라졌다.

정리 1.3 (인수분해 정리 (Neyman 1935)) T(X)T(\X)가 θ\theta의 충분통계량일 필요충분조건은 음이 아닌 함수 gg와 hh가 있어 모든 x\x와 θ\theta에 대해

f(x;θ)=g(T(x);θ) h(x)f(\x;\theta)=g\bigl(T(\x);\theta\bigr)\,h(\x)

인 것이다. hh는 θ\theta에 의존하지 않는다.

증명 전략 이산인 경우를 증명한다. (⇒\Rightarrow)는 결합확률을 “TT의 확률 × TT가 주어진 조건부확률”로 쪼개고, 두 인수를 gg와 hh로 삼는다. (⇐\Leftarrow)는 조건부확률을 직접 계산해 gg가 분자와 분모에서 약분됨을 보인다.

(⇒\Rightarrow)

  1. x\x를 고정하고 t=T(x)t=T(\x)라 하자. X=x\X=\x이면 T(X)=tT(\X)=t이므로 {X=x}⊂{T=t}\{\X=\x\}\subset\{T=t\}이다.TT는 X\X의 함수 [T1]

  2. Pθ(T=t)>0P_\theta(T=t)>0이면 다음이 성립한다.

    f(x;θ)=Pθ(X=x, T=t)=Pθ(T=t) Pθ(X=x∣T=t).f(\x;\theta)=P_\theta(\X=\x,\,T=t)=P_\theta(T=t)\,P_\theta(\X=\x\mid T=t) .
  3. 둘째 인수는 θ\theta에 의존하지 않는다. 그것을 h(x)=P(X=x∣T=T(x))h(\x)=P(\X=\x\mid T=T(\x))로 쓴다.충분성, 정의 1.1

  4. g(t;θ)=Pθ(T=t)g(t;\theta)=P_\theta(T=t)로 두면 f(x;θ)=g(T(x);θ) h(x)f(\x;\theta)=g(T(\x);\theta)\,h(\x)이다.2 3

(⇐\Leftarrow)

  1. T(x)=tT(\x)=t이고 Pθ(T=t)>0P_\theta(T=t)>0이라 하자. {T=t}\{T=t\}는 서로소인 사건 {X=y}\{\X=\y\}, T(y)=tT(\y)=t의 합집합이다.

    Pθ(T=t)=∑y: T(y)=tf(y;θ)=g(t;θ)∑y: T(y)=th(y).P_\theta(T=t)=\sum_{\y:\,T(\y)=t}f(\y;\theta)=g(t;\theta)\sum_{\y:\,T(\y)=t}h(\y) .
    가산가법성, 인수분해 가정
  2. 조건부확률을 계산한다.

    Pθ(X=x∣T=t)=f(x;θ)Pθ(T=t)=g(t;θ)h(x)g(t;θ)∑y: T(y)=th(y)=h(x)∑y: T(y)=th(y).P_\theta(\X=\x\mid T=t)=\frac{f(\x;\theta)}{P_\theta(T=t)}=\frac{g(t;\theta)h(\x)}{g(t;\theta)\sum_{\y:\,T(\y)=t}h(\y)}=\frac{h(\x)}{\sum_{\y:\,T(\y)=t}h(\y)} .
  3. 오른쪽에는 θ\theta가 없다. T(x)≠tT(\x)\ne t이면 조건부확률은 0이다. 따라서 T=tT=t가 주어진 X\X의 조건부분포는 θ\theta에 의존하지 않는다.정의 1.1

조건 확인 (⇐\Leftarrow)의 약분에는 g(t;θ)>0g(t;\theta)>0이 필요하다. Pθ(T=t)>0P_\theta(T=t)>0이면 1로 그렇다. (⇒\Rightarrow)에서 Pθ(T=t)=0P_\theta(T=t)=0이면 f(x;θ)=0f(\x;\theta)=0이므로 g(t;θ)=0g(t;\theta)=0으로 두면 된다. hh는 Pθ(T=t)>0P_\theta(T=t)>0인 어느 θ\theta로 계산해도 같은 값이다(충분성).

증명 없이 쓰는 사실 (연속인 경우) 밀도이면 {T=t}\{T=t\}의 확률이 0이므로 조건부분포를 정의하는 데 측도론이 필요하다. 그 언어로 같은 정리가 성립한다(Halmos–Savage 1949). 이 과정에서는 연속 모형에서도 인수분해를 충분성의 판정법으로 쓴다. 변수변환으로 직접 확인할 수 있는 경우가 많다(정규 표본은 6회의 Helmert 변환, 균등 표본은 8회의 순서통계량 밀도).

예제 1.4 (충분통계량 찾기) 

  1. (a)

    Poisson. f=∏e−λλxixi!=e−nλλ∑xi⋅1∏xi!f=\prod\tfrac{e^{-\lambda}\lambda^{x_i}}{x_i!}=e^{-n\lambda}\lambda^{\sum x_i}\cdot\tfrac1{\prod x_i!}이므로 T=∑XiT=\sum X_i.

  2. (b)

    정규. f=(2πσ2)−n/2exp⁡(−∑xi2−2μ∑xi+nμ22σ2)f=(2\pi\sigma^2)^{-n/2}\exp\bigl(-\tfrac{\sum x_i^2-2\mu\sum x_i+n\mu^2}{2\sigma^2}\bigr)이므로 (∑Xi,∑Xi2)(\sum X_i,\sum X_i^2), 같은 말로 (Xˉ,S2)(\bar X,S^2)가 (μ,σ2)(\mu,\sigma^2)의 충분통계량이다. μ\mu를 알면 ∑(Xi−μ)2\sum(X_i-\mu)^2 하나로 충분하다.

  3. (c)

    균등 U(0,θ)\mathrm U(0,\theta). f=θ−n1{x(n)≤θ}⋅1{x(1)≥0}f=\theta^{-n}1\{x_{(n)}\le\theta\}\cdot1\{x_{(1)}\ge0\}이므로 T=X(n)T=X_{(n)}. 8회의 독일 전차에서 최댓값이 모든 정보를 담는 이유다.

  4. (d)

    감마(α,β)(\alpha,\beta). f=Γ(α)−nβ−nα(∏xi)α−1e−∑xi/βf=\Gamma(\alpha)^{-n}\beta^{-n\alpha}\bigl(\prod x_i\bigr)^{\alpha-1}e^{-\sum x_i/\beta}이므로 (∑Xi, ∑log⁡Xi)(\sum X_i,\ \sum\log X_i). 9회 예제 4.4의 MLE가 이 두 수만 쓴 이유다.

1.2 최소충분통계량 ​

자료 전체 X\X는 언제나 충분하다. 쓸모 있는 것은 가장 많이 줄인 것이다.

정의 1.5 (최소충분통계량) 충분통계량 TT가 다른 모든 충분통계량 UU의 함수이면(U(x)=U(y)⇒T(x)=T(y)U(\x)=U(\y)\Rightarrow T(\x)=T(\y)) TT를 최소충분통계량이라 한다.

정리 1.6 (최소충분의 판정 (Lehmann–Scheffé 1950)) 모든 x,y\x,\y에 대해 “f(x;θ)/f(y;θ)f(\x;\theta)/f(\y;\theta)가 θ\theta에 의존하지 않는다   ⟺  T(x)=T(y)\iff T(\x)=T(\y)”이면 TT는 최소충분통계량이다. (받침은 θ\theta에 무관하다고 하고, 이산인 경우를 증명한다.)

증명 전략 충분성은 TT의 값마다 대표 표본을 하나 골라, 가능도를 “대표의 가능도 × 비”로 쓰고 인수분해 정리를 쓴다. 최소성은 다른 충분통계량 UU의 인수분해로 가능도비가 θ\theta에 무관함을 보이고 가정의 (⇒\Rightarrow) 방향을 쓴다.

충분성

  1. TT의 값 tt마다 받침 안에서 T(xt)=tT(\x_t)=t인 대표 xt\x_t를 하나 고른다.tt는 TT의 치역의 원소

  2. T(x)=T(xT(x))T(\x)=T(\x_{T(\x)})이므로 h(x)=f(x;θ)/f(xT(x);θ)h(\x)=f(\x;\theta)/f(\x_{T(\x)};\theta)는 θ\theta에 의존하지 않는다.가정의 (⇐\Leftarrow) 방향

  3. f(x;θ)=f(xT(x);θ) h(x)f(\x;\theta)=f(\x_{T(\x)};\theta)\,h(\x)이고, 앞 인수는 T(x)T(\x)와 θ\theta만의 함수다.2

  4. 따라서 TT는 충분통계량이다.정리 1.3

최소성

  1. UU가 충분통계량이고 U(x)=U(y)U(\x)=U(\y)라 하자. f(x;θ)=g(U(x);θ)h(x)f(\x;\theta)=g(U(\x);\theta)h(\x)로 쓸 수 있다.정리 1.3

  2. 가능도비에서 gg가 약분된다.

    f(x;θ)f(y;θ)=g(U(x);θ)h(x)g(U(y);θ)h(y)=h(x)h(y).\frac{f(\x;\theta)}{f(\y;\theta)}=\frac{g(U(\x);\theta)h(\x)}{g(U(\y);\theta)h(\y)}=\frac{h(\x)}{h(\y)} .
    1, U(x)=U(y)U(\x)=U(\y)
  3. 오른쪽은 θ\theta에 의존하지 않으므로 T(x)=T(y)T(\x)=T(\y)이다. 곧 TT는 UU의 함수다.가정의 (⇒\Rightarrow) 방향, 정의 1.5

조건 확인 가능도비는 분모가 0이 아닐 때 뜻이 있다. 받침이 θ\theta에 무관하다고 가정했으므로 받침 안의 x,y\x,\y에서는 모든 θ\theta에 대해 분모가 양수다. 그래서 1의 대표도 받침에서 고른다.

정규 표본에서 f(x;μ,σ2)f(y;μ,σ2)=exp⁡(−∑xi2−∑yi22σ2+μ(∑xi−∑yi)σ2)\tfrac{f(\x;\mu,\sigma^2)}{f(\y;\mu,\sigma^2)}=\exp\bigl(-\tfrac{\sum x_i^2-\sum y_i^2}{2\sigma^2}+\tfrac{\mu(\sum x_i-\sum y_i)}{\sigma^2}\bigr)이 모수에 무관할 필요충분조건은 ∑xi=∑yi\sum x_i=\sum y_i이고 ∑xi2=∑yi2\sum x_i^2=\sum y_i^2인 것이다. 그래서 (Xˉ,S2)(\bar X,S^2)는 최소충분이다. 반대로 Cauchy 위치모형에서는 순서통계량 전체가 최소충분이다(연습 1.4). 자료를 순서 말고는 하나도 줄일 수 없다. 9회에서 Cauchy의 MLE를 Newton으로 구해야 했던 이유다.

1.3 충분통계량은 정보를 보존한다 ​

명제 1.7 (통계량의 정보) 9회의 정칙조건 아래, 통계량 TT의 분포로 만든 Fisher 정보 IT(θ)I_T(\theta)는 자료 전체의 정보 IX(θ)=nI(θ)I_{\X}(\theta)=nI(\theta)보다 크지 않다. TT가 충분하면 등호가 성립한다.

증명 전략 TT의 점수가 자료 전체의 점수의 조건부기댓값임을 보이고, 전분산 공식(3회 정리 2.6)으로 분산을 비교한다. 충분하면 자료의 점수가 이미 TT의 함수다. 단계별 증명은 연습 1.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

Fisher에게 충분성은 처음부터 이 명제였다. 충분통계량은 정보를 하나도 잃지 않고, 다른 통계량은 정보를 잃는다. 1920년의 계산도 이 틀 안에 있다. 평균을 알 때 ∑Xi2\sum X_i^2는 σ\sigma의 충분통계량이고, 평균편차 1n∑∣Xi−μ∣\tfrac1n\sum|X_i-\mu|는 아니다. 큰 표본에서 평균편차가 담는 정보는 전체의 1π−2=0.876\tfrac1{\pi-2}=0.876이다(6절).

연습문제

연습 1.1 (Poisson의 조건부분포 ★) Xi∼iidPoi(λ)X_i\iid\mathrm{Poi}(\lambda)이면 X∣∑Xi=t∼M(t;1n,…,1n)\X\mid\sum X_i=t\sim\mathrm M(t;\tfrac1n,\allowbreak \dots,\allowbreak \tfrac1n)임을 보여라(4회 정리 2.4).

풀이

∑xi=t\sum x_i=t이면 P(X=x∣T=t)=∏e−λλxi/xi!e−nλ(nλ)t/t!=t!∏xi!(1n)tP(\X=\x\mid T=t)=\dfrac{\prod e^{-\lambda}\lambda^{x_i}/x_i!}{e^{-n\lambda}(n\lambda)^t/t!}=\dfrac{t!}{\prod x_i!}\Bigl(\dfrac1n\Bigr)^t (4회 정리 2.4로 T∼Poi(nλ)T\sim\mathrm{Poi}(n\lambda)). 이것이 M(t;1n,…,1n)\mathrm M(t;\tfrac1n,\allowbreak \dots,\allowbreak \tfrac1n)의 확률질량함수다.

연습 1.2 (인수분해 ★) 인수분해 정리로 충분통계량을 구하라. (a) 베타(a,b)(a,b), 두 모수 모두 미지. (b) 기하분포 P(X=x)=p(1−p)x−1P(X=x)=p(1-p)^{x-1}. (c) 지수분포를 cc에서 절단한 자료(10회 연습 2.3).

풀이

(a) ∏xia−1(1−xi)b−1B(a,b)\prod\tfrac{x_i^{a-1}(1-x_i)^{b-1}}{B(a,b)}이므로 (∑log⁡Xi, ∑log⁡(1−Xi))(\sum\log X_i,\allowbreak \ \sum\log(1-X_i)). (b) pn(1−p)∑xi−np^n(1-p)^{\sum x_i-n}이므로 ∑Xi\sum X_i. (c) θ−re−∑yi/θ\theta^{-r}e^{-\sum y_i/\theta}이므로 (절단되지 않은 수 rr, ∑yi\sum y_i)의 쌍.

연습 1.3 (이동한 균등분포 ★★) Xi∼iidU(θ,θ+1)X_i\iid\mathrm U(\theta,\allowbreak \theta+1)이면 (X(1),X(n))(X_{(1)},X_{(n)})이 최소충분임을 보여라. 모수는 하나인데 최소충분통계량은 2차원이다.

풀이

f(x;θ)=1{x(n)−1≤θ≤x(1)}f(\x;\theta)=1\{x_{(n)}-1\le\theta\le x_{(1)}\}이다. 비 f(x;θ)/f(y;θ)f(\x;\theta)/f(\y;\theta)가 θ\theta에 무관하려면(0/0을 제외한 뜻에서) 두 구간 [x(n)−1,x(1)][x_{(n)}-1,x_{(1)}]과 [y(n)−1,y(1)][y_{(n)}-1,y_{(1)}]이 같아야 하고, 그것은 (x(1),x(n))=(y(1),y(n))(x_{(1)},\allowbreak x_{(n)})=(y_{(1)},\allowbreak y_{(n)})과 같다. 정리 1.6로 최소충분이다.

연습 1.4 (Cauchy의 순서통계량 ★★) Cauchy 위치모형에서 f(x;θ)f(y;θ)=∏1+(yi−θ)21+(xi−θ)2\tfrac{f(\x;\theta)}{f(\y;\theta)}=\prod\tfrac{1+(y_i-\theta)^2}{1+(x_i-\theta)^2}가 θ\theta에 무관하면 x\x와 y\y가 순서만 다름을 보여라. (두 다항식의 근을 비교하라.)

풀이

비가 상수 cc이면 ∏(1+(yi−θ)2)=c∏(1+(xi−θ)2)\prod(1+(y_i-\theta)^2)=c\prod(1+(x_i-\theta)^2)가 θ\theta의 2n2n차 다항식으로서 같다. 최고차 계수가 둘 다 1이므로 c=1c=1이고, 복소근의 모임 {xi±i}\{x_i\pm\mathrm i\}와 {yi±i}\{y_i\pm\mathrm i\}가 같다. 따라서 {xi}\{x_i\}와 {yi}\{y_i\}는 순서만 다르다.

연습 1.5 (부호가 담는 정보 ★★) X∼N(θ,1)X\sim\N(\theta,1)에서 T=1{X>0}T=1\{X>0\}의 정보가 IT(θ)=φ(θ)2Φ(θ)(1−Φ(θ))I_T(\theta)=\tfrac{\varphi(\theta)^2}{\Phi(\theta)(1-\Phi(\theta))}이고, θ=0\theta=0에서 2π=0.637\tfrac2\pi=0.637, 곧 전체 정보의 64%임을 보여라.

풀이

T∼T\sim Bernoulli(p(θ))(p(\theta)), p=Φ(θ)p=\Phi(\theta)이므로 IT=p′(θ)2p(1−p)=φ(θ)2Φ(θ)(1−Φ(θ))I_T=\tfrac{p'(\theta)^2}{p(1-p)}=\tfrac{\varphi(\theta)^2}{\Phi(\theta)(1-\Phi(\theta))}(9회 연습 2.2의 변환 규칙). θ=0\theta=0에서 1/(2π)1/4=2π\tfrac{1/(2\pi)}{1/4}=\tfrac2\pi.

연습 1.6 (통계량의 정보: 증명 ★★ 유도형) 이산인 경우에 명제 1.7를 다음 순서로 증명하라. sX(x;θ)=∂θlog⁡f(x;θ)s_{\X}(\x;\theta)=\partial_\theta\log f(\x;\theta)는 자료 전체의 점수다.

  1. (a)

    Pθ(T=t)=∑x: T(x)=tf(x;θ)P_\theta(T=t)=\sum_{\x:\,T(\x)=t}f(\x;\theta)를 θ\theta로 미분해 TT의 점수 sT(t)=∂θlog⁡Pθ(T=t)s_T(t)=\partial_\theta\log P_\theta(T=t)가 Eθ[sX(X)∣T=t]E_\theta\bigl[s_{\X}(\X)\bigm|T=t\bigr]임을 보여라. 합과 미분의 순서를 바꾸는 근거는 무엇인가?

  2. (b)

    EθsT(T)=0E_\theta s_T(T)=0이고 IT=Var⁡θsT(T)I_T=\Var_\theta s_T(T)임을 확인하고, 전분산 공식으로 IT≤IXI_T\le I_{\X}를 얻어라.

  3. (c)

    TT가 충분하면 인수분해 정리로 sX=∂θlog⁡g(T(x);θ)s_{\X}=\partial_\theta\log g(T(\x);\theta)가 TT의 함수임을 보이고, 등호를 얻어라.

풀이

(a) 9회의 정칙조건은 합(적분)과 θ\theta-미분의 순서를 바꿀 수 있게 한다 [T6]. Pθ(T=t)>0P_\theta(T=t)>0이면

sT(t)=∂θPθ(T=t)Pθ(T=t)=∑x: T(x)=t∂θf(x;θ)f(x;θ)⋅f(x;θ)Pθ(T=t)=∑x: T(x)=tsX(x;θ) Pθ(X=x∣T=t),s_T(t)=\frac{\partial_\theta P_\theta(T=t)}{P_\theta(T=t)}=\sum_{\x:\,T(\x)=t}\frac{\partial_\theta f(\x;\theta)}{f(\x;\theta)}\cdot\frac{f(\x;\theta)}{P_\theta(T=t)}=\sum_{\x:\,T(\x)=t}s_{\X}(\x;\theta)\,P_\theta(\X=\x\mid T=t),

곧 sT(t)=Eθ[sX(X)∣T=t]s_T(t)=E_\theta[s_{\X}(\X)\mid T=t]이다. (b) 반복기댓값으로 EθsT(T)=EθsX=0E_\theta s_T(T)=E_\theta s_{\X}=0이다(9회 정리 2.2). 따라서 IT=EθsT(T)2=Var⁡θsT(T)I_T=E_\theta s_T(T)^2=\Var_\theta s_T(T)이다. 전분산 공식으로 IX=Var⁡sX=Var⁡E[sX∣T]+EVar⁡(sX∣T)≥Var⁡sT(T)=ITI_{\X}=\Var s_{\X}=\Var E[s_{\X}\mid T]+E\Var(s_{\X}\mid T)\ge\Var s_T(T)=I_T이다. (c) 인수분해 정리로 log⁡f(x;θ)=log⁡g(T(x);θ)+log⁡h(x)\log f(\x;\theta)=\log g(T(\x);\theta)+\log h(\x)이고, hh는 θ\theta에 의존하지 않으므로 sX=∂θlog⁡g(T(x);θ)s_{\X}=\partial_\theta\log g(T(\x);\theta)는 TT의 함수다. 그러면 E[sX∣T]=sXE[s_{\X}\mid T]=s_{\X}이고 Var⁡(sX∣T)=0\Var(s_{\X}\mid T)=0이므로 (b)의 부등식이 등호다.

이 회차에서 읽은 절 0개 · 회차 차례