Skip to content

14회 · 분산분석과 실험설계 · 노트

1 무작위화 (1885–1935) ​

역사 1885년 미국의 철학자 Charles S. Peirce와 제자 Joseph Jastrow는 아주 작은 무게 차이를 사람이 느낄 수 있는지 실험했다. 피험자가 기대나 습관으로 답하지 못하도록, 무게를 올리고 내리는 순서를 섞은 카드 묶음으로 정했다. 기록에 남은 최초의 의도적 무작위화다. 1923년 폴란드의 Jerzy Neyman은 농사 실험을 다룬 학위논문에서, 한 구획이 각 품종을 받았을 때 낼 수확을 “잠재적 수확”으로 적고, 무작위 배정 아래 평균 차이의 분산을 계산했다. 이 생각은 폴란드어로만 남아 있다가 1990년에 영어로 옮겨졌다. Fisher는 1926년과 1935년에 무작위화를 실험 설계의 원리로 세웠다. “무작위화만이 오차를 정당하게 추정하게 해 준다.”

1.1 잠재적 결과 ​

정의 1.1 (잠재적 결과와 처치효과) 단위 i=1,…,ni=1,\dots,n은 처치를 받으면 yi(1)y_i(1), 받지 않으면 yi(0)y_i(0)을 낸다. 두 값은 실험 전에 정해진 상수이고, 실제로는 그 가운데 하나만 관측된다. τi=yi(1)−yi(0)\tau_i=y_i(1)-y_i(0)을 단위 ii의 처치효과, τˉ=1n∑τi\bar\tau=\tfrac1n\sum\tau_i를 평균 처치효과라 한다. 배정 Wi∈{0,1}W_i\in\{0,1\} 아래 관측값은 yi=Wiyi(1)+(1−Wi)yi(0)y_i=W_iy_i(1)+(1-W_i)y_i(0)이다.

이 정의에서 확률은 단위들에 있지 않다. 단위와 그 두 잠재적 결과는 고정되어 있고, 무작위인 것은 오직 배정 WW다. 정규분포도, 독립인 오차도 가정하지 않는다. 실험자가 동전을 던졌다는 사실 하나가 모든 확률의 출처다.

정의 1.2 (완전무작위설계) nn개 단위 가운데 nTn_T개를 처치에, 나머지 nC=n−nTn_C=n-n_T개를 대조에 배정하는 (nnT)\binom n{n_T}가지 방법이 모두 같은 확률로 뽑히는 설계를 완전무작위설계라 한다.

보조정리 1.3 (배정 지시변수의 적률) 완전무작위설계에서 EWi=nT/nEW_i=n_T/n, Var⁡Wi=nTnC/n2\Var W_i=n_Tn_C/n^2이고 i≠ji\ne j이면 Cov⁡(Wi,Wj)=−nTnCn2(n−1)\Cov(W_i,\allowbreak W_j)=-\dfrac{n_Tn_C}{n^2(n-1)}이다.

증명 전략 한 단위가 처치에 들어가는 배정과 두 단위가 함께 들어가는 배정의 수를 세어 확률을 구한다. 공분산은 EWiWj−EWiEWjEW_iW_j-EW_iEW_j이다. ∑iWi=nT\sum_iW_i=n_T가 상수라는 사실로 검산한다. 단계별 증명은 연습 1.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

정리 1.4 (Neyman (1923)) S12=1n−1∑(yi(1)−yˉ(1))2S_1^2=\tfrac1{n-1}\sum(y_i(1)-\bar y(1))^2, S02S_0^2도 같게, Sτ2=1n−1∑(τi−τˉ)2S_\tau^2=\tfrac1{n-1}\sum(\tau_i-\bar\tau)^2이라 하자. 완전무작위설계에서 τ^=yˉT−yˉC\hat\tau=\bar y_T-\bar y_C (처치군과 대조군의 관측 평균의 차)는

Eτ^=τˉ,Var⁡τ^=S12nT+S02nC−Sτ2nE\hat\tau=\bar\tau,\qquad \Var\hat\tau=\frac{S_1^2}{n_T}+\frac{S_0^2}{n_C}-\frac{S_\tau^2}n

를 만족한다. 처치효과가 모든 단위에서 같으면(Sτ2=0S_\tau^2=0) 마지막 항이 없어진다.

증명 전략 τ^−τˉ\hat\tau-\bar\tau를 중심화한 배정 지시변수 Wi−nT/nW_i-n_T/n의 일차결합으로 쓴다. 그러면 평균은 0이고, 분산은 보조정리 1.3의 분산과 공분산으로 계산하는 이차형식이다.

  1. ai=yi(1)/nT+yi(0)/nCa_i=y_i(1)/n_T+y_i(0)/n_C로 두면 τ^=∑iWiyi(1)/nT−∑i(1−Wi)yi(0)/nC=∑iWiai−∑iyi(0)/nC\hat\tau=\sum_iW_iy_i(1)/n_T-\sum_i(1-W_i)y_i(0)/n_C=\sum_iW_ia_i-\sum_iy_i(0)/n_C이다.정의 1.1의 yiy_i

  2. ∑inTnai−∑iyi(0)nC=1n∑iyi(1)+(nTnnC−1nC)∑iyi(0)=τˉ\sum_i\tfrac{n_T}na_i-\sum_i\tfrac{y_i(0)}{n_C}=\tfrac1n\sum_iy_i(1)+\bigl(\tfrac{n_T}{nn_C}-\tfrac1{n_C}\bigr)\sum_iy_i(0)=\bar\tau이므로

    τ^−τˉ=∑i(Wi−nTn)ai.\hat\tau-\bar\tau=\sum_i\Bigl(W_i-\frac{n_T}n\Bigr)a_i .
    nTnnC−1nC=−1n\tfrac{n_T}{nn_C}-\tfrac1{n_C}=-\tfrac1n
  3. E(Wi−nT/n)=0E(W_i-n_T/n)=0이므로 Eτ^=τˉE\hat\tau=\bar\tau이다.보조정리 1.3, 선형성

  4. 2의 일차결합의 분산을 계산한다.

    Var⁡τ^=nTnCn2(∑iai2−1n−1∑i≠jaiaj)=nTnCn(n−1)∑i(ai−aˉ)2\begin{align*} \Var\hat\tau&=\frac{n_Tn_C}{n^2}\Bigl(\sum_ia_i^2-\frac1{n-1}\sum_{i\ne j}a_ia_j\Bigr) \tag*{\htmlClass{reason}{\text{보조정리~\href{/read/14/1#lem-wmoments}{1.3}}}}\\ &=\frac{n_Tn_C}{n(n-1)}\sum_i(a_i-\bar a)^2 \tag*{\htmlClass{reason}{\text{$\textstyle\sum_{i\ne j}a_ia_j=(\sum_i a_i)^2-\sum_i a_i^2$}}} \end{align*}
  5. S10S_{10}을 y(1)y(1)과 y(0)y(0)의 공분산(분모 n−1n-1)이라 하면 1n−1∑i(ai−aˉ)2=S12nT2+S02nC2+2S10nTnC\tfrac1{n-1}\sum_i(a_i-\bar a)^2=\tfrac{S_1^2}{n_T^2}+\tfrac{S_0^2}{n_C^2}+\tfrac{2S_{10}}{n_Tn_C}이므로

    Var⁡τ^=nCnS12nT+nTnS02nC+2S10n.\Var\hat\tau=\frac{n_C}{n}\frac{S_1^2}{n_T}+\frac{n_T}n\frac{S_0^2}{n_C}+\frac{2S_{10}}n .
    4, 표본공분산의 쌍선형성
  6. 2S10=S12+S02−Sτ22S_{10}=S_1^2+S_0^2-S_\tau^2을 넣고 nCnnT+1n=1nT\tfrac{n_C}{nn_T}+\tfrac1n=\tfrac1{n_T}, nTnnC+1n=1nC\tfrac{n_T}{nn_C}+\tfrac1n=\tfrac1{n_C}를 쓰면 정리의 식이다.τi=yi(1)−yi(0)\tau_i=y_i(1)-y_i(0)

조건 확인 확률은 배정 WW에서만 온다. 잠재적 결과는 상수이므로 모든 적률이 유한하고, 정규성도 표본의 독립도 쓰지 않았다.

Sτ2S_\tau^2는 두 잠재적 결과를 함께 보아야 알 수 있으므로 자료로 추정할 수 없다. 처치군과 대조군의 표본분산 sT2,sC2s_T^2,s_C^2로 만든 sT2/nT+sC2/nCs_T^2/n_T+s_C^2/n_C는 S12/nT+S02/nCS_1^2/n_T+S_0^2/n_C의 불편추정량이어서(연습 1.3), 참 분산을 과대추정한다. 보수적인 쪽으로 틀리는 것이다. 6회의 두 표본 tt에서 쓰던 표준오차가 무작위 배정만으로 이렇게 정당화된다.

예제 1.5 (처치가 없는 밭) 1910년 Rothamsted의 Mercer와 Hall은 겉보기에 고른 1에이커의 밀밭을 20×25=50020\times25=500개 구획으로 나누어 모두 똑같이 기르고 구획마다 수확을 쟀다(균일성 시험). 아무 처치도 없으므로 모든 τi\tau_i가 0이다. 500개 가운데 250개를 무작위로 골라 “처치”라 부르면, 정리 1.4로 τ^\hat\tau의 분산은 S2(1250+1250)=0.001680S^2(\tfrac1{250}+\tfrac1{250})=0.001680이다(S2=0.2100S^2=0.2100, 단위는 구획당 파운드의 제곱). 무작위 배정을 2만 번 되풀이하면 τ^\hat\tau의 평균은 −0.00006-0.00006, 분산은 0.0016790.001679이다.

1.2 Fisher의 무작위화 검정 ​

정의 1.6 (날카로운 귀무가설) 모든 단위에서 yi(1)=yi(0)y_i(1)=y_i(0)이라는 가설을 날카로운 귀무가설이라 한다. 이 가설 아래에서는 배정이 무엇이든 관측 벡터 y\y가 같다.

정리 1.7 (무작위화 검정은 정확하다) 배정 WW가 유한집합 W\mathcal W 위에서 균등하게 뽑히고, T(w,y)T(w,\y)가 아무 검정통계량이라 하자. W′W^\prime을 WW와 독립이고 같은 분포를 갖는 배정이라 하고

p(W)=PW′(T(W′,y)≥T(W,y))p(W)=P_{W^\prime}\bigl(T(W^\prime,\y)\ge T(W,\y)\bigr)

로 정의하면, 날카로운 귀무가설 아래 모든 α∈(0,1)\alpha\in(0,1)에 대해 P(p(W)≤α)≤αP\bigl(p(W)\le\alpha\bigr)\le\alpha이다.

증명 전략 귀무가설 아래 y\y는 배정과 무관하게 고정된다. 그러면 TT는 균등 배정만으로 무작위인 이산 확률변수이고, p(W)p(W)는 그 생존함수 GG에 TT 자신을 넣은 것이다. 생존함수에 자기 자신을 넣은 값은 균등분포보다 작은 쪽으로 몰리지 않는다.

  1. 날카로운 귀무가설 아래 y\y는 WW에 의존하지 않는다. 따라서 T=T(W,y)T=T(W,\y)의 무작위성은 W\mathcal W 위의 균등분포에서만 온다.정의 1.6

  2. G(t)=PW′(T(W′,y)≥t)G(t)=P_{W^\prime}\bigl(T(W^\prime,\allowbreak \y)\ge t\bigr)로 두면 p(W)=G(T)p(W)=G(T)이다.W′W^\prime과 WW의 분포가 같다

  3. GG는 감소함수다. t≤t′t\le t^\prime이면 {T≥t′}⊂{T≥t}\{T\ge t^\prime\}\subset\{T\ge t\}이기 때문이다.단조성 [T1]

  4. TT가 가질 수 있는 값은 유한개다. 그 가운데 G(t)≤αG(t)\le\alpha인 가장 작은 값을 tαt_\alpha라 하면 {G(T)≤α}={T≥tα}\{G(T)\le\alpha\}=\{T\ge t_\alpha\}이다.3, W\mathcal W가 유한

  5. P(p(W)≤α)=P(T≥tα)=G(tα)≤αP\bigl(p(W)\le\alpha\bigr)=P(T\ge t_\alpha)=G(t_\alpha)\le\alpha이다. 그런 값이 없으면 사건이 공집합이어서 확률은 0이다.2, tαt_\alpha의 정의

이 정리는 정규분포도, 표본의 독립도, 큰 표본도 쓰지 않는다. 쓰는 것은 실험자가 실제로 무작위로 배정했다는 사실뿐이다. 무작위화하지 않은 실험에는 이 보증이 없다. 8회 정리 4.2의 pp-값의 균등성을 이산판으로 다시 본 것이기도 하다.

예제 1.8 (홍차 감별 숙녀) Rothamsted의 차 시간에 조류학자 Muriel Bristol은 우유를 먼저 부은 차와 차를 먼저 부은 차를 맛으로 가릴 수 있다고 했다. Fisher는 실험의 설계(1935)에서 이 일을 실험으로 만들었다. 컵 8개 가운데 무작위로 고른 4개에 우유를 먼저 붓고, 숙녀에게 그 4개를 고르게 한다. 숙녀가 가리지 못한다면(날카로운 귀무가설) 맞힌 개수 KK는 초기하분포를 따르고

P(K=k)=(4k)(44−k)(84):170, 1670, 3670, 1670, 170(k=0,…,4)P(K=k)=\frac{\binom4k\binom4{4-k}}{\binom84}:\qquad \frac1{70},\ \frac{16}{70},\ \frac{36}{70},\ \frac{16}{70},\ \frac1{70}\qquad(k=0,\dots,4)

이다. 넷 다 맞힐 확률은 1/70=0.0141/70=0.014이고, 셋 이상은 17/70=0.24317/70=0.243이다. 5%에서 의미가 있는 결과는 넷 다 맞히는 것뿐이다. 이 검정이 Fisher의 정확검정이다.

예제 1.9 (Darwin의 옥수수) Darwin(1876)은 타가수정한 옥수수와 자가수정한 옥수수를 같은 화분에 짝지어 15쌍을 기르고 키(인치)를 쟀다. 짝마다 차이 did_i(타가 −- 자가)의 합은 39.25다. Fisher(1935)는 각 짝 안에서 어느 쪽이 타가수정인지 동전으로 정했다고 상상했다. 날카로운 귀무가설 아래에서는 각 did_i의 부호만 동전에 따라 바뀌므로, 215=327682^{15}=32768가지 부호 조합이 같은 확률을 갖는다. 그 가운데 ∑±∣di∣\sum\pm|d_i|가 39.25 이상인 것은 863개이고, 한쪽 pp-값은 863/32768=0.0263863/32768=0.0263, 양쪽은 0.05270.0527이다. 정규분포를 가정한 대응 tt 검정(6회)의 양쪽 pp-값은 0.04970.0497이다. Fisher의 결론은 tt 검정이 무작위화 검정의 좋은 근사라는 것이었다(그림 1.1 오른쪽).
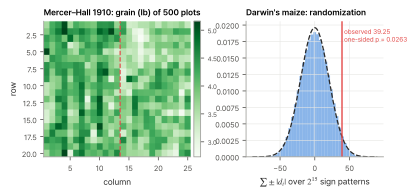
그림 1.1. 왼쪽: Mercer–Hall의 균일성 시험. 같은 처치를 받은 500개 구획의 수확(파운드)이 밭의 위치에 따라 고르지 않다. 번호가 작은 열들(1–13)이 큰 열들(14–25)보다 대체로 높다. 세로 점선은 7절의 “체계적 배치”의 경계다. 오른쪽: Darwin의 15쌍에 대한 무작위화 분포. 2^15개 부호 조합의 Σ
그림 1.1 왼쪽: Mercer–Hall의 균일성 시험. 같은 처치를 받은 500개 구획의 수확(파운드)이 밭의 위치에 따라 고르지 않다. 번호가 작은 열들(1–13)이 큰 열들(14–25)보다 대체로 높다. 세로 점선은 7절의 “체계적 배치”의 경계다. 오른쪽: Darwin의 15쌍에 대한 무작위화 분포. 2152^{15}개 부호 조합의 ∑±∣di∣\sum\pm|d_i|와 관측값 39.25(빨강). 점선은 같은 평균과 분산의 정규 근사다.
연습문제

연습 1.1 (컵 여섯 개 ★) 컵 6개 가운데 3개에 우유를 먼저 부으면, 숙녀가 모두 맞혀도 pp-값이 1/201/20임을 보여라. 컵 8개 대신 우유 먼저 2개, 차 먼저 6개로 하면 모두 맞힐 확률은 얼마인가? 어느 설계가 더 좋은가?

풀이

3개를 고르는 방법은 (63)=20\binom63=20가지이므로 모두 맞힐 확률은 1/20=0.051/20=0.05다. 우유 먼저가 2개이면 (82)=28\binom82=28가지에서 1/28=0.0361/28=0.036이다. 4:4 설계의 1/70=0.0141/70=0.014가 가장 작아서, 한 번의 완벽한 답이 가장 강한 증거가 된다. 2:6 설계는 “우유 먼저는 드물다”는 쪽으로 찍는 전략에 약하다.

연습 1.2 (두 단위 ★) n=2n=2, nT=nC=1n_T=n_C=1이면 τ^\hat\tau는 y1(1)−y2(0)y_1(1)-y_2(0)과 y2(1)−y1(0)y_2(1)-y_1(0) 가운데 하나다. 직접 분산을 계산해 정리 1.4의 식과 같음을 보여라.

풀이

A=y1(1)−y2(1)A=y_1(1)-y_2(1), B=y1(0)−y2(0)B=y_1(0)-y_2(0)이라 하면 τ^\hat\tau의 두 값의 차는 A+BA+B이고 확률이 반반이므로 Var⁡τ^=(A+B)2/4\Var\hat\tau=(A+B)^2/4. 정리의 식은 n=2n=2에서 S12=A2/2S_1^2=A^2/2, S02=B2/2S_0^2=B^2/2, Sτ2=(A−B)2/2S_\tau^2=(A-B)^2/2이므로 A2/2+B2/2−(A−B)2/4=(A+B)2/4A^2/2+B^2/2-(A-B)^2/4=(A+B)^2/4로 같다.

연습 1.3 (유한 모집단의 표본분산 ★★) 완전무작위설계에서 처치군의 표본분산 sT2=1nT−1∑i:Wi=1(yi(1)−yˉT)2s_T^2=\tfrac1{n_T-1}\sum_{i:W_i=1}(y_i(1)-\bar y_T)^2의 기댓값이 S12S_1^2임을 보조정리 1.3로 보여라. (∑iWi(yi(1)−yˉ(1))2\sum_iW_i(y_i(1)-\bar y(1))^2과 (yˉT−yˉ(1))2(\bar y_T-\bar y(1))^2의 기댓값을 각각 구하라.)

풀이

μ=yˉ(1)\mu=\bar y(1)이라 하면 ∑Wi=1(yi(1)−yˉT)2=∑iWi(yi(1)−μ)2−nT(yˉT−μ)2\sum_{W_i=1}(y_i(1)-\bar y_T)^2=\sum_iW_i(y_i(1)-\mu)^2-n_T(\bar y_T-\mu)^2. 첫 항의 기댓값은 nTn(n−1)S12\tfrac{n_T}n(n-1)S_1^2이다. 보조정리 1.3로 Var⁡∑Wiyi(1)=nTnCn(n−1)(n−1)S12\Var\sum W_iy_i(1)=\tfrac{n_Tn_C}{n(n-1)}(n-1)S_1^2이므로 Var⁡yˉT=nCnnTS12\Var\bar y_T=\tfrac{n_C}{nn_T}S_1^2이고, 둘째 항의 기댓값은 nCnS12\tfrac{n_C}nS_1^2이다. 차는 nT(n−1)−nCnS12=(nT−1)S12\tfrac{n_T(n-1)-n_C}nS_1^2=(n_T-1)S_1^2이다.

연습 1.4 (정확하지만 보수적 ★★) 홍차 실험에서 “p≤0.05p\le0.05이면 기각”하는 검정의 실제 크기가 1/701/70임을 보여라. 정리 1.7의 부등호가 등호가 되지 않는 이유는 무엇인가? 12회의 확률화 검정으로 크기를 정확히 0.05로 만들려면 어떻게 하는가?

풀이

p≤0.05p\le0.05는 K=4K=4일 때뿐이고(p=1/70p=1/70), 그 확률이 1/70=0.0141/70=0.014다. pp-값이 1/70, 17/70,…1/70,\ 17/70,\dots의 이산값만 가지므로 0.05에 맞는 값이 없다. 확률화 검정(12회 예제 1.4): K=4K=4이면 기각, K=3K=3이면 확률 γ\gamma로 기각하면 크기는 170+γ1670=0.05\tfrac1{70}+\gamma\tfrac{16}{70}=0.05, 곧 γ=0.156\gamma=0.156이다.

연습 1.5 (효과가 일정하다는 가설 ★★) 모든 단위에서 τi=τ0\tau_i=\tau_0이라는 가설 아래에서도 관측값으로부터 모든 잠재적 결과를 채울 수 있음을 보이고, 이것으로 Darwin의 자료에서 τ\tau의 신뢰구간을 무작위화 검정을 뒤집어 만드는 방법을 설명하라(8회 정리 3.5의 쌍대성).

풀이

τi≡τ0\tau_i\equiv\tau_0이면 관측된 쪽에서 τ0\tau_0을 더하거나 빼 다른 쪽을 채울 수 있다. Darwin의 짝에서는 di−τ0d_i-\tau_0이 날카로운 귀무가설 아래의 차이이므로, di−τ0d_i-\tau_0의 부호를 뒤집는 무작위화 검정을 한다. 기각되지 않는 τ0\tau_0들의 집합이 신뢰집합이다. 검정과 구간의 쌍대성(8회 정리 3.5) 그대로다.

연습 1.6 (배정 지시변수의 적률: 증명 ★ 유도형) 보조정리 1.3를 다음 순서로 증명하라.

  1. (a)

    단위 ii가 처치에 들어가는 배정의 수가 (n−1nT−1)\binom{n-1}{n_T-1}임을 보이고 EWi=P(Wi=1)=nT/nEW_i=P(W_i=1)=n_T/n을 얻어라. WiW_i는 0과 1만 가지므로 Var⁡Wi=EWi(1−EWi)\Var W_i=EW_i(1-EW_i)이다.

  2. (b)

    i≠ji\ne j가 함께 처치에 들어가는 배정의 수가 (n−2nT−2)\binom{n-2}{n_T-2}임을 보이고 P(Wi=Wj=1)=nT(nT−1)n(n−1)P(W_i=W_j=1)=\tfrac{n_T(n_T-1)}{n(n-1)}을 얻어라.

  3. (c)

    Cov⁡(Wi,Wj)=EWiWj−EWiEWj\Cov(W_i,\allowbreak W_j)=EW_iW_j-EW_iEW_j에 (a)와 (b)를 넣어 정리의 식을 얻어라.

  4. (d)

    ∑iWi=nT\sum_iW_i=n_T가 상수이므로 0=Var⁡∑iWi=nVar⁡W1+n(n−1)Cov⁡(W1,W2)0=\Var\sum_iW_i=n\Var W_1+n(n-1)\Cov(W_1,\allowbreak W_2)이다. 이것으로 (c)를 검산하라. 4회의 초기하분포의 분산과 같은 계산이다.

풀이

(a) 단위 ii를 처치에 넣고 나머지 n−1n-1개에서 nT−1n_T-1개를 고르는 배정이 (n−1nT−1)\binom{n-1}{n_T-1}개이므로 P(Wi=1)=(n−1nT−1)/(nnT)=nT/nP(W_i=1)=\binom{n-1}{n_T-1}/\binom n{n_T}=n_T/n이다. Wi2=WiW_i^2=W_i이므로 Var⁡Wi=EWi−(EWi)2=nTn⋅nCn\Var W_i=EW_i-(EW_i)^2=\tfrac{n_T}n\cdot\tfrac{n_C}n이다. (b) 같은 방법으로 P(Wi=Wj=1)=(n−2nT−2)/(nnT)=nT(nT−1)n(n−1)P(W_i=W_j=1)=\binom{n-2}{n_T-2}/\binom n{n_T}=\tfrac{n_T(n_T-1)}{n(n-1)}이다. (c) Cov⁡(Wi,Wj)=nT(nT−1)n(n−1)−nT2n2=nTn⋅n(nT−1)−(n−1)nTn(n−1)=−nTnCn2(n−1)\Cov(W_i,\allowbreak W_j)=\tfrac{n_T(n_T-1)}{n(n-1)}-\tfrac{n_T^2}{n^2}=\tfrac{n_T}{n}\cdot\tfrac{n(n_T-1)-(n-1)n_T}{n(n-1)}=-\tfrac{n_Tn_C}{n^2(n-1)}이다. 분자에서 n(nT−1)−(n−1)nT=nT−n=−nCn(n_T-1)-(n-1)n_T=n_T-n=-n_C를 썼다. (d) ∑iWi=nT\sum_iW_i=n_T이므로 분산은 0이고, nnTnCn2+n(n−1)Cov⁡(W1,W2)=0n\tfrac{n_Tn_C}{n^2}+n(n-1)\Cov(W_1,\allowbreak W_2)=0에서 Cov⁡(W1,W2)=−nTnCn2(n−1)\Cov(W_1,\allowbreak W_2)=-\tfrac{n_Tn_C}{n^2(n-1)}이 다시 나온다. 4회 정리 1.5의 초기하분포 분산 공식이 같은 계산에서 나온다.

이 회차에서 읽은 절 0개 · 회차 차례