
테마
노트북 · 14회 · 분산분석과 실험설계
분산분석과 실험설계 밭에 무작위를 심다
| 강의노트 | 14_anova_design_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 14_anova_design_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Mercer–Hall 균일성 시험 (agridat mercer.wheat.uniformity) · Broadbalk 밀 (agridat broadbalk.wheat) · Yates의 귀리 (agridat yates.oats) · 완두 요인실험 (datasets npk) · Darwin의 옥수수 (HistData ZeaMays) · Salk 백신 시험 (HistData PolioTrials) |
| 선수 지식 | 1–13회 (6회 ·, 8회 검정, 12회 검정력, 13회 사영·Cochran·일반선형가설) |
여는 질문. 새 비료가 밀 수확을 얼마나 늘리는지 알고 싶다. 같은 밭 안에서도 땅심이 다르고, 해마다 날씨가 다르며, 같은 처치를 해도 수확은 들쭉날쭉하다. 비료의 효과를 땅과 날씨와 우연에서 어떻게 떼어 내는가? 그리고 그 판단을 무엇이 보증하는가?
이번 회차의 지도
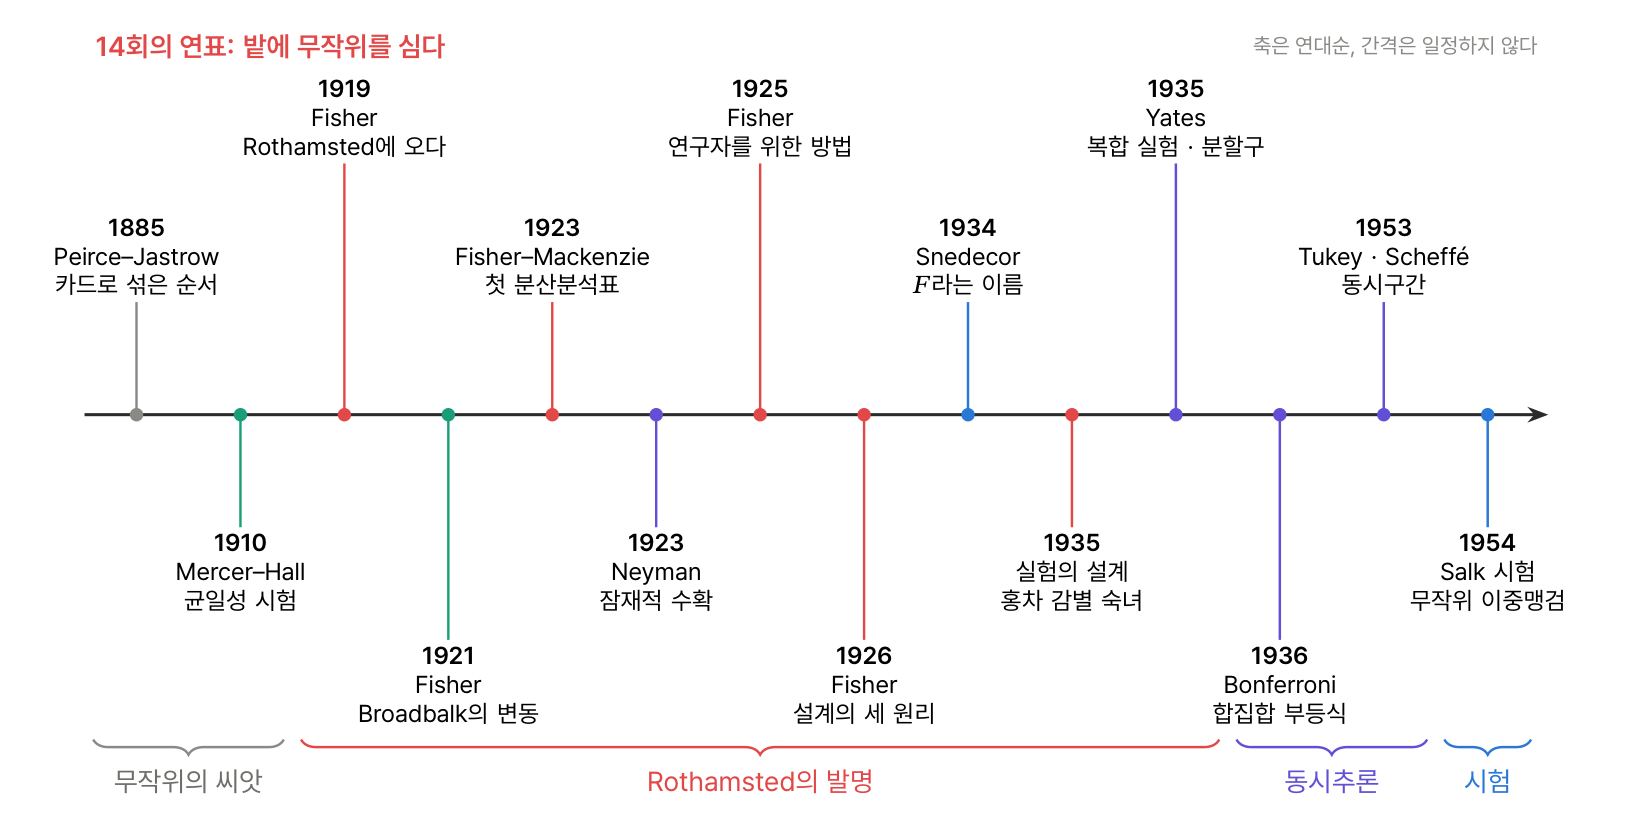
학습 목표
- 모든 배정을 열거해 Neyman의 분산 공식과 무작위화 검정의 정확성을 확인하고, 홍차 숙녀와 Darwin의 옥수수를 재현한다.
- 일원분산분석을 사영으로 계산하고, 비중심 ·로 검정력과 표본 크기를 정한다.
- Broadbalk와 Yates의 귀리로 이원분산분석과 분할구의 두 오차층을 계산한다.
- Bonferroni·Tukey·Scheffé의 동시추론을 구현하고 가족 단위 오류율을 시뮬레이션한다.
- Mercer–Hall로 블록과 짝의 효율을, npk로 요인설계를, Salk 시험으로 무작위화의 값을 보고, 하이퍼파라미터 그리드와 CUPED를 재현한다.
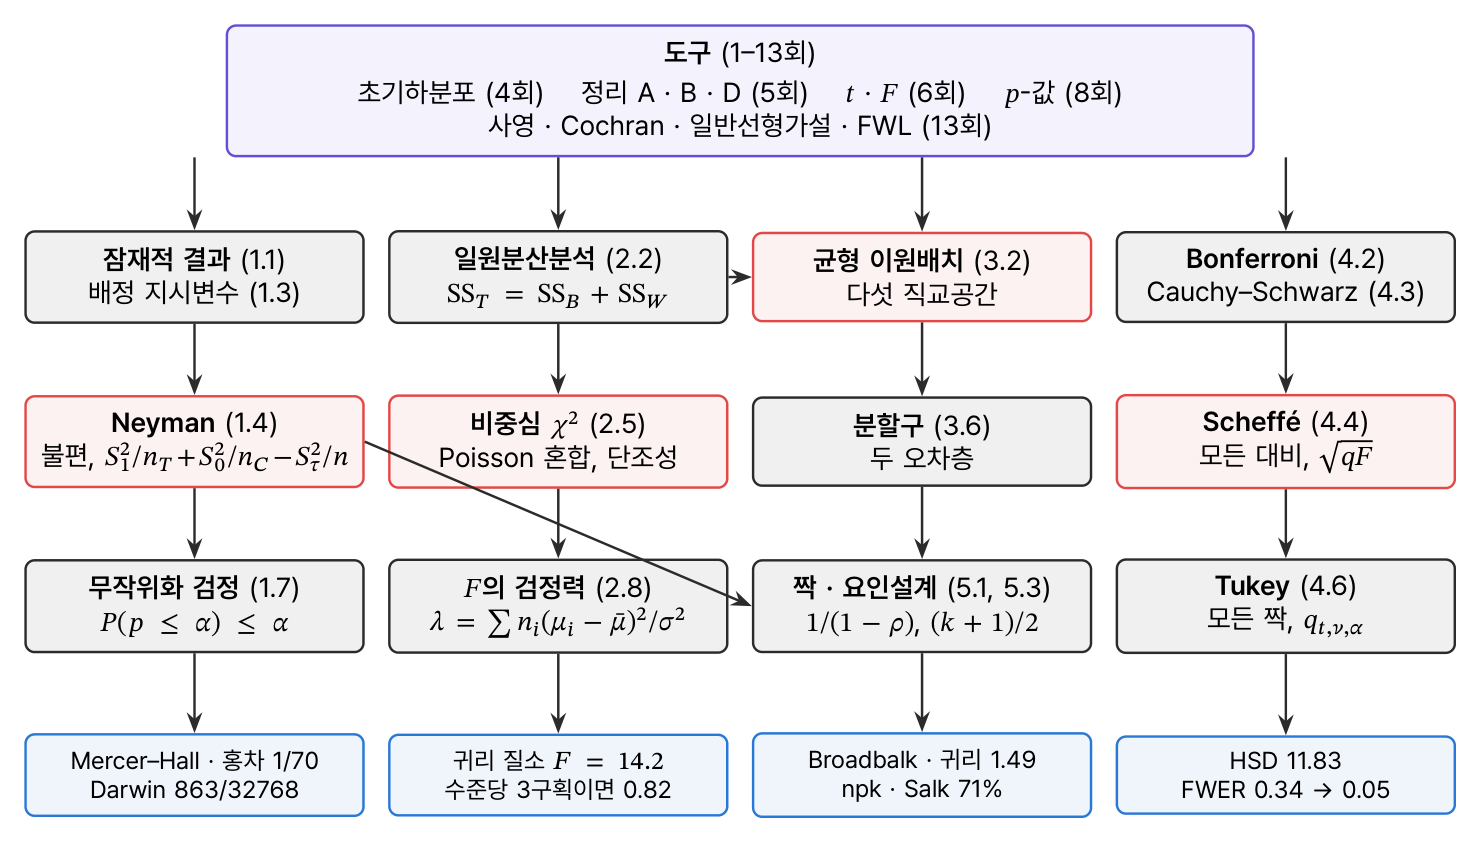
정리 지도
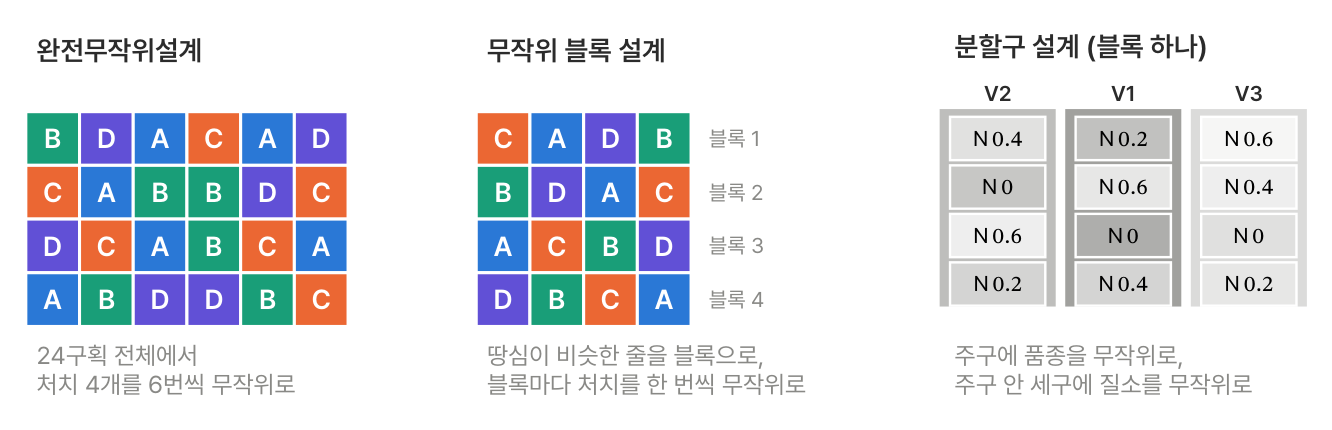
세 설계
0. 설정
python
%matplotlib inline
import itertools
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

SEED = 1926
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

def dummies(col, drop_first=True):
    return pd.get_dummies(col, drop_first=drop_first).to_numpy(float)

def rss_of(X, y):
    b = np.linalg.lstsq(X, y, rcond=None)[0]; e = y - X @ b
    return e @ e, np.linalg.matrix_rank(X)
1. 무작위화 (1885–1935)
정의 1.1 잠재적 결과 · 정의 1.2 완전무작위설계 · 보조정리 1.3 · 정리 1.4 Neyman: , · 정리 1.7 무작위화 검정은 정확하다 · 예제 1.8 홍차 숙녀 · 예제 1.9 Darwin의 옥수수.
확률의 출처가 배정뿐이므로, 작은 예에서는 모든 배정을 열거해 기댓값과 분산을 정확히 계산할 수 있다.
python
def all_assignments(n, nT):
    for idx in itertools.combinations(range(n), nT):
        w = np.zeros(n, int); w[list(idx)] = 1
        yield w

# 보조정리 1.3: n = 7, n_T = 3 의 모든 배정
n7, nT7 = 7, 3
Wall = np.array(list(all_assignments(n7, nT7)))
covW = np.cov(Wall.T, bias=True)
# 정리 1.4: 무작위 잠재적 결과 (n = 9, n_T = 4) — 효과가 단위마다 다르다
n9, nT9 = 9, 4
y0 = rng.normal(10, 2, n9); y1 = y0 + rng.normal(1.5, 1.0, n9)
taus = np.array([w @ y1 / nT9 - (1 - w) @ y0 / (n9 - nT9) for w in all_assignments(n9, nT9)])
S1, S0, St = y1.var(ddof=1), y0.var(ddof=1), (y1 - y0).var(ddof=1)
var_neyman = S1 / nT9 + S0 / (n9 - nT9) - St / n9
# 연습 1.3: 처치군 표본분산의 기댓값 = S1²
sT2 = np.array([np.var(y1[w == 1], ddof=1) for w in all_assignments(n9, nT9)])
# 연습 1.2: 두 단위
a1, a0, b1, b0 = 5.0, 3.0, 4.0, 1.0
two = np.array([a1 - b0, b1 - a0])
S1_2, S0_2, St_2 = np.var([a1, b1], ddof=1), np.var([a0, b0], ddof=1), np.var([a1 - a0, b1 - b0], ddof=1)
print(f"배정 {len(Wall)}가지: E W = {Wall.mean(0)[0]:.4f}, Var W = {covW[0, 0]:.4f}, Cov = {covW[0, 1]:.4f}")
print(f"Neyman: E τ̂ = {taus.mean():.6f} (τ̄ = {(y1 - y0).mean():.6f}), Var τ̂ = {taus.var():.6f} (공식 {var_neyman:.6f}), 보수적 추정의 기댓값 {S1 / nT9 + S0 / (n9 - nT9):.6f}")
report({"보조정리 1.3: E W = n_T/n, Var W = n_T n_C/n², Cov = −n_T n_C/(n²(n−1))":
            np.allclose(Wall.mean(0), 3 / 7) and np.allclose(np.diag(covW), 12 / 49) and np.allclose(covW[~np.eye(7, dtype=bool)], -12 / (49 * 6)),
        "정리 1.4: 모든 배정의 평균 = 평균 처치효과": abs(taus.mean() - (y1 - y0).mean()) < 1e-12,
        "정리 1.4: 모든 배정의 분산 = S1²/n_T + S0²/n_C − S_τ²/n": abs(taus.var() - var_neyman) < 1e-12,
        "연습 1.3: E s_T² = S1² (유한 모집단)": abs(sT2.mean() - S1) < 1e-12,
        "연습 1.2: n = 2 에서 직접 계산한 분산 = 공식": abs(two.var() - (S1_2 + S0_2 - St_2 / 2)) < 1e-12})
text
배정 35가지: E W = 0.4286, Var W = 0.2449, Cov = -0.0408
Neyman: E τ̂ = 1.928629 (τ̄ = 1.928629), Var τ̂ = 1.183393 (공식 1.183393), 보수적 추정의 기댓값 1.270288
  ✓  보조정리 1.3: E W = n_T/n, Var W = n_T n_C/n², Cov = −n_T n_C/(n²(n−1))
  ✓  정리 1.4: 모든 배정의 평균 = 평균 처치효과
  ✓  정리 1.4: 모든 배정의 분산 = S1²/n_T + S0²/n_C − S_τ²/n
  ✓  연습 1.3: E s_T² = S1² (유한 모집단)
  ✓  연습 1.2: n = 2 에서 직접 계산한 분산 = 공식
python
# 예제 1.5: Mercer–Hall 의 균일성 시험 — 처치가 없는 밭에서 무작위로 250 개를 고르면
MH = load_rdata("mercer.wheat.uniformity", "agridat")
Gmh = MH.pivot(index="row", columns="col", values="grain").to_numpy(float)    # 20 행 x 25 열
ymh = Gmh.ravel(); Nmh = len(ymh); S2mh = ymh.var(ddof=1)
gmh = np.random.default_rng(1926)
R = 20_000; diffs = np.empty(R); tstats = np.empty(R)
for r in range(R):
    w = np.zeros(Nmh, bool); w[gmh.choice(Nmh, 250, replace=False)] = True
    diffs[r] = ymh[w].mean() - ymh[~w].mean(); tstats[r] = stats.ttest_ind(ymh[w], ymh[~w]).statistic
size_rand = np.mean(np.abs(tstats) > stats.t.ppf(0.975, Nmh - 2))
print(f"500 구획, S² = {S2mh:.4f};  τ̂ 의 평균 {diffs.mean():.5f}, 분산 {diffs.var():.6f} (Neyman {S2mh * (2 / 250):.6f});  |t| > t_0.975 의 비율 {size_rand:.4f}")
report({"예제 1.5: 20 × 25 = 500 구획, S² = 0.2100": Gmh.shape == (20, 25) and round(S2mh, 4) == 0.2100,
        "예제 1.5: Neyman 분산 S²(1/250 + 1/250) = 0.001680, 모의 0.001679, 평균 −0.00006":
            round(S2mh * 2 / 250, 6) == 0.001680 and round(diffs.var(), 6) == 0.001679 and round(diffs.mean(), 5) == -0.00006,
        "정리 1.7 · 예제 7.1: 무작위 배정이면 5% 검정의 실제 크기 0.050": abs(size_rand - 0.05) < 4 * math.sqrt(0.05 * 0.95 / R)})
text
500 구획, S² = 0.2100;  τ̂ 의 평균 -0.00006, 분산 0.001679 (Neyman 0.001680);  |t| > t_0.975 의 비율 0.0503
  ✓  예제 1.5: 20 × 25 = 500 구획, S² = 0.2100
  ✓  예제 1.5: Neyman 분산 S²(1/250 + 1/250) = 0.001680, 모의 0.001679, 평균 −0.00006
  ✓  정리 1.7 · 예제 7.1: 무작위 배정이면 5% 검정의 실제 크기 0.050
python
# 정리 1.7: 작은 자료에서 모든 배정의 p-값을 열거해 P(p ≤ α) ≤ α 를 확인
yy = np.round(rng.normal(0, 1, 8), 1)                 # 반올림으로 동점을 만든다
Ws = np.array(list(all_assignments(8, 4)))
T = Ws @ yy / 4 - (1 - Ws) @ yy / 4
pvals = np.array([np.mean(T >= t - 1e-12) for t in T])
ok_exact = all(np.mean(pvals <= a) <= a + 1e-12 for a in np.linspace(0.01, 0.99, 99))
# 예제 1.8 · 연습 1.1 · 1.4: 홍차 숙녀
pk = np.array([math.comb(4, k) * math.comb(4, 4 - k) / 70 for k in range(5)])
fe = stats.fisher_exact([[4, 0], [0, 4]], alternative="greater").pvalue
gamma = (0.05 - 1 / 70) / (16 / 70)
print(f"P(K = k) = {np.round(pk * 70).astype(int)}/70;  P(K ≥ 3) = {pk[3:].sum():.3f};  Fisher 정확검정 p = {fe:.4f};  확률화 γ = {gamma:.3f}")
report({"정리 1.7: 모든 α 에서 P(p ≤ α) ≤ α (동점이 있어도)": ok_exact,
        "예제 1.8: 1/70, 16/70, 36/70, 16/70, 1/70; P(K ≥ 3) = 17/70 = 0.243": np.allclose(pk * 70, [1, 16, 36, 16, 1]) and round(pk[3:].sum(), 3) == 0.243,
        "예제 1.8: 넷 다 맞히면 Fisher 정확검정 p = 1/70 = 0.014": abs(fe - 1 / 70) < 1e-12,
        "연습 1.1: 6 컵(3:3)이면 1/20, 8 컵(2:6)이면 1/28": math.comb(6, 3) == 20 and math.comb(8, 2) == 28,
        "연습 1.4: 실제 크기 1/70, 확률화하면 γ = 0.156": round(gamma, 3) == 0.156})
text
P(K = k) = [ 1 16 36 16  1]/70;  P(K ≥ 3) = 0.243;  Fisher 정확검정 p = 0.0143;  확률화 γ = 0.156
  ✓  정리 1.7: 모든 α 에서 P(p ≤ α) ≤ α (동점이 있어도)
  ✓  예제 1.8: 1/70, 16/70, 36/70, 16/70, 1/70; P(K ≥ 3) = 17/70 = 0.243
  ✓  예제 1.8: 넷 다 맞히면 Fisher 정확검정 p = 1/70 = 0.014
  ✓  연습 1.1: 6 컵(3:3)이면 1/20, 8 컵(2:6)이면 1/28
  ✓  연습 1.4: 실제 크기 1/70, 확률화하면 γ = 0.156
python
# 예제 1.9: Darwin 의 옥수수 — 2^15 부호 조합
Zm = load_rdata("ZeaMays"); dz = Zm["diff"].to_numpy(float)
signs = np.array(list(itertools.product([1, -1], repeat=len(dz))))
Sz = signs @ np.abs(dz)
cnt = int(np.sum(Sz >= dz.sum() - 1e-9)); p1 = cnt / len(Sz); p2 = np.mean(np.abs(Sz) >= abs(dz.sum()) - 1e-9)
tt = stats.ttest_1samp(dz, 0)
# 연습 1.5: τ0 를 바꿔 가며 부호 검정을 뒤집은 95% 신뢰구간 (양쪽)
def p_two(t0):
    dd = dz - t0; S_ = signs @ np.abs(dd); return np.mean(np.abs(S_) >= abs(dd.sum()) - 1e-9)
grid = np.round(np.arange(-1.0, 6.01, 0.01), 2)
keep = [t0 for t0 in grid if p_two(t0) > 0.05]
print(f"15쌍, 합 {dz.sum()}: 한쪽 {cnt}/{len(Sz)} = {p1:.4f}, 양쪽 {p2:.4f};  대응 t: t = {tt.statistic:.3f}, 양쪽 p = {tt.pvalue:.4f}")
print(f"연습 1.5: 무작위화 검정을 뒤집은 95% 구간 ≈ [{min(keep):.2f}, {max(keep):.2f}] (t 구간 {np.round(stats.t.interval(0.95, 14, dz.mean(), dz.std(ddof=1) / math.sqrt(15)), 2)})")
report({"예제 1.9: 15쌍, 차이의 합 39.25": len(dz) == 15 and abs(dz.sum() - 39.25) < 1e-12,
        "예제 1.9: 2^15 = 32768 가운데 863 개, 한쪽 p = 0.0263, 양쪽 0.0527": len(Sz) == 32768 and cnt == 863 and round(p1, 4) == 0.0263 and round(p2, 4) == 0.0527,
        "예제 1.9: 대응 t 의 양쪽 p = 0.0497": round(tt.pvalue, 4) == 0.0497,
        "연습 1.5: 뒤집은 구간은 0 을 경계 근처에서 포함하고 관측 평균을 포함": min(keep) <= 0.05 and max(keep) >= dz.mean()})
text
15쌍, 합 39.25: 한쪽 863/32768 = 0.0263, 양쪽 0.0527;  대응 t: t = 2.148, 양쪽 p = 0.0497
연습 1.5: 무작위화 검정을 뒤집은 95% 구간 ≈ [-0.02, 5.12] (t 구간 [0.   5.23])
  ✓  예제 1.9: 15쌍, 차이의 합 39.25
  ✓  예제 1.9: 2^15 = 32768 가운데 863 개, 한쪽 p = 0.0263, 양쪽 0.0527
  ✓  예제 1.9: 대응 t 의 양쪽 p = 0.0497
  ✓  연습 1.5: 뒤집은 구간은 0 을 경계 근처에서 포함하고 관측 평균을 포함
숫자 읽기. 작은 예에서 모든 배정을 열거하면 Neyman의 분산 공식은 근사가 아니라 등식이다. 정규분포도 큰 표본도 쓰지 않았다. Darwin의 15쌍에서 무작위화 검정의 양쪽 과 검정의 이 거의 같다. Fisher가 검정을 "무작위화 검정의 근사"로 정당화한 근거가 이것이다. 뒤집은 신뢰구간은 0을 겨우 포함한다.
📝 연습 1.1–1.5 (강의노트): 컵 여섯 개, 두 단위, 유한 모집단의 표본분산, 정확하지만 보수적, 효과가 일정하다는 가설.
2. 일원분산분석과 비중심 분포
정리 2.2 , = 가능도비 검정 · 정리 2.5 비중심 : mgf, Poisson 혼합, 평균 , 분산 , 에 대해 단조 · 따름정리 2.6 · 정리 2.8 의 검정력, · 예제 2.9 반복 수.
python
# 정리 2.2 · 예제 2.3: 귀리를 질소만으로
Yo = load_rdata("yates.oats", "agridat"); yo = Yo["yield"].to_numpy(float); No = len(yo)
levels = sorted(Yo.nitro.unique()); Xo = np.column_stack([(Yo.nitro == l).to_numpy(float) for l in levels])
Ho = Xo @ np.linalg.solve(Xo.T @ Xo, Xo.T); Jo = np.full((No, No), 1 / No)
SST, SSB, SSW = yo @ (np.eye(No) - Jo) @ yo, yo @ (Ho - Jo) @ yo, yo @ (np.eye(No) - Ho) @ yo
F1 = (SSB / 3) / (SSW / (No - 4)); p1w = stats.f.sf(F1, 3, No - 4)
means_o = np.array([yo[Yo.nitro == l].mean() for l in levels])
fo = stats.f_oneway(*[yo[Yo.nitro == l] for l in levels])
s2_i = np.array([yo[Yo.nitro == l].var(ddof=1) for l in levels])
lam_lrt = (SSW / (SSW + SSB)) ** (No / 2)
# 연습 2.2: 두 수준만 — F = t²
a_, b_ = yo[Yo.nitro == 0.0], yo[Yo.nitro == 0.6]
F2 = stats.f_oneway(a_, b_).statistic; t2 = stats.ttest_ind(a_, b_).statistic
print(f"질소 평균 {np.round(means_o, 2)};  SS_B = {SSB:.1f} (3), SS_W = {SSW:.1f} ({No - 4}), F = {F1:.2f}, p = {p1w:.1e}, s = {math.sqrt(SSW / 68):.2f}")
report({"정리 2.2: H − J, I − H 는 계수 3, 68 의 사영, SS_T = SS_B + SS_W": np.linalg.matrix_rank(Ho - Jo) == 3 and np.linalg.matrix_rank(np.eye(No) - Ho) == 68 and abs(SST - SSB - SSW) < 1e-6,
        "예제 2.3: 평균 79.4, 98.9, 114.2, 123.4": np.allclose(np.round(means_o, 1), [79.4, 98.9, 114.2, 123.4]),
        "예제 2.3: SS_B = 20020.5, SS_W = 31965.4, F = 14.20, p = 2.8e−7, s = 21.7":
            round(SSB, 1) == 20020.5 and round(SSW, 1) == 31965.4 and round(F1, 2) == 14.20 and round(p1w * 1e7, 1) == 2.8 and round(math.sqrt(SSW / 68), 1) == 21.7,
        "정리 2.2 = scipy f_oneway": abs(fo.statistic - F1) < 1e-9,
        "연습 2.1: SS_W = Σ(n_i − 1)s_i², SS_B = Σn_i ȳ_i² − N ȳ²": abs(SSW - np.sum(17 * s2_i)) < 1e-6 and abs(SSB - (18 * np.sum(means_o**2) - No * yo.mean() ** 2)) < 1e-6,
        "정리 2.2: 가능도비 = (1 + (t−1)F/(N−t))^{−N/2}": abs(lam_lrt - (1 + 3 * F1 / 68) ** (-No / 2)) < 1e-12,
        "연습 2.2: t = 2 이면 F = t²": abs(F2 - t2**2) < 1e-9})
text
질소 평균 [ 79.39  98.89 114.22 123.39];  SS_B = 20020.5 (3), SS_W = 31965.4 (68), F = 14.20, p = 2.8e-07, s = 21.68
  ✓  정리 2.2: H − J, I − H 는 계수 3, 68 의 사영, SS_T = SS_B + SS_W
  ✓  예제 2.3: 평균 79.4, 98.9, 114.2, 123.4
  ✓  예제 2.3: SS_B = 20020.5, SS_W = 31965.4, F = 14.20, p = 2.8e−7, s = 21.7
  ✓  정리 2.2 = scipy f_oneway
  ✓  연습 2.1: SS_W = Σ(n_i − 1)s_i², SS_B = Σn_i ȳ_i² − N ȳ²
  ✓  정리 2.2: 가능도비 = (1 + (t−1)F/(N−t))^{−N/2}
  ✓  연습 2.2: t = 2 이면 F = t²
python
# 정리 2.5: 비중심 χ²
k_, lam_ = 3, 6.0
mu_vec = np.array([math.sqrt(lam_), 0, 0]); mu_rot = np.array([1.0, -1.0, 2.0]) / math.sqrt(6) * math.sqrt(lam_)
Xa = rng.standard_normal((200_000, 3)) + mu_vec; Xb = rng.standard_normal((200_000, 3)) + mu_rot
qa, qb = (Xa**2).sum(1), (Xb**2).sum(1)
grid = np.linspace(0.5, 30, 12)
mix_cdf = np.array([sum(stats.poisson.pmf(j, lam_ / 2) * stats.chi2.cdf(x, k_ + 2 * j) for j in range(80)) for x in grid])
mono = all(np.all(np.diff([stats.ncx2.sf(c, 3, l) for l in np.linspace(0.1, 20, 40)]) > 0) for c in (2, 8, 15))
# mgf: E exp(t Q) at t = 0.2
tm = 0.2; mgf_formula = (1 - 2 * tm) ** (-k_ / 2) * math.exp(lam_ * tm / (1 - 2 * tm))
mgf_mc = np.mean(np.exp(tm * qa))
print(f"평균 {qa.mean():.3f} (k+λ = {k_ + lam_}), 분산 {qa.var():.2f} (2k+4λ = {2 * k_ + 4 * lam_});  mgf(0.2) 모의 {mgf_mc:.3f}, 공식 {mgf_formula:.3f}")
report({"정리 2.5 (a): 같은 ‖μ‖ 이면 같은 분포 (두 표본 KS)": stats.ks_2samp(qa, qb).pvalue > 1e-3,
        "정리 2.5 (b): mgf (1−2t)^{−k/2} exp(λt/(1−2t))": abs(mgf_mc / mgf_formula - 1) < 0.02,
        "정리 2.5 (c): Poisson(λ/2) 혼합의 cdf = scipy ncx2": np.allclose(mix_cdf, stats.ncx2.cdf(grid, k_, lam_), atol=1e-10),
        "정리 2.5 (d): 평균 k + λ, 분산 2k + 4λ": within(qa.mean(), k_ + lam_, math.sqrt(30 / 200_000)) and abs(qa.var() / 30 - 1) < 0.02,
        "정리 2.5 (e): P(χ²(k,λ) > c) 는 λ 의 증가함수": mono,
        "연습 2.4: Var (Z + a)² = 2 + 4a²": abs(((rng.standard_normal(400_000) + 1.5) ** 2).var() / (2 + 4 * 2.25) - 1) < 0.02})
text
평균 8.976 (k+λ = 9.0), 분산 29.86 (2k+4λ = 30.0);  mgf(0.2) 모의 15.639, 공식 15.899
  ✓  정리 2.5 (a): 같은 ‖μ‖ 이면 같은 분포 (두 표본 KS)
  ✓  정리 2.5 (b): mgf (1−2t)^{−k/2} exp(λt/(1−2t))
  ✓  정리 2.5 (c): Poisson(λ/2) 혼합의 cdf = scipy ncx2
  ✓  정리 2.5 (d): 평균 k + λ, 분산 2k + 4λ
  ✓  정리 2.5 (e): P(χ²(k,λ) > c) 는 λ 의 증가함수
  ✓  연습 2.4: Var (Z + a)² = 2 + 4a²
python
# 따름정리 2.6 · 정리 2.8 · 예제 2.9 · 연습 2.3 · 2.5: 귀리 질소의 검정력
mu_n = means_o.copy(); sig_sp = math.sqrt(7968.75 / 45)            # 3절의 세구 오차
def power_oats(n_, sig_):
    lam = n_ * np.sum((mu_n - mu_n.mean()) ** 2) / sig_**2
    return stats.ncf.sf(stats.f.ppf(0.95, 3, 4 * n_ - 4), 3, 4 * n_ - 4, lam), lam
pw = {n_: power_oats(n_, sig_sp)[0] for n_ in (2, 3, 4)}
n_double = next(n_ for n_ in range(2, 40) if power_oats(n_, 2 * sig_sp)[0] >= 0.8)
# 모의: n = 3, 수준마다 3 개
n3 = 3; Xs = np.kron(np.eye(4), np.ones((n3, 1))); Hs = Xs @ np.linalg.solve(Xs.T @ Xs, Xs.T); Js = np.full((12, 12), 1 / 12)
Ysim = Xs @ mu_n + sig_sp * rng.standard_normal((100_000, 12))
qB = np.einsum("ij,jk,ik->i", Ysim, Hs - Js, Ysim); qW = np.einsum("ij,jk,ik->i", Ysim, np.eye(12) - Hs, Ysim)
Fs = (qB / 3) / (qW / 8); lam3 = power_oats(3, sig_sp)[1]
# 일반식 (Cβ)'W^{-1}(Cβ)/σ² 와 Σ n(μ − μ̄)²/σ² 가 같다 (C = μ_i − μ_4)
Cm = np.column_stack([np.eye(3), -np.ones(3)]); Wm = Cm @ np.linalg.inv(Xs.T @ Xs) @ Cm.T
lam_gen = (Cm @ mu_n) @ np.linalg.solve(Wm, Cm @ mu_n) / sig_sp**2
print(f"σ = {sig_sp:.1f}: 검정력 {', '.join(f'n={k}: {v:.2f}' for k, v in pw.items())};  모의(n=3) {np.mean(Fs > stats.f.ppf(0.95, 3, 8)):.3f};  σ 두 배면 n = {n_double}")
report({"따름정리 2.6: SS_B/σ² ~ χ²(3, μ'(H−J)μ/σ²)": stats.kstest(qB / sig_sp**2, stats.ncx2(3, lam3).cdf).pvalue > 1e-3,
        "정리 2.8: F ~ 비중심 F(3, 8, λ)": stats.kstest(Fs, stats.ncf(3, 8, lam3).cdf).pvalue > 1e-3,
        "정리 2.8 · 연습 2.3: 일반식의 λ = Σ n_i(μ_i − μ̄)²/σ²": abs(lam_gen - lam3) < 1e-9,
        "예제 2.9: σ = 13.3, 검정력 n = 2: 0.44, 3: 0.82, 4: 0.96": round(sig_sp, 1) == 13.3 and [round(pw[k], 2) for k in (2, 3, 4)] == [0.44, 0.82, 0.96],
        "예제 2.9: 모의 검정력도 0.82": within(np.mean(Fs > stats.f.ppf(0.95, 3, 8)), pw[3], math.sqrt(0.82 * 0.18 / 100_000)),
        "연습 2.5: σ 가 두 배면 수준당 8 구획": n_double == 8})
text
σ = 13.3: 검정력 n=2: 0.44, n=3: 0.82, n=4: 0.96; 모의(n=3) 0.821; σ 두 배면 n = 8text
  ✓  따름정리 2.6: SS_B/σ² ~ χ²(3, μ'(H−J)μ/σ²)
  ✓  정리 2.8: F ~ 비중심 F(3, 8, λ)
  ✓  정리 2.8 · 연습 2.3: 일반식의 λ = Σ n_i(μ_i − μ̄)²/σ²
  ✓  예제 2.9: σ = 13.3, 검정력 n = 2: 0.44, 3: 0.82, 4: 0.96
  ✓  예제 2.9: 모의 검정력도 0.82
  ✓  연습 2.5: σ 가 두 배면 수준당 8 구획
숫자 읽기. 비중심 는 평균 벡터의 방향과 무관하고 길이 만 본다. 그래서 검정력은 "평균들이 얼마나 흩어졌는가"를 오차로 잰 하나로 정해진다. 귀리의 질소 효과는 수준당 세 구획이면 80%를 넘는다. 오차가 두 배면 네 배가 아니라 2.7배(8구획)로 충분한 것은 반복이 늘면서 분모의 자유도도 늘기 때문이다.
📝 연습 2.1–2.5 (강의노트): 제곱합의 공식, 두 표본이면, 비중심도의 계산, 평균과 분산, 오차가 두 배면.
3. 블록과 이원분산분석
정리 3.2 균형 이원배치의 다섯 직교공간 · 예제 3.3 Broadbalk 74년 · 정의 3.4 Tukey의 비가법성 1자유도 · 예제 3.5 Yates의 귀리 분할구 · 명제 3.6 분할구의 기대평균제곱.
python
def twoway_projections(A, B):
    """정리 3.2: 균형 이원배치의 다섯 사영 (A, B 는 수준 번호 배열)"""
    N = len(A); one = np.ones(N)
    def avg_proj(labels):                       # 같은 라벨끼리의 평균으로 보내는 사영
        Z = np.column_stack([(labels == l).astype(float) for l in np.unique(labels)])
        return Z @ np.linalg.solve(Z.T @ Z, Z.T)
    J = np.outer(one, one) / N
    PA, PB = avg_proj(A), avg_proj(B)
    PAB = avg_proj(np.array([f"{a}|{b}" for a, b in zip(A, B)]))
    return dict(V0=J, VA=PA - J, VB=PB - J, VAB=PAB - PA - PB + J, VE=np.eye(N) - PAB)

# 귀리: 품종(3) × 질소(4), 칸마다 6 (블록을 반복으로)
P5 = twoway_projections(Yo.gen.to_numpy(), Yo.nitro.to_numpy())
ranks = {k: int(round(np.trace(v))) for k, v in P5.items()}
orth = all(np.allclose(P5[a] @ P5[b], 0, atol=1e-10) for a, b in itertools.combinations(P5, 2))
idem = all(np.allclose(v @ v, v, atol=1e-10) for v in P5.values())
total = sum(P5.values())
# 사영 = 평균의 차 공식
gm = yo.mean(); mA = Yo.groupby("gen")["yield"].transform("mean").to_numpy(); mB = Yo.groupby("nitro")["yield"].transform("mean").to_numpy()
mAB = Yo.groupby(["gen", "nitro"])["yield"].transform("mean").to_numpy()
formula_ok = np.allclose(P5["VAB"] @ yo, mAB - mA - mB + gm) and np.allclose(P5["VA"] @ yo, mA - gm) and np.allclose(P5["VE"] @ yo, yo - mAB)
print("차원:", ranks)
report({"정리 3.2: 다섯 공간은 서로 직교하고 멱등, 합은 I": orth and idem and np.allclose(total, np.eye(No)),
        "정리 3.2: 차원 1, a−1 = 2, b−1 = 3, (a−1)(b−1) = 6, ab(r−1) = 60": ranks == dict(V0=1, VA=2, VB=3, VAB=6, VE=60),
        "정리 3.2: 사영은 평균의 차 (ȳ_ij − ȳ_i − ȳ_j + ȳ 등)": formula_ok})
text
차원: {'V0': 1, 'VA': 2, 'VB': 3, 'VAB': 6, 'VE': 60}
  ✓  정리 3.2: 다섯 공간은 서로 직교하고 멱등, 합은 I
  ✓  정리 3.2: 차원 1, a−1 = 2, b−1 = 3, (a−1)(b−1) = 6, ab(r−1) = 60
  ✓  정리 3.2: 사영은 평균의 차 (ȳ_ij − ȳ_i − ȳ_j + ȳ 등)
python
# 예제 3.3 · 연습 3.3 · 정의 3.4: Broadbalk 74년 × 17구획
Bb = load_rdata("broadbalk.wheat", "agridat")
Pb = Bb.pivot(index="year", columns="plot", values="grain"); Ym = Pb.to_numpy(float); ny, npl = Ym.shape
g = Ym.mean(); ra, cb_ = Ym.mean(1) - g, Ym.mean(0) - g
SSy, SSp = npl * np.sum(ra**2), ny * np.sum(cb_**2); SSt = np.sum((Ym - g) ** 2); SSe = SSt - SSy - SSp
dfe = (ny - 1) * (npl - 1); MSe = SSe / dfe
Fy, Fp = SSy / (ny - 1) / MSe, SSp / (npl - 1) / MSe
pm = Pb.mean(axis=0)
def tukey_nonadd(M):
    g_ = M.mean(); a_ = M.mean(1) - g_; b_ = M.mean(0) - g_
    e_ = M - g_ - a_[:, None] - b_[None, :]
    ssn = np.sum(M * np.outer(a_, b_)) ** 2 / (np.sum(a_**2) * np.sum(b_**2))
    ssr = np.sum(e_**2); df_ = (M.shape[0] - 1) * (M.shape[1] - 1)
    z = np.outer(a_, b_); ssn_reg = np.sum(e_ * z) ** 2 / np.sum(z**2)            # 연습 3.4: 잔차를 a_i b_j 에 회귀
    Fn = ssn / ((ssr - ssn) / (df_ - 1))
    return Fn, stats.f.sf(Fn, 1, df_ - 1), abs(ssn - ssn_reg) < 1e-9
Fn, pn, reg_ok = tukey_nonadd(Ym); FnL, pnL, _ = tukey_nonadd(np.log(Ym))
print(f"SS 해 {SSy:.1f} ({ny - 1}), 구획 {SSp:.1f} ({npl - 1}), 나머지 {SSe:.1f} ({dfe});  비율 {SSy / SSt:.2f}, {SSp / SSt:.2f}, {SSe / SSt:.2f};  F 해 {Fy:.1f}, 구획 {Fp:.1f}")
print("구획 평균:", pm.round(2).to_dict())
print(f"Tukey 비가법성: F = {Fn:.1f} (p = {pn:.1e});  로그 수확 F = {FnL:.1f}")
report({"예제 3.3: 1852–1925년 74년 × 17구획, 빈칸 없음": (ny, npl) == (74, 17) and Pb.index.min() == 1852 and Pb.index.max() == 1925 and not Pb.isna().any().any(),
        "예제 3.3: SS 316.6 (73), 253.1 (16), 144.2 (1168)": [round(v, 1) for v in (SSy, SSp, SSe)] == [316.6, 253.1, 144.2] and dfe == 1168,
        "예제 3.3 · 연습 3.3: 비율 44%·35%·20%, F 해 35.1, 구획 128.1": [round(v, 2) for v in (SSy / SSt, SSp / SSt, SSe / SSt)] == [0.44, 0.35, 0.20] and round(Fy, 1) == 35.1 and round(Fp, 1) == 128.1,
        "예제 3.3: 구획 평균 3번 0.85, 5번 0.98, 6·7·8번 1.57·2.22·2.53, 2번 2.44":
            [round(pm[k], 2) for k in ["P03", "P05", "P06", "P07", "P08", "P02"]] == [0.85, 0.98, 1.57, 2.22, 2.53, 2.44],
        "정의 3.4 · 연습 3.4: SS_N = 잔차를 â_i b̂_j 에 회귀한 제곱합": reg_ok,
        "3.1절: Tukey F = 73.7 (p ≈ 3e−17), 로그 수확이면 17.7": round(Fn, 1) == 73.7 and round(pn * 1e17) == 3 and round(FnL, 1) == 17.7})
text
SS 해 316.6 (73), 구획 253.1 (16), 나머지 144.2 (1168);  비율 0.44, 0.35, 0.20;  F 해 35.1, 구획 128.1
구획 평균: {'P02': 2.44, 'P03': 0.85, 'P05': 0.98, 'P06': 1.57, 'P07': 2.22, 'P08': 2.53, 'P09': 1.93, 'P10': 1.39, 'P11': 1.56, 'P12': 1.98, 'P13': 2.14, 'P14': 1.95, 'P15': 2.03, 'P16': 2.03, 'P17': 1.52, 'P18': 1.52, 'P19': 1.82}
Tukey 비가법성: F = 73.7 (p = 2.8e-17);  로그 수확 F = 17.7
  ✓  예제 3.3: 1852–1925년 74년 × 17구획, 빈칸 없음
  ✓  예제 3.3: SS 316.6 (73), 253.1 (16), 144.2 (1168)
  ✓  예제 3.3 · 연습 3.3: 비율 44%·35%·20%, F 해 35.1, 구획 128.1
  ✓  예제 3.3: 구획 평균 3번 0.85, 5번 0.98, 6·7·8번 1.57·2.22·2.53, 2번 2.44
  ✓  정의 3.4 · 연습 3.4: SS_N = 잔차를 â_i b̂_j 에 회귀한 제곱합
  ✓  3.1절: Tukey F = 73.7 (p ≈ 3e−17), 로그 수확이면 17.7
python
# 예제 3.5 · 명제 3.6 · 7.2절: Yates 의 귀리 분할구
one72 = np.ones((No, 1)); Xb_, Xg_, Xn_ = dummies(Yo.block), dummies(Yo.gen), dummies(Yo.nitro.astype(str))
Xbg = np.column_stack([Xb_[:, i] * Xg_[:, j] for i in range(Xb_.shape[1]) for j in range(Xg_.shape[1])])
Xgn = np.column_stack([Xg_[:, i] * Xn_[:, j] for i in range(Xg_.shape[1]) for j in range(Xn_.shape[1])])
seq = [("블록", Xb_), ("품종", Xg_), ("주구 오차", Xbg), ("질소", Xn_), ("품종×질소", Xgn)]
Xc = one72; r_prev, k_prev = rss_of(Xc, yo); tab = {}
for name, D in seq:
    Xc = np.column_stack([Xc, D]); r_new, k_new = rss_of(Xc, yo); tab[name] = (r_prev - r_new, k_new - k_prev); r_prev, k_prev = r_new, k_new
tab["세구 오차"] = (r_prev, No - k_prev)
ms = {k: v[0] / v[1] for k, v in tab.items()}
F_var = ms["품종"] / ms["주구 오차"]; F_nit = ms["질소"] / ms["세구 오차"]; F_int = ms["품종×질소"] / ms["세구 오차"]
p_var, p_nit, p_int = stats.f.sf(F_var, 2, 10), stats.f.sf(F_nit, 3, 45), stats.f.sf(F_int, 6, 45)
# 잘못된 분석: 두 오차를 합친 잔차
ms_pool = (tab["주구 오차"][0] + tab["세구 오차"][0]) / 55; F_naive = ms["품종"] / ms_pool
print(pd.DataFrame({k: dict(df=v[1], SS=round(v[0], 1), MS=round(ms[k], 1)) for k, v in tab.items()}).T.to_string())
print(f"F 품종 {F_var:.2f} (p {p_var:.2f}), 질소 {F_nit:.2f} (p {p_nit:.1e}), 상호작용 {F_int:.2f} (p {p_int:.2f});  합친 잔차로 품종 F = {F_naive:.2f} (p {stats.f.sf(F_naive, 2, 55):.3f})")
report({"예제 3.5: 자유도 5·2·10·3·6·45": [tab[k][1] for k in ["블록", "품종", "주구 오차", "질소", "품종×질소", "세구 오차"]] == [5, 2, 10, 3, 6, 45],
        "예제 3.5: SS 15875.3, 1786.4, 6013.3, 20020.5, 321.7, 7968.8":
            [round(tab[k][0], 1) for k in ["블록", "품종", "주구 오차", "질소", "품종×질소", "세구 오차"]] == [15875.3, 1786.4, 6013.3, 20020.5, 321.7, 7968.8],
        "예제 3.5: F 품종 1.49 (p 0.27), 질소 37.69 (p < 1e−11), 상호작용 0.30 (p 0.93)":
            round(F_var, 2) == 1.49 and round(p_var, 2) == 0.27 and round(F_nit, 2) == 37.69 and p_nit < 1e-11 and round(F_int, 2) == 0.30 and round(p_int, 2) == 0.93,
        "3.2절: 주구 오차 601.3 은 세구 오차 177.1 의 3.4배": round(ms["주구 오차"], 1) == 601.3 and round(ms["세구 오차"], 1) == 177.1 and round(ms["주구 오차"] / ms["세구 오차"], 1) == 3.4,
        "예제 7.2: 합친 잔차(254.2, 자유도 55)로 품종을 검정하면 F = 3.51, p = 0.037": round(ms_pool, 1) == 254.2 and round(F_naive, 2) == 3.51 and round(stats.f.sf(F_naive, 2, 55), 3) == 0.037})
text
         df       SS      MS
블록      5.0  15875.3  3175.1
품종      2.0   1786.4   893.2
주구 오차  10.0   6013.3   601.3
질소      3.0  20020.5  6673.5
품종×질소   6.0    321.7    53.6
세구 오차  45.0   7968.8   177.1
F 품종 1.49 (p 0.27), 질소 37.69 (p 2.5e-12), 상호작용 0.30 (p 0.93);  합친 잔차로 품종 F = 3.51 (p 0.037)
  ✓  예제 3.5: 자유도 5·2·10·3·6·45
  ✓  예제 3.5: SS 15875.3, 1786.4, 6013.3, 20020.5, 321.7, 7968.8
  ✓  예제 3.5: F 품종 1.49 (p 0.27), 질소 37.69 (p < 1e−11), 상호작용 0.30 (p 0.93)
  ✓  3.2절: 주구 오차 601.3 은 세구 오차 177.1 의 3.4배
  ✓  예제 7.2: 합친 잔차(254.2, 자유도 55)로 품종을 검정하면 F = 3.51, p = 0.037
python
# 명제 3.6 · 연습 3.5: 주구 효과가 있는 세계를 만들어 두 평균제곱의 기댓값을 확인
sw, se_ = 2.0, 1.0
wp = (Yo.block + "_" + Yo.gen).to_numpy(); wp_codes = pd.factorize(wp)[0]
Xfull = np.column_stack([one72, Xb_, Xg_, Xbg, Xn_, Xgn]); Xwp = np.column_stack([one72, Xb_, Xg_])
Hfull = Xfull @ np.linalg.pinv(Xfull); Hw = np.column_stack([one72, Xb_, Xg_, Xbg]) @ np.linalg.pinv(np.column_stack([one72, Xb_, Xg_, Xbg]))
Hbg = Xwp @ np.linalg.pinv(Xwp)
P_wp = Hw - Hbg; P_sp = np.eye(No) - Hfull
Ind_ = np.eye(18)[wp_codes]; Pw_ = Ind_ @ np.linalg.pinv(Ind_)            # 주구 표시 벡터 18개의 공간
gs = np.random.default_rng(1935); Rr = 20_000
eta = gs.normal(0, sw, (Rr, 18))[:, wp_codes]; eps = gs.normal(0, se_, (Rr, No)); Yw = eta + eps
ms_wp = np.einsum("ij,jk,ik->i", Yw, P_wp, Yw) / 10; ms_sp = np.einsum("ij,jk,ik->i", Yw, P_sp, Yw) / 45
# 연습 3.5: 품종 평균의 차의 분산
gen = Yo.gen.to_numpy(); dv = Yw[:, gen == "GoldenRain"].mean(1) - Yw[:, gen == "Victory"].mean(1)
print(f"E MS 주구 오차: 모의 {ms_wp.mean():.3f} (σ² + 4σ_w² = {se_**2 + 4 * sw**2}),  세구 오차: {ms_sp.mean():.3f} (σ² = {se_**2});  품종 차의 분산 {dv.var():.4f} ((4σ_w² + σ²)/12 = {(4 * sw**2 + se_**2) / 12:.4f})")
report({"명제 3.6: E MS_주구 = σ² + 4σ_w²": within(ms_wp.mean(), se_**2 + 4 * sw**2, ms_wp.std() / math.sqrt(Rr)),
        "명제 3.6: E MS_세구 = σ²": within(ms_sp.mean(), se_**2, ms_sp.std() / math.sqrt(Rr)),
        "명제 3.6: 주구 오차 공간 ⊂ 주구 표시 공간 (P P_w = P), 세구 오차 ⊥ 주구 표시 공간, K = 4P_w":
            np.allclose(P_wp @ Pw_, P_wp, atol=1e-10) and np.allclose(P_sp @ Ind_, 0, atol=1e-10) and np.allclose(Ind_ @ Ind_.T, 4 * Pw_),
        "연습 3.5: 두 품종 평균의 차의 분산 = (4σ_w² + σ²)/12": abs(dv.var() / ((4 * sw**2 + se_**2) / 12) - 1) < 0.03})
text
E MS 주구 오차: 모의 17.003 (σ² + 4σ_w² = 17.0), 세구 오차: 1.000 (σ² = 1.0); 품종 차의 분산 1.4292 ((4σ_w² + σ²)/12 = 1.4167)text
  ✓  명제 3.6: E MS_주구 = σ² + 4σ_w²
  ✓  명제 3.6: E MS_세구 = σ²
  ✓  명제 3.6: 주구 오차 공간 ⊂ 주구 표시 공간 (P P_w = P), 세구 오차 ⊥ 주구 표시 공간, K = 4P_w
  ✓  연습 3.5: 두 품종 평균의 차의 분산 = (4σ_w² + σ²)/12
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
for plot, col, lab in [("P03", C["hist"], "3: none"), ("P05", C["data"], "5: minerals"), ("P06", C["stat"], "6: + N1"), ("P08", C["theta"], "8: + N3"), ("P02", C["assume"], "2b: manure")]:
    axes[0].plot(Pb.index, Pb[plot].rolling(5, center=True).mean(), color=col, lw=1.4, label=lab)
axes[0].set_ylabel("grain (t/ha), 5-yr mean"); axes[0].legend(fontsize=8, ncol=2); axes[0].set_title("Broadbalk: manure and weather")
tabm = Yo.pivot_table(index="nitro", columns="gen", values="yield", aggfunc="mean")
for gname, col in zip(tabm.columns, [C["stat"], C["data"], C["assume"]]):
    axes[1].plot(tabm.index, tabm[gname], "o-", color=col, label=gname)
axes[1].set_xlabel("nitrogen (cwt/acre)"); axes[1].legend(); axes[1].set_title(f"oats: interaction F = {F_int:.2f}")
plt.tight_layout(); plt.show()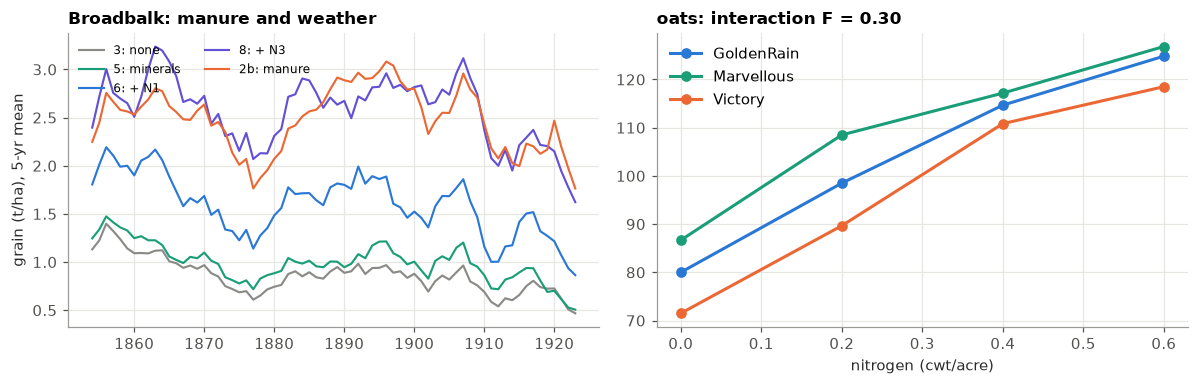
그림 읽기. 왼쪽: Broadbalk의 다섯 구획은 해마다 함께 오르내린다(날씨). 그 위에 질소와 두엄이 만든 층이 있다. 좋은 해에 거름을 많이 준 구획이 더 많이 오르는 것이 Tukey의 비가법성 검정()이 잡은 것이다. 오른쪽: 귀리의 세 품종은 질소에 거의 평행하게 반응한다. 품종의 차이(주구 오차로 )는 우연과 가려지지 않고, 질소는 뚜렷하다. 주구 오차가 세구 오차의 3.4배라는 사실은 무작위화가 일어난 단위의 크기가 오차를 정한다는 것을 숫자로 보여 준다.
📝 연습 3.1–3.5 (강의노트): 무작위 블록의 표, 균형이 하는 일, Broadbalk의 비율, Tukey의 1자유도, 분할구의 품종 비교.
4. 여러 비교를 한꺼번에
명제 4.2 Bonferroni · 보조정리 4.3 · 정리 4.4 Scheffé · 정리 4.6 Tukey · 예제 4.7 질소 수준의 비교 · 예제 4.8 우연만으로 몇 번 틀리나.
python
# 보조정리 4.3: 무작위 u, W 에서 최댓값과 그 위치
W4 = rng.normal(size=(4, 4)); W4 = W4 @ W4.T + np.eye(4); u4 = rng.normal(size=4)
cands = rng.normal(size=(200_000, 4))
ratio = (cands @ u4) ** 2 / np.einsum("ij,jk,ik->i", cands, W4, cands)
astar = np.linalg.solve(W4, u4); best = (astar @ u4) ** 2 / (astar @ W4 @ astar)
# 정리 4.4 · 4.6: 일원배치 (t = 4, n = 18, ν = 68) 에서 동시 포함확률
t4, n18 = 4, 18; nu68 = t4 * (n18 - 1); gsim = np.random.default_rng(1953)
Ysim = gsim.standard_normal((40_000, t4, n18)); mbar = Ysim.mean(2); s2 = Ysim.var(2, ddof=1).mean(1)
dev = mbar - mbar.mean(1, keepdims=True)
sup_contrast = n18 * np.sum(dev**2, 1) / s2                      # sup_c (c'(ȳ−μ))²/(s² Σc²/n) = n Σ(ȳ_i − ȳ)²/s²
cover_scheffe = np.mean(sup_contrast <= (t4 - 1) * stats.f.ppf(0.95, t4 - 1, nu68))
rng_stat = (mbar.max(1) - mbar.min(1)) / np.sqrt(s2 / n18)
cover_tukey = np.mean(rng_stat <= stats.studentized_range.ppf(0.95, t4, nu68))
# Scheffé 의 sup 을 무작위 대비로 확인 (한 표본)
cs = rng.normal(size=(100_000, t4)); cs -= cs.mean(1, keepdims=True)
sup_mc = np.max((cs @ mbar[0]) ** 2 / (s2[0] * np.sum(cs**2, 1) / n18))
print(f"보조정리 4.3: 무작위 a 의 최대 {ratio.max():.4f} ≤ u'W⁻¹u = {u4 @ np.linalg.solve(W4, u4):.4f} = a* 에서의 값 {best:.4f}")
print(f"동시 포함확률: Scheffé (모든 대비) {cover_scheffe:.4f}, Tukey (모든 짝) {cover_tukey:.4f}")
mc = 4 * math.sqrt(0.05 * 0.95 / 40_000)
report({"보조정리 4.3: sup = u'W⁻¹u, a ∝ W⁻¹u 에서 이루어진다": ratio.max() <= best + 1e-9 and abs(best - u4 @ np.linalg.solve(W4, u4)) < 1e-9,
        "정리 4.4: 대비의 sup = (t−1)F·s² 꼴 (무작위 대비가 넘지 못한다)": sup_mc <= sup_contrast[0] + 1e-8 and sup_mc > 0.95 * sup_contrast[0],
        "정리 4.4: Scheffé 의 동시 포함확률 0.95": abs(cover_scheffe - 0.95) < mc,
        "정리 4.6: Tukey 의 동시 포함확률 0.95": abs(cover_tukey - 0.95) < mc})
text
보조정리 4.3: 무작위 a 의 최대 1.6803 ≤ u'W⁻¹u = 1.6808 = a* 에서의 값 1.6808
동시 포함확률: Scheffé (모든 대비) 0.9510, Tukey (모든 짝) 0.9500
  ✓  보조정리 4.3: sup = u'W⁻¹u, a ∝ W⁻¹u 에서 이루어진다
  ✓  정리 4.4: 대비의 sup = (t−1)F·s² 꼴 (무작위 대비가 넘지 못한다)
  ✓  정리 4.4: Scheffé 의 동시 포함확률 0.95
  ✓  정리 4.6: Tukey 의 동시 포함확률 0.95
python
# 예제 4.7 · 연습 4.3 · 4.4: 귀리 질소 수준
mse_sp, nu_sp, nl = ms["세구 오차"], 45, 18
q = stats.studentized_range.ppf(0.95, 4, nu_sp); hsd = q * math.sqrt(mse_sp / nl)
pairs = list(itertools.combinations(range(4), 2))
diffs_n = {(levels[i], levels[j]): means_o[j] - means_o[i] for i, j in pairs}
sig = {k: abs(v) > hsd for k, v in diffs_n.items()}
crit = dict(tukey=q / math.sqrt(2), bonferroni=stats.t.ppf(1 - 0.05 / 12, nu_sp), scheffe=math.sqrt(3 * stats.f.ppf(0.95, 3, nu_sp)))
c_lin = np.array([-3, -1, 1, 3]); est_lin = c_lin @ means_o; se_lin = math.sqrt(mse_sp * np.sum(c_lin**2) / nl)
half_02 = stats.t.ppf(0.975, nu_sp) * math.sqrt(2 * mse_sp / nl)
print(f"q = {q:.3f}, HSD = {hsd:.2f};  차이 {[round(v, 1) for v in diffs_n.values()]};  유의 {list(sig.values())}")
print(f"짝 하나의 기준값: {({k: round(v, 3) for k, v in crit.items()})};  추세 대비 {est_lin:.1f}, SE {se_lin:.2f}, t = {est_lin / se_lin:.1f};  0 대 0.2 의 t 구간 ±{half_02:.1f}")
# scipy 의 tukey_hsd 와 대조 (같은 자료를 질소 수준별 '세구 오차 잔차' 대신 단순 일원배치로)
th = stats.tukey_hsd(*[yo[Yo.nitro == l] for l in levels]); ci_ = th.confidence_interval(); half_scipy = (ci_.high[0, 1] - ci_.low[0, 1]) / 2
half_mine = stats.studentized_range.ppf(0.95, 4, 68) * math.sqrt(SSW / 68 / 18)
report({"예제 4.7: q_{4,45,0.05} = 3.773, HSD = 11.83": round(q, 3) == 3.773 and round(hsd, 2) == 11.83,
        "예제 4.7: 차이 19.5, 34.8, 44.0, 15.3, 24.5, 9.2 — 0.4 와 0.6 만 HSD 보다 작다":
            [round(v, 1) for v in diffs_n.values()] == [19.5, 34.8, 44.0, 15.3, 24.5, 9.2] and [k for k, v in sig.items() if not v] == [(0.4, 0.6)],
        "예제 4.7: 기준값 Tukey 2.668, Bonferroni 2.760, Scheffé 2.904": [round(crit[k], 3) for k in ("tukey", "bonferroni", "scheffe")] == [2.668, 2.760, 2.904],
        "예제 4.7 · 연습 4.4: 추세 대비 147.3, SE 14.0, t = 10.5": round(est_lin, 1) == 147.3 and round(se_lin, 1) == 14.0 and round(est_lin / se_lin, 1) == 10.5,
        "연습 4.3: 0 대 0.2 만 미리 정했다면 19.5 ± 8.9": round(half_02, 1) == 8.9,
        "정리 4.6 = scipy tukey_hsd (단순 일원배치의 구간 반폭)": abs(half_scipy - half_mine) < 1e-6})
text
q = 3.773, HSD = 11.83;  차이 [np.float64(19.5), np.float64(34.8), np.float64(44.0), np.float64(15.3), np.float64(24.5), np.float64(9.2)];  유의 [np.True_, np.True_, np.True_, np.True_, np.True_, np.False_]
짝 하나의 기준값: {'tukey': np.float64(2.668), 'bonferroni': np.float64(2.76), 'scheffe': 2.904};  추세 대비 147.3, SE 14.03, t = 10.5;  0 대 0.2 의 t 구간 ±8.9
text
  ✓  예제 4.7: q_{4,45,0.05} = 3.773, HSD = 11.83
  ✓  예제 4.7: 차이 19.5, 34.8, 44.0, 15.3, 24.5, 9.2 — 0.4 와 0.6 만 HSD 보다 작다
  ✓  예제 4.7: 기준값 Tukey 2.668, Bonferroni 2.760, Scheffé 2.904
  ✓  예제 4.7 · 연습 4.4: 추세 대비 147.3, SE 14.0, t = 10.5
  ✓  연습 4.3: 0 대 0.2 만 미리 정했다면 19.5 ± 8.9
  ✓  정리 4.6 = scipy tukey_hsd (단순 일원배치의 구간 반폭)
python
# 예제 4.8 · 연습 4.1 · 4.2: 6처치 × 5, 15쌍 — 가족 단위 오류율
gf = np.random.default_rng(1953)
t6, n5, R6 = 6, 5, 40_000; nu24 = t6 * (n5 - 1)
Yn = gf.standard_normal((R6, t6, n5)); m6 = Yn.mean(2); s26 = Yn.var(2, ddof=1).mean(1)
iu = np.triu_indices(t6, 1); ts6 = np.abs(m6[:, iu[0]] - m6[:, iu[1]]) / np.sqrt(2 * s26 / n5)[:, None]
crit6 = dict(naive=stats.t.ppf(0.975, nu24), Bonferroni=stats.t.ppf(1 - 0.025 / 15, nu24),
             Tukey=stats.studentized_range.ppf(0.95, t6, nu24) / math.sqrt(2), Scheffé=math.sqrt(5 * stats.f.ppf(0.95, 5, nu24)))
fw = {k: np.mean((ts6 > c).any(1)) for k, c in crit6.items()}
sch_ge_t = all(math.sqrt(qq * stats.f.ppf(0.95, qq, 30)) >= stats.t.ppf(0.975, 30) - 1e-12 for qq in range(1, 10))
print("기준값", {k: round(v, 3) for k, v in crit6.items()}, " FWER", {k: round(v, 3) for k, v in fw.items()})
report({"예제 4.8: FWER 짝마다 5% 0.34, Bonferroni 0.034, Tukey 0.049, Scheffé 0.015":
            round(fw["naive"], 2) == 0.34 and round(fw["Bonferroni"], 3) == 0.034 and round(fw["Tukey"], 3) == 0.049 and round(fw["Scheffé"], 3) == 0.015,
        "연습 4.1: 독립이면 1 − 0.95^15 = 0.54, 짝 비교는 그보다 작다": round(1 - 0.95**15, 2) == 0.54 and fw["naive"] < 1 - 0.95**15,
        "연습 4.2: √(qF_{q,ν}) ≥ t_{ν,α/2}, q = 1 이면 같다": sch_ge_t and abs(math.sqrt(stats.f.ppf(0.95, 1, 30)) - stats.t.ppf(0.975, 30)) < 1e-10})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
se_pair = math.sqrt(2 * mse_sp / nl)
for k, (i, j) in enumerate(pairs):
    dif = means_o[j] - means_o[i]
    for off, (name, cval), col, lw in zip([-0.22, 0, 0.22], [("Scheffé", crit["scheffe"]), ("Tukey", crit["tukey"]), ("Bonferroni", crit["bonferroni"])], [C["theta"], C["stat"], C["assume"]], [1.2, 2.6, 1.2]):
        axes[0].plot([dif - cval * se_pair, dif + cval * se_pair], [k + off] * 2, color=col, lw=lw, label=name if k == 0 else None)
    axes[0].plot(dif, k, "o", color=C["ink"], ms=4)
axes[0].axvline(0, color=C["hist"]); axes[0].set_yticks(range(6), [f"{levels[j]}-{levels[i]}" for i, j in pairs]); axes[0].set_xlim(-8, 82)
axes[0].legend(loc="center right", fontsize=8); axes[0].set_title("oats: simultaneous 95% intervals")
axes[1].bar(list(fw), list(fw.values()), color=[C["key"], C["assume"], C["stat"], C["theta"]], alpha=0.8); axes[1].axhline(0.05, **THEORY)
axes[1].set_title("family-wise error, 6 groups")
plt.tight_layout(); plt.show()
text
기준값 {'naive': np.float64(2.064), 'Bonferroni': np.float64(3.258), 'Tukey': np.float64(3.092), 'Scheffé': 3.62}  FWER {'naive': np.float64(0.338), 'Bonferroni': np.float64(0.034), 'Tukey': np.float64(0.049), 'Scheffé': np.float64(0.015)}
  ✓  예제 4.8: FWER 짝마다 5% 0.34, Bonferroni 0.034, Tukey 0.049, Scheffé 0.015
  ✓  연습 4.1: 독립이면 1 − 0.95^15 = 0.54, 짝 비교는 그보다 작다
  ✓  연습 4.2: √(qF_{q,ν}) ≥ t_{ν,α/2}, q = 1 이면 같다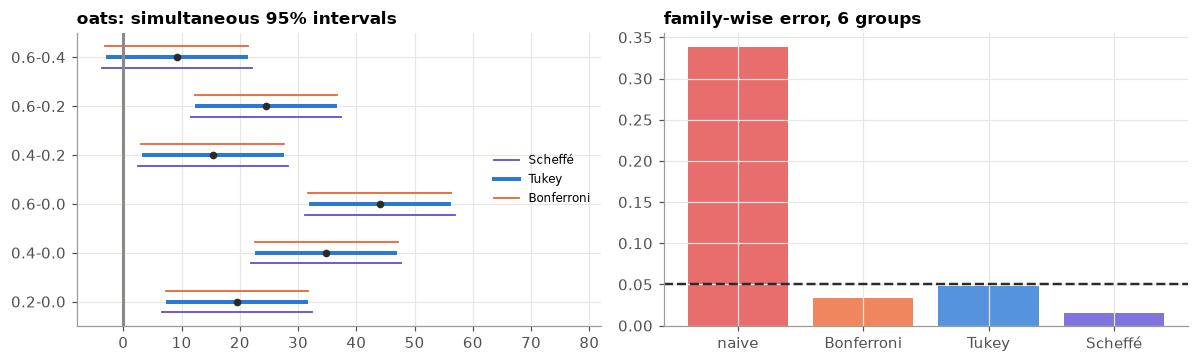
그림 읽기. 왼쪽: 같은 중심에 세 방법의 동시구간을 겹쳤다. 짝 비교만 할 때는 Tukey(굵은 파랑)가 가장 좁고, 0.4–0.6 cwt만 0을 포함한다. 오른쪽: 짝마다 5%로 검정하면 평균이 모두 같아도 세 번에 한 번꼴로 "차이"를 찾는다. Tukey는 정확히 5%, Bonferroni와 Scheffé는 보수적이다. Scheffé는 짝뿐 아니라 자료를 보고 고른 어떤 대비도 보호한다.
📝 연습 4.1–4.4 (강의노트): 독립이라면, Scheffé는 보다 넓다, HSD 계산, 추세 대비.
5. 설계의 원리 — 반복, 무작위화, 국소 관리
정리 5.1 짝 설계의 효율 · 예제 5.2 Mercer–Hall의 짝과 블록 · 정리 5.3 요인설계의 효율 · 예제 5.4 npk.
python
# 정리 5.1 · 예제 5.2: 이웃한 두 열을 짝으로 (행마다 1–2, 3–4, …, 23–24)
Gp = Gmh[:, :24].reshape(20, 12, 2); pa, pb = Gp[..., 0].ravel(), Gp[..., 1].ravel(); m_ = len(pa)
ypair = np.r_[pa, pb]; S2p = ypair.var(ddof=1); Sw2 = np.sum((pa - pb) ** 2) / (2 * m_)
rho_p = np.corrcoef(pa, pb)[0, 1]
var_crd, var_pair = 2 * S2p / m_, 2 * Sw2 / m_
gp = np.random.default_rng(1926 + 1)
Rp = 20_000; d_pair = np.empty(Rp); d_crd = np.empty(Rp)
for r in range(Rp):
    flip = gp.random(m_) < 0.5; d_pair[r] = np.mean(np.where(flip, pa - pb, pb - pa))
    w = np.zeros(2 * m_, bool); w[gp.choice(2 * m_, m_, replace=False)] = True; d_crd[r] = ypair[w].mean() - ypair[~w].mean()
print(f"240쌍: 짝 안의 상관 {rho_p:.3f}, S² = {S2p:.4f}, S_w² = {Sw2:.4f}, 효율 {S2p / Sw2:.3f} (1/(1−ρ) = {1 / (1 - rho_p):.3f})")
print(f"정확한 분산: 완전무작위 {var_crd:.6f}, 짝 {var_pair:.6f};  모의: {d_crd.var():.6f}, {d_pair.var():.6f} (비 {d_crd.var() / d_pair.var():.2f})")
report({"예제 5.2: 짝 안의 상관 0.33, S² = 0.2123, S_w² = 0.1433": round(rho_p, 2) == 0.33 and round(S2p, 4) == 0.2123 and round(Sw2, 4) == 0.1433,
        "정리 5.1 · 예제 5.2: 효율 S²/S_w² = 1.48 ≈ 1/(1−ρ) = 1.49": round(S2p / Sw2, 2) == 1.48 and round(1 / (1 - rho_p), 2) == 1.49,
        "정리 5.1: 무작위화 분산 = 2S²/m, 2S_w²/m (모의와 일치)": abs(d_crd.var() / var_crd - 1) < 0.03 and abs(d_pair.var() / var_pair - 1) < 0.03,
        "예제 5.2: 모의한 분산의 비도 1.5 근처": 1.4 < d_crd.var() / d_pair.var() < 1.6,
        "정리 5.1: 두 설계 모두 불편 (가짜 효과의 평균 0)": within(d_pair.mean(), 0, d_pair.std() / math.sqrt(Rp)) and within(d_crd.mean(), 0, d_crd.std() / math.sqrt(Rp))})
text
240쌍: 짝 안의 상관 0.329, S² = 0.2123, S_w² = 0.1433, 효율 1.481 (1/(1−ρ) = 1.490)
정확한 분산: 완전무작위 0.001770, 짝 0.001194;  모의: 0.001784, 0.001200 (비 1.49)
  ✓  예제 5.2: 짝 안의 상관 0.33, S² = 0.2123, S_w² = 0.1433
  ✓  정리 5.1 · 예제 5.2: 효율 S²/S_w² = 1.48 ≈ 1/(1−ρ) = 1.49
  ✓  정리 5.1: 무작위화 분산 = 2S²/m, 2S_w²/m (모의와 일치)
  ✓  예제 5.2: 모의한 분산의 비도 1.5 근처
  ✓  정리 5.1: 두 설계 모두 불편 (가짜 효과의 평균 0)
python
# 예제 5.2: 이웃한 다섯 구획을 블록으로 (행마다 5블록, 모두 100블록), 가짜 처치 5개
Gb5 = Gmh.reshape(20, 5, 5).reshape(100, 5)
def anova_rcb(Yb):
    bm, tm, g_ = Yb.mean(1, keepdims=True), Yb.mean(0, keepdims=True), Yb.mean()
    sse = np.sum((Yb - bm - tm + g_) ** 2); dfe_ = (Yb.shape[0] - 1) * (Yb.shape[1] - 1)
    return sse / dfe_, (np.sum((tm - g_) ** 2) * Yb.shape[0] / (Yb.shape[1] - 1)) / (sse / dfe_)
def anova_crd(yv, lab, t=5):
    g_ = yv.mean(); ssb = sum(np.sum(lab == k) * (yv[lab == k].mean() - g_) ** 2 for k in range(t)); sse = np.sum((yv - g_) ** 2) - ssb
    dfe_ = len(yv) - t
    return sse / dfe_, (ssb / (t - 1)) / (sse / dfe_)
gb = np.random.default_rng(1926 + 2); Rb = 4000
res = np.array([anova_rcb(np.take_along_axis(Gb5, np.argsort(gb.permuted(np.tile(np.arange(5), (100, 1)), axis=1), axis=1), axis=1))
                + anova_crd(Gb5.ravel(), gb.permutation(np.repeat(np.arange(5), 100))) for _ in range(Rb)])
RE = res[:, 2].mean() / res[:, 0].mean()
size_rcb = np.mean(res[:, 1] > stats.f.ppf(0.95, 4, 396)); size_crd = np.mean(res[:, 3] > stats.f.ppf(0.95, 4, 495))
print(f"평균 MSE: 블록 {res[:, 0].mean():.3f}, 완전무작위 {res[:, 2].mean():.3f}, 상대효율 {RE:.2f};  실제 크기: 블록 {size_rcb:.3f}, 완전무작위 {size_crd:.3f}")
mcb = 4 * math.sqrt(0.05 * 0.95 / Rb)
report({"예제 5.2: 오차의 평균제곱 0.210 → 0.167, 상대효율 1.26": round(res[:, 2].mean(), 3) == 0.210 and round(res[:, 0].mean(), 3) == 0.167 and round(RE, 2) == 1.26,
        "예제 5.2: 두 설계 모두 5% 검정의 실제 크기 0.05": abs(size_rcb - 0.05) < mcb and abs(size_crd - 0.05) < mcb})
text
평균 MSE: 블록 0.167, 완전무작위 0.210, 상대효율 1.26;  실제 크기: 블록 0.051, 완전무작위 0.057
  ✓  예제 5.2: 오차의 평균제곱 0.210 → 0.167, 상대효율 1.26
  ✓  예제 5.2: 두 설계 모두 5% 검정의 실제 크기 0.05
python
# 정리 5.3 · 연습 5.2: 요인설계 대 한 번에 한 요인 — 대비 계수로 정확한 분산
def var_factorial(k, N):
    combos = np.array(list(itertools.product([-1, 1], repeat=k))); per = N // 2**k
    D = np.repeat(combos, per, axis=0)
    c = np.where(D[:, 0] == 1, 1 / (N / 2), -1 / (N / 2))           # 첫 요인의 주효과
    cAB = D[:, 0] * D[:, 1] / (N / 2) / 1.0 if k >= 2 else None
    return np.sum(c**2), (np.sum((D[:, 0] * D[:, 1] / (N / 2)) ** 2) if k >= 2 else None)
def var_ofat(k, N):
    per = N // (k + 1); return 2 / per
eff_ok = all(abs(var_ofat(k, 2**k * (k + 1) * 4) / var_factorial(k, 2**k * (k + 1) * 4)[0] - (k + 1) / 2) < 1e-12 for k in range(1, 6))
vf, vint = var_factorial(3, 24)
# 연습 5.2 의 상호작용 정의 ½[(N,P) − (N) − (P) + (none)] — 각 칸 평균은 6구획
c_int = 0.5 * np.array([1, -1, -1, 1]) / 6
print(f"k = 3, N = 24: 요인설계 Var = {vf:.4f}σ² (= 4/24), OFAT {var_ofat(3, 24):.4f}σ², 상호작용 {np.sum(np.repeat(c_int, 6) ** 2):.4f}σ²")
report({"정리 5.3: 요인설계 4σ²/N, OFAT 2(k+1)σ²/N, 효율 (k+1)/2 (k = 1…5)": eff_ok and abs(vf - 4 / 24) < 1e-12,
        "연습 5.2: k = 3, N = 24 에서 σ²/6 대 σ²/3 (효율 2), 상호작용도 σ²/6": abs(vf - 1 / 6) < 1e-12 and abs(var_ofat(3, 24) - 1 / 3) < 1e-12 and abs(np.sum(np.repeat(c_int, 6) ** 2) - 1 / 6) < 1e-12})
text
k = 3, N = 24: 요인설계 Var = 0.1667σ² (= 4/24), OFAT 0.3333σ², 상호작용 0.1667σ²
  ✓  정리 5.3: 요인설계 4σ²/N, OFAT 2(k+1)σ²/N, 효율 (k+1)/2 (k = 1…5)
  ✓  연습 5.2: k = 3, N = 24 에서 σ²/6 대 σ²/3 (효율 2), 상호작용도 σ²/6
python
# 예제 5.4 · 연습 5.3 · 5.4: npk
npk = load_rdata("npk", "datasets"); ynpk = npk["yield"].to_numpy(float)
N_, P_, K_ = [2 * npk[c].to_numpy() - 1 for c in "NPK"]
Xnpk = np.column_stack([np.ones(24), dummies(npk.block), N_, P_, K_, N_ * P_, N_ * K_, P_ * K_])
rss_npk, rk = rss_of(Xnpk, ynpk); dfe_npk = 24 - rk; mse_npk = rss_npk / dfe_npk
effs = {nm: ynpk[v == 1].mean() - ynpk[v == -1].mean() for nm, v in [("N", N_), ("P", P_), ("K", K_), ("NP", N_ * P_), ("NK", N_ * K_), ("PK", P_ * K_)]}
Fs_npk = {k: 24 * v**2 / 4 / mse_npk for k, v in effs.items()}; ps_npk = {k: stats.f.sf(v, 1, dfe_npk) for k, v in Fs_npk.items()}
npk3 = N_ * P_ * K_
conf_ok = all(len(set(npk3[npk.block == b])) == 1 for b in npk.block.unique())
blk_mean = npk.groupby("block")["yield"].mean()
plus_blocks = sorted(npk.block[npk3 == 1].unique()); minus_blocks = sorted(npk.block[npk3 == -1].unique())
npk_est = ynpk[npk3 == 1].mean() - ynpk[npk3 == -1].mean()
print({k: (round(v, 2), round(Fs_npk[k], 2), round(ps_npk[k], 3)) for k, v in effs.items()}, f"MSE {mse_npk:.2f} (자유도 {dfe_npk});  NPK +1 블록 {plus_blocks}, −1 블록 {minus_blocks}")
# 연습 5.4: OFAT 가 놓치는 2×2
cells = {(0, 0): 10, (1, 0): 10, (0, 1): 10, (1, 1): 16}
main_A = (cells[(1, 0)] + cells[(1, 1)]) / 2 - (cells[(0, 0)] + cells[(0, 1)]) / 2
report({"예제 5.4: N +5.62 (F 12.26, p 0.004), K −3.98 (F 6.17, p 0.029), P −1.18 (F 0.54, p 0.47)":
            [round(effs[k], 2) for k in "NKP"] == [5.62, -3.98, -1.18] and [round(Fs_npk[k], 2) for k in "NKP"] == [12.26, 6.17, 0.54]
            and [round(ps_npk[k], 3) for k in "NK"] == [0.004, 0.029] and round(ps_npk["P"], 2) == 0.47,
        "예제 5.4: 오차 자유도 12, 평균제곱 15.44": dfe_npk == 12 and round(mse_npk, 2) == 15.44,
        "예제 5.4 · 연습 5.3: 블록마다 NPK 부호가 하나 — 블록 2·3·4 가 +1, 1·5·6 이 −1": conf_ok and plus_blocks == [2, 3, 4] and minus_blocks == [1, 5, 6],
        "연습 5.3: NPK 추정량 = 블록 2·3·4 의 평균 − 블록 1·5·6 의 평균": abs(npk_est - (blk_mean[[2, 3, 4]].mean() - blk_mean[[1, 5, 6]].mean())) < 1e-12,
        "연습 5.4: OFAT 는 두 효과 모두 0, 요인설계의 주효과는 각 +3": cells[(1, 0)] - cells[(0, 0)] == 0 and main_A == 3})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
bins = np.linspace(-0.16, 0.16, 60)
axes[0].hist(d_crd, bins=bins, density=True, color=C["assume"], alpha=0.5, label="completely random")
axes[0].hist(d_pair, bins=bins, density=True, color=C["stat"], alpha=0.55, label="paired")
axes[0].legend(); axes[0].set_title(f"Mercer–Hall: efficiency {S2p / Sw2:.2f}")
se_e = math.sqrt(4 * mse_npk / 24)
axes[1].errorbar(range(6), list(effs.values()), yerr=2 * se_e, fmt="o", color=C["stat"], capsize=4); axes[1].axhline(0, color=C["hist"])
axes[1].set_xticks(range(6), list(effs)); axes[1].set_title("npk: effects ± 2 SE")
plt.tight_layout(); plt.show()
text
{'N': (np.float64(5.62), np.float64(12.26), np.float64(0.004)), 'P': (np.float64(-1.18), np.float64(0.54), np.float64(0.475)), 'K': (np.float64(-3.98), np.float64(6.17), np.float64(0.029)), 'NP': (np.float64(-1.88), np.float64(1.38), np.float64(0.263)), 'NK': (np.float64(-2.35), np.float64(2.15), np.float64(0.169)), 'PK': (np.float64(0.28), np.float64(0.03), np.float64(0.863))} MSE 15.44 (자유도 12);  NPK +1 블록 [np.int64(2), np.int64(3), np.int64(4)], −1 블록 [np.int64(1), np.int64(5), np.int64(6)]
  ✓  예제 5.4: N +5.62 (F 12.26, p 0.004), K −3.98 (F 6.17, p 0.029), P −1.18 (F 0.54, p 0.47)
  ✓  예제 5.4: 오차 자유도 12, 평균제곱 15.44
  ✓  예제 5.4 · 연습 5.3: 블록마다 NPK 부호가 하나 — 블록 2·3·4 가 +1, 1·5·6 이 −1
  ✓  연습 5.3: NPK 추정량 = 블록 2·3·4 의 평균 − 블록 1·5·6 의 평균
  ✓  연습 5.4: OFAT 는 두 효과 모두 0, 요인설계의 주효과는 각 +3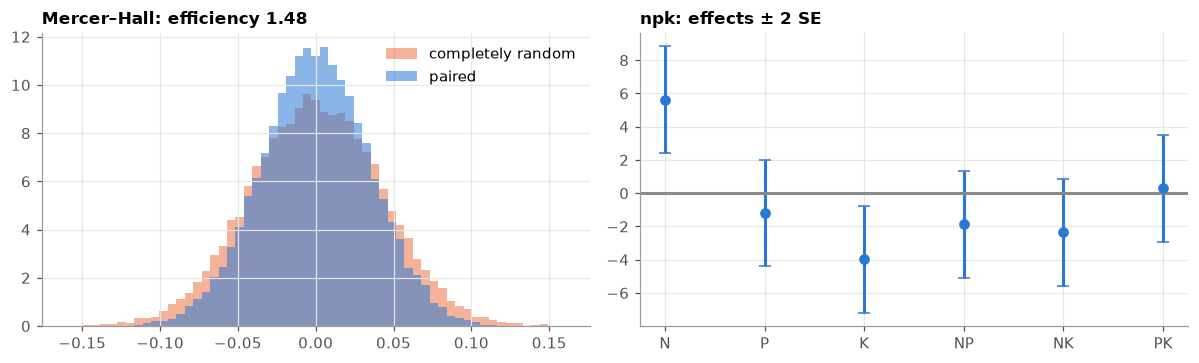
그림 읽기. 왼쪽: 같은 480구획에서, 이웃한 두 구획 안에서만 동전을 던지면 가짜 효과의 분포가 1.5배쯤 좁아진다. 짝의 두 구획이 땅심을 나누기 때문이다(상관 0.33). 오른쪽: 24구획으로 질소의 효과(+5.6파운드)와 칼륨의 효과()를 함께 읽는다. 세 요인을 따로 시험했다면 같은 정밀도에 두 배의 구획이 필요했다(정리 5.3). 대가는 NPK 삼중 상호작용으로, 블록과 섞여 읽을 수 없다.
📝 연습 5.1–5.4 (강의노트): 짝 안의 분산, 세 요인의 요인설계, 교락, OFAT가 놓치는 것.
6. 원자료로 — 1954년 Salk 백신 시험
명제 6.1 · 예제 6.2 무작위 시험의 결론 · 예제 6.3 동의는 무작위가 아니다.
python
Pt = load_rdata("PolioTrials")
Pt["paralytic_100k"] = Pt.Paralytic / Pt.Population * 1e5
Pt["all_100k"] = (Pt.Paralytic + Pt.NonParalytic) / Pt.Population * 1e5
Pt["nonpar_100k"] = Pt.NonParalytic / Pt.Population * 1e5
print(Pt[["Experiment", "Group", "Population", "Paralytic", "NonParalytic", "all_100k", "paralytic_100k"]].round(1).to_string(index=False))
row = lambda e, g: Pt[(Pt.Experiment == e) & (Pt.Group == g)].iloc[0]

def rr_ci(r1, r2, col="Paralytic"):
    a, n1, c, n2 = r1[col], r1.Population, r2[col], r2.Population
    rr = (a / n1) / (c / n2); se = math.sqrt(1 / a - 1 / n1 + 1 / c - 1 / n2)
    return rr, rr * math.exp(-1.96 * se), rr * math.exp(1.96 * se)

v, pl, nc = row("RandomizedControl", "Vaccinated"), row("RandomizedControl", "Placebo"), row("RandomizedControl", "NotInoculated")
ov, oc = row("ObservedControl", "Vaccinated"), row("ObservedControl", "Controls")
rr, lo, hi = rr_ci(v, pl); rr_o = rr_ci(ov, oc)[0]; rr_c, lo_c, hi_c = rr_ci(pl, nc)
tab2 = np.array([[v.Paralytic, v.Population - v.Paralytic], [pl.Paralytic, pl.Population - pl.Paralytic]])
chi = stats.chi2_contingency(tab2, correction=False)
p1_, p2_ = v.Paralytic / v.Population, pl.Paralytic / pl.Population; pp = (v.Paralytic + pl.Paralytic) / (v.Population + pl.Population)
z = (p1_ - p2_) / math.sqrt(pp * (1 - pp) * (1 / v.Population + 1 / pl.Population))
print(f"무작위: RR {rr:.3f} [{lo:.3f}, {hi:.3f}], VE {1 - rr:.0%} [{1 - hi:.3f}, {1 - lo:.3f}];  z = {z:.3f}, χ² = {chi.statistic:.2f}, p = {chi.pvalue:.1e};  관찰 대조: RR {rr_o:.3f}, VE {1 - rr_o:.0%}")
print(f"위약 대 동의하지 않음: RR {rr_c:.2f} [{lo_c:.2f}, {hi_c:.2f}];  비마비형 RR {v.nonpar_100k / pl.nonpar_100k:.2f}, 전체 RR {v.all_100k / pl.all_100k:.2f}")
report({"6절 표: 인원 200,745 · 201,229 · 338,778 · 221,998 · 725,173 · 123,605, 모두 1,829,916명":
            [int(row(e, g).Population) for e, g in [("RandomizedControl", "Vaccinated"), ("RandomizedControl", "Placebo"), ("RandomizedControl", "NotInoculated"),
                                                   ("ObservedControl", "Vaccinated"), ("ObservedControl", "Controls"), ("ObservedControl", "Grade2NotInoculated")]] == [200745, 201229, 338778, 221998, 725173, 123605]
            and int(Pt.Population.sum()) == 1829916,
        "6절 표: 소아마비 10만 명당 28.4 · 70.6 · 46.3 / 25.2 · 53.9 · 43.7":
            [round(row(e, g).all_100k, 1) for e, g in [("RandomizedControl", "Vaccinated"), ("RandomizedControl", "Placebo"), ("RandomizedControl", "NotInoculated"),
                                                      ("ObservedControl", "Vaccinated"), ("ObservedControl", "Controls"), ("ObservedControl", "Grade2NotInoculated")]] == [28.4, 70.6, 46.3, 25.2, 53.9, 43.7],
        "6절 표: 마비형 10만 명당 16.4 · 57.1 · 35.7 / 17.1 · 45.5 · 34.8":
            [round(row(e, g).paralytic_100k, 1) for e, g in [("RandomizedControl", "Vaccinated"), ("RandomizedControl", "Placebo"), ("RandomizedControl", "NotInoculated"),
                                                            ("ObservedControl", "Vaccinated"), ("ObservedControl", "Controls"), ("ObservedControl", "Grade2NotInoculated")]] == [16.4, 57.1, 35.7, 17.1, 45.5, 34.8],
        "예제 6.2 · 연습 6.1: RR 0.288 [0.195, 0.424], VE 71% [0.576, 0.805]": [round(x, 3) for x in (rr, lo, hi)] == [0.288, 0.195, 0.424] and round(1 - rr, 2) == 0.71 and [round(1 - hi, 3), round(1 - lo, 3)] == [0.576, 0.805],
        "예제 6.2 · 연습 6.2: z = −6.73, χ² = 45.3 = z², p = 1.7e−11": round(z, 2) == -6.73 and round(chi.statistic, 1) == 45.3 and abs(z**2 - chi.statistic) < 1e-6 and round(chi.pvalue * 1e11, 1) == 1.7,
        "예제 6.2: 관찰 대조 RR 0.376, VE 62%": round(rr_o, 3) == 0.376 and round(1 - rr_o, 2) == 0.62,
        "예제 6.3: 위약 57.1 대 동의하지 않음 35.7, RR 1.60 [1.24, 2.07]": round(rr_c, 2) == 1.60 and [round(lo_c, 2), round(hi_c, 2)] == [1.24, 2.07],
        "연습 6.3: 전체 RR 0.40, 비마비형 12.0 대 13.4 (RR 0.89)": round(v.all_100k / pl.all_100k, 2) == 0.40 and [round(v.nonpar_100k, 1), round(pl.nonpar_100k, 1)] == [12.0, 13.4] and round(v.nonpar_100k / pl.nonpar_100k, 2) == 0.89})
text
       Experiment                  Group  Population  Paralytic  NonParalytic  all_100k  paralytic_100k
RandomizedControl             Vaccinated      200745         33            24      28.4            16.4
RandomizedControl                Placebo      201229        115            27      70.6            57.1
RandomizedControl          NotInoculated      338778        121            36      46.3            35.7
RandomizedControl IncompleteVaccinations        8484          1             1      23.6            11.8
  ObservedControl             Vaccinated      221998         38            18      25.2            17.1
  ObservedControl               Controls      725173        330            61      53.9            45.5
  ObservedControl    Grade2NotInoculated      123605         43            11      43.7            34.8
  ObservedControl IncompleteVaccinations        9904          4             0      40.4            40.4
무작위: RR 0.288 [0.195, 0.424], VE 71% [0.576, 0.805];  z = -6.727, χ² = 45.25, p = 1.7e-11;  관찰 대조: RR 0.376, VE 62%
위약 대 동의하지 않음: RR 1.60 [1.24, 2.07];  비마비형 RR 0.89, 전체 RR 0.40
  ✓  6절 표: 인원 200,745 · 201,229 · 338,778 · 221,998 · 725,173 · 123,605, 모두 1,829,916명
  ✓  6절 표: 소아마비 10만 명당 28.4 · 70.6 · 46.3 / 25.2 · 53.9 · 43.7
  ✓  6절 표: 마비형 10만 명당 16.4 · 57.1 · 35.7 / 17.1 · 45.5 · 34.8
  ✓  예제 6.2 · 연습 6.1: RR 0.288 [0.195, 0.424], VE 71% [0.576, 0.805]
  ✓  예제 6.2 · 연습 6.2: z = −6.73, χ² = 45.3 = z², p = 1.7e−11
  ✓  예제 6.2: 관찰 대조 RR 0.376, VE 62%
  ✓  예제 6.3: 위약 57.1 대 동의하지 않음 35.7, RR 1.60 [1.24, 2.07]
  ✓  연습 6.3: 전체 RR 0.40, 비마비형 12.0 대 13.4 (RR 0.89)
python
fig, ax = plt.subplots(figsize=(9, 3.4))
groups = [("RandomizedControl", "Vaccinated", "vaccine", C["stat"]), ("RandomizedControl", "Placebo", "placebo", C["key"]),
          ("RandomizedControl", "NotInoculated", "no consent", C["hist"]), ("ObservedControl", "Vaccinated", "vaccine (gr. 2)", C["stat"]),
          ("ObservedControl", "Controls", "controls (gr. 1, 3)", C["key"]), ("ObservedControl", "Grade2NotInoculated", "no consent (gr. 2)", C["hist"])]
xs = [0, 1, 2, 3.6, 4.6, 5.6]
for xpos, (e, g, lab, col) in zip(xs, groups):
    r_ = row(e, g).paralytic_100k; ax.bar(xpos, r_, color=col, alpha=0.8); ax.text(xpos, r_ + 1, f"{r_:.1f}", ha="center")
ax.set_xticks(xs, [g[2] for g in groups]); ax.set_ylabel("paralytic per 100,000"); ax.set_title("Salk 1954: randomized (left) vs observed control (right)")
plt.tight_layout(); plt.show()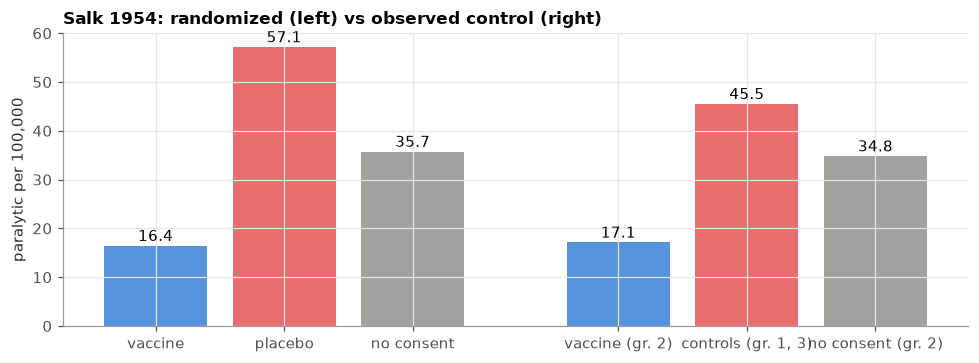
그림 읽기. 무작위 시험의 위약군(57.1)과 백신군(16.4)은 동의한 가정의 아이들끼리의 비교다. 동의하지 않은 가정의 아이들(35.7)은 백신을 맞지 않았는데도 위약군보다 덜 걸렸다. 동의 여부가 위험과 상관되어 있다는 뜻이다. 관찰 대조 설계는 동의한 2학년을 동의 여부가 섞인 1·3학년과 비교하므로 백신 효과를 62%로 작게 잰다. 무작위 이중맹검은 71%다. 무작위화는 측정할 수 없는 변수(소득, 위생, 의사의 기대)까지 두 군에 고르게 나눈다.
📝 연습 6.1–6.3 (강의노트): 신뢰구간, , 이중맹검.
7. 부숴보기 — 설계가 깨질 때
예제 7.1 체계적 배치 · 예제 7.2 의사반복 · 명제 7.3 순차 제곱합은 순서에 달려 있다 · 예제 7.4 귀리 7구획을 잃으면 · 예제 7.5 Box(1954)의 경고.
python
# 예제 7.1 · 연습 7.1: Mercer–Hall 의 열 14–25 를 '비료', 열 1–13 을 '대조' 로
col_idx = np.tile(np.arange(25), 20); row_idx = np.repeat(np.arange(20), 25)
east = col_idx >= 13
t_sys = stats.ttest_ind(ymh[east], ymh[~east]); diff_sys = ymh[east].mean() - ymh[~east].mean()
top = row_idx < 10; t_tb = stats.ttest_ind(ymh[top], ymh[~top])
sd_rand = math.sqrt(S2mh * (1 / 240 + 1 / 260))
print(f"열 14–25 대 1–13: 차이 {diff_sys:.3f}, t = {t_sys.statistic:.2f}, p = {t_sys.pvalue:.1e};  위 대 아래: t = {t_tb.statistic:.2f};  무작위 배치의 SD {sd_rand:.3f} → {diff_sys / sd_rand:.1f} SD")
report({"예제 7.1: 240 대 260 구획, 차이 −0.33, t = −8.55, p = 1.5e−16": east.sum() == 240 and round(diff_sys, 2) == -0.33 and round(t_sys.statistic, 2) == -8.55 and round(t_sys.pvalue * 1e16, 1) == 1.5,
        "예제 7.1: 위아래로 나누면 t = −0.77": round(t_tb.statistic, 2) == -0.77,
        "예제 7.1: 무작위로 고르면 크기 0.050 (1절의 2만 번)": abs(size_rand - 0.05) < 0.002,
        "연습 7.1: 무작위 배치의 SD 0.041, 차이는 약 −8 SD": round(sd_rand, 3) == 0.041 and round(diff_sys / sd_rand) == -8,
        "연습 7.2: 주구 오차 자유도 (6−1)(3−1) = 10, 72세구로 세면 55": tab["주구 오차"][1] == 10 and tab["주구 오차"][1] + tab["세구 오차"][1] == 55})
text
열 14–25 대 1–13: 차이 -0.328, t = -8.55, p = 1.5e-16;  위 대 아래: t = -0.77;  무작위 배치의 SD 0.041 → -8.0 SD
  ✓  예제 7.1: 240 대 260 구획, 차이 −0.33, t = −8.55, p = 1.5e−16
  ✓  예제 7.1: 위아래로 나누면 t = −0.77
  ✓  예제 7.1: 무작위로 고르면 크기 0.050 (1절의 2만 번)
  ✓  연습 7.1: 무작위 배치의 SD 0.041, 차이는 약 −8 SD
  ✓  연습 7.2: 주구 오차 자유도 (6−1)(3−1) = 10, 72세구로 세면 55
python
# 명제 7.3 · 예제 7.4 · 연습 7.3: 균형을 깨면
drop = [1, 30, 44, 49, 53, 57, 60]                 # 0부터 센 행 번호 (노트의 2, 31, 45, 50, 54, 58, 61번)
d7 = Yo.drop(index=drop).reset_index(drop=True); y7 = d7["yield"].to_numpy(float); one7 = np.ones((len(y7), 1))
B7, G7, N7 = dummies(d7.block), dummies(d7.gen), dummies(d7.nitro.astype(str))
base = np.column_stack([one7, B7]); r0 = rss_of(base, y7)[0]
r_g, r_n, r_gn = rss_of(np.column_stack([base, G7]), y7)[0], rss_of(np.column_stack([base, N7]), y7)[0], rss_of(np.column_stack([base, G7, N7]), y7)[0]
ss_g1, ss_g2, ss_n1, ss_n2 = r0 - r_g, r_n - r_gn, r0 - r_n, r_g - r_gn
# 균형 자료에서는 순서가 상관없다
b72 = np.column_stack([one72, Xb_]); R0 = rss_of(b72, yo)[0]
bal_g1 = R0 - rss_of(np.column_stack([b72, Xg_]), yo)[0]; bal_g2 = rss_of(np.column_stack([b72, Xn_]), yo)[0] - rss_of(np.column_stack([b72, Xn_, Xg_]), yo)[0]
# 연습 7.3: 2×2, 칸 수 [[2,1],[1,1]], 가법 자료
yt = np.array([0, 0, 1, 1, 2.0]); At = np.array([0, 0, 0, 1, 1]); Bt = np.array([0, 0, 1, 0, 1])
Xt0 = np.ones((5, 1)); XtA = np.column_stack([Xt0, At]); XtB = np.column_stack([Xt0, Bt]); XtAB = np.column_stack([Xt0, At, Bt])
ssA = rss_of(Xt0, yt)[0] - rss_of(XtA, yt)[0]; ssA_B = rss_of(XtB, yt)[0] - rss_of(XtAB, yt)[0]
print(f"7구획을 뺀 뒤: 품종 {ss_g1:.1f} (먼저) 대 {ss_g2:.1f} (질소 뒤), 질소 {ss_n1:.1f} 대 {ss_n2:.1f};  균형 자료의 품종 {bal_g1:.1f} = {bal_g2:.1f};  연습 7.3: {ssA:.3f} 대 {ssA_B:.3f}")
report({"예제 7.4: 품종 1026.3 대 1742.4, 질소 15044.4 대 15760.5": [round(v, 1) for v in (ss_g1, ss_g2, ss_n1, ss_n2)] == [1026.3, 1742.4, 15044.4, 15760.5],
        "명제 7.3: 균형 자료에서는 순서와 무관 (1786.4)": abs(bal_g1 - bal_g2) < 1e-8 and round(bal_g1, 1) == 1786.4,
        "연습 7.3: SS(A) = 1.633, SS(A | B) = 1.167": round(ssA, 3) == 1.633 and round(ssA_B, 3) == 1.167})
text
7구획을 뺀 뒤: 품종 1026.3 (먼저) 대 1742.4 (질소 뒤), 질소 15044.4 대 15760.5;  균형 자료의 품종 1786.4 = 1786.4;  연습 7.3: 1.633 대 1.167
  ✓  예제 7.4: 품종 1026.3 대 1742.4, 질소 15044.4 대 15760.5
  ✓  명제 7.3: 균형 자료에서는 순서와 무관 (1786.4)
  ✓  연습 7.3: SS(A) = 1.633, SS(A | B) = 1.167
python
# 예제 7.5 · 연습 7.4: Box (1954) — 크기 5, 10, 20 과 표준편차 3, 2, 1
sizes = np.array([5, 10, 20]); Nb = sizes.sum()
def box_size(sds, seed, R=40_000):
    gg = np.random.default_rng(seed); rej = 0
    for _ in range(R):
        rej += stats.f_oneway(*[gg.normal(0, s_, n_) for n_, s_ in zip(sizes, sds)]).pvalue < 0.05
    return rej / R
sz1, sz2 = box_size([3, 2, 1], 1954), box_size([1, 2, 3], 1955)
def ems_ratio(sds):
    sds = np.array(sds, float)
    return (np.sum(sds**2 * (1 - sizes / Nb)) / 2) / (np.sum((sizes - 1) * sds**2) / (Nb - 3))
print(f"실제 크기: 작은 집단이 시끄러우면 {sz1:.3f}, 큰 집단이 시끄러우면 {sz2:.3f};  기대평균제곱의 비 {ems_ratio([3, 2, 1]):.2f}, {ems_ratio([1, 2, 3]):.2f}")
report({"예제 7.5: 실제 크기 약 0.20 과 0.014": abs(sz1 - 0.20) < 0.01 and abs(sz2 - 0.014) < 0.003,
        "연습 7.4: E MS_B / E MS_W = 1.93 과 0.57": round(ems_ratio([3, 2, 1]), 2) == 1.93 and round(ems_ratio([1, 2, 3]), 2) == 0.57})
text
실제 크기: 작은 집단이 시끄러우면 0.204, 큰 집단이 시끄러우면 0.014;  기대평균제곱의 비 1.93, 0.57
  ✓  예제 7.5: 실제 크기 약 0.20 과 0.014
  ✓  연습 7.4: E MS_B / E MS_W = 1.93 과 0.57
숫자 읽기. 처치가 없는 밭에서 "열 14–25에 비료"라고 부르기만 해도 가 나온다. 땅심의 경향이 처치의 효과로 둔갑한 것이다. 위아래로 나누면 아무 일도 없다. 어느 방향이 위험한지 실험자는 모르므로, 무작위화만이 보증이다. 균형이 깨지면 같은 자료에서 품종의 제곱합이 1026과 1742 사이를 오간다. 작은 집단의 분산이 크면 5% 검정이 20% 검정이 된다.
📝 연습 7.1–7.4 (강의노트): 가짜 효과의 크기, 의사반복의 자유도, 작은 불균형, 합동 분산의 치우침.
8. 오늘의 실험설계 — 하이퍼파라미터와 A/B 테스트
예제 8.1 학습률 × 배치 크기 · 정리 8.2 공변량 보정(CUPED)의 분산 배.
python
# 예제 8.1: 가상의 정확도 곡면 (최적 학습률 ∝ 배치 크기)
lrs = np.array([1e-4, 3e-4, 1e-3, 3e-3, 1e-2]); bss = np.array([32, 64, 128, 256, 512])
def acc(lr, bs):
    opt = 1e-3 * (bs / 128)
    return 0.92 - 0.04 * (np.log10(lr) - np.log10(opt)) ** 2 - 0.01 * (np.log2(bs) - 7) ** 2 / 4
Mu = acc(lrs[:, None], bss[None, :])
i0 = int(np.argmax(Mu[:, 0])); j0 = int(np.argmax(Mu[i0, :])); ib, jb = np.unravel_index(Mu.argmax(), Mu.shape)
# 씨앗 3개로 반복한 그리드의 이원분산분석
gg = np.random.default_rng(2017); reps = 3
Yg = Mu[:, :, None] + gg.normal(0, 0.005, (5, 5, reps))
gmean = Yg.mean(); aa = Yg.mean((1, 2)) - gmean; bb_ = Yg.mean((0, 2)) - gmean; cell = Yg.mean(2)
ab = cell - gmean - aa[:, None] - bb_[None, :]
SSA, SSB_, SSAB, SSE_ = 5 * reps * np.sum(aa**2), 5 * reps * np.sum(bb_**2), reps * np.sum(ab**2), np.sum((Yg - cell[:, :, None]) ** 2)
F_AB = (SSAB / 16) / (SSE_ / (25 * (reps - 1)))
print(f"OFAT: lr {lrs[i0]:g}, batch {bss[j0]} → {Mu[i0, j0]:.4f};  그리드 최적 lr {lrs[ib]:g}, batch {bss[jb]} → {Mu.max():.3f};  상호작용 F = {F_AB:.0f} (자유도 16, 50)")
report({"예제 8.1: OFAT 는 (3e−4, 64) 에서 0.9155": (lrs[i0], bss[j0]) == (3e-4, 64) and round(Mu[i0, j0], 4) == 0.9155,
        "예제 8.1: 그리드의 최적은 (1e−3, 128) 의 0.920": (lrs[ib], bss[jb]) == (1e-3, 128) and round(Mu.max(), 3) == 0.920,
        "예제 8.1: 상호작용의 F = 97 (씨앗 3개)": round(F_AB) == 97})
text
OFAT: lr 0.0003, batch 64 → 0.9155;  그리드 최적 lr 0.001, batch 128 → 0.920;  상호작용 F = 97 (자유도 16, 50)
  ✓  예제 8.1: OFAT 는 (3e−4, 64) 에서 0.9155
  ✓  예제 8.1: 그리드의 최적은 (1e−3, 128) 의 0.920
  ✓  예제 8.1: 상호작용의 F = 97 (씨앗 3개)
python
# 정리 8.2 · 연습 8.1 · 8.2: CUPED
rho, n_arm, Rc = 0.7, 1000, 20_000
gc = np.random.default_rng(2013)
xx = gc.standard_normal((Rc, 2 * n_arm)); yy_ = rho * xx + math.sqrt(1 - rho**2) * gc.standard_normal((Rc, 2 * n_arm))
yy_[:, :n_arm] += 0.05                                                     # 처치효과 0.05
dm = yy_[:, :n_arm].mean(1) - yy_[:, n_arm:].mean(1)
cup = dm - rho * (xx[:, :n_arm].mean(1) - xx[:, n_arm:].mean(1))
# 연습 8.1: 한 번의 실험에서 회귀 Y ~ 1 + T + X 의 처치 계수 = 군 안 합동 기울기로 보정한 차이
Tr = np.r_[np.ones(n_arm), np.zeros(n_arm)]; x1, y1_ = xx[0], yy_[0]
coef = np.linalg.lstsq(np.column_stack([np.ones(2 * n_arm), Tr, x1]), y1_, rcond=None)[0]
xc = np.r_[x1[:n_arm] - x1[:n_arm].mean(), x1[n_arm:] - x1[n_arm:].mean()]; yc_ = np.r_[y1_[:n_arm] - y1_[:n_arm].mean(), y1_[n_arm:] - y1_[n_arm:].mean()]
theta_w = xc @ yc_ / (xc @ xc)
ancova = (y1_[:n_arm].mean() - y1_[n_arm:].mean()) - theta_w * (x1[:n_arm].mean() - x1[n_arm:].mean())
n_needed = 2 * (stats.norm.ppf(0.975) + stats.norm.ppf(0.8)) ** 2 / 0.01**2
print(f"분산비 {cup.var() / dm.var():.3f} (1 − ρ² = {1 - rho**2:.2f});  평균 {cup.mean():.4f}, {dm.mean():.4f} (참 0.05);  회귀 계수 {coef[1]:.6f} = 보정 차이 {ancova:.6f};  필요 인원 {n_needed:,.0f} → {n_needed * (1 - rho**2):,.0f}")
report({"정리 8.2: 분산이 (1 − ρ²) = 0.51 배 (모의 0.52)": abs(cup.var() / dm.var() - 0.51) < 0.015 and round(cup.var() / dm.var(), 2) == 0.52,
        "정리 8.2: 보정해도 불편": within(cup.mean(), 0.05, cup.std() / math.sqrt(Rc)) and within(dm.mean(), 0.05, dm.std() / math.sqrt(Rc)),
        "연습 8.1: 회귀 Y ~ 1 + T + X 의 처치 계수 = 군 안 합동 기울기로 보정한 차이": abs(coef[1] - ancova) < 1e-10,
        "연습 8.2: 군마다 2(1.96 + 0.84)²/0.01² ≈ 156,800명, 보정하면 약 절반": round(2 * (1.96 + 0.84) ** 2 / 0.01**2) == 156800 and abs(n_needed * 0.51 / n_needed - 0.51) < 1e-12})
text
분산비 0.516 (1 − ρ² = 0.51);  평균 0.0501, 0.0500 (참 0.05);  회귀 계수 0.085827 = 보정 차이 0.085827;  필요 인원 156,978 → 80,059
  ✓  정리 8.2: 분산이 (1 − ρ²) = 0.51 배 (모의 0.52)
  ✓  정리 8.2: 보정해도 불편
  ✓  연습 8.1: 회귀 Y ~ 1 + T + X 의 처치 계수 = 군 안 합동 기울기로 보정한 차이
  ✓  연습 8.2: 군마다 2(1.96 + 0.84)²/0.01² ≈ 156,800명, 보정하면 약 절반
python
# 연습 8.3: Holm (1979) — 지표 10개, 참인 귀무가설 6개
gh_ = np.random.default_rng(1979); m10, m0, Rh = 10, 6, 40_000
zs = gh_.standard_normal((Rh, m10)); zs[:, m0:] += 3.0
pv = 2 * stats.norm.sf(np.abs(zs))
def holm_reject(p, alpha=0.05):
    order = np.argsort(p); rej = np.zeros(len(p), bool)
    for k, i in enumerate(order):
        if p[i] <= alpha / (len(p) - k): rej[i] = True
        else: break
    return rej
H = np.array([holm_reject(p) for p in pv]); Bf = pv <= 0.05 / m10
fwer_holm, fwer_bonf = H[:, :m0].any(1).mean(), Bf[:, :m0].any(1).mean()
power_holm, power_bonf = H[:, m0:].mean(), Bf[:, m0:].mean()
print(f"FWER Holm {fwer_holm:.4f}, Bonferroni {fwer_bonf:.4f};  거짓 가설을 찾는 비율 Holm {power_holm:.3f}, Bonferroni {power_bonf:.3f}")
report({"연습 8.3: Holm 의 FWER ≤ 0.05": fwer_holm <= 0.05 + 4 * math.sqrt(0.05 * 0.95 / Rh),
        "연습 8.3: Holm 은 Bonferroni 보다 언제나 같거나 많이 기각한다": np.all(H >= Bf) and power_holm > power_bonf})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
im = axes[0].imshow(Mu, origin="lower", cmap="viridis"); axes[0].grid(False); fig.colorbar(im, ax=axes[0])
axes[0].set_xticks(range(5), bss); axes[0].set_yticks(range(5), ["1e-4", "3e-4", "1e-3", "3e-3", "1e-2"])
axes[0].annotate("", xy=(0, i0), xytext=(0, 2), arrowprops=dict(arrowstyle="->", color="white", lw=1.5))
axes[0].annotate("", xy=(j0, i0), xytext=(0, i0), arrowprops=dict(arrowstyle="->", color="white", lw=1.5))
axes[0].plot(jb, ib, "*", color=C["key"], ms=14, mec="white"); axes[0].set_xlabel("batch"); axes[0].set_ylabel("learning rate")
axes[0].set_title("one factor at a time vs grid")
axes[1].hist(dm, bins=60, density=True, color=C["assume"], alpha=0.5, label="difference in means")
axes[1].hist(cup, bins=60, density=True, color=C["stat"], alpha=0.55, label="CUPED")
axes[1].axvline(0.05, **THEORY); axes[1].legend(); axes[1].set_title(r"A/B test, $\rho=0.7$")
plt.tight_layout(); plt.show()
text
FWER Holm 0.0407, Bonferroni 0.0312;  거짓 가설을 찾는 비율 Holm 0.603, Bonferroni 0.576
  ✓  연습 8.3: Holm 의 FWER ≤ 0.05
  ✓  연습 8.3: Holm 은 Bonferroni 보다 언제나 같거나 많이 기각한다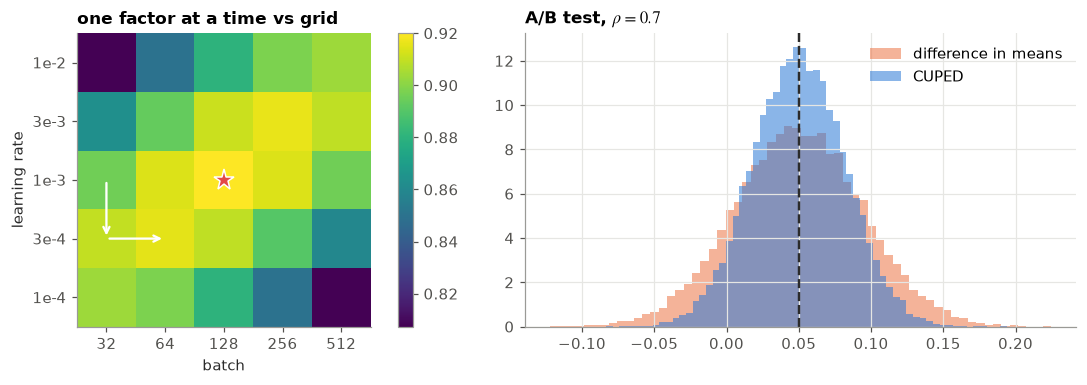
그림 읽기. 왼쪽: 배치 32에서 학습률을 고르고 그 학습률에서 배치를 고르면(흰 화살표) 상호작용 때문에 그리드의 최적(별)에 닿지 못한다. 그리드 탐색은 Fisher의 요인설계이고, 씨앗 반복은 반복이며, 분산분석표의 상호작용 행이 "하나씩 조정하면 안 된다"를 숫자로 말한다. 오른쪽: 같은 A/B 실험을 실험 전 지표로 보정하면 분포가 좁아지고 중심(참 효과 0.05)은 그대로다. 블록이 이산적인 국소 관리라면 공변량 보정은 연속적인 국소 관리다.
📝 연습 8.1–8.3 (강의노트): 추정한 , 몇 명이 필요한가, Holm의 단계.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 무작위화 (1.1–1.9) | 모든 배정의 열거로 Neyman의 공식, Mercer–Hall의 0.001680, , 홍차 1/70, Darwin 863/32768 | 1절 |
| 일원분산분석 (2.1–2.9) | 사영으로 , f_oneway 대조, 비중심 의 혼합·mgf·단조성, 검정력 0.44·0.82·0.96 |
2절 |
| 이원과 분할구 (3.1–3.6) | 다섯 직교공간, Broadbalk 44·35·20%, Tukey 73.7, 귀리의 두 오차층 1.49·37.69·0.30, 기대평균제곱 | 3절 |
| 동시추론 (4.1–4.8) | Cauchy–Schwarz, Scheffé·Tukey 포함확률 0.95, HSD 11.83, tukey_hsd 대조, FWER 0.34 → 0.05 |
4절 |
| 설계의 원리 (5.1–5.4) | 짝 효율 1.48, 블록 1.26, 요인설계 , npk와 교락 | 5절 |
| Salk (6.1–6.3) | RR 0.288 [0.195, 0.424], , 관찰 대조 62%, 동의의 치우침 1.60 | 6절 |
| 부숴보기 (7) | 체계적 배치 , 의사반복 3.51, 순차 제곱합, Box 0.20 | 3·7절 |
| 오늘 (8) | OFAT 0.9155 대 그리드 0.920, CUPED 0.51, 회귀 = ANCOVA, Holm | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 무작위화 | 1.1 컵 ★ · 1.2 두 단위 ★ · 1.3 유한 모집단 ★★ · 1.4 보수적 ★★ · 1.5 신뢰구간 ★★ · 1.6 배정 지시변수의 적률 ★ (유도형) | 1절 |
| 2 일원분산분석 | 2.1 ★ · 2.2 ★ · 2.3 비중심도 ★★ · 2.4 ★ · 2.5 오차가 두 배 ★ · 2.6 사영의 비중심도 ★ · 2.7 검정의 검정력 ★★ (유도형) | 1–2절 |
| 3 이원 | 3.1 ★ · 3.2 균형 ★★ · 3.3 ★ · 3.4 Tukey ★★ · 3.5 분할구 ★★ | 3절 |
| 4 동시추론 | 4.1 ★ · 4.2 ★★ · 4.3 HSD ★ · 4.4 추세 ★ · 4.5 Tukey의 동시구간 ★ (유도형) | 4절 |
| 5 설계 | 5.1 ★ · 5.2 요인 ★★ · 5.3 교락 ★ · 5.4 OFAT ★★ · 5.5 짝 설계의 효율 ★★ · 5.6 요인설계의 효율 ★ (유도형) | 5절 |
| 6 Salk | 6.1 ★ · 6.2 ★ · 6.3 이중맹검 ★ | 6절 |
| 7 부숴보기 | 7.1 ★ · 7.2 ★ · 7.3 ★★ · 7.4 ★★ | 7절 |
| 8 오늘 | 8.1 ★★ · 8.2 ★ · 8.3 Holm ★★ · 8.4 공변량 보정의 분산 ★ (유도형) | 8절 |
다음 회 (15회) — 가정이 틀리면: 순위·로버스트·부트스트랩 (1935 → 1979). 이번 회차의 와 는 정규 오차를 가정했지만, 1절의 무작위화 검정은 그 가정 없이도 정확했다. 15회는 그 생각을 넓힌다. 관측값 대신 순위를 쓰는 Wilcoxon(1945)의 검정, 이상치에 무너지지 않는 Huber(1964)의 추정, 분포를 자료 자신으로 바꾸는 Efron(1979)의 부트스트랩이다.
10. 워크북 검산
워크북(14_anova_design_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "2/5")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(2/5,0.4)나 식의 문자열("2*exp(1)","12*log(17/9)")로 넣는다. 소문항은"A9c"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다. 분위수 표를 쓰는 문항(A12, C3, C5)은 0.3%까지 본다.- 시뮬레이션으로 한 번 더 — 무작위화와 반복이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A5c")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A2a A2b A3a A3b A4a A4b A5a A5b A5c A6a A6b A6c A7a A7b A8a A8b A9a A9b A9c A9d A9e A10a A10b A10c A11a A11b A12a A12b A13a A13b A13c A14a A14b C1b C2b C3c C5c C6c C7b C8b D1a D1b D1c D2a D2b D2c D3a D3b D3c D3d D4b D4c D4d
A5c: 아직 답을 넣지 않았다. 예: check('A5c', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None,
    "A4a": None, "A4b": None, "A5a": None, "A5b": None, "A5c": None, "A6a": None, "A6b": None, "A6c": None,
    "A7a": None, "A7b": None, "A8a": None, "A8b": None,
    "A9a": None, "A9b": None, "A9c": None, "A9d": None, "A9e": None, "A10a": None, "A10b": None, "A10c": None,
    "A11a": None, "A11b": None, "A12a": None, "A12b": None, "A13a": None, "A13b": None, "A13c": None,
    "A14a": None, "A14b": None,
    "C1b": None, "C2b": None, "C3c": None, "C5c": None, "C6c": None, "C7b": None, "C8b": None,
    "D1a": None, "D1b": None, "D1c": None, "D2a": None, "D2b": None, "D2c": None,
    "D3a": None, "D3b": None, "D3c": None, "D3d": None, "D4b": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A2() |
A2 Neyman 분산 | 4단위에서 2개를 무작위로 처치 |
sim_A3() |
A3 컵 열 개 | 무작위로 고른 다섯 컵 |
sim_A4() |
A4 부호 뒤집기 | 짝마다 동전 |
sim_A11() |
A11 독립인 검정 열 개 | 균등분포 -값 10개 |
sim_C5() |
C5 임의효과 | 음수 분산 추정의 비율 |
sim_D2() |
D2 여섯 단위의 무작위화 검정 | 무작위 배정 |
sim_D4() |
D4 정확한 -값 | 귀무가설 아래의 정규 일원배치 |
python
N_WB = 200_000


def _mc(hits):
    hits = np.asarray(hits, dtype=float)
    p = hits.mean()
    return p, math.sqrt(max(p * (1 - p), 1e-300) / hits.size)


def sim_A2(n=N_WB):
    """E(τ̂ − τ̄)², 곧 Var τ̂ 의 추정 (τ̄ 는 표에서 바로 읽는다)"""
    y1, y0 = np.array([5, 7, 6, 10.0]), np.array([3, 4, 6, 7.0])
    perm = np.argsort(rng.random((n, 4)), axis=1)
    T, C = perm[:, :2], perm[:, 2:]
    tau = y1[T].mean(axis=1) - y0[C].mean(axis=1)
    sq = (tau - (y1 - y0).mean()) ** 2
    return sq.mean(), sq.std() / math.sqrt(n)


def sim_A3(n=N_WB):
    """컵 10개 가운데 5개를 무작위로 고를 때 넷 이상 맞힐 확률"""
    pick = np.argsort(rng.random((n, 10)), axis=1)[:, :5]
    return _mc((pick < 5).sum(axis=1) >= 4)


def sim_A4(n=N_WB):
    """부호를 무작위로 바꾼 합이 13 이상일 확률"""
    s = rng.choice([-1, 1], size=(n, 5)) @ np.array([1, 2, 3, 4, 5])
    return _mc(s >= 13)


def sim_A11(n=N_WB):
    """참인 귀무가설 10개를 크기 0.005 로 독립 검정할 때 하나라도 기각할 확률"""
    return _mc((rng.random((n, 10)) <= 0.005).any(axis=1))


def sim_C5(t=4, nn=5, ratio=0.2, n=N_WB):
    """임의효과 일원배치에서 (MS_B − MS_W)/n < 0 일 확률"""
    a = rng.normal(0, math.sqrt(ratio), size=(n, t, 1))
    y = a + rng.normal(size=(n, t, nn))
    gm = y.mean(axis=2)
    msb = nn * ((gm - gm.mean(axis=1, keepdims=True)) ** 2).sum(axis=1) / (t - 1)
    msw = ((y - gm[:, :, None]) ** 2).sum(axis=(1, 2)) / (t * (nn - 1))
    return _mc(msb < msw)


def sim_D2(n=N_WB):
    """6단위에서 3개를 무작위로 처치할 때 τ̂ ≥ 10/3 일 확률"""
    vals = np.array([8, 10, 12, 5, 6, 9.0])
    perm = np.argsort(rng.random((n, 6)), axis=1)
    tau = vals[perm[:, :3]].mean(axis=1) - vals[perm[:, 3:]].mean(axis=1)
    return _mc(tau >= 10 / 3 - 1e-9)


def sim_D4(n=N_WB):
    """처치 3개, 처치마다 4개인 정규 일원배치에서 귀무가설 아래 F > 4 일 확률"""
    y = rng.normal(size=(n, 3, 4))
    gm = y.mean(axis=2)
    ssb = 4 * ((gm - gm.mean(axis=1, keepdims=True)) ** 2).sum(axis=1)
    ssw = ((y - gm[:, :, None]) ** 2).sum(axis=(1, 2))
    return _mc((ssb / 2) / (ssw / 9) > 4)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0):
    est, se = sim
    return abs(est - _value(key)) <= z * se + 1e-12

assert _close(sim_A2(), "A2b")
assert _close(sim_A3(), "A3b")
assert _close(sim_A4(), "A4a")
assert _close(sim_A11(), "A11a")
assert _close(sim_C5(), "C5c")
assert _close(sim_D2(), "D2a")
assert _close(sim_D4(), "D4c")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    assert _same(_e, float(sp.sympify(_e["value"])))