Skip to content

14회 · 분산분석과 실험설계 · 노트

8 오늘의 실험설계 — 하이퍼파라미터와 A/B 테스트 ​

8.1 Ablation과 그리드: 상호작용을 보는가 ​

기계학습 논문의 ablation 표는 완성된 모델에서 부품을 하나씩 빼며 성능을 잰다. 하이퍼파라미터 조정도 흔히 하나씩 한다. 학습률을 고정된 배치 크기에서 고른 뒤, 그 학습률에서 배치 크기를 고르는 식이다. 둘 다 Fisher가 반박한 “한 번에 한 요인”이다. 요인 사이에 상호작용이 있으면 이 방법은 최적점을 놓친다.

예제 8.1 (학습률 ×\times 배치 크기) 학습률 5단계(10−410^{-4}부터 10−210^{-2}까지)와 배치 크기 5단계(32부터 512까지)의 검증 정확도가, 최적 학습률이 배치 크기에 비례하는(선형 스케일링 규칙) 가상의 곡면을 따른다고 하자. 배치 32에서 학습률을 고르면 3×10−43\times10^{-4}이고, 그 학습률에서 배치를 고르면 64다. 정확도는 0.9155다. 5×55\times5 전체 그리드를 보면 최적은 학습률 10−310^{-3}, 배치 128의 0.920이다. 조합마다 씨앗 3개로 반복한 그리드를 이원분산분석하면 상호작용의 FF가 97이다(그림 8.1 왼쪽). 그리드 탐색은 요인설계이고, 분산분석표는 어느 하이퍼파라미터가 얼마나, 그리고 서로 얽혀서 성능을 움직이는지 말해 준다. 씨앗을 반복하는 것은 Fisher의 반복이다.

8.2 A/B 테스트와 CUPED ​

온라인 서비스의 A/B 테스트는 사용자를 무작위로 두 판에 배정하는 완전무작위설계다. 1절의 모든 정리가 그대로 쓰인다. 사용자가 수백만이어도 효과가 작아서 분산을 줄이는 일이 중요하다. 블록의 연속판이 공변량 보정이다. Fisher(1932)는 이것을 공분산분석이라 불렀고, Deng 등(2013)은 실험 전 기간의 지표를 공변량으로 쓰는 방법을 CUPED라는 이름으로 퍼뜨렸다.

정리 8.2 (공변량 보정의 분산) 무작위 배정 전에 정해진 공변량 XX(처치의 영향을 받지 않음)가 있고, 단위들이 (X,Y)(X,Y)의 분포에서 독립으로 뽑혔다고 하자. θ=Cov⁡(X,Y)/Var⁡X\theta=\Cov(X,Y)/\Var X, ρ=Corr⁡(X,Y)\rho=\Corr(X,Y)(대조군 기준, 처치효과는 상수)일 때

τ^θ=(YˉT−θXˉT)−(YˉC−θXˉC)\hat\tau_\theta=(\bar Y_T-\theta\bar X_T)-(\bar Y_C-\theta\bar X_C)

는 불편이고 Var⁡τ^θ=(1−ρ2)Var⁡(YˉT−YˉC)\Var\hat\tau_\theta=(1-\rho^2)\Var(\bar Y_T-\bar Y_C)이다.

증명 전략 τ^θ\hat\tau_\theta는 새 반응 Y−θXY-\theta X의 두 군 평균의 차다. 불편성은 무작위 배정이 두 군의 XX 분포를 같게 만든다는 데서 나오고, 분산은 Var⁡(Y−θX)\Var(Y-\theta X)를 θ\theta의 이차식으로 펼쳐 얻는다. 단계별 증명은 연습 8.4(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

θ\theta는 YY를 XX로 맞춘 최선의 선형예측의 기울기(13회 정리 5.1)이고, 보정은 그 잔차로 비교하는 것이다.

실제로는 θ\theta를 자료에서 추정하지만, 표본이 크면 분산은 같다. 실험 전 지표와 실험 중 지표의 상관이 0.7이면 분산이 0.51배, 곧 같은 정밀도에 필요한 사용자가 절반이다(노트북의 2만 번 반복에서 0.52). 무작위화가 치우침을 없앤다면, 블록과 공변량 보정은 분산을 줄인다. 둘은 Fisher의 세 원리 가운데 둘이다.
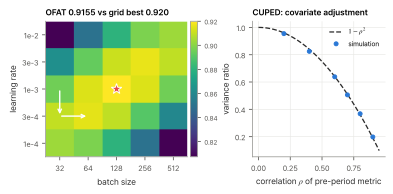
그림 8.1. 왼쪽: 학습률 × 배치 크기의 가상 정확도 곡면. 한 번에 한 요인(OFAT, 흰 화살표)은 (3×10^-4,64)에 멈추고, 그리드의 최적은 (10^-3,128)이다(별). 오른쪽: 공변량 보정의 분산비. 실선은 이론값 1-ρ², 점은 시뮬레이션이다.
그림 8.1 왼쪽: 학습률 ×\times 배치 크기의 가상 정확도 곡면. 한 번에 한 요인(OFAT, 흰 화살표)은 (3×10⁻⁴, 64)(3\times10^{-4},\,64)에 멈추고, 그리드의 최적은 (10−3, 128)(10^{-3},\,128)이다(별). 오른쪽: 공변량 보정의 분산비. 실선은 이론값 1−ρ21-\rho^2, 점은 시뮬레이션이다.
연습문제

연습 8.1 (추정한 θ\theta ★★) θ\theta 대신 두 군을 합친 자료의 회귀 기울기 θ^\hat\theta를 쓰면 τ^θ^\hat\tau_{\hat\theta}가 13회의 다중회귀 Y∼1+처치+XY\sim1+\text{처치}+X에서 처치의 계수와 거의 같음을 FWL(13회 정리 5.3)로 설명하라.

풀이

FWL로 처치의 계수는 YY와 처치 표시를 각각 (1,X)(1,X)로 맞춘 잔차끼리의 기울기다. 처치 표시는 무작위여서 XX와 거의 무상관이므로, 그 계수는 (YˉT−YˉC)−θ^(XˉT−XˉC)(\bar Y_T-\bar Y_C)-\hat\theta(\bar X_T-\bar X_C)이고 θ^\hat\theta는 군 안의 합동 기울기다. 큰 표본에서 이것은 CUPED와 같다.

연습 8.2 (몇 명이 필요한가 ★) 효과 0.01, 지표의 표준편차 1인 A/B 테스트에서 양쪽 5%, 검정력 80%에 군마다 필요한 사용자 수는 대략 2(1.96+0.84)2/0.0122(1.96+0.84)^2/0.01^2이다. 이 수를 계산하고, ρ=0.7\rho=0.7인 공변량 보정을 쓰면 몇 명으로 줄어드는지 구하라.

풀이

2(1.96+0.84)2/0.012=2×7.84×104=156,8002(1.96+0.84)^2/0.01^2=2\times7.84\times10^4=156{,}800명이다. 분산이 1−0.72=0.511-0.7^2=0.51배가 되면 79,96879{,}968명, 곧 약 절반이다.

연습 8.3 (Holm의 단계 ★★) 지표 mm개의 pp-값을 작은 것부터 p(1)≤⋯≤p(m)p_{(1)}\le\dots\le p_{(m)}으로 놓고, p(k)≤α/(m−k+1)p_{(k)}\le\alpha/(m-k+1)이 처음으로 깨지는 곳 직전까지 기각한다(Holm 1979). 참인 가설이 m0m_0개일 때 FWER ≤α\le\alpha임을 보여라. (참인 가설들 가운데 가장 작은 pp-값이 α/m0\alpha/m_0 이하일 확률을 Bonferroni로 묶어라.)

풀이

참인 가설들의 집합을 I0I_0 (∣I0∣=m0|I_0|=m_0)이라 하자. Holm이 참인 가설을 하나라도 기각했다면, 처음으로 기각된 참인 가설은 순서상 k≤m−m0+1k\le m-m_0+1번째에 있다(그 앞에는 거짓인 가설만 있을 수 있다). 그 pp-값은 α/(m−k+1)≤α/m0\alpha/(m-k+1)\le\alpha/m_0 이하다. 따라서 FWER ≤P(min⁡i∈I0pi≤α/m0)≤m0⋅α/m0=α\le P(\min_{i\in I_0}p_i\le\alpha/m_0)\le m_0\cdot\alpha/m_0=\alpha (Bonferroni).

연습 8.4 (공변량 보정의 분산: 증명 ★ 유도형) 정리 8.2를 다음 순서로 증명하라. 두 군의 크기는 고정되어 있고 처치효과는 상수 τ\tau다.

  1. (a)

    무작위 배정 아래 XˉT\bar X_T와 XˉC\bar X_C가 같은 평균을 가짐을 보이고 Eτ^θ=τE\hat\tau_\theta=\tau를 얻어라.

  2. (b)

    τ^θ\hat\tau_\theta가 반응 Y−θXY-\theta X의 두 군 평균의 차임을 보이고, 그 분산이 Var⁡(Y−θX) (1/nT+1/nC)\Var(Y-\theta X)\,(1/n_T+1/n_C)임을 보여라.

  3. (c)

    Var⁡(Y−θcX)\Var(Y-\theta c X)를 cc의 이차식으로 펼쳐 c=1c=1, 곧 θ=Cov⁡(X,Y)/Var⁡X\theta=\Cov(X,Y)/\Var X에서 최소이고 그 값이 (1−ρ2)Var⁡Y(1-\rho^2)\Var Y임을 보여라.

  4. (d)

    (b)와 (c)를 합쳐 정리의 식을 얻어라.

풀이

(a) 무작위 배정은 처치 전에 정해진 XX와 무관하므로 두 군의 XX는 같은 분포를 갖고 EXˉT=EXˉCE\bar X_T=E\bar X_C이다. 처치효과가 상수 τ\tau이므로 E(YˉT−YˉC)=τE(\bar Y_T-\bar Y_C)=\tau이고, Eτ^θ=τ−θ(EXˉT−EXˉC)=τE\hat\tau_\theta=\tau-\theta(E\bar X_T-E\bar X_C)=\tau이다. (b) τ^θ=(Y−θX)‾T−(Y−θX)‾C\hat\tau_\theta=\overline{(Y-\theta X)}_T-\overline{(Y-\theta X)}_C이다. 단위들이 독립이고 처치는 YY를 상수만큼 옮기므로 Y−θXY-\theta X의 분산은 두 군에서 같다. 두 평균은 독립이므로 Var⁡τ^θ=Var⁡(Y−θX)(1nT+1nC)\Var\hat\tau_\theta=\Var(Y-\theta X)\bigl(\tfrac1{n_T}+\tfrac1{n_C}\bigr)이다. (c) θ0=Cov⁡(X,Y)/Var⁡X\theta_0=\Cov(X,Y)/\Var X라 하면 Var⁡(Y−cθ0X)=Var⁡Y−2cθ0Cov⁡(X,Y)+c2θ02Var⁡X=Var⁡Y−(2c−c2)Cov⁡(X,Y)2Var⁡X\Var(Y-c\theta_0X)=\Var Y-2c\theta_0\Cov(X,\allowbreak Y)+c^2\theta_0^2\Var X=\Var Y-(2c-c^2)\tfrac{\Cov(X,Y)^2}{\Var X}이다. 이것은 c=1c=1에서 최소이고 그 값은 Var⁡Y−Cov⁡(X,Y)2Var⁡X=(1−ρ2)Var⁡Y\Var Y-\tfrac{\Cov(X,Y)^2}{\Var X}=(1-\rho^2)\Var Y이다. (d) (b)에 (c)를 넣으면 Var⁡τ^θ=(1−ρ2)Var⁡Y(1nT+1nC)=(1−ρ2)Var⁡(YˉT−YˉC)\Var\hat\tau_\theta=(1-\rho^2)\Var Y\bigl(\tfrac1{n_T}+\tfrac1{n_C}\bigr)=(1-\rho^2)\Var(\bar Y_T-\bar Y_C)이다.

이 회차에서 읽은 절 0개 · 회차 차례