Skip to content

13회 · 최소제곱 · 노트

5 회귀의 탄생 — Galton에서 Yule까지 ​

역사 Francis Galton은 최소제곱을 쓰지 않았다. 1886년 유전되는 키의 평범함으로의 회귀에서 그는 205쌍의 부모와 그 자녀 928명의 키를 표로 만들고, 부모 키(아버지 키와 어머니 키에 1.08을 곱한 값의 평균)의 칸마다 자녀 키의 중앙값을 읽었다. 그 점들은 기울기가 약 2/32/3인 직선 위에 있었다. 키가 큰 부모의 자녀는 크지만 부모만큼은 아니었다. Galton은 이것을 “평범함으로의 회귀”라 불렀다(5회 2절). Karl Pearson(1896)이 상관계수의 공식을 주었고, Pearson과 Alice Lee(1903)는 천 가족이 넘는 자료로 부모와 자녀의 회귀를 다시 쟀다. 1897년 George Udny Yule은 결정적인 한 걸음을 디뎠다. 회귀선은 정규분포를 가정하지 않아도 최소제곱으로 맞춘 직선이라는 것이다. 천문학의 최소제곱과 유전학의 회귀가 이렇게 만났다. Yule(1899)은 곧바로 이것을 여러 설명변수로 넓혀 영국의 빈곤율을 분석했다.

5.1 회귀는 최선의 선형예측이다 ​

정리 5.1 (모집단의 최소제곱) 확률벡터 x∈Rp\x\in\R^p와 확률변수 YY가 유한한 2차 적률을 갖고 Exx′E\x\x\T가 가역이라 하자.

  1. (a)

    E(Y−x′b)2E(Y-\x\T\bb)^2을 최소로 하는 b\bb는 β∗=(Exx′)−1ExY\bbeta^*=(E\x\x\T)^{-1}E\x Y 하나다. 오차 u=Y−x′β∗u=Y-\x\T\bbeta^*는 Exu=0E\x u=\bzero를 만족한다.

  2. (b)

    E[Y∣x]=x′βE[Y\mid\x]=\x\T\bbeta인 β\bbeta가 있으면 β∗=β\bbeta^*=\bbeta이다.

  3. (c)

    x=(1,X)′\x=(1,X)\T이면 β1∗=Cov⁡(X,Y)/Var⁡X\beta_1^*=\Cov(X,Y)/\Var X, β0∗=EY−β1∗EX\beta_0^*=EY-\beta_1^*EX이다.

증명 (a) 정리 2.2의 피타고라스를 기댓값으로 한다. Exu=ExY−Exx′β∗=0E\x u=E\x Y-E\x\x\T\bbeta^*=\bzero이므로 교차항 2E[(β∗−b)′xu]2E[(\bbeta^*-\bb)\T\x u]가 0이고

E(Y−x′b)2=Eu2+(b−β∗)′(Exx′)(b−β∗)E(Y-\x\T\bb)^2=E u^2+(\bb-\bbeta^*)\T(E\x\x\T)(\bb-\bbeta^*)

이다. Exx′E\x\x\T가 양정치이므로 둘째 항은 b=β∗\bb=\bbeta^*에서만 0이다. (b) 반복기댓값으로 Ex(Y−x′β)=E[x E(Y−x′β∣x)]=0E\x(Y-\x\T\bbeta)=E\bigl[\x\,E(Y-\x\T\bbeta\mid\x)\bigr]=\bzero이므로 β\bbeta가 (Exx′)β=ExY(E\x\x\T)\bbeta=E\x Y를 풀고, 해는 하나뿐이다. (c) 두 식을 풀면 된다(연습 2.1의 모집단판).

5회 따름정리 3.19는 이변량 정규에서 조건부 기댓값이 직선임을 보였다. 정리 5.1는 정규가 아니어도 그 직선이 “최선의 직선”이라는 뜻을 갖는다고 말한다. 이것이 Yule의 통찰이다. 표본의 최소제곱 β^=(1n∑xixi′)−1(1n∑xiyi)\bhat=(\tfrac1n\sum\x_i\x_i\T)^{-1}(\tfrac1n\sum\x_iy_i)은 이 식의 기댓값을 표본평균으로 바꾼 것이므로, 대수의 법칙(7회)으로 β∗\bbeta^*에 수렴한다. 선형모형이 틀려도 최소제곱은 “가장 좋은 선형 근사”를 추정한다.

예제 5.2 (Galton의 928명) 부모 키 xx로 자녀 키 yy를 최소제곱으로 맞추면

y^=23.94+0.646 x,SE(b^1)=0.041,R2=0.210\hat y=23.94+0.646\,x,\qquad \mathrm{SE}(\hat b_1)=0.041,\qquad R^2=0.210

이다. 거꾸로 yy로 xx를 맞춘 기울기는 0.326이다. 두 기울기의 곱 0.646×0.326=0.2100.646\times0.326=0.210은 r2r^2이다(r=0.459r=0.459). 두 회귀선은 다른 직선이다. 부모에서 자녀로도, 자녀에서 부모로도 평균 쪽으로 당겨진다(그림 5.1 왼쪽). Pearson–Lee(1903)의 도수표를 무게로 맞추면(따름정리 3.7) 아버지–아들 기울기는 0.519 (1078쌍, r=0.514r=0.514), 아버지–딸 0.479, 어머니–아들 0.563, 어머니–딸 0.545다. Galton의 기울기가 더 큰 것은 그의 설명변수가 두 부모의 평균이어서 분산이 개인 키의 약 절반이기 때문이다.
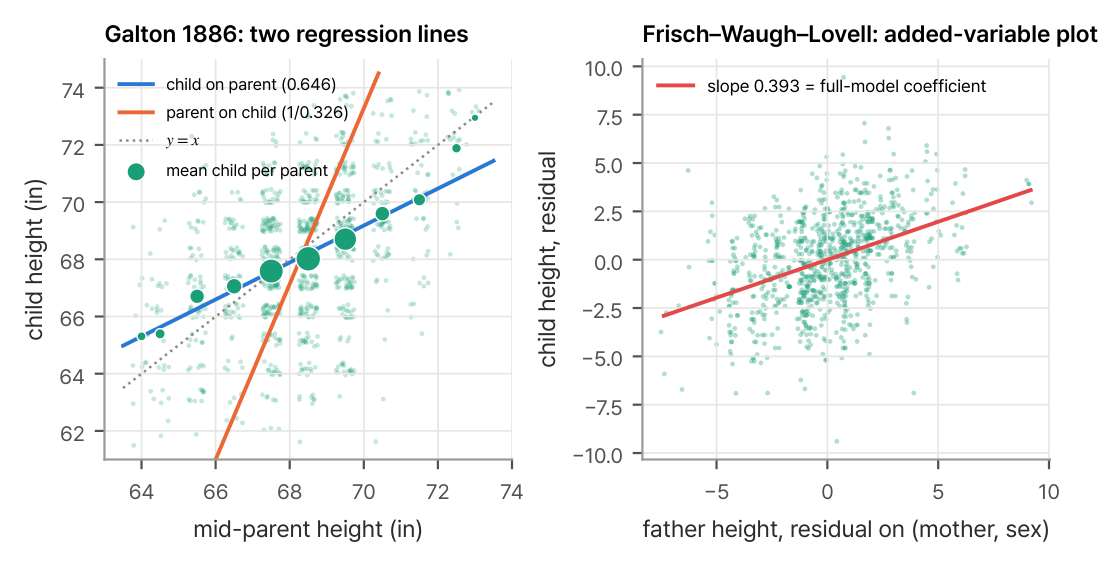
그림 5.1. 왼쪽: Galton의 928명(점은 겹치지 않게 조금 흔들었다). 자녀를 부모로 맞춘 직선(파랑, 기울기 0.646)과 부모를 자녀로 맞춘 직선(주황)은 다른 직선이고, 둘 다 y=x(점선)보다 평균 쪽으로 기울어 있다. 초록 점은 부모 키마다 자녀 키의 평균(크기는 인원)이다. 오른쪽: 가족 자료의 편회귀 그림. 아버지
그림 5.1 왼쪽: Galton의 928명(점은 겹치지 않게 조금 흔들었다). 자녀를 부모로 맞춘 직선(파랑, 기울기 0.646)과 부모를 자녀로 맞춘 직선(주황)은 다른 직선이고, 둘 다 y=xy=x(점선)보다 평균 쪽으로 기울어 있다. 초록 점은 부모 키마다 자녀 키의 평균(크기는 인원)이다. 오른쪽: 가족 자료의 편회귀 그림. 아버지 키와 자녀 키를 각각 (상수, 어머니 키, 성별)로 맞춘 잔차끼리의 기울기 0.393은 다중회귀의 아버지 계수와 같다(정리 5.3).

가정 주의 회귀의 오류. 1933년 Horace Secrist는 사업에서 평범함의 승리에서, 1920년 수익이 높았던 회사들이 10년 뒤 평균으로 내려오고 낮았던 회사들이 올라온 것을 보고 경쟁이 모든 회사를 평범하게 만든다고 결론지었다. Hotelling은 서평에서 이것이 상관이 1보다 작으면 반드시 생기는 회귀일 뿐이라고 지적했다. 같은 자료를 거꾸로 보면 1930년의 상위 회사들은 1920년에 평균에 더 가까웠다(연습 5.2). 처치 전에 극단인 집단을 고르면 처치가 없어도 “개선”된다.

5.2 다른 변수를 고정한다는 것 ​

설명변수가 여럿이면 계수 하나는 무엇을 뜻하나? Yule(1907)은 “다른 변수의 영향을 뺀” 편회귀계수라는 답을 주었다. 다음 정리가 그 뜻을 정확히 만든다.

정리 5.3 (Frisch–Waugh–Lovell) X=[X1,X2]X=[X_1,X_2] (n×p1n\times p_1, n×p2n\times p_2)이 완전 계수이고 β^=(β^1,β^2)\bhat=(\bhat_1,\bhat_2)가 y\y를 XX로 맞춘 최소제곱 해라 하자. H1H_1을 X1X_1의 hat 행렬, M1=I−H1M_1=I-H_1이라 하면

β^2=(X2′M1X2)−1X2′M1y\bhat_2=(X_2\T M_1X_2)^{-1}X_2\T M_1\y

이다. 곧 β^2\bhat_2는 “X1X_1로 맞추고 남은 y\y”를 “X1X_1로 맞추고 남은 X2X_2”로 맞춘 계수이고, 두 회귀의 잔차는 같다.

증명 전략 전체 회귀의 식 y=X1β^1+X2β^2+e\y=X_1\bhat_1+X_2\bhat_2+\e에 M1M_1을 곱해 X1X_1을 지운다. 남은 식이 M1yM_1\y를 M1X2M_1X_2로 맞추는 회귀의 정규방정식을 그대로 만족함을 확인한다.

  1. y=X1β^1+X2β^2+e\y=X_1\bhat_1+X_2\bhat_2+\e이고 X1′e=0X_1\T\e=\bzero, X2′e=0X_2\T\e=\bzero이다.정리 2.2(a)

  2. M1X1=0M_1X_1=0이고, e⊥col⁡(X1)\e\perp\col(X_1)이므로 M1e=eM_1\e=\e이다.정리 2.5(a)(c)

  3. 1의 양변에 M1M_1을 곱하면 M1y=M1X2 β^2+eM_1\y=M_1X_2\,\bhat_2+\e이다.2

  4. (M1X2)′e=X2′M1e=X2′e=0(M_1X_2)\T\e=X_2\T M_1\e=X_2\T\e=\bzero이다.M1M_1 대칭, 2 1

  5. 3 4는 β^2\bhat_2가 M1yM_1\y를 M1X2M_1X_2로 맞추는 정규방정식을 풀고 그 잔차가 e\e라는 뜻이다.정리 2.2(a)

  6. M1X2v=0M_1X_2\bv=\bzero이면 X2v∈col⁡(X1)X_2\bv\in\col(X_1)이고 XX가 완전 계수이므로 v=0\bv=\bzero이다. 따라서 X2′M1X2=(M1X2)′(M1X2)X_2\T M_1X_2=(M_1X_2)\T(M_1X_2)는 가역이고 해는 하나다.정리 2.2(c)

Frisch와 Waugh(1933)는 시계열에서 추세를 미리 빼고 회귀하는 것과 추세를 변수로 넣는 것이 같은 계수를 준다는 것을 보였다. Lovell(1963)이 일반형으로 썼다. 상수항 열 X1=1X_1=\one을 빼는 것은 평균을 빼는 것이다. 단순회귀의 기울기가 중심화한 자료의 기울기인 이유가 이것이다.

따름정리 5.4 (계수의 분산과 분산팽창계수) 상수항이 있는 모형에서 xjx_j를 나머지 열로 맞춘 결정계수를 Rj2R_j^2, Sjj=∑i(xij−xˉj)2S_{jj}=\sum_i(x_{ij}-\bar x_j)^2이라 하면

Var⁡β^j=σ2Sjj(1−Rj2),VIFj=11−Rj2.\Var\hat\beta_j=\frac{\sigma^2}{S_{jj}(1-R_j^2)},\qquad \mathrm{VIF}_j=\frac1{1-R_j^2}.

증명 전략 정리 5.3로 β^j\hat\beta_j를 “나머지 열로 맞추고 남은 xjx_j”에 대한 단순한 계수로 쓴다. 그 분모가 xjx_j를 나머지로 맞춘 잔차제곱합이고, 명제 2.6로 Sjj(1−Rj2)S_{jj}(1-R_j^2)이다. 단계별 증명은 연습 5.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

VIFj\mathrm{VIF}_j는 다른 변수와의 상관 때문에 β^j\hat\beta_j의 분산이 몇 배 커지는지 말한다. 7절에서 VIF가 수백인 자료를 본다.

예제 5.5 (Galton의 가족 자료) Galton의 원장부를 옮긴 가족 자료(205가족의 자녀 934명)로 자녀 키를 아버지 키, 어머니 키, 성별(아들이면 1)로 맞추면

y^=16.52+0.393 (아버지)+0.318 (어머니)+5.21 (아들)\hat y=16.52+0.393\,(\text{아버지})+0.318\,(\text{어머니})+5.21\,(\text{아들})

이고 표준오차는 차례로 2.73, 0.029, 0.031, 0.142, R2=0.635R^2=0.635, s=2.16s=2.16이다. 아버지 계수 0.393은 아버지 키를 (상수, 어머니, 성별)로 맞춘 잔차에 자녀 키의 잔차를 맞춘 기울기와 소수점 열두 자리까지 같다(정리 5.3, 그림 5.1 오른쪽). “아버지와 어머니의 계수가 같다”는 H0:β아버지=β어머니H_0:\beta_{\text{아버지}}=\beta_{\text{어머니}}의 FF 검정(정리 4.9, q=1q=1)은 F=3.00F=3.00, p=0.084p=0.084다. Galton의 “어머니 키에 1.08을 곱한다”는 처방은 아들과 딸의 평균 키의 비 69.23/64.10=1.08069.23/64.10=1.080과 같다.

가정 주의 한 가족의 자녀들은 독립이 아니다. 같은 부모에게서 같은 유전자와 같은 식탁을 물려받았다. 정의 1.1의 Cov⁡ε=σ2I\Cov\beps=\sigma^2I가 깨지므로 위의 표준오차는 실제보다 작다. 가족마다 공통의 효과를 넣는 계층모형은 16회에서 다룬다.

명제 5.6 (누락변수의 치우침) 참 모형이 y=X1β1+X2β2+ε\y=X_1\bbeta_1+X_2\bbeta_2+\beps인데 X1X_1만으로 맞추면 β~1=(X1′X1)−1X1′y\btil_1=(X_1\T X_1)^{-1}X_1\T\y의 기댓값은

Eβ~1=β1+Γβ2,Γ=(X1′X1)−1X1′X2E\btil_1=\bbeta_1+\Gamma\bbeta_2,\qquad \Gamma=(X_1\T X_1)^{-1}X_1\T X_2

이다. Γ\Gamma는 빠진 변수 X2X_2를 X1X_1로 맞춘 계수다. 치우침은 X1′X2β2=0X_1\T X_2\bbeta_2=\bzero일 때만 0이다.

증명 Eβ~1=(X1′X1)−1X1′(X1β1+X2β2)E\btil_1=(X_1\T X_1)^{-1}X_1\T(X_1\bbeta_1+X_2\bbeta_2). X1′X1X_1\T X_1이 가역이므로 마지막 문장이 나온다.

빠진 변수가 결과와 관계있고(β2≠0\bbeta_2\ne\bzero) 남은 변수와 상관되면(Γ≠0\Gamma\ne0), 남은 변수의 계수는 빠진 변수의 몫까지 떠안는다. 7절의 Yule–Simpson 역설이 이것의 극단이다.

연습문제

연습 5.1 (두 회귀선 ★) yy를 xx로 맞춘 기울기 byxb_{yx}와 xx를 yy로 맞춘 기울기 bxyb_{xy}의 곱이 r2r^2임을 보여라. 두 직선을 같은 (x,y)(x,y) 평면에 그리면 어느 쪽이 더 가파른가? Galton의 수치로 확인하라.

풀이

byx=Sxy/Sxxb_{yx}=S_{xy}/S_{xx}, bxy=Sxy/Syyb_{xy}=S_{xy}/S_{yy}이므로 곱은 Sxy2/(SxxSyy)=r2S_{xy}^2/(S_{xx}S_{yy})=r^2. (x,y)(x,y) 평면에서 xx를 yy로 맞춘 직선의 기울기는 1/bxy1/b_{xy}이고 ∣1/bxy∣=∣byx∣/r2≥∣byx∣|1/b_{xy}|=|b_{yx}|/r^2\ge|b_{yx}|이므로 더 가파르다. Galton: 0.646×0.326=0.2100.646\times0.326=0.210, 1/0.326=3.071/0.326=3.07.

연습 5.2 (회귀의 오류 ★★) (X,Y)(X,Y)가 평균 μ\mu, 분산 σ2\sigma^2이 같고 상관이 ρ<1\rho<1인 이변량 정규라 하자. E[Y−X∣X=x]=−(1−ρ)(x−μ)E[Y-X\mid X=x]=-(1-\rho)(x-\mu)와 E[X−Y∣Y=y]=−(1−ρ)(y−μ)E[X-Y\mid Y=y]=-(1-\rho)(y-\mu)를 보여라. 1920년(XX)의 상위 회사가 1930년(YY)에 내려오는 것과 1930년의 상위 회사가 1920년에 낮았던 것이 어떻게 동시에 참인가?

풀이

5회 따름정리 3.19로 E[Y∣X=x]=μ+ρ(x−μ)E[Y\mid X=x]=\mu+\rho(x-\mu)이므로 E[Y−X∣X=x]=−(1−ρ)(x−μ)E[Y-X\mid X=x]=-(1-\rho)(x-\mu). 대칭이므로 반대 방향도 같다. 두 해의 분산이 같아도 극단은 양쪽 시간 방향으로 모두 평균에 가까워진다. 극단을 고르는 순간 그 해의 우연한 오차까지 함께 고르기 때문이고, 그 오차는 다른 해에 반복되지 않는다. 분산이 줄어든 것이 아니므로 “평범해짐”은 일어나지 않았다.

연습 5.3 (직선이 놓치는 것 ★★) X∼N(0,1)X\sim\N(0,1), Y=X2Y=X^2이면 정리 5.1의 최선의 직선은 β0∗=1\beta_0^*=1, β1∗=0\beta_1^*=0임을 보여라. YY는 XX로 완전히 정해지는데 최선의 직선의 설명력은 0이다. 무엇이 잘못되었나?

풀이

Cov⁡(X,X2)=EX3=0\Cov(X,X^2)=EX^3=0이므로 β1∗=0\beta_1^*=0, β0∗=EX2=1\beta_0^*=EX^2=1이다. 최선의 직선은 상수 1이고 설명력은 0이다. 잘못은 모형의 꼴에 있다. E[Y∣X]=X2E[Y\mid X]=X^2은 직선이 아니다. 설계행렬에 x2x^2 열을 더하면(모수에 대해서는 여전히 선형모형) 완전히 맞는다.

연습 5.4 (성별을 빼면 ★★) 가족 자료에서 자녀 키를 Galton의 부모 키(아버지 키와 어머니 키의 1.08배의 평균)만으로 맞추면 기울기 0.637, R2=0.103R^2=0.103이고, 성별을 더하면 기울기 0.687, R2=0.633R^2=0.633이다. 명제 5.6로 기울기가 바뀐 방향을 설명하라. (노트북에서 Γ\Gamma를 계산한다.)

풀이

표본에서도 명제 5.6의 식은 정확한 항등식이다. 짧은 회귀의 기울기 == 긴 회귀의 기울기 +Γ^×+\hat\Gamma\times(성별 계수)이다. Γ^\hat\Gamma는 성별(아들 1)을 부모 키로 맞춘 기울기로, 노트북에서 −0.0095-0.0095이다. 0.687+(−0.0095)(5.215)=0.6370.687+(-0.0095)(5.215)=0.637. 부모 키가 큰 가족에 아들의 비율이 조금 낮았고, 성별을 빼면 그만큼 기울기가 작게 나온다. R2R^2이 크게 오른 것은 성별이 자녀 키의 변동을 많이 설명하기 때문이다.

연습 5.5 (계수의 분산과 VIF ★★ 유도형) 따름정리 5.4를 다음 순서로 증명하라. X1X_1을 jj번째 열을 뺀 나머지 열(상수항 포함), M=I−H1M=I-H_1이라 하자.

  1. (a)

    정리 5.3로 β^j=x(j)TMy/∥Mx(j)∥2\hat\beta_j=\x^{(j)\mathsf T}M\y/\|M\x^{(j)}\|^2임을 보여라.

  2. (b)

    My=Mx(j)βj+MεM\y=M\x^{(j)}\beta_j+M\beps를 보이고 Var⁡β^j=σ2/∥Mx(j)∥2\Var\hat\beta_j=\sigma^2/\|M\x^{(j)}\|^2을 얻어라.

  3. (c)

    ∥Mx(j)∥2\|M\x^{(j)}\|^2이 xjx_j를 X1X_1로 맞춘 잔차제곱합임을 보이고, 명제 2.6로 Sjj(1−Rj2)S_{jj}(1-R_j^2)와 같음을 보여라. 왜 X1X_1에 상수항이 있어야 하는가?

풀이

(a) 정리 5.3에서 X2=x(j)X_2=\x^{(j)} (한 열)로 두면 β^j=(x(j)TMx(j))−1x(j)TMy\hat\beta_j=(\x^{(j)\mathsf T}M\x^{(j)})^{-1}\x^{(j)\mathsf T}M\y이다. MM이 대칭 멱등이므로 x(j)TMx(j)=∥Mx(j)∥2\x^{(j)\mathsf T}M\x^{(j)}=\|M\x^{(j)}\|^2이다. (b) y=X1β1+x(j)βj+ε\y=X_1\bbeta_1+\x^{(j)}\beta_j+\beps이고 MX1=0MX_1=0이므로 My=Mx(j)βj+MεM\y=M\x^{(j)}\beta_j+M\beps이다. (a)에 넣으면 β^j=βj+x(j)TMε/∥Mx(j)∥2\hat\beta_j=\beta_j+\x^{(j)\mathsf T}M\beps/\|M\x^{(j)}\|^2이고, 5회 보조정리 3.1로 Var⁡β^j=σ2x(j)TMMx(j)/∥Mx(j)∥4=σ2/∥Mx(j)∥2\Var\hat\beta_j=\sigma^2\x^{(j)\mathsf T}MM\x^{(j)}/\|M\x^{(j)}\|^4=\sigma^2/\|M\x^{(j)}\|^2이다. (c) Mx(j)=(I−H1)x(j)M\x^{(j)}=(I-H_1)\x^{(j)}는 xjx_j를 X1X_1로 맞춘 잔차이므로 ∥Mx(j)∥2\|M\x^{(j)}\|^2은 그 회귀의 RSS다. X1X_1에 상수항이 있으므로 명제 2.6를 그 회귀에 쓸 수 있고, TSS=Sjj\mathrm{TSS}=S_{jj}이므로 RSS=Sjj(1−Rj2)\mathrm{RSS}=S_{jj}(1-R_j^2)이다. 상수항이 없으면 TSS=ESS+RSS\mathrm{TSS}=\mathrm{ESS}+\mathrm{RSS}가 중심화한 제곱합으로 성립하지 않아 이 식이 맞지 않는다.

이 회차에서 읽은 절 0개 · 회차 차례