Skip to content

13회 · 최소제곱 · 노트

7 부숴보기 — 가정이 깨질 때 ​

정의 1.1의 가정은 셋이다. 평균이 XβX\bbeta이고, 분산이 같고, 오차가 서로 무상관이다. 4절은 여기에 정규성을 더했다. 하나씩 깨 본다.

7.1 분산이 다르면 — 샌드위치 ​

명제 7.1 (이분산 아래의 최소제곱) Cov⁡ε=Σ=diag⁡(σ12,…,σn2)\Cov\beps=\Sigma=\diag(\sigma_1^2,\allowbreak \dots,\allowbreak \sigma_n^2)이면 β^\bhat은 여전히 불편이고

Cov⁡β^=(X′X)−1(∑i=1nσi2xixi′)(X′X)−1\Cov\bhat=(X\T X)^{-1}\Bigl(\sum_{i=1}^n\sigma_i^2\x_i\x_i\T\Bigr)(X\T X)^{-1}

이다. 보통의 공식 s2(X′X)−1s^2(X\T X)^{-1}은 일반적으로 이것과 다르다.

증명 불편성은 Eε=0E\beps=\bzero만 쓴다. 공분산은 5회 보조정리 3.1로 (X′X)−1X′ΣX(X′X)−1(X\T X)^{-1}X\T\Sigma X(X\T X)^{-1}이고 X′ΣX=∑σi2xixi′X\T\Sigma X=\sum\sigma_i^2\x_i\x_i\T이다.

빵 두 장 (X′X)−1(X\T X)^{-1} 사이에 속 ∑σi2xixi′\sum\sigma_i^2\x_i\x_i\T가 있어서 샌드위치라 부른다. 속의 σi2\sigma_i^2을 ei2e_i^2으로 바꾼 추정량(HC0)을 Eicker(1963), Huber(1967), White(1980)가 차례로 내놓았다. n→∞n\to\infty에서 일치추정량이다. 작은 표본에서는 n/(n−p)n/(n-p)를 곱하거나(HC1) ei2e_i^2을 ei2/(1−hii)2e_i^2/(1-h_{ii})^2로 바꾼다(HC3). 명제 2.7(c)로 Eei2≈σi2(1−hii)Ee_i^2\approx\sigma_i^2(1-h_{ii})이어서 잔차가 오차보다 작기 때문이다.

예제 7.2 (분산이 x2x^2에 비례할 때) xix_i를 0에서 10까지 고르게 100개 잡고 yi=1+0.5xi+εiy_i=1+0.5x_i+\varepsilon_i, εi∼N(0,(0.05xi2)2)\varepsilon_i\sim\N(0,\allowbreak (0.05x_i^2)^2)이라 하자. 기울기의 참 표준편차는 명제 7.1로 0.097이다. 보통의 공식으로 추정한 분산의 기댓값은 참 분산의 0.63배이고(연습 7.1), 표준오차로 바꾸면 0.077이다. 95% tt-구간의 실제 포함확률은 약 88%로 떨어진다. HC1과 HC3 표준오차로 바꾸면 약 94%와 95%로 돌아온다(노트북, 4만 번 반복). 분산이 큰 점이 xx의 양 끝, 곧 기울기를 정하는 데 힘이 큰 곳에 있어서 보통의 공식이 불확실성을 과소평가한다.

7.2 한 점이 모든 것을 정하면 — 지렛대와 영향 ​

명제 7.3 (한 점을 빼고 다시 맞추기) hii<1h_{ii}<1일 때 관측 ii를 빼고 맞춘 최소제곱 해를 β^(i)\bhat_{(i)}라 하면

β^−β^(i)=(X′X)−1xiei1−hii,yi−xi′β^(i)=ei1−hii.\bhat-\bhat_{(i)}=\frac{(X\T X)^{-1}\x_ie_i}{1-h_{ii}},\qquad y_i-\x_i\T\bhat_{(i)}=\frac{e_i}{1-h_{ii}} .

증명 전략 관측 하나를 빼면 X′XX\T X에서 계수 1인 행렬 xixi′\x_i\x_i\T가 빠진다. 그 역행렬을 Sherman–Morrison 공식(연습 7.2)으로 쓰고 전개한다. 단계별 증명은 연습 7.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

빼고 맞춘 잔차 ei/(1−hii)e_i/(1-h_{ii})의 제곱합(PRESS)은 한-점-빼기 교차검증의 오차다. 최소제곱에서는 nn번 다시 맞출 필요 없이 한 번의 적합으로 계산된다. 지렛대가 1에 가까우면 그 점을 빼는 순간 해가 크게 움직인다.

예제 7.4 (Anscombe의 네 자료 (1973)) Francis Anscombe는 n=11n=11인 자료 네 개를 만들었다. 네 자료 모두 최소제곱 직선이 y^=3.00+0.500x\hat y=3.00+0.500x이고 R2=0.667R^2=0.667이며 요약표의 숫자가 거의 같다. 그러나 그림 7.1을 보면 첫째만 직선 모형에 맞는다. 둘째는 곡선이고, 셋째는 이상치 하나가 기울기를 끌어올렸으며, 넷째는 xx가 열 번 8이고 한 번 19다. 넷째의 x=19x=19인 점은 지렛대가 1이어서(연습 2.3) 잔차가 언제나 0이고, 기울기는 그 한 점과 나머지 열 점의 평균을 잇는 직선의 기울기다. 그 점을 빼면 기울기는 정해지지도 않는다. 요약표만 보지 말고 그림을 보라는 것이 Anscombe의 교훈이다.
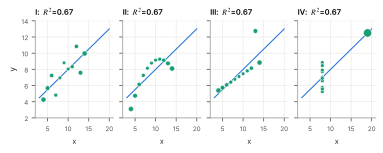
그림 7.1. Anscombe의 네 자료. 최소제곱 직선(파랑)과 R²이 모두 같다. 점의 크기는 지렛대 h_ii에 비례한다. 넷째 자료의 오른쪽 점은 h_ii=1이다.
그림 7.1 Anscombe의 네 자료. 최소제곱 직선(파랑)과 R2R^2이 모두 같다. 점의 크기는 지렛대 hiih_{ii}에 비례한다. 넷째 자료의 오른쪽 점은 hii=1h_{ii}=1이다.

7.3 설명변수가 서로 닮으면 — 공선성 ​

예제 7.5 (VIF 344) x1∼N(0,1)x_1\sim\N(0,1), x2=x1+N(0,0.052)x_2=x_1+\N(0,0.05^2)로 n=100n=100개를 만들고 y=1+x1+x2+εy=1+x_1+x_2+\varepsilon, ε∼N(0,1)\varepsilon\sim\N(0,1)로 맞춘다. 모집단에서는 r122=1/1.0025r_{12}^2=1/1.0025이므로 VIF=401\mathrm{VIF}=401이고, 한 표본에서는 r12=0.9985r_{12}=0.9985, VIF=1/(1−r122)=344\mathrm{VIF}=1/(1-r_{12}^2)=344였다. 따름정리 5.4로 두 계수의 분산은 상관이 없을 때의 344배이고, 그 표본에서 β^1=4.71\hat\beta_1=4.71, β^2=−2.87\hat\beta_2=-2.87, 표준오차는 둘 다 2.06이다. 참값은 둘 다 1이다. 두 계수 각각은 거의 아무것도 말하지 않는다. 그러나 합 β^1+β^2=1.83\hat\beta_1+\hat\beta_2=1.83의 표준오차는 0.111이다. 자료는 “두 변수를 함께 올리면 yy가 얼마나 오르나”에는 정확히 답하고, “하나만 올리면”에는 답하지 못한다. 두 변수가 따로 움직인 적이 거의 없기 때문이다. 그림 7.2의 가운데가 반복 표본에서의 (β^1,β^2)(\hat\beta_1,\hat\beta_2)다. 직선 β1+β2=2\beta_1+\beta_2=2를 따라 길게 늘어선다.

공선성은 모형의 잘못이 아니라 자료의 한계다. 처방은 두 변수를 따로 움직인 자료를 더 모으거나, 합처럼 정해지는 조합만 보고하거나, 8절의 ridge처럼 치우침을 받아들이는 것이다.

7.4 변수 하나를 빼면 — Yule–Simpson의 역설 ​

예제 7.6 (Berkeley 대학원 입학 (1973)) 1973년 가을 Berkeley 대학원의 큰 여섯 학과에 4526명이 지원했다. 남자의 합격률은 44.5%, 여자는 30.4%다. 합격(1 또는 0)을 여자 표시로 회귀하면(선형확률모형) 계수는 −0.142-0.142다. 학과 표시 여섯 개를 넣으면 계수는 +0.018+0.018 (SE 0.015)이 된다. 학과 안에서는 차이가 거의 없거나 여자 쪽이 조금 높다. 여자는 합격률이 낮은 학과에 많이 지원했다. 합격률이 6%인 F과, 25%인 E과, 35%인 C과의 여자 비율은 48%, 67%, 65%였고, 합격률이 64%와 63%인 A과와 B과에서는 12%와 4%였다. 명제 5.6의 언어로, 빠진 변수(학과)가 결과(합격)와 관계있고 남은 변수(성별)와 상관되어 성별의 계수가 학과의 몫을 떠안았다(그림 7.2 오른쪽).

역사 Pearson(1899)과 Yule(1903)은 두 집단을 합칠 때 연관의 방향이 뒤집힐 수 있다는 것을 알았다. Simpson(1951)이 이것을 정리했고, 1975년 Bickel·Hammel·O'Connell이 Berkeley 자료로 유명하게 만들었다. 어느 쪽이 “옳은” 계수인지는 통계학만으로 정해지지 않는다. 학과 선택이 성별의 결과인지, 성별과 무관한 다른 원인의 결과인지에 따라 묻는 질문이 다르다. 회귀계수는 “다른 변수를 고정했을 때”의 비교이고, 무엇을 고정할지는 인과의 구조가 정한다.
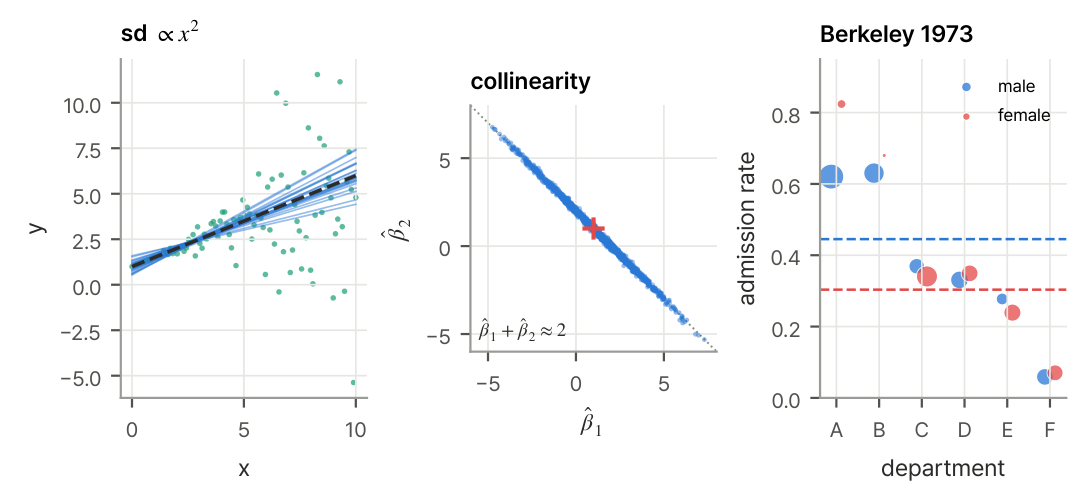
그림 7.2. 가정이 깨질 때. 왼쪽: 분산이 x²에 비례하는 자료와 반복 표본의 적합 직선 20개. 직선의 흔들림은 양 끝의 큰 분산에서 온다. 가운데: 공선성(모집단 VIF=401) 아래 반복 표본의 (hatβ_1,hatβ_2). 각각은 크게 흩어지지만 합은 2 근처에 묶여 있다. 오른쪽: Berkeley의 여섯 학과. 학과마다 남
그림 7.2 가정이 깨질 때. 왼쪽: 분산이 x2x^2에 비례하는 자료와 반복 표본의 적합 직선 20개. 직선의 흔들림은 양 끝의 큰 분산에서 온다. 가운데: 공선성(모집단 VIF=401\mathrm{VIF}=401) 아래 반복 표본의 (β^1,β^2)(\hat\beta_1,\hat\beta_2). 각각은 크게 흩어지지만 합은 2 근처에 묶여 있다. 오른쪽: Berkeley의 여섯 학과. 학과마다 남녀 합격률(점 크기는 지원자 수)과 전체 합격률(가로선). 전체에서는 여자가 낮지만 학과 안에서는 거의 같다.
연습문제

연습 7.1 (보통 공식의 기댓값 ★★) Cov⁡ε=Σ\Cov\beps=\Sigma일 때 보통의 분산 추정량 s2[(X′X)−1]jjs^2[(X\T X)^{-1}]_{jj}의 기댓값이 tr⁡((I−H)Σ)n−p[(X′X)−1]jj\dfrac{\tr\bigl((I-H)\Sigma\bigr)}{n-p}[(X\T X)^{-1}]_{jj}임을 보여라(보조정리 3.1). 예제 7.2의 비 0.63을 노트북으로 확인하라.

풀이

RSS=ε′(I−H)ε\mathrm{RSS}=\beps\T(I-H)\beps이고 보조정리 3.1로 E RSS=tr⁡((I−H)Σ)E\,\mathrm{RSS}=\tr\bigl((I-H)\Sigma\bigr)이다. n−pn-p로 나누고 [(X′X)−1]jj[(X\T X)^{-1}]_{jj}를 곱한다. 예제의 설계에서 이것과 명제 7.1의 참 분산의 비가 0.63이다(노트북).

연습 7.2 (Sherman–Morrison ★) 1−u′A−1u≠01-\bu\T A^{-1}\bu\ne0이면 (A−uu′)(A−1+A−1uu′A−11−u′A−1u)=I(A-\bu\bu\T)\Bigl(A^{-1}+\dfrac{A^{-1}\bu\bu\T A^{-1}}{1-\bu\T A^{-1}\bu}\Bigr)=I임을 확인하라.

풀이

c=1−u′A−1uc=1-\bu\T A^{-1}\bu라 하면 곱은 I+uu′A−1c−uu′A−1−u(u′A−1u)u′A−1c=I+uu′A−1(1−u′A−1uc−1)=II+\tfrac{\bu\bu\T A^{-1}}c-\bu\bu\T A^{-1}-\tfrac{\bu(\bu\T A^{-1}\bu)\bu\T A^{-1}}c=I+\bu\bu\T A^{-1}\bigl(\tfrac{1-\bu\T A^{-1}\bu}c-1\bigr)=I.

연습 7.3 (공선성의 두 표준오차 ★★) Var⁡(β^1+β^2)=Var⁡β^1+Var⁡β^2+2Cov⁡(β^1,β^2)\Var(\hat\beta_1+\hat\beta_2)=\Var\hat\beta_1+\Var\hat\beta_2+2\Cov(\hat\beta_1,\allowbreak \hat\beta_2)에서, 두 분산이 크더라도 합의 분산이 작을 수 있는 이유를 Cov⁡(β^1,β^2)\Cov(\hat\beta_1,\hat\beta_2)의 부호로 설명하라. 상수항이 없고 x1,x2x_1,x_2가 평균 0, 분산 1, 상관 rr인 경우 (X′X)−1(X\T X)^{-1}을 직접 쓰고 Var⁡(β^1±β^2)\Var(\hat\beta_1\pm\hat\beta_2)를 구하라.

풀이

β^1\hat\beta_1과 β^2\hat\beta_2의 공분산은 음수다(두 변수가 양의 상관이면 한쪽 계수가 크게 나올 때 다른 쪽이 작게 나온다). 합의 분산에서 큰 두 분산을 음의 공분산이 거의 상쇄한다. 예에서 X′X=n(1rr1)X\T X=n\smat{1&r\\r&1}, (X′X)−1=1n(1−r2)(1−r−r1)(X\T X)^{-1}=\tfrac1{n(1-r^2)}\smat{1&-r\\-r&1}이므로

Var⁡(β^1±β^2)=σ2(2∓2r)n(1−r2)=2σ2n(1±r).\Var(\hat\beta_1\pm\hat\beta_2)=\frac{\sigma^2(2\mp2r)}{n(1-r^2)}=\frac{2\sigma^2}{n(1\pm r)} .

합은 r→1r\to1에서 σ2/n\sigma^2/n으로 작고, 차는 2σ2/(n(1−r))2\sigma^2/(n(1-r))로 폭발한다.

연습 7.4 (두 학과의 역설 ★★) 두 학과 P, Q가 있다. P는 남자 80명 중 48명(60%), 여자 20명 중 13명(65%)을, Q는 남자 20명 중 4명(20%), 여자 80명 중 20명(25%)을 뽑았다. 학과마다 여자가 높지만 전체로는 남자가 높음을 보이고, 이것을 명제 5.6의 Γβ2\Gamma\beta_2로 설명하라.

풀이

전체: 남자 52/100=52%52/100=52\%, 여자 33/100=33%33/100=33\%. 학과 표시 QQ와 여자 표시 FF로 합격을 맞추면 칸의 평균이 0.60−0.40Q+0.05F0.60-0.40Q+0.05F로 정확히 맞으므로 긴 회귀의 여자 계수는 +0.05+0.05, QQ의 계수는 −0.40-0.40이다. Γ\Gamma는 QQ를 FF로 맞춘 기울기로, 여자 가운데 Q 지원 비율 0.8에서 남자의 0.2를 뺀 0.6이다. 짧은 회귀의 계수는 0.05+0.6×(−0.40)=−0.19=0.33−0.520.05+0.6\times(-0.40)=-0.19=0.33-0.52이다.

연습 7.5 (한 점을 빼고 다시 맞추기 ★★ 유도형) A=X′XA=X\T X, hii=xi′A−1xi<1h_{ii}=\x_i\T A^{-1}\x_i<1이다. 명제 7.3를 다음 순서로 증명하라.

  1. (a)

    관측 ii를 뺀 설계의 X′XX\T X와 X′yX\T\y가 A−xixi′A-\x_i\x_i\T와 X′y−xiyiX\T\y-\x_iy_i임을 보여라.

  2. (b)

    연습 7.2의 공식을 u=xi\bu=\x_i에 써서 β^(i)\bhat_{(i)}를 A−1A^{-1}, xi\x_i, hiih_{ii}로 써라.

  3. (c)

    전개해 β^(i)=β^−A−1xiyi+A−1xi(y^i−hiiyi)1−hii\bhat_{(i)}=\bhat-A^{-1}\x_iy_i+\dfrac{A^{-1}\x_i(\hat y_i-h_{ii}y_i)}{1-h_{ii}}를 얻고, 이것을 β^−A−1xiei1−hii\bhat-\dfrac{A^{-1}\x_ie_i}{1-h_{ii}}로 정리하라.

  4. (d)

    (c)에 xi′\x_i\T를 곱해 yi−xi′β^(i)=ei/(1−hii)y_i-\x_i\T\bhat_{(i)}=e_i/(1-h_{ii})를 얻어라.

풀이

(a) 관측 ii를 빼면 X′X=∑kxkxk′X\T X=\sum_k\x_k\x_k\T와 X′y=∑kxkykX\T\y=\sum_k\x_ky_k에서 k=ik=i인 항이 빠지므로 A−xixi′A-\x_i\x_i\T와 X′y−xiyiX\T\y-\x_iy_i이다. (b) hii=xi′A−1xi<1h_{ii}=\x_i\T A^{-1}\x_i<1이므로 연습 7.2의 공식을 쓸 수 있다.

β^(i)=(A−1+A−1xixi′A−11−hii)(X′y−xiyi).\bhat_{(i)}=\Bigl(A^{-1}+\frac{A^{-1}\x_i\x_i\T A^{-1}}{1-h_{ii}}\Bigr)(X\T\y-\x_iy_i) .

(c) A−1X′y=β^A^{-1}X\T\y=\bhat, xi′A−1X′y=y^i\x_i\T A^{-1}X\T\y=\hat y_i, xi′A−1xi=hii\x_i\T A^{-1}\x_i=h_{ii}을 써서 전개하면

β^(i)=β^−A−1xiyi+A−1xi(y^i−hiiyi)1−hii=β^+A−1xi(y^i−hiiyi−(1−hii)yi)1−hii=β^−A−1xiei1−hii.\bhat_{(i)}=\bhat-A^{-1}\x_iy_i+\frac{A^{-1}\x_i(\hat y_i-h_{ii}y_i)}{1-h_{ii}} =\bhat+\frac{A^{-1}\x_i\bigl(\hat y_i-h_{ii}y_i-(1-h_{ii})y_i\bigr)}{1-h_{ii}}=\bhat-\frac{A^{-1}\x_ie_i}{1-h_{ii}} .

(d) (c)에 xi′\x_i\T를 곱하면 xi′β^(i)=y^i−hiiei/(1−hii)\x_i\T\bhat_{(i)}=\hat y_i-h_{ii}e_i/(1-h_{ii})이므로 yi−xi′β^(i)=ei+hiiei/(1−hii)=ei/(1−hii)y_i-\x_i\T\bhat_{(i)}=e_i+h_{ii}e_i/(1-h_{ii})=e_i/(1-h_{ii})이다.

이 회차에서 읽은 절 0개 · 회차 차례