
테마
노트북 · 13회 · 최소제곱
최소제곱 방정식 27개로 미지수 3개를
| 강의노트 | 13_least_squares_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 13_least_squares_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Mayer의 달 칭동 (HistData Mayer) · Boscovich의 자오선 호 5개 (Stigler 1986의 표) · Laplace의 토성 (HistData Saturn) · Galton (HistData Galton, GaltonFamilies) · Pearson–Lee (HistData PearsonLee) · Anscombe의 네 자료 · Berkeley 입학 (datasets anscombe, UCBAdmissions) |
| 선수 지식 | 1–12회 (5회 다변량 정규·정리 D, 6회 Student의 정리··, 11회 완비충분통계량, 12회 가능도비 검정) |
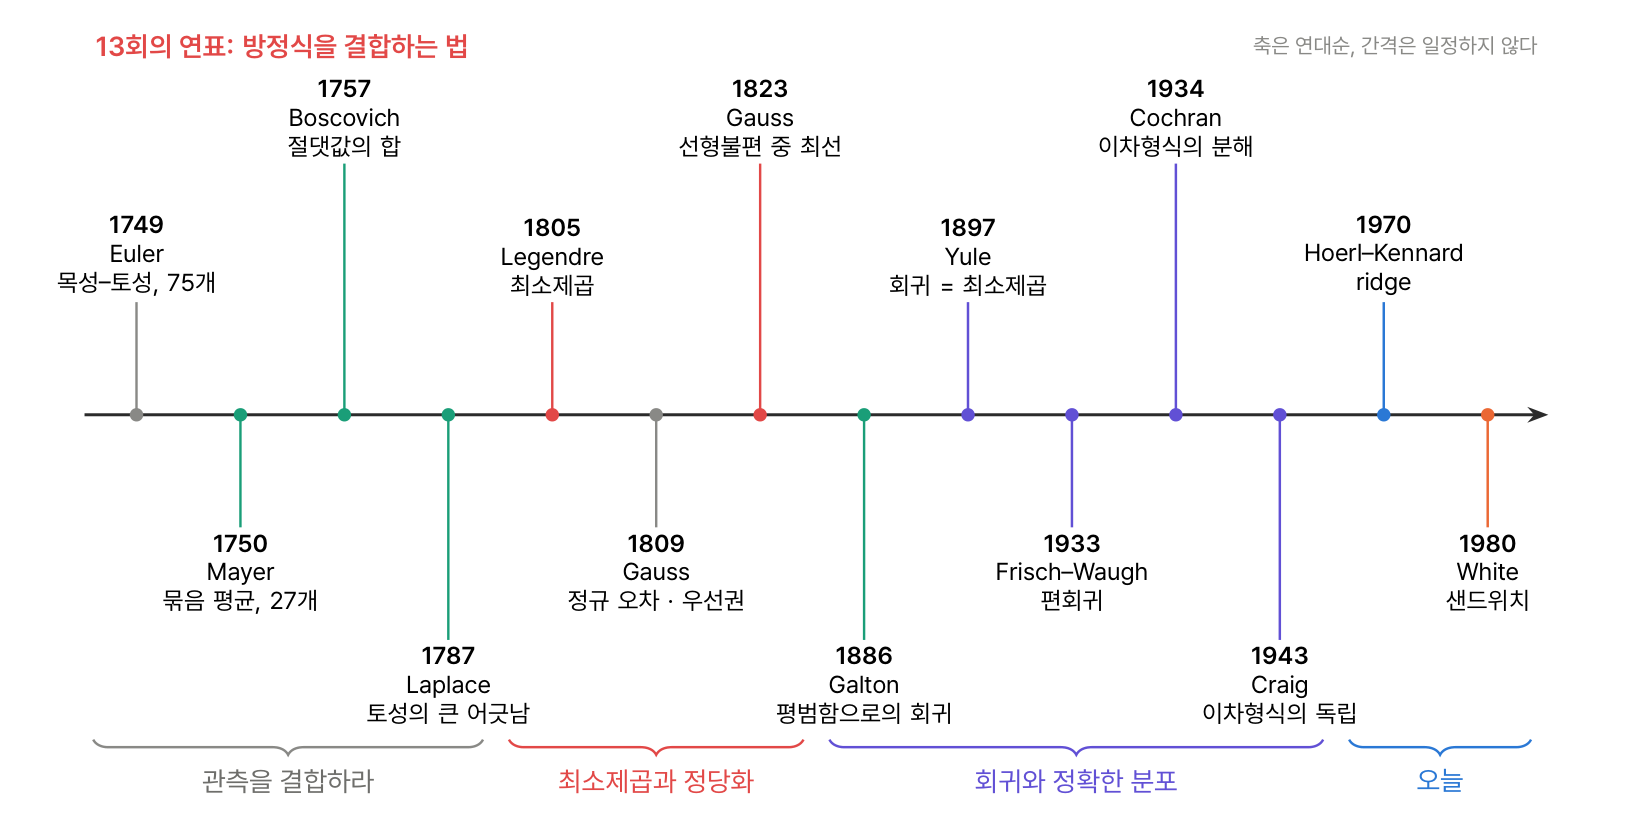
여는 질문. 미지수가 3개인데 관측 방정식이 27개다. 방정식들은 서로 조금씩 어긋나서 모두를 만족하는 해가 없다. 27개를 어떻게 하나로 결합해야 하는가? 그리고 어떤 결합이 "가장 좋은가"?
이번 회차의 지도
학습 목표
- Mayer의 묶음 평균, Boscovich의 가중 중앙값, 최소절댓값(선형계획법)을 직접 구현하고 최소제곱과 비교한다.
OLS를 정규방정식과 QR 두 방식으로 구현하고, hat 행렬의 성질과 조건수를 숫자로 확인한다.- Gauss–Markov 정리를 Mayer의 설계로 계산과 시뮬레이션 두 가지로 확인한다.
- 이차형식의 , Craig·Cochran의 독립, 계수의 와 일반선형가설의 를 시뮬레이션으로 확인한다.
- 회귀 요약표의 모든 숫자를 직접 계산하고(
statsmodels없이), 이분산·지렛대·공선성·Yule–Simpson·경사하강·ridge를 재현한다.
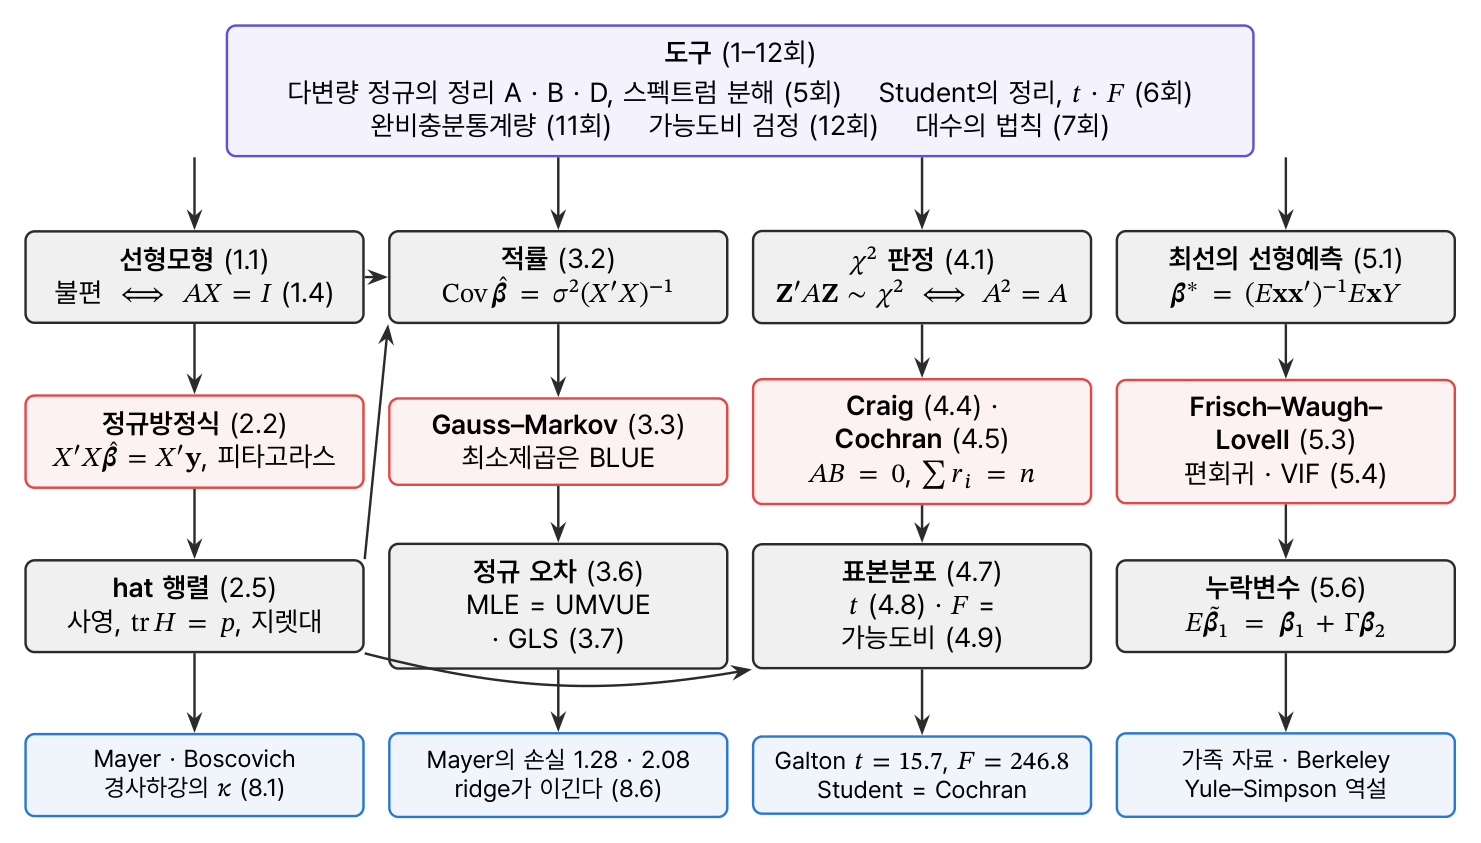
정리 지도
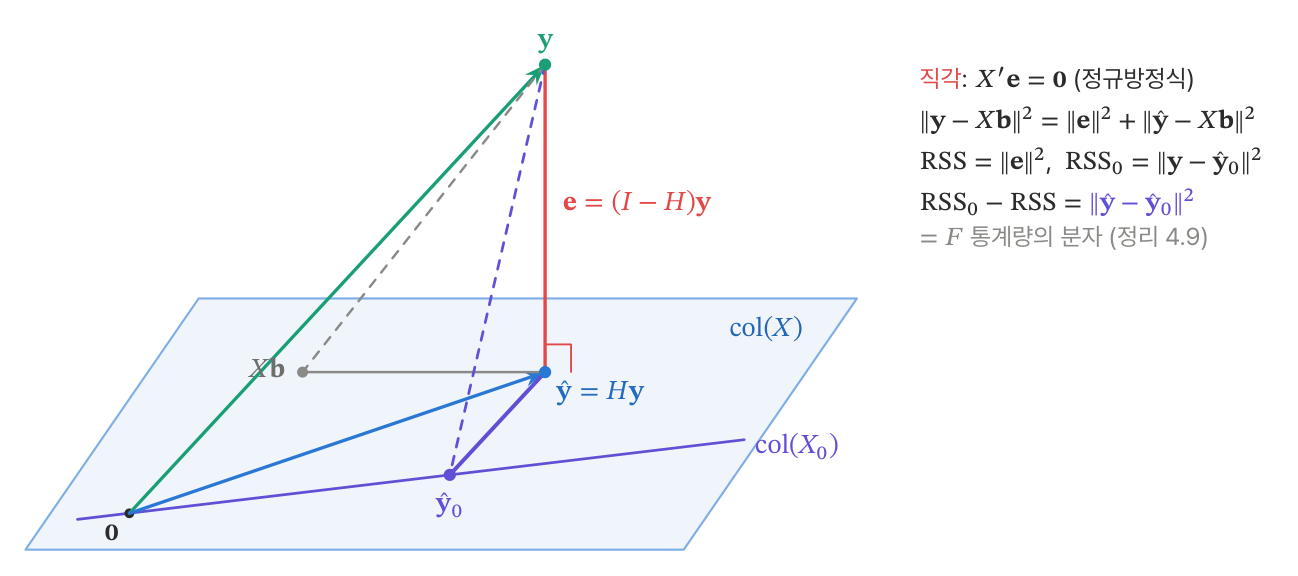
최소제곱의 기하
0. 설정
python
%matplotlib inline
import math
from itertools import combinations
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import optimize, stats

SEED = 1805
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

def dms(deg):
    """도 → '14°33.5′' (분은 소수 한 자리)"""
    s = "-" if deg < 0 else ""; deg = abs(deg); d = int(deg); m = round((deg - d) * 60, 1)
    if m >= 60: d, m = d + 1, m - 60
    return f"{s}{d}°{m:.1f}′"

def lad(X, y, A_extra=None):
    """최소절댓값: min Σ(u+v)  s.t.  Xb + u − v = y,  u, v ≥ 0  (연습 1.4의 선형계획법)"""
    n, p = X.shape
    c = np.r_[np.zeros(p), np.ones(2 * n)]
    A_eq = np.hstack([X, np.eye(n), -np.eye(n)]); b_eq = y
    if A_extra is not None:                        # 추가 등식 제약 (Boscovich 의 Σe = 0)
        A_eq = np.vstack([A_eq, A_extra]); b_eq = np.r_[y, 0.0]
    lp = optimize.linprog(c, A_eq=A_eq, b_eq=b_eq, bounds=[(None, None)] * p + [(0, None)] * (2 * n), method="highs")
    return lp.x[:p], lp.x[p:p + n], lp.x[p + n:]
1. 결합의 문제 (1749–1799)
정의 1.1 선형모형 , , · 예제 1.2 Mayer의 방정식 (로 선형화) · 명제 1.4 가 불편 · 예제 1.5 묶음 평균 · 명제 1.6 Boscovich = 가중 중앙값 · 명제 1.8 최소절댓값 해는 관측 개를 지난다.
Mayer의 자료에서 Y는 (도), X1은 (의 계수), X2·X3은 와 의 계수, Group은 Mayer가 정한 묶음이다.
python
M = load_rdata("Mayer")
X = M[["X1", "X2", "X3"]].to_numpy(float); y = M.Y.to_numpy(float); n, p = X.shape
G = np.column_stack([(M.Group == g).to_numpy(float) for g in ["I", "II", "III"]])
GX, Gy = G.T @ X, G.T @ y
print("묶음별 합 방정식 (β, α, γ 의 계수 | 우변):")
for g, row, rhs in zip(["I", "II", "III"], GX, Gy):
    print(f"  {g:>3}: {row.round(4)} | {rhs:.3f}")
A_M = np.linalg.solve(GX, G.T)                       # A = (G'X)^{-1} G'
b_M = A_M @ y; th_M = math.degrees(math.asin(b_M[2] / b_M[1]))
print(f"Mayer: β = {b_M[0]:.3f}° = {dms(b_M[0])},  α = {b_M[1]:.4f}° = {dms(b_M[1])},  γ = {b_M[2]:.4f},  θ = {dms(th_M)}")
groups = {g: list(M.Equation[M.Group == g]) for g in ["I", "II", "III"]}
report({"예제 1.5: 묶음 I = {1,2,3,6,9,10,11,12,27}, II = {8,18,19,21,...,26}": groups["I"] == [1, 2, 3, 6, 9, 10, 11, 12, 27] and groups["II"] == [8, 18, 19, 21, 22, 23, 24, 25, 26],
        "1.2절: 합 방정식의 계수 8.4987·−0.7932, −6.1404·1.7443, 2.7977·7.9649, 우변 −118.133·−140.283·−127.533":
            np.allclose(GX[:, 1:], [[8.4987, -0.7932], [-6.1404, 1.7443], [2.7977, 7.9649]], atol=5e-5) and np.allclose(Gy, [-118.133, -140.283, -127.533], atol=5e-4),
        "명제 1.4: Mayer 의 A 는 AX = I (선형불편)": np.allclose(A_M @ X, np.eye(3)),
        "예제 1.5 · 연습 1.1: β = 14°32.8′, α = 1°29.7′, γ = −0.0996, θ = −3°49.1′":
            dms(b_M[0]) == "14°32.8′" and dms(b_M[1]) == "1°29.7′" and abs(b_M[2] + 0.0996) < 5e-5 and dms(th_M) == "-3°49.1′"})
text
묶음별 합 방정식 (β, α, γ 의 계수 | 우변):
    I: [-9.      8.4987 -0.7932] | -118.133
   II: [-9.     -6.1404  1.7443] | -140.283
  III: [-9.      2.7977  7.9649] | -127.533
Mayer: β = 14.547° = 14°32.8′,  α = 1.4958° = 1°29.7′,  γ = -0.0996,  θ = -3°49.1′
  ✓  예제 1.5: 묶음 I = {1,2,3,6,9,10,11,12,27}, II = {8,18,19,21,...,26}
  ✓  1.2절: 합 방정식의 계수 8.4987·−0.7932, −6.1404·1.7443, 2.7977·7.9649, 우변 −118.133·−140.283·−127.533
  ✓  명제 1.4: Mayer 의 A 는 AX = I (선형불편)
  ✓  예제 1.5 · 연습 1.1: β = 14°32.8′, α = 1°29.7′, γ = −0.0996, θ = −3°49.1′
python
# 예제 1.5 끝 · 연습 1.5 · 예제 6.3: 세 방정식만 골라 풀면 — 2925 가지 선택
sols, dets = [], []
for idx in combinations(range(n), 3):
    XS = X[list(idx)]; dets.append(abs(np.linalg.det(XS)))
    sols.append(np.linalg.solve(XS, y[list(idx)]))
sols = np.array(sols); dets = np.array(dets)
b_ls = np.linalg.lstsq(X, y, rcond=None)[0]
within1 = np.mean(np.abs(sols[:, 0] - b_ls[0]) < 1 / 60)
print(f"{len(sols)} 가지: β 의 중앙값 {np.median(sols[:, 0]):.3f}°, 범위 [{sols[:, 0].min():.1f}, {sols[:, 0].max():.1f}]°, 최소제곱의 1′ 안쪽 {within1:.1%}")
print(f"  |det X_S| 가 가장 작은 선택: {dets.min():.2e} → β = {sols[dets.argmin(), 0]:.1f}°")
# 연습 1.5: A = X_S^{-1} E_S 의 AX = I, AA' = (X_S'X_S)^{-1}
idx = [0, 9, 20]; E_S = np.eye(n)[idx]; A_S = np.linalg.solve(X[idx], E_S)
report({"예제 1.5: 3개를 고르는 방법 C(27,3) = 2925, 모두 풀린다": len(sols) == math.comb(27, 3) == 2925 and dets.min() > 0,
        "예제 6.3: β 의 중앙값 14.55°, 범위 −426°…104°, 1′ 안쪽은 5.1%":
            abs(np.median(sols[:, 0]) - 14.55) < 0.005 and round(sols[:, 0].min()) == -426 and round(sols[:, 0].max()) == 104 and abs(within1 - 0.051) < 0.0005,
        "연습 1.5: 선택 추정량도 AX = I, Cov = σ²(X_S'X_S)^{-1}": np.allclose(A_S @ X, np.eye(3)) and np.allclose(A_S @ A_S.T, np.linalg.inv(X[idx].T @ X[idx]))})
text
2925 가지: β 의 중앙값 14.552°, 범위 [-426.2, 103.6]°, 최소제곱의 1′ 안쪽 5.1%
  |det X_S| 가 가장 작은 선택: 1.13e-05 → β = -426.2°
  ✓  예제 1.5: 3개를 고르는 방법 C(27,3) = 2925, 모두 풀린다
  ✓  예제 6.3: β 의 중앙값 14.55°, 범위 −426°…104°, 1′ 안쪽은 5.1%
  ✓  연습 1.5: 선택 추정량도 AX = I, Cov = σ²(X_S'X_S)^{-1}
python
# 연습 1.2: 9 개를 더해 9 로 나누면 표준편차는 1/3 (1/9 이 아니다)
eps = rng.normal(0, 1, (200_000, 9))
sd9 = eps.mean(1).std()
report({"연습 1.2: 평균 9 개의 표준편차 = σ/3": within(sd9, 1 / 3, (1 / 3) / math.sqrt(2 * 200_000))})
text
✓ 연습 1.2: 평균 9 개의 표준편차 = σ/31.3 Boscovich의 다섯 호
자료는 Stigler(1986)의 표 1.4다. x는 (희망봉은 Boscovich가 위도를 잘못 넣어 계산한 0.2987을 그대로 쓴다), y는 위도 1도의 자오선 길이(toise).
python
bosc = pd.DataFrame({"place": ["Quito", "Cape", "Rome", "Paris", "Lapland"],
                     "x": [0, 0.2987, 0.4648, 0.5762, 0.8386], "y": [56751, 57037, 56979, 57074, 57422.0]})
xb, yb = bosc.x.to_numpy(), bosc.y.to_numpy(); Xb = np.column_stack([np.ones(5), xb])

def boscovich(x, y):
    """명제 1.6: 무게중심을 지나고 Σ|e| 최소 → 기울기의 가중 중앙값 (무게 |x−x̄|)"""
    xm, ym = x.mean(), y.mean(); keep = x != xm
    s, w = (y[keep] - ym) / (x[keep] - xm), np.abs(x[keep] - xm)
    o = np.argsort(s); cw = np.cumsum(w[o]) / w.sum()
    b1 = s[o][np.searchsorted(cw, 0.5)]
    return np.array([ym - b1 * xm, b1]), s, w, cw

b_bos, slopes, wts, cumw = boscovich(xb, yb)
b_lsb = np.linalg.lstsq(Xb, yb, rcond=None)[0]
b_lad, u_, v_ = lad(Xb, yb)
# 독립 확인: Σe = 0 을 제약으로 넣은 선형계획법 (Σ(u − v) = 0)
b_bos_lp, *_ = lad(Xb, yb, A_extra=np.r_[0, 0, np.ones(5), -np.ones(5)][None, :])
ell = lambda b: 3 * b[0] / b[1]
print(bosc.assign(slope=np.round((yb - yb.mean()) / (xb - xb.mean()), 1), weight=np.round(np.abs(xb - xb.mean()), 4)).to_string(index=False))
print(f"무게중심 ({xb.mean():.4f}, {yb.mean():.1f});  누적 무게 비율 {np.round(cumw, 3)}")
for name, b in [("Boscovich", b_bos), ("Σe=0 인 LP", b_bos_lp), ("최소제곱", b_lsb), ("최소절댓값", b_lad)]:
    print(f"  {name:10s} y = {b[0]:.1f} + {b[1]:.1f} x   편평률 1/{ell(b):.1f}   Σ|e| = {np.abs(yb - Xb @ b).sum():.1f}")
xb2 = xb.copy(); xb2[1] = 0.3014
b_ls2 = np.linalg.lstsq(np.column_stack([np.ones(5), xb2]), yb, rcond=None)[0]
zero_lad = bosc.place[np.abs(yb - Xb @ b_lad) < 1e-6].tolist()
report({"예제 1.7: 무게중심 (0.4357, 57052.6), 누적 무게 0.025·0.145·0.268·0.648·1": abs(xb.mean() - 0.4357) < 5e-5 and abs(yb.mean() - 57052.6) < 0.05 and np.allclose(cumw, [0.025, 0.145, 0.268, 0.648, 1], atol=5e-4),
        "명제 1.6: 가중 중앙값 = Σe = 0 제약의 선형계획법 해 (기울기 692.3, 절편 56751)": np.allclose(b_bos, b_bos_lp, atol=1e-6) and abs(b_bos[1] - 692.3) < 0.05 and abs(b_bos[0] - 56751) < 1e-6,
        "예제 1.7: 편평률 Boscovich 1/246, 최소제곱 1/235 (56737.4 + 723.4x), 최소절댓값 1/213 (800.1)":
            round(ell(b_bos)) == 246 and round(ell(b_lsb)) == 235 and round(ell(b_lad)) == 213 and abs(b_lsb[0] - 56737.4) < 0.05 and abs(b_lsb[1] - 723.4) < 0.05 and abs(b_lad[1] - 800.1) < 0.05,
        "명제 1.8: 최소절댓값 직선은 Quito 와 Lapland 를 지난다": zero_lad == ["Quito", "Lapland"],
        "가정 주의: 희망봉을 0.3014 로 고치면 최소제곱 편평률 1/235.3 → 1/234.9": abs(ell(b_lsb) - 235.3) < 0.05 and abs(ell(b_ls2) - 234.9) < 0.05,
        "연습 1.4: 최적해에서 u_i v_i = 0": np.all(u_ * v_ < 1e-9)})
text
  place      x       y   slope  weight
  Quito 0.0000 56751.0   692.3  0.4357
   Cape 0.2987 57037.0   113.9  0.1370
   Rome 0.4648 56979.0 -2525.7  0.0291
  Paris 0.5762 57074.0   152.3  0.1405
Lapland 0.8386 57422.0   916.8  0.4029
무게중심 (0.4357, 57052.6);  누적 무게 비율 [0.025 0.145 0.268 0.648 1.   ]
  Boscovich  y = 56751.0 + 692.3 x   편평률 1/245.9   Σ|e| = 339.3
  Σe=0 인 LP  y = 56751.0 + 692.3 x   편평률 1/245.9   Σ|e| = 339.3
  최소제곱       y = 56737.4 + 723.4 x   편평률 1/235.3   Σ|e| = 349.9
  최소절댓값      y = 56751.0 + 800.1 x   편평률 1/212.8   Σ|e| = 328.9
  ✓  예제 1.7: 무게중심 (0.4357, 57052.6), 누적 무게 0.025·0.145·0.268·0.648·1
  ✓  명제 1.6: 가중 중앙값 = Σe = 0 제약의 선형계획법 해 (기울기 692.3, 절편 56751)
  ✓  예제 1.7: 편평률 Boscovich 1/246, 최소제곱 1/235 (56737.4 + 723.4x), 최소절댓값 1/213 (800.1)
  ✓  명제 1.8: 최소절댓값 직선은 Quito 와 Lapland 를 지난다
  ✓  가정 주의: 희망봉을 0.3014 로 고치면 최소제곱 편평률 1/235.3 → 1/234.9
  ✓  연습 1.4: 최적해에서 u_i v_i = 0
python
# 연습 1.3: X = 1 이면 최소제곱 = 평균, 최소절댓값 = 중앙값, Σe = 0 만으로 평균
yy = rng.standard_cauchy(15); one = np.ones((15, 1))
m_lad, *_ = lad(one, yy); m_bos, *_ = lad(one, yy, A_extra=np.r_[0, np.ones(15), -np.ones(15)][None, :])
report({"연습 1.3: 최소제곱 = 평균, 최소절댓값 = 중앙값 (n 홀수), Σe=0 이면 평균":
        abs(np.linalg.lstsq(one, yy, rcond=None)[0][0] - yy.mean()) < 1e-12 and abs(m_lad[0] - np.median(yy)) < 1e-8 and abs(m_bos[0] - yy.mean()) < 1e-8})

# 명제 1.8: Mayer 의 최소절댓값 해는 세 방정식을 정확히 지난다
b_lad_M, *_ = lad(X, y); r_lad = y - X @ b_lad_M
zero_eq = (np.where(np.abs(r_lad) < 1e-9)[0] + 1).tolist()
th_lad = math.degrees(math.asin(b_lad_M[2] / b_lad_M[1]))
print(f"Mayer 최소절댓값: β = {dms(b_lad_M[0])}, α = {b_lad_M[1]:.3f}° = {dms(b_lad_M[1])}, θ = {dms(th_lad)};  잔차 0 인 방정식 {zero_eq}")
report({"1.3절 끝 · 6.2절: 최소절댓값 β = 14°34.1′, α = 1.515° = 1°30.9′, θ = −5°2.8′": dms(b_lad_M[0]) == "14°34.1′" and abs(b_lad_M[1] - 1.515) < 5e-4 and dms(b_lad_M[1]) == "1°30.9′" and dms(th_lad) == "-5°2.8′",
        "명제 1.8 · 6.2절: 잔차가 0 인 방정식이 정확히 3 개 (1, 5, 19 번), 그 행들은 일차독립": zero_eq == [1, 5, 19] and abs(np.linalg.det(X[[0, 4, 18]])) > 1e-6})
text
  ✓  연습 1.3: 최소제곱 = 평균, 최소절댓값 = 중앙값 (n 홀수), Σe=0 이면 평균
Mayer 최소절댓값: β = 14°34.1′, α = 1.515° = 1°30.9′, θ = -5°2.8′;  잔차 0 인 방정식 [1, 5, 19]
  ✓  1.3절 끝 · 6.2절: 최소절댓값 β = 14°34.1′, α = 1.515° = 1°30.9′, θ = −5°2.8′
  ✓  명제 1.8 · 6.2절: 잔차가 0 인 방정식이 정확히 3 개 (1, 5, 19 번), 그 행들은 일차독립
python
# 그림 1.1: Σ|e| 를 기울기의 함수로 (무게중심을 지나는 직선)
bgrid = np.linspace(-150, 1300, 1500)
g = np.array([np.abs((yb - yb.mean()) - bb * (xb - xb.mean())).sum() for bb in bgrid])
fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
tt = np.linspace(0, 0.88, 50)
for b, col, lab in [(b_lsb, C["stat"], "least squares"), (b_bos, C["assume"], "Boscovich"), (b_lad, C["theta"], "least abs.")]:
    axes[0].plot(tt, b[0] + b[1] * tt, color=col, lw=1.5, label=f"{lab}: 1/{ell(b):.0f}")
axes[0].scatter(xb, yb, color=C["data"], zorder=3)
for _, r in bosc.iterrows():
    axes[0].annotate(r.place, (r.x, r.y), textcoords="offset points", xytext=(4, 4), fontsize=8)
axes[0].set_xlabel(r"$\sin^2 L$"); axes[0].set_ylabel("toises"); axes[0].legend(fontsize=8); axes[0].set_title("five arcs")
axes[1].plot(bgrid, g, color=C["assume"]); axes[1].axvline(b_bos[1], color=C["key"], ls=":")
axes[1].set_xlabel("slope through centroid"); axes[1].set_ylabel(r"$\sum|e_i|$"); axes[1].set_title(f"minimum at weighted median {b_bos[1]:.1f}")
plt.tight_layout(); plt.show()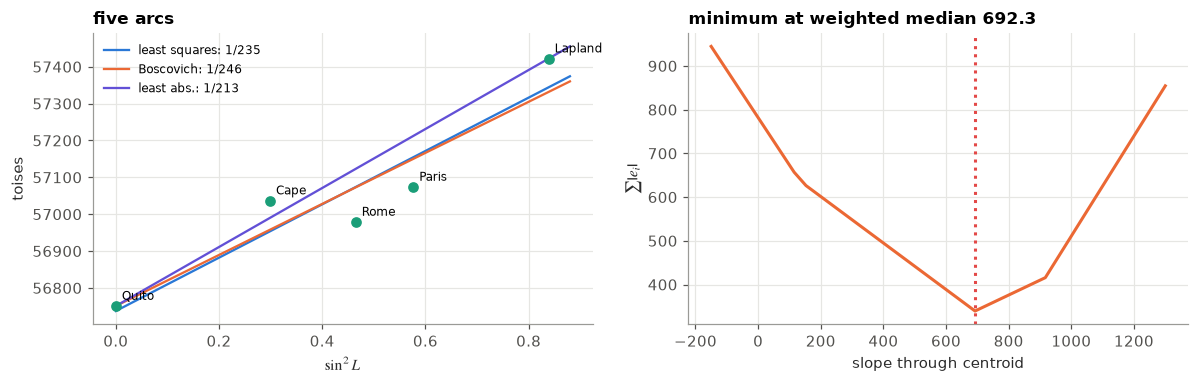
그림 읽기. 오른쪽 곡선은 꺾인 직선들로 이루어진 볼록함수이고, 꺾이는 점이 다섯 기울기 다. 기울기가 음에서 양으로 바뀌는 곳, 곧 누적 무게가 절반을 넘는 Quito의 기울기에서 최소다. 세 직선의 편평률(1/235, 1/246, 1/213)은 모두 오늘의 1/298과 멀다. 방법이 아니라 자료가 문제였다.
📝 연습 1.1–1.5 (강의노트): Mayer의 해, 제곱근의 법칙, 위치모형의 세 방법, 선형계획법, 세 방정식만 고르기.
2. 최소제곱과 사영의 기하
정리 2.2 정규방정식 , · 따름정리 2.3 상수항이 있으면 · 보조정리 2.4 대칭 멱등행렬 · 정리 2.5 hat 행렬 · 명제 2.6 · 명제 2.7 지렛대 · 알고리즘 2.8 QR.
OLS 클래스를 정규방정식과 QR(직접 쓴 Gram–Schmidt) 두 방식으로 만든다.
python
def gram_schmidt(X):
    """연습 2.6: X = QR (Q'Q = I, R 은 대각원소가 양수인 상삼각)"""
    n, p = X.shape; Q = np.zeros((n, p)); R = np.zeros((p, p))
    for k in range(p):
        v = X[:, k].astype(float).copy()
        for j in range(k):
            R[j, k] = Q[:, j] @ X[:, k]; v -= R[j, k] * Q[:, j]
        R[k, k] = np.linalg.norm(v); Q[:, k] = v / R[k, k]
    return Q, R

class OLS:
    """최소제곱 적합. method='qr' (알고리즘 2.8) 또는 'normal' (정리 2.2)"""
    def __init__(self, X, y, method="qr"):
        self.X, self.y = np.asarray(X, float), np.asarray(y, float)
        self.n, self.p = self.X.shape
        if method == "qr":
            Q, R = gram_schmidt(self.X); z = Q.T @ self.y
            self.coef = np.linalg.solve(R, z)                     # 상삼각: 거꾸로 대입
            Rinv = np.linalg.inv(R); self.XtXinv = Rinv @ Rinv.T
            self.hat_diag = np.sum(Q**2, axis=1)                    # H = QQ'
        else:
            self.XtXinv = np.linalg.inv(self.X.T @ self.X)
            self.coef = self.XtXinv @ self.X.T @ self.y
            self.hat_diag = np.einsum("ij,jk,ik->i", self.X, self.XtXinv, self.X)
        self.fitted = self.X @ self.coef; self.resid = self.y - self.fitted
        self.rss = self.resid @ self.resid; self.df = self.n - self.p; self.s2 = self.rss / self.df
        self.se = np.sqrt(self.s2 * np.diag(self.XtXinv))

    def hat(self):
        return self.X @ self.XtXinv @ self.X.T

fit_qr, fit_ne = OLS(X, y), OLS(X, y, method="normal")
b = fit_qr.coef; th = math.degrees(math.asin(b[2] / b[1]))
print(f"Mayer 최소제곱: β = {b[0]:.3f}° = {dms(b[0])},  α = {b[1]:.4f}° = {dms(b[1])},  γ = {b[2]:.4f},  θ = {dms(th)};  RSS = {fit_qr.rss:.4f}")
H = fit_qr.hat(); e = fit_qr.resid
T = np.array([[2.0, 0.3, 0], [0, -1.0, 0.5], [0.1, 0, 3.0]])
report({"알고리즘 2.8 = 정리 2.2 = np.linalg.lstsq": np.allclose(fit_qr.coef, fit_ne.coef) and np.allclose(fit_qr.coef, np.linalg.lstsq(X, y, rcond=None)[0]),
        "예제 2.9: β = 14°33.5′, α = 1°30.3′, γ = −0.0719, θ = −2°44.3′, RSS = 0.5689":
            dms(b[0]) == "14°33.5′" and dms(b[1]) == "1°30.3′" and abs(b[2] + 0.0719) < 5e-5 and dms(th) == "-2°44.3′" and abs(fit_qr.rss - 0.5689) < 5e-5,
        "정리 2.5 (a): H 대칭 · 멱등 · tr H = rank H = 3": np.allclose(H, H.T) and np.allclose(H @ H, H) and abs(np.trace(H) - 3) < 1e-10 and np.linalg.matrix_rank(H) == 3,
        "정리 2.5 (b): X'e = 0, ŷ'e = 0, ‖y‖² = ‖ŷ‖² + ‖e‖²": np.allclose(X.T @ e, 0, atol=1e-10) and abs(fit_qr.fitted @ e) < 1e-10 and abs(y @ y - fit_qr.fitted @ fit_qr.fitted - e @ e) < 1e-9,
        "정리 2.5 (c): I − H 는 계수 n − p = 24 의 사영, RSS = y'(I−H)y": np.linalg.matrix_rank(np.eye(n) - H) == 24 and abs(y @ (np.eye(n) - H) @ y - fit_qr.rss) < 1e-10,
        "정리 2.5 (d): XT 로 바꿔도 H 는 같다": np.allclose(OLS(X @ T, y).hat(), H),
        "명제 2.7: 0 ≤ h_ii ≤ 1, Σ h_ii = 3, 최대는 26 번의 0.247": fit_qr.hat_diag.min() >= 0 and fit_qr.hat_diag.max() <= 1 and abs(fit_qr.hat_diag.sum() - 3) < 1e-10 and fit_qr.hat_diag.argmax() == 25 and abs(fit_qr.hat_diag.max() - 0.247) < 5e-4})
text
Mayer 최소제곱: β = 14.558° = 14°33.5′,  α = 1.5058° = 1°30.3′,  γ = -0.0719,  θ = -2°44.3′;  RSS = 0.5689
  ✓  알고리즘 2.8 = 정리 2.2 = np.linalg.lstsq
  ✓  예제 2.9: β = 14°33.5′, α = 1°30.3′, γ = −0.0719, θ = −2°44.3′, RSS = 0.5689
  ✓  정리 2.5 (a): H 대칭 · 멱등 · tr H = rank H = 3
  ✓  정리 2.5 (b): X'e = 0, ŷ'e = 0, ‖y‖² = ‖ŷ‖² + ‖e‖²
  ✓  정리 2.5 (c): I − H 는 계수 n − p = 24 의 사영, RSS = y'(I−H)y
  ✓  정리 2.5 (d): XT 로 바꿔도 H 는 같다
  ✓  명제 2.7: 0 ≤ h_ii ≤ 1, Σ h_ii = 3, 최대는 26 번의 0.247
python
# 정리 2.2 의 항등식, 따름정리 2.3, 명제 2.6 — Galton 의 부모 키로
Gd = load_rdata("Galton"); xg, yg = Gd.parent.to_numpy(float), Gd.child.to_numpy(float); ng = len(xg)
Xg = np.column_stack([np.ones(ng), xg]); fg = OLS(Xg, yg)
bb = rng.normal(size=(5, 2)) + fg.coef
S = lambda c: np.sum((yg - Xg @ c) ** 2)
Sxx, Sxy = np.sum((xg - xg.mean()) ** 2), np.sum((xg - xg.mean()) * (yg - yg.mean()))
tss = np.sum((yg - yg.mean()) ** 2); ess = np.sum((fg.fitted - yg.mean()) ** 2)
r = np.corrcoef(xg, yg)[0, 1]
report({"정리 2.2: S(b) = S(β̂) + ‖X(b − β̂)‖² (아무 b 에서)": all(abs(S(c) - fg.rss - np.sum((Xg @ (c - fg.coef)) ** 2)) < 1e-7 for c in bb),
        "따름정리 2.3: Σe = 0, 직선이 (x̄, ȳ) 를 지난다": abs(fg.resid.sum()) < 1e-8 and abs(fg.coef[0] + fg.coef[1] * xg.mean() - yg.mean()) < 1e-10,
        "명제 2.6: TSS = ESS + RSS, R² = Corr(y, ŷ)²": abs(tss - ess - fg.rss) < 1e-8 and abs(ess / tss - np.corrcoef(yg, fg.fitted)[0, 1] ** 2) < 1e-12,
        "연습 2.1: b̂1 = Sxy/Sxx, b̂0 = ȳ − b̂1 x̄, R² = r²": abs(fg.coef[1] - Sxy / Sxx) < 1e-12 and abs(fg.coef[0] - (yg.mean() - Sxy / Sxx * xg.mean())) < 1e-9 and abs(ess / tss - r**2) < 1e-12,
        "명제 2.7 (b): 상수항이 있으면 h_ii ≥ 1/n": fg.hat_diag.min() >= 1 / ng - 1e-15})

# 연습 2.2–2.5
y5 = rng.normal(size=8); f1 = OLS(np.ones((8, 1)), y5)
an = load_rdata("anscombe", "datasets"); x4 = an.x4.to_numpy(float); X4 = np.column_stack([np.ones(11), x4])
h4 = OLS(X4, an.y4.to_numpy(float)).hat_diag
h_formula = 1 / 11 + (x4 - x4.mean()) ** 2 / np.sum((x4 - x4.mean()) ** 2)
fcm = OLS(np.column_stack([np.ones(ng), 2.54 * xg]), yg)
z = rng.normal(size=ng); fz = OLS(np.column_stack([Xg, z]), yg)
report({"연습 2.2: X = 1 이면 H = 11'/n, ŷ = ȳ1, RSS/(n−1) = S²": np.allclose(f1.hat(), np.full((8, 8), 1 / 8)) and np.allclose(f1.fitted, y5.mean()) and abs(f1.s2 - y5.var(ddof=1)) < 1e-12,
        "연습 2.3: h_ii = 1/n + (x_i − x̄)²/Sxx, Anscombe IV 의 x = 19 는 h = 1": np.allclose(h4, h_formula) and abs(h4[x4 == 19][0] - 1) < 1e-12,
        "연습 2.4: 센티미터로 바꾸면 절편 같고 기울기 /2.54, 적합값 같음": abs(fcm.coef[0] - fg.coef[0]) < 1e-9 and abs(fcm.coef[1] - fg.coef[1] / 2.54) < 1e-12 and np.allclose(fcm.fitted, fg.fitted),
        "연습 2.5: 열을 더하면 RSS 는 늘지 않는다": fz.rss <= fg.rss})
text
  ✓  정리 2.2: S(b) = S(β̂) + ‖X(b − β̂)‖² (아무 b 에서)
  ✓  따름정리 2.3: Σe = 0, 직선이 (x̄, ȳ) 를 지난다
  ✓  명제 2.6: TSS = ESS + RSS, R² = Corr(y, ŷ)²
  ✓  연습 2.1: b̂1 = Sxy/Sxx, b̂0 = ȳ − b̂1 x̄, R² = r²
  ✓  명제 2.7 (b): 상수항이 있으면 h_ii ≥ 1/n
  ✓  연습 2.2: X = 1 이면 H = 11'/n, ŷ = ȳ1, RSS/(n−1) = S²
  ✓  연습 2.3: h_ii = 1/n + (x_i − x̄)²/Sxx, Anscombe IV 의 x = 19 는 h = 1
  ✓  연습 2.4: 센티미터로 바꾸면 절편 같고 기울기 /2.54, 적합값 같음
  ✓  연습 2.5: 열을 더하면 RSS 는 늘지 않는다
python
# 연습 2.6 · 2.3절: QR 과 조건수
Q, R = gram_schmidt(Xg)
kap_raw = np.linalg.cond(Xg.T @ Xg); Xc = np.column_stack([np.ones(ng), xg - xg.mean()]); kap_c = np.linalg.cond(Xc.T @ Xc)
print(f"κ(X'X): 원래 {kap_raw:.3g}, 중심화 {kap_c:.3f};  κ(X)² = {np.linalg.cond(Xg) ** 2:.3g}")
# 조건수가 나쁠 때: 10차 다항식을 정확히 맞추는 문제 (참 계수 = 1)
xv = np.linspace(1, 2, 60); V = np.vander(xv, 11, increasing=True); beta_true = np.ones(11); yv = V @ beta_true
err_ne = np.max(np.abs(np.linalg.solve(V.T @ V, V.T @ yv) - beta_true))
Qv, Rv = np.linalg.qr(V); err_qr = np.max(np.abs(np.linalg.solve(Rv, Qv.T @ yv) - beta_true))
print(f"10차 다항식: κ(V) = {np.linalg.cond(V):.2e};  계수 오차  정규방정식 {err_ne:.2e},  QR {err_qr:.2e}")
report({"연습 2.6: Gram–Schmidt 의 Q'Q = I, R 은 상삼각, QR = X": np.allclose(Q.T @ Q, np.eye(2)) and np.allclose(np.tril(R, -1), 0) and np.all(np.diag(R) > 0) and np.allclose(Q @ R, Xg),
        "2.3절: κ(X'X) = κ(X)², Galton 원래 6.8×10⁶, 중심화 3.19": abs(kap_raw / np.linalg.cond(Xg) ** 2 - 1) < 1e-6 and abs(kap_raw / 6.83e6 - 1) < 0.01 and abs(kap_c - 3.19) < 0.005,
        "2.3절: 조건수가 나쁘면 정규방정식이 QR 보다 훨씬 많은 자릿수를 잃는다": err_ne > 100 * err_qr})
text
κ(X'X): 원래 6.83e+06, 중심화 3.191;  κ(X)² = 6.83e+06
10차 다항식: κ(V) = 1.07e+12;  계수 오차  정규방정식 1.19e+01,  QR 9.47e-06
  ✓  연습 2.6: Gram–Schmidt 의 Q'Q = I, R 은 상삼각, QR = X
  ✓  2.3절: κ(X'X) = κ(X)², Galton 원래 6.8×10⁶, 중심화 3.19
  ✓  2.3절: 조건수가 나쁘면 정규방정식이 QR 보다 훨씬 많은 자릿수를 잃는다
숫자 읽기. 10차 다항식의 설계행렬은 조건수가 이어서, 정규방정식()은 배정밀도의 유효숫자 16자리를 모두 잃고 계수가 10 넘게 틀린다. QR은 만큼만 잃어 오차가 정도다. 같은 최소제곱 문제라도 푸는 방법이 결과를 바꾼다. 8절에서 같은 조건수가 경사하강의 속도를 정한다.
📝 연습 2.1–2.6 (강의노트): 단순회귀, 평균의 hat 행렬, 단순회귀의 지렛대, 단위 변환, 변수를 더하면, Gram–Schmidt.
3. Gauss–Markov 정리
보조정리 3.1 · 정리 3.2 , , · 정리 3.3 Gauss–Markov: · 예제 3.5 Mayer의 손실 · 정리 3.6 정규 오차면 MLE = UMVUE · 따름정리 3.7 Aitken의 GLS.
Mayer의 설계 를 그대로 두고, 참값을 최소제곱 해 , 를 로 놓은 가상의 세계에서 관측을 20만 번 다시 만든다. 오차는 정규와 균등 두 가지로 한다. Gauss–Markov 가정에는 정규성이 없다.
python
beta0, sig = fit_qr.coef.copy(), math.sqrt(fit_qr.s2)
A0 = fit_qr.XtXinv @ X.T                              # 최소제곱의 A
V_ls = sig**2 * fit_qr.XtXinv
R = 200_000
out = {}
for name, draw in [("정규", lambda size: rng.normal(0, sig, size)),
                   ("균등", lambda size: rng.uniform(-sig * math.sqrt(3), sig * math.sqrt(3), size))]:
    Y = X @ beta0 + draw((R, n))
    B = Y @ A0.T; RSS = np.sum((Y - B @ X.T) ** 2, axis=1); BM = Y @ A_M.T
    out[name] = (B, RSS, BM)
    print(f"{name}: E β̂ − β = {np.round(B.mean(0) - beta0, 5)},  Var 비 (모의/공식) = {np.round(B.var(0) / np.diag(V_ls), 3)},  E s²/σ² = {RSS.mean() / 24 / sig**2:.4f}")
B, RSS, BM = out["정규"]
E1 = (Y := X @ beta0 + rng.normal(0, sig, (R, n)))[:, 0] - (Y @ A0.T @ X.T)[:, 0]    # 첫 잔차
cov_be = np.mean((Y @ A0.T)[:, 1] * E1) - (Y @ A0.T)[:, 1].mean() * E1.mean()
report({"정리 3.2 (a): E β̂ = β (정규·균등)": all(np.all(np.abs(o[0].mean(0) - beta0) <= 4 * np.sqrt(np.diag(V_ls) / R)) for o in out.values()),
        "정리 3.2 (a): Var β̂_j = σ²[(X'X)^{-1}]_jj (정규·균등, 비 1 ± 4·√(2/R))": all(np.all(np.abs(o[0].var(0) / np.diag(V_ls) - 1) < 4 * math.sqrt(2 / R) + 0.01) for o in out.values()),
        "정리 3.2 (c): E s² = σ² (정규·균등)": all(within(o[1].mean() / 24, sig**2, o[1].std() / 24 / math.sqrt(R)) for o in out.values()),
        "정리 3.2 (b): β̂ 와 잔차는 무상관": abs(cov_be) < 4 * math.sqrt(V_ls[1, 1] * sig**2 / R)})
text
정규: E β̂ − β = [-5.0e-05 -6.0e-05 -1.2e-04],  Var 비 (모의/공식) = [0.999 1.002 1.004],  E s²/σ² = 1.0008
균등: E β̂ − β = [ 5.0e-05  1.4e-04 -1.1e-04],  Var 비 (모의/공식) = [1.002 0.997 0.998],  E s²/σ² = 1.0001
text
  ✓  정리 3.2 (a): E β̂ = β (정규·균등)
  ✓  정리 3.2 (a): Var β̂_j = σ²[(X'X)^{-1}]_jj (정규·균등, 비 1 ± 4·√(2/R))
  ✓  정리 3.2 (c): E s² = σ² (정규·균등)
  ✓  정리 3.2 (b): β̂ 와 잔차는 무상관
python
# 정리 3.3 · 예제 3.5 · 연습 3.4: Mayer 의 묶음 평균 대 최소제곱
D = A_M - A0
Vdiff = sig**2 * (A_M @ A_M.T) - V_ls
ratio = np.diag(A_M @ A_M.T) / np.diag(fit_qr.XtXinv)
det_ratio = np.linalg.det(A_M @ A_M.T) / np.linalg.det(fit_qr.XtXinv)
sim_ratio = BM.var(0) / B.var(0)
print(f"분산의 비 (Mayer/최소제곱): 공식 {np.round(ratio, 3)}, 모의 {np.round(sim_ratio, 3)};  행렬식의 비 {det_ratio:.2f}")
# 아무 선형불편추정량이나: 무작위 G 로 A = (G'X)^{-1}G'
psd_all = True
for _ in range(2000):
    Gr = rng.normal(size=(n, 3)); Ar = np.linalg.solve(Gr.T @ X, Gr.T)
    psd_all &= np.linalg.eigvalsh(Ar @ Ar.T - fit_qr.XtXinv).min() > -1e-10
# 연습 3.4: 묶음 안에서 x3 의 퍼짐 — 합이 버리는 정보
for gname in ["I", "II", "III"]:
    x3 = X[M.Group == gname, 2]
    print(f"  묶음 {gname}: x3 범위 [{x3.min():.2f}, {x3.max():.2f}], 합 {x3.sum():.4f}")
report({"정리 3.3: DX = 0, Cov(Mayer) − Cov(LS) = σ²DD' ⪰ 0": np.allclose(D @ X, 0, atol=1e-12) and np.allclose(Vdiff, sig**2 * D @ D.T) and np.linalg.eigvalsh(Vdiff).min() > -1e-14,
        "예제 3.5 · 연습 3.4: 분산의 비 1.28, 1.15, 2.08, 행렬식의 비 2.37": np.allclose(np.round(ratio, 2), [1.28, 1.15, 2.08]) and round(det_ratio, 2) == 2.37,
        "예제 3.5: 모의 분산의 비도 같다 (±3%)": np.allclose(sim_ratio, ratio, rtol=0.03),
        "따름정리 3.4 (a): 행렬식 · 대각합도 Mayer 가 크다": det_ratio > 1 and np.trace(A_M @ A_M.T) > np.trace(fit_qr.XtXinv),
        "정리 3.3: 무작위로 만든 선형불편추정량 2000 개 모두 Cov − Cov_LS ⪰ 0": bool(psd_all)})
text
분산의 비 (Mayer/최소제곱): 공식 [1.28  1.154 2.085], 모의 [1.28  1.151 2.079];  행렬식의 비 2.37
  묶음 I: x3 범위 [-0.47, 0.46], 합 -0.7932
  묶음 II: x3 범위 [-0.91, 0.99], 합 1.7443
  묶음 III: x3 범위 [0.60, 1.00], 합 7.9649
  ✓  정리 3.3: DX = 0, Cov(Mayer) − Cov(LS) = σ²DD' ⪰ 0
  ✓  예제 3.5 · 연습 3.4: 분산의 비 1.28, 1.15, 2.08, 행렬식의 비 2.37
  ✓  예제 3.5: 모의 분산의 비도 같다 (±3%)
  ✓  따름정리 3.4 (a): 행렬식 · 대각합도 Mayer 가 크다
  ✓  정리 3.3: 무작위로 만든 선형불편추정량 2000 개 모두 Cov − Cov_LS ⪰ 0
python
# 연습 3.1–3.3, 3.5 와 가정 주의 (1)
XtXi_g = fg.XtXinv; xbar = xg.mean()
f_var = np.array([[1 / ng + xbar**2 / Sxx, -xbar / Sxx], [-xbar / Sxx, 1 / Sxx]])
corr01 = -xbar / math.sqrt(xbar**2 + Sxx / ng)
w = rng.dirichlet(np.ones(12), 5000) * 1.7 - 0.7 / 12               # 합이 1 인 무게들 (음수 포함)
mlab = np.array([3, 7, 12, 5]); ybar = rng.normal(10, 1 / np.sqrt(mlab))
Vg = np.diag(1 / mlab); one4 = np.ones(4)
gls_mean = (one4 @ np.linalg.solve(Vg, ybar)) / (one4 @ np.linalg.solve(Vg, one4))
# 연습 3.5: c ȳ 의 평균제곱오차 (μ = 0.5, σ = 1, n = 10)
mu5, n5 = 0.5, 10; cstar = mu5**2 / (mu5**2 + 1 / n5)
yb5 = rng.normal(mu5, 1 / math.sqrt(n5), 400_000)
mse_c, mse_1 = np.mean((cstar * yb5 - mu5) ** 2), np.mean((yb5 - mu5) ** 2)
# 가정 주의 (1): Laplace 오차의 위치모형 (n = 27) — 중앙값이 평균을 이긴다
Lp = rng.laplace(0, 1, (100_000, 27)); vr_lap = np.median(Lp, 1).var() / Lp.mean(1).var()
print(f"상관 (b0, b1) = {corr01:.4f};  c* = {cstar:.3f}: MSE {mse_c:.4f} 대 ȳ {mse_1:.4f} (공식 {0.1 * 0.25 / 0.35:.4f});  Laplace: Var(중앙값)/Var(평균) = {vr_lap:.3f}")
report({"연습 3.1: (X'X)^{-1} = [[1/n + x̄²/Sxx, −x̄/Sxx], [−x̄/Sxx, 1/Sxx]]": np.allclose(XtXi_g, f_var),
        "연습 3.1: x̄ = 68.3 이면 절편과 기울기의 상관이 −1 에 가깝다 (−0.9997)": round(corr01, 4) == -0.9997,
        "연습 3.2: 합이 1 인 무게는 Σw² ≥ 1/n": np.all(np.allclose(w.sum(1), 1)) and np.all((w**2).sum(1) >= 1 / 12 - 1e-12),
        "연습 3.3: 묶음 평균들의 BLUE = Σm_j ȳ_j / Σm_j": abs(gls_mean - np.sum(mlab * ybar) / mlab.sum()) < 1e-12,
        "연습 3.5: c* = μ²/(μ² + σ²/n) 의 MSE = (σ²/n)μ²/(μ²+σ²/n) < σ²/n": within(mse_c, 0.1 * 0.25 / 0.35, 0.0002) and mse_c < mse_1,
        "가정 주의 (1): Laplace 오차에서 중앙값의 분산이 평균보다 작다 (n = 27)": vr_lap < 0.75})
text
상관 (b0, b1) = -0.9997;  c* = 0.714: MSE 0.0714 대 ȳ 0.1002 (공식 0.0714);  Laplace: Var(중앙값)/Var(평균) = 0.658
  ✓  연습 3.1: (X'X)^{-1} = [[1/n + x̄²/Sxx, −x̄/Sxx], [−x̄/Sxx, 1/Sxx]]
  ✓  연습 3.1: x̄ = 68.3 이면 절편과 기울기의 상관이 −1 에 가깝다 (−0.9997)
  ✓  연습 3.2: 합이 1 인 무게는 Σw² ≥ 1/n
  ✓  연습 3.3: 묶음 평균들의 BLUE = Σm_j ȳ_j / Σm_j
  ✓  연습 3.5: c* = μ²/(μ² + σ²/n) 의 MSE = (σ²/n)μ²/(μ²+σ²/n) < σ²/n
  ✓  가정 주의 (1): Laplace 오차에서 중앙값의 분산이 평균보다 작다 (n = 27)
python
# 정리 3.6 (a): 정규 로그가능도를 수치로 최대화하면 최소제곱과 RSS/n
def negll(th):
    b, ls2 = th[:3], th[3]
    return 0.5 * n * (math.log(2 * math.pi) + ls2) + np.sum((y - X @ b) ** 2) / (2 * math.exp(ls2))
mle = optimize.minimize(negll, np.r_[np.zeros(3), 0.0], method="BFGS", options=dict(gtol=1e-10))
# 따름정리 3.7: Pearson–Lee 도수표의 가중 최소제곱 (무게 = 도수)
PL = load_rdata("PearsonLee")
pl_rows = {}
for par, chl in [("Father", "Son"), ("Father", "Daughter"), ("Mother", "Son"), ("Mother", "Daughter")]:
    d = PL[(PL.par == par) & (PL.chl == chl)]
    wv, xv_, yv_ = d.frequency.to_numpy(float), d.parent.to_numpy(float), d.child.to_numpy(float)
    Xw = np.column_stack([np.ones(len(d)), xv_])
    b_w = np.linalg.solve(Xw.T @ (wv[:, None] * Xw), Xw.T @ (wv * yv_))           # (X'WX)^{-1} X'Wy
    b_t = np.linalg.lstsq(np.sqrt(wv)[:, None] * Xw, np.sqrt(wv) * yv_, rcond=None)[0]   # V^{-1/2} 로 변환한 최소제곱
    mx, my = np.average(xv_, weights=wv), np.average(yv_, weights=wv)
    rr = np.average((xv_ - mx) * (yv_ - my), weights=wv) / math.sqrt(np.average((xv_ - mx) ** 2, weights=wv) * np.average((yv_ - my) ** 2, weights=wv))
    pl_rows[(par, chl)] = (wv.sum(), b_w[1], rr, np.allclose(b_w, b_t))
    print(f"  {par}–{chl}: N = {wv.sum():.0f}, 기울기 {b_w[1]:.3f}, r = {rr:.3f}")
print("  도수에 소수가 있다:", bool(np.any(PL.frequency % 1 != 0)))
# 따름정리 3.7: V ≠ I 일 때 보통 최소제곱의 공분산 ⪰ GLS
Vt = np.diag(rng.uniform(0.2, 5, n))
cov_ols = fit_qr.XtXinv @ X.T @ Vt @ X @ fit_qr.XtXinv; cov_gls = np.linalg.inv(X.T @ np.linalg.solve(Vt, X))
fs = pl_rows[("Father", "Son")]
report({"정리 3.6 (a): 정규 MLE 의 β = 최소제곱, σ² = RSS/n": np.allclose(mle.x[:3], fit_qr.coef, atol=1e-5) and abs(math.exp(mle.x[3]) - fit_qr.rss / n) < 1e-6,
        "따름정리 3.7: 가중 최소제곱 = V^{-1/2} 로 변환한 최소제곱": all(v[3] for v in pl_rows.values()),
        "예제 5.2: Pearson–Lee 아버지–아들 1078쌍, 기울기 0.519, r = 0.514": round(fs[0]) == 1078 and round(fs[1], 3) == 0.519 and round(fs[2], 3) == 0.514,
        "예제 5.2: 아버지–딸 0.479, 어머니–아들 0.563, 어머니–딸 0.545":
            [round(pl_rows[k][1], 3) for k in [("Father", "Daughter"), ("Mother", "Son"), ("Mother", "Daughter")]] == [0.479, 0.563, 0.545],
        "따름정리 3.7: 상관된 오차에서 Cov(OLS) − Cov(GLS) ⪰ 0": np.linalg.eigvalsh(cov_ols - cov_gls).min() > -1e-12})
text
  Father–Son: N = 1078, 기울기 0.519, r = 0.514
  Father–Daughter: N = 1376, 기울기 0.479, r = 0.511
  Mother–Son: N = 1057, 기울기 0.563, r = 0.494
  Mother–Daughter: N = 1381, 기울기 0.545, r = 0.502
  도수에 소수가 있다: True
  ✓  정리 3.6 (a): 정규 MLE 의 β = 최소제곱, σ² = RSS/n
  ✓  따름정리 3.7: 가중 최소제곱 = V^{-1/2} 로 변환한 최소제곱
  ✓  예제 5.2: Pearson–Lee 아버지–아들 1078쌍, 기울기 0.519, r = 0.514
  ✓  예제 5.2: 아버지–딸 0.479, 어머니–아들 0.563, 어머니–딸 0.545
  ✓  따름정리 3.7: 상관된 오차에서 Cov(OLS) − Cov(GLS) ⪰ 0
숫자 읽기. 균등 오차에서도 평균·분산·이 공식과 맞는다. 정리 3.2와 3.3은 정규분포를 쓰지 않는다. Mayer의 묶음 평균은 의 분산이 최소제곱의 2.08배인데, 묶음 I과 II 안에서 이 에서 , 에서 까지 퍼져 있다가 더하는 순간 서로 지워지기 때문이다. 무작위로 만든 선형불편추정량 2000개 가운데 최소제곱보다 나은 것은 하나도 없다. 그러나 Laplace 오차에서는 비선형인 중앙값이 평균의 분산을 3분의 2 아래로 줄인다. "최선"은 선형불편 안에서만이다.
📝 연습 3.1–3.5 (강의노트): 단순회귀의 분산, 평균은 BLUE, 묶음의 평균, Mayer의 분산, 치우친 추정량.
4. 정규 오차 아래의 분포 — Cochran과 Craig
정리 4.1 , · 보조정리 4.3 · 정리 4.4 Craig · 정리 4.5 Cochran · 정리 4.7 정규, , 독립 · 따름정리 4.8 · 정리 4.9 일반선형가설의 = 가능도비 검정.
Mayer의 설계는 첫 열이 이므로 다. 의 세 사영(계수 1, 2, 24)을 쓴다.
python
J = np.full((n, n), 1 / n); Ih = np.eye(n) - H; HJ = H - J
Z = rng.standard_normal((200_000, n))
qf = lambda A: np.einsum("ij,jk,ik->i", Z, A, Z)
qJ, qHJ, qI = qf(J), qf(HJ), qf(Ih)
# 정리 4.1: I − H (멱등, 계수 24) 는 χ²(24); 연습 4.1 의 두 반례
ks = stats.kstest(qI, stats.chi2(24).cdf).pvalue
z2 = Z[:, :2]; q2 = 2 * z2[:, 0] ** 2; qpm = z2[:, 0] ** 2 - z2[:, 1] ** 2
print(f"Z'(I−H)Z: 평균 {qI.mean():.3f}, 분산 {qI.var():.2f}, KS p = {ks:.3f};  2Z1²: 평균 {q2.mean():.3f} 분산 {q2.var():.2f};  Z1²−Z2²: 평균 {qpm.mean():.3f} 분산 {qpm.var():.2f}")
# 보조정리 4.3: 무작위 대칭행렬로
A5 = rng.normal(size=(5, 5)); A5 = A5 + A5.T; B5 = rng.normal(size=(5, 5)); B5 = B5 + B5.T
Z5 = rng.standard_normal((400_000, 5))
qa, qb = np.einsum("ij,jk,ik->i", Z5, A5, Z5), np.einsum("ij,jk,ik->i", Z5, B5, Z5)
cov_ab = np.cov(qa, qb)[0, 1]; se_cov = np.std((qa - qa.mean()) * (qb - qb.mean())) / math.sqrt(len(qa))
# 연습 4.2: Var S² = 2/(n−1) — 대각합 공식
nn_ = 10; Jn = np.full((nn_, nn_), 1 / nn_); var_s2 = 2 * np.trace((np.eye(nn_) - Jn) @ (np.eye(nn_) - Jn)) / (nn_ - 1) ** 2
report({"정리 4.1 (⇐): Z'(I−H)Z ~ χ²(24) (평균 24, 분산 48, KS)": within(qI.mean(), 24, math.sqrt(48 / len(qI))) and within(qI.var(), 48, 48 * math.sqrt(12 / len(qI) + 2 / len(qI))) and ks > 1e-3,
        "연습 4.1: 2Z1² 는 평균 2 분산 8, Z1² − Z2² 는 평균 0 분산 4 — χ² 가 아니다": within(q2.mean(), 2, math.sqrt(8 / len(q2))) and abs(q2.var() / 8 - 1) < 0.03 and within(qpm.mean(), 0, math.sqrt(4 / len(qpm))) and abs(qpm.var() / 4 - 1) < 0.03,
        "보조정리 4.3: Cov(Z'AZ, Z'BZ) = 2 tr(AB)": within(cov_ab, 2 * np.trace(A5 @ B5), se_cov),
        "보조정리 4.3: E Z'AZ = tr A, Var Z'AZ = 2 tr(A²)": within(qa.mean(), np.trace(A5), qa.std() / math.sqrt(len(qa))) and abs(qa.var() / (2 * np.trace(A5 @ A5)) - 1) < 0.03,
        "연습 4.2: Var S² = 2 tr((I−J)²)/(n−1)² = 2/(n−1)": abs(var_s2 - 2 / (nn_ - 1)) < 1e-12})
text
Z'(I−H)Z: 평균 23.989, 분산 48.05, KS p = 0.606;  2Z1²: 평균 1.999 분산 8.03;  Z1²−Z2²: 평균 -0.002 분산 4.00
  ✓  정리 4.1 (⇐): Z'(I−H)Z ~ χ²(24) (평균 24, 분산 48, KS)
  ✓  연습 4.1: 2Z1² 는 평균 2 분산 8, Z1² − Z2² 는 평균 0 분산 4 — χ² 가 아니다
  ✓  보조정리 4.3: Cov(Z'AZ, Z'BZ) = 2 tr(AB)
  ✓  보조정리 4.3: E Z'AZ = tr A, Var Z'AZ = 2 tr(A²)
  ✓  연습 4.2: Var S² = 2 tr((I−J)²)/(n−1)² = 2/(n−1)
python
# 정리 4.4 (Craig) 와 정리 4.5 (Cochran) — 세 사영 J, H − J, I − H
ranks = [np.linalg.matrix_rank(A) for A in (J, HJ, Ih)]
cors = np.corrcoef([qJ, qHJ, qI])
# 독립은 무상관보다 강하다: 사건의 곱셈 법칙 P(qHJ > 중앙값, qI > 중앙값) = 1/4
both = np.mean((qHJ > np.median(qHJ)) & (qI > np.median(qI)))
# AB ≠ 0 인 짝: H 와 J (HJ = J) — 상관 = 2tr(HJ)/√(2tr H² · 2tr J²) = 1/√3
qH = qf(H); cor_HJ = np.corrcoef(qH, qJ)[0, 1]
# Craig (b): L = (X'X)^{-1}X' 이고 L(I − H) = 0 → β̂ − β 와 RSS 독립
LZ = Z @ A0.T
cor_b = [np.corrcoef(LZ[:, j] ** 2, qI)[0, 1] for j in range(3)]
# Craig (c): 양의 준정치면 tr(AB) = ‖A^{1/2}B^{1/2}‖_F²
P1 = rng.normal(size=(6, 3)); P2 = rng.normal(size=(6, 4)); Ap, Bp = P1 @ P1.T, P2 @ P2.T
sq = lambda A: (lambda w, V: V @ np.diag(np.sqrt(np.clip(w, 0, None))) @ V.T)(*np.linalg.eigh(A))
# 예제 4.6: Student = Cochran (n = 10): Z̄ 와 Σ(Z − Z̄)² 는 독립
Z10 = rng.standard_normal((200_000, 10)); zb = Z10.mean(1); ss = ((Z10 - zb[:, None]) ** 2).sum(1)
print(f"계수 {ranks};  세 이차형식의 평균 {np.round([qJ.mean(), qHJ.mean(), qI.mean()], 3)};  상관 {np.round(cors[np.triu_indices(3, 1)], 4)};  P(둘 다 중앙값 위) = {both:.4f}")
print(f"H 와 J (AB ≠ 0) 의 상관 {cor_HJ:.3f} (이론 {1 / math.sqrt(3):.3f});  (β̂_j−β_j)² 와 RSS 의 상관 {np.round(cor_b, 4)}")
se_c = 4 / math.sqrt(len(qI))
report({"정리 4.5: 계수 1 + 2 + 24 = 27, 각 평균 = 계수 (χ²(1), χ²(2), χ²(24))": ranks == [1, 2, 24] and all(within(q.mean(), r_, math.sqrt(2 * r_ / len(q))) for q, r_ in zip([qJ, qHJ, qI], ranks)),
        "정리 4.4 (a) · 4.5: (H−J)(I−H) = 0, J(H−J) = 0 → 서로 상관 0": np.allclose(HJ @ Ih, 0, atol=1e-12) and np.allclose(J @ HJ, 0, atol=1e-12) and np.all(np.abs(cors[np.triu_indices(3, 1)]) < se_c),
        "정리 4.4 (a): 독립이므로 P(둘 다 중앙값 위) = 1/4": within(both, 0.25, math.sqrt(0.25 * 0.75 / len(qI))),
        "보조정리 4.3: AB ≠ 0 이면 상관이 생긴다 (H 와 J: 1/√3)": abs(cor_HJ - 1 / math.sqrt(3)) < 0.01,
        "정리 4.4 (b): L(I−H) = 0, (β̂_j − β_j)² 와 RSS 의 상관 0": np.allclose(A0 @ Ih, 0, atol=1e-12) and all(abs(c_) < se_c for c_ in cor_b),
        "정리 4.4 (c): 양의 준정치면 tr(AB) = ‖A^½B^½‖_F² ≥ 0": abs(np.trace(Ap @ Bp) - np.sum((sq(Ap) @ sq(Bp)) ** 2)) < 1e-8,
        "예제 4.6: Z̄² 와 Σ(Z−Z̄)² 는 상관 0, nZ̄² ~ χ²(1), Σ(Z−Z̄)² ~ χ²(9)": abs(np.corrcoef(zb**2, ss)[0, 1]) < 4 / math.sqrt(len(zb)) and within((10 * zb**2).mean(), 1, math.sqrt(2 / len(zb))) and within(ss.mean(), 9, math.sqrt(18 / len(zb)))})
text
계수 [np.int64(1), np.int64(2), np.int64(24)];  세 이차형식의 평균 [ 1.002  1.999 23.989];  상관 [-0.0038 -0.0033  0.0031];  P(둘 다 중앙값 위) = 0.2503
H 와 J (AB ≠ 0) 의 상관 0.575 (이론 0.577);  (β̂_j−β_j)² 와 RSS 의 상관 [-0.0007  0.0009  0.0038]
  ✓  정리 4.5: 계수 1 + 2 + 24 = 27, 각 평균 = 계수 (χ²(1), χ²(2), χ²(24))
  ✓  정리 4.4 (a) · 4.5: (H−J)(I−H) = 0, J(H−J) = 0 → 서로 상관 0
  ✓  정리 4.4 (a): 독립이므로 P(둘 다 중앙값 위) = 1/4
  ✓  보조정리 4.3: AB ≠ 0 이면 상관이 생긴다 (H 와 J: 1/√3)
  ✓  정리 4.4 (b): L(I−H) = 0, (β̂_j − β_j)² 와 RSS 의 상관 0
  ✓  정리 4.4 (c): 양의 준정치면 tr(AB) = ‖A^½B^½‖_F² ≥ 0
  ✓  예제 4.6: Z̄² 와 Σ(Z−Z̄)² 는 상관 0, nZ̄² ~ χ²(1), Σ(Z−Z̄)² ~ χ²(9)
python
# 정리 4.7 · 따름정리 4.8: 정규 오차로 Mayer 를 다시 만든다
Y = X @ beta0 + sig * rng.standard_normal((200_000, n))
Bh = Y @ A0.T; RSSs = np.sum((Y - Bh @ X.T) ** 2, 1); s_ = np.sqrt(RSSs / 24)
q3 = np.einsum("ij,jk,ik->i", Bh - beta0, X.T @ X, Bh - beta0) / sig**2
tq = stats.t.ppf(0.975, 24)
cover_g = np.mean(np.abs(Bh[:, 2] - beta0[2]) <= tq * s_ * math.sqrt(fit_qr.XtXinv[2, 2]))
x0 = np.array([-1, 0.3, 0.9]); y0 = x0 @ beta0 + sig * rng.standard_normal(len(Y))
cover_pi = np.mean(np.abs(y0 - Bh @ x0) <= tq * s_ * math.sqrt(1 + x0 @ fit_qr.XtXinv @ x0))
cover_wrong = np.mean(np.abs(y0 - Bh @ x0) <= tq * s_ * math.sqrt(x0 @ fit_qr.XtXinv @ x0))
print(f"RSS/σ²: KS p (χ²(24)) = {stats.kstest(RSSs / sig**2, stats.chi2(24).cdf).pvalue:.3f}, (χ²(27)) = {stats.kstest(RSSs / sig**2, stats.chi2(27).cdf).pvalue:.1e};  2차형식 KS p (χ²(3)) = {stats.kstest(q3, stats.chi2(3).cdf).pvalue:.3f}")
print(f"γ 의 t 구간 포함확률 {cover_g:.4f};  새 관측의 예측구간 {cover_pi:.4f} (신뢰구간 폭을 잘못 쓰면 {cover_wrong:.3f})")
mc = 4 * math.sqrt(0.05 * 0.95 / len(Y))
report({"정리 4.7 (b): RSS/σ² ~ χ²(n − p) = χ²(24) (χ²(27) 이 아니다)": stats.kstest(RSSs / sig**2, stats.chi2(24).cdf).pvalue > 1e-3 and stats.kstest(RSSs / sig**2, stats.chi2(27).cdf).pvalue < 1e-6,
        "정리 4.7 (c): β̂ 와 RSS 는 상관 0": all(abs(np.corrcoef(Bh[:, j], RSSs)[0, 1]) < 4 / math.sqrt(len(Y)) for j in range(3)),
        "정리 4.7 (d): (β̂−β)'X'X(β̂−β)/σ² ~ χ²(3)": stats.kstest(q3, stats.chi2(3).cdf).pvalue > 1e-3,
        "따름정리 4.8: 계수의 t 구간과 예측구간의 포함확률 95%": abs(cover_g - 0.95) < mc and abs(cover_pi - 0.95) < mc,
        "따름정리 4.8: 예측에 신뢰구간의 폭을 쓰면 포함확률이 크게 모자란다": cover_wrong < 0.5})
text
RSS/σ²: KS p (χ²(24)) = 0.865, (χ²(27)) = 0.0e+00;  2차형식 KS p (χ²(3)) = 0.202
γ 의 t 구간 포함확률 0.9495;  새 관측의 예측구간 0.9502 (신뢰구간 폭을 잘못 쓰면 0.409)
text
  ✓  정리 4.7 (b): RSS/σ² ~ χ²(n − p) = χ²(24) (χ²(27) 이 아니다)
  ✓  정리 4.7 (c): β̂ 와 RSS 는 상관 0
  ✓  정리 4.7 (d): (β̂−β)'X'X(β̂−β)/σ² ~ χ²(3)
  ✓  따름정리 4.8: 계수의 t 구간과 예측구간의 포함확률 95%
  ✓  따름정리 4.8: 예측에 신뢰구간의 폭을 쓰면 포함확률이 크게 모자란다
python
def linear_hypothesis(fit, Cm, d):
    """정리 4.9: H0: Cβ = d 의 제약 최소제곱, RSS0 − RSS, F, p, 가능도비"""
    Cm = np.atleast_2d(Cm); d = np.atleast_1d(d); q = Cm.shape[0]
    W = Cm @ fit.XtXinv @ Cm.T; r_ = Cm @ fit.coef - d
    b0 = fit.coef - fit.XtXinv @ Cm.T @ np.linalg.solve(W, r_)
    rss0 = np.sum((fit.y - fit.X @ b0) ** 2)
    F = ((rss0 - fit.rss) / q) / (fit.rss / fit.df)
    lam = (fit.rss / rss0) ** (fit.n / 2)
    return dict(b0=b0, rss0=rss0, drop=r_ @ np.linalg.solve(W, r_), F=F, p=stats.f.sf(F, q, fit.df), lam=lam, q=q)

t_g = fit_qr.coef[2] / fit_qr.se[2]
h1 = linear_hypothesis(fit_qr, [0, 0, 1], 0)                      # θ = 0 (γ = 0)
direct1 = OLS(X[:, :2], y)                                          # 셋째 열을 빼고 직접 맞춘 것
h2 = linear_hypothesis(fit_qr, [[0, 1, 0], [0, 0, 1]], [1.5, 0])    # α = 1.5°, γ = 0
direct2 = OLS(X[:, :1], y - 1.5 * X[:, 1])
print(f"H0: γ = 0 → t = {t_g:.3f}, F = {h1['F']:.3f}, p = {h1['p']:.3f};   H0: α = 1.5, γ = 0 → F = {h2['F']:.3f}, p = {h2['p']:.3f}")
# 귀무가설 아래 F 의 분포 (q = 2): 앞에서 만든 Y 를 α = 1.5, γ = 0 인 세계로
beta_h = np.array([beta0[0], 1.5, 0.0]); Yh = X @ beta_h + sig * rng.standard_normal((100_000, n))
Bh2 = Yh @ A0.T; rss_h = np.sum((Yh - Bh2 @ X.T) ** 2, 1)
Cm2 = np.array([[0, 1, 0], [0, 0, 1.0]]); W2 = Cm2 @ fit_qr.XtXinv @ Cm2.T
rr2 = Bh2 @ Cm2.T - np.array([1.5, 0]); Fs = (np.einsum("ij,jk,ik->i", rr2, np.linalg.inv(W2), rr2) / 2) / (rss_h / 24)
# 연습 4.6: Wilks 근사 (−2 log λ > 3.84) 의 실제 크기
thr = 24 * (math.exp(stats.chi2.ppf(0.95, 1) / 27) - 1)
size_wilks = stats.f.sf(thr, 1, 24)
size_wilks_mc = np.mean(-2 * 27 / 2 * np.log(rss_h / (rss_h + (Bh2[:, 2] ** 2) / fit_qr.XtXinv[2, 2])) > stats.chi2.ppf(0.95, 1))
print(f"Wilks: F > {thr:.3f} ⇔ −2logλ > 3.84, 실제 크기 {size_wilks:.4f} (모의 {size_wilks_mc:.4f});  정확한 임계값 {stats.f.ppf(0.95, 1, 24):.2f}")
report({"정리 4.9 (a): 공식의 제약 해 = 열을 빼고 직접 맞춘 해 (γ = 0)": np.allclose(h1["b0"][:2], direct1.coef) and abs(h1["b0"][2]) < 1e-12 and abs(h1["rss0"] - direct1.rss) < 1e-12,
        "정리 4.9 (a): α = 1.5, γ = 0 의 제약 해도 같다": abs(h2["b0"][0] - direct2.coef[0]) < 1e-12 and abs(h2["rss0"] - direct2.rss) < 1e-12,
        "정리 4.9 (b): RSS0 − RSS = (Cβ̂−d)'W^{-1}(Cβ̂−d)": abs(h1["rss0"] - fit_qr.rss - h1["drop"]) < 1e-12 and abs(h2["rss0"] - fit_qr.rss - h2["drop"]) < 1e-12,
        "예제 4.10 (i) · 연습 4.4: F = t² (γ: t = −1.41, F = 2.00, p = 0.17)": abs(h1["F"] - t_g**2) < 1e-10 and round(t_g, 2) == -1.41 and round(h1["p"], 2) == 0.17,
        "정리 4.9 (d): λ = (RSS/RSS0)^{n/2} = (1 + qF/(n−p))^{−n/2}": all(abs(h["lam"] - (1 + h["q"] * h["F"] / 24) ** (-n / 2)) < 1e-12 for h in (h1, h2)),
        "정리 4.9 (c): 귀무가설 아래 F ~ F(2, 24)": stats.kstest(Fs, stats.f(2, 24).cdf).pvalue > 1e-3,
        "연습 4.6: Wilks 근사의 실제 크기 0.067 (정확한 임계값 4.26)": round(size_wilks, 3) == 0.067 and abs(size_wilks_mc - size_wilks) < 4 * math.sqrt(0.067 * 0.933 / len(Yh)) and round(stats.f.ppf(0.95, 1, 24), 2) == 4.26})
text
H0: γ = 0 → t = -1.415, F = 2.002, p = 0.170;   H0: α = 1.5, γ = 0 → F = 1.046, p = 0.367
Wilks: F > 3.669 ⇔ −2logλ > 3.84, 실제 크기 0.0674 (모의 0.0678);  정확한 임계값 4.26
  ✓  정리 4.9 (a): 공식의 제약 해 = 열을 빼고 직접 맞춘 해 (γ = 0)
  ✓  정리 4.9 (a): α = 1.5, γ = 0 의 제약 해도 같다
  ✓  정리 4.9 (b): RSS0 − RSS = (Cβ̂−d)'W^{-1}(Cβ̂−d)
  ✓  예제 4.10 (i) · 연습 4.4: F = t² (γ: t = −1.41, F = 2.00, p = 0.17)
  ✓  정리 4.9 (d): λ = (RSS/RSS0)^{n/2} = (1 + qF/(n−p))^{−n/2}
  ✓  정리 4.9 (c): 귀무가설 아래 F ~ F(2, 24)
  ✓  연습 4.6: Wilks 근사의 실제 크기 0.067 (정확한 임계값 4.26)
python
# 예제 4.10 (ii) · 연습 4.5: Galton 의 F = t² 와 R² 로 쓴 F
t_slope = fg.coef[1] / fg.se[1]; R2g = 1 - fg.rss / tss
hg = linear_hypothesis(fg, [0, 1], 0)
F_r2 = (R2g / 1) / ((1 - R2g) / (ng - 2))
print(f"Galton: t = {t_slope:.2f}, F = {hg['F']:.2f}, R² 로 쓴 F = {F_r2:.2f}")
report({"예제 4.10 · 연습 4.5: Galton t = 15.71, F = 246.8 = t² = R²/(1−R²)·926": round(t_slope, 2) == 15.71 and round(hg["F"], 1) == 246.8 and abs(hg["F"] - t_slope**2) < 1e-8 and abs(F_r2 - hg["F"]) < 1e-8})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
grid = np.linspace(0, 60, 400)
axes[0].hist(RSSs / sig**2, bins=80, density=True, color=C["stat"], alpha=0.5)
axes[0].plot(grid, stats.chi2(24).pdf(grid), **THEORY, label=r"$\chi^2(24)$")
axes[0].plot(grid, stats.chi2(27).pdf(grid), color=C["key"], ls=":", lw=1.6, label=r"$\chi^2(27)$ (wrong)")
axes[0].set_title(r"RSS$/\sigma^2$: three degrees spent on $\hat\beta$"); axes[0].legend()
fg_ = np.linspace(0, 8, 400)
axes[1].hist(Fs[Fs < 8], bins=80, density=True, color=C["theta"], alpha=0.45)
axes[1].plot(fg_, stats.f(2, 24).pdf(fg_), **THEORY, label=r"$F(2,24)$")
axes[1].axvline(h2["F"], color=C["key"], lw=1.5, label=f"Mayer: F = {h2['F']:.2f}")
axes[1].set_title(r"$H_0:\alpha=1.5,\ \gamma=0$ — null distribution of $F$"); axes[1].legend()
plt.tight_layout(); plt.show()
text
Galton: t = 15.71, F = 246.84, R² 로 쓴 F = 246.84
  ✓  예제 4.10 · 연습 4.5: Galton t = 15.71, F = 246.8 = t² = R²/(1−R²)·926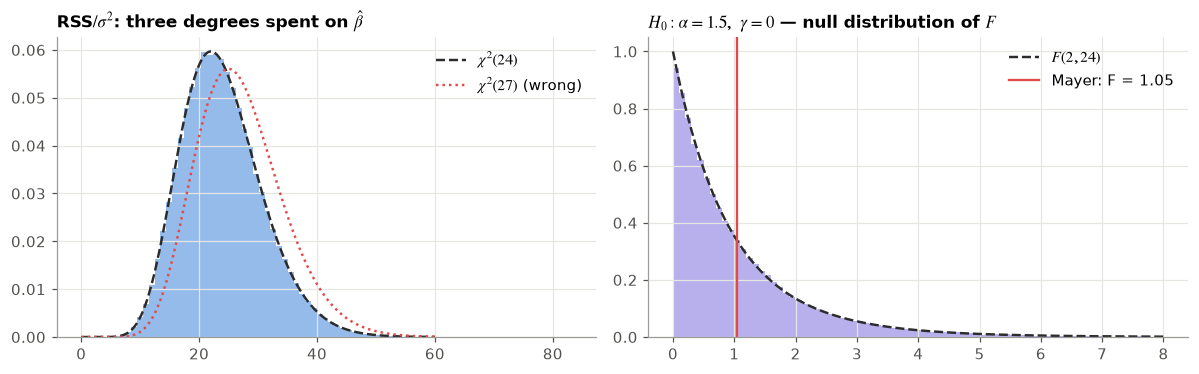
그림 읽기. 왼쪽: 잔차제곱합은 이 아니라 를 따른다. 모수 3개를 맞추는 데 쓴 세 방향(정리 2.5(c))만큼 자유도가 줄었다. 오른쪽: 귀무가설(, ) 아래에서 만든 의 히스토그램이 밀도와 겹친다. Mayer의 실제 자료가 준 (빨간 선)가 분포의 어디쯤에 있는지가 -값이다. Craig·Cochran 정리 덕분에 이 분포는 근사가 아니라 정확하다. 에서 Wilks의 근사를 쓰면 5% 검정이 실제로는 6.7% 검정이 된다.
📝 연습 4.1–4.6 (강의노트): 멱등이 아니면, 의 분산, 일반 공분산의 Craig, , 에서 로, 근사와 정확.
5. 회귀의 탄생 — Galton에서 Yule까지
정리 5.1 최선의 선형예측 · 예제 5.2 Galton의 두 회귀선, Pearson–Lee · 정리 5.3 Frisch–Waugh–Lovell · 따름정리 5.4 · 예제 5.5 Galton의 가족 자료 · 명제 5.6 누락변수의 치우침.
python
# 예제 5.2 · 연습 5.1: 두 회귀선
fx = OLS(np.column_stack([np.ones(ng), yg]), xg)            # 부모를 자녀로
r = np.corrcoef(xg, yg)[0, 1]
print(f"자녀←부모: {fg.coef[0]:.2f} + {fg.coef[1]:.4f} x (SE {fg.se[1]:.4f}), R² = {1 - fg.rss / tss:.4f};  부모←자녀 기울기 {fx.coef[1]:.4f} (평면에서 1/{fx.coef[1]:.3f} = {1 / fx.coef[1]:.2f})")
print(f"r = {r:.4f};  분산 부모 {xg.var(ddof=1):.2f}, 자녀 {yg.var(ddof=1):.2f} (비 {xg.var(ddof=1) / yg.var(ddof=1):.3f})")
report({"예제 5.2: ŷ = 23.94 + 0.646x, SE 0.041, R² = 0.210": round(fg.coef[0], 2) == 23.94 and round(fg.coef[1], 3) == 0.646 and round(fg.se[1], 3) == 0.041 and round(1 - fg.rss / tss, 3) == 0.210,
        "예제 5.2 · 연습 5.1: 거꾸로 맞춘 기울기 0.326, 곱 = r² = 0.210 (r = 0.459)": round(fx.coef[1], 3) == 0.326 and abs(fg.coef[1] * fx.coef[1] - r**2) < 1e-12 and round(r, 3) == 0.459,
        "연습 5.1: 거꾸로 맞춘 직선이 더 가파르다 (1/0.326 = 3.07)": round(1 / fx.coef[1], 2) == 3.07,
        "예제 5.2: 부모 키(두 사람의 평균)의 분산은 자녀 키의 약 절반": abs(xg.var() / yg.var() - 0.5) < 0.01})
text
자녀←부모: 23.94 + 0.6463 x (SE 0.0411), R² = 0.2105;  부모←자녀 기울기 0.3256 (평면에서 1/0.326 = 3.07)
r = 0.4588;  분산 부모 3.19, 자녀 6.34 (비 0.504)
  ✓  예제 5.2: ŷ = 23.94 + 0.646x, SE 0.041, R² = 0.210
  ✓  예제 5.2 · 연습 5.1: 거꾸로 맞춘 기울기 0.326, 곱 = r² = 0.210 (r = 0.459)
  ✓  연습 5.1: 거꾸로 맞춘 직선이 더 가파르다 (1/0.326 = 3.07)
  ✓  예제 5.2: 부모 키(두 사람의 평균)의 분산은 자녀 키의 약 절반
python
# 정리 5.1: 정규가 아닌 모집단에서 — X ~ Exp(1), Y = sin(2X) + 잡음.  β* 를 적분으로, 표본 최소제곱과 비교
from scipy import integrate
EX, EX2 = 1.0, 2.0
EY = integrate.quad(lambda t: math.sin(2 * t) * math.exp(-t), 0, np.inf)[0]
EXY = integrate.quad(lambda t: t * math.sin(2 * t) * math.exp(-t), 0, np.inf)[0]
bstar = np.linalg.solve([[1, EX], [EX, EX2]], [EY, EXY])
xs_ = rng.exponential(1, 2_000_000); ys_ = np.sin(2 * xs_) + rng.normal(0, 0.3, len(xs_))
bs_hat = np.linalg.lstsq(np.column_stack([np.ones(len(xs_)), xs_]), ys_, rcond=None)[0]
u_ = ys_ - bs_hat[0] - bs_hat[1] * xs_
# 연습 5.3: Y = X², X ~ N(0,1) — 최선의 직선은 상수 1
xq = rng.standard_normal(2_000_000); bq = np.linalg.lstsq(np.column_stack([np.ones(len(xq)), xq]), xq**2, rcond=None)[0]
r2q = 1 - np.sum((xq**2 - bq[0] - bq[1] * xq) ** 2) / np.sum((xq**2 - (xq**2).mean()) ** 2)
# 연습 5.2: 회귀의 오류 — ρ = 0.5 인 두 해, 양쪽 방향의 상위 10%
rho = 0.5; XY = rng.multivariate_normal([0, 0], [[1, rho], [rho, 1]], 1_000_000)
topX = XY[:, 0] > np.quantile(XY[:, 0], 0.9); topY = XY[:, 1] > np.quantile(XY[:, 1], 0.9)
gapX, gapY = (XY[topX, 1] - XY[topX, 0]).mean(), (XY[topY, 0] - XY[topY, 1]).mean()
print(f"β* = {np.round(bstar, 4)}, 표본 {np.round(bs_hat, 4)};  Y = X²: 기울기 {bq[1]:.4f}, 절편 {bq[0]:.4f}, R² = {r2q:.5f};  상위 10%: Y−X {gapX:.3f}, X−Y {gapY:.3f}")
report({"정리 5.1 (a): 표본 최소제곱 → β* (대수의 법칙)": np.allclose(bs_hat, bstar, atol=0.005),
        "정리 5.1 (a): 오차는 x 와 무상관 (E x u = 0)": abs(np.mean(xs_ * u_)) < 1e-10 and abs(u_.mean()) < 1e-10,
        "연습 5.3: Y = X² 의 최선의 직선은 β0* = 1, β1* = 0, 설명력 0": abs(bq[0] - 1) < 0.005 and abs(bq[1]) < 0.005 and r2q < 1e-4,
        "연습 5.2: 위로 고르면 아래로, 양쪽 시간 방향 모두 −(1−ρ)E[X | 상위]": abs(gapX - gapY) < 0.01 and within(gapX, -(1 - rho) * stats.norm.pdf(stats.norm.ppf(0.9)) / 0.1, 0.004),
        "연습 5.2: 두 해의 분산은 같다 (평범해지지 않았다)": abs(XY[:, 0].var() - XY[:, 1].var()) < 0.01})
text
β* = [ 0.64 -0.24], 표본 [ 0.6398 -0.2403]; Y = X²: 기울기 -0.0033, 절편 1.0009, R² = 0.00001; 상위 10%: Y−X -0.879, X−Y -0.876text
  ✓  정리 5.1 (a): 표본 최소제곱 → β* (대수의 법칙)
  ✓  정리 5.1 (a): 오차는 x 와 무상관 (E x u = 0)
  ✓  연습 5.3: Y = X² 의 최선의 직선은 β0* = 1, β1* = 0, 설명력 0
  ✓  연습 5.2: 위로 고르면 아래로, 양쪽 시간 방향 모두 −(1−ρ)E[X | 상위]
  ✓  연습 5.2: 두 해의 분산은 같다 (평범해지지 않았다)
python
# 예제 5.5: Galton 의 가족 자료 — 다중회귀와 FWL
GF = load_rdata("GaltonFamilies")
male = (GF.gender == "male").to_numpy(float); yc = GF.childHeight.to_numpy(float)
fat, mot = GF.father.to_numpy(float), GF.mother.to_numpy(float)
Xf = np.column_stack([np.ones(len(GF)), fat, mot, male]); ff = OLS(Xf, yc)
tss_f = np.sum((yc - yc.mean()) ** 2)
print(f"자녀 {len(GF)}명, 가족 {GF.family.nunique()};  계수 {np.round(ff.coef, 3)}, SE {np.round(ff.se, 3)}, R² = {1 - ff.rss / tss_f:.3f}, s = {math.sqrt(ff.s2):.2f}")
# 정리 5.3: 아버지 키와 자녀 키를 (상수, 어머니, 성별)로 맞춘 잔차끼리
Z1 = np.column_stack([np.ones(len(GF)), mot, male]); M1 = lambda v: v - Z1 @ np.linalg.lstsq(Z1, v, rcond=None)[0]
rf_, ry_ = M1(fat), M1(yc); b_fwl = rf_ @ ry_ / (rf_ @ rf_)
# H0: 아버지 계수 = 어머니 계수
hfm = linear_hypothesis(ff, [0, 1, -1, 0], 0)
ratio_mf = yc[male == 1].mean() / yc[male == 0].mean()
# 따름정리 5.4: [(X'X)^{-1}]_jj = 1/(S_jj (1 − R_j²))
vif_ok = True; vifs = []
for j in (1, 2, 3):
    others = np.delete(Xf, j, axis=1); fj = OLS(others, Xf[:, j])
    Sjj = np.sum((Xf[:, j] - Xf[:, j].mean()) ** 2); Rj2 = 1 - fj.rss / Sjj
    vif_ok &= abs(ff.XtXinv[j, j] - 1 / (Sjj * (1 - Rj2))) < 1e-12; vifs.append(1 / (1 - Rj2))
print(f"FWL 기울기 {b_fwl:.12f} 대 다중회귀 {ff.coef[1]:.12f};  아버지=어머니: F = {hfm['F']:.2f}, p = {hfm['p']:.3f};  아들/딸 평균 {ratio_mf:.3f};  VIF {np.round(vifs, 3)}")
report({"예제 5.5: 16.52 + 0.393·아버지 + 0.318·어머니 + 5.21·아들, SE 2.73·0.029·0.031·0.142": np.allclose(np.round(ff.coef, 3), [16.521, 0.393, 0.318, 5.215]) and np.allclose(np.round(ff.se, 3), [2.727, 0.029, 0.031, 0.142]),
        "예제 5.5: 자녀 934명, 205가족, R² = 0.635, s = 2.16": len(GF) == 934 and GF.family.nunique() == 205 and round(1 - ff.rss / tss_f, 3) == 0.635 and round(math.sqrt(ff.s2), 2) == 2.16,
        "정리 5.3: 잔차끼리의 기울기 = 다중회귀의 계수 (소수점 12자리), 잔차도 같다": abs(b_fwl - ff.coef[1]) < 1e-12 and np.allclose(ry_ - b_fwl * rf_, ff.resid),
        "예제 5.5: 아버지 = 어머니 의 F = 3.00, p = 0.084": round(hfm["F"], 2) == 3.00 and round(hfm["p"], 3) == 0.084,
        "예제 5.5: 아들과 딸의 평균 키의 비 69.23/64.10 = 1.080": round(yc[male == 1].mean(), 2) == 69.23 and round(yc[male == 0].mean(), 2) == 64.10 and round(ratio_mf, 3) == 1.080,
        "따름정리 5.4: [(X'X)^{-1}]_jj = 1/(S_jj(1 − R_j²))": bool(vif_ok)})
text
자녀 934명, 가족 205;  계수 [16.521  0.393  0.318  5.215], SE [2.727 0.029 0.031 0.142], R² = 0.635, s = 2.16
FWL 기울기 0.392843330030 대 다중회귀 0.392843330029;  아버지=어머니: F = 3.00, p = 0.084;  아들/딸 평균 1.080;  VIF [1.004 1.004 1.001]
  ✓  예제 5.5: 16.52 + 0.393·아버지 + 0.318·어머니 + 5.21·아들, SE 2.73·0.029·0.031·0.142
  ✓  예제 5.5: 자녀 934명, 205가족, R² = 0.635, s = 2.16
  ✓  정리 5.3: 잔차끼리의 기울기 = 다중회귀의 계수 (소수점 12자리), 잔차도 같다
  ✓  예제 5.5: 아버지 = 어머니 의 F = 3.00, p = 0.084
  ✓  예제 5.5: 아들과 딸의 평균 키의 비 69.23/64.10 = 1.080
  ✓  따름정리 5.4: [(X'X)^{-1}]_jj = 1/(S_jj(1 − R_j²))
python
# 명제 5.6 · 연습 5.4: 성별을 빼면 — 짧은 회귀 = 긴 회귀 + Γ × (빠진 계수)
mid = GF.midparentHeight.to_numpy(float)
f_short = OLS(np.column_stack([np.ones(len(GF)), mid]), yc)
f_long = OLS(np.column_stack([np.ones(len(GF)), mid, male]), yc)
Gam = OLS(np.column_stack([np.ones(len(GF)), mid]), male).coef          # 빠진 변수를 남은 변수로 맞춘 계수
print(f"짧은: 기울기 {f_short.coef[1]:.4f}, R² {1 - f_short.rss / tss_f:.3f};  긴: {f_long.coef[1]:.4f}, R² {1 - f_long.rss / tss_f:.3f};  Γ = {Gam[1]:.5f}")
report({"연습 5.4: 기울기 0.637 → 0.687, R² 0.103 → 0.633": round(f_short.coef[1], 3) == 0.637 and round(f_long.coef[1], 3) == 0.687 and round(1 - f_short.rss / tss_f, 3) == 0.103 and round(1 - f_long.rss / tss_f, 3) == 0.633,
        "명제 5.6: 짧은 회귀 = 긴 회귀 + Γ·β_아들 (표본에서 정확한 항등식), Γ = −0.0095": np.allclose(f_short.coef, f_long.coef[:2] + Gam * f_long.coef[2]) and round(Gam[1], 4) == -0.0095})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
jit = lambda v, a: v + rng.uniform(-a, a, len(v))
axes[0].scatter(jit(xg, 0.25), jit(yg, 0.25), s=4, color=C["data"], alpha=0.25)
tt = np.linspace(63.5, 73.5, 50); yy_ = np.linspace(61, 74.5, 50)
axes[0].plot(tt, fg.coef[0] + fg.coef[1] * tt, color=C["stat"], label=f"child on parent ({fg.coef[1]:.3f})")
axes[0].plot(fx.coef[0] + fx.coef[1] * yy_, yy_, color=C["assume"], label=f"parent on child (1/{fx.coef[1]:.3f})")
axes[0].plot(tt, tt, color=C["hist"], ls=":", lw=1.2, label="y = x")
axes[0].set_xlim(63, 74); axes[0].set_ylim(61, 75); axes[0].legend(fontsize=8); axes[0].set_title("Galton 1886: two regression lines")
axes[1].scatter(jit(rf_, 0.15), ry_, s=4, color=C["data"], alpha=0.35)
tt = np.linspace(rf_.min(), rf_.max(), 10); axes[1].plot(tt, b_fwl * tt, color=C["key"], label=f"slope {b_fwl:.3f}")
axes[1].set_xlabel("father | (mother, sex)"); axes[1].set_ylabel("child | (mother, sex)"); axes[1].legend(); axes[1].set_title("FWL: added-variable plot")
plt.tight_layout(); plt.show()
text
짧은: 기울기 0.6374, R² 0.103;  긴: 0.6870, R² 0.633;  Γ = -0.00952
  ✓  연습 5.4: 기울기 0.637 → 0.687, R² 0.103 → 0.633
  ✓  명제 5.6: 짧은 회귀 = 긴 회귀 + Γ·β_아들 (표본에서 정확한 항등식), Γ = −0.0095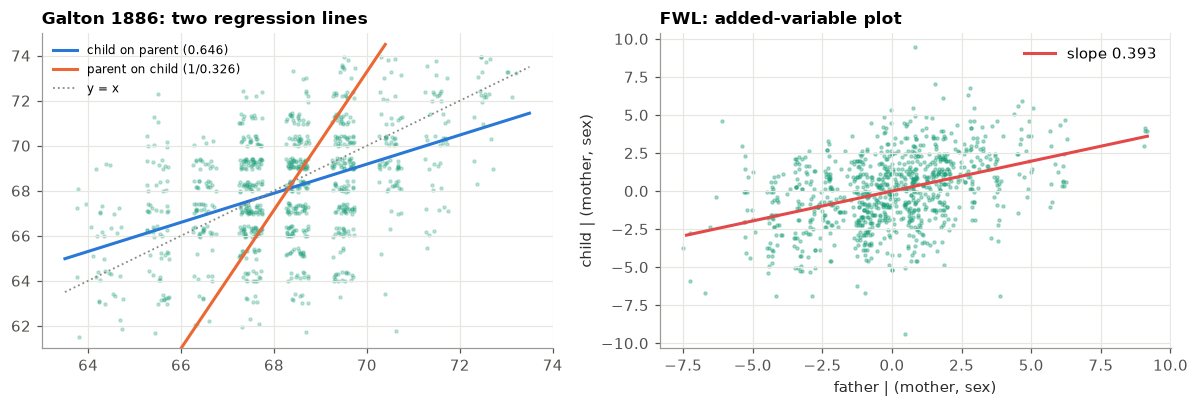
그림 읽기. 왼쪽: 두 회귀선은 같은 타원(5회 정리 3.20)의 수직 접점과 수평 접점의 자취이고, 어느 쪽도 가 아니다. "회귀"는 인과의 방향이 아니라 상관이 1보다 작다는 사실의 기하다. 오른쪽: (상수, 어머니 키, 성별)의 영향을 뺀 아버지 키와 자녀 키의 산점도. 그 기울기가 다중회귀의 아버지 계수 0.393과 소수점 12자리까지 같다. "다른 변수를 고정한다"는 말의 정확한 뜻이 이 그림이다.
📝 연습 5.1–5.4 (강의노트): 두 회귀선, 회귀의 오류, 직선이 놓치는 것, 성별을 빼면.
6. 원자료로 — 회귀 요약표의 모든 숫자
알고리즘 6.1 회귀 요약표 · 예제 6.2 Galton · 예제 6.3 Mayer의 · 예제 6.4 Laplace의 토성.
statsmodels가 없어도 요약표는 1–4절의 공식 몇 줄이다. 직접 만들고 scipy.stats.linregress와 대조한다.
python
def summary_table(fit, names, alpha=0.05):
    """알고리즘 6.1: 계수 · SE · t · p · 구간 · R² · 수정 R² · F · 로그가능도 · AIC · BIC"""
    t = fit.coef / fit.se; pv = 2 * stats.t.sf(np.abs(t), fit.df); q = stats.t.ppf(1 - alpha / 2, fit.df)
    tab = pd.DataFrame({"coef": fit.coef, "SE": fit.se, "t": t, "p": pv, "lo": fit.coef - q * fit.se, "hi": fit.coef + q * fit.se}, index=names)
    tss_ = np.sum((fit.y - fit.y.mean()) ** 2); R2 = 1 - fit.rss / tss_
    ll = -fit.n / 2 * (math.log(2 * math.pi * fit.rss / fit.n) + 1)
    info = dict(n=fit.n, s=math.sqrt(fit.s2), R2=R2, adjR2=1 - (1 - R2) * (fit.n - 1) / fit.df,
                F=(R2 / (fit.p - 1)) / ((1 - R2) / fit.df), loglik=ll, AIC=-2 * ll + 2 * fit.p, BIC=-2 * ll + fit.p * math.log(fit.n))
    info["F_p"] = stats.f.sf(info["F"], fit.p - 1, fit.df)
    return tab, info

tab_g, inf_g = summary_table(fg, ["const", "parent"])
print(tab_g.to_string(float_format=lambda v: f"{v:.4g}")); print({k: round(v, 4) if isinstance(v, float) else v for k, v in inf_g.items()})
lr = stats.linregress(xg, yg)
x72 = np.array([1, 72.0]); yhat72 = x72 @ fg.coef; tq = stats.t.ppf(0.975, fg.df)
ci72 = tq * math.sqrt(x72 @ fg.XtXinv @ x72 * fg.s2); pi72 = tq * math.sqrt(fg.s2 * (1 + x72 @ fg.XtXinv @ x72))
t_one = (fg.coef[1] - 1) / fg.se[1]
print(f"부모 72인치: {yhat72:.2f} ± {ci72:.2f} (평균), ± {pi72:.2f} (한 명);  기울기 = 1 의 t = {t_one:.2f}")
rel = lambda a, b: abs(a / b - 1)
print("linregress 와의 상대 차이:", {k: f"{rel(a, b):.1e}" for k, a, b in [("slope", lr.slope, fg.coef[1]), ("intercept", lr.intercept, fg.coef[0]), ("R2", lr.rvalue**2, inf_g["R2"]),
                                                                            ("p", lr.pvalue, tab_g.p.iloc[1]), ("SE", lr.stderr, fg.se[1]), ("SE0", lr.intercept_stderr, fg.se[0])]})
report({"알고리즘 6.1 = scipy linregress (기울기, 절편, R², 두 SE 는 열 자리, p 는 여섯 자리)":
            max(rel(lr.slope, fg.coef[1]), rel(lr.intercept, fg.coef[0]), rel(lr.rvalue**2, inf_g["R2"]), rel(lr.stderr, fg.se[1]), rel(lr.intercept_stderr, fg.se[0])) < 1e-10 and rel(lr.pvalue, tab_g.p.iloc[1]) < 1e-6,
        "예제 6.2: 상수 23.9415 (2.8109), t 8.517, p 6.5e−17, 구간 [18.425, 29.458]": np.allclose(tab_g.iloc[0, :2].round(4), [23.9415, 2.8109]) and round(tab_g.t.iloc[0], 3) == 8.517 and round(tab_g.p.iloc[0] * 1e17, 1) == 6.5 and np.allclose(tab_g.iloc[0, 4:].round(3), [18.425, 29.458]),
        "예제 6.2: 기울기 0.6463 (0.0411), t 15.711, p 1.7e−49, 구간 [0.566, 0.727]": np.allclose(tab_g.iloc[1, :2].round(4), [0.6463, 0.0411]) and round(tab_g.t.iloc[1], 3) == 15.711 and round(tab_g.p.iloc[1] * 1e49, 1) == 1.7 and np.allclose(tab_g.iloc[1, 4:].round(3), [0.566, 0.727]),
        "예제 6.2: s = 2.2385, R² = 0.2105, 수정 0.2096, F = 246.84 (p 1.7e−49)": round(inf_g["s"], 4) == 2.2385 and round(inf_g["R2"], 4) == 0.2105 and round(inf_g["adjR2"], 4) == 0.2096 and round(inf_g["F"], 2) == 246.84 and rel(inf_g["F_p"], tab_g.p.iloc[1]) < 1e-6,
        "예제 6.2 · 연습 6.3: ℓ = −2063.58, AIC 4131.16, BIC 4140.83 (R 관행 AIC 4133.16)": round(inf_g["loglik"], 2) == -2063.58 and round(inf_g["AIC"], 2) == 4131.16 and round(inf_g["BIC"], 2) == 4140.83 and round(inf_g["AIC"] + 2, 2) == 4133.16,
        "예제 6.2: 부모 72인치 → 70.47 ± 0.33 (평균), ± 4.41 (한 명)": round(yhat72, 2) == 70.47 and round(ci72, 2) == 0.33 and round(pi72, 2) == 4.41,
        "연습 6.1: 기울기 = 1 의 t = −8.60": round(t_one, 2) == -8.60})
text
         coef      SE     t         p     lo    hi
const   23.94   2.811 8.517 6.537e-17  18.43 29.46
parent 0.6463 0.04114 15.71 1.733e-49 0.5656 0.727
{'n': 928, 's': 2.2385, 'R2': np.float64(0.2105), 'adjR2': np.float64(0.2096), 'F': np.float64(246.8391), 'loglik': -2063.5814, 'AIC': 4131.1628, 'BIC': 4140.8289, 'F_p': np.float64(0.0)}
부모 72인치: 70.47 ± 0.33 (평균), ± 4.41 (한 명);  기울기 = 1 의 t = -8.60
linregress 와의 상대 차이: {'slope': '9.7e-13', 'intercept': '1.8e-12', 'R2': '8.9e-16', 'p': '1.9e-10', 'SE': '2.2e-16', 'SE0': '6.7e-16'}
  ✓  알고리즘 6.1 = scipy linregress (기울기, 절편, R², 두 SE 는 열 자리, p 는 여섯 자리)
  ✓  예제 6.2: 상수 23.9415 (2.8109), t 8.517, p 6.5e−17, 구간 [18.425, 29.458]
  ✓  예제 6.2: 기울기 0.6463 (0.0411), t 15.711, p 1.7e−49, 구간 [0.566, 0.727]
  ✓  예제 6.2: s = 2.2385, R² = 0.2105, 수정 0.2096, F = 246.84 (p 1.7e−49)
  ✓  예제 6.2 · 연습 6.3: ℓ = −2063.58, AIC 4131.16, BIC 4140.83 (R 관행 AIC 4133.16)
  ✓  예제 6.2: 부모 72인치 → 70.47 ± 0.33 (평균), ± 4.41 (한 명)
  ✓  연습 6.1: 기울기 = 1 의 t = −8.60
python
# 6.2절 · 예제 6.3: Mayer 의 세 방법과 θ 의 표준오차
# 상수항이 따로 없는 모형(첫 열이 −1)이라 계수 표만 쓴다
t_m = fit_qr.coef / fit_qr.se; p_m = 2 * stats.t.sf(np.abs(t_m), 24)
Vab = fit_qr.s2 * fit_qr.XtXinv
theta_of = lambda b: math.asin(b[2] / b[1])
u = fit_qr.coef[2] / fit_qr.coef[1]
grad = np.array([0, -fit_qr.coef[2] / (fit_qr.coef[1] ** 2 * math.sqrt(1 - u * u)), 1 / (fit_qr.coef[1] * math.sqrt(1 - u * u))])
gnum = np.array([(theta_of(fit_qr.coef + h) - theta_of(fit_qr.coef - h)) / 2e-7 for h in np.eye(3) * 1e-7])
se_th = math.degrees(math.sqrt(grad @ Vab @ grad))
rows = []
for name, bb in [("최소제곱", fit_qr.coef), ("Mayer 묶음", b_M), ("최소절댓값", b_lad_M)]:
    rr_ = y - X @ bb
    rows.append([name, dms(bb[0]), dms(bb[1]), dms(math.degrees(theta_of(bb))), round(rr_ @ rr_, 4), round(np.abs(rr_).sum(), 3)])
print(pd.DataFrame(rows, columns=["방법", "β", "α", "θ", "Σe²", "Σ|e|"]).to_string(index=False))
print(f"θ 의 기울기 (α, γ 방향) {np.round(grad[1:], 5)};  주된 항 {math.degrees(grad[2] * fit_qr.se[2]):.2f}°")
print(f"최소제곱 SE: β {fit_qr.se[0] * 60:.1f}′, α {fit_qr.se[1] * 60:.1f}′, θ {dms(se_th)};  γ: t = {t_m[2]:.2f}, p = {p_m[2]:.2f};  s = {math.sqrt(fit_qr.s2) * 60:.1f}′, s/√27 = {math.sqrt(fit_qr.s2) * 60 / math.sqrt(27):.1f}′")
report({"6.2절 표: Σe² 최소제곱 0.5689 · Mayer 0.5767, Σ|e| 최소제곱 3.220 · 최소절댓값 3.066": [rows[0][4], rows[1][4]] == [0.5689, 0.5767] and [rows[0][5], rows[2][5]] == [3.220, 3.066],
        "6.2절: 각 방법은 자기 기준에서 최선 (Σe² 는 최소제곱, Σ|e| 는 최소절댓값이 가장 작다)": rows[0][4] == min(r_[4] for r_ in rows) and rows[2][5] < rows[0][5],
        "6.2절 표: SE β 2.1′, α 2.5′, s = 0.154° = 9.2′": round(fit_qr.se[0] * 60, 1) == 2.1 and round(fit_qr.se[1] * 60, 1) == 2.5 and round(math.sqrt(fit_qr.s2), 3) == 0.154 and round(math.sqrt(fit_qr.s2) * 60, 1) == 9.2,
        "예제 6.3 · 연습 6.2: 델타 방법의 SE(θ̂) = 1.95° = 1°56.8′ (해석적 기울기 = 수치 기울기)": np.allclose(grad, gnum, rtol=1e-5, atol=1e-9) and round(se_th, 2) == 1.95 and dms(se_th) == "1°56.8′",
        "연습 6.2: 기울기 벡터 (0.0318, 0.6649)": np.allclose(np.round(grad[1:], 4), [0.0318, 0.6649]),
        "예제 6.3: γ 의 t = −1.41, p = 0.17": round(t_m[2], 2) == -1.41 and round(p_m[2], 2) == 0.17})
text
      방법        β       α        θ    Σe²  Σ|e|
    최소제곱 14°33.5′ 1°30.3′ -2°44.3′ 0.5689 3.220
Mayer 묶음 14°32.8′ 1°29.7′ -3°49.1′ 0.5767 3.164
   최소절댓값 14°34.1′ 1°30.9′  -5°2.8′ 0.6274 3.066
θ 의 기울기 (α, γ 방향) [0.03176 0.66486];  주된 항 1.94°
최소제곱 SE: β 2.1′, α 2.5′, θ 1°56.8′;  γ: t = -1.41, p = 0.17;  s = 9.2′, s/√27 = 1.8′
  ✓  6.2절 표: Σe² 최소제곱 0.5689 · Mayer 0.5767, Σ|e| 최소제곱 3.220 · 최소절댓값 3.066
  ✓  6.2절: 각 방법은 자기 기준에서 최선 (Σe² 는 최소제곱, Σ|e| 는 최소절댓값이 가장 작다)
  ✓  6.2절 표: SE β 2.1′, α 2.5′, s = 0.154° = 9.2′
  ✓  예제 6.3 · 연습 6.2: 델타 방법의 SE(θ̂) = 1.95° = 1°56.8′ (해석적 기울기 = 수치 기울기)
  ✓  연습 6.2: 기울기 벡터 (0.0318, 0.6649)
  ✓  예제 6.3: γ 의 t = −1.41, p = 0.17
python
# 예제 6.4: Laplace 의 토성 (1787)
Sa = load_rdata("Saturn")
Xs = np.column_stack([np.ones(len(Sa)), Sa[["X1", "X2", "X3"]].to_numpy(float)]); fs_ = OLS(Xs, Sa.Y.to_numpy(float))
tab_s, inf_s = summary_table(fs_, ["const", "t", "x2", "x3"])
imax = np.abs(fs_.resid).argmax()
print(tab_s.round(4).to_string()); print(f"s = {inf_s['s']:.3f}′, 최대 잔차 {fs_.resid[imax]:.2f}′ ({Sa.Year[imax]}년), R² = {inf_s['R2']:.3f}, F = {inf_s['F']:.2f} (p = {inf_s['F_p']:.3f})")
report({"예제 6.4: 1591–1785년 관측 24개": len(Sa) == 24 and Sa.Year.min() == 1591 and Sa.Year.max() == 1785,
        "예제 6.4: 3.43 (0.27), 0.0032 (0.0040), 0.70 (0.30), 0.27 (0.32)": np.allclose(np.round(fs_.coef, 2)[[0, 2, 3]], [3.43, 0.70, 0.27]) and round(fs_.coef[1], 4) == 0.0032 and np.allclose(np.round(fs_.se, 2)[[0, 2, 3]], [0.27, 0.30, 0.32]) and round(fs_.se[1], 4) == 0.0040,
        "예제 6.4: s = 1.02′, 가장 큰 잔차는 1753년의 −1.68′": round(inf_s["s"], 2) == 1.02 and Sa.Year[imax] == 1753 and round(fs_.resid[imax], 2) == -1.68,
        "예제 6.4: R² = 0.25, F = 2.24, p = 0.11": round(inf_s["R2"], 2) == 0.25 and round(inf_s["F"], 2) == 2.24 and round(inf_s["F_p"], 2) == 0.11})
text
         coef      SE        t       p      lo      hi
const  3.4290  0.2708  12.6617  0.0000  2.8641  3.9940
t      0.0032  0.0040   0.8141  0.4252 -0.0050  0.0115
x2     0.6958  0.2988   2.3287  0.0305  0.0725  1.3190
x3     0.2713  0.3172   0.8552  0.4026 -0.3904  0.9329
s = 1.022′, 최대 잔차 -1.68′ (1753년), R² = 0.252, F = 2.24 (p = 0.115)
  ✓  예제 6.4: 1591–1785년 관측 24개
  ✓  예제 6.4: 3.43 (0.27), 0.0032 (0.0040), 0.70 (0.30), 0.27 (0.32)
  ✓  예제 6.4: s = 1.02′, 가장 큰 잔차는 1753년의 −1.68′
  ✓  예제 6.4: R² = 0.25, F = 2.24, p = 0.11
숫자 읽기. Galton의 요약표는 linregress와 열 자리 넘게 일치한다. 요약표의 숫자는 모두 , , RSS 세 가지에서 나온다. Mayer의 는 표준오차가 거의 여서 세 방법의 에서 까지의 차이는 우연의 크기 안이다. 토성의 는 낮지만, 그것은 Laplace의 이론이 이미 대부분을 설명하고 남은 "관측 − 이론"을 다시 회귀했기 때문이다. 잔차 는 당시 관측 정밀도와 같은 크기다.
📝 연습 6.1–6.3 (강의노트): 요약표 읽기, 의 델타 방법, 로그가능도와 AIC.
7. 부숴보기 — 가정이 깨질 때
명제 7.1 샌드위치 · 예제 7.2 분산이 에 비례 · 명제 7.3 한 점 빼기 · 예제 7.4 Anscombe · 예제 7.5 공선성 · 예제 7.6 Berkeley 1973.
python
# 예제 7.2 · 연습 7.1: x 는 0–10 에 고르게 100개, 오차 sd = 0.05 x²
gh = np.random.default_rng(1980)
nh = 100; xh = np.linspace(0, 10, nh); Xh = np.column_stack([np.ones(nh), xh]); XtXi_h = np.linalg.inv(Xh.T @ Xh)
Hh = Xh @ XtXi_h @ Xh.T; hh = np.diag(Hh); Sig_h = np.diag((0.05 * xh**2) ** 2)
true_var = (XtXi_h @ Xh.T @ Sig_h @ Xh @ XtXi_h)[1, 1]                       # 명제 7.1
E_classic = np.trace((np.eye(nh) - Hh) @ Sig_h) / (nh - 2) * XtXi_h[1, 1]    # 연습 7.1
Rh = 40_000
Yh_ = 1 + 0.5 * xh + gh.standard_normal((Rh, nh)) * (0.05 * xh**2)
Bh_ = Yh_ @ (XtXi_h @ Xh.T).T; Eh = Yh_ - Bh_ @ Xh.T
L1 = (XtXi_h @ Xh.T)[1]
se_cl = np.sqrt((Eh**2).sum(1) / (nh - 2) * XtXi_h[1, 1])
se_hc1 = np.sqrt((Eh**2) @ L1**2 * nh / (nh - 2)); se_hc3 = np.sqrt((Eh**2 / (1 - hh) ** 2) @ L1**2)
tq = stats.t.ppf(0.975, nh - 2)
cov_ = {k: np.mean(np.abs(Bh_[:, 1] - 0.5) <= tq * s_) for k, s_ in [("보통", se_cl), ("HC1", se_hc1), ("HC3", se_hc3)]}
print(f"기울기의 참 표준편차 {math.sqrt(true_var):.4f} (모의 {Bh_[:, 1].std():.4f});  보통 공식의 분산 기댓값/참 분산 = {E_classic / true_var:.3f}, 표준오차 평균 {se_cl.mean():.4f}")
print("95% 구간의 포함확률:", {k: round(v, 4) for k, v in cov_.items()})
mc = 4 * math.sqrt(0.95 * 0.05 / Rh)
report({"명제 7.1 · 예제 7.2: 참 표준편차 0.097 (모의와 일치)": round(math.sqrt(true_var), 3) == 0.097 and within(Bh_[:, 1].std(), math.sqrt(true_var), math.sqrt(true_var) / math.sqrt(2 * Rh)),
        "연습 7.1 · 예제 7.2: 보통 공식의 분산 기댓값은 참 분산의 0.63배 (모의와 일치)": round(E_classic / true_var, 2) == 0.63 and within(np.mean(se_cl**2), E_classic, np.std(se_cl**2) / math.sqrt(Rh)),
        "예제 7.2: 보통 공식의 √(분산 기댓값) = 0.077, 포함확률 약 88%": round(math.sqrt(E_classic), 3) == 0.077 and abs(cov_["보통"] - 0.88) < 0.01,
        "예제 7.2: HC1 약 94%, HC3 약 95%": abs(cov_["HC1"] - 0.94) < 0.01 and abs(cov_["HC3"] - 0.95) < mc + 0.003})
text
기울기의 참 표준편차 0.0970 (모의 0.0969);  보통 공식의 분산 기댓값/참 분산 = 0.631, 표준오차 평균 0.0765
95% 구간의 포함확률: {'보통': np.float64(0.883), 'HC1': np.float64(0.9426), 'HC3': np.float64(0.9472)}
  ✓  명제 7.1 · 예제 7.2: 참 표준편차 0.097 (모의와 일치)
  ✓  연습 7.1 · 예제 7.2: 보통 공식의 분산 기댓값은 참 분산의 0.63배 (모의와 일치)
  ✓  예제 7.2: 보통 공식의 √(분산 기댓값) = 0.077, 포함확률 약 88%
  ✓  예제 7.2: HC1 약 94%, HC3 약 95%
python
# 명제 7.3 · 연습 7.2: 한 점을 빼고 다시 맞추기 — Mayer 의 27개 모두
A_ = X.T @ X; ok_loo = True; press = 0.0
for i in range(n):
    keep = np.arange(n) != i
    b_i = np.linalg.lstsq(X[keep], y[keep], rcond=None)[0]
    hi_, ei_ = fit_qr.hat_diag[i], fit_qr.resid[i]
    ok_loo &= np.allclose(fit_qr.coef - b_i, np.linalg.solve(A_, X[i]) * ei_ / (1 - hi_), atol=1e-12)
    ok_loo &= abs((y[i] - X[i] @ b_i) - ei_ / (1 - hi_)) < 1e-12
    press += (y[i] - X[i] @ b_i) ** 2
uu = rng.normal(size=3); Ainv = np.linalg.inv(A_)
SM = Ainv + np.outer(Ainv @ uu, uu @ Ainv) / (1 - uu @ Ainv @ uu)
print(f"PRESS = {press:.4f} (공식 {np.sum((fit_qr.resid / (1 - fit_qr.hat_diag)) ** 2):.4f}),  RSS = {fit_qr.rss:.4f}")
# 예제 7.4: Anscombe
an_rows = []
for k in range(1, 5):
    xa, ya = an[f"x{k}"].to_numpy(float), an[f"y{k}"].to_numpy(float); fa = OLS(np.column_stack([np.ones(11), xa]), ya)
    an_rows.append((fa.coef[0], fa.coef[1], 1 - fa.rss / np.sum((ya - ya.mean()) ** 2), fa.hat_diag.max(), fa))
print("Anscombe (절편, 기울기, R², 최대 지렛대):", [tuple(round(v, 3) for v in r_[:4]) for r_ in an_rows])
f4 = an_rows[3][4]; i19 = int(np.argmax(an.x4)); y4 = an.y4.to_numpy(float)
slope4 = (y4[i19] - y4[an.x4 == 8].mean()) / (19 - 8)
report({"명제 7.3: β̂ − β̂_(i) = (X'X)^{-1}x_i e_i/(1−h_ii), 빼고 맞춘 잔차 = e_i/(1−h_ii) (27개 모두)": bool(ok_loo),
        "명제 7.3: PRESS 를 한 번의 적합으로": abs(press - np.sum((fit_qr.resid / (1 - fit_qr.hat_diag)) ** 2)) < 1e-10,
        "연습 7.2: Sherman–Morrison": np.allclose(SM @ (A_ - np.outer(uu, uu)), np.eye(3)),
        "예제 7.4: 네 자료 모두 ŷ = 3.00 + 0.500x, R² = 0.67": all(round(r_[0], 2) == 3.00 and round(r_[1], 3) == 0.500 and round(r_[2], 2) == 0.67 for r_ in an_rows),
        "예제 7.4: 넷째 자료의 x = 19 는 지렛대 1, 잔차 0, 기울기 = 그 점과 나머지 평균을 잇는 기울기":
            abs(f4.hat_diag[i19] - 1) < 1e-12 and abs(f4.resid[i19]) < 1e-10 and abs(f4.coef[1] - slope4) < 1e-12})
text
PRESS = 0.7547 (공식 0.7547),  RSS = 0.5689
Anscombe (절편, 기울기, R², 최대 지렛대): [(np.float64(3.0), np.float64(0.5), np.float64(0.667), np.float64(0.318)), (np.float64(3.001), np.float64(0.5), np.float64(0.666), np.float64(0.318)), (np.float64(3.002), np.float64(0.5), np.float64(0.666), np.float64(0.318)), (np.float64(3.002), np.float64(0.5), np.float64(0.667), np.float64(1.0))]
  ✓  명제 7.3: β̂ − β̂_(i) = (X'X)^{-1}x_i e_i/(1−h_ii), 빼고 맞춘 잔차 = e_i/(1−h_ii) (27개 모두)
  ✓  명제 7.3: PRESS 를 한 번의 적합으로
  ✓  연습 7.2: Sherman–Morrison
  ✓  예제 7.4: 네 자료 모두 ŷ = 3.00 + 0.500x, R² = 0.67
  ✓  예제 7.4: 넷째 자료의 x = 19 는 지렛대 1, 잔차 0, 기울기 = 그 점과 나머지 평균을 잇는 기울기
python
# 예제 7.5 · 연습 7.3: 공선성 (seed 458 의 표본)
gc = np.random.default_rng(458)
x1 = gc.normal(0, 1, 100); x2 = x1 + gc.normal(0, 0.05, 100); ycol = 1 + x1 + x2 + gc.normal(0, 1, 100)
Xcol = np.column_stack([np.ones(100), x1, x2]); fcol = OLS(Xcol, ycol)
r12 = np.corrcoef(x1, x2)[0, 1]; vif = 1 / (1 - r12**2)
cvec = np.array([0, 1, 1.0]); se_sum = math.sqrt(fcol.s2 * cvec @ fcol.XtXinv @ cvec)
# 반복 표본 (설계 고정): 각 계수는 크게 흩어지고 합은 묶여 있다
Bc = np.array([OLS(Xcol, 1 + x1 + x2 + gc.normal(0, 1, 100)).coef for _ in range(3000)])
# 연습 7.3: 평균 0, 분산 1, 상관 r 이 정확한 설계 (상수항 없음)
nr, rr = 200, 0.9; Q_, _ = np.linalg.qr(gc.normal(size=(nr, 2)) - gc.normal(size=(nr, 2)).mean(0))
Q_ = Q_ - Q_.mean(0); Q_, _ = np.linalg.qr(Q_)
z1 = Q_[:, 0] * math.sqrt(nr); z2 = (rr * Q_[:, 0] + math.sqrt(1 - rr**2) * Q_[:, 1]) * math.sqrt(nr)
Xr_ = np.column_stack([z1, z2]); Vr = np.linalg.inv(Xr_.T @ Xr_)
print(f"r = {r12:.4f}, VIF = {vif:.0f} (모집단 {1.0025 / 0.0025:.0f});  β̂ = {np.round(fcol.coef[1:], 2)}, SE {np.round(fcol.se[1:], 2)};  합 {fcol.coef[1] + fcol.coef[2]:.2f} (SE {se_sum:.3f})")
print(f"반복 표본: sd(β̂1) {Bc[:, 1].std():.2f}, sd(β̂2) {Bc[:, 2].std():.2f}, sd(합) {(Bc[:, 1] + Bc[:, 2]).std():.3f}, 상관 {np.corrcoef(Bc[:, 1], Bc[:, 2])[0, 1]:.4f}")
report({"예제 7.5: r = 0.9985, VIF = 344, 모집단 VIF = 401": round(r12, 4) == 0.9985 and round(vif) == 344 and round(1.0025 / 0.0025) == 401,
        "예제 7.5: β̂ = (4.71, −2.87), SE 2.06, 합 1.83 (SE 0.111)": np.allclose(np.round(fcol.coef[1:], 2), [4.71, -2.87]) and np.allclose(np.round(fcol.se[1:], 2), [2.06, 2.06]) and round(fcol.coef[1] + fcol.coef[2], 2) == 1.83 and round(se_sum, 3) == 0.111,
        "따름정리 5.4: Var β̂1 = σ²/(S11(1 − R1²)) 의 VIF 가 1/(1 − r²)": abs(fcol.XtXinv[1, 1] * np.sum((x1 - x1.mean()) ** 2) - vif) < 1e-6,
        "예제 7.5: 반복 표본에서 각 계수의 sd 는 합의 sd 의 15배 넘게 크다, 상관은 −1 에 가깝다": Bc[:, 1].std() > 15 * (Bc[:, 1] + Bc[:, 2]).std() and np.corrcoef(Bc[:, 1], Bc[:, 2])[0, 1] < -0.99,
        "연습 7.3: Var(β̂1 ± β̂2) = 2σ²/(n(1 ± r))": abs(np.array([1, 1]) @ Vr @ np.array([1, 1]) - 2 / (nr * (1 + rr))) < 1e-12 and abs(np.array([1, -1]) @ Vr @ np.array([1, -1]) - 2 / (nr * (1 - rr))) < 1e-12})
text
r = 0.9985, VIF = 344 (모집단 401);  β̂ = [ 4.71 -2.87], SE [2.06 2.06];  합 1.83 (SE 0.111)
반복 표본: sd(β̂1) 1.93, sd(β̂2) 1.93, sd(합) 0.104, 상관 -0.9985
  ✓  예제 7.5: r = 0.9985, VIF = 344, 모집단 VIF = 401
  ✓  예제 7.5: β̂ = (4.71, −2.87), SE 2.06, 합 1.83 (SE 0.111)
  ✓  따름정리 5.4: Var β̂1 = σ²/(S11(1 − R1²)) 의 VIF 가 1/(1 − r²)
  ✓  예제 7.5: 반복 표본에서 각 계수의 sd 는 합의 sd 의 15배 넘게 크다, 상관은 −1 에 가깝다
  ✓  연습 7.3: Var(β̂1 ± β̂2) = 2σ²/(n(1 ± r))
python
# 예제 7.6 · 연습 7.4: Berkeley 1973 — 선형확률모형과 누락변수
U = load_rdata("UCBAdmissions", "datasets")
rows_ = U.loc[U.index.repeat(U.Freq)].reset_index(drop=True)
adm = (rows_.Admit == "Admitted").to_numpy(float); fem = (rows_.Gender == "Female").to_numpy(float)
depts = sorted(rows_.Dept.unique()); Dm = np.column_stack([(rows_.Dept == d).to_numpy(float) for d in depts])
f_s = OLS(np.column_stack([np.ones(len(adm)), fem]), adm)                              # 짧은 회귀
f_l = OLS(np.column_stack([np.ones(len(adm)), fem, Dm[:, 1:]]), adm)                   # 긴 회귀 (A 가 기준)
Gm = np.linalg.lstsq(np.column_stack([np.ones(len(adm)), fem]), Dm[:, 1:], rcond=None)[0]
tab_d = pd.DataFrame({d: dict(rate=adm[rows_.Dept == d].mean(), female_share=fem[rows_.Dept == d].mean(),
                              male=adm[(rows_.Dept == d) & (fem == 0)].mean(), female=adm[(rows_.Dept == d) & (fem == 1)].mean()) for d in depts}).T
print(f"지원자 {len(adm)};  합격률 남 {adm[fem == 0].mean():.3f}, 여 {adm[fem == 1].mean():.3f};  여자 계수: 짧은 {f_s.coef[1]:.3f}, 학과를 넣으면 {f_l.coef[1]:.3f} (SE {f_l.se[1]:.3f})")
print(tab_d.round(3).to_string())
# 연습 7.4: 두 학과의 예
two = pd.DataFrame(dict(Q=[0] * 100 + [1] * 100, F=[0] * 80 + [1] * 20 + [0] * 20 + [1] * 80,
                        A=[1] * 48 + [0] * 32 + [1] * 13 + [0] * 7 + [1] * 4 + [0] * 16 + [1] * 20 + [0] * 60))
ts = OLS(np.column_stack([np.ones(200), two.F]), two.A.to_numpy(float)); tl = OLS(np.column_stack([np.ones(200), two.Q, two.F]), two.A.to_numpy(float))
G2 = OLS(np.column_stack([np.ones(200), two.F]), two.Q.to_numpy(float)).coef[1]
report({"예제 7.6: 4526명, 합격률 남 44.5%, 여 30.4%": len(adm) == 4526 and round(adm[fem == 0].mean(), 3) == 0.445 and round(adm[fem == 1].mean(), 3) == 0.304,
        "예제 7.6: 여자 계수 −0.142 → 학과를 넣으면 +0.018 (SE 0.015)": round(f_s.coef[1], 3) == -0.142 and round(f_l.coef[1], 3) == 0.018 and round(f_l.se[1], 3) == 0.015,
        "예제 7.6: F·E·C 과 합격률 6%·25%·35%, 여자 비율 48%·67%·65%; A·B 과 64%·63%, 12%·4%":
            np.allclose(tab_d.loc[["F", "E", "C", "A", "B"], "rate"].round(2), [0.06, 0.25, 0.35, 0.64, 0.63]) and np.allclose(tab_d.loc[["F", "E", "C", "A", "B"], "female_share"].round(2), [0.48, 0.67, 0.65, 0.12, 0.04]),
        "명제 5.6: 짧은 회귀의 계수 = 긴 회귀 + Γ × (학과 계수) — 정확한 항등식": np.allclose(f_s.coef, f_l.coef[:2] + Gm @ f_l.coef[2:]),
        "연습 7.4: 학과마다 여자가 5%p 높지만 전체는 33% 대 52%, −0.19 = 0.05 + 0.6 × (−0.40)":
            np.allclose(tl.coef, [0.60, -0.40, 0.05]) and round(ts.coef[1], 2) == -0.19 and round(G2, 2) == 0.60 and abs(ts.coef[1] - (tl.coef[2] + G2 * tl.coef[1])) < 1e-12})
text
지원자 4526;  합격률 남 0.445, 여 0.304;  여자 계수: 짧은 -0.142, 학과를 넣으면 0.018 (SE 0.015)
    rate  female_share   male  female
A  0.644         0.116  0.621   0.824
B  0.632         0.043  0.630   0.680
C  0.351         0.646  0.369   0.341
D  0.340         0.473  0.331   0.349
E  0.252         0.673  0.277   0.239
F  0.064         0.478  0.059   0.070
  ✓  예제 7.6: 4526명, 합격률 남 44.5%, 여 30.4%
  ✓  예제 7.6: 여자 계수 −0.142 → 학과를 넣으면 +0.018 (SE 0.015)
  ✓  예제 7.6: F·E·C 과 합격률 6%·25%·35%, 여자 비율 48%·67%·65%; A·B 과 64%·63%, 12%·4%
  ✓  명제 5.6: 짧은 회귀의 계수 = 긴 회귀 + Γ × (학과 계수) — 정확한 항등식
  ✓  연습 7.4: 학과마다 여자가 5%p 높지만 전체는 33% 대 52%, −0.19 = 0.05 + 0.6 × (−0.40)
python
fig, axes = plt.subplots(1, 3, figsize=(12, 3.5))
axes[0].bar(["classic", "HC1", "HC3"], list(cov_.values()), color=[C["assume"], C["stat"], C["stat"]], alpha=0.8)
axes[0].axhline(0.95, **THEORY); axes[0].set_ylim(0.8, 1); axes[0].set_title(r"coverage when sd $\propto x^2$")
axes[1].scatter(Bc[:, 1], Bc[:, 2], s=3, color=C["stat"], alpha=0.4); axes[1].plot(1, 1, "+", color=C["key"], ms=10, mew=2)
axes[1].set_xlabel(r"$\hat\beta_1$"); axes[1].set_ylabel(r"$\hat\beta_2$"); axes[1].set_title(f"collinearity: VIF ≈ {vif:.0f}")
xs3 = np.arange(len(depts))
axes[2].plot(xs3, tab_d.male, "o", color=C["stat"], label="male"); axes[2].plot(xs3, tab_d.female, "o", color=C["key"], label="female")
axes[2].axhline(adm[fem == 0].mean(), color=C["stat"], ls="--", lw=1); axes[2].axhline(adm[fem == 1].mean(), color=C["key"], ls="--", lw=1)
axes[2].set_xticks(xs3, depts); axes[2].legend(); axes[2].set_title("Berkeley 1973: by department")
plt.tight_layout(); plt.show()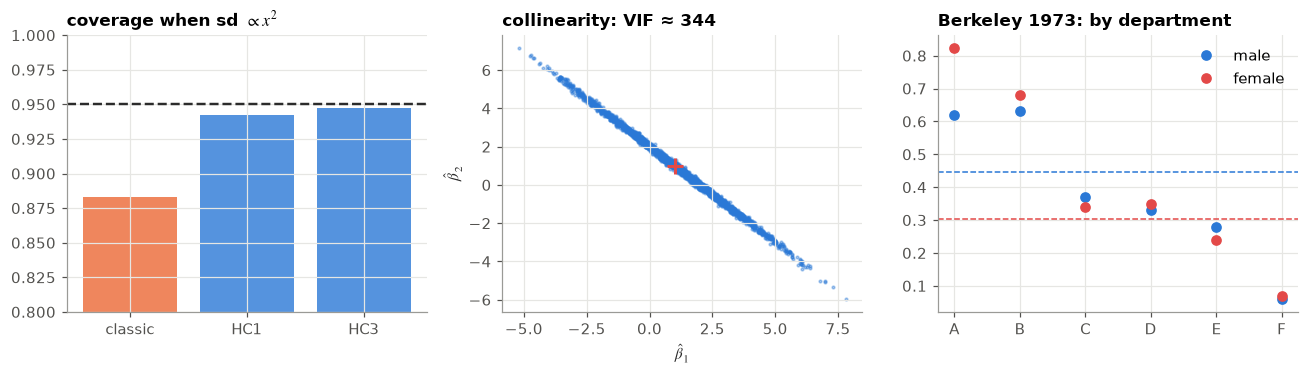
그림 읽기. 왼쪽: 분산이 에 비례하면 보통 공식의 95% 구간은 88%만 맞힌다. 샌드위치(HC1, HC3)는 를 모르면서도 거의 95%로 돌려놓는다. 가운데: 공선성 아래 는 직선 를 따라 수십 단위로 퍼지지만 그 직선에서는 거의 벗어나지 않는다. 오른쪽: 점선(전체 합격률)으로는 남녀의 차이가 14%p지만, 학과 안의 점들은 거의 겹친다. 여자가 합격률이 낮은 학과에 더 많이 지원했다는 사실 하나가 전체의 차이를 만든다.
📝 연습 7.1–7.4 (강의노트): 보통 공식의 기댓값, Sherman–Morrison, 공선성의 두 표준오차, 두 학과의 역설.
8. 오늘의 최소제곱 — 경사하강과 weight decay
정리 8.1 경사하강의 속도 · 정리 8.3 원점에서 출발하면 최소노름 해 · 명제 8.5 ridge는 방향마다 배 · 정리 8.6 Hoerl–Kennard.
python
def gd_error_exact(Xd, yd, k):
    """정리 8.1: w_k − β̂ = (I − ηA)^k (w_0 − β̂), w_0 = 0, η = 1/μ_max — 고유분해로 k 번째 오차를 정확히"""
    A = Xd.T @ Xd / len(yd); mu, V = np.linalg.eigh(A); bstar = np.linalg.solve(A, Xd.T @ yd / len(yd))
    c = V.T @ (-bstar); fac = (1 - mu / mu.max()) ** k
    return np.linalg.norm(V @ (fac * c)) / np.linalg.norm(bstar), mu.max() / mu.min()

def gd_run(Xd, yd, K):
    A = Xd.T @ Xd / len(yd); eta = 1 / np.linalg.eigvalsh(A).max(); bstar = np.linalg.solve(A, Xd.T @ yd / len(yd))
    w_ = np.zeros(Xd.shape[1]); errs = [1.0]
    for _ in range(K):
        w_ = w_ - eta * (A @ w_ - Xd.T @ yd / len(yd)); errs.append(np.linalg.norm(w_ - bstar) / np.linalg.norm(bstar))
    return np.array(errs)

Xc_g = np.column_stack([np.ones(ng), xg - xg.mean()])
err_c = gd_run(Xc_g, yg, 160); k_c = int(np.argmax(err_c <= 1e-3))
kap_cg = gd_error_exact(Xc_g, yg, 0)[1]; bound_c = (1 - 1 / kap_cg) ** np.arange(161)
err_raw = gd_run(Xg, yg, 10_000)
lo, hi = 1, 10**9                                     # 원래 자료: 오차가 1e-3 이 되는 k 를 이분법으로
while lo < hi:
    mid = (lo + hi) // 2
    if gd_error_exact(Xg, yg, mid)[0] <= 1e-3: hi = mid
    else: lo = mid + 1
kap_r = gd_error_exact(Xg, yg, 0)[1]
# 연습 8.3: κ ≈ (1 + x̄² + s²)² / s²
s2x = xg.var(); kap_formula = (1 + xg.mean() ** 2 + s2x) ** 2 / s2x
print(f"중심화: {k_c}번에 1e-3;  원래: 1만 번 뒤에도 상대오차 {err_raw[-1]:.4f}, 1e-3 까지 {lo:,}번 (κ log 1000 = {kap_r * math.log(1000):,.0f});  κ 근사식 {kap_formula:.3g}")
report({"예제 8.2: 중심화하면 19번에 상대오차 1e-3": k_c == 19,
        "정리 8.1: 오차는 (1 − 1/κ)^k 이하 (기계 정밀도에 닿기 전까지)": np.all((err_c <= bound_c * (1 + 1e-9))[bound_c > 1e-11]),
        "예제 8.2: 원래 자료는 4,721만 번 (1만 번 뒤에도 오차가 거의 그대로)": round(lo / 1e4) == 4721 and err_raw[-1] > 0.99,
        "정리 8.1: 반복 수 ≈ κ log(1/ε)": abs(lo / (kap_r * math.log(1000)) - 1) < 0.01,
        "연습 8.3: κ ≈ (1 + x̄² + s²)²/s² = 6.8×10⁶": abs(kap_formula / kap_r - 1) < 0.01})
text
중심화: 19번에 1e-3;  원래: 1만 번 뒤에도 상대오차 0.9977, 1e-3 까지 47,207,431번 (κ log 1000 = 47,213,354);  κ 근사식 6.83e+06
  ✓  예제 8.2: 중심화하면 19번에 상대오차 1e-3
  ✓  정리 8.1: 오차는 (1 − 1/κ)^k 이하 (기계 정밀도에 닿기 전까지)
  ✓  예제 8.2: 원래 자료는 4,721만 번 (1만 번 뒤에도 오차가 거의 그대로)
  ✓  정리 8.1: 반복 수 ≈ κ log(1/ε)
  ✓  연습 8.3: κ ≈ (1 + x̄² + s²)²/s² = 6.8×10⁶
python
# 정리 8.3 · 연습 8.2: 모수가 관측보다 많을 때
def gd_lsq(Xd, yd, w0, K=20_000):
    eta = 1 / np.linalg.eigvalsh(Xd.T @ Xd).max(); w_ = w0.astype(float).copy()
    for _ in range(K):
        w_ = w_ - eta * Xd.T @ (Xd @ w_ - yd)
    return w_
Xs2 = np.array([[1, 0, 1], [0, 1, 1.0]]); ys2 = np.array([1, 1.0])
w_small = gd_lsq(Xs2, ys2, np.zeros(3))
Xp = rng.normal(size=(20, 50)); yp = rng.normal(size=20)
w0_ = gd_lsq(Xp, yp, np.zeros(50)); w1_ = gd_lsq(Xp, yp, rng.normal(size=50))
pinv_sol = np.linalg.pinv(Xp) @ yp
print(f"연습 8.2: {np.round(w_small, 6)};  p = 50 > n = 20: 원점에서 ‖w‖ = {np.linalg.norm(w0_):.4f} (pinv {np.linalg.norm(pinv_sol):.4f}), 무작위 출발 ‖w‖ = {np.linalg.norm(w1_):.4f}")
report({"연습 8.2: 원점에서 출발한 경사하강 → (1/3, 1/3, 2/3)": np.allclose(w_small, [1 / 3, 1 / 3, 2 / 3], atol=1e-9),
        "정리 8.3: 원점에서 출발하면 최소노름 해 X⁺y (잔차 0)": np.allclose(w0_, pinv_sol, atol=1e-8) and np.allclose(Xp @ w0_, yp, atol=1e-8),
        "정리 8.3: 다른 곳에서 출발하면 자료는 맞추지만 노름이 더 크다": np.allclose(Xp @ w1_, yp, atol=1e-8) and np.linalg.norm(w1_) > np.linalg.norm(w0_) + 0.1})
text
연습 8.2: [0.333333 0.333333 0.666667];  p = 50 > n = 20: 원점에서 ‖w‖ = 0.8484 (pinv 0.8484), 무작위 출발 ‖w‖ = 5.5488
  ✓  연습 8.2: 원점에서 출발한 경사하강 → (1/3, 1/3, 2/3)
  ✓  정리 8.3: 원점에서 출발하면 최소노름 해 X⁺y (잔차 0)
  ✓  정리 8.3: 다른 곳에서 출발하면 자료는 맞추지만 노름이 더 크다
python
# 정의 8.4 · 명제 8.5 · 정리 8.6 · 예제 8.7 · 연습 8.1: ridge
Xr = np.column_stack([x1 - x1.mean(), x2 - x2.mean()]); yr = ycol - ycol.mean()
Ur, dr, Vrt = np.linalg.svd(Xr, full_matrices=False)
ridge = lambda lam: np.linalg.solve(Xr.T @ Xr + lam * np.eye(2), Xr.T @ yr)
ridge_svd = lambda lam: Vrt.T @ (dr / (dr**2 + lam) * (Ur.T @ yr))
lam = 1.0
aug = np.linalg.lstsq(np.vstack([Xr, math.sqrt(lam) * np.eye(2)]), np.r_[yr, 0, 0], rcond=None)[0]
w_ = np.zeros(2); eta = 1 / (dr.max() ** 2 + lam)
for _ in range(200_000):
    w_ = (1 - eta * lam) * w_ - eta * Xr.T @ (Xr @ w_ - yr)
path = {l_: ridge(l_) for l_ in (0, 1, 10)}
# 정리 8.6: 이 설계에서 σ = 1, β = (1, 1) 일 때의 평균제곱오차
theta_ = Vrt @ np.array([1.0, 1.0])
M_ = lambda l_: np.sum((dr**2 + l_**2 * theta_**2) / (dr**2 + l_) ** 2)
lams = np.logspace(-3, 3, 6001); Ms = np.array([M_(l_) for l_ in lams]); lam_opt = lams[Ms.argmin()]
bound = 1 / np.max(theta_**2)
# 모의: 설계를 고정하고 y 만 다시
gs = np.random.default_rng(1970); Ysim = (Xr @ np.array([1.0, 1.0]))[None, :] + gs.standard_normal((20_000, 100)); Ysim -= Ysim.mean(1, keepdims=True)
mse_sim = lambda l_: np.mean(np.sum((Ysim @ (Xr @ np.linalg.inv(Xr.T @ Xr + l_ * np.eye(2))) - 1) ** 2, 1))
print(f"특이값 {np.round(dr, 3)};  λ = 0, 1, 10: {[np.round(v, 2).tolist() for v in path.values()]}")
print(f"MSE: 최소제곱 {M_(0):.2f} (모의 {mse_sim(0):.2f}), 최소 {Ms.min():.4f} (λ ≈ {lam_opt:.1f}, 모의 {mse_sim(lam_opt):.4f});  정리 8.6 의 상한 σ²/max θ² = {bound:.2f}")
report({"연습 8.1 (a): 덧붙인 자료의 최소제곱 = ridge": np.allclose(aug, ridge(lam)),
        "연습 8.1 (b): weight decay 경사하강의 고정점 = ridge": np.allclose(w_, ridge(lam), atol=1e-8),
        "명제 8.5: 특이값 분해의 식 = (X'X + λI)^{-1}X'y": all(np.allclose(ridge(l_), ridge_svd(l_)) for l_ in (0, 0.3, 5)),
        "예제 8.7: 특이값 13.56, 0.366; λ = 0, 1, 10 에서 (4.71, −2.87) → (1.36, 0.47) → (0.93, 0.82)":
            np.allclose(np.round(dr, 2), [13.56, 0.37]) and round(dr[1], 3) == 0.366 and np.allclose(np.round(path[1], 2), [1.36, 0.47]) and np.allclose(np.round(path[10], 2), [0.93, 0.82]),
        "예제 8.7: 작은 특이값의 방향 ≈ (1, −1)/√2": abs(abs(Vrt[1] @ np.array([1, -1]) / math.sqrt(2)) - 1) < 1e-3,
        "예제 8.7: 평균제곱오차 최소제곱 7.47, ridge 최소 0.010 (λ ≈ 7) — 모의와 일치":
            round(M_(0), 2) == 7.47 and round(Ms.min(), 3) == 0.010 and round(lam_opt) == 7 and abs(mse_sim(0) / M_(0) - 1) < 0.03 and abs(mse_sim(lam_opt) / Ms.min() - 1) < 0.05,
        "정리 8.6: 0 < λ < σ²/max θ_j² 이면 MSE(λ) < MSE(0)": all(M_(l_) < M_(0) for l_ in np.linspace(1e-4, bound, 50)[:-1])})
text
특이값 [13.563  0.366];  λ = 0, 1, 10: [[4.71, -2.87], [1.36, 0.47], [0.93, 0.82]]
MSE: 최소제곱 7.47 (모의 7.57), 최소 0.0104 (λ ≈ 7.1, 모의 0.0104);  정리 8.6 의 상한 σ²/max θ² = 0.50
  ✓  연습 8.1 (a): 덧붙인 자료의 최소제곱 = ridge
  ✓  연습 8.1 (b): weight decay 경사하강의 고정점 = ridge
  ✓  명제 8.5: 특이값 분해의 식 = (X'X + λI)^{-1}X'y
  ✓  예제 8.7: 특이값 13.56, 0.366; λ = 0, 1, 10 에서 (4.71, −2.87) → (1.36, 0.47) → (0.93, 0.82)
  ✓  예제 8.7: 작은 특이값의 방향 ≈ (1, −1)/√2
  ✓  예제 8.7: 평균제곱오차 최소제곱 7.47, ridge 최소 0.010 (λ ≈ 7) — 모의와 일치
  ✓  정리 8.6: 0 < λ < σ²/max θ_j² 이면 MSE(λ) < MSE(0)
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
axes[0].semilogy(np.maximum(err_raw[:161], 1e-17), color=C["assume"], label=f"raw (κ = {kap_r:.2g})")
axes[0].semilogy(np.maximum(err_c, 1e-17), color=C["stat"], label="centered (κ = 3.19)")
axes[0].semilogy(bound_c, **THEORY, label=r"$(1-1/\kappa)^k$")
axes[0].set_ylim(1e-17, 3); axes[0].set_xlabel("iteration"); axes[0].legend(); axes[0].set_title("gradient descent on Galton")
ll_ = np.logspace(-3, 3, 200); P_ = np.array([ridge(l_) for l_ in ll_])
axes[1].semilogx(ll_, P_[:, 0], color=C["stat"], label=r"$\hat\beta_1$"); axes[1].semilogx(ll_, P_[:, 1], color=C["data"], label=r"$\hat\beta_2$")
axes[1].semilogx(ll_, P_.sum(1), color=C["key"], ls="--", label="sum"); axes[1].axhline(1, color=C["hist"], ls=":")
ax2 = axes[1].twinx(); ax2.semilogx(lams, Ms, color=C["theta"], lw=1); ax2.set_yscale("log"); ax2.set_ylabel("MSE", color=C["theta"]); ax2.grid(False)
axes[1].legend(loc="center left"); axes[1].set_title("ridge path (left axis) and its MSE (right)")
plt.tight_layout(); plt.show()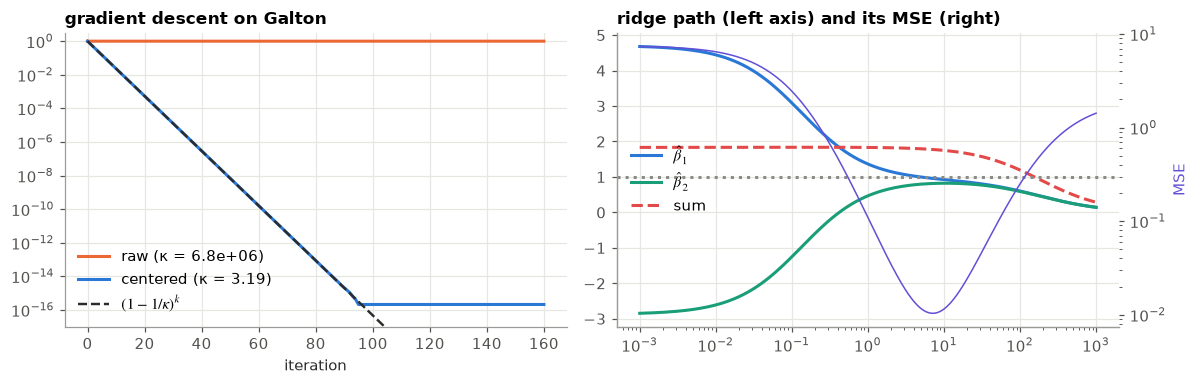
그림 읽기. 왼쪽: 원래의 부모 키로 경사하강을 하면 첫 걸음에 큰 고유값 방향의 오차가 사라지고, 나머지는 의 비율로 줄어 160번 동안 눈에 띄게 움직이지 않는다. 평균을 빼면 같은 문제가 100번쯤에 끝난다. 오른쪽: 가 커지면 두 계수가 1 근처로 모이고(합은 거의 그대로), 평균제곱오차(보라)는 에서 최소제곱의 700분의 1이 된다. 치우침을 조금 받아들이면 분산이 크게 준다. Gauss–Markov 정리는 불편추정량 안에서만 최선이다.
📝 연습 8.1–8.3 (강의노트): 덧붙인 자료, 두 점과 세 모수, 조건수와 중심화.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 결합의 문제 (1.1–1.8) | Mayer의 묶음 합과 해 (), , 2925가지 선택, Boscovich의 가중 중앙값 = 선형계획법, 편평률 1/246·1/235·1/213, 최소절댓값이 지나는 관측 | 1절 |
| 사영 (2.1–2.9) | OLS (QR = 정규방정식), 의 성질, 지렛대, , 조건수 대 3.19, 10차 다항식 |
2절 |
| Gauss–Markov (3.1–3.7) | 정규·균등 오차의 적률, Mayer의 손실 1.28·1.15·2.08, 무작위 선형불편추정량 2000개, MLE, Pearson–Lee 가중 최소제곱 | 3절 |
| 분포 (4.1–4.10) | 판정, , Craig·Cochran, ·, ·예측구간, 제약 최소제곱과 = 가능도비, Wilks의 6.7% | 4절 |
| 회귀 (5.1–5.6) | 두 회귀선, 최선의 선형예측, 회귀의 오류, FWL (12자리), , 누락변수의 항등식 | 5절 |
| 요약표 (6.1–6.4) | Galton의 모든 숫자 (linregress 대조), Mayer의 세 방법과 , 토성 |
6절 |
| 부숴보기 (7) | 샌드위치 88% → 94–95%, 한 점 빼기, Anscombe, VIF 344, Berkeley | 7절 |
| 오늘 (8) | 경사하강 19번 대 4,721만 번, 최소노름 해, ridge = weight decay, MSE 7.47 → 0.010 | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 결합의 문제 | 1.1 Mayer의 해 ★ · 1.2 ★ · 1.3 위치모형 ★ · 1.4 선형계획법 ★★ · 1.5 세 방정식 ★★ | 1절 |
| 2 사영 | 2.1 ★ · 2.2 ★ · 2.3 지렛대 ★ · 2.4 단위 ★ · 2.5 ★ · 2.6 Gram–Schmidt ★★ · 2.7 대칭 멱등 ★★ · 2.8 hat 행렬 ★★ · 2.9 지렛대의 성질 ★★ (유도형) | 2절 |
| 3 Gauss–Markov | 3.1 ★ · 3.2 ★ · 3.3 ★ · 3.4 Mayer의 분산 ★★ · 3.5 축소 ★★ · 3.6 일반화 최소제곱 ★★ (유도형) | 3절 |
| 4 분포 | 4.1 ★ · 4.2 ★ · 4.3 ★★ · 4.4 ★ · 4.5 ★ · 4.6 Wilks ★★ | 4절 |
| 5 회귀 | 5.1 ★ · 5.2 회귀의 오류 ★★ · 5.3 ★★ · 5.4 누락변수 ★★ · 5.5 VIF ★★ (유도형) | 5절 |
| 6 요약표 | 6.1 ★ · 6.2 델타 방법 ★★ · 6.3 AIC ★ | 6절 |
| 7 부숴보기 | 7.1 ★★ · 7.2 ★ · 7.3 공선성 ★★ · 7.4 두 학과 ★★ · 7.5 한 점 빼기 ★★ (유도형) | 7절 |
| 8 오늘 | 8.1 ★ · 8.2 최소노름 ★★ · 8.3 조건수 ★★ | 8절 |
다음 회 (14회) — 분산분석과 실험설계 (1885 → 1954). 이번 회차의 설계행렬은 주어진 것이었다. 14회는 그것을 고른다. Rothamsted의 Fisher는 처치를 밭에 무작위로 배치해 그 효과를 땅과 날씨의 차이에서 떼어 냈다. 분산분석표는 이번 회차의 Cochran 정리에 사영을 더 그린 것이고, 무작위화는 7절의 Yule–Simpson 역설을 설계 단계에서 없앤다.
10. 워크북 검산
워크북(13_least_squares_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "3/5")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/5,0.6)나 식의 문자열("sqrt(5)")로 넣는다. 소문항은"A1a"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 이 곱해진 분산(A7, D3)은 의 계수만 넣는다. 분포의 꼬리(A10, D2, D4)는 계산기로 구한 소수를 넣는다.
- 시뮬레이션으로 한 번 더 — 분포에서 나오는 답은 아래에 시뮬레이션 함수를 정의해 두었다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A1a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A1d A2a A2b A3a A3b A4a A4b A4c A5 A6a A6b A7a A7b A7c A8 A9a A9b A9c A10a A10b A11 A12a A12b A13a A13b A14a A14b C3a C3b D1d D1e D2a D2b D2c D3a D3b D3c D3d D4c D4d
A1a: 아직 답을 넣지 않았다. 예: check('A1a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A1d": None, "A2a": None, "A2b": None,
    "A3a": None, "A3b": None, "A4a": None, "A4b": None, "A4c": None, "A5": None,
    "A6a": None, "A6b": None, "A7a": None, "A7b": None, "A7c": None, "A8": None,
    "A9a": None, "A9b": None, "A9c": None, "A10a": None, "A10b": None, "A11": None,
    "A12a": None, "A12b": None, "A13a": None, "A13b": None, "A14a": None, "A14b": None,
    "C3a": None, "C3b": None,
    "D1d": None, "D1e": None, "D2a": None, "D2b": None, "D2c": None,
    "D3a": None, "D3b": None, "D3c": None, "D3d": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다(D3은 세 쌍). 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A6() |
A6 RSS의 평균과 분산 | , , 인 정규 선형모형을 되풀이해 맞춘다 |
sim_A10() |
A10 의 꼬리 | 독립인 의 비 |
sim_D2() |
D2 절편 검정의 유의확률 | A1의 설계에서 인 자료를 만들어 를 계산 |
sim_D3() |
D3 세 추정량의 분산 | , |
sim_D4() |
D4 두 표본 의 유의확률 | 인 두 집단 |
python
def _mean_se(v, batches=20):
    """배치 평균으로 구한 (평균, 표준오차)"""
    b = np.asarray(v).reshape(batches, -1).mean(axis=1)
    return b.mean(), b.std(ddof=1) / math.sqrt(batches)


def sim_A6(reps=40_000):
    X = np.c_[np.ones(20), rng.normal(size=(20, 3))]
    M = np.eye(20) - X @ np.linalg.solve(X.T @ X, X.T)
    eps = rng.normal(scale=math.sqrt(2), size=(reps, 20))
    rss = np.einsum("ri,ij,rj->r", eps, M, eps)
    batch_var = rss.reshape(20, -1).var(axis=1, ddof=1)
    return _mean_se(rss), (batch_var.mean(), batch_var.std(ddof=1) / math.sqrt(20))


def sim_A10(reps=400_000):
    f = (rng.chisquare(2, reps) / 2) / (rng.chisquare(25, reps) / 25)
    return _mean_se(f > 3.125)


def sim_D2(reps=200_000):
    x = np.array([1, 2, 3, 4, 5.])
    X, X0 = np.c_[np.ones(5), x], x[:, None]
    M, M0 = (np.eye(5) - X @ np.linalg.pinv(X)), (np.eye(5) - X0 @ np.linalg.pinv(X0))
    y = 0.7 * x + rng.normal(size=(reps, 5))           # H0: 절편 0
    rss = np.einsum("ri,ij,rj->r", y, M, y)
    rss0 = np.einsum("ri,ij,rj->r", y, M0, y)
    return _mean_se((rss0 - rss) / (rss / 3) > 5.5)


def sim_D3(reps=200_000):
    x = np.arange(1, 11.)
    y = 2.0 * x + rng.normal(size=(reps, 10))
    ests = [(y @ x) / (x @ x), y.sum(axis=1) / x.sum(), (y / x).mean(axis=1)]
    out = []
    for e in ests:
        bv = e.reshape(20, -1).var(axis=1, ddof=1)
        out.append((bv.mean(), bv.std(ddof=1) / math.sqrt(20)))
    return out


def sim_D4(reps=200_000):
    g = rng.normal(size=(reps, 7))                      # μ1 = μ2 = 0, σ = 1
    m1, m2 = g[:, :3].mean(axis=1), g[:, 3:].mean(axis=1)
    sse = ((g[:, :3] - m1[:, None]) ** 2).sum(axis=1) + ((g[:, 3:] - m2[:, None]) ** 2).sum(axis=1)
    F = (m1 - m2) ** 2 / (1 / 3 + 1 / 4) / (sse / 5)
    return _mean_se(F > 240 / 49)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0):
    est, se = sim
    return abs(est - _value(key)) <= z * se + 1e-12

_a6m, _a6v = sim_A6()
assert _close(_a6m, "A6a") and _close(_a6v, "A6b")
assert _close(sim_A10(), "A10b")
assert _close(sim_D2(), "D2c")
for _s, _k in zip(sim_D3(), ["D3a", "D3b", "D3c"]):
    assert _close(_s, _k)
assert _close(sim_D4(), "D4d")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))