Skip to content

13회 · 최소제곱 · 노트

3 Gauss–Markov 정리 ​

역사 Gauss의 첫 정당화(1809)는 순환논법이었다. 그는 평균이 가장 그럴듯한 값이 되는 오차분포가 정규임을 보였고(5회 정리 1.5), 정규 오차를 가정하면 최소제곱이 가장 그럴듯한 값을 준다고 결론지었다. 이듬해 Laplace의 중심극한정리가 오차가 작은 원인들의 합이면 정규라는 근거를 댔다. 그러나 Gauss는 만족하지 않았다. 1821–1823년의 오차가 가장 작은 관측의 결합 이론에서 그는 정규분포를 버렸다. 오차의 평균이 0이고 분산이 같기만 하면, 최소제곱이 모든 선형불편 결합 가운데 분산이 가장 작다는 것을 증명한 것이다. 1900년 Markov가 교과서에서 이 증명을 다시 썼고, Neyman(1934)이 그것을 “Markov의 정리”라 부르면서 오늘의 이름이 굳었다. Aitken(1935)은 이 정리를 행렬로 쓰고 상관된 오차로 넓혔다.

3.1 최소제곱추정량의 적률 ​

보조정리 3.1 (이차형식의 기댓값) 확률벡터 u\bu의 평균이 μ\bmu, 공분산이 Σ\Sigma이고 AA가 상수 행렬이면 E u′Au=tr⁡(AΣ)+μ′AμE\,\bu\T A\bu=\tr(A\Sigma)+\bmu\T A\bmu이다.

증명 u′Au\bu\T A\bu는 1×11\times1이므로 자기 대각합이고 tr⁡(u′Au)=tr⁡(Auu′)\tr(\bu\T A\bu)=\tr(A\bu\bu\T)이다. 대각합과 기댓값은 바꿀 수 있고 Euu′=Σ+μμ′E\bu\bu\T=\Sigma+\bmu\bmu\T이므로 E u′Au=tr⁡(AΣ)+tr⁡(Aμμ′)=tr⁡(AΣ)+μ′AμE\,\bu\T A\bu=\tr(A\Sigma)+\tr(A\bmu\bmu\T)=\tr(A\Sigma)+\bmu\T A\bmu.

정리 3.2 (최소제곱추정량의 적률) 정의 1.1의 모형에서

  1. (a)

    Eβ^=βE\bhat=\bbeta, Cov⁡β^=σ2(X′X)−1\Cov\bhat=\sigma^2(X\T X)^{-1}.

  2. (b)

    Ee=0E\e=\bzero, Cov⁡e=σ2(I−H)\Cov\e=\sigma^2(I-H), 그리고 β^\bhat과 e\e는 무상관이다.

  3. (c)

    E RSS=(n−p)σ2E\,\mathrm{RSS}=(n-p)\sigma^2이다. 따라서 s2=RSS/(n−p)s^2=\mathrm{RSS}/(n-p)는 σ2\sigma^2의 불편추정량이다.

증명 전략 β^−β\bhat-\bbeta와 e\e를 오차 ε\beps의 선형변환으로 쓰고 선형변환의 평균·공분산 공식(5회 보조정리 3.1)을 쓴다. RSS\mathrm{RSS}는 ε\beps의 이차형식이므로 보조정리 3.1를 쓴다.

  1. L=(X′X)−1X′L=(X\T X)^{-1}X\T로 두면 β^=L(Xβ+ε)=β+Lε\bhat=L(X\bbeta+\beps)=\bbeta+L\beps이다.정리 2.2(c), LX=ILX=I

  2. Eβ^=βE\bhat=\bbeta이고 Cov⁡β^=L(σ2I)L′=σ2(X′X)−1\Cov\bhat=L(\sigma^2I)L\T=\sigma^2(X\T X)^{-1}이다.5회 보조정리 3.1, LL′=(X′X)−1LL\T=(X\T X)^{-1}

  3. e=(I−H)y=(I−H)ε\e=(I-H)\y=(I-H)\beps이다.(I−H)X=0(I-H)X=0, 정리 2.5(a)

  4. Ee=0E\e=\bzero이고 Cov⁡e=σ2(I−H)(I−H)′=σ2(I−H)\Cov\e=\sigma^2(I-H)(I-H)\T=\sigma^2(I-H)이다.5회 보조정리 3.1, I−HI-H 대칭 멱등

  5. Cov⁡(β^,e)=L(σ2I)(I−H)′=σ2(X′X)−1(X′−X′H)=0\Cov(\bhat,\allowbreak \e)=L(\sigma^2I)(I-H)\T=\sigma^2(X\T X)^{-1}(X\T-X\T H)=0이다.X′H=(HX)′=X′X\T H=(HX)\T=X\T

  6. RSS=e′e=ε′(I−H)ε\mathrm{RSS}=\e\T\e=\beps\T(I-H)\beps이다.3, I−HI-H 대칭 멱등

  7. E RSS=σ2tr⁡(I−H)=σ2(n−p)E\,\mathrm{RSS}=\sigma^2\tr(I-H)=\sigma^2(n-p)이다.보조정리 3.1, 정리 2.5(c)

p=1p=1, X=1X=\one이면 (c)는 6회 정리 1.1의 “n−1n-1로 나누기”다. 일반적으로 n−pn-p는 잔차가 사는 공간 col⁡(X)⊥\col(X)^\perp의 차원이다. 모수 pp개를 맞추면서 잔차가 움직일 수 있는 방향 pp개를 썼다.

3.2 최선의 선형불편추정량 ​

정리 3.3 (Gauss–Markov) 정의 1.1의 모형에서 β~=Ay\btil=A\y를 아무 선형불편추정량이라 하고 A0=(X′X)−1X′A_0=(X\T X)^{-1}X\T, D=A−A0D=A-A_0이라 하자. 그러면

Cov⁡β~−Cov⁡β^=σ2DD′ ⪰ 0.\Cov\btil-\Cov\bhat=\sigma^2DD\T\ \succeq\ 0 .

따라서 모든 c∈Rp\bc\in\R^p에 대해 Var⁡(c′β~)≥Var⁡(c′β^)\Var(\bc\T\btil)\ge\Var(\bc\T\bhat)이다. 최소제곱추정량은 최선의 선형불편추정량(BLUE)이다.

증명 전략 아무 선형불편추정량의 계수행렬 AA를 최소제곱의 A0A_0와 그 차 DD로 나눈다. 불편성에서 DX=0DX=0이 나오고, 그러면 공분산이 피타고라스처럼 두 조각의 합으로 갈라진다.

  1. AX=IAX=I이고 A0X=IA_0X=I이므로 DX=0DX=0이다.명제 1.4

  2. DA0′=DX(X′X)−1=0DA_0\T=DX(X\T X)^{-1}=0이고 A0D′=(DA0′)′=0A_0D\T=(DA_0\T)\T=0이다.1

  3. 공분산을 전개한다.

    Cov⁡β~=σ2AA′=σ2(A0+D)(A0+D)′=σ2(A0A0′+DD′)=Cov⁡β^+σ2DD′\begin{align*} \Cov\btil&=\sigma^2AA\T=\sigma^2(A_0+D)(A_0+D)\T \tag*{\htmlClass{reason}{\text{5회 보조정리 3.1}}}\\ &=\sigma^2\bigl(A_0A_0\T+DD\T\bigr) \tag*{\htmlClass{reason}{\text{\htmlClass{sref}{\text{2}}로 교차항 0}}}\\ &=\Cov\bhat+\sigma^2DD\T \tag*{\htmlClass{reason}{\text{$A_0A_0\T=(X\T X)^{-1}$, 정리~\href{/read/13/3#thm-lsmoments}{3.2}(a)}}} \end{align*}
  4. c′DD′c=∥D′c∥2≥0\bc\T DD\T\bc=\|D\T\bc\|^2\ge0이므로 σ2DD′⪰0\sigma^2DD\T\succeq0이고 Var⁡(c′β~)−Var⁡(c′β^)=σ2∥D′c∥2≥0\Var(\bc\T\btil)-\Var(\bc\T\bhat)=\sigma^2\|D\T\bc\|^2\ge0이다.준정치의 정의 [T4]

증명은 2절의 피타고라스를 추정량의 공간에서 한 번 더 쓴 것이다. 아무 선형불편추정량은 최소제곱추정량에 그것과 “직교하는” 잡음 DyD\y를 더한 것이다.

따름정리 3.4 (BLUE의 여러 얼굴) 선형불편추정량 β~\btil에 대해

  1. (a)

    성분마다 Var⁡β~j≥Var⁡β^j\Var\tilde\beta_j\ge\Var\hat\beta_j이고, det⁡Cov⁡β~≥det⁡Cov⁡β^\det\Cov\btil\ge\det\Cov\bhat, tr⁡Cov⁡β~≥tr⁡Cov⁡β^\tr\Cov\btil\ge\tr\Cov\bhat이다.

  2. (b)

    Var⁡(c′β~)=Var⁡(c′β^)\Var(\bc\T\btil)=\Var(\bc\T\bhat)이면 c′β~=c′β^\bc\T\btil=\bc\T\bhat이다. 곧 c′β\bc\T\bbeta의 BLUE는 하나뿐이다.

증명 (a) 성분은 c=ej\bc=\mathbf e_j로 둔 경우다. B=Cov⁡β^≻0B=\Cov\bhat\succ0, A=Cov⁡β~⪰BA=\Cov\btil\succeq B이면 B−1/2AB−1/2⪰IB^{-1/2}AB^{-1/2}\succeq I이므로 그 고유값이 모두 1 이상이고, det⁡A/det⁡B=det⁡(B−1/2AB−1/2)≥1\det A/\det B=\det(B^{-1/2}AB^{-1/2})\ge1이다. 대각합은 성분의 합이다. (b) 차이가 σ2∥D′c∥2=0\sigma^2\|D\T\bc\|^2=0이면 c′D=0′\bc\T D=\bzero\T이고 c′β~=c′(A0+D)y=c′β^\bc\T\btil=\bc\T(A_0+D)\y=\bc\T\bhat이다.

예제 3.5 (Mayer는 얼마나 잃었나) Mayer의 묶음 추정량은 A=(G′X)−1G′A=(G\T X)^{-1}G\T인 선형불편추정량이다(예제 1.5). 공분산 σ2AA′\sigma^2AA\T와 σ2(X′X)−1\sigma^2(X\T X)^{-1}의 대각원소의 비는 (β,α,γ)(\beta,\alpha,\gamma) 순으로

1.28,1.15,2.081.28,\qquad 1.15,\qquad 2.08

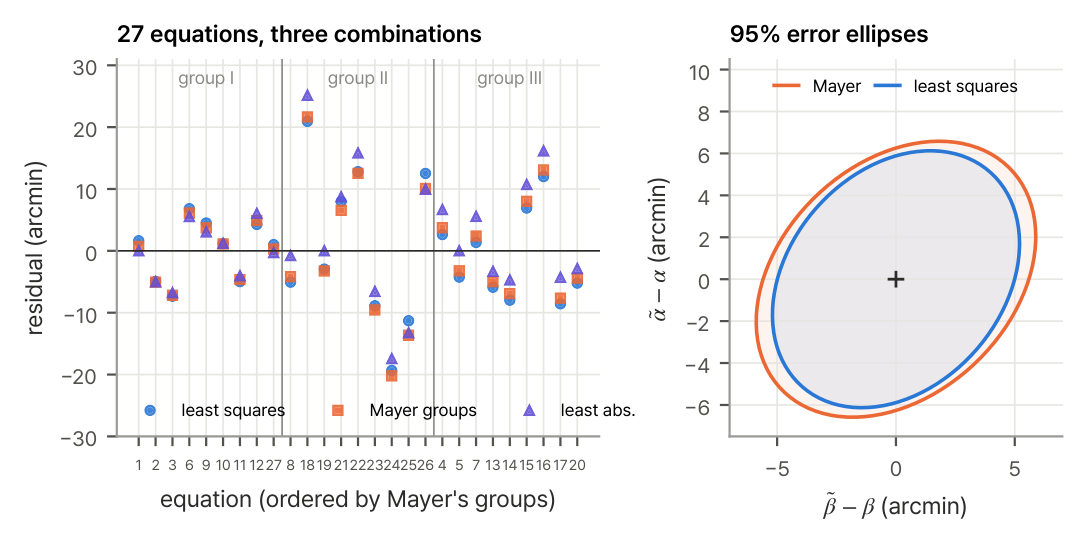
이고 행렬식의 비는 2.37이다. 비는 σ2\sigma^2과 무관하므로 자료 없이 설계만으로 정해진다. β\beta를 최소제곱만큼 정확히 정하려면 Mayer의 방법으로는 관측이 28% 더 필요했고, γ\gamma(곧 θ\theta)에는 두 배가 넘게 필요했다. 그림 3.1의 오른쪽이 이것을 신뢰타원으로 보여 준다. 최소제곱의 타원은 Mayer의 타원 안에 들어간다. Cov⁡β~⪰Cov⁡β^\Cov\btil\succeq\Cov\bhat의 그림이 그것이다.

그림 3.1. Mayer의 27개 방정식. 왼쪽: 세 방법의 잔차. 최소제곱(파랑)은 큰 잔차를 줄이고, 최소절댓값(보라)은 세 방정식에서 잔차가 정확히 0이다. 묶음 평균(주황)은 최소제곱과 비슷하다. 오른쪽: 추정 오차 (tildeβ-β,tildeα-α)의 95% 타원(각의 분, σ는 최소제곱의 s로 둠). 최소제곱의 타원이 May
그림 3.1 Mayer의 27개 방정식. 왼쪽: 세 방법의 잔차. 최소제곱(파랑)은 큰 잔차를 줄이고, 최소절댓값(보라)은 세 방정식에서 잔차가 정확히 0이다. 묶음 평균(주황)은 최소제곱과 비슷하다. 오른쪽: 추정 오차 (β~−β, α~−α)(\tilde\beta-\beta,\allowbreak \ \tilde\alpha-\alpha)의 95% 타원(각의 분, σ\sigma는 최소제곱의 ss로 둠). 최소제곱의 타원이 Mayer의 타원 안에 있다. 정리 3.3의 Cov⁡β~⪰Cov⁡β^\Cov\btil\succeq\Cov\bhat를 그린 것이다.

가정 주의 Gauss–Markov 정리의 “최선”은 선형이고 불편인 추정량 가운데서다. (1) 비선형 추정량은 이길 수 있다. 오차가 Laplace 분포 12e−∣u∣\tfrac12e^{-|u|}이면 위치모형에서 중앙값의 점근분산은 1/(4f(0)2n)=1/n1/(4f(0)^2n)=1/n으로(8회 정리 1.4), 평균의 분산 2/n2/n의 절반이다. 최소절댓값 추정은 선형이 아니다. (2) 치우친 추정량은 평균제곱오차에서 이길 수 있다. 8절의 ridge와 16회의 Stein 추정량이 그렇다. (3) 등분산과 무상관이 깨지면 최소제곱은 더 이상 최선이 아니다(따름정리 3.7).

3.3 정규 오차라면: 모든 불편추정량 가운데 최선 ​

정리 3.6 (정규 선형모형) y∼Nn(Xβ,σ2I)\y\sim\N_n(X\bbeta,\sigma^2I), rank⁡X=p\rank X=p라 하자.

  1. (a)

    β\bbeta의 MLE는 β^\bhat이고 σ2\sigma^2의 MLE는 RSS/n\mathrm{RSS}/n이다.

  2. (b)

    (X′y, y′y)(X\T\y,\ \y\T\y)는 (β,σ2)(\bbeta,\sigma^2)의 완비충분통계량이다.

  3. (c)

    β^\bhat과 s2s^2은 모든 불편추정량 가운데 분산이 가장 작다(UMVUE). c′β^\bc\T\bhat도 c′β\bc\T\bbeta의 UMVUE이다.

증명 (a) 로그가능도는 ℓ(β,σ2)=−n2log⁡(2πσ2)−12σ2∥y−Xβ∥2\ell(\bbeta,\allowbreak \sigma^2)=-\tfrac n2\log(2\pi\sigma^2)-\tfrac1{2\sigma^2}\|\y-X\bbeta\|^2이다. σ2\sigma^2이 무엇이든 β\bbeta에 대한 최대는 ∥y−Xβ∥2\|\y-X\bbeta\|^2의 최소, 곧 β^\bhat이다. 그 다음 −n2log⁡σ2−RSS/(2σ2)-\tfrac n2\log\sigma^2-\mathrm{RSS}/(2\sigma^2)을 σ2\sigma^2에 대해 최대로 하면 RSS/n\mathrm{RSS}/n이다.

(b) 밀도를 펼치면

f(y)=exp⁡{(βσ2)′X′y−12σ2 y′y−∥Xβ∥22σ2−n2log⁡(2πσ2)}f(\y)=\exp\Bigl\{\Bigl(\frac{\bbeta}{\sigma^2}\Bigr)\T X\T\y-\frac1{2\sigma^2}\,\y\T\y-\frac{\|X\bbeta\|^2}{2\sigma^2}-\frac n2\log(2\pi\sigma^2)\Bigr\}

이다. 자연모수 (β/σ2, −1/(2σ2))(\bbeta/\sigma^2,\allowbreak \ -1/(2\sigma^2))는 Rp×(−∞,0)\R^p\times(-\infty,0), 곧 Rp+1\R^{p+1}의 열린 집합 전체를 움직이고 자연통계량은 (X′y,y′y)(X\T\y,\y\T\y)이다. 11회 정리 4.5로 완비충분이다.

(c) β^=(X′X)−1X′y\bhat=(X\T X)^{-1}X\T\y와 RSS=y′y−(X′y)′(X′X)−1(X′y)\mathrm{RSS}=\y\T\y-(X\T\y)\T(X\T X)^{-1}(X\T\y)는 이 통계량의 함수이고, 정리 3.2로 β^\bhat과 s2s^2은 불편이다. Lehmann–Scheffé(11회 정리 3.3)로 UMVUE다.

정규 오차에서 최소제곱은 MLE이고, 선형이든 아니든 불편추정량 가운데 최선이다. Gauss의 1809년 논리(정규 ⇒\Rightarrow 최소제곱)와 1823년 논리(정규가 아니어도 선형 가운데 최선)가 이렇게 만난다.

3.4 상관된 오차: 일반화 최소제곱 ​

따름정리 3.7 (Aitken의 일반화 최소제곱 (1935)) Cov⁡ε=σ2V\Cov\beps=\sigma^2V이고 VV가 알려진 양정치 행렬이면

β^GLS=(X′V−1X)−1X′V−1y,Cov⁡β^GLS=σ2(X′V−1X)−1\bhat_{\mathrm{GLS}}=(X\T V^{-1}X)^{-1}X\T V^{-1}\y,\qquad \Cov\bhat_{\mathrm{GLS}}=\sigma^2(X\T V^{-1}X)^{-1}

가 BLUE이다. 보통의 최소제곱은 여전히 불편이지만 공분산은 σ2(X′X)−1X′VX(X′X)−1\sigma^2(X\T X)^{-1}X\T VX(X\T X)^{-1}이고, 이는 Cov⁡β^GLS\Cov\bhat_{\mathrm{GLS}} 이상이다.

증명 전략 V−1/2V^{-1/2}를 곱해 오차의 공분산을 σ2I\sigma^2I로 바꾼 모형에 정리 3.3를 쓴다. 두 모형의 선형불편추정량이 같은 모임임을 확인하면 비교 대상이 같다. 단계별 증명은 연습 3.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

가중 최소제곱은 VV가 대각인 경우다. yiy_i가 mim_i개 관측의 평균이면 Var⁡yi=σ2/mi\Var y_i=\sigma^2/m_i이므로 무게 mim_i로 제곱합 ∑mi(yi−xi′b)2\sum m_i(y_i-\x_i\T\bb)^2을 최소로 한다. Pearson–Lee의 도수표(5절)는 이렇게 맞춘다. 무게가 틀리면(이분산을 모르고 무시하면) 공분산의 공식이 틀린다. 7절의 주제다.

연습문제

연습 3.1 (단순회귀의 분산 ★) 단순회귀에서 Var⁡b^1=σ2/Sxx\Var\hat b_1=\sigma^2/S_{xx}, Var⁡b^0=σ2(1n+xˉ2Sxx)\Var\hat b_0=\sigma^2\bigl(\tfrac1n+\tfrac{\bar x^2}{S_{xx}}\bigr), Cov⁡(b^0,b^1)=−σ2xˉ/Sxx\Cov(\hat b_0,\allowbreak \hat b_1)=-\sigma^2\bar x/S_{xx}임을 정리 3.2로 보여라. xˉ\bar x가 0에서 멀면 b^0\hat b_0과 b^1\hat b_1은 어떻게 상관되는가?

풀이

X′X=(n∑xi∑xi∑xi2)X\T X=\smat{n&\sum x_i\\ \sum x_i&\sum x_i^2}의 행렬식은 nSxxnS_{xx}이므로 (X′X)−1=1nSxx(∑xi2−∑xi−∑xin)(X\T X)^{-1}=\tfrac1{nS_{xx}}\smat{\sum x_i^2&-\sum x_i\\ -\sum x_i&n}. ∑xi2=Sxx+nxˉ2\sum x_i^2=S_{xx}+n\bar x^2을 쓰면 세 식이 나온다. 상관은 −xˉ/xˉ2+Sxx/n-\bar x/\sqrt{\bar x^2+S_{xx}/n}이고, xˉ\bar x가 0에서 멀면 −1-1(또는 +1+1)에 가깝다. 절편은 자료에서 먼 x=0x=0에서의 외삽이어서 기울기와 강하게 얽힌다. 중심화하면 상관이 0이 된다.

연습 3.2 (평균은 BLUE ★) yi=μ+εiy_i=\mu+\varepsilon_i에서 선형불편추정량 ∑wiyi\sum w_iy_i의 조건이 ∑wi=1\sum w_i=1임을 보이고, 그 가운데 분산이 가장 작은 것이 yˉ\bar y임을 직접(라그랑주 승수 없이) 보여라.

풀이

E∑wiyi=μ∑wiE\sum w_iy_i=\mu\sum w_i이므로 불편   ⟺  ∑wi=1\iff\sum w_i=1. Var⁡=σ2∑wi2\Var=\sigma^2\sum w_i^2이고 ∑wi2=∑(wi−1n)2+2n∑wi−1n=∑(wi−1n)2+1n≥1n\sum w_i^2=\sum(w_i-\tfrac1n)^2+\tfrac2n\sum w_i-\tfrac1n=\sum(w_i-\tfrac1n)^2+\tfrac1n\ge\tfrac1n. 등호는 wi=1/nw_i=1/n일 때뿐이다.

연습 3.3 (묶음의 평균 ★) 한 양 μ\mu를 kk개 실험실이 쟀다. 실험실 jj는 mjm_j번 재서 평균 yˉj\bar y_j를 보고한다(각 측정의 분산 σ2\sigma^2, 모두 독립). 따름정리 3.7로 μ\mu의 BLUE가 ∑mjyˉj/∑mj\sum m_j\bar y_j/\sum m_j임을 보이고, 이것이 모든 원래 측정의 평균임을 확인하라.

풀이

yˉj=μ+εˉj\bar y_j=\mu+\bar\varepsilon_j, Var⁡εˉj=σ2/mj\Var\bar\varepsilon_j=\sigma^2/m_j이므로 V=diag⁡(1/m1,…,1/mk)V=\diag(1/m_1,\dots,1/m_k), X=1X=\one이다. 따름정리 3.7로 μ^=(1′V−11)−11′V−1yˉ=∑mjyˉj/∑mj\hat\mu=(\one\T V^{-1}\one)^{-1}\one\T V^{-1}\bar\y=\sum m_j\bar y_j/\sum m_j. 분자는 모든 측정의 합이므로 전체 평균이다.

연습 3.4 (Mayer의 분산 ★★) 예제 3.5의 비 1.28, 1.15, 2.08과 2.37을 계산하라(노트북). 왜 γ\gamma의 손실이 가장 큰가? 묶음 III의 γ\gamma 계수(7.9649)와 나머지 두 묶음의 γ\gamma 계수를 보고 설명하라.

풀이

A=(G′X)−1G′A=(G\T X)^{-1}G\T로 AA′AA\T를 계산해 (X′X)−1(X\T X)^{-1}과 대각원소를 비교한다(노트북). 묶음 합은 각 묶음 안에서 xi3x_{i3}의 차이를 버린다. 묶음 I의 xi3x_{i3}은 −0.47-0.47에서 0.460.46까지 퍼져 있지만 합은 −0.79-0.79이고, 묶음 II도 −0.91-0.91에서 0.940.94까지 퍼져 있지만 합은 1.741.74이다. γ\gamma에 대한 정보는 묶음 III의 큰 합(7.96)에만 남는다. 최소제곱은 각 방정식의 xi3x_{i3}을 따로 쓰므로 묶음 안의 퍼짐까지 정보로 쓴다. α\alpha의 계수는 Mayer가 묶음을 그것으로 나눴으므로 정보가 덜 버려졌다.

연습 3.5 (치우친 추정량이 이길 때 ★★) yi=μ+εiy_i=\mu+\varepsilon_i, εi∼iidN(0,σ2)\varepsilon_i\iid\N(0,\allowbreak \sigma^2)에서 cyˉc\bar y (0<c<10<c<1)의 평균제곱오차가 c2σ2/n+(1−c)2μ2c^2\sigma^2/n+(1-c)^2\mu^2임을 보여라. 이를 최소로 하는 cc를 구하고, 그때의 평균제곱오차가 yˉ\bar y의 것보다 작음을 보여라. 이 cc를 실제로 쓸 수 없는 이유는 무엇인가? (16회 Stein의 예고다.)

풀이

Ecyˉ=cμE c\bar y=c\mu, Var⁡cyˉ=c2σ2/n\Var c\bar y=c^2\sigma^2/n이므로 평균제곱오차는 c2σ2/n+(1−c)2μ2c^2\sigma^2/n+(1-c)^2\mu^2. cc로 미분해 0으로 두면 c∗=μ2/(μ2+σ2/n)c^*=\mu^2/(\mu^2+\sigma^2/n)이고, 그때의 값은 σ2n⋅μ2μ2+σ2/n<σ2n\tfrac{\sigma^2}n\cdot\tfrac{\mu^2}{\mu^2+\sigma^2/n}<\tfrac{\sigma^2}n이다. c∗c^*가 모르는 μ\mu에 의존하므로 그대로는 쓸 수 없다.

연습 3.6 (일반화 최소제곱 ★★ 유도형) 따름정리 3.7를 다음 순서로 증명하라.

  1. (a)

    양정치 VV의 제곱근 V1/2V^{1/2}(5회 보조정리 3.2)로 y∗=V−1/2y\y^*=V^{-1/2}\y, X∗=V−1/2XX^*=V^{-1/2}X를 두면 y∗=X∗β+ε∗\y^*=X^*\bbeta+\beps^*, Cov⁡ε∗=σ2I\Cov\beps^*=\sigma^2I임을 보여라. rank⁡X∗=p\rank X^*=p인 이유도 적어라.

  2. (b)

    원래 모형의 선형불편추정량 AyA\y (AX=IAX=I)와 변환된 모형의 선형불편추정량 A∗y∗A^*\y^* (A∗X∗=IA^*X^*=I)가 A∗=AV1/2A^*=AV^{1/2}로 하나씩 대응함을 보여라.

  3. (c)

    변환된 모형에 정리 3.3를 쓰고 BLUE (X∗TX∗)−1X∗Ty∗(X^{*\mathsf T}X^*)^{-1}X^{*\mathsf T}\y^*를 원래의 X,V,yX,V,\y로 다시 써라.

  4. (d)

    보통 최소제곱의 공분산 σ2(X′X)−1X′VX(X′X)−1\sigma^2(X\T X)^{-1}X\T VX(X\T X)^{-1}을 5회 보조정리 3.1로 구하고, 그것이 Cov⁡β^GLS\Cov\bhat_{\mathrm{GLS}} 이상인 이유를 (b)(c)로 설명하라.

풀이

(a) 5회 보조정리 3.2로 양정치 VV는 양정치인 대칭 제곱근 V1/2V^{1/2}를 갖고, V−1/2=(V1/2)−1V^{-1/2}=(V^{1/2})^{-1}이다. y∗=V−1/2y=X∗β+ε∗\y^*=V^{-1/2}\y=X^*\bbeta+\beps^*, ε∗=V−1/2ε\beps^*=V^{-1/2}\beps이고, 5회 보조정리 3.1로 Cov⁡ε∗=V−1/2(σ2V)V−1/2=σ2I\Cov\beps^*=V^{-1/2}(\sigma^2V)V^{-1/2}=\sigma^2I이다. V−1/2V^{-1/2}가 가역이므로 rank⁡X∗=rank⁡X=p\rank X^*=\rank X=p이다. (b) A∗=AV1/2A^*=AV^{1/2}로 두면 Ay=AV1/2V−1/2y=A∗y∗A\y=AV^{1/2}V^{-1/2}\y=A^*\y^*이고, A∗X∗=AV1/2V−1/2X=AXA^*X^*=AV^{1/2}V^{-1/2}X=AX이다. 따라서 AX=I  ⟺  A∗X∗=IAX=I\iff A^*X^*=I이고, A↦AV1/2A\mapsto AV^{1/2}는 일대일 대응이다. 두 모형의 선형불편추정량은 같은 추정량들의 모임이다. (c) 변환된 모형은 정의 1.1의 가정을 만족하므로 정리 3.3로 BLUE는 (X∗TX∗)−1X∗Ty∗=(X′V−1X)−1X′V−1y(X^{*\mathsf T}X^*)^{-1}X^{*\mathsf T}\y^*=(X\T V^{-1}X)^{-1}X\T V^{-1}\y이고 공분산은 σ2(X∗TX∗)−1=σ2(X′V−1X)−1\sigma^2(X^{*\mathsf T}X^*)^{-1}=\sigma^2(X\T V^{-1}X)^{-1}이다. (d) 보통 최소제곱은 LyL\y, L=(X′X)−1X′L=(X\T X)^{-1}X\T이고 LX=ILX=I이므로 여전히 불편이다. 5회 보조정리 3.1로 Cov⁡Ly=L(σ2V)L′=σ2(X′X)−1X′VX(X′X)−1\Cov L\y=L(\sigma^2V)L\T=\sigma^2(X\T X)^{-1}X\T VX(X\T X)^{-1}이다. LyL\y는 (b)로 변환된 모형의 선형불편추정량이므로 (c)의 BLUE보다 공분산이 작지 않다(정리 3.3).

이 회차에서 읽은 절 0개 · 회차 차례