Skip to content

13회 · 최소제곱 · 노트

8 오늘의 최소제곱 — 경사하강과 weight decay ​

신경망의 선형층 nn.Linear에 평균제곱오차를 손실로 붙이면 그것이 최소제곱이다. 다른 것은 푸는 방법뿐이다. 정규방정식이나 QR 대신 경사하강을 쓴다. 이 절은 그 차이가 무엇을 낳는지 본다.

8.1 경사하강의 속도는 조건수가 정한다 ​

정리 8.1 (최소제곱의 경사하강) L(w)=12n∥y−Xw∥2L(\bw)=\tfrac1{2n}\|\y-X\bw\|^2, A=X′X/nA=X\T X/n이고 rank⁡X=p\rank X=p라 하자. AA의 고유값을 0<μmin⁡≤⋯≤μmax⁡0<\mu_{\min}\le\dots\le\mu_{\max}, κ=μmax⁡/μmin⁡\kappa=\mu_{\max}/\mu_{\min}이라 하고 학습률 η=1/μmax⁡\eta=1/\mu_{\max}로 wk+1=wk−η∇L(wk)\bw_{k+1}=\bw_k-\eta\nabla L(\bw_k)를 되풀이하면

wk−β^=(I−ηA)k(w0−β^),∥wk−β^∥≤(1−1κ)k∥w0−β^∥.\bw_k-\bhat=(I-\eta A)^k(\bw_0-\bhat),\qquad \|\bw_k-\bhat\|\le\Bigl(1-\frac1\kappa\Bigr)^k\|\bw_0-\bhat\| .

오차를 ϵ\epsilon배로 줄이는 데 대략 κlog⁡(1/ϵ)\kappa\log(1/\epsilon)번이 든다.

증명 ∇L(w)=Aw−X′y/n\nabla L(\bw)=A\bw-X\T\y/n이고 정규방정식으로 X′y/n=Aβ^X\T\y/n=A\bhat이므로 ∇L(w)=A(w−β^)\nabla L(\bw)=A(\bw-\bhat)이다. 따라서 wk+1−β^=(I−ηA)(wk−β^)\bw_{k+1}-\bhat=(I-\eta A)(\bw_k-\bhat). 대칭행렬 I−ηAI-\eta A의 고유값은 1−μi/μmax⁡∈[0, 1−1/κ]1-\mu_i/\mu_{\max}\in[0,\allowbreak \ 1-1/\kappa]이므로 그 노름은 1−1/κ1-1/\kappa 이하다. (1−1/κ)k≤e−k/κ(1-1/\kappa)^k\le e^{-k/\kappa}에서 마지막 문장이 나온다.

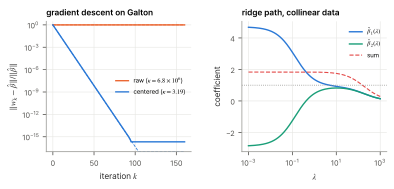
예제 8.2 (Galton을 경사하강으로) X=[1, 부모 키]X=[\one,\ \text{부모 키}]의 κ\kappa는 6.8×1066.8\times10^6이다(2절). 원점에서 출발해 상대오차 10−310^{-3}에 이르려면 4,721만 번의 반복이 든다. 부모 키에서 평균을 빼면 κ=3.19\kappa=3.19이고 19번이면 된다(그림 8.1 왼쪽). 상수 열과 거의 평행한 열이 손실 함수의 등고선을 길쭉한 골짜기로 만들고, 경사하강은 골짜기의 벽 사이를 오가며 바닥을 따라 아주 느리게 내려간다. 입력을 표준화하는 것, 신경망의 배치 정규화(5회 6절의 백색화)는 이 골짜기를 둥글게 만드는 일이다.

8.2 모수가 관측보다 많으면 — 최소노름 해 ​

p>np>n이면 rank⁡X<p\rank X<p이고 정규방정식의 해가 무수히 많다. 그 해들은 모두 자료를 완벽히 맞춘다(잔차 0). 경사하강은 그 가운데 어느 것을 고르나?

정리 8.3 (경사하강은 최소노름 해로 간다) w0=0\bw_0=\bzero에서 출발해 0<η<2/μmax⁡0<\eta<2/\mu_{\max}로 경사하강을 하면 wk\bw_k는 정규방정식의 해 가운데 노름이 가장 작은 것 w†\bw^\dagger로 수렴한다.

증명 

1. 행공간에 머문다. ∇L(w)=X′(Xw−y)/n∈col⁡(X′)\nabla L(\bw)=X\T(X\bw-\y)/n\in\col(X\T)이므로 w0=0\bw_0=\bzero에서 시작한 wk\bw_k는 모두 col⁡(X′)\col(X\T)에 있다.

2. 행공간의 해는 하나이고 노름이 최소다. 해 하나를 w∗\bw^*라 하면 해 전체는 w∗+null(X)\bw^*+\mathrm{null}(X)이다. Rp=col⁡(X′)⊕null(X)\R^p=\col(X\T)\oplus\mathrm{null}(X) (직교 분해)로 w∗=w†+wn\bw^*=\bw^\dagger+\bw_n이라 쓰면 Xwn=0X\bw_n=\bzero이므로 w†\bw^\dagger도 해이고, 행공간에 있는 해는 이것 하나다(두 해의 차는 null(X)∩col⁡(X′)={0}\mathrm{null}(X)\cap\col(X\T)=\{\bzero\}에 있다). 아무 해 w=w†+v\bw=\bw^\dagger+\bv (v∈null(X)\bv\in\mathrm{null}(X))에 대해 ∥w∥2=∥w†∥2+∥v∥2\|\bw\|^2=\|\bw^\dagger\|^2+\|\bv\|^2이다.

3. 수렴. 정리 8.1의 증명처럼 wk+1−w†=(I−ηA)(wk−w†)\bw_{k+1}-\bw^\dagger=(I-\eta A)(\bw_k-\bw^\dagger)이고 wk−w†∈col⁡(X′)\bw_k-\bw^\dagger\in\col(X\T)이다. AA는 col⁡(X′)\col(X\T)를 자기 자신으로 보내고, 거기서의 고유값은 양수 μi≤μmax⁡\mu_i\le\mu_{\max}이므로 I−ηAI-\eta A의 고유값 1−ημi1-\eta\mu_i는 절댓값이 1보다 작다. 따라서 wk→w†\bw_k\to\bw^\dagger.

w†=X+y\bw^\dagger=X^+\y (X+X^+는 Moore–Penrose 역행렬)이다. 아무도 노름을 작게 하라고 시키지 않았는데 경사하강이 스스로 그렇게 한다. 이것을 암묵적 정칙화라 부른다. 모수가 자료보다 훨씬 많은 오늘의 신경망이 왜 자료를 외우면서도 새 자료에서 망가지지 않는지 설명하려는 연구가 이 정리에서 출발했다.

8.3 Ridge와 weight decay ​

정의 8.4 (Ridge 추정량) λ>0\lambda>0에 대해 ∥y−Xb∥2+λ∥b∥2\|\y-X\bb\|^2+\lambda\|\bb\|^2을 최소로 하는

β^λ=(X′X+λI)−1X′y\bhat_\lambda=(X\T X+\lambda I)^{-1}X\T\y

를 ridge 추정량이라 한다(Hoerl–Kennard 1970). 상수항은 벌점에서 빼는 것이 보통이어서 설명변수와 반응을 중심화한 뒤에 쓴다.

X′X+λIX\T X+\lambda I는 언제나 양정치이므로 p>np>n이어도, 공선성이 심해도 해가 하나로 정해진다. 신경망에서 손실에 λ2∥w∥2\tfrac\lambda2\|\bw\|^2을 더하는 것을 weight decay라 부른다. 경사하강 한 걸음이 w←(1−ηλ)w−η∇L(w)\bw\leftarrow(1-\eta\lambda)\bw-\eta\nabla L(\bw), 곧 매번 가중치를 조금씩 줄이는 꼴이기 때문이다. 손실이 제곱오차이면 그 고정점이 ridge 해다(연습 8.1).

명제 8.5 (ridge는 방향마다 줄인다) X=UDV′X=UDV\T를 특이값 분해(d1≥⋯≥dp>0d_1\ge\dots\ge d_p>0)라 하면

β^λ=∑j=1pdj2dj2+λ⋅uj′ydj vj,β^=∑j=1puj′ydj vj.\bhat_\lambda=\sum_{j=1}^p\frac{d_j^2}{d_j^2+\lambda}\cdot\frac{\bu_j\T\y}{d_j}\,\bv_j,\qquad \bhat=\sum_{j=1}^p\frac{\bu_j\T\y}{d_j}\,\bv_j .

최소제곱 해의 성분을 방향 vj\bv_j마다 dj2/(dj2+λ)d_j^2/(d_j^2+\lambda)배로 줄인다. 특이값이 작은 방향, 곧 자료가 정보를 적게 가진 방향을 가장 많이 줄인다.

증명 X′X+λI=V(D2+λI)V′X\T X+\lambda I=V(D^2+\lambda I)V\T, X′y=VDU′yX\T\y=VDU\T\y이므로 β^λ=V(D2+λI)−1DU′y\bhat_\lambda=V(D^2+\lambda I)^{-1}DU\T\y이다. 성분으로 쓰면 위의 식이고, λ=0\lambda=0이 최소제곱이다.

정리 8.6 (Hoerl–Kennard (1970)) 정의 1.1의 모형에서 0<λ<σ2/max⁡jϑj20<\lambda<\sigma^2/\max_j\vartheta_j^2이면 (ϑ=V′β\boldsymbol\vartheta=V\T\bbeta)

E∥β^λ−β∥2<E∥β^−β∥2.E\|\bhat_\lambda-\bbeta\|^2<E\|\bhat-\bbeta\|^2 .

치우친 ridge 추정량이 BLUE를 평균제곱오차에서 이기는 λ\lambda가 언제나 있다.

증명 VV로 돌려도 노름은 같으므로 ϑ=V′β\boldsymbol\vartheta=V\T\bbeta의 좌표에서 계산한다. 최소제곱의 jj번째 성분 ϑ^j=uj′y/dj\hat\vartheta_j=\bu_j\T\y/d_j는 평균 ϑj\vartheta_j, 분산 σ2/dj2\sigma^2/d_j^2이고, ridge의 성분은 cjϑ^jc_j\hat\vartheta_j, cj=dj2/(dj2+λ)c_j=d_j^2/(d_j^2+\lambda)이다. 분산과 치우침의 제곱을 더하면

M(λ)=E∥β^λ−β∥2=∑j=1pσ2dj2+λ2ϑj2(dj2+λ)2,M′(λ)=∑j=1p2dj2(λϑj2−σ2)(dj2+λ)3M(\lambda)=E\|\bhat_\lambda-\bbeta\|^2=\sum_{j=1}^p\frac{\sigma^2d_j^2+\lambda^2\vartheta_j^2}{(d_j^2+\lambda)^2},\qquad M'(\lambda)=\sum_{j=1}^p\frac{2d_j^2(\lambda\vartheta_j^2-\sigma^2)}{(d_j^2+\lambda)^3}

이다. 0<λ<σ2/max⁡ϑj20<\lambda<\sigma^2/\max\vartheta_j^2이면 모든 항이 음수이므로 MM은 [0,λ][0,\lambda]에서 감소하고, M(λ)<M(0)=E∥β^−β∥2M(\lambda)<M(0)=E\|\bhat-\bbeta\|^2이다.

예제 8.7 (공선성 자료의 ridge) 예제 7.5의 표본(중심화)에서 XX의 두 특이값은 13.56과 0.366이다. λ\lambda를 0, 1, 10으로 올리면 (β^1,β^2)(\hat\beta_1,\hat\beta_2)는 (4.71,−2.87)→(1.36,0.47)→(0.93,0.82)(4.71,\allowbreak -2.87)\to(1.36,\allowbreak 0.47)\to(0.93,\allowbreak 0.82)로 참값 (1,1)(1,1) 쪽으로 모인다(그림 8.1 오른쪽). 줄어드는 것은 거의 전부 작은 특이값의 방향 v2≈(1,−1)/2\bv_2\approx(1,-1)/\sqrt2, 곧 “두 계수의 차”다. 합의 방향은 거의 건드리지 않는다. 이 설계에서 σ=1\sigma=1, β=(1,1)\bbeta=(1,1)이면 최소제곱의 평균제곱오차는 7.47이고 ridge는 λ≈7\lambda\approx7에서 0.010으로, 700배 작다. β\bbeta가 거의 전부 큰 특이값의 방향에 있어서 작은 방향을 줄이는 대가(치우침)가 거의 없기 때문이다.

가정 주의 최적의 λ\lambda는 모르는 β\bbeta에 의존한다(연습 3.5의 cc와 같다). 실무에서는 교차검증으로 고른다. 16회에서 Stein은 정규 평균 세 개 이상을 동시에 추정할 때, β\bbeta와 무관하게 언제나 최소제곱을 이기는 축소 추정량이 있음을 보인다.

그림 8.1. 왼쪽: Galton 자료의 경사하강. 원래의 부모 키(κ=6.8×10^6, 주황)로는 오차가 거의 줄지 않고, 중심화하면(κ=3.19, 파랑) 100번쯤에 기계 정밀도에 이른다. 점선은 정리 8.1의 상계 (1-1/κ)^k이다. 오른쪽: 공선성 자료의 ridge 경로. λ가 커지면 두 계수가 참값 1(회색 점선) 근처로
그림 8.1 왼쪽: Galton 자료의 경사하강. 원래의 부모 키(κ=6.8×10⁶\kappa=6.8\times10^6, 주황)로는 오차가 거의 줄지 않고, 중심화하면(κ=3.19\kappa=3.19, 파랑) 100번쯤에 기계 정밀도에 이른다. 점선은 정리 8.1의 상계 (1−1/κ)k(1-1/\kappa)^k이다. 오른쪽: 공선성 자료의 ridge 경로. λ\lambda가 커지면 두 계수가 참값 1(회색 점선) 근처로 모이고, 합(빨강 점선)은 λ≈10\lambda\approx10까지 거의 그대로다.
연습문제

연습 8.1 (덧붙인 자료 ★) (a) X~=(XλIp)\tilde X=\smat{X\\ \sqrt\lambda I_p}, y~=(y0)\tilde\y=\smat{\y\\ \bzero}로 최소제곱을 하면 ridge 해가 나옴을 보여라. (b) weight decay를 붙인 경사하강 w←(1−ηλ)w−ηX′(Xw−y)\bw\leftarrow(1-\eta\lambda)\bw-\eta X\T(X\bw-\y)의 고정점이 β^λ\bhat_\lambda임을 보여라.

풀이

(a) X~′X~=X′X+λI\tilde X\T\tilde X=X\T X+\lambda I, X~′y~=X′y\tilde X\T\tilde\y=X\T\y이므로 정규방정식이 ridge의 식이다. (b) 고정점에서 w=(1−ηλ)w−ηX′(Xw−y)\bw=(1-\eta\lambda)\bw-\eta X\T(X\bw-\y)이므로 λw=−X′(Xw−y)\lambda\bw=-X\T(X\bw-\y), 곧 (X′X+λI)w=X′y(X\T X+\lambda I)\bw=X\T\y.

연습 8.2 (두 점, 세 모수 ★★) X=(101011)X=\smat{1&0&1\\0&1&1}, y=(1,1)′\y=(1,1)\T이다. 정규방정식의 해 전체를 쓰고, 그 가운데 노름이 가장 작은 해가 (1/3,1/3,2/3)(1/3,1/3,2/3)임을 보여라. 원점에서 출발한 경사하강이 이 해로 가는 것을 정리 8.3으로 설명하라.

풀이

rank⁡X=2=n\rank X=2=n이므로 정규방정식의 해는 Xw=yX\bw=\y의 해, 곧 w1+w3=1w_1+w_3=1, w2+w3=1w_2+w_3=1이다. 해 전체는 (1−t,1−t,t)(1-t,1-t,t)이고 노름의 제곱 2(1−t)2+t22(1-t)^2+t^2은 t=2/3t=2/3에서 최소다. 해 (1/3,1/3,2/3)=13(1,0,1)+13(0,1,1)(1/3,\allowbreak 1/3,\allowbreak 2/3)=\tfrac13(1,\allowbreak 0,\allowbreak 1)+\tfrac13(0,\allowbreak 1,\allowbreak 1)은 XX의 행공간에 있다. 원점에서 시작한 경사하강은 행공간을 떠나지 않으므로(정리 8.3의 1단계) 그 안의 유일한 해로 간다.

연습 8.3 (조건수와 중심화 ★★) 단순회귀에서 A=X′X/n=(1xˉxˉx2‾)A=X\T X/n=\smat{1&\bar x\\ \bar x&\overline{x^2}}이다. xx를 중심화하면 A=diag⁡(1, sx2)A=\diag(1,\ s_x^2) (sx2=1n∑(xi−xˉ)2s_x^2=\tfrac1n\sum(x_i-\bar x)^2)임을 보이고, 중심화하지 않았을 때 xˉ2≫1\bar x^2\gg1이면 κ≈(1+xˉ2+sx2)2/sx2\kappa\approx(1+\bar x^2+s_x^2)^2/s_x^2임을 보여라(고유값의 합과 곱을 쓰라). Galton의 xˉ=68.3\bar x=68.3, sx2=3.19s_x^2=3.19로 6.8×1066.8\times10^6을 확인하라.

풀이

중심화하면 xˉ=0\bar x=0이므로 A=diag⁡(1,sx2)A=\diag(1,s_x^2). 중심화하지 않으면 AA의 대각합은 1+xˉ2+sx21+\bar x^2+s_x^2, 행렬식은 x2‾−xˉ2=sx2\overline{x^2}-\bar x^2=s_x^2이다. xˉ2≫1\bar x^2\gg1이면 큰 고유값은 대각합에 가깝고 작은 고유값은 행렬식//대각합에 가까우므로 κ≈(1+xˉ2+sx2)2/sx2\kappa\approx(1+\bar x^2+s_x^2)^2/s_x^2. Galton: (1+4666+3.19)2/3.19=6.8×106(1+4666+3.19)^2/3.19=6.8\times10^6. 중심화하면 κ=3.19\kappa=3.19.

이 회차에서 읽은 절 0개 · 회차 차례