분포를 주어진 것으로 받지 않고 만들어 낼 수 있는가. 진입·퇴출·성장이라는 세 규칙에서 무엇이 나오는가.
기업 규모의 로그-로그 기울기 -1.06을 회귀로 얻고 나면 다음 줄이 없다. 그 숫자가 어느 규칙의 어느 비에서 왔는지 말할 수 없기 때문이다. Zipf 기울기가 1.06인 경제와 1.25인 경제는 무엇이 다른가. 분포를 추정 대상으로만 읽으면 이 질문 자체가 생기지 않는다.
논문의 장면은 기업 규모 분포다. Axtell (2001)류의 자료 논문은 미국 기업의 종업원 수 생존함수가 로그-로그에서 기울기 약 -1.06의 직선임을 보인다. Luttmer (2007)류의 이론 논문은 "규모 밀도는 진입을 원천으로 갖는 정상 전진방정식의 해이고, 꼬리 지수는 진입과 기존 기업 성장의 비로 결정되며, 진입이 작을수록 Zipf에 가까워진다"는 뜻의 한 문단을 쓴 뒤 곧바로 지수의 식을 적는다. 학부 읽기는 자료 논문의 기울기까지는 따라간다. 이론 논문의 "정상해"라는 단어에서 멈춘다 — 분포가 방정식의 해라는 문장을 처음 만나기 때문이다.
실무의 장면은 거래처 집중도다. 한 은행의 거래상대 익스포저 상위 목록이 해마다 흩어지지 않는다. 생존함수의 기울기가 1.1 근처라는 것까지는 계산한다. 그 기울기가 "새 거래처가 생기는 속도 대 기존 거래처와의 거래가 자라는 속도"의 비 하나로 정해지며, 그 비를 바꾸지 않는 한 집중도는 구조적으로 유지된다는 것은 읽지 못한다. 답은 3절의 (9) 한 줄이다.
두 장면에서 막히는 자리는 같다. 한쪽에는 기울기라는 숫자가 있고 다른 쪽에는 진입·성장이라는 규칙이 있는데, 둘 사이에 방정식이 하나 빠져 있다. 그 방정식은 규모 k인 기업의 수가 시간에 따라 어떻게 변하는지를 적은 것이고, 0절의 식이 그것이다. 학부 확률론은 분포를 먼저 주고 그 성질을 묻는다. 순서를 뒤집으면 — 규칙을 먼저 주고 분포를 풀면 — 풀린 분포의 꼬리 기울기는 규칙의 파라미터 둘의 비 하나로만 나타나고, 그래서 자료의 기울기 하나가 그 비를 되돌려 준다.
이 회차가 메우는 결핍은 하나다. 분포는 추정할 모수가 아니라 흐름의 균형이 남긴 형태이고, 그 형태의 꼬리 기울기는 바닥에서 들어오는 양과 위에서 자라는 양의 비 하나로 읽힌다.
상수처럼 보이는 함수. (1)의 A는 파라미터 자리에 있지만 A(t)=a/U(t)다. 연결 확률이 "가진 몫 k/U(t)"라는 규칙 자체가 분모 U(t)를 만들고, U(t)가 자라므로 A는 1/t로 줄어든다. 상수인 것은 A가 아니라 무차원 결합 At=1−p다. 이 한 줄이 이 회차의 L0이고, 3절의 (4)가 그것을 증명한다. A가 진짜 상수가 되는 세계는 둘뿐이다 — 퇴출이 있어 총 단위 수가 멈추고 A(t)→A∗가 되는 세계((14))와, 정규화 1/U(t) 자체를 버려 지수가 1에 머무는 세계((17))다. 0절이 A를 상수처럼 적은 것은 오류가 아니라 생략이며, 무엇을 생략했는지가 4절 식 일기의 “기호 선택” 문항이다. ∂Nk/∂t도 같은 종류의 생략이다 — k는 이산 지표이므로 편미분할 다른 변수가 없고, ∂Nk/∂t는 dNk/dt=N˙k와 같다. 논문이 ∂를 쓰는 것은 k를 연속 변수로 보낼 준비이지 편미분이 아니다. 3절부터는 N˙k로 쓴다.
같은 글자, 다른 이름. A는 W10의 생산성 수준([재화/노동]1−α[시간−1])이 아니라 연결률([시간−1])이다. δ는 W09–W12의 감가상각률이 아니라 W19와 같은 퇴출률이다 — 문헌의 관례이며, 같은 글자가 같은 차원 [시간−1]을 갖는 것은 우연이 아니다(둘 다 "사라지는 강도"다). Γ(k)는 W12의 실현가능 대응(집합)이 아니라 감마함수(수)다. 혼동을 피하려고 본문의 닫힌 형은 베타함수 B(k,1+ζ)로 쓰고, Γ는 점근 (8) 근처에서만 쓴다. p는 W01·W04의 가격 벡터가 아니라 스칼라 확률이며, W19 (2)의 진입 확률과 같은 뜻이다. γ·ζ는 W17 규약 그대로 밀도·생존함수의 꼬리지수다Newman, 2005. t는 W02·W04의 배율이 아니라 W09 이후의 시간이다. N은 W18·W19의 몬테카를로 표본 크기가 아니라 총 기업 수 N(t)다. 이 회차에 λ는 없다 — W10의 수렴속도 λ 자리에는 로그시간당 속도 1+(1−p)k가 선다(4절 Q10). η는 W10 보조정리 증명의 임시 허용오차가 아니라 진입률이다. 문헌은 이 성장 규칙을 선호적 연결(preferential attachment)Barabási & Albert, 1999 또는 누적 이익(cumulative advantage)Price, 1976이라 부른다 — 이 책에서는 기업 규모의 비례 성장으로 읽고, 노드·링크·차수라는 말은 (15) 한 곳에서만 대응시킨다.
변수와 파라미터의 구분. Nk(t)는 확률변수의 기댓값이다(3절 A4). 첨자 k는 상태(규모), 괄호 안 t는 시간이며, Nk 전체는 "k마다 하나씩"의 열이다. nk=Nk/t는 수준을 시간으로 나눈 형태이고, 정상해 nk∗는 t에 무관한 숫자 열이다. "정상"은 Nk의 수준이 멈춘다는 뜻이 아니라 형태가 멈춘다는 뜻이다 — W10 Definition 1이 말한 고정점은 여기서 n∗이지 N이 아니다. p는 이산 Simon 과정에서는 확률이고, 일반 율 (a,η)에서는 “새 단위 유입 가운데 신생 기업으로 가는 몫” η/(a+η)로 정의된다 — 한 기에 단위 하나가 들어오는 이산 과정에서 둘은 일치한다. ζ는 (6)에서 1/(1−p)의 이름으로 먼저 붙이고, (10)에서 그것이 생존함수 꼬리지수임을 확인한다 — 이름을 미리 붙이고 뒤에서 맞음을 확인하는 순서다.
3부의 주력 백지 유도. 선호적 연결 율 방정식을 세우고 정상해에서 멱법칙 지수를 얻는 전 과정. 진입률을 바꾸면 지수가 어떻게 움직이는지까지.
가정을 먼저 번호 붙인다.
A1 (상태와 개체) 기업의 규모는 양의 정수 k∈{1,2,…}(단위 수). Nk(t)≥0, N0(t)≡0. 기업은 줄지 않고 사라지지 않는다 — 퇴출 없음. (14)에서만 완화한다.
A2 (진입) 신생 기업은 일정한 율 η>0으로 들어오고, 들어올 때 규모는 1이다. 일반 진입 규모 k0는 (15)에서만.
A3 (선호적 연결 = 비례 성장) 기존 기업으로 가는 단위는 일정한 율 a>0으로 도착하고, 각 단위는 규모 k인 기업에 확률 k/U(t)로 붙는다. 따라서 규모 k인 한 기업이 단위를 받는 율은 A(t)k, A(t):=a/U(t)다. 이것이 W19 (1)의 비례 성장(Gibrat)Gibrat, 1931을 기댓값에서 구현한 것이다.
A4 (기댓값과 연속시간)Nk(t)는 규모 k 기업 수의 기댓값이다. 율 방정식의 우변은 N에 선형이므로, 한 기에 단위 하나가 도착하는 이산 과정(Simon)에서는 기댓값에 대해 정확한 차분식이 되고((12)), 연속시간 N˙k는 그 차분식의 연속화다 — W09 Definition 1의 오일러 이산화를 거꾸로 밟은 것이다.
A5 (시간 원점) 시간 원점은 U(0)=0, N(0)=0이 되도록 잡는다. 이산 과정에서 규모 1인 기업 하나로 t=1에 시작하면 U(t)=t가 정확히 성립하고 N(t)=ηt+O(1)이다 — O(1)은 nk=Nk/t에서 사라진다.
외부에서 빌려 오는 결과 넷을 이름으로 적는다. (F1) 감마·베타함수 — Γ(z+1)=zΓ(z), B(x,y)=Γ(x)Γ(y)/Γ(x+y)=∫01ux−1(1−u)y−1du. (F2) 감마 비의 점근(Stirling) — 아래 Lemma 1. (F3) 하삼각 상수계수 선형 상미분방정식의 해는 고정점에 대각 성분을 지수로 갖는 모드들의 합을 더한 것이다 — W10 Lemma 1의 선형 경우, W11의 고윳값Strogatz, 2024. (F4) 망원합(telescoping).
(c)의 마지막 줄이 W19 (2)를 율 방정식의 정상해로 다시 얻는 것이다. W19 Lemma 2는 평균장 근사로 지수만 얻고 소규모 형태는 인용했다. 여기서는 정상해 전체가 나오고 지수는 그 점근이다.
번역. 규모 k인 기업의 수는 한 단위 작은 기업이 단위를 받아 올라오는 만큼 늘고 자신이 단위를 받아 올라가는 만큼 줄며, 맨 아래 칸에는 신생 기업이 일정한 속도로 들어온다. 받는 속도가 가진 만큼에 비례하고 신생 기업이 꾸준히 바닥에서 들어오면, 오래 지난 뒤 규모 분포의 형태는 하나로 정해지고, 그 꼬리의 기울기는 신생 기업이 가져가는 몫과 기존 기업이 가져가는 몫의 비 하나로 결정된다. 진입 몫이 0에 가까우면 Zipf이고, 커질수록 꼬리는 얇아진다.
검산과 변형. 정리를 두 방향에서 다시 얻고(이산 과정·개별 기업), 가정 둘을 하나씩 푼다(퇴출·진입 규모).
근거 — A4·A5: 한 기에 단위 하나. 확률 p로 신생 기업, 1−p로 기존 기업(규모 비례). 우변이 N에 선형이므로 기댓값을 취해도 정확하다. 정상 형태에서 nk는 상수이므로 Nk=nkt를 넣으면 좌변은 nk(t+1)−nkt=nk — (6)과 문자 그대로 같은 점화식이다. 정상해에는 이산화 오차가 없고, 오차는 과도기((11)의 지수)에만 있다 — W09 Theorem 1의 "같은 고정점, 다른 속도"가 여기서 되풀이된다. Ijiri & Simon (1977)는 이 점화식을 기업 규모에 적용한 원형이다.
근거 — A3의 수취율 A(t)k=(1−p)k/t를 기업 i의 기댓값 성장으로 읽으면 변수분리 상미분방정식(W09), ki(ti)=1. 진입 시각 ti는 A2에 의해 [0,t] 위에 균등하다. 이것은 발견적 검산이다 — 규모를 결정론적으로 다루므로 지수 ζ=1/(1−p)는 (10)과 일치하고 소규모 형태는 다르다. W19 Lemma 2의 연령 논법과 글자까지 같다. 읽기: 성장률이 규모에 비례하는 것(W19 (1)의 Gibrat)과 바닥에서 꾸준히 들어오는 질량(여기서는 진입, W19에서는 반사벽)이 짝을 이룰 때 Pareto가 나온다. 반사벽은 있던 기업을 되돌리고 진입은 새 기업을 넣는다는 점만 다르다.
근거 — A1의 "퇴출 없음"을 규모 무관 퇴출률 δ>0으로 완화. 둘째 줄은 (4)와 같은 망원합에 −δN, −δU가 더해진 것 — N과 U가 수준의 고정점을 갖고 e−δt로 수렴한다(W10 (2)의 실시간 지수 수렴, λ 자리에 δ, 반감기 ln2/δ). 셋째 줄: N˙k=0에 A∗를 넣고 δ/A∗=1/(1−p)=ζ. 지수는 δ에 무관하다 — 퇴출은 수준을 멈추게 하지만 형태를 바꾸지 않는다. 단서가 하나 있다. 일반형은 ζ=δ/A∗, 곧 퇴출률 대 단위당 성장률의 비다. δ가 소거되는 것은 총 단위 유입 a를 고정한 폐쇄에서 A∗=(1−p)δ로 성장률이 퇴출률에 비례해 조정되기 때문이다. 기업 수준 성장률 g를 원시 파라미터로 고정하는 폐쇄에서는 ζ=δ/g로 퇴출률이 지수에 직접 들어간다Luttmer, 2007Gabaix, 2009 — 어느 양을 원시로 두는가가 답을 가른다. 이 세계에서 0절의 A는 정상상태에서 상수 A∗가 된다. 도입의 “진입·퇴출·성장” 세 규칙이 여기서 모두 회수된다.
근거 — 진입 규모를 k0로 두면 (4)에서 U˙=a+ηk0이고, 진입 몫의 정의(새 단위 유입 가운데 신생 기업으로 가는 몫)를 그대로 쓰면 1−p=a/(a+ηk0)다. 나머지 유도는 k≥k0에서 동일하다. 읽기: 지수를 정하는 것은 “진입이 가져오는 단위 질량” 대 "기존 기업이 받는 단위 질량"의 비다. 성장 네트워크 문헌의 γ=3은 η=1, k0=m, a=m인 경우 — 새 노드의 링크 m개가 기존 노드의 차수를 합쳐 m만큼 올리므로 진입 질량과 성장 질량이 같다Barabási & Albert, 1999. 경제의 예는 진입 은행이 k0개 거래상대와 함께 들어오는 은행간 시장이다.
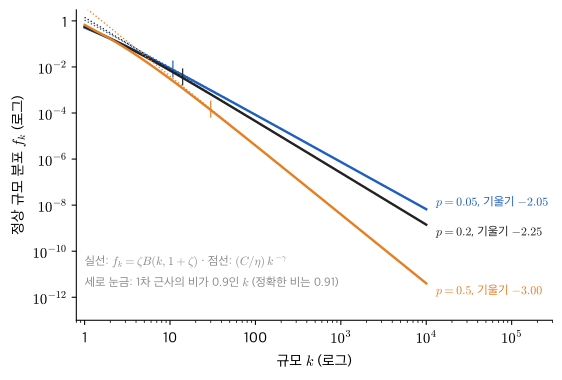
수치 확인. 진입 몫을 바꾸면 지수가 어떻게 움직이는지를 표로 적는다. ζ=1/(1−p), γ=1+ζ, f1=1/(2−p), 평균 규모 1/p다.
p
1−p
ζ
γ
f1
평균 1/p
0.01
0.99
1.010
2.010
0.503
100
0.05
0.95
1.053
2.053
0.513
20
0.0566
0.943
1.060
2.060
0.515
17.7
0.1
0.9
1.111
2.111
0.526
10
0.2
0.8
1.250
2.250
0.556
5
0.5
0.5
2
3
0.667
2
0.9
0.1
10
11
0.909
1.11
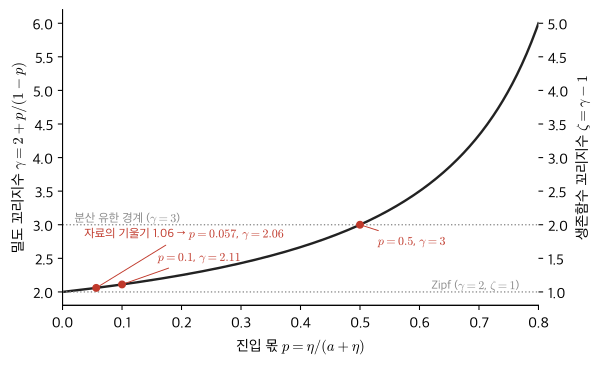
p=0.0566은 1절의 기울기 ζ^≈1.06을 (9)로 되돌린 값이다: η/a=ζ^−1=0.06. 그때 평균 규모 1/p≈18은 자료의 평균 고용 규모와 같은 자릿수다. 표의 p=0.05와 0.2 두 행이 말하는 것은 하나다 — 진입 몫이 5%에서 20%로 오르면 밀도 꼬리지수는 2.05에서 2.25로, 생존함수 꼬리지수는 1.05에서 1.25로 오른다. Figure 1이 이 관계의 볼록성을 보인다.
Figure 1:밀도 꼬리지수 γ(p)=2+p/(1−p). 진입 몫 p가 오르면 지수는 볼록하게 오른다 — 꼬리가 얇아진다. 회색 점선은 Zipf 경계 γ=2와 분산 유한 경계 γ=3이고, 점 셋은 자료의 기울기 1.06에 대응하는 p=0.057, 그림 공통 파라미터 p=0.1, 분산 경계 p=0.5다. 오른쪽 눈금은 ζ=γ−1.
2절 표가 답이다. 한 줄만 더한다. (1)의 우변에는 Nk가 아닌 것이 셋 있다 — A(함수), η(파라미터), 1{k=1}(지표). 셋의 종류가 다르다는 것이 첫 읽기다. A를 파라미터로 읽는 순간 (4)의 보존이 사라지고, η를 함수로 읽는 순간 정상해가 사라진다.
(1): 규모 k인 기업의 수는 한 단위 작은 기업이 단위를 받아 올라오는 만큼 늘고 자신이 단위를 받아 올라가는 만큼 줄며, 맨 아래 칸에는 신생 기업이 일정한 속도로 들어온다. 이 흐름이 자리를 잡으면 규모 분포는 멱법칙이 된다. Theorem 1 (b)·(c): 받는 속도가 가진 만큼에 비례하고 신생 기업이 꾸준히 바닥에서 들어오면, 규모 분포의 형태는 하나로 정해지고 그 꼬리의 기울기는 진입 몫과 기존 기업 몫의 비 하나로 결정된다. (14): 기업이 규모와 무관하게 사라지면 기업 수와 단위 수는 멈추지만, 총 단위 유입을 고정하는 한 분포의 꼬리 기울기는 그대로다.
덩어리 짓기. Jk:=AkNk를 "규모 k와 k+1 사이의 경계를 단위시간에 넘는 기업의 수"라는 하나의 개체로 이름 붙이면 (1)은 N˙k=Jk−1−Jk+η1{k=1}이다 — 규모 축 위의 연속방정식이다. 정상해는 이 흐름이 원천과 균형을 이루는 형태다. 등가 재작성. N˙k=−A[kNk−(k−1)Nk−1]+η1{k=1} — 후진 차분 하나로 쓰면 "규모 축을 따라 실려 가는 양 kNk"가 보인다. 기호 선택. 0절이 A를 상수처럼 쓴 것은 선형 구조를 보존하고 1/U(t) 정규화를 버린 것이다. 버린 것이 (17)에서 되살아난다.
무차원군은 둘이다. k, Nk는 이미 무차원이고, 차원 있는 양은 a, η(모두 [시간−1])와 t([시간])다 — A=a/U는 이들의 파생량이다. 독립 무차원군은 η/a(=p/(1−p))와 at(누적 단위 수의 눈금) 둘이다. 정상 형태는 정의상 t에 무관하므로 지수 γ는 둘째 군을 잃고 첫째 군만의 함수여야 한다 — 동치로 p, 또는 (4)에 의해 t가 소거된 At=1−p다. 지수가 순수 숫자인 이유가 여기 있고, 유도는 그 함수가 1+1/(At)임을 보였다. W19의 간극 상자가 던진 질문(“메커니즘이 지수를 고정하는가, 자유롭게 남기는가”)의 답이다. 고정하되 진입 몫의 함수로 고정한다. W02 (2)의 탄력성 읽기로는 −γ가 탄력성 dlnnk∗/dlnk의 k→∞ 극한이다.
Simon의 정규화 a+η=1은 시간 단위를 "단위 하나가 도착하는 기간"으로 잡은 것이다. 그러면 t는 누적 단위 수와 같은 눈금이고, 가장 오래된 기업의 규모 t1−p가 규모 축의 상한이 된다 — 멱법칙의 유효 범위 1≪k≪t1−p가 차원적으로 정합인 이유다. 왼쪽 경계는 (8)의 O(1/k), 오른쪽 경계는 유한 t의 절단이다. "모든 k에서 직선"이 아니다.
근거 — 첫 등식은 (4)의 항등식이며 구성상 항상 참이다. 둘째는 (F1)의 베타 적분 ∑kkB(k,1+ζ)=∫01(1−u)ζ−2du=1/(ζ−1) (ζ>1이므로 항상 유한 — 평균은 늘 존재). 분산 조건은 W18 (1)의 γ>n+1에 n=2. 꼬리 질량은 (8)의 점근을 적분한 것이다. 읽기: p=0.1이면 K=2×10⁴까지 더한 평균은 6.5이고 꼬리 질량 근사는 3.5다 — 평균 10의 35%가 k>2×10⁴에 있다. 평균은 존재하지만 표본에서 잘 보이지 않는 세계다.
δ>0이면 총 단위 유입을 고정한 채로는 지수가 불변이고 수준은 정상상태를 갖는다((14)). k0가 커지면 γ=2+ηk0/a가 커진다 — 진입 질량이 커지면 꼬리가 얇아진다((15)).
근거 — 추측–검증. x:=1−e−At, x˙=Ae−At. k=1: 좌변 ηe−At, 우변 −ηx+η=η(1−x). k≥2: 좌변 ηxk−1e−At, 우변 ηxk−1−ηxk=ηxk−1(1−x). Nk(0)=0. ∑kNk=−(η/A)ln(1−x)=ηt. 순수 출생 과정의 닫힌 형이다Yule, 1925. 읽기: t→∞에서 Nk→η/(Ak) — γ=1, 정규화 불가, 정상 형태 없음. 총 단위가 지수적으로 자라고 오래된 기업이 전부를 가져간다. 분모 U(t) — 단위가 희소하다는 것 — 가 γ를 1 위로 밀어 올린다.
몇 개. Nk 자체에는 고정점이 없다 — 모두 ∞로 간다(수준). 형태 nk=Nk/t의 로그시간 계 (5)는 하삼각 선형계이고 대각 −(1+(1−p)k)=0이므로 고정점이 정확히 하나다((6)). W10 Definition 1의 "고정점"이 여기서는 벡터장의 영점(연속시간 s)이고, (12)의 이산 점화에서는 사상의 부동점이다 — 같은 n∗다.
안정. 고윳값이 모두 음이므로 전역 안정이다. W10처럼 선형화가 필요 없다 — 계가 이미 선형이다. W10 Lemma 1의 "국소"가 여기서는 "전역"이 된다는 점은 W12 Theorem 1의 압축사상 결과와 닮았으나, 여기에는 실시간의 압축계수가 없다 — 로그시간에서는 계수 e−(2−p)의 압축이고 실시간에서는 압축이 아니다. W12의 βn과 다른 점은 시계다.
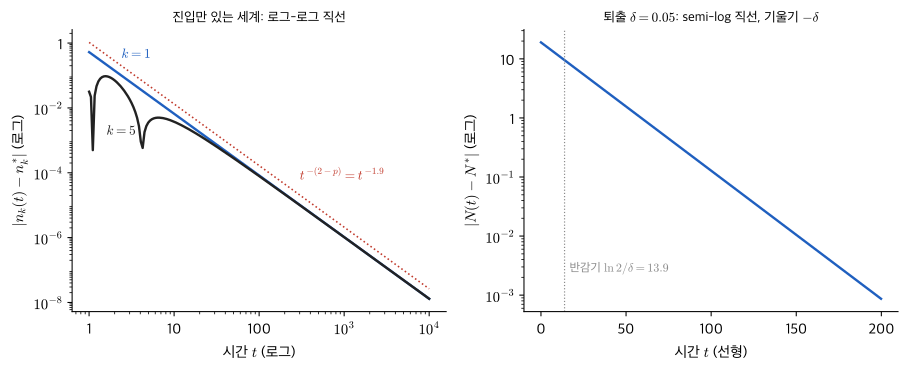
얼마나 빨리. 로그시간에서 지수적 e−(2−p)s, 실시간에서 대수적 t−(2−p). 반감기는 t가 21/(2−p)배 될 때마다 절반 — p=0.1이면 1.44배다. 초기에는 빠르고 갈수록 느려진다. 시계 A(t)=(1−p)/t가 1/t로 느려지기 때문이다. W10 (2)의 λ 자리에 서는 것은 A(t)k=(1−p)k/t이고, 그것이 상수가 아니라는 것이 실시간 지수 수렴이 없는 이유다. 퇴출 δ>0이면((14)) 수준 N, U가 고정점을 갖고 e−δt로 수렴한다 — W10의 세계로 돌아온다. Figure 3이 두 세계를 나란히 놓는다. η=1, p=0.1, t=1에서 전 질량을 k=3에 두고 (5)를 로그시간 오일러(Δs=10−3, k≤400)로 적분하면 ∣n1(t)−n1∗∣는 t=10에서 6.6×10⁻³, 102에서 8.3×10⁻⁵, 103에서 1.04×10⁻⁶, 104에서 1.30×10⁻⁸이고, 로그-로그 기울기는 −1.90=−(2−p)다. k=5의 편차는 처음에 두 번 부호를 바꾸며 흔들리다가 t≥102에서 같은 기울기로 붙는다 — 빠른 모드 j≥2가 먼저 사라지고 j=1만 남는다.
Figure 3:왼쪽: 진입만 있는 세계의 ∣nk(t)−nk∗∣ (k=1 파랑, k=5 검정)와 기준선 t−1.9(빨강 점선) — 로그-로그 직선이다. 오른쪽: 퇴출 δ=0.05를 넣은 (14)의 ∣N(t)−N∗∣ — semi-log 직선이고 기울기는 −δ, 반감기 ln2/δ=13.9다. 같은 진입 몫 p=0.1에서 수준의 시계와 형태의 시계가 다르다.
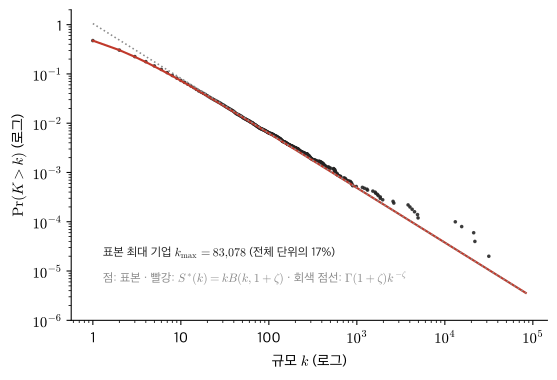
몬테카를로에서는 이 과도기가 보이지 않는다. 표본 요동은 t−1/2로 줄고 과도기는 t−1.9로 줄므로, 표본에서 남는 것은 요동뿐이다 — 노트북 예측 3이 이것을 묻는다. 반대로 정상 형태 자체는 표본에서 잘 보인다. Figure 4는 5×10⁵단위의 이산 Simon 과정 하나가 (10)의 S∗(k) 위에 놓이는 것을 보인다. 흩어지는 것은 상위 몇 개 기업뿐이고, 그것이 유한 t 절단이다.
Figure 4:이산 Simon 과정(p=0.1, T=5×10⁵단위, 시드 0)의 표본 생존함수(점), 정확한 S∗(k)=kB(k,1+ζ)(빨강), 점근 Γ(1+ζ)k−ζ(회색 점선). k≲103에서 점은 빨강 위에 있고, 상위 기업 몇 개만 흩어진다. 최대 기업의 규모 83,078은 전체 단위의 17%다.
"흐름 수지 (3) → 보존·At=1−p(4) → 로그시간 고정점 (5)–(6) → 베타 닫힌 형 (7) → 감마 비 점근 (8) → γ=2+η/a(9) → 안정성 (11)"을 내일 백지 항목으로 등록한다. 항목 이름 옆에 근거 줄 여덟 개 — 6절의 채점 기준 — 를 적는다. 백지에서 막히는 자리는 대개 둘째 줄의 망원합과 셋째 줄의 "수준이 아니라 형태"다.
자료 논문은 "기업 규모의 생존함수는 기울기 -1.06의 멱법칙"이라 쓰고, 이론 논문은 "규모 분포는 진입을 원천으로 갖는 율 방정식(연속 규모에서는 전진 Kolmogorov 방정식)의 정상해이며 꼬리 지수는 진입과 성장의 비로 결정된다"고 쓴다. 학부 읽기는 첫 문장을 "Pareto를 적합했다"로, 둘째 문장을 "복잡한 확률과정을 풀었다"로 읽고 둘을 잇지 못한다. 대학원 읽기는 둘째 문장을 (3)–(9)의 일곱 줄로 읽고, 첫 문장의 1.06을 (9)에 넣어 η/a=0.06, 곧 p≈0.057을 얻는다 — 그리고 그 p가 자료의 진입 몫(신규 고용 가운데 신생 기업의 몫)과, 같은 p가 예측하는 평균 규모 1/p≈18과 규모 1 비율 f1=0.515가 자료와 맞는지를 묻는다. 같은 1.06을 W19의 Gibrat+반사벽으로 읽으면 μ/σ2 하나가 되고, 맞출 둘째 관측치는 진입 몫이 아니라 성장률의 평균과 분산이다 — 두 후보를 가르는 것은 기울기가 아니라 기울기와 짝지을 둘째 관측치다. 이것이 상자의 "후보 메커니즘 역추적"이다Gabaix, 2009.
Luttmer (2007)류 논문의 핵심 식은 정상 밀도 방정식이고, 그 꼬리 지수는 진입(또는 기업 수 증가)의 속도와 기존 기업의 성장 속도가 들어간 2차식의 양의 근이다. 논문은 "진입이 성장에 비해 작을수록 지수는 1(Zipf)에 가까워진다"는 뜻의 문장을 쓴다. (9)의 ζ=1+η/a가 정확히 그 문장이다 — 연속 규모·연속 시간에서 식의 모양은 달라도 "바닥의 원천 대 위의 성장"이라는 구조는 같다. 학부 읽기는 논문의 2차식 앞에서 멈추고, 대학원 읽기는 그 근이 왜 진입률의 증가함수인지를 (9)의 ∂γ/∂p>0으로 먼저 안다.
실무에도 같은 간극이 있다. 거래처·차주 집중도 관리에서 "상위 10곳의 비중"을 보고하는 것은 분포를 주어진 것으로 받는 일이다. 생존 기울기가 1.1이면 (16)에 의해 분산은 없고 최대 비중은 t−p로만 준다 — 집중도는 표본이 커져도 씻기지 않는 구조적 양이며, 그것을 바꾸는 손잡이는 η/a(새 거래처 개척 대 기존 거래 확대) 하나다. 율 방정식으로 읽을 때만 보이는 정책 변수다.
노트북(40분) — w20-lab.ipynb. 코드를 쓰기 전에 답한다. 계산 계획: numpy만. (a) 이산 Simon 과정을 직접 쌓는다 — p=0.1, T=5×10⁵단위, t=1에 규모 1 기업 하나. 규모 비례 선택은 단위 하나를 균등하게 골라 그 소유 기업에 붙인다(가중 추출 함수 금지). (b) 도수에서 f1,f2, 표본 생존함수, logS 대 logk의 최소제곱 기울기를 직접 계산한다. (c) (5)를 로그시간 오일러(Δs=10−3, k≤400)로 적분해 ∣n1(t)−n1∗∣의 로그-로그 기울기를 잰다. (d) (6) 점화로 정확한 fk·S∗(k)를 만들어 (b)와 대조한다.
정상 형태. 규모 1 기업의 비율은 1/(2−p)=0.526에 ±0.005 안쪽(표본 표준편차 ≈0.002). 규모 2는 0.165–0.175. 평균 규모 U/N은 1/p=10에 ±1% — 항등식이다.
꼬리 기울기. 표본 생존함수의 [5,200] 구간 로그-로그 기울기는 -1.05에서 -1.15 사이(정확 정상해는 -1.08, 점근 -1.11). k=1부터 잡으면 더 얕아진다((8)의 O(1/k) 보정). 상위 1,000개의 순위–규모 기울기는 −1/ζ=−0.9와 -1.0 사이 — 유한 t 절단이 큰 쪽을 깎는다. 최대 기업의 비중은 15–40%(시드 종속, t−p≈27% 근처).
과도기. 결정론적 (5)의 ∣n1(t)−n1∗∣는 로그-로그 기울기 −1.9=−(2−p). 몬테카를로의 f1(t) 요동은 t−1/2로만 줄어 과도기를 덮는다 — 표본에서는 보이지 않는다.
대조 표(예측 | 결과 | 어긋남 | 원인)의 원인 후보는 표본 요동·유한 k 보정·유한 t 절단(k≲t1−p)이다. T를 두 배로 늘리면 셋이 갈라진다 — 요동은 1/2배, 보정은 그대로, 절단은 오른쪽으로 21−p배.
지금은 이렇게 읽힌다. Nk는 기댓값 열이고 A는 상수가 아니라 (1−p)/t이며, η1{k=1}은 바닥에서 들어오는 원천이다. 0절이 생략한 것은 분모 U(t) 하나이고, 그 분모가 정말 없으면 지수는 1에 머문다. 양변은 [시간−1]이고 정상 형태에 남는 무차원군은 At=1−p 하나 — 그래서 지수는 순수 숫자이며 1+1/(At)다. 우변 첫 괄호는 규모 축 위의 흐름(유입 − 유출)이고, 정상해는 그 흐름이 원천과 균형을 이루는 형태다. 고정점은 로그시간에서 하나이고 안정이며 실시간에서는 대수적으로 닿는다. 화살표 오른쪽의 γ는 "진입 몫 대 성장 몫"의 비 2+η/a이고, 자료에서 ζ를 읽으면 그 비가 되돌아온다 — 분포가 메커니즘의 이름표가 된다. 퇴출을 넣으면 A는 상수가 되고 수준은 멈추지만, 총 단위 유입을 고정하는 한 지수는 그대로다. 화살표의 ∼은 두 경계 사이에서만 성립한다. 왼쪽은 소규모의 O(1/k) 보정, 오른쪽은 가장 오래된 기업의 규모 t1−p다. 논문의 "정상해"라는 한 단어는 이 문단의 축약이고, 자료 논문의 1.06과 이론 논문의 지수 식은 (9) 한 줄로 이어진다.
Axtell, R. L. (2001). Zipf Distribution of U.S. Firm Sizes. Science, 293(5536), 1818–1820.
Luttmer, E. G. J. (2007). Selection, Growth, and the Size Distribution of Firms. The Quarterly Journal of Economics, 122(3), 1103–1144.
Newman, M. E. J. (2005). Power laws, Pareto distributions and Zipf’s law. Contemporary Physics, 46(5), 323–351. 10.1080/00107510500052444
Barabási, A.-L., & Albert, R. (1999). Emergence of Scaling in Random Networks. Science, 286(5439), 509–512. 10.1126/science.286.5439.509
Price, D. de S. (1976). A General Theory of Bibliometric and Other Cumulative Advantage Processes. Journal of the American Society for Information Science, 27(5), 292–306.
Gibrat, R. (1931). Les inégalités économiques. Librairie du Recueil Sirey.
Strogatz, S. H. (2024). Nonlinear Dynamics and Chaos (3rd ed.). CRC Press.
Bender, C. M., & Orszag, S. A. (1999). Advanced Mathematical Methods for Scientists and Engineers I: Asymptotic Methods and Perturbation Theory. Springer.
Krapivsky, P. L., Redner, S., & Leyvraz, F. (2000). Connectivity of Growing Random Networks. Physical Review Letters, 85(21), 4629–4632. 10.1103/PhysRevLett.85.4629
Simon, H. A. (1955). On a Class of Skew Distribution Functions. Biometrika, 42(3/4), 425–440. 10.1093/biomet/42.3-4.425
Yule, G. U. (1925). A Mathematical Theory of Evolution, Based on the Conclusions of Dr. J. C. Willis, F.R.S. Philosophical Transactions of the Royal Society of London. Series B, 213, 21–87. 10.1098/rstb.1925.0002
Ijiri, Y., & Simon, H. A. (1977). Skew Distributions and the Sizes of Business Firms. North-Holland.