노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
코드를 쓰기 전에 아래 셋에 답한다. 계산하지 않는다.
1. 두 점 성장 , 확률 각 , , 기업·기: 로그–로그 생존함수의 꼬리 기울기는 -1.00(Zipf — 이므로 정확히). 로 바꾸면 약 -2(이분법 근 -1.975); 정규 공식 (eq-w19-11)은 1.908을 준다(3.4% 낮다). 벽에 붙어 있는() 기업 비율은 약 14%(첫 사례)·26%(둘째). 예측: “기울기 -1.00, -1.98; 벽 비율 14%, 26%”. 원인란에 적을 것: 구간 최소제곱은 유한 표본 때문에 이론값보다 5%까지 가파를 수 있다.
예측: ____
2. 벽을 떼면 — 에서 41.1(첫 사례). 벽을 두면 는 이후 더 늘지 않고 약 근처 — 1.0(첫 사례), 0.26(둘째) — 에서 포화한다. 예측: “벽 없음은 에 선형, 벽 있음은 포화”. 원인란에 적을 것: 경계층 때문에 정확히 은 아니다.
예측: ____
3. Simon : 이면 기업 수 약 104, 규모 1인 비율 , 로그–로그 국소 기울기 에서 -1.11. : 규모 1 비율 0.667, 국소 기울기 에서 -1.83, 에서 -1.98(순수 멱 -2는 점근; 면 , ). 에 진입한 기업들의 평균 규모는 ()·10(). 예측: “규모 1 비율 0.53·0.67, 기울기는 가 커질수록 로”. 원인란에 적을 것: 진입 시각별 평균 규모는 표본이 적어 seed마다 흔들린다.
예측: ____
2. 계산
계산은 직접 쌓는다. 반사 무작위보행은 한 줄로 돌리고, 경험적 생존함수는 정렬로, 고유값 식 은 손으로 짠 이분법으로 푼다.
# 도구를 올리고 한국어 글꼴을 고른다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager
from matplotlib.ticker import FuncFormatter, LogLocator, NullFormatter
from math import exp, lgamma, log

_cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
_have = {f.name for f in font_manager.fontManager.ttflist}
for _f in _cands:
    if _f in _have:
        plt.rcParams['font.family'] = _f
        break
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['mathtext.fontset'] = 'cm'

rng = np.random.default_rng(19)
print('글꼴:', plt.rcParams['font.family'][0])
글꼴: Apple SD Gothic Neo
# 두 점 성장의 적률생성함수와 로그 성장률의 두 적률을 쌓는다.
def M(theta, u, d):
    return 0.5 * (u ** theta + d ** theta)          # M(θ) = E[(1+g)^θ], 확률 각 1/2


def cumulants(u, d):
    e = np.array([log(u), log(d)])                  # ε = ln(1+g)
    return e.mean(), ((e - e.mean()) ** 2).mean()   # μ_Δ, σ²_Δ


# 로그축 눈금을 $10^{n}$ 으로 적는다 — 한국어 글꼴에 빼기표가 없어 생기는 깨짐을 피한다.
def pow10_axes(ax):
    fmt = FuncFormatter(lambda v, _: r'$10^{%d}$' % int(round(np.log10(v))))
    for axis in (ax.xaxis, ax.yaxis):
        axis.set_major_locator(LogLocator(base=10.0))
        axis.set_major_formatter(fmt)
        axis.set_minor_formatter(NullFormatter())


mu0, s20 = cumulants(1.2, 0.8)
print(f'(u, d) = (1.2, 0.8):  μ_Δ = {mu0:+.4f}  σ²_Δ = {s20:.4f}  M(1) = E[1+g] = {M(1.0, 1.2, 0.8):.4f}')
(u, d) = (1.2, 0.8): μ_Δ = -0.0204 σ²_Δ = 0.0411 M(1) = E[1+g] = 1.0000
# (eq-w19-7)의 M(θ)=1 을 손으로 짠 이분법으로 푼다 — scipy.optimize 를 쓰지 않는다.
def root_bisect(u, d, lo=1e-6, hi=20.0, it=200):
    mu, _ = cumulants(u, d)
    if mu >= 0 or M(hi, u, d) <= 1:        # A4 위반이면 양의 근이 없다
        return None
    for _ in range(it):
        mid = 0.5 * (lo + hi)
        if M(mid, u, d) < 1:
            lo = mid
        else:
            hi = mid
    return 0.5 * (lo + hi)


# 네 파라미터에서 μ_Δ·σ²_Δ·E[g]·ζ·정규 공식 ζ_N 을 나란히 적는다.
PARS = [(1.2, 0.8), (1.2, 0.75), (1.2, 0.83), (1.2, 0.85)]
ZETA = {}
print(f"{'(u, d)':>12}{'mu_D':>9}{'s2_D':>9}{'E[g]':>9}{'zeta':>9}{'zeta_N':>9}{'M(1)':>9}")
for u, d in PARS:
    mu, s2 = cumulants(u, d)
    ZETA[(u, d)] = root_bisect(u, d)
    zs = '없음' if ZETA[(u, d)] is None else f'{ZETA[(u, d)]:.3f}'
    zn = '-' if mu >= 0 else f'{-2 * mu / s2:.3f}'
    print(f'({u}, {d})'.rjust(12) + f'{mu:+9.4f}{s2:9.4f}{0.5 * (u + d) - 1:+9.4f}'
          f'{zs:>9}{zn:>9}{M(1.0, u, d):9.4f}')
mu2, s22 = cumulants(1.2, 0.75)
print(f'정규 공식의 어긋남 (1.2, 0.75): ζ_N/ζ - 1 = '
      f'{(-2 * mu2 / s22) / ZETA[(1.2, 0.75)] - 1:+.2%}')
(u, d) mu_D s2_D E[g] zeta zeta_N M(1)
(1.2, 0.8) -0.0204 0.0411 +0.0000 1.000 0.993 1.0000
(1.2, 0.75) -0.0527 0.0552 -0.0250 1.975 1.908 0.9750
(1.2, 0.83) -0.0020 0.0340 +0.0150 0.118 0.118 1.0150
(1.2, 0.85) +0.0099 0.0297 +0.0250 없음 - 1.0250
정규 공식의 어긋남 (1.2, 0.75): ζ_N/ζ - 1 = -3.40%
예측 1. 두 파라미터 세트의 반사 무작위보행을 돌려 로그–로그 생존함수의 꼬리 기울기와 벽 위의 비율을 잰다. 이분법 근 · 정규 공식 · 회귀 기울기 셋을 나란히 놓는다.
# 반사 무작위보행 x ← max(x+ε, 0) 과 벽 없는 y ← y+ε 를 같은 ε 로 함께 쌓는다.
N, T = 20000, 2000
SNAPS = (10, 100, 500, 1000, 2000)
TS = sorted(set(np.unique(np.round(np.logspace(0, np.log10(T), 40))).astype(int).tolist())
            | set(SNAPS))


def walk(u, d, n, horizon, ts):
    lu, ld = log(u), log(d)
    x = np.zeros(n)                        # 벽 있음 — (eq-w19-3)
    y = np.zeros(n)                        # 벽 없음 — (eq-w19-4)
    rec = {}
    for t in range(1, horizon + 1):
        eps = np.where(rng.random(n) < 0.5, lu, ld)
        y = y + eps
        x = np.maximum(x + eps, 0.0)
        if t in ts:
            rec[t] = (x.var(), y.var(), float((x == 0).mean()))
    return x, rec


X, REC = {}, {}
for u, d in [(1.2, 0.8), (1.2, 0.75)]:
    X[(u, d)], REC[(u, d)] = walk(u, d, N, T, set(TS))
    print(f'({u}, {d}) — 마지막 x 의 평균 {X[(u, d)].mean():.4f}, '
          f'최대 {X[(u, d)].max():.3f}, 벽 위 비율 {REC[(u, d)][T][2]:.3f}')
(1.2, 0.8) — 마지막 x 의 평균 0.9229, 최대 11.510, 벽 위 비율 0.138
(1.2, 0.75) — 마지막 x 의 평균 0.4352, 최대 4.590, 벽 위 비율 0.258
# 경험적 생존함수를 정렬로 만들고 x∈[1,5] 구간 최소제곱으로 꼬리 기울기를 잰다.
def survival(x):
    xs = np.sort(x)
    return xs, 1.0 - np.arange(x.size) / x.size


def tail_slope(xs, surv, lo=1.0, hi=5.0):
    m = (xs >= lo) & (xs <= hi) & (surv > 0)
    A = np.column_stack([np.ones(int(m.sum())), xs[m]])
    b = np.linalg.solve(A.T @ A, A.T @ np.log(surv[m]))    # 정규방정식을 직접 푼다
    return b[1], int(m.sum())


SLOPE, WALL = {}, {}
print(f"{'(u, d)':>12}{'-zeta':>9}{'회귀 기울기':>12}{'상대 어긋남':>13}{'벽 비율':>10}{'표본':>8}")
for u, d in [(1.2, 0.8), (1.2, 0.75)]:
    xs, surv = survival(X[(u, d)])
    b, n = tail_slope(xs, surv)
    z = ZETA[(u, d)]
    SLOPE[(u, d)], WALL[(u, d)] = b, REC[(u, d)][T][2]
    print(f'({u}, {d})'.rjust(12) + f'{-z:9.3f}{b:12.3f}{(-b - z) / z:+13.2%}'
          f'{WALL[(u, d)]:10.3f}{n:8d}')
(u, d) -zeta 회귀 기울기 상대 어긋남 벽 비율 표본
(1.2, 0.8) -1.000 -0.988 -1.24% 0.138 6647
(1.2, 0.75) -1.975 -1.949 -1.31% 0.258 2372
# 두 사례의 경험적 생존함수를 로그–로그로 그리고 기울기 -ζ 직선을 겹친다.
fig, ax = plt.subplots(figsize=(6.2, 4.0))
for (u, d), col in [((1.2, 0.8), 'C0'), ((1.2, 0.75), 'C3')]:
    xs, surv = survival(X[(u, d)])
    k = surv > 0
    s = np.exp(xs[k])
    z = ZETA[(u, d)]
    ax.plot(s, surv[k], color=col, lw=1.6,
            label=rf'$(u,d)=({u},{d})$, $\zeta={z:.3f}$')
    anchor = surv[np.searchsorted(xs, 1.0)]                # x=1 에서 경험값에 맞춘다
    line = np.array([np.e, s.max()])
    ax.plot(line, anchor * (line / np.e) ** (-z), color='k', ls=':', lw=1.1)
ax.set_xscale('log')
ax.set_yscale('log')
pow10_axes(ax)
ax.set_xlabel(r'규모 $s/S_{\min}$ (로그)')
ax.set_ylabel(r'$\Pr(S>s)$ (로그)')
ax.set_title(r'점선 기울기 $-\zeta$ 는 $\mathbb{E}[(1+g)^{\zeta}]=1$ 의 근', fontsize=10)
ax.legend(fontsize=9, loc='lower left')
fig.tight_layout()
plt.show()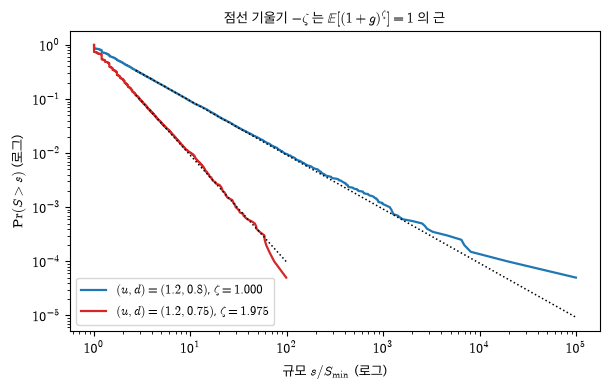
예측 2. 같은 난수로 벽 있음·없음 두 벌을 함께 쌓았으므로 의 분산을 두 벌에서 그대로 꺼내 비교한다.
# 벽 없음·있음 두 벌의 분산을 T = 10, 100, 500, 1000, 2000 에서 나란히 적는다.
print(' ' * 16 + ''.join(f'{t:>12}' for t in SNAPS))
for u, d in [(1.2, 0.8), (1.2, 0.75)]:
    mu, s2 = cumulants(u, d)
    z = ZETA[(u, d)]
    print(f'(u, d) = ({u}, {d})   σ²_Δ = {s2:.4f}   ζ = {z:.3f}   1/ζ² = {1 / z ** 2:.3f}')
    print('  벽 없음 Var[y]' + ''.join(f'{REC[(u, d)][t][1]:12.2f}' for t in SNAPS))
    print('  이론  T·σ²_Δ ' + ''.join(f'{t * s2:12.2f}' for t in SNAPS))
    print('  벽 있음 Var[x]' + ''.join(f'{REC[(u, d)][t][0]:12.3f}' for t in SNAPS))
    print('  벽 위 비율    ' + ''.join(f'{REC[(u, d)][t][2]:12.3f}' for t in SNAPS))
10 100 500 1000 2000
(u, d) = (1.2, 0.8) σ²_Δ = 0.0411 ζ = 1.000 1/ζ² = 1.000
벽 없음 Var[y] 0.41 4.09 20.51 40.56 82.01
이론 T·σ²_Δ 0.41 4.11 20.55 41.10 82.20
벽 있음 Var[x] 0.107 0.608 0.988 1.014 1.014
벽 위 비율 0.251 0.148 0.140 0.137 0.138
(u, d) = (1.2, 0.75) σ²_Δ = 0.0552 ζ = 1.975 1/ζ² = 0.256
벽 없음 Var[y] 0.56 5.60 27.65 55.37 111.63
이론 T·σ²_Δ 0.55 5.52 27.61 55.23 110.45
벽 있음 Var[x] 0.101 0.251 0.252 0.259 0.258
벽 위 비율 0.314 0.261 0.259 0.265 0.258
# 분산의 시간 경로를 로그–로그로 — 벽 없음은 기울기 1, 벽 있음은 포화.
fig, ax = plt.subplots(figsize=(6.2, 4.0))
for (u, d), col in [((1.2, 0.8), 'C0'), ((1.2, 0.75), 'C3')]:
    z = ZETA[(u, d)]
    ax.plot(TS, [REC[(u, d)][t][1] for t in TS], color=col, lw=1.4, ls='--',
            label=f'벽 없음 $({u},{d})$')
    ax.plot(TS, [REC[(u, d)][t][0] for t in TS], color=col, lw=1.8,
            label=f'벽 있음 $({u},{d})$')
    ax.axhline(1 / z ** 2, color=col, lw=0.9, ls=':')
ax.set_xscale('log')
ax.set_yscale('log')
pow10_axes(ax)
ax.set_xlabel('기간 $T$ (로그)')
ax.set_ylabel(r'$\mathrm{Var}$ (로그)')
ax.set_title(r'벽을 떼면 $T\sigma^{2}_{\Delta}$ 로 선형, 벽을 두면 $1/\zeta^{2}$ 근처에서 포화',
             fontsize=10)
ax.legend(fontsize=8, loc='upper left')
fig.tight_layout()
plt.show()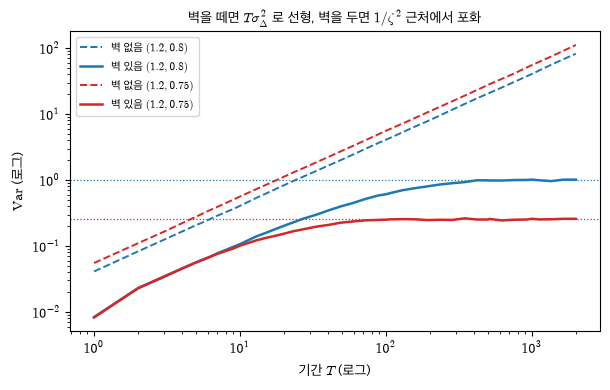
예측 3. Simon 규칙을 단위 소유 배열로 구현한다. 길이 의 배열에서 균등 난수로 단위 하나를 뽑으면 그 단위의 주인이 뽑히는 확률이 규모에 비례하므로, 그것이 (A6)의 규모 비례 선택이다.
# Simon 규칙을 단위 소유 배열로 쌓는다 — 균등 난수로 단위를 뽑으면 규모 비례 선택이 된다.
def simon(p, t):
    owner = np.empty(t, dtype=np.int64)
    owner[0] = 0
    birth = [0]
    r, pick = rng.random(t), rng.random(t)
    for s in range(1, t):
        if r[s] < p:                       # 확률 p 로 규모 1 의 새 기업
            owner[s] = len(birth)
            birth.append(s)
        else:                              # 확률 1-p 로 뽑힌 단위의 주인에게
            owner[s] = owner[int(pick[s] * s)]
    return np.bincount(owner), np.array(birth)


TSIM = 100_000
SIZES, BIRTH, AGE = {}, {}, {}
for p in (0.1, 0.5):
    SIZES[p], BIRTH[p] = simon(p, TSIM)
    sz, bt = SIZES[p], BIRTH[p]
    m = (bt >= int(TSIM * 0.009)) & (bt < int(TSIM * 0.011))    # t_i ≈ t/100 에 진입
    AGE[p] = sz[m].mean()
    print(f'p = {p}:  기업 수 {sz.size} (평균장 p·t = {p * TSIM:.0f}) · '
          f'규모 1 비율 {np.mean(sz == 1):.3f} (이론 1/(2-p) = {1 / (2 - p):.3f})')
    print(f'          t_i≈t/100 진입 {int(m.sum())}개의 평균 규모 {AGE[p]:.1f} '
          f'(평균장 (t/t_i)^(1-p) = {100 ** (1 - p):.1f})')
p = 0.1: 기업 수 10217 (평균장 p·t = 10000) · 규모 1 비율 0.524 (이론 1/(2-p) = 0.526)
t_i≈t/100 진입 20개의 평균 규모 58.7 (평균장 (t/t_i)^(1-p) = 63.1)
p = 0.5: 기업 수 50143 (평균장 p·t = 50000) · 규모 1 비율 0.668 (이론 1/(2-p) = 0.667)
t_i≈t/100 진입 102개의 평균 규모 11.0 (평균장 (t/t_i)^(1-p) = 10.0)
# 정확식 Pr(K≥k) = ζB(k,ζ) 를 math.lgamma 로 만들고 국소 기울기를 잰다.
def yule_ccdf(k, zeta):
    return np.array([zeta * exp(lgamma(kk) + lgamma(zeta) - lgamma(kk + zeta))
                     for kk in np.atleast_1d(k)])


def ccdf_emp(sizes):
    cnt = np.bincount(sizes)[1:]
    return np.arange(1, cnt.size + 1), np.cumsum(cnt[::-1])[::-1] / sizes.size


CC, SL = {}, {}
print(f"{'p':>5}{'zeta':>8}{'k':>6}{'정확식 G':>11}{'경험 G':>11}{'국소 기울기':>13}{'순수 멱':>10}")
for p in (0.1, 0.5):
    z = 1.0 / (1.0 - p)
    CC[p] = ccdf_emp(SIZES[p])
    for k in (5, 50):
        h = 1e-4                           # d ln G / d ln k 를 중심차분으로
        g = yule_ccdf([k - h, k + h], z)
        SL[(p, k)] = k * (log(g[1]) - log(g[0])) / (2 * h)
        print(f'{p:5}{z:8.3f}{k:6d}{yule_ccdf(k, z)[0]:11.4f}{CC[p][1][k - 1]:11.4f}'
              f'{SL[(p, k)]:13.2f}{-z:10.2f}')
p zeta k 정확식 G 경험 G 국소 기울기 순수 멱
0.1 1.111 5 0.1739 0.1774 -1.10 -1.11
0.1 1.111 50 0.0136 0.0144 -1.11 -1.11
0.5 2.000 5 0.0667 0.0665 -1.83 -2.00
0.5 2.000 50 0.0008 0.0007 -1.98 -2.00
# Simon 규모 분포를 로그–로그로 — 시뮬레이션 점, 정확식 실선, 평균장 순수 멱 점선.
fig, ax = plt.subplots(figsize=(6.2, 4.2))
for p, col in [(0.1, 'C0'), (0.5, 'C3')]:
    z = 1.0 / (1.0 - p)
    ks, tail = CC[p]
    idx = np.unique(np.round(np.logspace(0, np.log10(ks.max()), 50)).astype(int)) - 1
    idx = idx[(idx < ks.size) & (tail[np.minimum(idx, ks.size - 1)] >= 3.0 / SIZES[p].size)]
    ax.plot(ks[idx], tail[idx], 'o', ms=3.5, mfc='none', color=col, label=f'$p={p}$ 시뮬레이션')
    kk = np.arange(1, ks.max() + 1)
    ax.plot(kk, yule_ccdf(kk, z), color=col, lw=1.5,
            label=rf'$p={p}$ 정확식 $\zeta B(k,\zeta)$, $\zeta={z:.2f}$')
    ax.plot(kk, kk ** (-z), color='k', ls=':', lw=1.0)
ax.set_xscale('log')
ax.set_yscale('log')
pow10_axes(ax)
ax.set_xlabel('규모 $k$ (로그)')
ax.set_ylabel(r'$\Pr(K\geq k)$ (로그)')
ax.set_title(r'점선은 평균장 순수 멱 $k^{-\zeta}$ — 지수는 같고 작은 $k$ 의 형태가 다르다',
             fontsize=10)
ax.legend(fontsize=8, loc='lower left')
fig.tight_layout()
plt.show()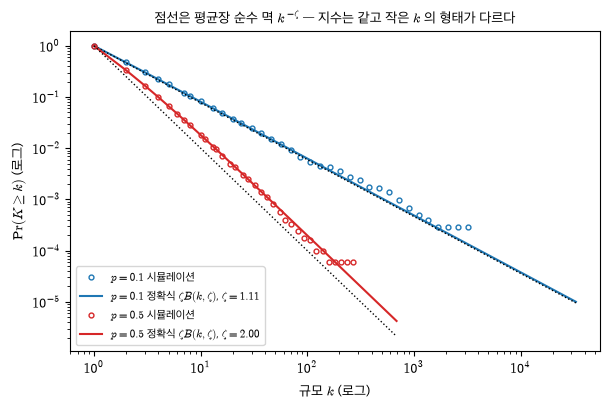
# 대조 표에 옮길 수치를 예측 항목 순서로 모은다.
a, b = (1.2, 0.8), (1.2, 0.75)
print(f'예측 1 — 회귀 기울기 {SLOPE[a]:.3f} · {SLOPE[b]:.3f} '
      f'(이분법 근 {-ZETA[a]:.3f} · {-ZETA[b]:.3f}, 정규 공식 {2 * cumulants(*b)[0] / cumulants(*b)[1]:.3f}) / '
      f'벽 비율 {WALL[a]:.1%} · {WALL[b]:.1%}')
print(f'예측 2 — 벽 없음 Var[y] T=1000 {REC[a][1000][1]:.2f} (이론 {1000 * cumulants(*a)[1]:.2f}), '
      f'T=2000 {REC[a][2000][1]:.2f} / 벽 있음 포화 {REC[a][2000][0]:.3f} · {REC[b][2000][0]:.3f} '
      f'(1/ζ² {1 / ZETA[a] ** 2:.3f} · {1 / ZETA[b] ** 2:.3f})')
print(f'예측 3 — 규모 1 비율 {np.mean(SIZES[0.1] == 1):.3f} · {np.mean(SIZES[0.5] == 1):.3f} / '
      f'국소 기울기 p=0.1 k=50 {SL[(0.1, 50)]:.2f}, p=0.5 k=5 {SL[(0.5, 5)]:.2f}, '
      f'k=50 {SL[(0.5, 50)]:.2f} / t/100 진입 평균 규모 {AGE[0.1]:.1f} · {AGE[0.5]:.1f}')
예측 1 — 회귀 기울기 -0.988 · -1.949 (이분법 근 -1.000 · -1.975, 정규 공식 -1.908) / 벽 비율 13.8% · 25.8%
예측 2 — 벽 없음 Var[y] T=1000 40.56 (이론 41.10), T=2000 82.01 / 벽 있음 포화 1.014 · 0.258 (1/ζ² 1.000 · 0.256)
예측 3 — 규모 1 비율 0.524 · 0.668 / 국소 기울기 p=0.1 k=50 -1.11, p=0.5 k=5 -1.83, k=50 -1.98 / t/100 진입 평균 규모 58.7 · 11.0
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w19-7)·(eq-w19-9)로, 2번은 (eq-w19-4)·(eq-w19-5)로, 3번은 (eq-w19-13)·(eq-w19-14)로 돌아간다.