노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다. 답은 본문 3절의 식과 표에서 전부 읽어 낼 수 있어야 하며, 읽어 내지 못하는 항목이 있으면 그 자리가 이번 주의 구멍이다.
표본 에서 표본평균·표본분산·표본 4차 모멘트 중 어느 것이 수렴하는가. 4차 모멘트는 이 10배 될 때 대략 몇 배가 되는가. 시드를 바꾸면 어느 것이 가장 크게 달라지는가.
예측: ____
같은 표본의 경험적 ·는 이론값 4.642·6.962에 맞는가. 비율은 에서 모두 1.5 근처인가. 표본은 1.434·1.217·1.145로 1에 접근하는가.
예측: ____
상위 개로 계산한 Hill 추정량 는 3 근처인가. 최댓값은 을 1,000배 할 때 몇 배가 되는가.
예측: ____
2. 계산
난수 생성기가 돌려주는 분포 함수는 답이 아니다. 역함수법·누적합·정렬을 직접 쌓는다.
# 도구를 올린다 — 값은 아래 셀들에서 직접 쌓는다
import math
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager
from matplotlib.ticker import FuncFormatter

# 한국어 글꼴을 후보 목록에서 있는 것으로 고른다
_cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
_have = {f.name for f in font_manager.fontManager.ttflist}
for _f in _cands:
    if _f in _have:
        plt.rcParams['font.family'] = _f
        break
plt.rcParams['axes.unicode_minus'] = False
# 로그 축의 지수 라벨은 직접 만든다 — 기본 포맷터의 음수 기호가 한국어 글꼴에 없다
LOGFMT = FuncFormatter(lambda v, _: '$10^{%d}$' % round(math.log10(v)))
XM, ZETA = 1.0, 3.0
NMAX, SEEDS = 10 ** 6, list(range(5))
GRID = np.array([10 ** k for k in range(2, 7)])

# 역함수법으로 표본을 손으로 쌓는다 — Pareto는 U^{-1/ζ}, 지수는 -ln(1-U)/λ
def pareto(n, seed, xm=XM, z=ZETA):
    return xm * np.random.default_rng(seed).random(n) ** (-1.0 / z)

def expo(n, seed, lam=1.0):
    return -np.log1p(-np.random.default_rng(1000 + seed).random(n)) / lam

# 표본 크기 ns에서의 running 평균·분산·4차 모멘트를 누적합으로 쌓는다
def run_moments(x, ns):
    i = np.asarray(ns) - 1
    m1 = np.cumsum(x)[i] / ns
    return m1, np.cumsum(x ** 2)[i] / ns - m1 ** 2, np.cumsum(x ** 4)[i] / ns

print('글꼴:', plt.rcParams['font.family'][0])
글꼴: Apple SD Gothic Neo
# 예측 1 — 시드 0에서 N별 표본평균·표본분산·4차 모멘트·표본 첨도를 쌓는다
x = pareto(NMAX, 0)
m1, var, m4 = run_moments(x, GRID)
m2, m3 = np.cumsum(x ** 2)[GRID - 1] / GRID, np.cumsum(x ** 3)[GRID - 1] / GRID
kurt = (m4 - 4 * m1 * m3 + 6 * m1 ** 2 * m2 - 3 * m1 ** 4) / var ** 2
print(f"{'N':>9}{'표본평균':>12}{'표본분산':>12}{'4차 모멘트':>16}{'표본 첨도':>13}")
for i, n in enumerate(GRID):
    print(f'{n:9d}{m1[i]:12.4f}{var[i]:12.4f}{m4[i]:16.2f}{kurt[i]:13.1f}')
print(f'{"이론":>9}{ZETA / (ZETA - 1):12.4f}'
      f'{ZETA / ((ZETA - 1) ** 2 * (ZETA - 2)):12.4f}{"∞":>16}{"∞":>13}')
N 표본평균 표본분산 4차 모멘트 표본 첨도
100 1.4779 0.6740 38.57 25.2
1000 1.4940 1.0828 235.27 129.0
10000 1.5003 0.6828 94.03 114.6
100000 1.4998 0.7446 373.58 552.1
1000000 1.5000 0.7333 397.63 621.5
이론 1.5000 0.7500 ∞ ∞
# 시드 다섯 벌을 같은 격자에서 쌓아 시드 간 폭과 4차 모멘트의 성장 배율을 본다
M1 = np.zeros((len(SEEDS), len(GRID)))
V2 = np.zeros_like(M1)
M4 = np.zeros_like(M1)
for s in SEEDS:
    M1[s], V2[s], M4[s] = run_moments(pareto(NMAX, s), GRID)
print(f"{'N':>9}{'표본평균 폭':>20}{'표본분산 폭':>20}{'4차 모멘트 폭':>28}")
for j, n in enumerate(GRID):
    print(f'{n:9d}{M1[:, j].min():9.3f}–{M1[:, j].max():<9.3f}'
          f'{V2[:, j].min():9.3f}–{V2[:, j].max():<9.3f}'
          f'{M4[:, j].min():13.1f}–{M4[:, j].max():<13.1f}')

g = M4[:, 1:] / M4[:, :-1]
print()
print('N을 10배 할 때 4차 모멘트의 배율 (시드별)')
for s in SEEDS:
    print(f'  시드 {s}: ' + '  '.join(f'{v:7.2f}' for v in g[s]))
print(f'예측 규모 10^(1/3) = {10 ** (1 / 3):.2f}    실제 범위 {g.min():.2f}–{g.max():.2f}')
print(f'N=10^6 시드 간 최대/최소 — 평균 {M1[:, -1].max() / M1[:, -1].min():.2f}배, '
      f'분산 {V2[:, -1].max() / V2[:, -1].min():.2f}배, 4차 {M4[:, -1].max() / M4[:, -1].min():.2f}배')
N 표본평균 폭 표본분산 폭 4차 모멘트 폭
100 1.358–1.541 0.149–0.708 5.7–65.4
1000 1.467–1.506 0.438–1.083 22.2–235.3
10000 1.496–1.520 0.669–0.860 94.0–220.7
100000 1.498–1.505 0.689–0.887 184.7–1717.9
1000000 1.499–1.500 0.722–0.790 348.4–5109.9
N을 10배 할 때 4차 모멘트의 배율 (시드별)
시드 0: 6.10 0.40 3.97 1.06
시드 1: 0.89 4.51 17.14 0.20
시드 2: 1.05 5.10 1.39 27.67
시드 3: 0.66 5.13 1.81 2.23
시드 4: 8.01 2.87 6.72 0.49
예측 규모 10^(1/3) = 2.15 실제 범위 0.20–27.67
N=10^6 시드 간 최대/최소 — 평균 1.00배, 분산 1.09배, 4차 14.67배
# 세 모멘트의 running 곡선을 시드 다섯 벌로 겹쳐 그린다
NS = np.unique(np.logspace(2, 6, 90).astype(int))
cur = [run_moments(pareto(NMAX, s), NS) for s in SEEDS]
fig, axes = plt.subplots(1, 3, figsize=(10.8, 3.4))
for a, b, c in cur:
    axes[0].plot(NS, a, lw=0.9)
    axes[1].plot(NS, b, lw=0.9)
    axes[2].plot(NS, c, lw=0.9)
axes[0].axhline(ZETA / (ZETA - 1), ls='--', color='k', lw=1.0)
axes[1].axhline(ZETA / ((ZETA - 1) ** 2 * (ZETA - 2)), ls='--', color='k', lw=1.0)
ref = np.median([c for _, _, c in cur], axis=0)
axes[2].plot(NS, ref[0] * (NS / NS[0]) ** (1 / ZETA), ls='--', color='k', lw=1.0)
titles = ['(a) 표본평균 — 1.5로', '(b) 표본분산 — 0.75로', '(c) 4차 모멘트 — 점선은 $N^{1/3}$']
for ax, t in zip(axes, titles):
    ax.set_xscale('log')
    ax.set_xlabel('표본 크기 $N$')
    ax.set_title(t, fontsize=10)
axes[0].set_ylim(1.1, 2.2)
axes[1].set_ylim(0.2, 1.8)
axes[2].set_yscale('log')
plt.tight_layout()
plt.show()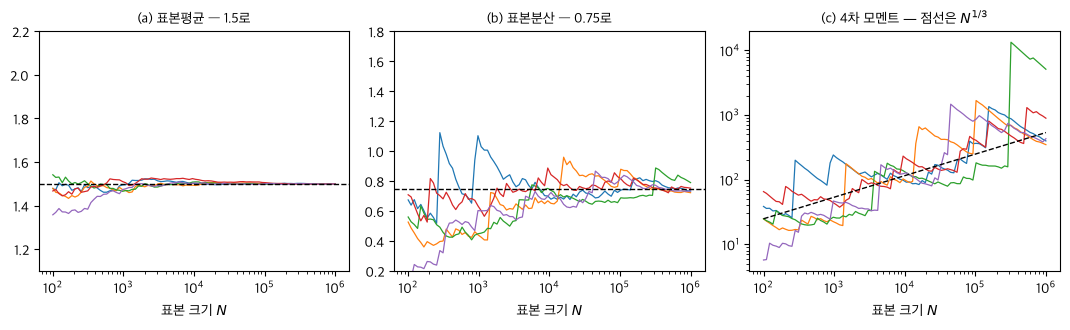
예측 2. 경험적 VaR은 정렬 후 번째 값, ES는 그 위의 산술평균이다. 분위수 함수를 부르지 않는다. 3절 수치 표는 정규 을 이분법으로 다시 만들어 재현한다.
# 예측 2 — 경험적 VaR은 정렬 후 ⌈αN⌉번째 값, ES는 그 위의 산술평균으로 쌓는다
def emp_var_es(v, a):
    s = np.sort(v)
    k = int(np.ceil(a * len(v)))
    return s[k - 1], s[k:].mean()


ALPHAS = [0.9, 0.99, 0.999]
xp, xe = pareto(NMAX, 0), expo(NMAX, 0)
print(f"{'α':>7}{'VaR 표본':>12}{'VaR 이론':>12}{'ES 표본':>12}{'ES 이론':>12}"
      f"{'비율 표본':>12}{'비율 이론':>12}")
print('Pareto ζ=3  (N=10^6)')
for a in ALPHAS:
    v, e = emp_var_es(xp, a)
    vt = XM * (1 - a) ** (-1 / ZETA)
    print(f'{a:7.3f}{v:12.3f}{vt:12.3f}{e:12.3f}{ZETA / (ZETA - 1) * vt:12.3f}'
          f'{e / v:12.3f}{ZETA / (ZETA - 1):12.3f}')
print('Exp(1)  (N=10^6)')
for a in ALPHAS:
    v, e = emp_var_es(xe, a)
    vt = -math.log(1 - a)
    print(f'{a:7.3f}{v:12.3f}{vt:12.3f}{e:12.3f}{vt + 1:12.3f}'
          f'{e / v:12.3f}{(vt + 1) / vt:12.3f}')
α VaR 표본 VaR 이론 ES 표본 ES 이론 비율 표본 비율 이론
Pareto ζ=3 (N=10^6)
0.900 2.156 2.154 3.232 3.232 1.499 1.500
0.990 4.641 4.642 6.980 6.962 1.504 1.500
0.999 10.054 10.000 15.145 15.000 1.506 1.500
Exp(1) (N=10^6)
0.900 2.306 2.303 3.306 3.303 1.433 1.434
0.990 4.613 4.605 5.609 5.605 1.216 1.217
0.999 6.905 6.908 7.894 7.908 1.143 1.145
# 정규 분위수를 이분법으로 직접 만든다 — Φ는 math.erf, φ는 손으로
def Phi(z):
    return 0.5 * (1.0 + math.erf(z / math.sqrt(2.0)))


def phi(z):
    return math.exp(-0.5 * z * z) / math.sqrt(2.0 * math.pi)


def norm_q(a, lo=-12.0, hi=12.0):
    for _ in range(120):
        mid = 0.5 * (lo + hi)
        lo, hi = (mid, hi) if Phi(mid) < a else (lo, mid)
    return 0.5 * (lo + hi)


# 세 분포의 VaR·ES를 폐형식과 이분법으로 함께 쌓는다
def var_es(name, a):
    if name == 'N':
        v = norm_q(a)
        return v, phi(v) / (1 - a)
    if name == 'E':
        v = -math.log(1 - a)
        return v, v + 1.0
    z = float(name)
    v = XM * (1 - a) ** (-1 / z)
    return v, z / (z - 1) * v


print(f'Φ(2.326348) = {Phi(2.326348):.6f}   Φ^(-1)(0.99) = {norm_q(0.99):.6f}')
print(f'φ(Φ^(-1)(0.99)) / 0.01 = {phi(norm_q(0.99)) / 0.01:.6f}')
Φ(2.326348) = 0.990000 Φ^(-1)(0.99) = 2.326348
φ(Φ^(-1)(0.99)) / 0.01 = 2.665214
# 3절 수치 표를 네 분포에서 다시 쌓는다 — 소수 셋째 자리까지 대조한다
COLS = [('N', '정규'), ('E', 'Exp(1)'), ('3', 'Pareto ζ=3'), ('1.5', 'Pareto ζ=1.5')]
r99 = [var_es(c, 0.99) for c, _ in COLS]
r975 = [var_es(c, 0.975) for c, _ in COLS]
rows = [('VaR(0.99)', [v for v, _ in r99]),
        ('ES(0.99)', [e for _, e in r99]),
        ('ES/VaR (0.99)', [e / v for v, e in r99]),
        ('VaR(0.975)', [v for v, _ in r975]),
        ('ES(0.975)', [e for _, e in r975]),
        ('ES(0.975)/VaR(0.99)', [b[1] / a[0] for a, b in zip(r99, r975)])]
print(f"{'':>21}" + ''.join(f'{nm:>15}' for _, nm in COLS))
for lab, vals in rows:
    print(f'{lab:>21}' + ''.join(f'{v:15.3f}' for v in vals))
print()
print('존재하는 모멘트 — 정규·Exp(1)은 모든 n, Pareto는 n < ζ (각각 n<3, n<1.5)')
정규 Exp(1) Pareto ζ=3 Pareto ζ=1.5
VaR(0.99) 2.326 4.605 4.642 21.544
ES(0.99) 2.665 5.605 6.962 64.633
ES/VaR (0.99) 1.146 1.217 1.500 3.000
VaR(0.975) 1.960 3.689 3.420 11.696
ES(0.975) 2.338 4.689 5.130 35.088
ES(0.975)/VaR(0.99) 1.005 1.018 1.105 1.629
존재하는 모멘트 — 정규·Exp(1)은 모든 n, Pareto는 n < ζ (각각 n<3, n<1.5)
# 왼쪽은 log-log 생존함수, 오른쪽은 α에 대한 ES/VaR 비율을 쌓아 그린다
K, st = 200_000, 50
rr = np.arange(1, K + 1, st) / NMAX
fig, axes = plt.subplots(1, 2, figsize=(9.6, 3.6))
axes[0].plot(np.sort(xp)[::-1][:K:st], rr, lw=1.3, label='Pareto $\\zeta=3$ 표본')
axes[0].plot(np.sort(xe)[::-1][:K:st], rr, lw=1.3, label='Exp(1) 표본')
gx = np.logspace(0, 2.2, 60)
axes[0].plot(gx, gx ** (-ZETA), ls='--', color='k', lw=1.0, label='기울기 $-3$')
axes[0].set_xscale('log')
axes[0].set_yscale('log')
axes[0].yaxis.set_major_formatter(LOGFMT)
axes[0].set_xlabel('손실 $x$')
axes[0].set_ylabel('생존함수 $\\bar F(x)$')
axes[0].set_title('(a) log-log 생존함수', fontsize=10)
axes[0].legend(fontsize=8)
aa = np.linspace(0.8, 0.9995, 300)
for nm, lab in COLS[:3]:
    vv = [var_es(nm, a) for a in aa]
    axes[1].plot(aa, [e / v for v, e in vv], lw=1.3, label=lab)
axes[1].axhline(ZETA / (ZETA - 1), ls=':', color='gray', lw=1.0, zorder=0)
axes[1].scatter([0.99] * 3, [e / v for v, e in r99[:3]], s=18, color='k', zorder=3)
axes[1].set_xlabel('신뢰수준 $\\alpha$')
axes[1].set_ylabel('$\\mathrm{ES}_\\alpha/\\mathrm{VaR}_\\alpha$')
axes[1].set_title('(b) 비율 — 멱법칙은 상수, 지수·정규는 1로', fontsize=10)
axes[1].legend(fontsize=8)
plt.tight_layout()
plt.show()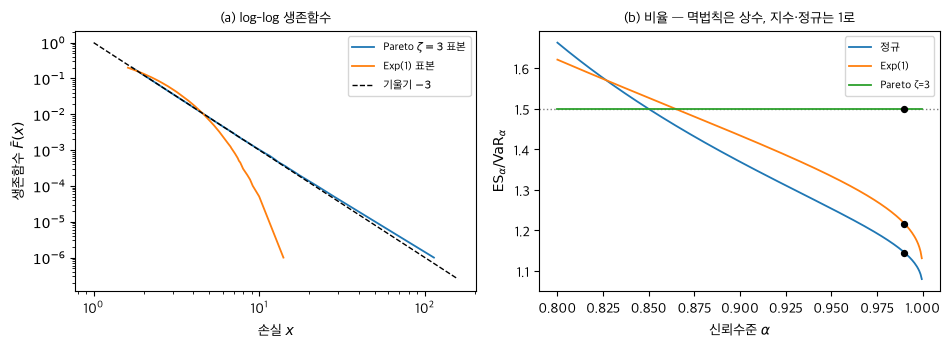
예측 3. Hill 추정량은 내림차순 정렬 에서 이다. 최댓값의 규모는 (13)의 다.
# 예측 3 — Hill 추정량과 최댓값의 규모를 정렬만으로 쌓는다
def hill(v, k):
    s = np.sort(v)[::-1]
    return 1.0 / np.mean(np.log(s[:k]) - np.log(s[k]))


N5 = 10 ** 5
print(f"{'시드':>6}{'k=N/1000':>12}{'k=N/100':>12}{'k=N/10':>12}{'최댓값':>12}")
for s in SEEDS:
    xs = pareto(N5, s)
    print(f'{s:6d}' + ''.join(f'{hill(xs, N5 // d):12.3f}' for d in (1000, 100, 10))
          + f'{xs.max():12.2f}')
print(f'{"이론":>6}{ZETA:12.3f}{ZETA:12.3f}{ZETA:12.3f}')

mx = {}
print()
print(f"{'N':>9}{'최댓값 중앙값':>17}{'예측 N^(1/3)':>17}{'시드 20벌 범위':>24}")
for n in [10 ** 3, 10 ** 4, 10 ** 5, 10 ** 6]:
    mx[n] = np.array([pareto(n, s).max() for s in range(20)])
    print(f'{n:9d}{np.median(mx[n]):17.1f}{n ** (1 / ZETA):17.1f}'
          f'{mx[n].min():11.1f}–{mx[n].max():<11.1f}')
print(f'N을 1,000배 할 때 중앙값 배율 = '
      f'{np.median(mx[10 ** 6]) / np.median(mx[10 ** 3]):.2f}   (예측 1000^(1/3) = 10)')
시드 k=N/1000 k=N/100 k=N/10 최댓값
0 2.506 3.057 3.080 65.92
1 2.418 2.966 2.987 109.05
2 3.247 3.001 3.030 54.13
3 2.408 2.786 3.004 52.53
4 2.725 2.910 3.032 86.50
이론 3.000 3.000 3.000
N 최댓값 중앙값 예측 N^(1/3) 시드 20벌 범위
1000 9.8 10.0 5.3–90.3
10000 21.4 21.5 14.8–97.6
100000 53.3 46.4 35.9–134.2
  1000000            106.9            100.0       60.5–255.1
N을 1,000배 할 때 중앙값 배율 = 10.94   (예측 1000^(1/3) = 10)
# 왼쪽은 k에 대한 Hill 추정량, 오른쪽은 최댓값의 규모를 쌓아 그린다
ks = np.unique(np.logspace(1, 4, 40).astype(int))
fig, axes = plt.subplots(1, 2, figsize=(9.6, 3.6))
for s in SEEDS:
    xs = np.sort(pareto(N5, s))[::-1]
    axes[0].plot(ks, [1.0 / np.mean(np.log(xs[:k]) - np.log(xs[k])) for k in ks], lw=0.9)
axes[0].axhline(ZETA, ls='--', color='k', lw=1.0)
axes[0].set_xscale('log')
axes[0].set_xlabel('상위 관측 수 $k$')
axes[0].set_ylabel('$\\hat\\zeta_k$')
axes[0].set_title('(a) Hill 추정량 — $N=10^5$, 시드 다섯', fontsize=10)
ns = np.array(sorted(mx))
axes[1].fill_between(ns, [mx[n].min() for n in ns], [mx[n].max() for n in ns],
                     alpha=0.18, color='gray')
axes[1].plot(ns, [np.median(mx[n]) for n in ns], 'o-', lw=1.3, label='최댓값 중앙값')
axes[1].plot(ns, math.log(2.0) ** (-1 / ZETA) * ns ** (1 / ZETA), ls='--', color='k', lw=1.0,
             label='$(\\ln 2)^{-1/3}N^{1/3}$')
axes[1].set_xscale('log')
axes[1].set_yscale('log')
axes[1].set_xlabel('표본 크기 $N$')
axes[1].set_ylabel('최댓값')
axes[1].set_title('(b) 최댓값은 $N^{1/\\zeta}$ 규모', fontsize=10)
axes[1].legend(fontsize=8)
plt.tight_layout()
plt.show()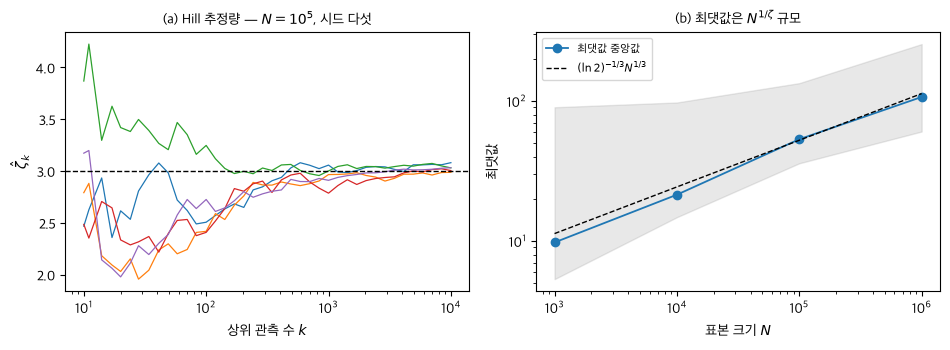
# 예측 항목 세 개에 대응하는 수치를 한자리에 모은다
print(f'[예측 1] N=10^6 — 표본평균 {M1[:, -1].min():.3f}–{M1[:, -1].max():.3f} (이론 1.500), '
      f'표본분산 {V2[:, -1].min():.3f}–{V2[:, -1].max():.3f} (이론 0.750)')
print(f'         4차 모멘트 {M4[:, -1].min():.0f}–{M4[:, -1].max():.0f} (이론 없음), '
      f'시드 0 표본 첨도 {kurt[-1]:.0f}')
print(f'         10배 성장 배율 {g.min():.2f}–{g.max():.2f}, 중앙값 {np.median(g):.2f} '
      f'(예측 규모 2.15)')
vp = [emp_var_es(xp, a) for a in ALPHAS]
ve = [emp_var_es(xe, a) for a in ALPHAS]
print(f'[예측 2] Pareto VaR(0.99) {vp[1][0]:.3f} (이론 4.642), ES(0.99) {vp[1][1]:.3f} (이론 6.962)')
print('         ES/VaR — Pareto ' + ' · '.join(f'{e / v:.3f}' for v, e in vp)
      + '   Exp(1) ' + ' · '.join(f'{e / v:.3f}' for v, e in ve) + '   (α=0.9, 0.99, 0.999)')
hs = [hill(pareto(N5, s), N5 // 100) for s in SEEDS]
print(f'[예측 3] Hill(k=N/100, N=10^5) — ' + ' · '.join(f'{h:.3f}' for h in hs)
      + f'   평균 {np.mean(hs):.3f}')
print(f'         최댓값 중앙값 {np.median(mx[10 ** 3]):.1f} (N=10^3) → '
      f'{np.median(mx[10 ** 6]):.1f} (N=10^6) = {np.median(mx[10 ** 6]) / np.median(mx[10 ** 3]):.2f}배'
      f' (예측 10배)')
[예측 1] N=10^6 — 표본평균 1.499–1.500 (이론 1.500), 표본분산 0.722–0.790 (이론 0.750)
4차 모멘트 348–5110 (이론 없음), 시드 0 표본 첨도 622
10배 성장 배율 0.20–27.67, 중앙값 2.55 (예측 규모 2.15)
[예측 2] Pareto VaR(0.99) 4.641 (이론 4.642), ES(0.99) 6.980 (이론 6.962)
         ES/VaR — Pareto 1.499 · 1.504 · 1.506   Exp(1) 1.433 · 1.216 · 1.143   (α=0.9, 0.99, 0.999)
[예측 3] Hill(k=N/100, N=10^5) — 3.057 · 2.966 · 3.001 · 2.786 · 2.910   평균 2.944
         최댓값 중앙값 9.8 (N=10^3) → 106.9 (N=10^6) = 10.94배 (예측 10배)
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w18-4)·(eq-w18-14)로, 2번은 (eq-w18-9)·(eq-w18-11)·(eq-w18-12)로, 3번은 (eq-w18-13)으로 돌아간다.