Zipf 법칙의 지수는 왜 하필 1 근처인가. 다른 분포의 지수는 왜 예쁜 유리수가 아닌가.
log-log 회귀가 -1.06을 돌려준다. 그 숫자는 자료가 정한 것인가, 자료를 만든 과정이 정한 것인가.
미국 기업규모 분포의 순위–규모 그림은 로그–로그에서 직선이고 기울기는 -1에 가깝다 — 절댓값 약 1.06 Axtell, 2001. 이 그림을 다시 그리고 기울기에 표준오차를 다는 일은 학부 회귀로 된다. 회귀표의 기울기·표준오차·결정계수 칸까지는 채워진다. 막히는 줄은 그 아래 — 기울기가 왜 그 값이어야 하는지를 묻는 줄이다. 그 다음 Gabaix (1999)를 편다. 명제 하나가 나온다 — 정상분포는 Pareto이고, 그 지수는 표류와 분산의 비로 정해지며, 정규화된 규모의 평균 성장률이 0이면 지수가 1이다. 여기서 멈춘다. 회귀 기울기가 왜 두 모수의 비여야 하는지, 왜 그 비가 1에 붙는지가 보이지 않는다. 회귀는 지수를 추정할 모수로 다루었고, 논문은 지수를 풀어서 나오는 값으로 다룬다. 두 읽기 사이에 다리가 없다.
같은 장면의 실무 변형. 리스크 관리자가 1일 VaR에 10을 곱해 10일 VaR을 만든다. 그 1/2은 어디서 왔는가. 같은 사람이 수익률의 꼬리지수를 3 근처로 추정한다(W18). 그 3은 차원표에서 읽히는 수인가, 어떤 과정이 풀어 주는 수인가. 두 지수는 같은 이름을 달고 있지만 출처가 다르다. 1/2은 분산율의 단위가 1/시간이고 증분이 독립이라는 데서 나온다 — 차원표와 가정 하나로 읽힌다. 3은 어떤 식의 근이다 — 차원표 어디에도 없다. 회귀표는 두 숫자를 같은 칸에 적기 때문에 눈에는 같은 종류로 보인다. 이 회차는 그 3이 무엇인지 답하지 않는다. 두 출처를 가르는 법 — 차원표를 먼저 보고, 차원표에 없으면 어떤 식의 근인지를 묻는 순서 — 을 준다.
Zipf가 도시 인구에서, Pareto가 소득에서 본 직선은 백 년 넘게 같은 자리에 서 있다Zipf, 1949Pareto, 1896. 직선을 보는 눈은 학부에서 생긴다. 직선의 기울기가 어디서 오는지를 묻는 눈은 따로 만들어야 한다. 회귀를 아무리 많이 돌려도 그 눈은 생기지 않는다.
이 회차가 메우는 결핍은 하나다. 지수를 추정할 줄은 알지만, 그 지수가 차원에서 읽히는 것인지 생성 과정이 풀어 주는 고유값인지를 가르지 못한다.
규모의 단위 [규모]는 종업원 수([명])이든 매출([화폐/시간])이든 상관없다 — 이 회차의 결과는 단위에 불변이다(4절 Q6). 시간은 둘로 나눠 적는다. 기간 번호 t는 정수이고, 기간 길이 Δ와 지평 T=nΔ는 실수 시간이다 — W09 (1)과 (2)의 관계 그대로다. 로그 성장률의 평균·분산은 W09의 δ·δΔ 규약과 같은 방향으로 적는다. 단위시간당 율 μ, σ2가 기본이고 기간당 값은 첨자 Δ를 붙여 μΔ=μΔ, σΔ2=σ2Δ로 쓴다.
변수·파라미터·결과. St, xt는 변수이고 Smin·μ·σ2·p는 파라미터다. ζ·γ·θ∗는 파라미터가 아니라 결과다 — 모형이 (7)을 풀어 돌려주는 수. 학부 읽기는 ζ를 추정할 모수로 보고, 여기서는 — 로그정규면 — ζ=ζ(μ/σ2)라는 함수값으로 본다. 이 구분이 5절 간극의 내용이다. Smin은 W17·W18의 xm 자리다 — 반사벽이라는 이름만 새것이고, (9)의 밀도 계수 CζSminζ은 C=1일 때 W18 (2)의 (γ−1)xmγ−1과 같은 계산이다. (1)의 ∝는 점근 ∼의 뜻이다. 정확한 등식은 3절 정리 (ii)(a)의 가설 아래에서만, 그리고 연속시간 극한에서만 성립한다. 일반형은 lims→∞(s/Smin)ζPr(S>s)=C다.
같은 글자, 다른 이름. (a) γ — W13에서는 상대적 위험회피도였고, W17부터는 밀도 꼬리지수다. 여기서도 W18과 같은 뜻이다. (b) σ — W09 (3)의 σ는 수준의 확산계수 [화폐·시간−1/2]이고, 여기 σ는 로그의 확산계수 [시간−1/2] — 같은 자리, 다른 차원. (c) μ — 로그 성장률의 표류율이다. 수준 성장률의 평균 E[g]와 다르다. 로그정규면 E[1+g]=eμΔ+σΔ2/2다. Gabaix (1999)의 μ는 수준 표류 μG=μ+σ2/2이므로 그 논문의 ζ=1−2μG/σ2와 이 회차의 ζ=−2μ/σ2는 같은 식이다. (d) p — W01·W04의 가격 벡터가 아니라 확률이다. p/(1−p)는 진입의 오즈(odds)이고, (2)는 "γ−2는 진입 오즈"로 읽힌다. (e) t — Simon 과정에서는 시각이면서 동시에 총 규모다. 한 스텝에 한 단위가 들어오므로 t스텝 뒤 총 규모가 t다. (f) α는 W02·W10의 자본분배율이고 이 회차에서는 쓰지 않는다. 상사 지수(Definition 1)는 ν로 쓴다 — W02의 동차 차수 ν와 같은 구실, 멱의 차수다. (g) θ는 적률생성함수의 인수이자 고유값 변수이며 W05의 파라미터 θ·W17의 Calvo 확률 θ와 다른 글자다. (h) u, d는 W15의 상승·하락 배수와 같은 역할이되 여기서는 성장 배율이고, 확률은 21로 고정한다. (i) gt는 W17의 곱셈 비율 함수 g(b)와 다른 글자, Δ는 W09의 기간 길이(W17의 이동량이 아니다), St는 W14·W15의 주가가 아니라 규모다. δ는 4절에서 퇴출률로 한 번 쓰며 W09–W12의 감가상각률과 다른 뜻이다. (j) C — W18 (2)의 C=(γ−1)xmγ−1은 밀도의 규격화 상수(차원 [X]γ−1)이고, 여기 C는 (s/Smin)−ζ 앞의 무차원 상수로, 이산시간의 경계층 때문에 1 아래로 내려간다(연속시간 극한에서 1). K는 W02·W09–W12의 자본이 아니라 Simon 과정의 규모 확률변수이고, xt는 W17·W18의 규모 x가 아니라 로그 규모다. λ·β는 이 회차에 쓰지 않는다.
첨자 t와 충격의 크기. St의 t는 정수 기간 번호이고 T=nΔ는 실수 시간이다. εt는 평균 μΔ를 가진다 — W09 (14)의 표준정규 εj와 대응시키려면 εt=μΔ+σΔεtstd 꼴이라야 한다(3절 (4)). 표류는 Δ에, 충격은 Δ에 비례한다는 W09의 차수가 여기서도 그대로다.
A2 (Gibrat — 규모와 무관한 i.i.d. 성장) — g1,g2,…는 i.i.d.이고 gt는 (S0,…,St)와 독립이다. μΔ:=E[εt], σΔ2:=Var[εt]∈(0,∞). 기간 Δ에 대해 μΔ=μΔ, σΔ2=σ2Δ.
A3 (적률생성함수와 양의 성장) — M(θ)=E[eθεt]<∞ (모든 θ≥0), Pr(εt>0)>0, εt는 비격자(non-lattice). 정리 (ii)(a)에서만 추가로 유계 εt≤εmax<∞를 쓴다. 유계 분포는 적률생성함수 조건과 유계를 저절로 만족하고, 두 점 분포는 lnu/lnd가 무리수일 때 비격자다 — 이 회차의 (u,d) 넷은 모두 그렇다; u=1/d 같은 격자 경우는 (ii)(b)에서 제외된다. 정규분포는 유계만 빼고 만족한다.
A4 (음의 로그 표류) — μ<0. 벽이 없으면 규모가 0으로 가는 세계다. 벽이 있어야 정상분포가 생긴다.
A5 (정상분포) — (3)의 xt는 유일한 정상분포 π를 갖고, G(y):=Prπ(x>y)다. A4에서 따른다 — 반사 무작위보행의 정상분포는 음의 표류 아래 존재한다Feller, 1971. 여기서는 가정으로 두고 증명하지 않는다.
A6 (Simon 규칙) — 매 스텝 t=1,2,…에 단위 하나가 도착한다. 확률 p로 크기 1의 새 기업을 세우고, 확률 1−p로 기존 기업 하나에 붙는데 그 기업이 선택될 확률은 규모에 비례한다 — 규모 k인 기업 하나가 선택될 확률은 (1−p)k/t다(총 규모가 t이므로).
A7 (평균장(mean field)·유체 근사) — 한 기업의 확률적 증분을 조건부 기댓값으로 바꾸고 t를 연속 변수로 다룬다. 시각 τ까지 세워진 기업 수를 pτ로 둔다.
A1–A2가 Gibrat의 세계다 — Gibrat (1931)가 로그정규를 얻은 자리이고, 그 뒤 기업 자료가 이 가정을 어디까지 견디는지는 Sutton (1997)이 정리했다. 벽 A1과 음의 표류 A4를 더한 것이 Champernowne (1953)의 소득 모형이며 이 회차의 이산 원형이다. 정의 하나를 먼저 둔다. 이 회차 제목의 두 낱말이다.
정의는 극한에 관한 것이다. 이 회차에서 그 극한은 s/Smin→∞ — 벽에서 멀리 떨어진 큰 규모의 꼬리다. 그 비가 이 회차의 Π2이고, ν의 자리에 −ζ가 선다.
이 회차가 증명하는 것은 (i), (ii)(a), (iii), (iv)의 첫 문장, Lemma 1, Lemma 2의 평균장 부분이다. (ii)(b)와 Yule–Simon 분포는 인용한다. 연속시간 극한 — 로그 규모가 반사벽 위의 브라운 운동인 경우 — 에서는 경계층이 사라지고 (9)가 s≥Smin 전체에서 등호로 성립한다는 것도 인용만 한다Gabaix, 1999.
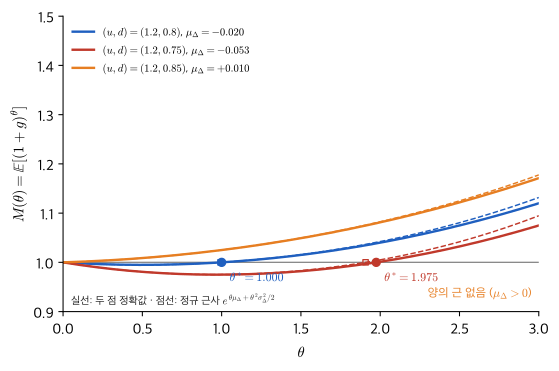
Figure 1:정상성은 고유값 M(θ)가 1이 되는 θ를 요구한다. 볼록성과 M′(0)=μΔ<0이 근을 하나로 만든다 — (1.2,0.8)에서 1.000, (1.2,0.75)에서 1.975. (1.2,0.85)는 μΔ>0이라 1을 다시 만나지 않는다. 점선(정규 근사 eθμΔ+θ2σΔ2/2)의 근은 빈 사각형 — 둘째 경우 3% 낮게 잡는다.
Figure 1가 (8)의 네 성질을 한 장에 담는다. 세 곡선 모두 (0,1)에서 출발하고, 파랑과 빨강은 음의 기울기로 내려갔다가 볼록하게 되올라와 M=1을 한 번 더 지난다 — 그 교점의 가로좌표가 지수다. 주황은 양의 기울기로 출발해 1 위에 머문다 — 표류가 양이면 벽이 있어도 정상분포가 없다. 표류 μΔ가 곡선을 아래로 끌고 분산 σΔ2가 위로 휘게 하므로 지수는 두 힘의 비이고, 점선은 로그정규 공식 (11)이 두 점 분포에서 빗나가는 정도 — 근이 클수록 크다 — 를 보인다.
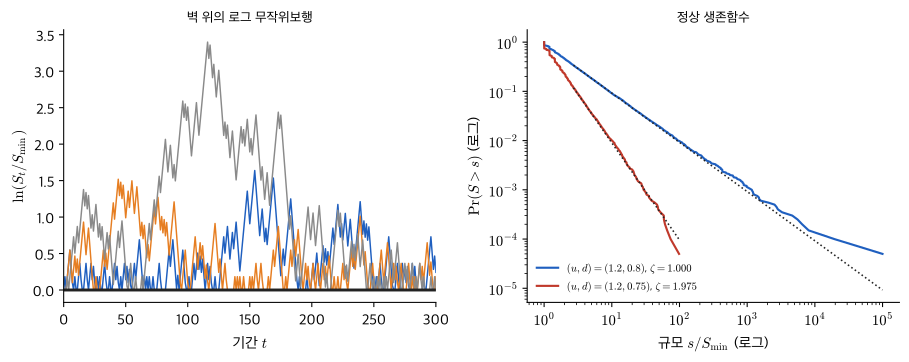
Figure 2:벽에 반사되는 로그 무작위보행의 정상분포는 로그–로그 직선이다. 기울기는 E[(1+g)ζ]=1의 근 — E[g]=0인 (1.2,0.8)에서 정확히 -1, (1.2,0.75)에서 -1.975. 20,000개 기업을 2,000기 돌린 경험적 생존함수(실선) 위에 이분법으로 구한 근의 기울기(점선)를 겹쳤다.
Figure 2의 왼쪽은 (3)이고 오른쪽은 (9)다. 왼쪽의 경로 셋은 벽에 부딪히고 튀어 오르고 위로 멀리 갔다가 표류에 끌려 되돌아온다 — 벽이 없으면 −∞로 흘러 내려갔을 경로다(A4). 오른쪽에서 두 직선의 기울기가 다른 이유는 d가 0.8에서 0.75로 바뀌어 μΔ/σΔ2가 달라졌기 때문이며, 파란 직선은 규모가 10배 커질 때 그 위의 기업 수가 10분의 1이 되는 Zipf의 세계, 빨간 직선은 100분의 1이 되는 세계다. 학부 회귀는 이 두 기울기를 자료에서 추정하고 이 회차는 u, d에서 계산한다. 빨간 곡선의 끝이 점선 아래로 꺾이는 것은 모형이 아니라 표본이다 — 그 규모에 이른 기업이 몇 개뿐이라 생존함수의 마지막 계단이 거칠다.
근거 — Simon (1955)와 Yule (1925)의 결과(증명 없이 인용). Simon 원문의 ρ가 이 책의 ζ다. 점근은 Γ(k+a)/Γ(k+b)∼ka−b. 지수 ζ+1=γ가 (14)와 일치한다 — 평균장은 지수를 맞히고 작은 k의 형태(베타함수의 휨)는 놓친다. 검산: ζ=2 (p=21)에서 Pr(K=k)=4/(k(k+1)(k+2)), 합은 1, 평균은 ζ/(ζ−1)=2=1/p(총 단위 수를 기업 수로 나눈 것 — 맞아야 한다). 생존함수는 Pr(K≥k)=ζB(k,ζ)다.
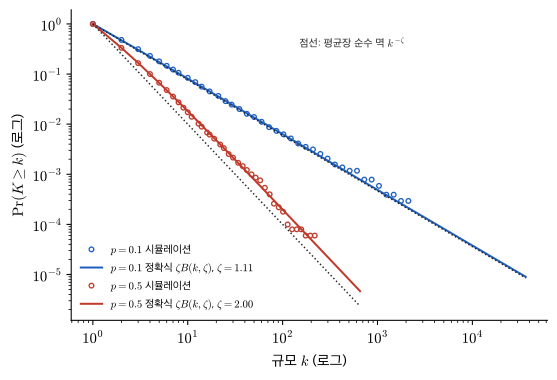
Figure 3:Simon 과정 105스텝. 평균장은 지수를 맞히고(-1.11, -2) 정확 분포 ζB(k,ζ)는 작은 k의 휨까지 맞힌다. p=21의 국소 기울기는 k=5에서 -1.83, k=50에서 -1.98 — 순수 멱 -2는 점근이다.
Figure 3에서 점선과 실선이 벌어지는 자리를 본다. 순수 멱 k−ζ와 정확 분포 ζB(k,ζ)는 k=1에서 1로 만나고, 그 뒤로는 정확 분포가 위에 있다 — 비 ζB(k,ζ)/k−ζ는 1에서 출발해 Γ(ζ+1)(p=21이면 2)로 단조 증가한다. p=21의 국소 기울기가 k=1, 5, 50에서 -1.5, -1.83, -1.98로 -2를 향해 가파라지는 것이 휨이고, 큰 k에서 두 곡선이 평행해지는 것이 “지수가 같다”, 높이가 Γ(ζ+1)배 다른 것이 "형태가 다르다"의 뜻이다. 회귀로 지수를 잰다면 작은 k를 버려야 하고, 어디서부터 버릴지를 정하는 것이 이 휨이다.
번역. 성장률이 규모와 무관하게 곱해지고 아래에 벽이 있으면 규모의 분포는 멱법칙 꼬리를 갖는다. 그 지수는 성장 배율을 그 지수만큼 거듭제곱해 평균하면 정확히 1이 되는 수이며, 성장률의 분포가 정하지 규모의 단위나 차원이 정하지 않는다. 벽이 없으면 로그 규모의 산포는 시간의 제곱근으로 자란다 — 분산율의 단위가 1/시간이고 증분이 독립이기 때문이다. 평균 성장률이 0이면 지수는 정확히 1이다 — Zipf는 순증가가 없는 세계의 이름이다. 새 단위 가운데 진입 확률만큼이 새 기업이 되고 나머지가 규모에 비례해 기존 기업에 붙으면, 기업 규모는 나이의 거듭제곱으로 자라되 그 지수는 기존 기업의 몫(1에서 진입 확률을 뺀 값)이고, 규모 분포의 지수는 그 역수다.
수치로 확인한다. 두 점 성장 1+g∈{u,d}, 확률 각 21. 정확한 ζ는 (7)을 이분법으로 푼 것이고 ζN=−2μΔ/σΔ2는 로그정규 공식 (11)이다.
(u,d)
μΔ
σΔ2
E[g]
정확한 ζ
ζN
읽기
(1.2,0.8)
-0.0204
0.0411
0
1.000
0.993
Zipf — E[g]=0
(1.2,0.75)
-0.0527
0.0552
-0.025
1.975
1.908
평균 존재, 분산 경계 근처
(1.2,0.83)
-0.0020
0.0340
+0.015
0.118
0.118
E[g]>0이지만 μΔ<0 — 정상 Pareto 있음, 평균 무한
(1.2,0.85)
+0.0099
0.0297
+0.025
없음
—
A4 위반 — 벽이 있어도 정상분포 없음
셋째 행과 넷째 행이 이 표의 요점이다. 둘 다 E[g]>0이지만 셋째는 정상 Pareto를 갖고 넷째는 갖지 못한다. 가르는 것은 E[g]의 부호가 아니라 μΔ의 부호다 — 수준 성장률의 평균이 양이어도 로그 성장률의 평균은 음일 수 있고(Jensen), 그때 벽은 분포를 붙잡되 꼬리는 너무 두꺼워 평균이 없다. 로그정규 연간 σ=0.2에서는 μ=−0.02이면 ζ=1(Zipf), μ=−0.03이면 1.5, μ=−0.06이면 3이다 — W18의 수치와 같은 값이 나오는 예이지 수익률 꼬리의 설명이 아니다. Simon에서는 p=0.05이면 γ=2.053, p=0.1이면 2.111, p=21이면 3. Axtell의 ζ=1.06을 Simon으로 읽으면 p=0.057 — "성장의 6%가 새 기업 몫"이라는 읽기다(자료 주장이 아니라 읽기 연습).
(1): “규모는 매기 규모와 무관한 배율로 자라되 바닥 아래로는 못 내려간다 — 그러면 큰 규모의 빈도는 규모의 거듭제곱으로 줄어든다.” (2): “밀도 꼬리지수는 2에 진입 오즈를 더한 것이다 — 새 기업이 드물수록 2, 곧 Zipf에 붙는다.” 등가 재작성: E[(1+g)ζ]=1⟺E[eζε]=1⟺lnM(ζ)=0 — 값은 같고 "누적률 생성함수(cumulant generating function)의 0점"이 드러난다. 덩어리 짓기: μ/σ2 전체가 하나의 개체다 — 지수 ζ를 정하는 유일한 수(σ2Δ는 상수 C와 경계층에만).
(1) 좌변: St+1, (1+gt)St, Smin 모두 [규모] — 같은 차원끼리의 max다. 우변: Pr은 무차원, s−ζ는 차원 있는 양의 비정수 거듭제곱 — W02 (5)의 규칙대로 기준 규모로 나눈 (s/Smin)−ζ라야 뜻을 갖고, ∝가 Sminζ을 숨긴다. 무차원군은 벽 없는 유한시간에 넷((5)), 정상상태에 셋((10)) — 지평 T가 사라지면서 μT, σ2T, Δ/T가 μ/σ2·σ2Δ 둘로 줄고, 지수 ζ에는 μ/σ2 하나만 남는다(연속시간 극한 σ2Δ→0에서는 분포 전체가 μ/σ2 하나). ζ가 무차원인 것은 (7)에서 θε이 지수 자리에 있기 때문 — ε이 무차원이므로 θ도 무차원이다. Δ/T가 정상상태에서 사라지는 것은 지평이 무한이 되어 나눌 것이 없어졌기 때문이고, 그 자리를 σ2Δ가 차지한다 — 한 기간의 충격이 얼마나 굵은가는 정상분포의 벽 근처 모양에 남는다. (2): 전부 무차원(개수의 비). 진입 확률 p와 개수 k, 시각 t가 모두 단위 수로 재어지므로 Simon 과정에는 차원표가 없다 — 그래서 Simon 지수에는 차원이 정할 자리가 처음부터 없다.
근거 — 누적률 생성함수의 정의(학부 확률; κ3은 3차 중심적률, κ4는 4차 중심적률에서 3σΔ4를 뺀 것). 두 점 (1.2,0.75), θ∗=1.975에서 항의 크기는 -0.104, +0.108, 0(κ3=0 — 대칭 두 점), -0.0039다. 셋째·넷째를 지우면 (11) — 정규 공식 1.908, 정확값 1.975, 3.4% 차이. W03의 절단 오차 논리대로 지운 항은 θ∗가 클수록(꼬리가 얇을수록) 되살아난다. 첫 두 항이 서로 상쇄하는 구조(θμΔ<0, θ2σΔ2/2>0)가 근의 존재 이유다 — 표류가 끌어내리고 분산이 밀어 올린다.
이 3.4%는 작지 않다. 회귀 기울기 -1.91과 -1.98은 표준오차 안에서 구분되지 않을 때가 많지만, 그 차이는 자료가 아니라 공식에서 온 것이다 — 정규 공식은 두 점 분포의 4차 누적률을 버린다. 로그정규 공식으로 자료를 읽는 논문은 성장률 분포가 정규에서 얼마나 먼지를 먼저 밝혀야 하고, 밝히지 않으면 지수의 몇 %가 모형의 것인지 알 수 없다. 3절 수치 확인 표가 정확한 ζ와 ζN을 나란히 두는 이유다.
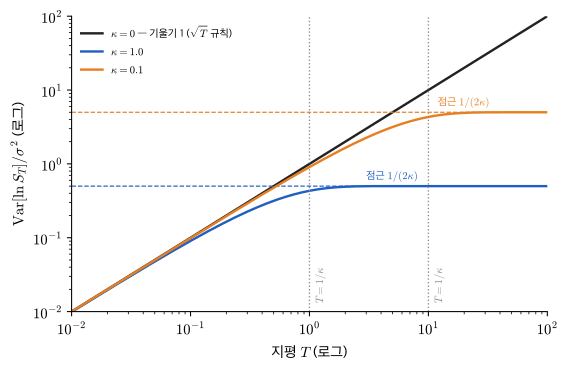
근거 — 로그 규모에 평균회귀 κ를 넣은 것. κ>0은 A2 위반 — 성장률이 규모에 의존해 작은 기업이 빨리 자라는 세계(Sutton (1997)의 Gibrat 이탈)이고, 그래서 완전상사가 깨진다. W09 (15)의 분산 재귀에서 수준 대신 로그, δ→κ이며 κ는 (18)의 Vasicek κ와 같은 뜻이다. 등비급수 합 Vn=σ2Δ[1−(1−κΔ)2n]/[κΔ(2−κΔ)], Lemma 1로 (1−κΔ)2n→e−2κT, 분모는 2κΔ로. 읽기: κT→0에서 Ψ→1 — (5)의 완전상사, 지수 1/2. κT→∞에서 Ψ∼1/(2κT) — 지수 0, 정상분산 σ2/(2κ)((16)과 같은 값). 그 사이 κT∼1에서는 어떤 멱도 아니다 — Ψ(0.5)=0.63, Ψ(1)=0.43, Ψ(5)=0.10. "10 규칙"은 κ⋅10일이 1보다 훨씬 작을 때만 맞는다.
Figure 4:지평이 평균회귀 시간 1/κ보다 짧으면 분산은 T에 비례하고(T 규칙), 길면 상수 σ2/(2κ)다. 그 사이는 어떤 멱도 아니다.
(1) 쪽의 극한. s→∞에서 Pr(S>s)→0은 어느 분포나 같지만 그 속도가 멱이라는 것이 내용이다. s→Smin+에서는 경계층 — (9)의 지수형이 깨진다. 강제되는 것은 Pr(S≥Smin)=1(G~의 둘째 줄)이지 G(0)=1이 아니다. G(0)=Prπ(x>0)=1−Prπ(x=0)<1이고, 그 벽의 원자 — 노트북 예측 1의 벽 비율 약 14%·26%, 곧 G(0)≈0.86·0.74 — 가 경계층이다. 원자가 0이 되어 G(0)=1인 것은 연속시간 극한뿐이다.
S→cS, Smin→cSmin(단위 변경): (3)의 xt가 그대로이므로 ζ 불변 — 지수는 단위를 모르는 사람도 비교할 수 있는 수다. W02에서 A는 비교 불가, α는 비교 가능했던 것((2), Lemma 1)과 같은 이유이고, 여기서는 C와 ζ의 차이다. S→S+h, h>0 [규모](모든 기업에 고정액 보조; Δ는 기간 길이이므로 다른 글자): 곱셈 구조가 깨지고 (3)이 성립하지 않는다 — 그러나 꼬리지수는 그대로다. 반사벽을 덧셈 항으로 바꾼 St+1=(1+gt)St+bt (bt>0)에서도 꼬리는 E[(1+g)ζ]=1의 같은 근을 갖는다Kesten, 1973 — 덧셈 항은 지수를 바꾸지 못하고, 꼬리는 곱셈이 지배한다. 시간 단위 변경 Δ→cΔ: μΔ, σΔ2가 함께 c배 — ζ=−2μ/σ2 불변((11)의 마지막 등호).
dlnPr(S>s)/dlns=−ζ 상수 — 멱법칙의 정의이자 W17의 “탄력성 상수 ⟺ 멱”(Theorem 1)의 재확인이다. ζ 자체의 탄력성((11)): ∂lnζ/∂ln∣μ∣=+1, ∂lnζ/∂lnσ2=−1 — 분산이 2배면 꼬리지수는 반, 꼬리는 두 배로 두꺼워진다. 두 탄력성의 합이 0이라는 것이 Q6의 시간 단위 불변을 다시 말한다. Simon: ∂lnζ/∂ln(1−p)=−1 — 기존 기업 몫이 1% 줄면 꼬리지수는 1% 오른다. p 자체에 대해서는 ∂lnζ/∂lnp=p/(1−p) — 진입이 드문 세계일수록 진입 확률의 변화가 지수에 미치는 영향이 작다.
μ→0−: ζ→0 — 꼬리가 한없이 두꺼워지고 모든 모멘트가 사라진다. μ=0에서 정상분포 자체가 없다(벽이 있어도 계속 퍼진다). μ>0: 벽이 무의미해지고 (i)의 세계 — 로그정규가 퍼져 나가는 Gibrat의 원래 세계다.
σ2→0 (μ<0 고정): ζ→∞ — 모두 벽에 붙는다. 산포가 없으니 꼬리도 없다. 멱법칙은 표류가 끌어내리는 힘과 분산이 밀어 올리는 힘의 비가 유한할 때만 있다.
σ2→∞: ζ→0. 분산이 클수록 큰 기업이 흔하다.
E[g]<0, =0, >0(단 μ<0): ζ>1 평균 존재 / ζ=1 Zipf / 0<ζ<1 평균 무한 — 세 세계의 경계가 (12) 한 줄이다. E[g]>0이면서 μ<0인 세계는 넓다: 로그정규 σ2=0.04, μ=−0.01이면 E[g]=e0.01−1=+1.0%, ζ=0.5; 두 점 (1.2,0.83)이면 μΔ=−0.002, E[g]=+0.015, ζ=0.118(수치 확인 표).
μ≥0: 벽이 있어도 정상분포 없음(A4 위반) — 정상분포 부재의 조건은 E[g]의 부호가 아니라 μ의 부호다. 표의 (1.2,0.85)가 정상분포를 잃는 것은 E[g]>0 때문이 아니라 μΔ>0 때문이다.
퇴출률 δ를 넣으면(기업이 매 단위시간 확률 δ로 사라지고 벽에서 새로 태어남; W09–W12의 감가상각률과 다른 뜻): 벽에서 먼 곳의 정상성은 M(θ)e−δΔ=1, 로그정규에서 21σ2θ2+μθ−δ=0, θ∗=(−μ+μ2+2σ2δ)/σ2. μ≥0이어도 양의 근이 생긴다 — 퇴출이 벽과 같은 일을 한다Gabaix, 2009. 예: μ=−0.02, σ2=0.04에서 δ=0이면 ζ=1, δ=0.02이면 ζ=1.62.
Simon p→0: γ→2(Zipf) — 성장이 전부 기존 기업 몫. 단, 기업 수 pt가 느리게 늘므로 유한 t에서는 정상분포가 채 형성되지 않는다 — "p→0에서 Zipf"는 t→∞를 먼저 보낸 뒤의 극한이다. p→1: γ→∞ — 모든 단위가 새 기업, 규모 1의 세계. p=21: γ=3, ζ=2 — 분산이 막 존재하는 경계(W18 Theorem 1: γ>3이라야 분산). p<21이면 규모의 분산이 무한이다.
Figure 2이 로그–로그 생존함수(기울기 -1과 -1.975), Figure 3이 Simon(p=0.1, 21)이다. 세미로그 읽기: x=ln(S/Smin) 축에 lnG를 그리면 직선이다 — 로그에서 지수분포이므로. 수준 s의 세미로그에서는 볼록하게 휜다(d2lnPr(S>s)/ds2=ζ/s2>0 — 급히 떨어지다 평평해지는 모양) — 직선이어야 할 지수분포보다 꼬리가 두껍다는 신호다. 숫자 하나를 넣어 본다. (1.2,0.8)의 시뮬레이션에서 x=1, 곧 s=e≈2.7배 규모 위에 있는 기업의 비율은 약 0.34이고, x=5(s≈148배) 위에는 약 0.006이다 — 순수 지수형 e−1, e−5보다 조금 낮은 것은 벽의 원자가 C를 1 아래로 끌어내리기 때문이고, 비율은 e4≈55로 같다. 같은 두 점을 수준 축에 놓으면 규모 55배에 확률 55분의 1 — 기울기 -1. 두 그림을 같은 자료로 그려 보는 것이 노트북 과제다.
학부 읽기는 순위–규모 그림에 직선을 맞추고 기울기 -1.06에 표준오차를 단다. 이 읽기로 Gabaix (1999)의 명제 — 지수는 수준 표류와 분산의 비 1−2μG/σ2이고, 정규화된 규모의 평균 성장률이 0이면 ζ=1 — 를 열면 첫 줄에서 멈춘다. 회귀계수가 왜 두 모수의 비여야 하는지, 왜 "평균 성장 0"이 1을 주는지가 보이지 않는다. 지수는 추정할 모수였지 풀어서 나오는 값이 아니었기 때문이다.
대학원 읽기는 (7)을 본다. 정상성이 고유값 식을 강제하고 지수는 그 근이다. 그러면 세 질문이 생긴다. (a) 지수가 파라미터에 자유롭게 의존하는가 — (10)의 불완전상사, ζ=−2μ/σ2는 어떤 양수든 될 수 있다. (b) 무엇이 그것을 고정하는가 — 점유율 보존이 E[g]=0을 강제해 ζ=1((12)), 진입이 사라지면 γ→2((14)). (c) 차원이 고정하는 지수는 따로 있는가 — σ2T의 1/2((5)). 자료에서 멱법칙을 보았을 때 대학원 읽기는 "지수가 1에 가까운가, 1을 벗어나 있는가"를 먼저 묻고, 가까우면 보존 제약을, 벗어나 있으면 μ/σ2 같은 비를 찾는다. Gabaix (2016)가 멱법칙 개관에서 "무작위 성장 + 마찰"을 첫 메커니즘으로 놓는 이유가 이 세 질문이다. 세 질문의 답이 갈리는 자리가 모형의 분류 기준이 된다. 지수가 1에 고정되는 모형은 보존 제약을 갖고, 지수가 자유로운 모형은 표류와 분산의 비를 자료에서 읽어야 하며, 지수가 진입 오즈 같은 하나의 몫으로 고정되는 모형은 Simon처럼 진입과 성장의 배분을 갖는다. 회귀 기울기 하나가 세 가지 다른 진술 가운데 어느 것을 지지하는지는 기울기의 값이 아니라 그 값이 어디에 붙어 있는지로 읽는다.
구체 장면 하나. 기업 동학 논문 — Luttmer (2007) 계열 — 의 한 줄은 꼬리지수를 표류·분산·그리고 진입 또는 퇴출을 재는 율 하나로 이루어진 2차식의 양의 근으로 준다. 학부 읽기는 이 2차식과 회귀의 -1.06을 잇지 못한다. 대학원 읽기는 그것이 (11)과 같은 꼴 — 상수 퇴출률이면 M(θ)e−δΔ=1의 로그정규형(4절 Q8, Gabaix (2009)) — 임을 알아본다. 추정된 1.06은 표류·분산·그 율의 한 무차원 조합을 고정하는 관측 하나이고, 1에 가깝다는 것은 그 조합이 "순증가 0"의 경계에 붙어 있다는 뜻이다. 그 계열의 논문에서 이런 꼴의 2차식이 나온다는 것까지가 이 회차의 읽기이며, 계수의 정확한 꼴은 각 논문이 정한다.
로그 변환 줄((3)) 옆에 "로그는 단조이므로 max와 교환된다, 규모의 벽이 x=0의 벽이 된다"가 적혀 있는가.
벽 없는 줄((4)·(5)) 옆에 "i.i.d.이므로 분산 가법, 무차원군 넷, [σ2]= [시간−1]이 지수 1/2을 정한다 — 완전상사"가 적혀 있는가.
정상성 줄((6)) 옆에 "xt+1과 xt가 같은 분포, εt는 xt와 독립, y≥0에서 max가 사라짐, 음의 인수에서 G~=1"이 적혀 있는가.
고유값 줄((7)) 옆에 "y>y0+εmax에서 경계항 없음, e−θy는 이동 연산자의 고유함수·고유값 M(θ)"가 적혀 있고 M(θ)=E[(1+g)θ]로 바꿔 적었는가.
유일성 줄((8)) 옆에 "M(0)=1, M′(0)=μΔ<0, 볼록, θ→∞에서 발산"의 넷이 모두 적혀 있는가.
수준 복귀·불완전상사 줄((9)·(10)) 옆에 "밀도 꼬리지수 =ζ+1, 정상상태 무차원군 셋 s/Smin·μ/σ2·σ2Δ, ζ는 μ/σ2만의 함수(σ2Δ는 C와 경계층에만) — 차원표에 없다"가 적혀 있고, 로그정규 줄((11))에서 부호 ζ=−2μ/σ2>0과 Zipf 조건 E[g]=0((12))이 있는가.
Simon 줄((13)·(14)) 옆에 "총 규모 =t, 평균장, 진입 시각 균등"이 적혀 있고 γ=1+1/(1−p)=2+p/(1−p)의 대수와 p=21→3 검산이 있는가.
번역 문장이 있는가.
냉시동 인출(40분) — 자료 없이 백지에 쓴다.
1주 전 — W18 · 모멘트 존재 조건 γ>n+1 · VaR과 ES. 절단적분의 극한에서 부등식까지, ES가 VaR의 ζ/(ζ−1)배라는 것까지.
3주 전 — W16 관문에서 통과하지 못한 항목 1개. 관문 기록에 적힌 그 항목을 그대로.
8주 전 — W11 · 램지 널클라인·야코비안 고유값 → 안장점 판정. 두 널클라인의 교점에서 야코비안을 세우고 행렬식의 부호로 고유값의 부호가 갈린다는 것까지.
노트북(40분) — w19-lab.ipynb. 코드를 쓰기 전에 아래 셋에 답한다.
두 점 성장 (u,d)=(1.2,0.8), 확률 각 21, Smin=1, N=20,000 기업·T=2,000기: 로그–로그 생존함수의 꼬리 기울기는 -1.00(Zipf — E[g]=0이므로 정확히). d=0.75로 바꾸면 약 -2(이분법 근 -1.975); 정규 공식 (11)은 1.908을 준다(3.4% 낮다). 벽에 붙어 있는(xt=0) 기업 비율은 약 14%(첫 사례)·26%(둘째). 예측: “기울기 -1.00, -1.98; 벽 비율 14%, 26%”. 원인란에 적을 것: x∈[1,5] 구간 최소제곱은 유한 표본 때문에 이론값보다 5%까지 가파를 수 있다.
벽을 떼면 Var[lnST]=TσΔ2 — T=1,000에서 41.1(첫 사례). 벽을 두면 Var[xt]는 T≈500 이후 더 늘지 않고 약 1/ζ2 근처 — 1.0(첫 사례), 0.26(둘째) — 에서 포화한다. 예측: “벽 없음은 T에 선형, 벽 있음은 포화”. 원인란에 적을 것: 경계층 때문에 정확히 1/ζ2은 아니다.
Simon t=105: p=0.1이면 기업 수 약 104, 규모 1인 비율 1/(2−p)=0.526, 로그–로그 국소 기울기 k=50에서 -1.11. p=21: 규모 1 비율 0.667, 국소 기울기 k=5에서 -1.83, k=50에서 -1.98(순수 멱 -2는 점근; ζ=2면 Pr(K≥k)=2/(k(k+1)), dlnG/dlnk=−(1+k/(k+1))). ti≈t/100에 진입한 기업들의 평균 규모는 1000.9≈63(p=0.1)·10(p=21). 예측: “규모 1 비율 0.53·0.67, 기울기는 k가 커질수록 −ζ로”. 원인란에 적을 것: 진입 시각별 평균 규모는 표본이 적어 seed마다 ±15% 흔들린다.
계산은 직접 쌓는다. 반사 무작위보행을 numpy 벡터로 x←max(x+ε,0) 한 줄로 돌리고, 경험적 생존함수는 정렬로 만든다. 고유값 식 M(θ)=1은 손으로 짠 이분법으로 푼다 — scipy.optimize를 쓰지 않는다. 분산의 시간 경로는 벽 있음·없음 두 벌을 T=10,100,500,1000,2000에서 기록한다. Simon 과정은 단위 소유 배열에서 균등 난수로 단위를 뽑아 규모 비례 선택을 구현하고, 정확식 ζB(k,ζ)는 math.lgamma로 만든다. 대조 표는 예측 | 결과 | 어긋남 | 원인 4열이다.
지금은 이렇게 읽힌다. max는 벽이고, 1+gt는 규모와 무관한 i.i.d. 배율이며, ζ는 파라미터가 아니라 E[(1+g)ζ]=1의 유일한 양의 근이다. 차원으로는 s−ζ가 (s/Smin)−ζ이고, 정상상태의 무차원군 s/Smin·μ/σ2·σ2Δ 가운데 ζ는 μ/σ2만의 함수다 — 차원해석이 정하지 못하는 지수, 불완전상사. 벽 없는 σ2T의 1/2은 차원이 정한다 — 완전상사. 메커니즘으로는 아래로 끄는 음의 표류와 위로 밀어 올리는 분산이 벽 위에서 균형을 이루는 곳에서 로그는 지수분포, 수준은 Pareto다. E[g]=0이면 ζ=1, Simon에서 p→0이면 γ→2 — 지수 1은 "순증가 없음"의 이름이고, 그 밖의 지수는 두 연속량의 비라서 예쁜 수가 아니다. (2)는 진입 오즈로 읽힌다 — 새 단위 가운데 새 기업이 되는 몫과 기존 기업에 붙는 몫의 비가 밀도 꼬리지수에서 2를 뺀 값이고, 그 지수에는 차원이 정할 자리가 처음부터 없다.
E[(1+g)ζ]=1이 왜 나오는지가 안 되면 3절의 (6)·(7)로 돌아간다. 왜 1/2은 차원이 정하고 ζ는 못 정하는지가 안 되면 (5)와 (10)을 나란히 놓고 다시 읽는다. Simon 지수가 안 되면 (13)의 변수분리와 (14)의 균등한 진입 시각을 다시 본다 — 근사는 기댓값을 경로로 바꾼 한 곳에만 있다.
Simon 지수를 평균장 없이 정확히 — 규모 k의 기업 수가 시간에 따라 어떻게 흐르는지를 세는 율 방정식의 정상해로 — 얻는 일은 W20에서 한다.
이어지는 자료 — Barenblatt, Scaling 1–5장 · Gabaix(2009) Power Laws in Economics and Finance 2–3절 · Gabaix(1999) Zipf’s Law for Cities
Simon, H. A. (1955). On a Class of Skew Distribution Functions. Biometrika, 42(3/4), 425–440. 10.1093/biomet/42.3-4.425
Barabási, A.-L., & Albert, R. (1999). Emergence of Scaling in Random Networks. Science, 286(5439), 509–512. 10.1126/science.286.5439.509
Yule, G. U. (1925). A Mathematical Theory of Evolution, Based on the Conclusions of Dr. J. C. Willis, F.R.S. Philosophical Transactions of the Royal Society of London. Series B, 213, 21–87. 10.1098/rstb.1925.0002
Kesten, H. (1973). Random Difference Equations and Renewal Theory for Products of Random Matrices. Acta Mathematica, 131, 207–248. 10.1007/BF02392040
Gabaix, X. (2016). Power Laws in Economics: An Introduction. Journal of Economic Perspectives, 30(1), 185–206. 10.1257/jep.30.1.185