노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다.
두 배 비율의 표본판. Pareto(, ) 표본 2,000개(역함수 표본추출, seed 0)에서 경험적 생존함수의 두 배 비율 를 에서 구하면? 지수() 표본에서는?
예측: ____
순위–규모 기울기. 같은 두 표본의 log-log OLS 기울기를 전체 / 상위 10%(순위 1–200) / 순위 201 이후(나머지 1,800개)로 나누면?
예측: ____
단위 변경. 멱 표본에 1,300을 곱하면(달러→원) log-log 기울기와 절편은? 지수 표본에 곱하면 는?
예측: ____
2. 계산
패키지 호출로 답을 내지 않는다. 표본과 경험적 생존함수와 OLS 기울기를 직접 쌓는다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager

# 한국어 글꼴을 후보 목록에서 있는 것으로 고른다
_cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
_have = {f.name for f in font_manager.fontManager.ttflist}
for _f in _cands:
    if _f in _have:
        plt.rcParams['font.family'] = _f
        break
plt.rcParams['axes.unicode_minus'] = False

# 본문 3절과 같은 파라미터에서 두 표본을 역함수 표본추출로 쌓는다
ZETA, XM, LAM, DELTA, N = 1.0, 1.0, 0.1, 1.0, 2000
rng = np.random.default_rng(0)
u = rng.uniform(size=N)
x_par = XM * u ** (-1.0 / ZETA)   # 생존함수 (x/x_m)^{-ζ} 를 가진 표본
x_exp = -np.log(u) / LAM          # 생존함수 e^{-λx} 를 가진 표본

print('글꼴:', plt.rcParams['font.family'][0])
print(f'멱  표본  최소 {x_par.min():9.4f}  중앙값 {np.median(x_par):8.4f}  최대 {x_par.max():10.2f}')
print(f'지수 표본  최소 {x_exp.min():9.4f}  중앙값 {np.median(x_exp):8.4f}  최대 {x_exp.max():10.2f}')
print(f'표본평균  멱 {x_par.mean():.3f} (이론은 ζ=1에서 발산)   지수 {x_exp.mean():.3f} (이론 1/λ = 10)')
글꼴: Apple SD Gothic Neo
멱 표본 최소 1.0005 중앙값 2.0112 최대 5263.11
지수 표본 최소 0.0050 중앙값 6.9875 최대 85.68
표본평균 멱 13.727 (이론은 ζ=1에서 발산) 지수 10.189 (이론 1/λ = 10)
예측 1. 두 검사를 두 표본에 건다. 두 배 비율 와 비율 를 본문 3절 표와 같은 자리()에서 센다.
# 경험적 생존함수를 x보다 큰 표본의 비율로 직접 센다
def Fhat(x, t):
    return np.mean(x > t)


TS = [1.0, 2.0, 5.0, 10.0, 20.0]
par_dbl, exp_dbl = [], []
print('두 배 검사 — 경험적 생존함수의 비율')
print(f"{'x':>4}{'멱 표본':>12}{'멱 이론':>11}{'지수 표본':>13}{'지수 이론':>12}{'꼬리 표본수':>14}")
for t in TS:
    p = Fhat(x_par, 2 * t) / Fhat(x_par, t)
    e = Fhat(x_exp, 2 * t) / Fhat(x_exp, t)
    par_dbl.append(p)
    exp_dbl.append(e)
    print(f'{t:4.0f}{p:12.4f}{2.0 ** -ZETA:11.4f}{e:13.4f}{np.exp(-LAM * t):12.4f}'
          f'{int(np.sum(x_par > t)):7d}/{int(np.sum(x_exp > t)):4d}')
두 배 검사 — 경험적 생존함수의 비율
x 멱 표본 멱 이론 지수 표본 지수 이론 꼬리 표본수
1 0.5035 0.5000 0.9009 0.9048 2000/1806
2 0.5045 0.5000 0.8181 0.8187 1007/1627
5 0.5012 0.5000 0.6051 0.6065 419/1223
10 0.5238 0.5000 0.3770 0.3679 210/ 740
20 0.5636 0.5000 0.1828 0.1353 110/ 279
# 같은 표본에 +Δ 검사를 걸어 본문 3절 2x2 표의 표본판을 쌓는다
print(f"{'x':>4}{'멱 2배':>11}{'멱 +1':>10}{'지수 2배':>12}{'지수 +1':>11}")
for t in TS:
    print(f'{t:4.0f}'
          f'{Fhat(x_par, 2 * t) / Fhat(x_par, t):11.4f}'
          f'{Fhat(x_par, t + DELTA) / Fhat(x_par, t):10.4f}'
          f'{Fhat(x_exp, 2 * t) / Fhat(x_exp, t):12.4f}'
          f'{Fhat(x_exp, t + DELTA) / Fhat(x_exp, t):11.4f}')
print()
print(f'이론  멱 2배 = 2^-ζ = {2.0 ** -ZETA:.4f} 고정,   멱 +1 = (1+1/x)^-ζ — x가 남는다')
print(f'      지수 +1 = e^-λΔ = {np.exp(-LAM * DELTA):.4f} 고정,   지수 2배 = e^-λx — x가 남는다')
x 멱 2배 멱 +1 지수 2배 지수 +1
1 0.5035 0.5035 0.9009 0.9009
2 0.5045 0.6663 0.8181 0.9041
5 0.5012 0.8091 0.6051 0.8880
10 0.5238 0.9238 0.3770 0.9054
20 0.5636 0.9636 0.1828 0.9032
이론 멱 2배 = 2^-ζ = 0.5000 고정, 멱 +1 = (1+1/x)^-ζ — x가 남는다
지수 +1 = e^-λΔ = 0.9048 고정, 지수 2배 = e^-λx — x가 남는다
# 두 검사의 표본 비율과 이론 곡선을 같은 축에 쌓는다
tg = np.linspace(1.0, 20.0, 39)
d_par = np.array([Fhat(x_par, 2 * t) / Fhat(x_par, t) for t in tg])
d_exp = np.array([Fhat(x_exp, 2 * t) / Fhat(x_exp, t) for t in tg])
a_par = np.array([Fhat(x_par, t + DELTA) / Fhat(x_par, t) for t in tg])
a_exp = np.array([Fhat(x_exp, t + DELTA) / Fhat(x_exp, t) for t in tg])

fig, axes = plt.subplots(1, 2, figsize=(9.4, 3.5))
axes[0].plot(tg, d_par, 'o', ms=3.2, color='#3b6ea5', label='멱 표본')
axes[0].plot(tg, np.full_like(tg, 2.0 ** -ZETA), color='#3b6ea5', lw=1.0, label=r'멱 이론 $2^{-\zeta}$')
axes[0].plot(tg, d_exp, 's', ms=3.2, color='#c0392b', label='지수 표본')
axes[0].plot(tg, np.exp(-LAM * tg), color='#c0392b', lw=1.0, label=r'지수 이론 $e^{-\lambda x}$')
axes[0].set_ylabel(r'$\hat{\bar F}(2x)/\hat{\bar F}(x)$')
axes[0].set_title('두 배 검사 — 멱만 수평선')
axes[0].legend(fontsize=8, loc='lower left')
axes[1].plot(tg, a_par, 'o', ms=3.2, color='#3b6ea5')
axes[1].plot(tg, (1.0 + DELTA / tg) ** -ZETA, color='#3b6ea5', lw=1.0)
axes[1].plot(tg, a_exp, 's', ms=3.2, color='#c0392b')
axes[1].plot(tg, np.full_like(tg, np.exp(-LAM * DELTA)), color='#c0392b', lw=1.0)
axes[1].set_ylabel(r'$\hat{\bar F}(x+1)/\hat{\bar F}(x)$')
axes[1].set_title(r'$+\Delta$ 검사 ($\Delta=1$) — 지수만 수평선')
for ax in axes:
    ax.set_xlabel('규모 $x$')
    ax.set_ylim(0.0, 1.05)
plt.tight_layout()
plt.show()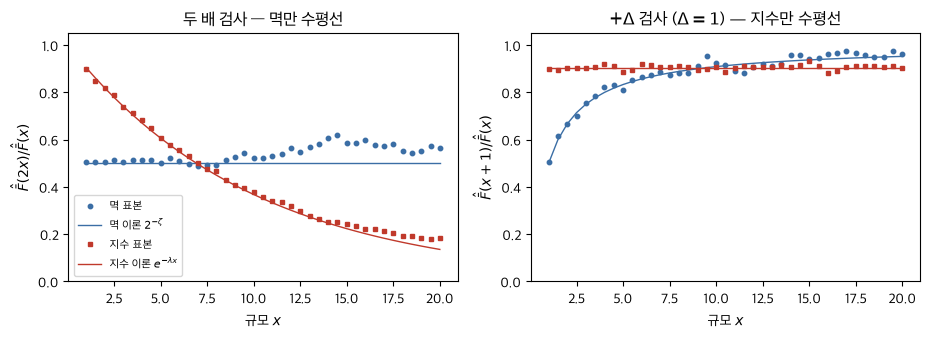
예측 2. 표본을 내림차순으로 정렬해 순위를 붙이고, 에 대한 의 OLS 기울기를 공분산/분산 비로 직접 만든다. 전체 · 상위 10%(순위 1–200) · 순위 201 이후(나머지 1,800개) 세 구간에서 각각 센다.
# 순위를 붙이고 공분산/분산으로 OLS 기울기를 직접 만든다 — 적합 함수를 쓰지 않는다
def ols(a, b):
    a = np.asarray(a, float)
    b = np.asarray(b, float)
    return np.mean((a - a.mean()) * (b - b.mean())) / np.mean((a - a.mean()) ** 2)


lr = np.log(np.arange(1, N + 1))
lx_par = np.log(np.sort(x_par)[::-1])
lx_exp = np.log(np.sort(x_exp)[::-1])
slopes = {}
print('순위-규모 log-log OLS 기울기')
print(f"{'표본':>5}{'전체':>12}{'상위 10%(1-200)':>19}{'순위 201 이후':>18}")
for name, lx in [('멱', lx_par), ('지수', lx_exp)]:
    slopes[name] = (ols(lr, lx), ols(lr[:200], lx[:200]), ols(lr[200:], lx[200:]))
    s = slopes[name]
    print(f'{name:>5}{s[0]:12.4f}{s[1]:14.4f}{s[2]:16.4f}')
print()
print('한 구간의 기울기만으로는 두 표본을 가르지 못한다 — 전체 기울기가 둘 다 -1 근처다')
순위-규모 log-log OLS 기울기
표본 전체 상위 10%(1-200) 순위 201 이후
멱 -1.0536 -1.1347 -1.0161
지수 -1.0256 -0.2818 -1.7165
한 구간의 기울기만으로는 두 표본을 가르지 못한다 — 전체 기울기가 둘 다 -1 근처다
# 두 표본의 순위-규모를 ln-ln 평면에 찍는다
fig, ax = plt.subplots(figsize=(6.4, 4.2))
ax.plot(lr, lx_par, '.', ms=2.5, color='#3b6ea5',
        label='멱: 전체 {:.2f} · 상위 {:.2f} · 나머지 {:.2f}'.format(*slopes['멱']))
ax.plot(lr, lx_exp, '.', ms=2.5, color='#c0392b',
        label='지수: 전체 {:.2f} · 상위 {:.2f} · 나머지 {:.2f}'.format(*slopes['지수']))
ax.plot(lr, np.log(N) - lr, color='k', lw=0.9, ls='--', label=r'기울기 $-1$ 기준선')
ax.axvline(np.log(200.0), color='#2e7d5b', lw=0.8, ls=':')
ax.text(np.log(200.0) + 0.1, lx_par.max() - 0.4, '순위 200', color='#2e7d5b', fontsize=9)
ax.set_xlabel(r'$\ln$ 순위 $r$')
ax.set_ylabel(r'$\ln$ 규모 $x$')
ax.set_title('멱 표본은 직선, 지수 표본은 휜다')
ax.legend(fontsize=8, loc='lower left', title='구간별 OLS 기울기', title_fontsize=8)
plt.tight_layout()
plt.show()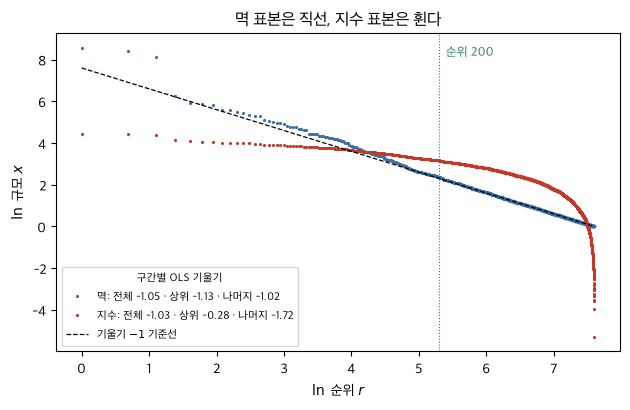
예측 3. 같은 표본에 1,300을 곱해(달러→원) 같은 계산을 반복한다. 지수 표본에서는 를 단위 변경 전후로 잰다.
# 표본에 1300을 곱해(달러→원) 기울기와 절편을 다시 쌓는다
C13 = 1300.0
unit = {}
print(f"{'표본':>5}{'기울기(달러)':>18}{'기울기(원)':>18}{'절편(달러)':>14}{'절편(원)':>12}{'절편 차':>11}")
for name, x in [('멱', x_par), ('지수', x_exp)]:
    l1 = np.log(np.sort(x)[::-1])
    l2 = np.log(np.sort(x * C13)[::-1])
    b1, b2 = ols(lr, l1), ols(lr, l2)
    a1 = l1.mean() - b1 * lr.mean()
    a2 = l2.mean() - b2 * lr.mean()
    unit[name] = (b1, b2, a1, a2)
    print(f'{name:>5}{b1:16.10f}{b2:17.10f}{a1:12.4f}{a2:11.4f}{a2 - a1:10.4f}')
print(f'ln 1300 = {np.log(C13):.4f}   기울기 차 = '
      f'{unit["멱"][1] - unit["멱"][0]:.1e}, {unit["지수"][1] - unit["지수"][0]:.1e}')
lam1 = 1.0 / x_exp.mean()
lam2 = 1.0 / (x_exp * C13).mean()
print(f'λ̂ = 1/x̄ : {lam1:.6f} → {lam2:.4e}   비 {lam2 / lam1:.10f}   1/1300 = {1.0 / C13:.10f}')
표본 기울기(달러) 기울기(원) 절편(달러) 절편(원) 절편 차
멱 -1.0536373357 -1.0536373357 7.9764 15.1465 7.1701
지수 -1.0256361384 -1.0256361384 8.5044 15.6745 7.1701
ln 1300 = 7.1701 기울기 차 = 0.0e+00, 0.0e+00
λ̂ = 1/x̄ : 0.098143 → 7.5495e-05 비 0.0007692308 1/1300 = 0.0007692308
보너스. 배율 하나로는 부족하다는 것(가정 A3)을 반례로 확인한다. 은 에서만 불변이다.
# 배율 2 하나만 통과하는 반례를 쌓아 가정 A3(모든 b)의 자리를 확인한다
def P_osc(x, g=1.5, e=0.3):
    return x ** (-g) * (1.0 + e * np.cos(2.0 * np.pi * np.log2(x)))


print('P(x) = x^-1.5 (1 + 0.3 cos(2π log2 x))')
print(f"{'x':>6}{'P(2x)/P(x)':>14}{'P(3x)/P(x)':>14}")
for xv in [1.3, 2.7, 10.0]:
    print(f'{xv:6.1f}{P_osc(2 * xv) / P_osc(xv):14.4f}{P_osc(3 * xv) / P_osc(xv):14.4f}')
print(f'이론  2^-1.5 = {2.0 ** -1.5:.4f} (맞는다)     3^-1.5 = {3.0 ** -1.5:.4f} (맞지 않는다)')
P(x) = x^-1.5 (1 + 0.3 cos(2π log2 x))
x P(2x)/P(x) P(3x)/P(x)
1.3 0.3536 0.3175
2.7 0.3536 0.3440
10.0 0.3536 0.2769
이론 2^-1.5 = 0.3536 (맞는다) 3^-1.5 = 0.1925 (맞지 않는다)
# 예측 항목 세 개에 대응하는 수치를 한자리에 모은다
print('[예측 1] 두 배 비율 x = 1, 2, 5, 10, 20')
print('   멱  표본 ' + ', '.join(f'{v:.3f}' for v in par_dbl) + f'   이론 {2.0 ** -ZETA:.3f} 고정')
print('   지수 표본 ' + ', '.join(f'{v:.3f}' for v in exp_dbl))
print('   지수 이론 ' + ', '.join(f'{np.exp(-LAM * t):.3f}' for t in TS))
print('[예측 2] log-log OLS 기울기 (전체 / 상위 10% / 순위 201 이후)')
for name in ['멱', '지수']:
    print(f'   {name:>4}  ' + ' / '.join(f'{s:.3f}' for s in slopes[name]))
print('[예측 3] 1300배 전후')
for name in ['멱', '지수']:
    b1, b2, a1, a2 = unit[name]
    print(f'   {name:>4}  기울기 {b1:.6f} → {b2:.6f} (차 {b2 - b1:+.1e}), '
          f'절편 {a1:.4f} → {a2:.4f} (차 {a2 - a1:.4f})')
print(f'   λ̂  {lam1:.6f} → {lam2:.4e}  ({lam2 / lam1:.3e} 배 = 1/1300)')
[예측 1] 두 배 비율 x = 1, 2, 5, 10, 20
멱 표본 0.503, 0.504, 0.501, 0.524, 0.564 이론 0.500 고정
지수 표본 0.901, 0.818, 0.605, 0.377, 0.183
지수 이론 0.905, 0.819, 0.607, 0.368, 0.135
[예측 2] log-log OLS 기울기 (전체 / 상위 10% / 순위 201 이후)
멱 -1.054 / -1.135 / -1.016
지수 -1.026 / -0.282 / -1.717
[예측 3] 1300배 전후
멱 기울기 -1.053637 → -1.053637 (차 +0.0e+00), 절편 7.9764 → 15.1465 (차 7.1701)
지수 기울기 -1.025636 → -1.025636 (차 +0.0e+00), 절편 8.5044 → 15.6745 (차 7.1701)
λ̂ 0.098143 → 7.5495e-05 (7.692e-04 배 = 1/1300)
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 (eq-w17-6)·(eq-w17-11)·(eq-w17-10)으로 돌아간다.