추정량은 배웠다. 그런데 이 모수가 애초에 데이터에서 결정되기는 하는가. 표본을 무한히 늘려도 답이 정해지지 않는 질문이 있다. 어느 질문이 그런지 식만 보고 가려낼 수 있는가.
LaLonde (1986)의 표 앞에서 멈춘다. 같은 직업훈련 프로그램의 임금 효과가 한 표에 두 방식으로 적혀 있다. 한 행은 무작위로 배정된 대조집단과 견준 실험 추정치다. 나머지 행들은 인구조사와 패널 자료에서 고른 비교집단과 견준 비실험 추정치다. 실험 행은 양수 몇백 달러다. 비실험 행들은 비교집단을 어떻게 고르느냐에 따라 큰 음수에서 양수까지 흩어진다. 같은 프로그램, 같은 참가자, 같은 임금 자료인데 행마다 답이 다르다. 학부 읽기는 각 열이 어떤 추정량 — 평균 차이, 회귀, 선택 보정 — 으로 계산됐는지는 안다. 행마다 표본 크기가 다르다는 것도 안다. 표준오차를 읽고 유의성을 판정하는 것까지도 한다. 그런데 표본이 아무리 커도 행들이 한 값으로 모이지 않으리라는 것, 행마다 다른 것을 재고 있다는 것은 말하지 못한다. 유의성은 행 안의 물음이고, 행 사이의 물음은 다른 종류다.
그 답이 (1)의 둘째 항이다. 비교집단을 바꾸는 것은 E[Y∣D=0]을 바꾸는 일이고, 그때 우변의 첫째 항은 한 자리도 움직이지 않는다. 움직이는 것은 둘째 항, 곧 처치가 없었더라도 두 집단이 달랐을 만큼이다. 비실험 행들이 흩어진 폭은 추정 오차의 폭이 아니라 둘째 항의 폭이다. 두 폭은 성질이 다르다. 앞의 것은 표본이 커지면 줄고, 뒤의 것은 표본이 커져도 그대로다.
같은 결핍이 다른 자리에서 나타난다. Hansen & Singleton (1982)의 결과 표에는 추정치 옆에 χ2 통계량과 그 확률값 — 과대식별 제약의 검정 — 이 적혀 있다. 무엇이 과대인가. 모멘트 조건이 모수보다 몇 개 많은지, 남는 개수가 어디에 쓰이는지를 세어 본 적이 없으면 그 숫자는 읽히지 않는다. (2)의 q와 p가 그 개수다.
추정 이전에 "이 양이 관측 분포의 함수인가"를 묻는 단계가 빠져 있다. 그 단계의 이름이 식별(identification)이다. 그 단계가 없으면 표본이 아무리 커도 좁혀지지 않는 오차와 표본이 커지면 사라지는 오차를 구별하지 못한다. 그 구별은 표본이 아니라 식에서 읽힌다 — 어느 오차가 어느 것인지 식만 보고 가려내는 일이다.
처치집단 평균처치효과(average treatment effect on the treated, ATT), 평균처치효과(ATE), 비처치집단 평균처치효과(ATU)
δ0,δ1
스칼라(잠재 분포의 범함수)
δd=E[Yd∣D=1]−E[Yd∣D=0]
[화폐]
선택편의(selection bias), 효과 이질성의 재료
β0,β1
스칼라
R
[화폐]
더미 회귀의 모집단 계수
P,P,Pobs,ϕ
집합, 확률측도, 확률측도, 함수
P∈P는 (Y0,Y1,D)의 분포; ϕ(P)=P(Y,D); Pobs∈ϕ(P)
—
허용 분포족, 잠재 분포, 관측 분포, 관측 사상
ΘI
집합
⊆Rp
[θ]
식별집합(identified set)
w,θ,θ0,Θ
확률변수(벡터), 벡터, 벡터, 집합
w∈W⊆Rd, θ∈Θ⊆Rp
성분마다 다름
관측 벡터, 모수, 참값, 모수 공간
g,gˉ,gˉn,G
함수, 함수, 함수, 행렬
W×Θ→Rq; Θ→Rq; Θ→Rq; q×p
성분마다 다름; [Gjk]=[gj]/[θk]
모멘트 함수, 모집단 모멘트, 표본 모멘트, 모멘트의 야코비안
q,p
지표(정수)
—
무차원
모멘트 조건 수, 모수 수
W,MG
행렬
q×q
[Wjk]=1/([gj][gk]); [(MG)jn]=[gj]/[gn]
가중행렬(weighting matrix), 소멸행렬(W07의 M과 같은 대수)
A,μ,η,c
행렬, 벡터, 벡터, 벡터
2×3, R3, R2, R3
—, [화폐], [화폐], 무차원
선형 관측 사상, 잠재 칸 평균 μdd′=E[Yd∣D=d′], 관측 칸 평균, 관심 범함수의 계수
같은 E, 다른 정보.(1) 좌변의 E[Y∣D=1]은 관측 분포 Pobs만으로 계산되는 숫자다. 우변의 E[Y0∣D=1]은 같은 기호로 적히지만 잠재 분포 P가 있어야 정의된다. 처치받은 사람의 “받지 않았더라면” — 반사실(counterfactual) — 은 어떤 표본에도 없다. 기호는 이 차이를 숨기고, 표의 “종류” 칸 — 관측 분포의 범함수인가 잠재 분포의 범함수인가 — 이 그것을 드러낸다. 범함수(functional)는 분포를 넣으면 숫자를 돌려주는 함수다. Δ는 Pobs를 넣으면 숫자가 나오고, τATT는 P를 넣어야 숫자가 나온다. 하나 더 갈라 둔다. E[Y∣D=1]은 숫자이고 A4에 나오는 E[Y0∣D]는 확률변수다 — D의 값에 따라 두 값을 취하는 σ(D)-가측 함수이며, W14 2절이 학부의 숫자와 대학원의 함수를 갈라 둔 구분 그대로다.
변수와 파라미터, 첨자.τATT·δ0·θ0은 모집단의 고정된 숫자이고 추정치가 아니다. 모자가 없다. 이 회차는 (15) 전까지 표본을 다루지 않는다 — 식별은 모집단의 성질이고, 그 앞에서 표본 크기 n은 "그것과 무관하다"는 자리에만 나온다. Yd의 아래첨자 d∈{0,1}은 시간이 아니라 처치 상태다. W09 이후의 t가 시점을 가리키던 자리에 여기서는 "어느 세계인가"가 온다. μdd′의 첫 첨자는 잠재결과의 종류, 둘째 첨자는 실제 처치 집단이다 — μ01은 처치받은 집단이 처치 없는 세계에서 받았을 임금이고, 표본에 없는 칸이다. q와 p는 개수이지 확률이 아니다. s는 예제의 선택 강도 Pr(D=1∣H)이며 W10·W11의 저축률 s가 아니다. ν는 (9)에서 반사실의 후보 분포이며 W02의 동차 차수·W19의 상사 지수와 다른 뜻이다.
같은 글자, 다른 이름.β1은 회귀계수(W07)이고 4절 (17)의 β는 할인인자(W13)다. 한 회차에 둘 다 나오므로 첨자 유무로 구별한다. γ는 (17)에서 상대적 위험회피도(W13)이며 W17 이후의 꼬리지수가 아니다. δ0·δ1은 선택편의이며 W10·W11의 감가상각률, W19·W20의 퇴출률과 다른 뜻이다. Δ는 관측 차이이며 W09·W13의 기간 길이, W03의 변화분 접두어와 다른 뜻이다. π는 처치 확률이며 원주율도, W06의 이윤 π(K;r)도, W21의 비중 벡터도 아니다. P는 확률측도(W14·W15)이지 W07의 사영행렬이 아니다. 사영은 W14를 따라 Π로 쓴다 — Πσ(D)는 L2(σ(D)) 위 직교사영, ΠA′는 C(A′) 위 직교사영이다. 직전 회차와의 충돌을 한 줄씩 적는다. W(가중행렬)는 W21의 투입산출 몫 행렬 W·W14의 시험 방향 W∈L2(F)와 다른 글자다. w(관측 벡터)는 W21의 wij·W04의 소득과 다른 글자다. MG는 W07의 소멸행렬 M과 같은 대수를 가진다. g는 모멘트 함수이며 W13이 소비성장 배수에 쓴 g와 다른 글자다. η는 관측 칸 평균이며 W20의 진입률 η와 다른 글자다. A는 2×3 관측 사상이며 W02·W10의 생산성 수준 A·W20의 단위당 연결률 A와 다른 글자다. 표본 크기 n은 W07과 같은 글자이고 W18·W21의 몬테카를로 N과 같은 역할이다. 회차 안에서도 겹치는 글자가 있다. μdd′(칸 평균)와 4절의 μc,μR(로그정규 평균), σ(D)(σ-대수)와 σc,σR,σcR(표준편차·공분산)는 첨자와 괄호로 구별한다.
관측 가능한 차이를 처치효과와 선택편의로 분해한다. 모멘트 조건의 개수와 모수의 개수로 식별·과대식별을 판정한다. W14의 사영이 여기서 세 번째로 쓰인다. W07에서는 행렬 P였고 W14에서는 연산자 ΠF였던 것이 여기서는 세 얼굴로 나온다 — 더미 회귀의 계수, 식별 가정의 문장, "질문의 계수 벡터가 관측 사상의 행공간 위에 있는가"라는 판정.
가정을 번호 붙여 둔다.
A1 (잠재결과·일관성(consistency)) 각 개체는 잠재결과 쌍 (Y0,Y1)을 가지며, 처치 D∈{0,1}에 따라 Y=DY1+(1−D)Y0만 관측된다 Rubin, 1974. 개체 사이에 간섭이 없고 처치는 한 종류다(SUTVA, stable unit treatment value assumption). 관측되는 것은 (Y,D)의 결합분포 Pobs뿐이다 — 공변량도, 도구도, 둘째 결과도 없다.
A2 (적분가능) Y0,Y1∈L2(Ω,G,P). 분해 자체는 L1이면 되지만 사영의 언어(W14)를 쓰기 위해 L2로 둔다. A2’ (유계 지지) (9)에서만: Y0,Y1∈[yL,yU] a.s.
A3 (겹침(overlap)) π:=Pr(D=1)∈(0,1). 두 조건부 기댓값이 모두 정의되려면 두 집단이 모두 존재해야 한다.
A4 (식별 가정 — 평균독립(mean independence)) E[Y0∣D]=E[Y0]. A4’ (무작위 배정) (Y0,Y1)⊥D. A4’는 A4를 함의한다. 둘 다 (10)에서만 쓴다 — 정리의 (i)·(ii)는 A4 없이 성립한다.
A1–A3은 대상이 무엇인지 정한다 — 무엇이 존재하고 무엇이 보이는가. A4만이 잠재결과와 처치 사이의 관계를 말하고, 그 관계는 A1이 보여 주지 않는 칸에 관한 것이다. 실험은 A4’를 설계로 참이 되게 하는 장치이고, 관측 자료에서는 A4를 자료 밖에서 들여와야 한다. A5·A6은 둘째 식 (2)의 것이며, 거기서도 같은 질문 — 자료가 주는 식이 몇 개이고 미지수가 몇 개인가 — 이 반복된다.
번역. 처치집단과 대조집단의 평균 차이는, 처치가 처치집단에 준 효과와 처치가 없었더라도 두 집단이 달랐을 만큼의 합이다. 데이터는 그 합만 보여 주고, 두 조각을 나누는 것은 자료 밖에서 들여온 가정이다. 모멘트 조건은 모수보다 적으면 답을 정하지 못하고, 같으면 답만 정하며, 많으면 답과 함께 모형을 시험할 잣대를 남긴다.
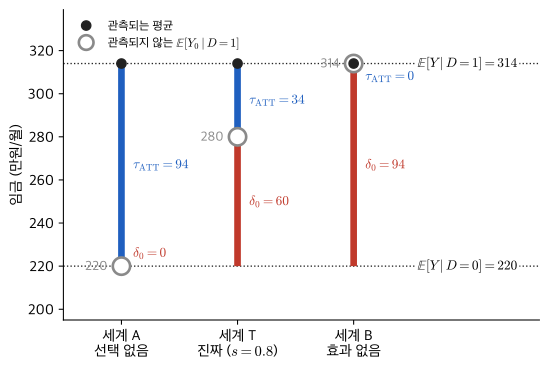
수치 확인 1 — 두 유형 직업훈련 모형. 유형 H·L이 각 절반이고, 잠재 임금(만원/월)은 y0H=300, y1H=330, y0L=200, y1L=250이다. 처치효과는 유형별로 τH=30, τL=50 — 불리한 유형에게 더 크다. 선택 강도 s=Pr(D=1∣H)=1−Pr(D=1∣L)=0.8이면 π=21, Pr(H∣D=1)=0.8, Pr(H∣D=0)=0.2다. 관측: E[Y∣D=1]=0.8⋅330+0.2⋅250=314, E[Y∣D=0]=0.2⋅300+0.8⋅200=220, Δ=94; Cov(Y,D)=23.5, Var(D)=0.25, β1=94, β0=220. 잠재: E[Y0∣D=1]=280, E[Y1∣D=0]=266, τATT=34, δ0=60, τATE=40, τATU=46, δ1=48. 검산 34+60=94, 34−40=0.5×(48−60)=−6. 관측 차이 94는 처치집단 효과 34의 2.8배다.
세계
E[Y0∣D=1]
δ0
τATT
Δ
관측 분포
T (진짜, s=0.8)
280
60
34
94
같음
A (선택 없음, ν=PY∣D=0)
220
0
94
94
같음
B (효과 없음, ν=PY∣D=1)
314
94
0
94
같음
식별집합, [yL,yU]=[150,400]
[150,400]
[−70,180]
[−86,164]
{94}
같음
세 세계의 (Y,D) 분포는 글자 하나까지 같다 — D=1이면 330(확률 0.8)·250(0.2), D=0이면 300(0.2)·200(0.8). 표본이 아무리 커도 세 세계를 가를 통계량은 없다. 식별집합의 폭 250은 n이 얼마든 그대로다. 단조 선택 δ0≥0 — 처치받은 쪽이 처치 없이도 더 나았다 — 을 더하면 [−86,94]가 되고, A4를 더하면 {94}가 된다. 그런데 진짜 값은 34다. 가정이 틀리면 점식별된 답은 확실하게 틀린다.
같은 표를 (11)의 글자로 읽는다. 진짜 세계의 칸 평균은 μ∗=(314,280,220)′이고 관측 칸은 η=(314,220)′이다. Aμ=η의 해집합은 (314,μ01,220)′, μ01은 자유 — 세 세계 A·T·B는 이 직선 위의 세 점 μ01=220,280,314이고 A2’는 직선을 μ01∈[150,400]로 자른다. cΔ′μ=314−220=94는 직선 위 어디서나 같고, cATT′μ=314−μ01은 점마다 다르다. (12)의 ΠA′cATT=(1,0,0)′은 "처치집단의 관측 평균 314"라는 데이터가 답하는 부분이고, (I−ΠA′)cATT=(0,−1,0)′은 "그 집단의 반사실 평균"이라는 데이터가 못 보는 부분이다. 질문 하나가 두 조각으로 갈리고, 자료는 앞 조각만 돌려준다. Figure 1이 세 세계를 한 축에 놓는다.
Figure 1:관측되는 것은 두 점 314·220뿐이다. 그 차 94를 처치효과(파랑)와 선택편의(빨강)로 나누는 방식은 세 세계에서 다르고, 데이터는 셋을 구별하지 못한다.
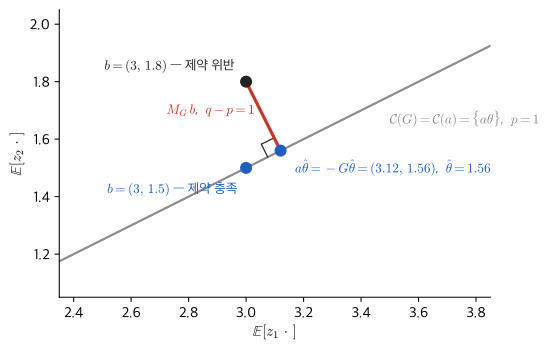
수치 확인 2 — 모멘트 둘, 모수 하나.p=1, q=2, W=I, a:=E[zx]=(2,1)′로 둔다. (가) b:=E[zy]=(3,1.5)′: 두 비 3/2=1.5/1이 같고, θ0=1.5, 잔차 0 — 과대식별 제약이 충족된다. (나) b=(3,1.8)′: 비 1.5=1.8, 어떤 θ도 두 식을 동시에 풀지 못한다. 최소점 θ^=a′b/a′a=7.8/5=1.56, 잔차 b−aθ^=(−0.12,0.24)′, a와의 내적 0, 제곱길이 0.072. MG=I−aa′/5=(0.2−0.4−0.40.8), tr=1=q−p, MG2=MG. (다) z2를 버려 q=1로 하면 θ=b1/a1, 잔차는 항등적으로 0 — (나)의 불일치가 보이지 않게 된다. Figure 2가 이 셈을 평면에 놓는다 — 모형이 허용하는 모멘트 벡터는 원점을 지나는 직선 {aθ}뿐이다.
Figure 2:직선 위의 점만 어떤 θ의 모형 모멘트다. 직선 밖의 점은 사영되고, 남는 잔차 MGb가 과대식별 검정의 재료다. 모멘트가 하나뿐이면 직선이 평면 전체가 되어 잔차가 생길 수 없다.
2절 표가 답이다. 두 줄만 덧붙인다. (1)의 다섯 기댓값 가운데 잠재 분포가 있어야 값이 정해지는 것은 E[Y0∣D=1] 하나다 — E[Y1∣D=1]과 E[Y0∣D=0]은 (3)으로 좌변의 관측 평균과 같은 숫자다. (2)의 θ0은 "gˉ의 영점"이고, q·p는 g의 형상이다. 등호도 종류가 다르다. (1)의 등호는 항등식 — 어떤 잠재 분포에서도 성립한다 — 이고, (2)의 등호는 모형의 주장 — 참 모수에서만 성립한다 — 이다.
(1): “처치받은 집단과 받지 않은 집단의 평균 차이는, 처치가 받은 집단에 준 효과에, 처치가 없었더라도 두 집단이 달랐을 만큼을 더한 것이다.” (2): “모형이 맞다면 어떤 관측 가능한 양들의 평균이 참 모수에서 정확히 0이 된다 — 모수란 그 평균들을 0으로 만드는 값이다.”
두 문장은 한 문장으로 이어진다. 첫째 식은 등식이 하나뿐인데 미지수가 둘이라는 문장이고, 둘째 식은 등식이 q개인데 미지수가 p개라는 문장이다. 부족한 등식을 채우는 것은 첫째에서 A4, 둘째에서 도구이며, 채운 등식이 검정되는 것은 채우고도 남을 때뿐이다.
(1): 다섯 항 모두 [화폐]이고, D·π는 무차원이다. 단위를 Yd→κYd+κ0으로 바꾸면 — κ는 배율, κ0은 이동이며 이 문장 안에서만 쓰는 글자다 — 모든 항이 κ배가 되고 κ0은 차에서 소거된다. 분해는 아핀 변환에 공변한다. 식별집합의 폭 yU−yL도 κ배다. 무차원군은 δ0/Δ — 관측 차이 가운데 선택이 차지하는 비율 — 이며 예제에서 60/94=0.64, 나머지 τATT/Δ=0.36이다.
(2): [gj]=[zj][y]처럼 성분마다 단위가 다르다. 목적함수 gˉ′Wgˉ가 무차원이려면 [Wjk]=1/([gj][gk])이어야 하고, 차원이 강제하는 것은 여기까지다 — S−1(S=Var(g))도 diag(1/Vargj)도 이 조건을 만족하고, 그 가운데 S−1을 고르는 이유는 효율성이다. 식별은 W와 무관하다 — gˉ(θ0)=0이면 어떤 W에서도 θ0이 최소점이므로, 가중은 추정의 문제이고 식별은 모집단의 문제다. Jn은 무차원이고 극한분포 χq−p2의 평균이 정수 q−p다 — W02의 차원 읽기로 정수는 단위가 없고, MG의 대각 성분만 무차원인 것(2절 표)과 정합한다.
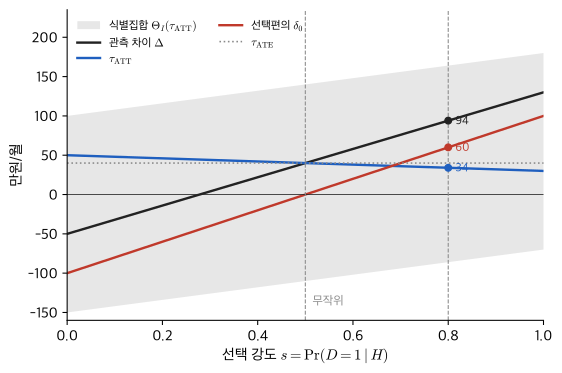
s=21(무작위 배정): δ0=0, Δ=τATT=τATE=40. 실험의 세계 — 가정 A4’가 설계로 참이 된다.
s→1(완전 분류): δ0=100, τATT=30, Δ=130. 관측 차이가 효과의 4.3배다. ATT 자체도 움직인다 — 누가 처치받는가가 바뀌면 "처치집단의 효과"라는 질문의 대상이 바뀐다. β1=Δ는 s의 함수이지만 유형별 잠재임금과 효과 τH,τL은 아니다 — 사영 계수는 체제와 함께 움직이고 구조 원시량은 남는다.
s<21(음의 선택 — 불리한 사람을 겨냥하는 프로그램): δ0<0, Δ<τATT. s<5/18이면 Δ<0이고, s=0이면 Δ=−50<0<τATT=50. 효과가 양수인데 관측 차이는 음수다 — LaLonde (1986)의 비실험 행이 음수였던 구조가 이것이다.
π→0 또는 1: (7)의 분자 Cov(Y,D)=π(1−π)Δ와 분모 Var(D)=π(1−π)가 같은 속도로 0이 되므로 β1=Δ는 극한 직전까지 유한하고, 극한에서는 0/0으로 정의되지 않는다 — 발산이 아니라 미정의다. 한쪽 집단이 비어 A3의 겹침이 깨지고 질문 자체가 자료에 없다 — W07 Q8의 완전 공선성과 같은 자리다. 처치 인원이 적어 β^1의 분산이 커지는 것은 추정의 문제이고, 모집단의 미정의와 다른 자리다.
yU−yL→∞: 식별집합이 R — 자료가 아무것도 말하지 않는다. yU−yL→0: 모든 것이 식별되지만 변동이 없어 물을 것도 없다.
(2)에서 q<p·q=p·q>p: 답 없음·답만·답과 잣대. q→∞ — 조건부 모멘트 E[mt+1Rt+1−1∣Ft]=0, W14 (17)의 “모든 W∈L2(Ft)” — 이면 무한히 많은 모멘트를 쓸 수 있지만, 식별은 θ↦E[mt+1(θ)Rt+1∣Ft]의 단사성에 달려 있다. 아래 Q11의 σcR=0이 그 반례다. W14 (17)은 시험 방향 W를 고르는 일을 추정의 문제로만 적고 지나갔다 — 어느 W라야 θ가 정해지는가는 거기서 묻지 않은 질문이고, 여기서 받는다.
이 가정은 모형의 것인가 데이터의 것인가. s는 데이터에 없다 — 유형 H·L은 관측되지 않는다. s=21이라는 주장은 설계(무작위 배정)이거나 가정이며, 어느 쪽이든 (Y,D)가 확인해 주지 않는다. 반면 π와 Δ는 데이터의 것이다. yL·yU는 중간이다 — 임금이 음수일 수 없다는 것은 자료 밖의 지식이지만, 관측된 Y의 최솟값과 최댓값이 그 안에 있어야 한다는 것은 자료가 확인한다. 자료 밖에서 온 것만이 식별집합을 좁힌다.
Figure 3:선택이 강할수록 관측 차이는 처치효과에서 멀어진다. 회색 띠는 자료만으로 허용되는 처치효과의 범위이며, 어느 s에서도 폭 250이다. s<0.5면 관측 차이가 처치효과보다 작아지고, s<5/18≈0.28이면 효과는 양수인데 관측 차이는 음수가 된다.
어느 양과 어느 양이 균등해지는가. (1)에서 A4 아래 균등해지는 것은 관측되지 않는 처치집단의 반사실 평균과 관측되는 대조집단의 평균이다 — E[Y0∣D=1]=E[Y∣D=0]. 상충은 가정의 세기와 식별집합의 폭 사이에 있다. 아무 가정 없이 [−86,164], 단조 선택으로 [−86,94], 평균독립으로 {94}다. (2)·(15)에서 균등해지는 것은 1계 조건 G′Wgˉn(θ^)=0 — q개 표본 모멘트의 p개 가중 결합이 정확히 0이 되고, q>p면 전부를 0으로 만들 수 없어 나머지 q−p개 방향에 잔차가 남는다.
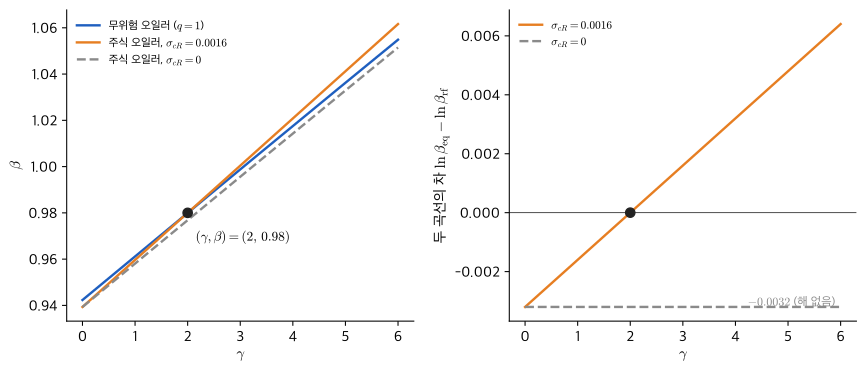
근거 — W13 (2)에 CRRA mt+1=β(ct+1/ct)−γ를 넣은 것이다. W13은 소비성장 배수를 g로 썼지만 이 회차에서 g는 모멘트 함수이므로 비를 그대로 적는다. (ln(ct+1/ct),lnRt+1)은 결합정규, ln(ct+1/ct)∼N(μc,σc2), lnRt+1∼N(μR,σR2), Cov(ln(ct+1/ct),lnRt+1)=σcR. 로그정규 모멘트 E[eaZ]=eaμ+a2σ2/2 — W13 (18)과 같은 계산이며, 거기의 Rf가 이 책의 표준 표기로 Rf다. 여기서 β는 할인인자, γ는 상대적 위험회피도(W13)다 — 3절의 β1·3부의 꼬리지수와 다른 뜻이다. 두 식을 빼면 γ의 1차식이 되므로 σcR=0이면 유일해이고, 그 뒤 β가 정해진다. 수치: β=0.98, γ=2, μc=σc=0.02, σR=0.16, 상관 0.5이면 σcR=0.0016, lnRf=0.0594(W13의 값), μR=0.0498, 로그 프리미엄 μR+21σR2−lnRf=0.0032=γσcR, γ=2.
읽기. 모멘트 하나(q=1, 무위험 자산만)면 (γ,lnβ) 평면의 포물선 하나가 식별집합이다 — W13 (18)이 (β,γ)에서 Rf를 주던 식이 거꾸로 읽히면 Rf에서 곡선을 준다. 둘(q=p=2)이면 점이다. 그러나 σcR=0이면 두 포물선이 평행해 그 차가 상수 lnRf−μR−21σR2가 된다. 그 상수가 0이 아니면(예시값 -0.0032) 두 식을 함께 푸는 θ가 없다 — A5의 θ0이 없고 모형이 기각된다. 0이면 두 곡선이 겹쳐 둘째 모멘트가 γ에 대해 아무것도 더하지 않는다. 어느 쪽이든 개수 조건은 맞고 계수 조건이 깨진다 — Lemma 2의 G의 둘째 열이 첫째 열의 상수배다. 위험 프리미엄을 소비와의 공분산으로 나눈 것이 γ를 식별한다. W13 4절 Q8에서 큰 γ가 필요했던 계산이 여기서는 "식별된 γ가 크다"로 읽힌다 — 다만 그 회차의 샤프비율 0.4와 이 회차의 로그 프리미엄 0.32%는 다른 설정이다. Figure 4가 두 곡선과 평행한 경우를 나란히 놓는다.
Figure 4:모멘트 하나는 (γ,β)의 곡선 하나만 남긴다. 둘째 모멘트가 곡선을 점으로 자르는 것은 수익률이 소비와 공변할 때뿐이다 — 개수 조건은 같은데 계수 조건이 갈린다.
멈추는 줄은 LaLonde (1986)의 표 — 실험 대조집단 행과 여러 비교집단 행들 — 이다. 학부 읽기는 각 행의 추정량이 β1에 일치추정량이라는 것까지 안다. 그런데 행마다 다른 β1을 향해 일치하고 있고, 그중 어느 것이 τATT인지는 표본이 알려 주지 않는다. 학부 읽기는 "추정량이 일치한다"에서 멈추고 "무엇에 일치하는가"를 묻지 않는다. 표의 각 행을 (1)로 읽으면 비교집단을 바꾸는 것은 E[Y∣D=0]을 바꾸는 일이고, 첫째 항은 고정된 채 둘째 항만 행마다 달라진다 — 실험 행은 둘째 항이 설계로 0인 행이다. 같은 자리에서 Hansen & Singleton (1982)의 χ2 통계량 — 과대식별 제약의 검정 — 도 읽히지 않는다. 몇 개가 남는지 세어 본 적이 없기 때문이다. Heckman (1979)이 선택을 명시적 모형으로 다루는 길을 연 것은 이 둘째 항을 0으로 가정하는 대신 그 항 자체를 모형화하는 길이고, 그 모형 역시 자료 밖에서 들여온 가정 위에 선다.
대학원 읽기는 추정 이전에 두 번 센다. 관측 분포가 주는 식이 몇 개, 질문이 걸린 미지수가 몇 개. (11)에서 2<3이면 가정 하나가 필요하고, 그 가정이 채우는 식은 검정되지 않는다는 것까지 (12)의 ΠA′c=c 한 줄로 본다. 식별집합 [−86,164]가 정직한 답이고, {94}는 가정 A4의 값이며, 둘 중 어느 쪽도 진짜 34를 집어 주지 않는다는 것을 3절의 표에서 읽는다 — 구간은 34를 담지만 가리키지 못하고, 점으로 좁힌 94는 34가 아니다 — Manski (2003)이 신뢰성 감소의 법칙(law of decreasing credibility)이라 부른 상충이다. 강한 가정일수록 결론은 좁고 믿기 어렵다. 어느 가정을 들여올지는 통계가 아니라 경제학이 정하며, 그 가정의 값이 어디까지 검정되는지는 개수가 정한다.
구조 모형과 축약형의 다툼이 여기서 보인다. 양쪽은 ϕ(P) — 데이터가 보이는 것 — 에 대해서는 다투지 않는다. 다투는 것은 P다. 구조 모형은 허용 분포를 좁혀 ΘI를 점으로 만들고 q−p개의 검정 가능한 제약을 얻지만, 그 좁힘이 틀리면 점이 틀린다. 축약형은 사영 계수 β1처럼 언제나 식별되는 양에 머물지만, 그 양이 정책 아래 불변이라는 보장이 없다. Lucas (1976)의 비판은 4절 (16)이 보인 것 — 사영 계수 β1=180s−50은 누가 처치받는가(s)가 바뀌면 바뀌지만 τH·τL·ydH·ydL은 바뀌지 않는다 — 을 정책 개입 일반에 대해 말한 것이고, Sims (1980)의 "믿기 어려운 식별 제약"은 계수 조건을 채우기 위해 들여온 0들이 어디서 왔느냐는 물음이며, Koopmans (1949)의 계수 조건이 그 둘 사이의 원점이다. 이 회차가 갈라놓는 것은 "추정이 잘 됐는가"와 "질문이 자료에 있는가"이고, 후자는 자료를 더 모아도 바뀌지 않는다.
관측식 Y=DY1+(1−D)Y0 옆에 "A1 일관성 — {D=1} 위에서 Y=Y1"과 "A3 0<π<1"이 적혀 있는가.
더하고 빼는 줄 (5) 옆에 "E[Y0∣D=1] — 관측되지 않지만 존재(A2·A3)"가 적혀 있고, 어느 항이 ATT이고 어느 항이 선택편의인지 이름이 붙어 있는가.
β1=Δ 줄 옆에 "정규방정식(W07 (8)) · D2=D · Var(D)=π(1−π)>0"과 "이항 D이므로 선형사영 = 조건부 기댓값(W14 (10))"이 적혀 있는가.
비식별 줄에 같은 관측 분포를 주는 두 잠재 분포(선택 없음·효과 없음)가 명시적으로 구성돼 있고, 식별집합의 폭이 표본 크기와 무관하다는 한 마디가 있는가.
식별 가정 줄 옆에 "Πσ(D)Y0=E[Y0]"와 "검정 불가 — 관측 사상의 값이 같음"이 적혀 있는가. 무작위 배정(A4’)과 평균독립(A4)이 구별돼 있는가.
개수 세기 줄에 Aμ=η의 q=2, p=3, kerA의 방향, "cATT는 행공간 밖"이 적혀 있고, A4가 행 하나를 더해 q=p가 되는 것이 적혀 있는가.
모멘트 조건 줄에 계수 조건 rankG=p 옆 "역함수 정리(W06의 야코비안 비특이)"와 개수 조건 q≥p 옆 "필요조건일 뿐"이 적혀 있고, MG의 tr=q−p 계산이 있는가.
번역 문장이 있는가 — 분해와 개수 각각 한 문장.
냉시동 인출(40분) — 1주 전 · 3주 전 · 8주 전 각 1항목. 자료 없이 백지에서 재구성한다. 막힌 항목은 다음 주 “1주 전” 자리에 다시 올린다.
1주 전 — W21 · Leontief 역행렬 → 영향력 벡터 → 감쇠율. 역행렬의 급수 전개와 영향력 벡터의 노름이 n에 따라 줄어드는 속도까지.
3주 전 — W19 · Gibrat + 반사벽 → Pareto · Simon 지수 γ=2+p/(1−p). 반사벽이 없으면 로그정규로 남는 이유까지.
8주 전 — W14 · E[Y∣F] = L2 직교사영 · 타워 성질. 직교조건에 지표함수를 넣어 유한 분할의 칸별 평균이 나오는 줄까지 — 이번 회차의 (3)·(7)이 그 줄에서 온다.
노트북(40분) — w22-lab.ipynb. 코드를 쓰기 전에 다음 셋에 답한다. 답은 3절의 표와 (15)에서 전부 읽어 낼 수 있어야 한다.
두 유형 모형(s=0.8)에서 n=102,103,104,105로 늘릴 때 표본 평균 차이 Δ^는 34로 가는가 94로 가는가. 정규방정식으로 직접 푼 더미 회귀 기울기 β^1은 Δ^와 모든 표본에서 정확히 같은가. — 예측: 94로 간다; 소수점 끝자리까지 같다 — 대수 항등식이며 W07 (18)이다.
시뮬레이션의 잠재 Y0을 신의 시점에서 써서 잰 τ^ATT는 34로 가는가. [150,400]으로 계산한 표본 Manski 경계의 폭은 n에 따라 줄어드는가. — 예측: 34로 간다; 폭은 250에서 움직이지 않고 양끝만 -86·164로 수렴한다.
선형 IV p=1, q=2, n=500, 2,000회 반복, 2단계 GMM. 바른 모형에서 Jn>3.84인 비율과 Jn의 평균은 얼마인가. 잘못된 모형(u에 0.3z2를 섞음)에서 그 비율은, n을 4배로 하면 Jn 평균은 몇 배가 되는가. z2를 버려 q=p=1로 하면 Jn은 얼마인가. — 예측: 약 0.05와 약 1 — 극한분포 χ12의 평균 q−p이며 시뮬레이션 관찰값으로만 확인한다; 1.00과 약 4배 — Jn은 n에 비례한다; 항등적으로 0.
계산은 패키지 호출 없이 한다. 유형을 반반으로 뽑고 D를 Pr(D=1∣u)로, (Y0,Y1)을 유형별 상수로 만들어 Y=DY1+(1−D)Y0을 직접 쌓는다. β^1은 X=[1D]로 X′X, X′y를 만들어 푼다. 선형 IV는 z1,z2,v,e를 표준정규로 뽑아 x=z1+0.5z2+v, u=0.5v+e(바른 모형) 또는 u=0.5v+0.3z2+e(틀린 모형), y=1.5x+u로 두고, 1단계 W=I, 2단계 W=S^−1로 θ^와 Jn을 식 그대로 계산한다. 틀린 모형의 W=I 유사참값은 a=(1,0.5)′, b=(1.5,1.05)′에서 a′b/a′a=1.62이고 두 비는 1.5·2.1이다. 대조 표는 예측 | 결과 | 어긋남 | 원인 4열이다.
지금은 이렇게 읽힌다. 좌변의 두 기댓값은 관측 분포의 숫자이고, 우변의 E[Y0∣D=1]은 어떤 표본에도 없는 잠재 분포의 숫자다 — 같은 E가 두 종류다. 다섯 항은 모두 [화폐]이고 분해는 단위에 공변하며, 관측 차이 가운데 선택의 몫 δ0/Δ가 무차원 지표다. 좌변은 더미의 회귀계수, 곧 사영 계수이므로 언제나 식별되고, 우변의 두 항은 관측 사상의 핵 방향으로 서로 상쇄되는 성분을 가져 합만 식별된다. 그 핵을 메우는 것이 "반사실을 처치 정보에 사영하면 상수"라는 가정 A4이고, 그 가정은 식을 하나 채우되 남기지 않으므로 검정되지 않는다. 모멘트가 모수보다 많을 때만 남는 것이 생기고, 남는 개수 q−p가 검정 통계량 극한분포의 평균이다. 예제의 94는 34와 60으로 갈리지만, 자료가 보는 것은 94 하나이고 띠의 폭 250은 표본이 커져도 줄지 않는다.
더하고 빼기가 왜 식별을 바꾸지 못하는지 보이지 않으면 3절의 (9)로, 개수가 안 세어지면 (11)로 돌아간다.
다음 회차 W23 · 모형을 캐리커처로 읽기는 식별 가정을 데이터의 결함이 아니라 저자가 분리하려 한 인과 채널의 선택으로 읽고, 그 선택을 직접 한 번 한다.
이어지는 자료 — 식별 문헌 · 이 회차는 4년 계획의 실증 축으로 가는 분기점이다 · Manski, Identification Problems in the Social Sciences 1–2장 Manski, 1995 · Angrist & Pischke, Mostly Harmless Econometrics 2장 — 선택편의와 효과 이질성의 분해 Angrist & Pischke, 2009 · Lewbel, The Identification Zoo — 식별이라는 낱말의 여러 뜻 Lewbel, 2019 · Imbens & Angrist — 도구가 있을 때 무엇의 효과가 식별되는가(이 회차 밖) Imbens & Angrist, 1994
LaLonde, R. J. (1986). Evaluating the Econometric Evaluations of Training Programs with Experimental Data. The American Economic Review, 76(4), 604–620.
Hansen, L. P., & Singleton, K. J. (1982). Generalized Instrumental Variables Estimation of Nonlinear Rational Expectations Models. Econometrica, 50(5), 1269–1286. 10.2307/1911873
Rubin, D. B. (1974). Estimating Causal Effects of Treatments in Randomized and Nonrandomized Studies. Journal of Educational Psychology, 66(5), 688–701. 10.1037/h0037350
Koopmans, T. C. (1949). Identification Problems in Economic Model Construction. Econometrica, 17(2), 125–144. 10.2307/1905689
Holland, P. W. (1986). Statistics and Causal Inference. Journal of the American Statistical Association, 81(396), 945–960. 10.1080/01621459.1986.10478354
Manski, C. F. (1995). Identification Problems in the Social Sciences. Harvard University Press.
Manski, C. F. (2003). Partial Identification of Probability Distributions. Springer.
Manski, C. F. (1990). Nonparametric Bounds on Treatment Effects. The American Economic Review, 80(2), 319–323.
Rothenberg, T. J. (1971). Identification in Parametric Models. Econometrica, 39(3), 577–591.
Hansen, L. P. (1982). Large Sample Properties of Generalized Method of Moments Estimators. Econometrica, 50(4), 1029–1054. 10.2307/1912775
Newey, W. K., & McFadden, D. (1994). Large Sample Estimation and Hypothesis Testing. In Handbook of Econometrics (Vol. 4, pp. 2111–2245). Elsevier.
Heckman, J. J. (1979). Sample Selection Bias as a Specification Error. Econometrica, 47(1), 153–161. 10.2307/1912352
Lucas, R. E., Jr. (1976). Econometric Policy Evaluation: A Critique. Carnegie-Rochester Conference Series on Public Policy, 1, 19–46. 10.1016/S0167-2231(76)80003-6
Sims, C. A. (1980). Macroeconomics and Reality. Econometrica, 48(1), 1–48. 10.2307/1912017
Angrist, J. D., & Pischke, J.-S. (2009). Mostly Harmless Econometrics: An Empiricist’s Companion. Princeton University Press.