Et[⋅]의 아래첨자 t는 정확히 무엇인가. 논문은 답하지 않고 다음 줄에서 첨자를 지운다. 반복기댓값의 법칙은 왜 성립하는가.
Cochrane (2005) 1장의 장면이다. 기본 가격식 pt=Et[mt+1xt+1]을 적은 뒤 바로 다음 줄에서 첨자를 떼고 무조건부 1=E[mR]로 넘어간다. W13이 같은 자리를 지났다. (2)의 1=Et[mt+1Rt+1]은 조건부였고, (3)의 Cov(m,R)은 무조건부다. 조건부 위험 프리미엄 (14)에서 (3)으로 가는 사이에 빈 줄이 하나 있다. 그 빈 줄에서 일어나는 조작은 "첨자 t를 지운다"이다. W13은 그 자리에서 상수 Rf라는 가정은 따로 적었고, 첨자를 지우는 조작 자체의 근거는 반복기댓값의 법칙이라는 이름으로만 불렀다. 이름은 근거가 아니다.
학부 확률로 이 빈 줄을 메우려 하면 막힌다. 학부의 조건부 기댓값은 E[Y∣A]=E[Y1A]/P(A), 사건 A 하나에 숫자 하나를 돌려주는 공식이다. 논문의 Ft는 사건 하나가 아니라 "t까지 관측된 모든 변수의 모든 역사"다. 가격·소비·금리의 과거 경로 전부를 조건으로 거는데, 연속 변수에서 그 조건 사건의 확률은 0이다. 분모가 0이고 분자도 0이다. 공식을 적용할 대상이 없는 자리에서 학부 읽기는 멈춘다.
같은 결핍이 다른 얼굴로 나타난다. Hall (1978)의 따름정리 — “t기에 알려진 어떤 변수도 ct+1의 예측에 ct 이상의 정보를 주지 못한다” — 는 검정 가능한 명제다. 논문은 이것을 ct+1이 ct의 1차식에 예측오차 εt+1을 더한 것, Et[εt+1]=0으로 적고, 다음 줄에서 "εt+1은 t기의 모든 변수와 직교(orthogonal)한다"고 말한 뒤, 소득·주가·과거 소비를 우변에 추가해 계수가 0인지 본다. 세 줄이 각각 다른 조작이다. 첫 줄은 Et를 잔차로 바꾸고, 둘째 줄은 "조건부 평균 0"을 "모든 것과 직교"로 바꾸며, 셋째 줄은 그 “모든 것” 가운데 몇 개를 골라 표본으로 재는 일이다. 무엇이 무엇과 직교한다는 뜻인지 모르면 둘째 줄을 읽을 수 없고, 둘째 줄을 읽지 못하면 셋째 줄의 회귀식을 세울 수 없다. 어느 변수를 우변에 넣어야 하는가. 왜 어느 변수를 넣어도 되는가. "정보집합에 속한 변수"라는 답은 정보집합이 무엇의 이름인지 알 때만 답이 된다. Muth (1961) 이후 경제학의 "기대"는 정보집합 조건부 기댓값이라는 규약으로 고정됐고, 그 규약의 수학은 확률 공식이 아니라 함수 공간의 기하다.
조건부 기댓값을 "계산 절차"가 아니라 "정보로 만든 함수 공간 위의 직교사영(orthogonal projection)"으로 읽지 않으면, 첨자를 붙이고 떼는 논문의 한 줄 한 줄에 근거를 댈 수 없다. 그 빈 줄의 근거가 이 회차가 메우는 결핍이다.
집합의 집합과 함수의 공간.F는 사건들의 모임이고 L2(F)는 그 사건들로 만들 수 있는 함수들의 공간이다. 둘은 종류가 다르다. σ-대수는 Ω의 부분집합족 가운데 Ω를 담고 여집합과 가산 합집합에 닫힌 것이다 — 판별할 수 있는 사건의 여집합도, 판별할 수 있는 사건들의 합집합도 판별할 수 있다는 뜻이다. 2기 이항나무 S0=100, u=1.2, d=0.9, p=0.6에서 세어 본다. 1기 정보 F1={∅,{uu,ud},{du,dd},Ω}는 원소가 4개인 집합족이고, {uu,ud}와 {du,dd}가 서로 여집합이며 그 합집합이 Ω이므로 위 조건을 만족한다. 그 위의 L2(F1)은 cu1up+cd1down 꼴 전부, 곧 2차원 벡터공간이다. F0={∅,Ω} 위의 L2(F0)은 상수뿐이므로 1차원이고, F2=2Ω 위의 L2(F2)는 4차원이다. "정보가 많다"는 "부분공간이 크다"로 읽는다. 사건을 하나 더 구별할 수 있으면 함수를 하나 더 만들 수 있다.
확률변수와 숫자. 학부의 E[Y∣A]=E[Y1A]/P(A)는 숫자다. E[Y∣F]는 ω마다 값이 다른 함수, 곧 확률변수다. 분할이 유한할 때 이 함수는 각 칸 위에서 그 칸의 E[Y∣Aj]를 취한다 — 3절의 (10)이 그 등식이다. 논문의 약기 둘을 풀어 둔다. E[Y∣X]는 E[Y∣σ(X)], 즉 X가 만드는 사건족을 조건으로 건 것이다. σ(X)는 X의 값으로 판별할 수 있는 사건 전부의 모임이고, 예제에서는 σ(S1)=F1이다 — S1이 120인지 90인지로 갈라지는 사건이 up·down 둘뿐이기 때문이다. Et[⋅]는 E[⋅∣Ft]의 약기이며 W13이 이 약기로 오일러 방정식을 적었다. 도입의 질문 "아래첨자 t는 무엇인가"의 답은 여기 있다. t는 시점이 아니라 σ-대수 Ft의 이름표이고, 그 σ-대수가 부분공간 L2(Ft)를 정한다.
형상 칸을 W01의 정의역→공역으로 읽는다. E[⋅∣F]의 입력은 L2(G)의 어떤 확률변수이고 출력은 L2(F)의 원소다. 출력이 입력보다 거친 함수다 — 큰 사건족으로 판별되던 차이가 작은 사건족에서는 판별되지 않으므로 뭉개진다. 나무에서 S2는 네 값을 갖지만 E[S2∣F1]은 두 값, E[S2∣F0]은 한 값을 갖는다. 뭉개지는 방식이 평균이라는 것, 그 평균이 제곱오차의 최소점이라는 것이 Theorem 1의 내용이다. Y^t의 아래첨자도 시점이 아니라 어느 부분공간에 내렸는가의 표시이며, Y^ 위의 모자는 W07의 β^·y^와 같은 뜻 — 사영해서 얻은 값 — 이다. ε에는 분포 가정이 없다. W07이 오차항 없이 대수만으로 사영을 다뤘듯, 여기서도 ε=Y−Y^는 정의이지 가정이 아니다.
같은 글자, 다른 이름.P는 W07에서 사영행렬 X(X′X)−1X′이었고 이 회차에서는 확률측도다. 그래서 이 회차의 사영 연산자는 ΠF로 쓴다. M은 W07의 소멸행렬 I−P다. 교과서가 마팅게일(martingale)에 쓰는 Mt는 이 회차에서 Y^t로 적는다. e는 W07의 잔차 My였고, 여기의 ε=Y−Y^는 같은 기하 — 부분공간에 수직인 성분 — 의 다른 이름이다. u·d는 상승·하락 배수이며 W01의 효용함수 u와 다른 글자다. W는 시험 방향이며 W09의 위너 과정 Wt, W13의 부 Wt와 다른 대상이다. p는 상승확률이며 W01의 가격 벡터 p가 아니고, 1절·5절에 나오는 W13의 가격 pt=Et[mt+1xt+1]과는 첨자 유무로 갈린다. ϵ은 3절 (7)의 섭동 크기 — 실수 — 이고, ε=Y−Y^는 예측오차 — 확률변수 — 다. 분할의 칸 수는 n, 몬테카를로의 관측 수는 N이다. 이 회차의 t는 시간 첨자로만 쓴다.
조건부 기댓값이 L2에서의 직교사영임을 보이고, 반복기댓값의 법칙을 사영의 타워 성질로 유도한다. W07의 P와 같은 구조다. 유한차원에서 P2=P, P′=P였던 것이 함수 공간에서 Π2=Π, 자기수반(self-adjoint)으로 다시 나온다.
가정을 번호 붙여 둔다.
A1 (제곱적분가능) (Ω,G,P)는 확률공간이다. Y∈L2(Ω,G,P), 즉 E[Y2]<∞. 조건부 기댓값은 L1에서도 정의되지만, 이 회차의 사영 특성화는 L2에서만 말한다.
A2 (정보의 포함) F⊆G는 σ-대수다. 타워에서는 Ft⊆Ft+1⊆G — 정보는 잊히지 않는다. L2(F)는 덧셈·상수배·차에 닫힌 선형부분공간이고, Ft⊆Ft+1이면 L2(Ft)⊆L2(Ft+1)이다. 상수는 모든 L2(F)에 속한다.
A3 (빌려 오는 정리 — 사영 정리) L2(G)는 완비(complete)이고, L2(F)는 그 안의 닫힌 부분공간이며, 힐베르트 공간(Hilbert space)의 닫힌 부분공간 위에는 각 점에서 가장 가까운 점이 존재한다. 단순함수 — 지표함수의 유한 선형결합 — 는 L2(F)에서 조밀(dense)하다. 이 회차는 이것들을 증명하지 않고 빌린다 Luenberger, 1969Durrett, 2019. 골격의 "가정 확인용"이 이 자리다.
A4 (동일시) P(X=Z)=1인 두 확률변수는 같은 것으로 본다. 이 회차의 "유일"은 모두 이 뜻이다.
A5 (유한 분할 특수경우) (10)에서만: F=σ(A1,…,An), A1,…,An은 Ω의 분할, 모든 P(Ai)>0.
A3이 사는 곳을 짚어 둔다. 유한차원에서는 A3이 필요 없다. 나무의 L2(F1)은 R2이고, R2 위의 강볼록 2차함수(양정치 2차형식)는 최소점을 반드시 갖는다 — W07이 X′X의 양정치성으로 정규방정식의 해를 얻은 것과 같은 이유다. 무한차원에서는 "가장 가까운 점"이 있다는 것 자체가 정리다. 부분공간이 닫혀 있지 않으면 거리의 하한에 다가가는 점열은 있어도 그 하한을 달성하는 점은 없을 수 있다. L2(F)가 닫힌 부분공간이라는 것과 L2(G)의 완비성이 그 점열의 극한을 공간 안에 붙잡아 준다. 이 회차는 그 붙잡는 일을 빌리고, 붙잡힌 점이 무엇인지 — 직교조건, Kolmogorov 등식, 타워 — 를 증명한다. A1의 L2 한정도 같은 자리에서 온다. 조건부 기댓값은 E∣Y∣<∞만으로 정의되지만, 그때는 내적이 없으므로 "직교"라는 말을 할 수 없다. 사영으로 읽는 것은 L2의 특권이다.
번역. 정보로 만들 수 있는 모든 예측 가운데 제곱오차가 가장 작은 것이 조건부 기댓값이고, 그때 남는 오차는 그 정보로 만든 어떤 양과도 상관이 없다. 정보를 줄여 가며 예측을 거듭해도 결과는 가장 적은 정보로 한 번에 예측한 것과 같다. 예측의 경로는 마팅게일이고, 예측의 수정은 어제의 정보로 예측되지 않으며, 예측의 분산은 정보가 쌓일수록 커진다.
세 얼굴이 한 대상이다. 최소점(8)은 최적화의 얼굴, 직교조건(7)은 기하의 얼굴, Kolmogorov 등식(4)은 측도론의 얼굴이다. 논문이 어느 얼굴로 적든 같은 것을 가리키며, 어느 얼굴에서 다른 얼굴로 옮겨 가는 데 필요한 조작은 시험 방향 W를 고르는 일뿐이다. W=Y^−Z를 고르면 최소가 나오고, W=1A를 고르면 조건부 확률이 나오며, W∈L2(Ft)로 제한하면 타워가 나온다.
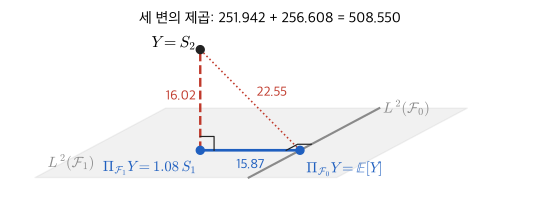
수치 확인. 2기 이항나무 S0=100, u=1.2, d=0.9, p=0.6에서 전부 손으로 계산된다. 상태 Ω={uu,ud,du,dd}, 확률 (0.36,0.24,0.24,0.16), S2∈{144,108,108,81}, S1∈{120,90}. Y=S2, F1=σ(S1)로 둔다. (10)으로 칸별 평균을 구하면 cu=(0.36⋅144+0.24⋅108)/0.6=129.6, cd=(0.24⋅108+0.16⋅81)/0.4=97.2이고, 둘 다 1.08S1이다. 타워: E[Y^1]=0.6⋅129.6+0.4⋅97.2=116.64=E[S2]. 직교: E[(S2−Y^1)1up]=0.36⋅14.4−0.24⋅21.6=0. up 칸 안에서 양의 오차 14.4와 음의 오차 -21.6이 확률 0.36과 0.24로 정확히 상쇄된다 — 칸별 평균이라는 말의 뜻이 이것이다. 피타고라스: Var(S2)=508.550, Var(Y^1)=251.942, E[(S2−Y^1)2]=256.608, 합 251.942+256.608=508.550. 조건부 분산은 up 칸 311.04, down 칸 174.96, 확률가중평균 256.608이다. up 칸의 조건부 분산이 큰 것은 주가가 높을수록 같은 배수가 더 큰 금액을 움직이기 때문이고, 두 칸의 비 311.04/174.96=(120/90)2이 그 이유를 숫자로 적는다. 모든 숫자는 정확한 유리수다. 후보 예측을 공간별로 늘어놓으면 최소점이 어디 있는지가 보인다.
후보 Z
속하는 공간
E[(S2−Z)2]
E[S2]=116.64
L2(F0)
508.550
S1
L2(F1)
332.640
1.08S1=E[S2∣F1]
L2(F1)
256.608
S2
L2(F2) — 후보 아님
0
표의 네 줄은 중첩된 네 공간이다. 첫 줄의 상수는 1차원 공간 L2(F0)의 최소점이고, 셋째 줄은 그것을 품는 2차원 공간 L2(F1)의 최소점이며, 넷째 줄은 4차원 전체 공간의 최소점 — Y 자신 — 이다. 공간이 커질수록 최소 오차는 508.55, 256.608, 0으로 줄어든다. 줄어드는 폭 508.550−256.608=251.942가 바로 Var(Y^1)이다. 정보 F1이 사들이는 것은 예측의 분산만큼의 오차 감소이고, (13)이 그 회계다. S1 그대로를 예측으로 쓰면 L2(F1) 안에 있으면서도 최소점이 아니다. 오차 332.64와 256.608의 차 76.03은 ∥Y^1−S1∥2=0.082E[S12]=0.0064⋅11880과 같다 — (6)의 둘째 항이며, 최소점에서 벗어난 거리의 제곱이 오차에 그대로 더해진다. 세 변의 길이 256.608=16.02, 251.942=15.87, 508.550=22.55를 축척대로 놓으면 Figure 1이 된다.
Figure 1:Y를 큰 부분공간 L2(F1)에 내린 발을 다시 작은 부분공간 L2(F0)에 내리면 처음부터 작은 부분공간에 내린 발과 같다. 세 변은 피타고라스를 만족한다 — 251.942+256.608=508.550.
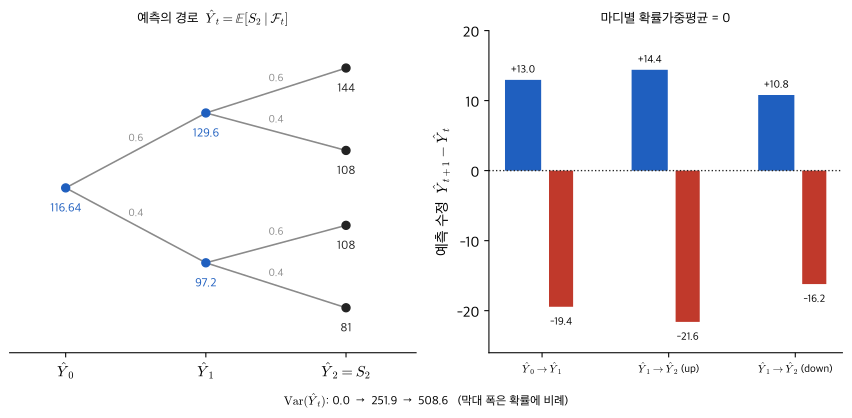
(14)를 같은 나무에서 본다. Y^0=116.64, Y^1∈{129.6,97.2}, Y^2=S2. 각 마디의 값은 자식 값의 확률가중평균이다. 뿌리에서의 수정 +12.96(확률 0.6)과 -19.44(확률 0.4)는 가중평균이 0이고, up 마디의 +14.4·-21.6, down 마디의 +10.8·-16.2도 같다. 분산은 0→251.9→508.6으로 커진다. Figure 2가 이것을 그린다. 마팅게일인 것은 예측의 경로 Y^t이지 주가 St가 아니다. 이 나무에서 E[St+1∣Ft]=1.08St=St이므로 주가는 마팅게일이 아니고, 그럼에도 "S2에 대한 예측"의 경로는 어떤 (u,d,p)에서도 마팅게일이다. 예측 대상이 무엇이든 (14)는 사영의 성질만으로 성립한다.
Figure 2:예측은 정보가 쌓일수록 흩어지지만, 수정의 방향은 직전 정보로 예측되지 않는다. 각 마디에서 수정폭의 확률가중평균은 0이다.
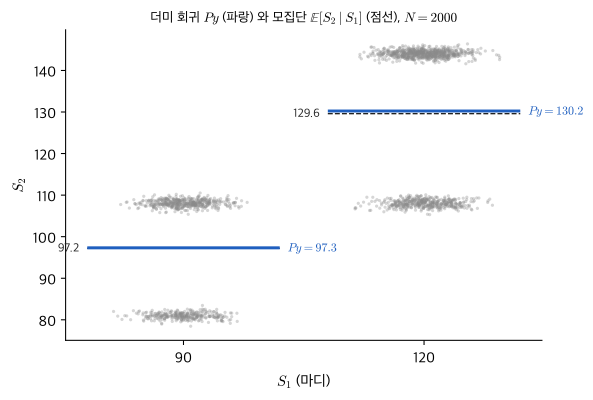
(10)의 W07 고리를 몬테카를로로 본다. N=2000 경로를 만들고 S1 마디 지표 두 열을 X로 두면 X′X=diag(Nup,Ndown)이고, P=X(X′X)−1X′는 각 관측을 그 칸의 표본평균으로 바꾼다. 씨앗 0에서 그 값은 130.2와 97.3이며, Figure 3에서 모집단값 129.6·97.2 옆에 붙어 있다. 차이는 표본오차다 — up 칸의 조건부 표준편차 311.04=17.6을 칸의 관측 수 약 1200의 제곱근으로 나눈 0.5 안팎이다. P2=P, P′=P가 프로베니우스 노름 10-12 아래로 맞고, P0=11′/N에 대해 P0P=P0이 같은 정밀도로 맞는다 — 전체 평균으로 보내는 사영과 칸별 평균으로 보내는 사영의 합성이 전체 평균으로 보내는 사영이라는 것, 곧 타워의 행렬 판이다. 상수항 열은 두 지표 열의 합이므로 C(1)⊂C(X)이고, 포함 관계가 있는 열공간의 사영은 W07 (1)의 대수만으로 합성된다.
Figure 3:유한 분할 위의 사영은 더미 회귀다. Py(파랑)는 칸별 표본평균이고, 모집단 조건부 기댓값(점선)에 붙는다. W07의 P가 이 회차의 ΠF1의 표본 판이다.
2절 표가 답이다. 한 줄만 덧붙인다. (1)의 argmin은 숫자를 돌려주는 최소화가 아니라 함수를 돌려주는 최소화다. 변수가 Z 하나로 보이지만 Z는 L2(F)의 원소이고, 예제에서는 (cu,cd)∈R2다. 우변의 E[⋅]는 무조건부 기댓값 — L1(G)→R — 이고, 좌변의 E[⋅∣F]는 L2(G)→L2(F)다. 같은 글자 E가 한 식 안에서 두 형상으로 나온다. 등호도 A4의 등호다 — 좌변과 우변은 확률 1로 같은 함수이며, 확률 0인 상태에서 값이 달라도 같은 것으로 본다.
(1): “정보 F만으로 만들 수 있는 예측 가운데 제곱오차를 가장 작게 하는 것이 조건부 기댓값이다.” (2): “먼 미래를 내일의 정보로 먼저 예측하고 그 예측을 다시 오늘의 정보로 예측하면, 처음부터 오늘의 정보로 예측한 것과 같다 — 작은 정보가 이긴다.” 순서를 바꿔 오늘의 예측을 내일의 정보로 다시 예측해도 답은 오늘의 예측이다. 오늘의 예측은 이미 내일의 공간 안에 있기 때문이다.
같은 식을 다른 얼굴로 번역하면 문장이 바뀐다. 직교조건의 얼굴: “최선의 예측이 남긴 오차는 그 정보로 만든 어떤 양과 곱해 평균해도 0이다.” Kolmogorov의 얼굴: “정보로 판별할 수 있는 어떤 사건 위에서도 예측의 평균과 실제의 평균이 같다.” 세 문장은 같은 대상의 세 이름 — 최소화·직교·Kolmogorov — 이고, 논문은 셋 가운데 편한 것을 골라 적는다. 자산가격 논문의 모멘트 조건은 직교의 얼굴이고, 계량 교과서의 조건부 기댓값 함수는 최소화의 얼굴이며, 확률론 교과서의 정의는 Kolmogorov의 얼굴이다.
(1) 좌변은 [Y]다. 우변의 목적함수 E[(Y−Z)2]는 [Y]2이지만 argmin은 Z를 돌려주므로 [Y]다. 양변이 맞는다. (2)는 양변 [Y]. F·P·1A는 무차원이다 — 정보에는 단위가 없다. 화폐 단위를 바꿔 Y→cY+b로 놓으면 (8)의 선형성과 "상수 ∈L2(F)"로 ΠF(cY+b)=cΠFY+b이므로 사영은 단위 변경에 공변한다. 원화로 예측하고 달러로 바꾸나 달러로 바꾸고 예측하나 같다. 직교조건의 "0"은 [Y][W] 단위를 가진 0이다. 연산자 ΠF 자체는 무차원이다 — W07의 P가 무차원 행렬이었던 것과 같은 이유로, 입력의 단위를 그대로 출력에 넘긴다.
무차원군은 하나다: Var(E[Y∣F])/Var(Y) — 정보의 설명력, 모집단 R2. 예제에서 251.942/508.550=0.495이고, F1이 S2 분산의 49.5%를 설명한다. (13)에 의해 이 비율은 항상 [0,1] 안에 있다. "제곱"은 무고하지 않다. 절대오차 E∣Y−Z∣를 최소화하면 조건부 중앙값이 나오는데, 그것은 선형 연산자가 아니므로 사영이 아니고 타워도 성립하지 않는다. 제곱을 골랐기 때문에 내적이 생기고, 내적이 있기 때문에 직각이 있다.
F={∅,Ω}: L2(F)는 상수뿐이고 E[Y∣F]=E[Y]다. 정보 없는 세계 — 예측은 평균이고 오차는 분산 전부(예제에서 508.55)다.
F⊇σ(Y): Y∈L2(F)이므로 E[Y∣F]=Y, 오차 0. 완전 예견의 세계다.
Y가 F와 독립: 모든 A∈F에서 E[Y1A]=E[Y]P(A)=E[E[Y]1A]이므로 상수 E[Y]가 (4)를 만족하고, E[Y∣F]=E[Y]다. 정보가 아무리 많아도 무관하면 없는 것과 같다. 직교는 "작다"가 아니라 "무관하다"의 기하다.
Ft⊆Ft+1이 깨질 때: 타워는 거짓이다. 반례 하나. 나무의 두 배수로 F=σ(ξ1), H=σ(ξ2), Y=ξ1+ξ2를 두면 ΠFΠHY=ΠF(E[ξ1]+ξ2)=E[ξ1]+E[ξ2]인데 ΠFY=ξ1+E[ξ2]다. 두 사영의 합성이 작은 쪽 사영과 같아지는 것은 부분공간이 포함 관계일 때뿐이다. 이 예에서 합성은 ΠF0, 곧 둘 중 어느 것도 아닌 다른 사영이 된다. 경제로 옮기면 ξ2만 보는 사람의 예측을 ξ1만 보는 사람이 다시 예측하는 세계 — 정보가 공유되지 않는 세계 — 이고, 거기서는 둘의 정보가 모두 씻겨 나가 무조건부 평균만 남는다.
정보가 커지는 방향은 단조다. Ft⊆Ft+1이면 (6)을 F=Ft+1, Z=Y^t — A2로 L2(Ft+1)에 속한다 — 에 적용해 E[(Y−Y^t)2]=E[(Y−Y^t+1)2]+E[(Y^t+1−Y^t)2]≥E[(Y−Y^t+1)2]이다. 정보를 더하면 최소 오차는 줄거나 같다 — 예제에서 508.55에서 256.608로, 다시 0으로. 정보를 더했는데 오차가 늘어나는 일은 없다. 그것이 무관한 정보이면 사영이 그것을 쓰지 않을 뿐이다.
나무의 파라미터를 극단으로 보낸다. u=d이면 S2는 F0-가측이고 오차는 0이다. p→1 또는 p→0이면 확률이 한 경로에 몰려 Var(S2)→0이고 사영은 자명하다. p=0.5, u=1/d이면 E[S2∣F1]=21(u+d)S1>S1 — 배수가 대칭이어도 산술평균이 1을 넘으므로 예측은 위로 치우친다. 같은 나무에서 pu+(1−p)d=1이 되도록 p를 고르면 — p=(1−d)/(u−d)=1/3 — 예측은 S1 자신이 되고 주가의 경로가 마팅게일이 된다. 이 모든 경우가 한 식의 pu+(1−p)d를 움직여 읽힌다.
어느 양과 어느 양이 균등해지는가. 최적점에서 E[Y^W]=E[YW], 모든 W∈L2(F). 예측값과 실제값은 정보로 만든 어떤 양과도 같은 내적을 갖는다. 한계 원리로 읽으면, Y^에 ϵW를 더해 얻는 제곱오차의 한계 감소가 모든 방향 W에서 0이다 — 남은 오차에 정보로 짜낼 것이 없다. 경제 번역이 둘 있다.
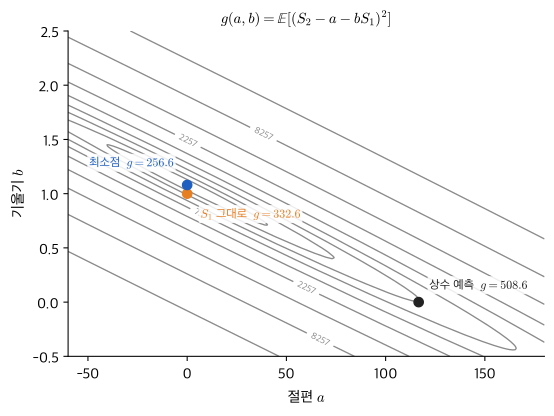
(1) 제곱오차 곡면과 정규방정식. S1이 두 값이므로 {a+bS1}=L2(F1)이다(2차원 = 2차원). 아래의 최소점이 곧 조건부 기댓값인 것은 그 때문이다. 이 우연은 S1이 이진이라서 생긴다. 일반적으로 span{1,X} 위 사영(최선 선형예측)은 L2(σ(X)) 위 사영보다 작은 공간의 사영이고 둘은 다르다 — 같은 기하, 다른 부분공간.
근거 — (7)에 W=1, W=S1. 수치: E[S1]=108, E[S12]=11880, E[S1S2]=12830.4, E[S22]=14113.44. b∗=Cov(S1,S2)/Var(S1)=233.28/216=1.08, a∗=116.64−1.08⋅108=0. g(0,1.08)=256.608, g(0,1)=332.64, g(116.64,0)=508.550. E[S1S2]=1.08E[S12] 자체가 (7)에 W=S1을 넣은 직교조건 ⟨S2−Y^1,S1⟩=0 — F1-가측 인수를 E1 안으로 넣는 조작 — 의 사용이다. Figure 4가 곡면의 등고선과 세 점을 보인다.
Figure 4:g(a,b)=E[(S2−a−bS1)2]의 등고선. 상수 예측(검정) 508.6, S1 그대로(주황) 332.6, 최소점 (0,1.08)(파랑) 256.6. S1이 두 값이므로 이 평면이 L2(F1) 전체다.
(2) W13 고리. (2)의 Et는 ΠFt다. 첨자를 지우는 줄과 Hall의 직교 검정이 한 식에서 나온다.
근거 — 첫째: (2)에 F0={∅,Ω} — 타워, 작은 정보가 이긴다. (2)에서 무조건부 1=E[mR]로 가는 줄이 이것이다 — (14)에서 (3)으로 가는 빈 줄에는 상수 Rf가 하나 더 겹쳐 있고, 5절에서 가른다. 둘째: (7), 상수 1은 Ft-가측. mt+1Rt+1∈L2(G)는 여기서 추가로 가정한다 — W13 A5(모든 조건부 2차 모멘트 유한)는 조건부만 말하고, a.s. 유한한 조건부 2차 모멘트의 기댓값은 무한할 수 있으므로 이 회차의 A1이 이 자리에서 다시 필요하다. W에 t기 소득·과거 소비 등 어떤 관측치를 넣어도 0 — Hall (1978)이 검정한 명제이고, 시험 방향 W를 도구변수로 골라 표본 내적을 0에 맞추는 것이 Hansen & Singleton (1982)의 추정이다.
둘째 식의 경제 번역은 이렇다. 균등해지는 두 양은 E[mt+1Rt+1W]와 E[W]이다. W가 t기 소득이면, 소득이 높은 시기에 할인된 수익률이 체계적으로 높거나 낮지 않다는 뜻이고, W가 과거 소비면 소비의 관성이 할인된 수익률을 예측하지 않는다는 뜻이다. 어느 W∈L2(Ft)에서 표본 내적이 0에서 멀면 m의 지정이 기각된다. 반대로 Ft 밖의 W — 이를테면 t+1기의 변수 — 에서 내적이 0이 아닌 것은 기각이 아니다. 직교는 정보집합 안에서만 약속된 것이기 때문이다. 첫째 식의 F0는 W=1 하나만 시험하는 가장 약한 검정이고, 둘째 식은 시험 방향을 L2(Ft) 전체로 넓힌 가장 강한 형태다. 타워는 그 사이의 모든 중간 정보에서 같은 식이 성립함을 보장한다.
학부 읽기는 E[Y∣X=x]=∑yyP(Y=y∣X=x)에서 멈춘다. 이 공식이 작동하려면 조건 사건의 확률이 양수여야 하고 조건이 되는 변수가 유한 개여야 한다. 연속 변수 하나라면 학부도 조건부 밀도 f(y∣x)=f(x,y)/fX(x)로 넘어가지만, 조건이 변수 하나가 아니라 “t까지의 모든 역사” — σ-대수 Ft — 일 때는 조건부 밀도조차 세울 수 없다. 공식을 적용할 대상이 없는 자리에서 학부 읽기는 멈춘다. 대학원 읽기는 공식을 버리고 (4)의 등식 — 모든 A∈F에서 E[Y^1A]=E[Y1A] — 을 정의로 삼는다. 이 등식은 분모가 없으므로 확률 0인 사건에서도 무너지지 않고, 3절이 보였듯 그 정의는 사영의 직교조건과 같은 것이다.
구체 장면 하나. Cochrane (2005) 1장, pt=Et[mt+1xt+1] 바로 아래에서 첨자를 떼고 무조건부 모멘트로 넘어가는 한 줄. 대학원 읽기는 이 줄에서 ΠF0ΠFt=ΠF0를 본다. 한 걸음 더 본다. 타워가 지우는 것은 Et 하나뿐이다. (14)의 우변 −Rt+1fCovt(m,R)에서 첨자를 떼려면 Rt+1f이 상수라는 별도의 가정이 필요하고, W13은 그 가정을 적어 두었다. Rf가 움직이면 E[Rt+1fCovt(⋅)]이 인수분해되지 않고, Rt+1f이 상수 Rf이면 Et[m]=1/Rf도 상수라서 Cov(Etm,EtR)=0, 곧 E[Covt(m,R)]=Cov(m,R)이 되어 W13이 무조건부 공분산 분해로 얻은 (3)과 같은 식이 나온다. 첨자를 떼는 한 줄에 타워 하나와 상수성 하나, 두 근거가 겹쳐 있다는 것을 사영으로 읽는 눈이 가려낸다. 같은 눈으로 Hall (1978)의 따름정리 — “t기의 어떤 정보도 ct+1 예측에 보탬이 되지 않는다” — 를 읽으면, 그것은 E[(u′(ct+1)−u′(ct)/(βR))W]=0이라는 직교조건이고, 검정은 W를 골라 표본 내적이 0인지 보는 일이다. 어느 W를 넣어도 된다는 것이 "모든 W∈L2(Ft)"의 뜻이다. 소득을 넣으면 소득이 소비를 예측하는지 묻는 것이고, 과거 소비를 넣으면 관성을 묻는 것이다. 모두 같은 직교조건의 다른 시험 방향이다.
대학원 읽기가 추가로 보는 것은 셋이다. (a) E[⋅∣F]는 확률변수를 돌려주는 선형 연산자다. (b) 그 연산자의 고정점 집합은 L2(F) 전체다 — W12의 압축사상은 고정점이 하나였고 (1)의 벨만 연산자 T는 그 하나로 수렴했다. 사영은 고정점이 부분공간 전체이고, 한 번 적용하면 그 자리에 머문다(Π2=Π). "연산자로 읽는다"는 눈은 같고, 고정점의 모양이 다르다. T는 max 때문에 비선형이었고 Π는 선형이다 — 선형이기 때문에 고정점의 집합이 부분공간이 된다. (c) "마팅게일"은 새 개념이 아니라 Y^t=ΠFtY의 경로에 붙은 이름이다. (14)의 첫째 식이 정의이고, 나머지 두 식이 그 정의에서 따라 나오는 성질이다.
계산은 패키지 호출 없이 한다. 상태 4개와 확률 벡터를 배열로 쌓아 모든 기댓값을 가중합으로 구하고, (a,b) 격자에서 g를 계산해 격자탐색 최소점과 정규방정식 2×2의 해를 대조하며, N=100,000 경로를 시뮬레이션해 표본 공분산을 직접 계산한다. 더미 행렬 X와 P=X(X′X)−1X′는 N=2000 부분표본에서만 만들어 P2=P, P′=P, P0P=P0을 프로베니우스 노름으로 확인한다. 대조 표는 예측 | 결과 | 어긋남 | 원인 4열이다.
지금은 이렇게 읽힌다. F는 집합의 집합이 아니라 부분공간 L2(F)의 이름으로 읽힌다. 정보가 많으면 부분공간이 크고, 아래첨자 t는 그 부분공간의 이름표다. 나무에서 그 공간은 1차원·2차원·4차원이었다. argmin은 숫자가 아니라 함수를 돌려주고, 그 함수의 차원은 Y의 차원이며, 정보 자체에는 단위가 없다. 화폐 단위를 바꿔도 사영은 따라 움직일 뿐 모양이 변하지 않는다. 최소화의 1계 조건이 직교조건이고, 직교조건에 지표함수를 넣으면 학부의 조건부 확률 공식이 나온다 — 학부 공식은 틀린 것이 아니라 유한 분할이라는 특수경우다. 첨자 t를 떼는 조작은 ΠF0ΠFt=ΠF0이며, W07의 P2=P, P′=P가 함수 공간에서 Π2=Π, 자기수반으로 다시 나온다. 남은 오차는 정보로 만든 어떤 양과도 내적이 0이고, 그것이 Hall의 검정이 묻는 전부다. 예측의 경로에 붙은 마팅게일이라는 이름은 이 직교의 시간축 판이다. 세 변의 제곱 251.942+256.608=508.550이 그 모든 문장의 숫자 판이다.
다음 회차 W15 · 측도를 바꾼다는 것은 내적의 가중치인 확률 P 자체를 다른 확률 Q로 바꾸면 어느 사영이 보존되는지를 묻는다.
이어지는 자료 — MIT OCW 6.262(Gallager) 강의노트 1·7장 — 단행본에서는 1·9장 Gallager, 2013 · Durrett(가정 확인용) Durrett, 2019 · Williams, Probability with Martingales 9장 — 조건부 기댓값을 사영으로 정의하는 방식 그대로 Williams, 1991 · Luenberger, Optimization by Vector Space Methods 3장 — 사영 정리 Luenberger, 1969
Cochrane, J. H. (2005). Asset Pricing (Revised). Princeton University Press.
Hall, R. E. (1978). Stochastic Implications of the Life Cycle-Permanent Income Hypothesis: Theory and Evidence. Journal of Political Economy, 86(6), 971–987. 10.1086/260724
Muth, J. F. (1961). Rational Expectations and the Theory of Price Movements. Econometrica, 29(3), 315–335.
Luenberger, D. G. (1969). Optimization by Vector Space Methods. Wiley.
Durrett, R. (2019). Probability: Theory and Examples (5th ed.). Cambridge University Press.
Boyd, S., & Vandenberghe, L. (2018). Introduction to Applied Linear Algebra: Vectors, Matrices, and Least Squares. Cambridge University Press.
Hansen, L. P., & Singleton, K. J. (1982). Generalized Instrumental Variables Estimation of Nonlinear Rational Expectations Models. Econometrica, 50(5), 1269–1286. 10.2307/1911873
Gallager, R. G. (2013). Stochastic Processes: Theory for Applications. Cambridge University Press.
Williams, D. (1991). Probability with Martingales. Cambridge University Press.