노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다.
, , , 에서 연 스텝 오일러의 오차 부호와 크기는 무엇인가. 스텝을 분기로 줄이면 오차는 몇 배가 되는가.
예측: ____
에서 오일러 경로의 모양은 무엇인가. 에서는 무엇인가.
예측: ____
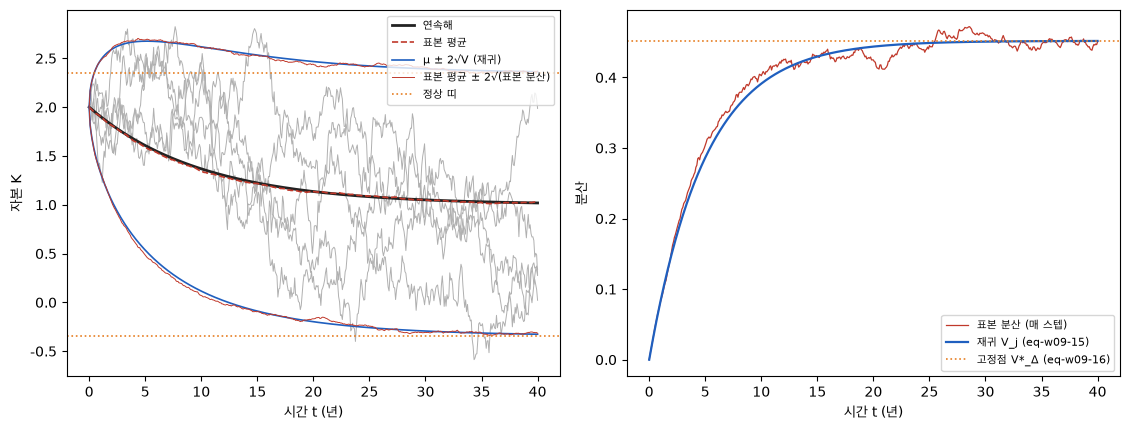
, , , 경로 2,000개, 에서 의 표본 분산은 얼마인가. 표본 평균 경로는 어느 곡선 위에 있는가.
예측: ____
# 도구와 한국어 글꼴을 세운다
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager as fm

cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
have = {f.name for f in fm.fontManager.ttflist}
font = next((f for f in cands if f in have), 'DejaVu Sans')
plt.rcParams['font.family'] = ['DejaVu Sans', font]   # 기호는 앞, 한글은 뒤에서 찾는다
plt.rcParams['axes.unicode_minus'] = False
print('글꼴:', plt.rcParams['font.family'])
글꼴: ['DejaVu Sans', 'Apple SD Gothic Neo']
# 본문 파라미터와 두 해를 쌓는다 — 연속해는 공식, 오일러는 반복문
delta, T, K0, I = 0.10, 10.0, 2.0, 0.10
Kstar = I / delta

def K_exact(t):
    # (eq-w09-5)
    return Kstar + (K0 - Kstar) * np.exp(-delta * t)

def euler_path(step, n, k0=K0, rate=I, dec=delta):
    # (eq-w09-6)을 한 스텝씩 되풀이한다
    ks = np.empty(n + 1)
    ks[0] = k0
    for j in range(n):
        ks[j + 1] = (1.0 - dec * step) * ks[j] + rate * step
    return ks

print(f'K* = {Kstar:.6f},   K(T) = {K_exact(T):.6f}')
K* = 1.000000, K(T) = 1.367879
# 스텝을 반씩 줄여 가며 오차와 오차/Δ를 쌓는다
exact_T = K_exact(T)
coef = -0.5 * delta**2 * T * np.exp(-delta * T) * (K0 - Kstar)   # (eq-w09-9)의 1차 계수
rows = []
print(f'{"Δ":>9} {"n":>5} {"K_n(오일러)":>12} {"오차":>11} {"1차 예측":>11} {"오차/Δ":>10}')
for n in [10, 20, 40, 80, 160, 320, 640]:
    step = T / n
    kn = euler_path(step, n)[-1]
    err = kn - exact_T
    rows.append((step, n, kn, err))
    print(f'{step:9.5f} {n:5d} {kn:12.6f} {err:11.6f} {coef * step:11.6f} {err / step:10.5f}')

err_year = rows[0][3]      # Δ = 1 (연)
err_quarter = rows[2][3]   # Δ = 1/4 (분기)
print()
print(f'연 스텝 오차   = {err_year:+.6f}   부호: {"음" if err_year < 0 else "양"}')
print(f'분기 스텝 오차 = {err_quarter:+.6f}   연 스텝 대비 배율 = {err_quarter / err_year:.4f}  (1/4 = 0.25)')
print(f'오차/Δ가 수렴하는 값 = {coef:.6f}')
Δ n K_n(오일러) 오차 1차 예측 오차/Δ
1.00000 10 1.348678 -0.019201 -0.018394 -0.01920
0.50000 20 1.358486 -0.009394 -0.009197 -0.01879
0.25000 40 1.363232 -0.004647 -0.004598 -0.01859
0.12500 80 1.365568 -0.002311 -0.002299 -0.01849
0.06250 160 1.366727 -0.001153 -0.001150 -0.01844
0.03125 320 1.367304 -0.000576 -0.000575 -0.01842
0.01562 640 1.367592 -0.000288 -0.000287 -0.01841
연 스텝 오차 = -0.019201 부호: 음
분기 스텝 오차 = -0.004647 연 스텝 대비 배율 = 0.2420 (1/4 = 0.25)
오차/Δ가 수렴하는 값 = -0.018394
# 경로 비교와 오차의 차수를 그린다
tt = np.linspace(0.0, T, 400)
fig, ax = plt.subplots(1, 2, figsize=(11.0, 4.0))
ax[0].plot(tt, K_exact(tt), color='#222222', lw=2, label='연속해')
for step, style in [(1.0, 'o--'), (0.25, '.--')]:
    n = int(round(T / step))
    ax[0].plot(np.arange(n + 1) * step, euler_path(step, n), style, ms=5, lw=0.8,
               label=f'오일러 Δ={step}')
ax[0].axhline(Kstar, color='#8a8a8a', lw=0.8)
ax[0].set_xlabel('시간 t (년)'); ax[0].set_ylabel('자본 K'); ax[0].legend()

steps = np.array([r[0] for r in rows])
errs = np.array([abs(r[3]) for r in rows])
ax[1].loglog(steps, errs, 'o', color='#1f5fbf', label='|K_n - K(T)|')
ax[1].loglog(steps, abs(coef) * steps, '-', color='#222222', label='1차 예측')
ax[1].loglog(steps, errs[0] * (steps / steps[0])**2, ':', color='#8a8a8a', label='기울기 2')
ax[1].set_xlabel('스텝 Δ'); ax[1].set_ylabel('오차의 크기'); ax[1].legend()
plt.tight_layout(); plt.show()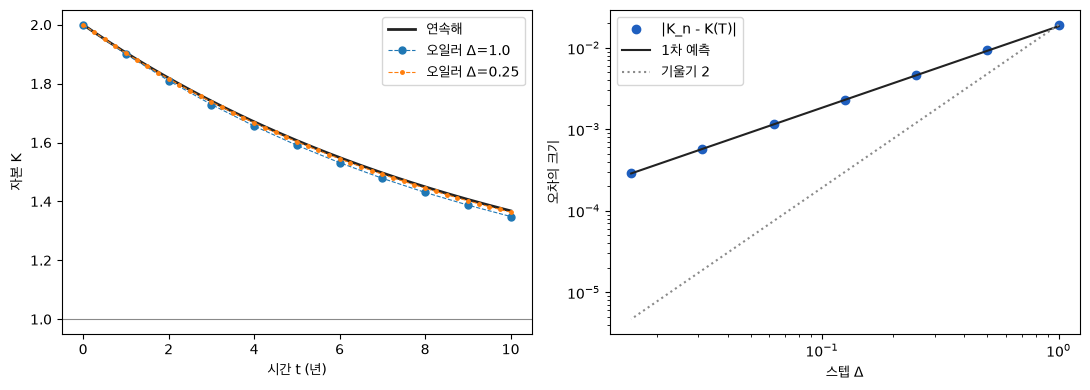
# δ=1로 두고 δΔ 다섯 값의 경로를 같은 반복문으로 쌓는다
nstep = 12
paths = {}
print(f'{"δΔ":>5} {"공비 1-δΔ":>9} {"진폭비":>7} {"부호 바뀜":>7} {"K_12 - K*":>12}   모양(경로에서 읽는다)')
for dd in [0.5, 1.0, 1.5, 2.0, 2.2]:
    p = euler_path(dd, nstep, k0=2.0, rate=1.0, dec=1.0)   # K* = 1
    paths[dd] = p
    u = p - 1.0                                  # 고정점에서의 이탈
    live = u[np.abs(u) > 1e-12]
    flips = int(np.sum(np.sign(live[1:]) != np.sign(live[:-1])))   # 부호가 바뀐 횟수
    ratio = abs(u[-1]) / abs(u[-2]) if abs(u[-2]) > 1e-12 else 0.0
    if abs(u[-1]) < 1e-12:                       # 이탈이 사라졌다
        shape = '한 스텝에 고정점'
    else:                                        # 부호 바뀜과 진폭비로만 판정한다
        swing = '진동하며 ' if flips > 0 else '단조 '
        pull = '수렴' if ratio < 1.0 else ('발산' if ratio > 1.0 else '진폭 그대로')
        shape = swing + pull
    print(f'{dd:5.1f} {1.0 - dd:9.2f} {ratio:7.3f} {flips:7d} {u[-1]:12.5f}   {shape}')
δΔ 공비 1-δΔ 진폭비 부호 바뀜 K_12 - K* 모양(경로에서 읽는다)
0.5 0.50 0.500 0 0.00024 단조 수렴
1.0 0.00 0.000 0 0.00000 한 스텝에 고정점
1.5 -0.50 0.500 12 0.00024 진동하며 수렴
2.0 -1.00 1.000 12 1.00000 진동하며 진폭 그대로
2.2 -1.20 1.200 12 8.91610 진동하며 발산
# 진동과 발산을 같은 고정점 위에 그린다
tt2 = np.linspace(0.0, 8.0, 300)
fig, ax = plt.subplots(figsize=(7.4, 4.2))
ax.plot(tt2, 1.0 + np.exp(-tt2), color='#222222', lw=2, label='연속해 (δ=1)')
for dd, col in [(0.5, '#1f5fbf'), (1.5, '#e67e22'), (2.2, '#c0392b')]:
    p = paths[dd]
    ax.plot(np.arange(len(p)) * dd, p, 'o--', ms=4, lw=1.0, color=col, label=f'δΔ={dd}')
ax.axhline(1.0, color='#8a8a8a', lw=0.8)
ax.set_xlim(0.0, 8.0); ax.set_ylim(-4.0, 6.0)
ax.set_xlabel('시간 t (1/δ 단위)'); ax.set_ylabel('자본 K'); ax.legend(loc='upper right')
plt.tight_layout(); plt.show()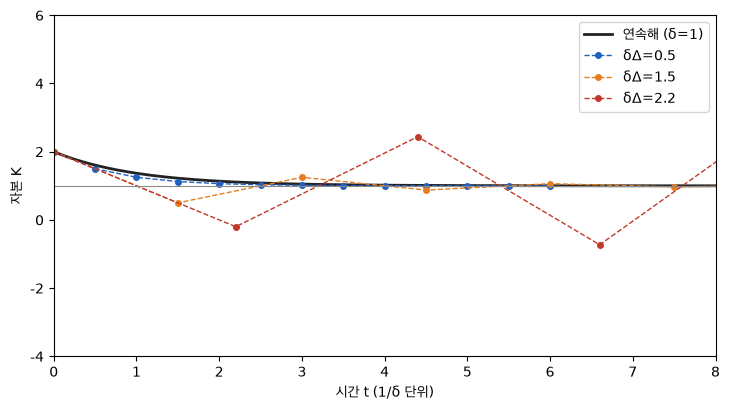
# (eq-w09-14)를 2,000경로 동시에 반복해 매 스텝 표본 평균·분산을 쌓는다
sigma, hstep, T_em, M = 0.30, 1.0 / 12.0, 40.0, 2000
n_em = int(round(T_em / hstep))

def em_moments(seed, keep=0):
    rng = np.random.default_rng(seed)
    K = np.full(M, K0)
    m = np.empty(n_em + 1); v = np.empty(n_em + 1)
    m[0], v[0] = K.mean(), K.var(ddof=1)
    kept = np.empty((keep, n_em + 1)); kept[:, 0] = K0
    for j in range(n_em):
        z = rng.standard_normal(M)
        K = K + (I - delta * K) * hstep + sigma * np.sqrt(hstep) * z   # (eq-w09-14)
        m[j + 1], v[j + 1] = K.mean(), K.var(ddof=1)
        kept[:, j + 1] = K[:keep]
    return m, v, kept

m_hat, v_hat, shown = em_moments(20250917, keep=5)
grid = np.arange(n_em + 1) * hstep
print(f'스텝 {n_em}개(Δ=1/12, T={T_em:.0f}년), 경로 {M}개')
스텝 480개(Δ=1/12, T=40년), 경로 2000개
# 재귀 (eq-w09-15)의 μ_j·V_j를 따로 쌓아 표본 적률과 맞댄다
mu = np.empty(n_em + 1); V = np.empty(n_em + 1)
mu[0], V[0] = K0, 0.0
for j in range(n_em):
    mu[j + 1] = (1.0 - delta * hstep) * mu[j] + I * hstep
    V[j + 1] = (1.0 - delta * hstep)**2 * V[j] + sigma**2 * hstep
V_star = sigma**2 / (2.0 * delta - delta**2 * hstep)            # (eq-w09-16)

print(f'표본 분산 Var(K_T)          = {v_hat[-1]:.5f}')
print(f'재귀의 V_n (eq-w09-15)      = {V[-1]:.5f}')
print(f'고정점 V*_Δ (eq-w09-16)     = {V_star:.5f}')
print(f'연속 극한 σ²/(2δ)           = {sigma**2 / (2.0 * delta):.5f}')
print()
print(f'표본 평균과 연속해 (eq-w09-5)의 최대 차이 = {np.max(np.abs(m_hat - K_exact(grid))):.5f}')
print(f'재귀 μ_j와 연속해의 최대 차이             = {np.max(np.abs(mu - K_exact(grid))):.5f}')
print()
print('잣대 — 씨앗만 바꿔 같은 크기의 표본을 네 번 더 뽑는다')
again = np.array([v_hat[-1]] + [em_moments(s)[1][-1] for s in (11, 22, 33, 44)])
print('  표본 분산 다섯: ' + '  '.join(f'{x:.5f}' for x in again))
print(f'  최대-최소 = {np.ptp(again):.5f},   V*_Δ에서 가장 먼 값의 차 = {np.max(np.abs(again - V_star)):.5f}')
표본 분산 Var(K_T) = 0.45046
재귀의 V_n (eq-w09-15) = 0.45174
고정점 V*_Δ (eq-w09-16) = 0.45188
연속 극한 σ²/(2δ) = 0.45000
표본 평균과 연속해 (eq-w09-5)의 최대 차이 = 0.02888
재귀 μ_j와 연속해의 최대 차이 = 0.00154
잣대 — 씨앗만 바꿔 같은 크기의 표본을 네 번 더 뽑는다
표본 분산 다섯: 0.45046 0.47375 0.43631 0.43002 0.44272
최대-최소 = 0.04374, V*_Δ에서 가장 먼 값의 차 = 0.02187
# 왼쪽은 경로와 두 띠, 오른쪽은 분산의 시간 경로 — 표본과 재귀를 나란히 둔다
fig, ax = plt.subplots(1, 2, figsize=(11.4, 4.4))
for i in range(5):
    ax[0].plot(grid, shown[i], color='#b0b0b0', lw=0.7)
ax[0].plot(grid, K_exact(grid), color='#222222', lw=2, label='연속해')
ax[0].plot(grid, m_hat, color='#c0392b', lw=1.2, ls='--', label='표본 평균')
ax[0].plot(grid, mu + 2.0 * np.sqrt(V), color='#1f5fbf', lw=1.2)
ax[0].plot(grid, mu - 2.0 * np.sqrt(V), color='#1f5fbf', lw=1.2, label='μ ± 2√V (재귀)')
ax[0].plot(grid, m_hat + 2.0 * np.sqrt(v_hat), color='#c0392b', lw=0.7)
ax[0].plot(grid, m_hat - 2.0 * np.sqrt(v_hat), color='#c0392b', lw=0.7, label='표본 평균 ± 2√(표본 분산)')
ax[0].axhline(Kstar + 2.0 * np.sqrt(V_star), color='#e67e22', ls=':', lw=1.2)
ax[0].axhline(Kstar - 2.0 * np.sqrt(V_star), color='#e67e22', ls=':', lw=1.2, label='정상 띠')
ax[0].set_xlabel('시간 t (년)'); ax[0].set_ylabel('자본 K')
ax[0].legend(loc='upper right', fontsize=8)

ax[1].plot(grid, v_hat, color='#c0392b', lw=0.9, label='표본 분산 (매 스텝)')
ax[1].plot(grid, V, color='#1f5fbf', lw=1.6, label='재귀 V_j (eq-w09-15)')
ax[1].axhline(V_star, color='#e67e22', ls=':', lw=1.2, label='고정점 V*_Δ (eq-w09-16)')
ax[1].set_xlabel('시간 t (년)'); ax[1].set_ylabel('분산')
ax[1].legend(loc='lower right', fontsize=8)
plt.tight_layout(); plt.show()