노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다. 세 항목은 본문 6절 "노트북(40분)"의 것과 같다.
, , , 의 로그정규 소비성장에서 는 얼마인가. (eq-w13-18)로 손계산하면 , 이다. 난수 개로 만든 의 표본평균의 역수가 이 값에 소수 셋째 자리까지 맞는가.
예측: ____
같은 파라미터에서 어떤 자산도 샤프비율 0.04를 넘지 못한다. 샤프비율 0.4에 닿으려면 가 약 19 이상이어야 하고, 그때 는 약 1.39다. 격자에서 곡선과 곡선을 직접 그려 (fig-w13-2)·(fig-w13-3)을 재현한다.
예측: ____
두 상태 경제에서 A(순환)의 프리미엄은 양, B(역순환)의 프리미엄은 음이며 크기는 거의 같다(p). 를 4로 올리면 두 프리미엄의 절댓값이 대략 두 배가 된다 — 공분산이 에 거의 비례하기 때문이다. 표로 확인한다.
예측: ____
2. 계산
패키지 호출로 답을 내지 않는다. 확률벡터와 상태별 값, 난수 표본에서 과 가격을 직접 쌓는다.
# 계산 도구와 한국어 글꼴만 먼저 쌓는다.
import numpy as np
import matplotlib as mpl
import matplotlib.pyplot as plt
from matplotlib import font_manager

CANDIDATES = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic',
              'Noto Sans CJK KR', 'Malgun Gothic']
installed = {f.name for f in font_manager.fontManager.ttflist}
for _name in CANDIDATES:
    if _name in installed:
        mpl.rcParams['font.family'] = _name
        break
mpl.rcParams['axes.unicode_minus'] = False
mpl.rcParams['figure.dpi'] = 110

BETA, GAMMA = 0.98, 2.0      # 할인인자, 상대적 위험회피도
MU_C, SIG_C = 0.02, 0.02     # 소비성장 로그의 평균과 표준편차
print('글꼴:', mpl.rcParams['font.family'][0], '| beta =', BETA, '| gamma =', GAMMA)
글꼴: Apple SD Gothic Neo | beta = 0.98 | gamma = 2.0
가 · 두 상태 경제. 본문 3절 끝의 수치 예를 상태별 값으로 다시 쌓는다. (eq-w13-11)의 로 가격을 매기고, (eq-w13-14)의 좌·우변을 나란히 놓는다.
# 두 상태 경제를 확률벡터와 상태별 값으로 직접 쌓는다.
pi = np.array([0.5, 0.5])            # 상태 확률
g2 = np.array([0.95, 1.05])          # 소비성장 c_{t+1}/c_t
payoffs = {'A': g2, 'B': 2.0 - g2}   # A는 순환, B는 역순환 지급액


def two_state(beta, gamma, pi, g, payoffs):
    # 상태별 m을 만들고 p = sum_s pi_s m_s x_s 로 가격을 매긴다
    m = beta * g ** (-gamma)
    Em = float(pi @ m)
    Rf = 1.0 / Em
    rows = []
    for name, x in payoffs.items():
        p = float(pi @ (m * x))
        R = x / p
        ER = float(pi @ R)
        Ex = float(pi @ x)
        cov = float(pi @ ((m - Em) * (R - ER)))
        rows.append(dict(name=name, Ex=Ex, sdx=float(np.sqrt(pi @ (x - Ex) ** 2)),
                         p=p, ER=ER, prem=ER - Rf, rhs=-Rf * cov,
                         EmR=float(pi @ (m * R))))
    return m, Em, Rf, rows


m2, Em2, Rf2, rows2 = two_state(BETA, GAMMA, pi, g2, payoffs)
print(f'm = [{m2[0]:.4f}, {m2[1]:.4f}]   E[m] = {Em2:.6f}   R_f = 1/E[m] = {Rf2:.6f}')
m = [1.0859, 0.8889] E[m] = 0.987381 R_f = 1/E[m] = 1.012781
# (eq-w13-11)의 E[mR]=1과 (eq-w13-14)의 좌·우변을 한 표에 놓는다.
print('열: 자산 · 기대 지급액 · 지급액 표준편차 · 가격 · 기대수익률 · 프리미엄 · -Rf·Cov · E[mR]')
head = ('asset', 'E[x]', 'sd(x)', 'price', 'E[R]', 'prem(%p)', '-RfCov(%p)', 'E[mR]')
print('{:<6}{:>8}{:>8}{:>10}{:>10}{:>12}{:>12}{:>10}'.format(*head))
for r in rows2:
    print('{:<6}{:>8.4f}{:>8.4f}{:>10.6f}{:>10.6f}{:>12.4f}{:>12.4f}{:>10.6f}'.format(
        r['name'], r['Ex'], r['sdx'], r['p'], r['ER'],
        100 * r['prem'], 100 * r['rhs'], r['EmR']))
gap = max(abs(r['prem'] - r['rhs']) for r in rows2)
err = max(abs(r['EmR'] - 1.0) for r in rows2)
print(f'\n프리미엄 좌·우변 차이 최대 {gap:.2e},  E[mR]-1 최대 {err:.2e}')
print(f"기대 지급액은 둘 다 {rows2[0]['Ex']:.4f}, 지급액 표준편차도 둘 다 {rows2[0]['sdx']:.4f}이다")
열: 자산 · 기대 지급액 · 지급액 표준편차 · 가격 · 기대수익률 · 프리미엄 · -Rf·Cov · E[mR]
asset E[x] sd(x) price E[R] prem(%p) -RfCov(%p) E[mR]
A 1.0000 0.0500 0.982456 1.017857 0.5077 0.5077 1.000000
B 1.0000 0.0500 0.992305 1.007754 -0.5026 -0.5026 1.000000
프리미엄 좌·우변 차이 최대 9.89e-17, E[mR]-1 최대 0.00e+00
기대 지급액은 둘 다 1.0000, 지급액 표준편차도 둘 다 0.0500이다
# gamma를 키우며 두 프리미엄이 얼마나 자라는지 표로 쌓는다.
print('열: gamma · 무위험 총수익률 · A 프리미엄 · B 프리미엄 · A 프리미엄의 배율')
print('{:>6}{:>10}{:>14}{:>14}{:>19}'.format(
    'gamma', 'R_f', 'premA(%p)', 'premB(%p)', '|A|/|A(gamma=1)|'))
prem_by_gamma = {}
for gam in (1.0, 2.0, 4.0, 8.0):
    _, _, Rf_g, rr = two_state(BETA, gam, pi, g2, payoffs)
    prem_by_gamma[gam] = (rr[0]['prem'], rr[1]['prem'])
    ratio = abs(prem_by_gamma[gam][0]) / abs(prem_by_gamma[1.0][0])
    print('{:>6.0f}{:>10.6f}{:>14.4f}{:>14.4f}{:>19.3f}'.format(
        gam, Rf_g, 100 * prem_by_gamma[gam][0], 100 * prem_by_gamma[gam][1], ratio))
rA = abs(prem_by_gamma[4.0][0]) / abs(prem_by_gamma[2.0][0])
rB = abs(prem_by_gamma[4.0][1]) / abs(prem_by_gamma[2.0][1])
print(f'\ngamma 2 -> 4 배율: A {rA:.3f}배, B {rB:.3f}배')
열: gamma · 무위험 총수익률 · A 프리미엄 · B 프리미엄 · A 프리미엄의 배율
gamma R_f premA(%p) premB(%p) |A|/|A(gamma=1)|
1 1.017857 0.2551 -0.2538 1.000
2 1.012781 0.5077 -0.5026 1.990
4 0.995306 0.9928 -0.9734 3.892
8 0.934363 1.8108 -1.7432 7.098
gamma 2 -> 4 배율: A 1.956배, B 1.937배
# 프리미엄을 gamma 격자 위에 그려 부호와 기울기를 본다.
gam_line = np.linspace(0.5, 10.0, 96)
pa = np.array([two_state(BETA, gm, pi, g2, payoffs)[3][0]['prem'] for gm in gam_line])
pb = np.array([two_state(BETA, gm, pi, g2, payoffs)[3][1]['prem'] for gm in gam_line])

fig, ax = plt.subplots(figsize=(6.0, 3.8))
ax.plot(gam_line, 100 * pa, color='#1f4e79', label='A (순환, Cov(m,R)<0)')
ax.plot(gam_line, 100 * pb, color='#a63603', label='B (역순환, Cov(m,R)>0)')
ax.axhline(0.0, color='0.45', linewidth=0.8)
for gm in (1.0, 2.0, 4.0, 8.0):
    ax.plot([gm], [100 * prem_by_gamma[gm][0]], 'o', color='#1f4e79', markersize=4)
    ax.plot([gm], [100 * prem_by_gamma[gm][1]], 'o', color='#a63603', markersize=4)
ax.set_xlabel(r'상대적 위험회피도 $\gamma$')
ax.set_ylabel('위험 프리미엄 (%p)')
ax.set_title('두 상태 경제 · 프리미엄의 부호는 공분산의 부호다')
ax.legend(loc='upper left', fontsize=9)
fig.tight_layout()
plt.show()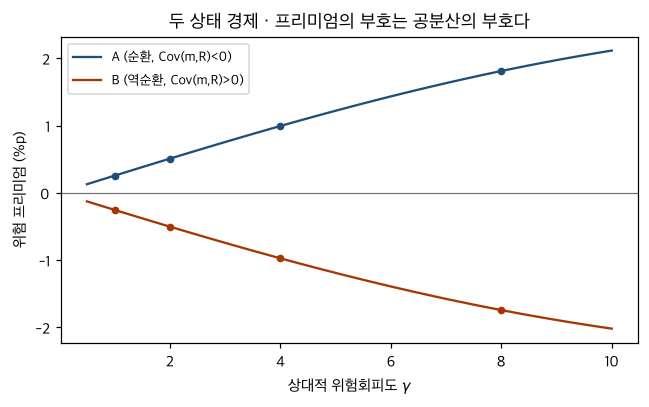
나 · 로그정규 소비성장. (eq-w13-18)의 닫힌 꼴을 난수 표본으로 되받는다. 은 를 그대로 쌓은 것이다.
# 로그정규 소비성장을 난수로 뽑아 m = beta * exp(-gamma * dlnc) 를 직접 만든다.
N = 200_000
rng = np.random.default_rng(13)
dlnc = rng.normal(MU_C, SIG_C, N)
g_mc = np.exp(dlnc)
m_mc = BETA * np.exp(-GAMMA * dlnc)

Em_mc = float(m_mc.mean())
sd_mc = float(m_mc.std(ddof=1))
Rf_mc = 1.0 / Em_mc
lnRf_cf = -np.log(BETA) + GAMMA * MU_C - 0.5 * GAMMA ** 2 * SIG_C ** 2
Rf_cf = float(np.exp(lnRf_cf))
cv_cf = float(np.sqrt(np.exp(GAMMA ** 2 * SIG_C ** 2) - 1.0))

print(f'표본 수 N = {N}')
print(f'손계산  ln R_f = {lnRf_cf:.6f}   R_f = {Rf_cf:.6f}   sd(m)/E[m] = {cv_cf:.6f}')
print(f'난수    ln R_f = {np.log(Rf_mc):.6f}   R_f = {Rf_mc:.6f}   sd(m)/E[m] = {sd_mc / Em_mc:.6f}')
print(f'소수 셋째 자리: 손계산 {Rf_cf:.3f} vs 난수 {Rf_mc:.3f}   (차이 {abs(Rf_mc - Rf_cf):.2e})')
print(f'근사 gamma*sigma_c = {GAMMA * SIG_C:.6f}')
표본 수 N = 200000
손계산 ln R_f = 0.059403 R_f = 1.061203 sd(m)/E[m] = 0.040016
난수 ln R_f = 0.059370 R_f = 1.061168 sd(m)/E[m] = 0.040077
소수 셋째 자리: 손계산 1.061 vs 난수 1.061 (차이 3.43e-05)
근사 gamma*sigma_c = 0.040000
# gamma 격자 위에 (eq-w13-18)의 두 곡선을 쌓고 샤프 0.4와 만나는 점을 찾는다.
SHARPE = 0.4
gam_grid = np.linspace(0.0, 30.0, 6001)


def cv_of(gam, sig):
    # 할인인자의 변동계수 — (eq-w13-15) 우변
    return np.sqrt(np.exp(gam ** 2 * sig ** 2) - 1.0)


def lnRf_of(gam, sig):
    # 로그 무위험 수익률 — (eq-w13-18) 둘째 식
    return -np.log(BETA) + gam * MU_C - 0.5 * gam ** 2 * sig ** 2


cross = {}
for sig in (0.02, 0.036):
    c = cv_of(gam_grid, sig)
    k = int(np.argmax(c >= SHARPE))
    w = (SHARPE - c[k - 1]) / (c[k] - c[k - 1])
    gstar = float(gam_grid[k - 1] + w * (gam_grid[k] - gam_grid[k - 1]))
    cross[sig] = (gstar, float(np.exp(lnRf_of(gstar, sig))))
    print(f'sigma_c = {sig:.3f}: 샤프 {SHARPE}에 닿는 gamma = {gstar:.2f}, '
          f'ln R_f = {lnRf_of(gstar, sig):.4f}, R_f = {cross[sig][1]:.3f}')
print(f'\ngamma = 2, sigma_c = 0.02의 경계 sd(m)/E[m] = {cv_of(2.0, 0.02):.4f}')
print(f'포물선 꼭짓점 gamma = mu_c/sigma_c^2 = {MU_C / 0.02 ** 2:.1f} (sigma_c = 0.02)')
sigma_c = 0.020: 샤프 0.4에 닿는 gamma = 19.26, ln R_f = 0.3312, R_f = 1.393
sigma_c = 0.036: 샤프 0.4에 닿는 gamma = 10.70, ln R_f = 0.1600, R_f = 1.174
gamma = 2, sigma_c = 0.02의 경계 sd(m)/E[m] = 0.0400
포물선 꼭짓점 gamma = mu_c/sigma_c^2 = 50.0 (sigma_c = 0.02)
# 그림 2·3을 격자 위에서 다시 그린다 — 경계 곡선과 무위험 수익률 포물선.
gg = np.linspace(0.0, 25.0, 501)
fig, axes = plt.subplots(1, 2, figsize=(10.0, 3.9))
for sig, col in ((0.02, '#1f4e79'), (0.036, '#a63603')):
    axes[0].plot(gg, cv_of(gg, sig), color=col, label=rf'$\sigma_c={sig}$')
    axes[1].plot(gg, lnRf_of(gg, sig), color=col, label=rf'$\sigma_c={sig}$')
    gstar, Rfstar = cross[sig]
    axes[0].plot([gstar], [SHARPE], 'o', color=col, markersize=5)
    axes[1].plot([gstar], [np.log(Rfstar)], 'o', color=col, markersize=5)
    axes[1].annotate(f'$R_f$={Rfstar:.2f}', (gstar, np.log(Rfstar)),
                     textcoords='offset points', xytext=(6, -2), fontsize=9, color=col)
axes[0].axhline(SHARPE, color='0.45', linewidth=0.8, linestyle='--')
axes[0].axhline(cv_of(2.0, 0.02), color='0.7', linewidth=0.8, linestyle=':')
axes[0].set_ylabel(r'$\sigma(m)/\mathbb{E}[m]$')
axes[0].set_title('경계 · 주식 샤프비율 0.4에 닿는 $\\gamma$')
axes[1].axhline(np.log(1.01), color='0.45', linewidth=0.8, linestyle='--')
axes[1].set_ylabel(r'$\ln R_f$')
axes[1].set_title('무위험 수익률 · 관측된 약 1%(파선)와의 거리')
for ax in axes:
    ax.set_xlabel(r'상대적 위험회피도 $\gamma$')
    ax.legend(loc='upper left', fontsize=9)
fig.tight_layout()
plt.show()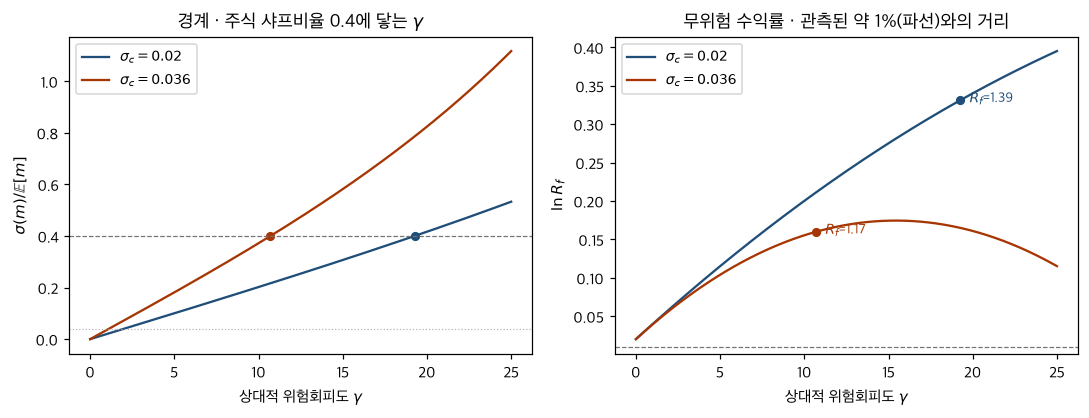
다 · 인위적 자산. (은 와 독립)을 만들어 로 가격을 매긴다. 이면 의 분산이 아무리 커도 프리미엄이 0이다.
# 인위적 자산 x = R_f + b(g - gbar) + eps 를 쌓아 p = E[m x] 로 가격을 매긴다.
gbar = float(g_mc.mean())
rng_e = np.random.default_rng(1313)
print('열: b · eps 표준편차 · 가격 · 기대수익률 · 프리미엄 · 수익률 표준편차 · 샤프비율')
print('{:>6}{:>10}{:>10}{:>10}{:>12}{:>10}{:>10}'.format(
    'b', 'sd(eps)', 'price', 'E[R]', 'prem(%p)', 'sd(R)', '|Sharpe|'))
for b, s in ((10.0, 0.0), (10.0, 0.05), (-10.0, 0.0), (0.0, 0.05), (0.0, 0.50)):
    eps = s * rng_e.standard_normal(N) if s > 0 else np.zeros(N)
    x = Rf_mc + b * (g_mc - gbar) + eps      # 지급액을 직접 만든다
    p = float((m_mc * x).mean())             # (eq-w13-11) 둘째 줄
    R = x / p
    ER, sdR = float(R.mean()), float(R.std(ddof=1))
    prem = ER - Rf_mc
    print('{:>6.1f}{:>10.2f}{:>10.6f}{:>10.6f}{:>12.4f}{:>10.4f}{:>10.4f}'.format(
        b, s, p, ER, 100 * prem, sdR, abs(prem) / sdR))
print(f'\n(eq-w13-15)의 경계 sd(m)/E[m] = {sd_mc / Em_mc:.4f} — 위 샤프의 절댓값은 모두 이 값 이하다')
print('b = 0이면 sd(eps)를 10배로 키워도 프리미엄은 난수 오차(1e-2 %p) 안에서 0이다')
열: b · eps 표준편차 · 가격 · 기대수익률 · 프리미엄 · 수익률 표준편차 · 샤프비율
b sd(eps) price E[R] prem(%p) sd(R) |Sharpe|
10.0 0.00 0.992288 1.069415 0.8247 0.2060 0.0400
10.0 0.05 0.992222 1.069418 0.8250 0.2121 0.0389
-10.0 0.00 1.007712 1.053047 -0.8121 0.2028 0.0400
0.0 0.05 1.000079 1.061168 -0.0000 0.0501 0.0000
0.0 0.50 1.000011 1.061150 -0.0018 0.5004 0.0000
(eq-w13-15)의 경계 sd(m)/E[m] = 0.0401 — 위 샤프의 절댓값은 모두 이 값 이하다
b = 0이면 sd(eps)를 10배로 키워도 프리미엄은 난수 오차(1e-2 %p) 안에서 0이다
# 예측 세 항목에 대응하는 수치를 한자리에 모은다.
print(f'예측 1 — R_f: 손계산 {Rf_cf:.6f}, 난수 {Rf_mc:.6f}, '
      f'소수 셋째 자리 {Rf_cf:.3f} vs {Rf_mc:.3f} (차이 {abs(Rf_mc - Rf_cf):.2e})')
print(f'예측 2 — gamma=2의 경계 {cv_of(2.0, 0.02):.4f}; '
      f'샤프 0.4에 닿는 gamma {cross[0.02][0]:.2f} (sigma_c=0.02) / '
      f'{cross[0.036][0]:.2f} (sigma_c=0.036), 그때 R_f {cross[0.02][1]:.3f} / {cross[0.036][1]:.3f}')
print(f'예측 3 — gamma=2에서 A {100 * prem_by_gamma[2.0][0]:+.4f}%p, '
      f'B {100 * prem_by_gamma[2.0][1]:+.4f}%p; '
      f'gamma 2->4 배율 A {rA:.3f}배, B {rB:.3f}배')
예측 1 — R_f: 손계산 1.061203, 난수 1.061168, 소수 셋째 자리 1.061 vs 1.061 (차이 3.43e-05)
예측 2 — gamma=2의 경계 0.0400; 샤프 0.4에 닿는 gamma 19.26 (sigma_c=0.02) / 10.70 (sigma_c=0.036), 그때 R_f 1.393 / 1.174
예측 3 — gamma=2에서 A +0.5077%p, B -0.5026%p; gamma 2->4 배율 A 1.956배, B 1.937배
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 (eq-w13-18)·(eq-w13-15)·(eq-w13-14)로 돌아간다.