노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
코드를 쓰기 전에 아래 셋에 답한다. 계산하지 않는다.
1. -불변. , , , , 에서 네 경우의 콜 가격 는 네 값이 모두 같다(11.90). 같은 로 를 계산하면 5.71·9.52·13.33·17.14로 달라진다. 예측: “네 값 동일 / 실제 확률 할인은 에 선형으로 증가”. 원인란에 적을 것: 이면 프리미엄이 음수인데도 가격은 같다.
예측: ____
2. 단계 → 연속 극한. , , , 의 나무 가격이 에서 11.30, 9.22, 9.39, 9.41로 수렴하고, 참조값 9.41과의 오차 1.88, -0.20, -0.02, -0.002가 차수(log-log 기울기 -1)로 준다. 부호는 짝수 에서 음, 홀수 에서 양으로 진동하며 로 일정하다(: -0.040, : +0.037). 예측: “오차 크기는 에 반비례, 부호는 의 홀짝으로 진동”. 원인란에 적을 것: 짝수 에서만 만기 마디 하나가 정확히 위에 놓인다.
예측: ____
3. 드리프트 이동. , : -나무와 -나무에서 의 평균은 0.060과 0.010(차이 ), 분산은 둘 다 0.040(10-3 이내로 같음). 경로별 밀도 의 -평균은 1.000. 예측: “평균만 0.05 이동, 분산 불변, ”.
예측: ____
2. 계산
패키지가 돌려주는 옵션 가격은 답이 아니라 참조값이다. 페이오프·복제·역방향 반복을 직접 쌓는다.
# 도구를 올린다 — 값은 아래 셀들에서 직접 쌓는다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager
from matplotlib.ticker import FuncFormatter, NullFormatter
from scipy.special import comb, erf

# 한국어 글꼴을 고른다.
CANDIDATES = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic',
              'Noto Sans CJK KR', 'Malgun Gothic']
installed = {f.name for f in font_manager.fontManager.ttflist}
for name in CANDIDATES:
    if name in installed:
        plt.rcParams['font.family'] = name
        break
plt.rcParams['axes.unicode_minus'] = False
print('글꼴:', plt.rcParams['font.family'])
글꼴: ['Apple SD Gothic Neo']
# 한 기간 나무의 파라미터와 콜의 페이오프를 상태 2개 배열로 쌓는다.
S0, u, d, R, K = 100.0, 1.2, 0.8, 1.05, 100.0
S1 = np.array([d * S0, u * S0])            # 순서는 [T, H]
X = np.maximum(S1 - K, 0.0)
XT, XH = float(X[0]), float(X[1])

# (eq-w15-8) 복제 포트폴리오를 연립에서 직접 푼다.
Delta = (XH - XT) / ((u - d) * S0)
Bond = (u * XT - d * XH) / ((u - d) * R)
V0 = Delta * S0 + Bond

# (eq-w15-1)의 q로 (eq-w15-9)의 할인 기댓값을 따로 쌓아 맞춰 본다.
q = (R - d) / (u - d)
price_Q = (q * XH + (1 - q) * XT) / R

print(f'q = {q:.4f},  1-q = {1 - q:.4f}')
print(f'X_H = {XH:.2f},  X_T = {XT:.2f}')
print(f'Delta = {Delta:.4f},  B = {Bond:.4f}')
print(f'복제비용 V0 = {V0:.4f}   위험중립 할인 = {price_Q:.4f}   차이 = {V0 - price_Q:.2e}')
q = 0.6250, 1-q = 0.3750
X_H = 20.00, X_T = 0.00
Delta = 0.5000, B = -38.0952
복제비용 V0 = 11.9048 위험중립 할인 = 11.9048 차이 = 7.11e-15
# 예측 1 — p마다 m을 새로 풀어 할인인자 경로로 가격을 다시 쌓는다((eq-w15-13)).
ps = [0.3, 0.5, 0.7, 0.9]
RS = np.array([d, u])                      # 주식 총수익률 R_S = S_1/S_0
rows = []
for p in ps:
    mH, mT = q / (p * R), (1 - q) / ((1 - p) * R)          # (eq-w15-13)
    price_m = p * mH * XH + (1 - p) * mT * XT              # E[mX] — p를 넣은 채로 쌓는다
    m, w = np.array([mT, mH]), np.array([1 - p, p])
    cov = float(w @ (m * RS) - (w @ m) * (w @ RS))
    rows.append([p, mH, mT, q / p, (1 - q) / (1 - p), p * (q / p), price_m,
                 (p * XH + (1 - p) * XT) / R, float(w @ RS) - R, -R * cov])

head = ['p', 'm_H', 'm_T', 'Z(H)', 'Z(T)', 'p·Z(H)', 'E[mX]', 'P할인', 'E[R_S]-R', '-R·Cov']
print(''.join(f'{h:>10}' for h in head))
for row in rows:
    print(''.join(f'{v:10.4f}' for v in row))

prices_m = [row[6] for row in rows]
prices_P = [row[7] for row in rows]
QH = [row[5] for row in rows]
print(f'\nE[mX] 네 값 = {[round(v, 4) for v in prices_m]}  '
      f'(표준편차 {np.std(prices_m):.2e}, max|E[mX]-V0| = '
      f'{max(abs(v - V0) for v in prices_m):.2e})')
print(f'Q(H)=p·Z(H) 네 값 = {[round(v, 4) for v in QH]}  '
      f'(q = {q:.4f}, max 차 = {max(abs(v - q) for v in QH):.2e})')
print(f'P할인 네 값 = {[round(v, 2) for v in prices_P]}  (이웃 간 차 일정: '
      f'{np.round(np.diff(prices_P), 4).tolist()})')
p m_H m_T Z(H) Z(T) p·Z(H) E[mX] P할인 E[R_S]-R -R·Cov
0.3000 1.9841 0.5102 2.0833 0.5357 0.6250 11.9048 5.7143 -0.1300 -0.1300
0.5000 1.1905 0.7143 1.2500 0.7500 0.6250 11.9048 9.5238 -0.0500 -0.0500
0.7000 0.8503 1.1905 0.8929 1.2500 0.6250 11.9048 13.3333 0.0300 0.0300
0.9000 0.6614 3.5714 0.6944 3.7500 0.6250 11.9048 17.1429 0.1100 0.1100
E[mX] 네 값 = [11.9048, 11.9048, 11.9048, 11.9048] (표준편차 8.88e-16, max|E[mX]-V0| = 7.11e-15)
Q(H)=p·Z(H) 네 값 = [0.625, 0.625, 0.625, 0.625] (q = 0.6250, max 차 = 0.00e+00)
P할인 네 값 = [5.71, 9.52, 13.33, 17.14] (이웃 간 차 일정: [3.8095, 3.8095, 3.8095])
# 그림 1 — p를 연속으로 움직여 가격의 불변과 m의 상쇄를 겹쳐 본다.
pg = np.linspace(0.05, 0.95, 181)
fig, ax = plt.subplots(1, 2, figsize=(10.0, 3.6))
ax[0].axhline(price_Q, color='C3', lw=2, label='위험중립 가격 $R^{-1}E^Q[X]$')
ax[0].plot(pg, (pg * XH + (1 - pg) * XT) / R, color='C0', lw=2,
           label='실제 확률 할인 $R^{-1}E[X]$')
ax[0].scatter(ps, [(p * XH + (1 - p) * XT) / R for p in ps], color='C0', zorder=3)
ax[0].set_xlabel('$p$'); ax[0].set_ylabel('값'); ax[0].legend(fontsize=8)
ax[0].set_title('가격은 $p$에 불변, 실제 확률 할인은 선형')

ax[1].plot(pg, q / (pg * R), color='C2', lw=2, label='$m_H=q/(pR)$')
ax[1].plot(pg, (1 - q) / ((1 - pg) * R), color='C4', lw=2, label='$m_T=(1-q)/((1-p)R)$')
ax[1].axhline(1 / R, color='0.5', ls=':', label='$1/R$')
ax[1].axvline(q, color='0.5', ls='--')
ax[1].set_ylim(0, 4.0); ax[1].set_xlabel('$p$'); ax[1].set_ylabel('할인인자 $m$')
ax[1].legend(fontsize=8)
ax[1].set_title('$q$는 고정, $m$이 움직여 상쇄한다')
fig.tight_layout(); plt.show()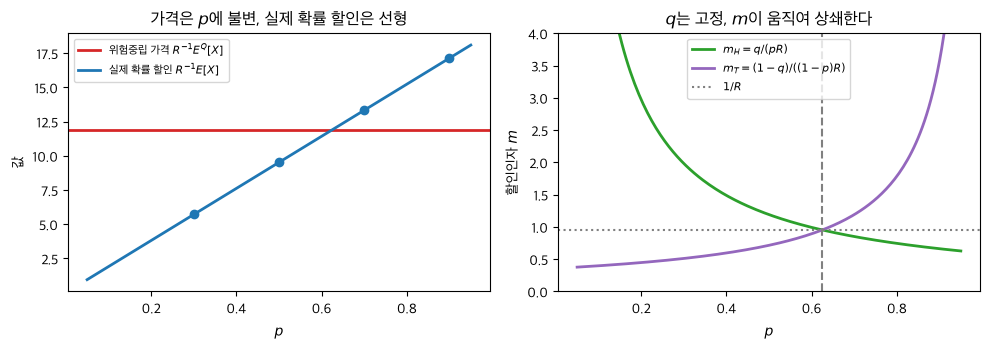
# N단계 나무를 직접 쌓는다 — 만기 마디 N+1개, 역방향 반복 N번((eq-w15-17)).
def tree_call(N, S0=100.0, K=100.0, sigma=0.2, r=0.03, Nh=1.0):
    h = Nh / N                                  # 만기는 Nh — 시각 T를 따로 두지 않는다
    uN, dN, RN = np.exp(sigma * np.sqrt(h)), np.exp(-sigma * np.sqrt(h)), np.exp(r * h)
    qN = (RN - dN) / (uN - dN)
    j = np.arange(N + 1)
    V = np.maximum(S0 * uN ** j * dN ** (N - j) - K, 0.0)
    for _ in range(N):
        V = (qN * V[1:] + (1 - qN) * V[:-1]) / RN
    return float(V[0])


# 참조값 — 답이 아니라 눈금이다. 표준정규 누적분포를 erf로 쌓는다.
def bs_call(S0=100.0, K=100.0, sigma=0.2, r=0.03, Nh=1.0):
    d1 = (np.log(S0 / K) + (r + sigma ** 2 / 2) * Nh) / (sigma * np.sqrt(Nh))
    d2 = d1 - sigma * np.sqrt(Nh)
    Phi = lambda x: 0.5 * (1.0 + erf(x / np.sqrt(2.0)))
    return float(S0 * Phi(d1) - K * np.exp(-r * Nh) * Phi(d2))


REF = bs_call()
print(f'참조값 = {REF:.4f}')
참조값 = 9.4134
# 예측 2 — N을 키우며 오차와 N·|오차|를 쌓는다.
Ns = [1, 10, 100, 1000, 50, 51]
print(f'{"N":>6}{"나무 가격":>12}{"오차":>12}{"N·|오차|":>12}{"부호":>6}{"홀짝":>6}')
for N in Ns:
    v = tree_call(N)
    e = v - REF
    print(f'{N:6d}{v:12.4f}{e:12.4f}{N * abs(e):12.4f}'
          f'{"+" if e > 0 else "-":>6}{"짝" if N % 2 == 0 else "홀":>6}')

# 짝수 N에서만 만기 마디가 K 위에 놓이는지 직접 확인한다.
for N in (50, 51):
    h = 1.0 / N                             # 만기 Nh = 1
    nodes = 100.0 * np.exp(0.2 * np.sqrt(h) * (2 * np.arange(N + 1) - N))
    print(f'N={N}: 만기 마디와 K=100의 최소 거리 = {np.abs(nodes - 100.0).min():.3e}')
N 나무 가격 오차 N·|오차| 부호 홀짝
1 11.2972 1.8838 1.8838 + 홀
10 9.2179 -0.1956 1.9555 - 짝
100 9.3936 -0.0198 1.9808 - 짝
1000 9.4114 -0.0020 1.9830 - 짝
50 9.3738 -0.0396 1.9782 - 짝
51 9.4504 0.0370 1.8876 + 홀
N=50: 만기 마디와 K=100의 최소 거리 = 0.000e+00
N=51: 만기 마디와 K=100의 최소 거리 = 2.762e+00
# 그림 2 — log-log에서 오차 크기의 기울기를 재고 홀짝을 색으로 가른다.
Ng = np.arange(2, 201)
err = np.array([tree_call(int(N)) - REF for N in Ng])
slope = float(np.polyfit(np.log(Ng), np.log(np.abs(err)), 1)[0])

fig, ax = plt.subplots(figsize=(6.6, 3.9))
ax.loglog(Ng[err < 0], -err[err < 0], 'o', ms=3.2, color='C0', label='짝수 $N$ (오차 음)')
ax.loglog(Ng[err > 0], err[err > 0], 'o', ms=3.2, color='C3', label='홀수 $N$ (오차 양)')
ax.loglog(Ng, 1.9 / Ng, color='0.4', ls='--', lw=1.4, label='$1.9/N$')
plain = FuncFormatter(lambda v, _: f'{v:g}')      # 눈금을 한글 글꼴로 찍는다
for axis in (ax.xaxis, ax.yaxis):
    axis.set_major_formatter(plain); axis.set_minor_formatter(NullFormatter())
ax.set_xlabel('$N$'); ax.set_ylabel('|오차|')
ax.set_title(f'log-log 기울기 = {slope:.2f}, $N\\cdot|$오차$|\\approx 1.9$')
ax.legend(fontsize=8); fig.tight_layout(); plt.show()

print(f'log-log 기울기 = {slope:.3f}')
print(f'N·|오차| 중앙값 = {np.median(Ng * np.abs(err)):.3f}')
print(f'부호가 짝수 N에서 모두 음인가: {bool((err[Ng % 2 == 0] < 0).all())}')
print(f'부호가 홀수 N에서 모두 양인가: {bool((err[Ng % 2 == 1] > 0).all())}')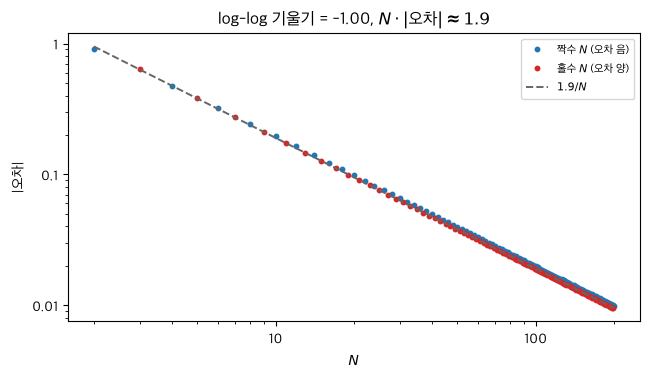
log-log 기울기 = -0.998
N·|오차| 중앙값 = 1.915
부호가 짝수 N에서 모두 음인가: True
부호가 홀수 N에서 모두 양인가: True
# 예측 3 — 이항 확률질량을 이항계수로 직접 만들고 P·Q 두 저울로 잰다.
N, sigma, r, mu = 50, 0.2, 0.03, 0.08
h = 1.0 / N                                 # 만기 Nh = 1
uN, dN, RN = np.exp(sigma * np.sqrt(h)), np.exp(-sigma * np.sqrt(h)), np.exp(r * h)
qN = (RN - dN) / (uN - dN)
pN = (np.exp(mu * h) - dN) / (uN - dN)

k = np.arange(N + 1)
pmf_P = comb(N, k) * pN ** k * (1 - pN) ** (N - k)
pmf_Q = comb(N, k) * qN ** k * (1 - qN) ** (N - k)
logS = (2 * k - N) * sigma * np.sqrt(h)          # ln(S_N/S_0)

mean_P, mean_Q = float(pmf_P @ logS), float(pmf_Q @ logS)
var_P = float(pmf_P @ (logS - mean_P) ** 2)
var_Q = float(pmf_Q @ (logS - mean_Q) ** 2)
Z = (qN / pN) ** k * ((1 - qN) / (1 - pN)) ** (N - k)   # 경로별 밀도 dQ/dP
EZ = float(pmf_P @ Z)

print(f'q = {qN:.6f},  p = {pN:.6f}')
print(f'평균  P = {mean_P:.4f}   Q = {mean_Q:.4f}   이동 = {mean_P - mean_Q:.4f}'
      f'   ((mu-r)Nh = {(mu - r) * N * h:.4f})')
print(f'분산  P = {var_P:.4f}   Q = {var_Q:.4f}   차 = {abs(var_P - var_Q):.2e}')
print(f'E[Z] = {EZ:.4f},  Z 범위 = [{Z.min():.3f}, {Z.max():.3f}]')
q = 0.503538, p = 0.521233
평균 P = 0.0601 Q = 0.0100 이동 = 0.0500 ((mu-r)Nh = 0.0500)
분산 P = 0.0399 Q = 0.0400 차 = 7.01e-05
E[Z] = 1.0000, Z 범위 = [0.178, 6.139]
# 그림 3 — 두 저울 아래 로그수익률 분포를 겹친다.
bw = float(logS[1] - logS[0])
fig, ax = plt.subplots(figsize=(6.6, 3.9))
ax.bar(logS - 0.24 * bw, pmf_P, width=0.46 * bw, color='C0', alpha=0.8, label='$P$')
ax.bar(logS + 0.24 * bw, pmf_Q, width=0.46 * bw, color='C3', alpha=0.8, label='$Q$')
ax.axvline(mean_P, color='C0', ls='--', lw=1.4)
ax.axvline(mean_Q, color='C3', ls='--', lw=1.4)
ax.set_xlim(-0.55, 0.65)
ax.set_xlabel('$\\ln(S_N/S_0)$'); ax.set_ylabel('확률')
ax.set_title(f'평균 {mean_P:.3f} → {mean_Q:.3f} (이동 {mean_P - mean_Q:.3f}), '
             f'분산 {var_P:.3f} · {var_Q:.3f}')
ax.legend(fontsize=9); fig.tight_layout(); plt.show()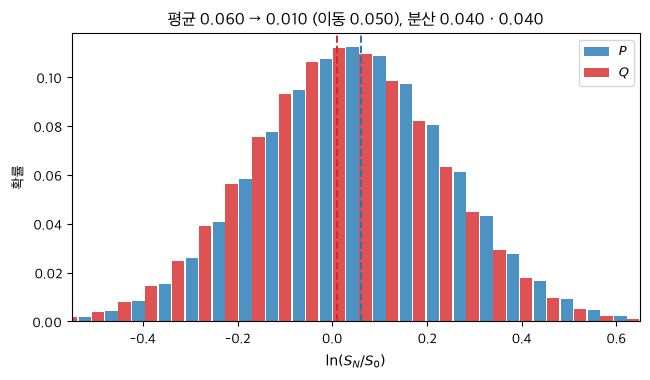
# 대조 표에 옮길 수치를 예측 항목 순서로 모은다.
print('예측 1 — E[mX] ' + str([round(v, 4) for v in prices_m])
      + f' (표준편차 {np.std(prices_m):.1e}, max|E[mX]-V0| = '
      + f'{max(abs(v - V0) for v in prices_m):.1e}) / '
      + f'Q(H)=p·Z(H) = q = {q:.4f} (max 차 {max(abs(v - q) for v in QH):.1e}) / '
      + 'P할인 ' + str([round(v, 2) for v in prices_P])
      + f' / 프리미엄 {[round(row[8], 2) for row in rows]}')
vals = [tree_call(N) for N in (1, 10, 100, 1000)]
print('예측 2 — 가격 ' + str([round(v, 2) for v in vals])
      + f' / 참조 {REF:.2f} / 오차 ' + str([round(v - REF, 3) for v in vals])
      + f' / 기울기 {slope:.2f} / N=50 {tree_call(50) - REF:+.3f}, '
      f'N=51 {tree_call(51) - REF:+.3f}')
print(f'예측 3 — 평균 {mean_P:.3f} → {mean_Q:.3f} (이동 {mean_P - mean_Q:.3f}) / '
      f'분산 {var_P:.3f} · {var_Q:.3f} (차 {abs(var_P - var_Q):.1e}) / E[Z] = {EZ:.3f}')
예측 1 — E[mX] [11.9048, 11.9048, 11.9048, 11.9048] (표준편차 8.9e-16, max|E[mX]-V0| = 7.1e-15) / Q(H)=p·Z(H) = q = 0.6250 (max 차 0.0e+00) / P할인 [5.71, 9.52, 13.33, 17.14] / 프리미엄 [-0.13, -0.05, 0.03, 0.11]
예측 2 — 가격 [11.3, 9.22, 9.39, 9.41] / 참조 9.41 / 오차 [1.884, -0.196, -0.02, -0.002] / 기울기 -1.00 / N=50 -0.040, N=51 +0.037
예측 3 — 평균 0.060 → 0.010 (이동 0.050) / 분산 0.040 · 0.040 (차 7.0e-05) / E[Z] = 1.000
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w15-9)·(eq-w15-13)·(eq-w15-18)로, 2번은 (eq-w15-15)·(eq-w15-17)로, 3번은 (eq-w15-16)으로 돌아간다.