노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다. 답은 본문 3절의 표에서 전부 읽어 낼 수 있어야 하며, 읽어 내지 못하는 항목이 있으면 그 자리가 이번 주의 구멍이다.
이항나무(, , , )에서 로 를 예측할 때 제곱오차를 최소로 하는 는 무엇인가. 최소값은 의 몇 %인가.
예측: ____
정보를 에서 로 줄이면 최소 제곱오차는 몇 배가 되는가. 과 최소 오차 가운데 어느 것이 큰가.
예측: ____
시뮬레이션 잔차 과 , , 의 표본 공분산은 0에 가까운가. 잔차와 의 공분산은 얼마인가. 더미 회귀의 는 129.6·97.2에 수렴하는가. 와 의 차는 0인가.
예측: ____
2. 계산
패키지 호출로 답을 내지 않는다. 상태 4개와 확률 벡터부터 직접 쌓는다. 모든 기댓값은 가중합이고, 최소화는 격자탐색과 정규방정식 둘로 따로 구해 대조한다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager

# 한국어 글꼴을 고른다
_have = {f.name for f in font_manager.fontManager.ttflist}
for _name in ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']:
    if _name in _have:
        plt.rcParams['font.family'] = _name
        break
plt.rcParams['axes.unicode_minus'] = False
print('글꼴:', plt.rcParams['font.family'][0])
글꼴: Apple SD Gothic Neo
상태공간. 와 확률 벡터를 손으로 쌓고, 기댓값을 가중합으로 정의한다.
# 상태 4개와 확률 벡터를 쌓는다
S0, u, d, p = 100.0, 1.2, 0.9, 0.6
states = ['uu', 'ud', 'du', 'dd']
prob = np.array([p * p, p * (1 - p), (1 - p) * p, (1 - p) * (1 - p)])
S1 = np.array([S0 * u, S0 * u, S0 * d, S0 * d])
S2 = np.array([S0 * u * u, S0 * u * d, S0 * d * u, S0 * d * d])


def E(x):
    """가중합으로 기댓값을 쌓는다"""
    return float(np.sum(prob * np.asarray(x, dtype=float)))


def Var(x):
    """2차 모멘트에서 평균의 제곱을 뺀다"""
    return E(np.asarray(x, dtype=float) ** 2) - E(x) ** 2


print(f'{"상태":>5}{"P":>8}{"S1":>9}{"S2":>9}')
for s, q, a, b in zip(states, prob, S1, S2):
    print(f'{s:>5}{q:8.2f}{a:9.1f}{b:9.1f}')
print(f'E[S1]={E(S1):.3f}  E[S2]={E(S2):.3f}  Var(S1)={Var(S1):.3f}  Var(S2)={Var(S2):.3f}')
print(f'E[S1^2]={E(S1 ** 2):.3f}  E[S1*S2]={E(S1 * S2):.3f}  E[S2^2]={E(S2 ** 2):.3f}')
상태 P S1 S2
uu 0.36 120.0 144.0
ud 0.24 120.0 108.0
du 0.24 90.0 108.0
dd 0.16 90.0 81.0
E[S1]=108.000 E[S2]=116.640 Var(S1)=216.000 Var(S2)=508.550
E[S1^2]=11880.000 E[S1*S2]=12830.400 E[S2^2]=14113.440
칸별 평균. 분할 위에서 (eq-w14-10)의 를 직접 쌓는다. 직교조건 (eq-w14-9), 타워 (eq-w14-2), 피타고라스 (eq-w14-13)를 같은 배열로 확인한다.
# 칸 지표에서 조건부 기댓값을 쌓는다
up = (S1 == 120.0).astype(float)
dn = 1.0 - up
c_u = E(S2 * up) / E(up)
c_d = E(S2 * dn) / E(dn)
Yhat1 = c_u * up + c_d * dn
eps0 = S2 - Yhat1
print(f'c_u={c_u:.3f} (=S1의 {c_u / 120:.2f}배)   c_d={c_d:.3f} (=S1의 {c_d / 90:.2f}배)')
print(f'직교  E[(S2-Yhat1)1_up]={E(eps0 * up):.3e}   E[(S2-Yhat1)1_dn]={E(eps0 * dn):.3e}')
print(f'타워  E[Yhat1]={E(Yhat1):.3f}   E[S2]={E(S2):.3f}')
v_hat, v_eps = Var(Yhat1), E(eps0 ** 2)
print(f'피타고라스  Var(Yhat1)={v_hat:.3f} + E[eps^2]={v_eps:.3f} = {v_hat + v_eps:.3f} = Var(S2)={Var(S2):.3f}')
print(f'칸별 조건부 분산  up={E((eps0 ** 2) * up) / E(up):.3f}   down={E((eps0 ** 2) * dn) / E(dn):.3f}')
c_u=129.600 (=S1의 1.08배) c_d=97.200 (=S1의 1.08배)
직교 E[(S2-Yhat1)1_up]=3.553e-15 E[(S2-Yhat1)1_dn]=-1.776e-15
타워 E[Yhat1]=116.640 E[S2]=116.640
피타고라스 Var(Yhat1)=251.942 + E[eps^2]=256.608 = 508.550 = Var(S2)=508.550
칸별 조건부 분산 up=311.040 down=174.960
후보와 최소점. 세 후보 의 제곱오차를 재고, 격자에서 의 최소점을 탐색한 뒤 정규방정식 (eq-w14-16)의 해와 대조한다.
# 후보별 제곱오차를 쌓는다
def g(a, b):
    """후보 a+b*S1의 제곱오차를 가중합으로 쌓는다"""
    return E((S2 - a - b * S1) ** 2)


for name, a, b in [('E[S2] 상수 (F0)', E(S2), 0.0), ('S1 그대로 (F1)', 0.0, 1.0),
                   ('1.08*S1 (F1)', 0.0, 1.08)]:
    print(f'{name:>16}  a={a:7.2f}  b={b:5.2f}  MSE={g(a, b):9.3f}')
print(f'{"S2 자신 (F2)":>16}  a={"—":>7}  b={"—":>5}  MSE={0.0:9.3f}   (a+b*S1 족의 후보가 아니다)')

# (a,b) 격자 위에 g를 쌓는다
A = np.linspace(-40.0, 160.0, 401)
B = np.linspace(-0.2, 1.6, 361)
AA, BB = np.meshgrid(A, B, indexing='ij')
G = np.zeros_like(AA)
for q, s1k, s2k in zip(prob, S1, S2):
    G += q * (s2k - AA - BB * s1k) ** 2
i, j = np.unravel_index(np.argmin(G), G.shape)
print(f'격자탐색 최소점  (a,b)=({A[i]:.3f}, {B[j]:.3f})  g={G[i, j]:.3f}')
E[S2] 상수 (F0) a= 116.64 b= 0.00 MSE= 508.550
S1 그대로 (F1) a= 0.00 b= 1.00 MSE= 332.640
1.08*S1 (F1) a= 0.00 b= 1.08 MSE= 256.608
S2 자신 (F2) a= — b= — MSE= 0.000 (a+b*S1 족의 후보가 아니다)
격자탐색 최소점 (a,b)=(0.000, 1.080) g=256.608
# 정규방정식 2x2를 직접 푼다
M = np.array([[1.0, E(S1)], [E(S1), E(S1 ** 2)]])
v = np.array([E(S2), E(S1 * S2)])
det = M[0, 0] * M[1, 1] - M[0, 1] * M[1, 0]
a_star = (v[0] * M[1, 1] - M[0, 1] * v[1]) / det
b_star = (M[0, 0] * v[1] - M[1, 0] * v[0]) / det
mse_F1 = g(a_star, b_star)
mse_F0 = g(E(S2), 0.0)
print(f'정규방정식 해  (a*,b*)=({a_star:.3f}, {b_star:.3f})  g={mse_F1:.3f}')
print(f'격자와의 차    da={abs(a_star - A[i]):.3e}   db={abs(b_star - B[j]):.3e}')
print(f'b* = Cov(S1,S2)/Var(S1) = {(E(S1 * S2) - E(S1) * E(S2)) / Var(S1):.4f}')
print(f'[예측1] (a*,b*)=({a_star:.2f}, {b_star:.2f}),  최소 g={mse_F1:.3f} = Var(S2)의 {100 * mse_F1 / Var(S2):.1f}%')
정규방정식 해 (a*,b*)=(0.000, 1.080) g=256.608
격자와의 차 da=0.000e+00 db=5.551e-15
b* = Cov(S1,S2)/Var(S1) = 1.0800
[예측1] (a*,b*)=(0.00, 1.08), 최소 g=256.608 = Var(S2)의 50.5%
정보를 줄인다. 의 최소 오차와 의 최소 오차를 비교한다. 줄어드는 폭이 이라는 것이 (eq-w14-13)의 회계다.
# 두 공간의 최소 오차를 비교한다
ratio = mse_F0 / mse_F1
bigger = '최소오차' if mse_F1 > v_hat else 'Var(Yhat1)'
print(f'F1 최소오차={mse_F1:.3f}   F0 최소오차={mse_F0:.3f}')
print(f'감소폭 {mse_F0 - mse_F1:.3f} = Var(Yhat1) {v_hat:.3f}   설명력 R^2={v_hat / Var(S2):.3f}')
print(f'[예측2] 배수={ratio:.2f}배,  Var(Yhat1)={v_hat:.3f} vs 최소오차={mse_F1:.3f} → 큰 쪽은 {bigger}')
F1 최소오차=256.608 F0 최소오차=508.550
감소폭 251.942 = Var(Yhat1) 251.942 설명력 R^2=0.495
[예측2] 배수=1.98배, Var(Yhat1)=251.942 vs 최소오차=256.608 → 큰 쪽은 최소오차
그림 1. 의 등고선 위에 세 후보를 얹는다. 이 두 값이므로 이 평면이 전체다.
# 제곱오차 곡면의 등고선을 그린다
fig, ax = plt.subplots(figsize=(6.6, 4.6))
levels = np.geomspace(mse_F1 * 1.05, G.max(), 10)
cs = ax.contour(A, B, G.T, levels=levels, colors='0.65', linewidths=0.8)
ax.clabel(cs, fmt='%.0f', fontsize=7)
ax.plot(E(S2), 0.0, 'o', color='k', label=f'상수 예측 (116.64, 0) · {mse_F0:.1f}')
ax.plot(0.0, 1.0, 'o', color='tab:orange', label=f'S1 그대로 (0, 1) · {g(0.0, 1.0):.1f}')
ax.plot(a_star, b_star, 'o', color='tab:blue', label=f'최소점 (0, 1.08) · {mse_F1:.1f}')
ax.set_xlabel('a (절편)')
ax.set_ylabel('b (기울기)')
ax.set_title('제곱오차 g(a,b) = E[(S2 - a - b·S1)^2] 의 등고선')
ax.legend(loc='upper right', fontsize=8)
plt.tight_layout()
plt.show()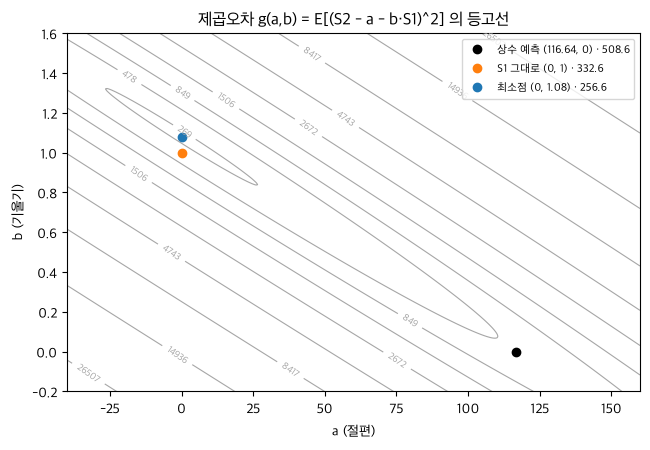
시뮬레이션. 경로를 쌓아 잔차 의 표본 공분산을 평균 빼고 곱해 직접 계산한다. 직교는 "작다"가 아니라 "무관하다"이므로 표본상관도 함께 적는다.
# N=100,000 경로를 쌓는다 — 뒤에서 쓸 앞 2000경로 부분표본이 본문 3절·그림 4의
# "씨앗 0에서 2000경로" 표본과 같아지도록, 2000경로분 난수를 먼저 뽑고 나머지를 이어 붙인다
rng = np.random.default_rng(0)
N, n_sub = 100_000, 2000
h1, h2 = rng.random(n_sub), rng.random(n_sub)
t1, t2 = rng.random(N - n_sub), rng.random(N - n_sub)
xi1 = np.where(np.concatenate([h1, t1]) < p, u, d)
xi2 = np.where(np.concatenate([h2, t2]) < p, u, d)
s1 = S0 * xi1
s2 = s1 * xi2
eps = s2 - 1.08 * s1


def scov(x, y):
    """평균을 빼고 곱해 표본 공분산을 쌓는다"""
    return float(np.mean((x - np.mean(x)) * (y - np.mean(y))))


print(f'표본 평균  E[S1]={np.mean(s1):.3f}  E[S2]={np.mean(s2):.3f}  E[eps]={np.mean(eps):.4f}')
print(f'{"시험 방향 W":>14}{"Cov(eps,W)":>14}{"Corr(eps,W)":>14}')
for nm, w in [('S1', s1), ('S1^2', s1 ** 2), ('1{S1=120}', (s1 == 120.0).astype(float)), ('S2', s2)]:
    cov_w = scov(eps, w)
    print(f'{nm:>14}{cov_w:14.4f}{cov_w / np.sqrt(scov(eps, eps) * scov(w, w)):14.5f}')
print(f'[예측3a] Cov(eps,S2)={scov(eps, s2):.3f}  (모집단 E[eps^2]={v_eps:.3f})')
표본 평균 E[S1]=108.005 E[S2]=116.717 E[eps]=0.0708
시험 방향 W Cov(eps,W) Corr(eps,W)
S1 0.2509 0.00107
S1^2 52.6961 0.00107
1{S1=120} 0.0084 0.00107
S2 256.4249 0.71043
[예측3a] Cov(eps,S2)=256.425 (모집단 E[eps^2]=256.608)
더미 회귀. 칸 지표 두 열이 다. 이므로 는 칸별 표본평균이고, 이것이 (eq-w14-10)의 표본 판이다. 앞 2000경로 부분표본은 본문 3절과 그림 4가 쓰는 "씨앗 0에서 2000경로"와 같은 표본이므로 칸별 평균도 같은 130.2·97.3이 나와야 한다. 칸마다 조건부 분산이 다르니(up 311.04, down 174.96) 표본오차 눈금도 칸마다 따로 재고, 편차를 그 눈금으로 나눠 붙인다.
# 칸 지표 행렬을 쌓아 칸별 표본평균을 구한다
def cell_means(x1, y):
    """더미 열 X와 X'X 대각에서 칸별 평균을 쌓는다"""
    X = np.column_stack([(x1 == 120.0).astype(float), (x1 == 90.0).astype(float)])
    dg = np.diag(X.T @ X)
    return X, dg, (X.T @ y) / dg


Xf, nf, beta_full = cell_means(s1, s2)
print(f'N={N}    칸 관측 수 {nf.astype(int)}   Py={beta_full[0]:.3f} · {beta_full[1]:.3f}')
Xs, ns, beta_sub = cell_means(s1[:n_sub], s2[:n_sub])   # 앞 2000경로 = 본문 3절·그림 4의 표본
print(f'n_sub={n_sub}  칸 관측 수 {ns.astype(int)}   Py={beta_sub[0]:.3f} · {beta_sub[1]:.3f}')
se_u, se_d = np.sqrt(311.04 / ns[0]), np.sqrt(174.96 / ns[1])
print(f'모집단      129.600 · 97.200   표본오차 눈금 up=sqrt(311.04/{int(ns[0])})={se_u:.3f}'
      f'   down=sqrt(174.96/{int(ns[1])})={se_d:.3f}')
print(f'편차/눈금   up {(beta_sub[0] - 129.6) / se_u:+.2f}   down {(beta_sub[1] - 97.2) / se_d:+.2f}')
N=100000 칸 관측 수 [60018 39982] Py=129.685 · 97.250
n_sub=2000 칸 관측 수 [1209 791] Py=130.243 · 97.316
모집단 129.600 · 97.200 표본오차 눈금 up=sqrt(311.04/1209)=0.507 down=sqrt(174.96/791)=0.470
편차/눈금 up +1.27 down +0.25
# 부분표본에서 사영행렬을 쌓아 항등식을 잰다
P = Xs @ np.diag(1.0 / ns) @ Xs.T
P0 = np.ones((n_sub, n_sub)) / n_sub
Py = P @ s2[:n_sub]


def fro(Mx):
    """프로베니우스 노름을 쌓는다"""
    return float(np.sqrt(np.sum(Mx * Mx)))


d_idem, d_sym, d_tower = fro(P @ P - P), fro(P.T - P), fro(P0 @ P - P0)
print(f"||P^2-P||_F={d_idem:.3e}   ||P'-P||_F={d_sym:.3e}   ||P0P-P0||_F={d_tower:.3e}")
print(f'Py가 갖는 값 두 개: {np.unique(np.round(Py, 6))}')
print(f'[예측3b] Py=({beta_sub[0]:.3f}, {beta_sub[1]:.3f}) → N에서 ({beta_full[0]:.3f}, {beta_full[1]:.3f}),  ||P0P-P0||={d_tower:.2e}')
||P^2-P||_F=1.402e-14 ||P'-P||_F=0.000e+00 ||P0P-P0||_F=1.652e-14
Py가 갖는 값 두 개: [ 97.316056 130.243176]
[예측3b] Py=(130.243, 97.316) → N에서 (129.685, 97.250),  ||P0P-P0||=1.65e-14
그림 2. 왼쪽은 중첩된 세 공간의 최소 오차, 오른쪽은 더미 사영의 적합값이다.
# 중첩 공간의 오차와 더미 사영을 그린다
fig, ax = plt.subplots(1, 2, figsize=(10.0, 4.2))
vals = [mse_F0, mse_F1, 0.0]
ax[0].bar(['L2(F0)\n상수', 'L2(F1)\n1.08·S1', 'L2(F2)\nS2 자신'], vals,
          color=['0.35', 'tab:blue', 'tab:green'])
for k, val in enumerate(vals):
    ax[0].text(k, val + 12, f'{val:.3f}', ha='center', fontsize=9)
ax[0].set_ylabel('최소 제곱오차')
ax[0].set_title(f'정보가 커지면 오차가 준다 (감소폭 {mse_F0 - mse_F1:.3f} = Var(Yhat1))', fontsize=10)
jit = rng.normal(0.0, 1.6, n_sub)
ax[1].scatter(s1[:n_sub] + jit, s2[:n_sub], s=5, alpha=0.15, color='0.6', label='표본 (S1, S2)')
ax[1].scatter(s1[:n_sub], Py, s=8, color='tab:blue', label='Py 칸별 표본평균')
for x0, y0 in [(120.0, 129.6), (90.0, 97.2)]:
    ax[1].plot([x0 - 12, x0 + 12], [y0, y0], 'k--', lw=1.2)
ax[1].plot([], [], 'k--', lw=1.2, label='모집단 조건부 기댓값 129.6 · 97.2')
ax[1].set_xlabel('S1')
ax[1].set_ylabel('S2')
ax[1].set_title('유한 분할 위의 사영은 더미 회귀다', fontsize=10)
ax[1].legend(loc='upper left', fontsize=8)
plt.tight_layout()
plt.show()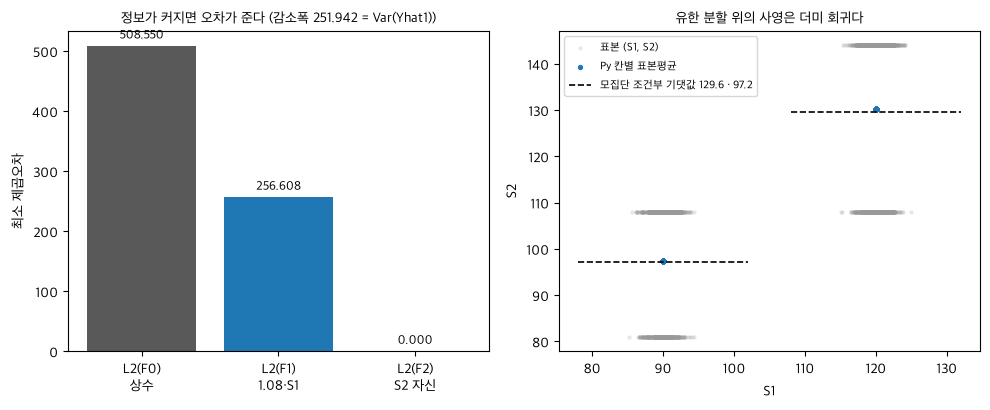
예측 대조용 수치. 세 항목의 답을 한자리에 모은다.
# 예측 항목 3개에 대응하는 수치를 모은다
print('[예측1] (a*,b*) = ({:.2f}, {:.2f});  최소 g = {:.3f} = Var(S2) {:.3f}의 {:.1f}%'
      .format(a_star, b_star, mse_F1, Var(S2), 100 * mse_F1 / Var(S2)))
print('[예측2] F1→F0 최소오차 {:.3f}→{:.3f} = {:.2f}배;  Var(Yhat1)={:.3f}, 최소오차={:.3f} (큰 쪽: {})'
      .format(mse_F1, mse_F0, ratio, v_hat, mse_F1, bigger))
sd_e = np.sqrt(scov(eps, eps))
for nm, w in [('S1', s1), ('S1^2', s1 ** 2), ('1up', (s1 == 120.0).astype(float)), ('S2', s2)]:
    sd_w = np.sqrt(scov(w, w))
    print('[예측3] Cov(eps,{:>4})={:10.4f}   corr={:+.5f}   표본오차 눈금 {:.4f}'
          .format(nm, scov(eps, w), scov(eps, w) / (sd_e * sd_w), sd_e * sd_w / np.sqrt(N)))
print('        Cov(eps,S2)의 모집단값 {:.3f};  Py=({:.3f}, {:.3f}) → N에서 ({:.3f}, {:.3f})'
      .format(v_eps, beta_sub[0], beta_sub[1], beta_full[0], beta_full[1]))
print("        ||P^2-P||={:.2e}  ||P'-P||={:.2e}  ||P0P-P0||={:.2e}"
      .format(d_idem, d_sym, d_tower))
[예측1] (a*,b*) = (0.00, 1.08); 최소 g = 256.608 = Var(S2) 508.550의 50.5%
[예측2] F1→F0 최소오차 256.608→508.550 = 1.98배; Var(Yhat1)=251.942, 최소오차=256.608 (큰 쪽: 최소오차)
[예측3] Cov(eps, S1)= 0.2509 corr=+0.00107 표본오차 눈금 0.7438
[예측3] Cov(eps,S1^2)= 52.6961 corr=+0.00107 표본오차 눈금 156.1939
[예측3] Cov(eps, 1up)= 0.0084 corr=+0.00107 표본오차 눈금 0.0248
[예측3] Cov(eps, S2)= 256.4249 corr=+0.71043 표본오차 눈금 1.1414
Cov(eps,S2)의 모집단값 256.608; Py=(130.243, 97.316) → N에서 (129.685, 97.250)
||P^2-P||=1.40e-14 ||P'-P||=0.00e+00 ||P0P-P0||=1.65e-14
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 (eq-w14-16)·(eq-w14-13)·(eq-w14-12)로 돌아간다.