노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다.
5부문 예제에서 어느 부문의 가 가장 큰가, 는 얼마인가, 는 보다 큰가. 노이만 부분합의 최대 오차는 회차마다 몇 배로 주는가. 예측 — 열합이 가장 큰 에너지(1.9); 합은 ; 크다, 0.917; 약 배(, 정확 등식은 아니고 극한에서).
예측: ____
계수 1 족, 순위–규모 , 에서 이면 는 몇 분의 1이 되는가. 균등 이면? 예측 — 지수 × 3자릿수 ≈ , 실제는 으로 약 13분의 1(유한 보정); 균등은 10-1.5, 31.6분의 1.
예측: ____
iid Pareto 몬테카를로에서 의 10–90% 띠 폭은 이 커질 때 어떻게 되는가 — 와 각각. 예측 — 은 로 조인다(a.s. 수렴). 는 조이지 않는다 — 극한이 비퇴화 확률변수라서(최댓값 항 는 Fréchet, 는 안정분포 — 어느 쪽이든 비퇴화) 분위비가 3 근방에 머문다.
예측: ____
2. 계산
패키지 호출로 답을 내지 않는다. 투입산출 행렬과 전파 회차와 비중 벡터를 직접 쌓는다. 역행렬을 부르지 않고 선형계를 풀며, 급수는 반복문으로, Pareto 표본은 역함수법으로 만든다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager

# 한국어 글꼴을 후보 목록에서 있는 것으로 고른다
_cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
_have = {f.name for f in font_manager.fontManager.ttflist}
for _f in _cands:
    if _f in _have:
        plt.rcParams['font.family'] = _f
        break
plt.rcParams['axes.unicode_minus'] = False

# 5부문 투입산출 몫 행렬을 직접 입력한다 — 행 = 구매자, 열 = 공급자
SECTORS = ['에너지', '소재', '제조', '물류', '서비스']
W = np.array([[0.4, 0.2, 0.2, 0.1, 0.1],
              [0.5, 0.2, 0.1, 0.1, 0.1],
              [0.2, 0.4, 0.1, 0.2, 0.1],
              [0.6, 0.0, 0.2, 0.1, 0.1],
              [0.2, 0.0, 0.2, 0.2, 0.4]])
ALPHA, N5 = 0.5, 5
B5 = np.full(N5, 1.0 / N5)
assert np.all(W >= 0) and np.allclose(W.sum(axis=1), 1.0)   # A1: 비음, 행합 1
d = W.sum(axis=0)                                           # 가중 출차수 d = W'1 (열합)


print('글꼴:', plt.rcParams['font.family'][0])
print('행합 :', W.sum(axis=1))
print('열합 d:', d, '  합 =', d.sum(), '= n')
글꼴: Apple SD Gothic Neo
행합 : [1. 1. 1. 1. 1.]
열합 d: [1.9 0.8 0.8 0.7 0.8] 합 = 5.0 = n
예측 1. 3절 5부문 예제(, , 행은 구매자·열은 공급자)에서 영향력 벡터 를 선형계 로 풀고((eq-w21-9)), 같은 벡터를 노이만 급수 (eq-w21-7)의 부분합으로 따로 쌓아 오차가 회차마다 몇 배로 주는지 본다.
# 영향력 벡터를 선형계 (I-(1-α)W')v = b 로 푼다 — 역행렬을 부르지 않는다
def influence(Wm, alpha, b):
    n = Wm.shape[0]
    return np.linalg.solve(np.eye(n) - (1.0 - alpha) * Wm.T, b)


v5 = influence(W, ALPHA, B5)
first = (1.0 + (1.0 - ALPHA) * d) / N5        # 급수를 k=0,1 에서 끊은 1차 근사
print(f"{'부문':<7}{'열합 d':>9}{'1차 근사':>11}{'v_i 정확':>11}{'차':>9}")
for i in range(N5):
    print(f'{SECTORS[i]:<7}{d[i]:9.2f}{first[i]:11.3f}{v5[i]:11.3f}{v5[i] - first[i]:9.3f}')
print(f'{"합":<7}{d.sum():9.2f}{first.sum():11.3f}{v5.sum():11.3f}')
print()
print(f'가장 큰 v_i : {SECTORS[int(np.argmax(v5))]} ({v5.max():.4f})')
print(f'합 1\'v      = {v5.sum():.6f}   1/α = {1.0 / ALPHA:.6f}')
print(f"고정점 확인  : max|v - b - (1-α)W'v| = {np.abs(v5 - B5 - (1 - ALPHA) * (W.T @ v5)).max():.2e}")
부문 열합 d 1차 근사 v_i 정확 차
에너지 1.90 0.390 0.580 0.190
소재 0.80 0.280 0.367 0.087
제조 0.80 0.280 0.363 0.083
물류 0.70 0.270 0.336 0.066
서비스 0.80 0.280 0.353 0.073
합 5.00 1.500 2.000
가장 큰 v_i : 에너지 (0.5803)
합 1'v = 2.000000 1/α = 2.000000
고정점 확인 : max|v - b - (1-α)W'v| = 5.55e-17
# 2-노름과 허핀달을 쌓고, 노이만 부분합을 반복문으로 회차마다 더한다
nv, low = np.linalg.norm(v5), 1.0 / (ALPHA * np.sqrt(N5))
herf = np.sum((v5 / v5.sum()) ** 2)
print(f'||v||_2 = {nv:.4f}   하한 1/(α√n) = {low:.4f}   상한 1/α = {1 / ALPHA:.4f}')
print(f'허핀달 = α²||v||² = {herf:.4f}   유효 부문 수 = {1 / herf:.3f}')
print()
term, acc, parts = B5.copy(), B5.copy(), [B5.copy()]
for k in range(8):
    term = (1.0 - ALPHA) * (W.T @ term)       # k 바퀴째 전파 (1-α)^k (W')^k b
    acc = acc + term
    parts.append(acc.copy())
parts = np.array(parts)
err = np.abs(parts - v5).max(axis=1)
ratio = err[1:] / err[:-1]
print(f"{'K':>3}{'부분합 합':>12}{'최대 오차':>12}{'직전 대비':>11}")
for k in range(9):
    tail = '' if k == 0 else f'{ratio[k - 1]:11.4f}'
    print(f'{k:3d}{parts[k].sum():12.4f}{err[k]:12.4f}{tail}')
print(f'오차비 평균 {ratio.mean():.4f}   1-α = {1 - ALPHA:.4f}   최대 편차 {np.abs(ratio - 0.5).max():.4f}')
||v||_2 = 0.9172 하한 1/(α√n) = 0.8944 상한 1/α = 2.0000
허핀달 = α²||v||² = 0.2103 유효 부문 수 = 4.755
K 부분합 합 최대 오차 직전 대비
0 1.0000 0.3803
1 1.5000 0.1903 0.5004
2 1.7500 0.0953 0.5008
3 1.8750 0.0478 0.5011
4 1.9375 0.0239 0.5002
5 1.9688 0.0119 0.5001
6 1.9844 0.0060 0.5000
7 1.9922 0.0030 0.5000
8 1.9961 0.0015 0.5000
오차비 평균 0.5003 1-α = 0.5000 최대 편차 0.0011
# 부분합의 수렴과 영향력 벡터를 두 패널에 그린다
cols = ['#c0392b', '#3b6ea5', '#222222', '#3f8f5f', '#d98c3f']
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(9.6, 3.8))
ks = np.arange(parts.shape[0])
for i in range(N5):
    ax1.plot(ks, parts[:, i], marker='o', ms=3.5, color=cols[i], label=SECTORS[i])
    ax1.axhline(v5[i], ls=':', lw=1.0, color=cols[i])
ax1.set_xlabel('전파 회차 $K$')
ax1.set_ylabel(r'영향력 부분합 $v_i^{(K)}$')
ax1.set_xticks(ks)
ax1.legend(loc='lower right', fontsize=8, ncol=2)
ax1.set_title('(a) 노이만 부분합 — 점선은 정확한 $v$', fontsize=10, loc='left')
ax2.bar(SECTORS, v5, 0.6, color=['#c0392b'] + ['#3f8f5f'] * 4)
ax2.axhline(1.0 / (ALPHA * N5), ls='--', lw=1.2, color='k')
ax2.text(4.4, 1.0 / (ALPHA * N5) + 0.015, r'균등 $1/(\alpha n)=0.4$', ha='right', fontsize=9)
ax2.text(4.4, v5.max() * 0.97, f'합 = {v5.sum():.2f} = 1/α', ha='right', va='top', fontsize=10)
ax2.set_xlabel('부문')
ax2.set_ylabel(r'Domar 가중치 $v_i$')
ax2.set_ylim(0, v5.max() * 1.15)
ax2.set_title(f'(b) 영향력 벡터 — $\\|v\\|_2$ = {nv:.3f} > {low:.3f}', fontsize=10, loc='left')
plt.tight_layout()
plt.show()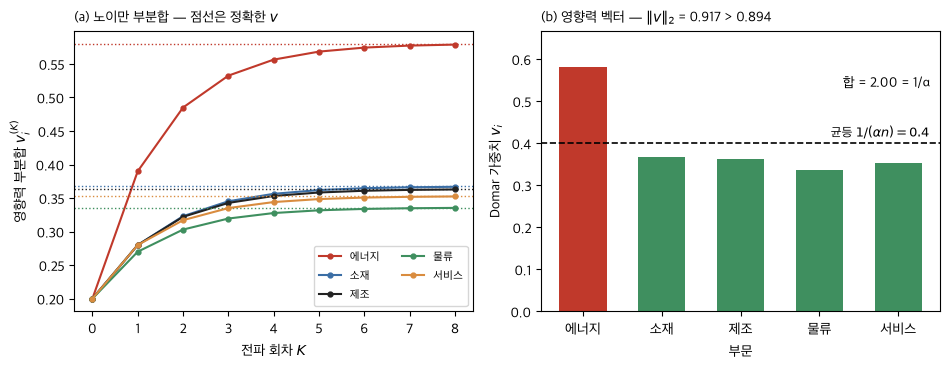
예측 2. 계수 1 족 의 닫힌형 (eq-w21-13)과 전체 로 푼 값을 먼저 맞춰 보고, 순위–규모 벡터 로 의 를 쌓는다. 같은 에서 네 벡터의 합은 모두 이므로 다른 것은 길이뿐이다((eq-w21-12)).
# 계수 1 족 W = 1π' 의 닫힌형과 전체 L 로 푼 값을 작은 n 에서 맞춰 본다
def rank_size_pi(n, zeta):
    S = np.arange(1, n + 1, dtype=float) ** (-1.0 / zeta)   # S_i = i^{-1/ζ}
    return S / S.sum()


def norm_v_closed(pi, alpha):
    c = (1.0 - alpha) / alpha                               # (eq-w21-13)
    return np.sqrt((1.0 + 2.0 * c) / pi.size + c ** 2 * np.sum(pi ** 2))


print(f"{'n':>5}{'π 종류':>10}{'닫힌형':>11}{'전체 L':>11}{'차':>11}")
for n in (5, 8, 20):
    for nm, pi in (('균등', np.full(n, 1.0 / n)), ('ζ=1.5', rank_size_pi(n, 1.5)),
                   ('별', np.eye(n)[0])):
        Wr = np.outer(np.ones(n), pi)                       # 모든 구매자가 같은 비율로 산다
        assert np.allclose(Wr.sum(axis=1), 1.0)
        v = influence(Wr, ALPHA, np.full(n, 1.0 / n))
        a, b = norm_v_closed(pi, ALPHA), np.linalg.norm(v)
        print(f'{n:5d}{nm:>10}{a:11.6f}{b:11.6f}{a - b:11.1e}')
n π 종류 닫힌형 전체 L 차
5 균등 0.894427 0.894427 0.0e+00
5 ζ=1.5 0.913394 0.913394 -2.2e-16
5 별 1.264911 1.264911 0.0e+00
8 균등 0.707107 0.707107 0.0e+00
8 ζ=1.5 0.729898 0.729898 0.0e+00
8 별 1.172604 1.172604 0.0e+00
20 균등 0.447214 0.447214 -1.1e-16
20 ζ=1.5 0.474779 0.474779 0.0e+00
20 별 1.072381 1.072381 0.0e+00
# 표 2 — n을 열 자리씩 키우며 네 구조의 ||v||_2 를 쌓는다
# 계수 1 족의 영향력 벡터 v = b + ((1-α)/α)π — (eq-w21-13) 의 벡터형 (b 균등)
def v_rank1(pi, alpha):
    return np.full(pi.size, 1.0 / pi.size) + (1.0 - alpha) / alpha * pi


ns2 = [10 ** k for k in range(2, 7)]
tab = {}
print(f"{'n':>8}{'균등':>10}{'ζ=1.5':>10}{'ζ=1.1':>10}{'별':>10}{'합 1′v':>10}")
for n in ns2:
    pis = [np.full(n, 1.0 / n), rank_size_pi(n, 1.5),
           rank_size_pi(n, 1.1), np.eye(1, n, 0)[0]]
    row = [norm_v_closed(pi, ALPHA) for pi in pis]
    sums = [v_rank1(pi, ALPHA).sum() for pi in pis]          # 네 벡터의 합을 실제로 잰다
    assert abs(row[0] - 1.0 / (ALPHA * np.sqrt(n))) < 1e-12  # 균등이면 정확히 1/(α√n)
    assert max(abs(s - 1.0 / ALPHA) for s in sums) < 1e-9    # 넷 다 1'v = 1/α (eq-w21-12)
    tab[n] = row
    print(f'{n:8d}' + ''.join(f'{x:10.4f}' for x in row) + f'{max(sums):10.4f}')
print()
lg = np.log(10.0 ** 3)
for j, nm in enumerate(['균등', 'ζ=1.5', 'ζ=1.1', '별']):
    fac = tab[10 ** 3][j] / tab[10 ** 6][j]
    print(f'{nm:>6}: 10^3 → 10^6 에서 {fac:8.2f} 분의 1  '
          f'(log-log 기울기 {-np.log(fac) / lg:+.3f})')
pn = {n: np.linalg.norm(rank_size_pi(n, 1.5)) for n in ns2}
print('ζ=1.5 의 n^{1/3}||π||_2 :', ' '.join(f'{n ** (1 / 3) * pn[n]:.3f}' for n in ns2))
print(f'||π||_2 만의 기울기 {-np.log(pn[10 ** 3] / pn[10 ** 6]) / lg:+.3f}   (극한 -1/3)')
n 균등 ζ=1.5 ζ=1.1 별 합 1′v
100 0.2000 0.2288 0.2758 1.0149 2.0000
1000 0.0632 0.0857 0.1444 1.0015 2.0000
10000 0.0200 0.0346 0.0925 1.0001 2.0000
100000 0.0063 0.0148 0.0654 1.0000 2.0000
 1000000    0.0020    0.0066    0.0483    1.0000    2.0000

    균등: 10^3 → 10^6 에서    31.62 분의 1  (log-log 기울기 -0.500)
 ζ=1.5: 10^3 → 10^6 에서    13.02 분의 1  (log-log 기울기 -0.372)
 ζ=1.1: 10^3 → 10^6 에서     2.99 분의 1  (log-log 기울기 -0.158)
     별: 10^3 → 10^6 에서     1.00 분의 1  (log-log 기울기 -0.000)
ζ=1.5 의 n^{1/3}||π||_2 : 0.694 0.659 0.645 0.638 0.635
||π||_2 만의 기울기 -0.339   (극한 -1/3)
# 같은 계산을 촘촘한 n 격자에서 되풀이해 log-log 에 찍는다
# (로그 축 눈금은 직접 붙인다 — 기본 서식의 유니코드 마이너스가 한국어 글꼴에 없다)
from matplotlib.ticker import FuncFormatter, NullFormatter


def log_ticks(ax, axes='xy'):
    for nm in axes:
        a = ax.xaxis if nm == 'x' else ax.yaxis
        a.set_major_formatter(FuncFormatter(lambda v, _: f'$10^{{{round(np.log10(v))}}}$'))
        a.set_minor_formatter(NullFormatter())


ns = np.unique(np.concatenate([10.0 ** np.arange(1, 7), 3 * 10.0 ** np.arange(1, 6)])).astype(int)
curves = {nm: [] for nm in ['균등', 'ζ=1.5', 'ζ=1.1', '별']}
for n in ns:
    curves['균등'].append(norm_v_closed(np.full(n, 1.0 / n), ALPHA))
    curves['ζ=1.5'].append(norm_v_closed(rank_size_pi(n, 1.5), ALPHA))
    curves['ζ=1.1'].append(norm_v_closed(rank_size_pi(n, 1.1), ALPHA))
    curves['별'].append(norm_v_closed(np.eye(1, n, 0)[0], ALPHA))
fig, ax = plt.subplots(figsize=(6.4, 4.2))
for nm, col in zip(curves, ['#3f8f5f', '#3b6ea5', '#d98c3f', '#c0392b']):
    ax.loglog(ns, curves[nm], marker='o', ms=3.5, color=col, label=nm)
ax.loglog([1e3, 1e6], 0.045 * np.array([1.0, 10.0 ** -1.5]), ls='--', lw=1.0, color='k')
ax.text(3e4, 0.0050, '기울기 $-1/2$', fontsize=9, ha='center', va='top')
ax.loglog([1e4, 1e6], 0.06 * np.array([1.0, 1e2 ** (-1 / 3)]), ls='--', lw=1.0, color='k')
ax.text(3e5, 0.028, '기울기 $-1/3$', fontsize=9, ha='center', va='bottom')
ax.set_xlabel('부문 수 $n$')
ax.set_ylabel(r'$\|v\|_2$ = 집계 변동성 / 개별 변동성')
log_ticks(ax)
ax.legend(loc='lower left', fontsize=9)
ax.set_title('같은 합, 다른 길이 — 구조가 감쇠율을 정한다', fontsize=10, loc='left')
plt.tight_layout()
plt.show()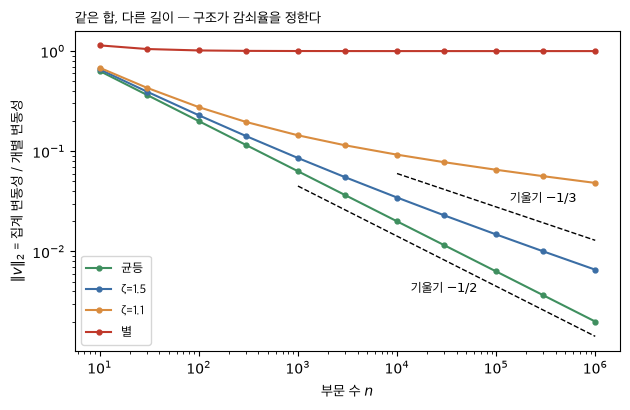
예측 3. iid Pareto를 역함수법 로 뽑아(, 시드 21, 300회) 의 중앙값과 10–90% 분위를 잰다. 척도는 에서 , 에서 이다((eq-w21-17)·(eq-w21-18)). 띠 폭은 분위비 90%/10%로 읽는다.
# iid Pareto 를 역함수법으로 뽑아 ||π||_2 의 중앙값과 10–90% 분위를 쌓는다
rng = np.random.default_rng(21)
REPS = 300
nsm = [10, 30, 100, 300, 1000, 3000, 10 ** 4, 3 * 10 ** 4, 10 ** 5]   # 본문 3절과 같은 격자
mc = {}
for zeta in (1.5, 3.0):
    med, q10, q90 = [], [], []
    for n in nsm:
        vals = np.empty(REPS)
        for r in range(REPS):
            S = rng.random(n) ** (-1.0 / zeta)          # S = U^{-1/ζ}, S_min = 1
            vals[r] = np.sqrt((S ** 2).sum()) / S.sum()
        med.append(np.median(vals))
        q10.append(np.quantile(vals, 0.10))
        q90.append(np.quantile(vals, 0.90))
    mc[zeta] = tuple(np.array(a) for a in (med, q10, q90))
for zeta in (1.5, 3.0):
    med, q10, q90 = mc[zeta]
    sc = np.array(nsm, dtype=float) ** (1.0 - 1.0 / zeta) if zeta < 2 else np.sqrt(nsm)
    lab = 'n^{1-1/ζ}' if zeta < 2 else '√n'
    print(f'--- ζ = {zeta}   척도 {lab} ---')
    print(f"{'n':>8}{'중앙값':>10}{'10%':>10}{'90%':>10}{'분위비':>10}")
    for i, n in enumerate(nsm):
        print(f'{n:8d}{sc[i] * med[i]:10.3f}{sc[i] * q10[i]:10.3f}'
              f'{sc[i] * q90[i]:10.3f}{q90[i] / q10[i]:10.2f}')
ZETA3 = 3.0
lim3 = (ZETA3 - 1.0) / np.sqrt(ZETA3 * (ZETA3 - 2.0))       # (eq-w21-18) 을 그대로 계산
print(f'ζ={ZETA3:g} 의 극한 (ζ-1)/√(ζ(ζ-2)) = {lim3:.4f}')
--- ζ = 1.5 척도 n^{1-1/ζ} ---
n 중앙값 10% 90% 분위비
10 0.824 0.718 1.142 1.59
30 0.785 0.648 1.322 2.04
100 0.790 0.615 1.474 2.40
300 0.765 0.579 1.629 2.81
1000 0.741 0.552 1.421 2.58
3000 0.742 0.554 1.593 2.88
10000 0.739 0.541 1.700 3.14
30000 0.720 0.537 1.486 2.77
100000 0.711 0.536 1.732 3.23
--- ζ = 3.0 척도 √n ---
n 중앙값 10% 90% 분위비
10 1.045 1.014 1.167 1.15
30 1.072 1.031 1.189 1.15
100 1.096 1.059 1.190 1.12
300 1.113 1.076 1.218 1.13
1000 1.128 1.095 1.196 1.09
3000 1.138 1.110 1.197 1.08
10000 1.142 1.122 1.174 1.05
30000 1.145 1.131 1.177 1.04
100000 1.148 1.138 1.168 1.03
ζ=3 의 극한 (ζ-1)/√(ζ(ζ-2)) = 1.1547
# 척도를 맞추기 전과 맞춘 뒤를 나란히 그린다 — 띠가 줄어드는가만 본다
# 기준선 lim3 은 앞 셀에서 (eq-w21-18) 로 계산한 값을 그대로 쓴다
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(9.6, 3.8))
for zeta, col in ((1.5, '#3b6ea5'), (3.0, '#222222')):
    med, q10, q90 = mc[zeta]
    ax1.loglog(nsm, med, color=col, marker='o', ms=3.5, label=f'ζ = {zeta}')
    ax1.fill_between(nsm, q10, q90, color=col, alpha=0.2, lw=0)
    sc = np.array(nsm, dtype=float) ** (1.0 - 1.0 / zeta) if zeta < 2 else np.sqrt(nsm)
    ax2.semilogx(nsm, sc * med, color=col, marker='o', ms=3.5, label=f'ζ = {zeta}')
    ax2.fill_between(nsm, sc * q10, sc * q90, color=col, alpha=0.2, lw=0)
ax1.loglog(nsm, lim3 * np.array(nsm, dtype=float) ** -0.5, ls='--', lw=1.2, color='#3f8f5f',
           label=rf'${lim3:.3f}\,n^{{-1/2}}$')
ax1.set_xlabel('부문 수 $n$')
ax1.set_ylabel(r'$\|\pi\|_2$')
log_ticks(ax1)
ax1.legend(loc='lower left', fontsize=9)
ax1.set_title('(a) 중앙값과 10–90% 띠', fontsize=10, loc='left')
ax2.axhline(lim3, ls='--', lw=1.2, color='#3f8f5f')
ax2.text(1.2e1, lim3 + 0.22, rf'$(\zeta-1)/\sqrt{{\zeta(\zeta-2)}}={lim3:.3f}$', fontsize=9)
ax2.set_xlabel('부문 수 $n$')
ax2.set_ylabel(r'$n^{1-1/\zeta}\|\pi\|_2$   ($\zeta=3$: $\sqrt{n}\,\|\pi\|_2$)')
ax2.set_ylim(0, 2.4)
log_ticks(ax2, 'x')
ax2.legend(loc='upper right', fontsize=9)
ax2.set_title('(b) 척도를 맞춘 뒤 — 조이는가', fontsize=10, loc='left')
plt.tight_layout()
plt.show()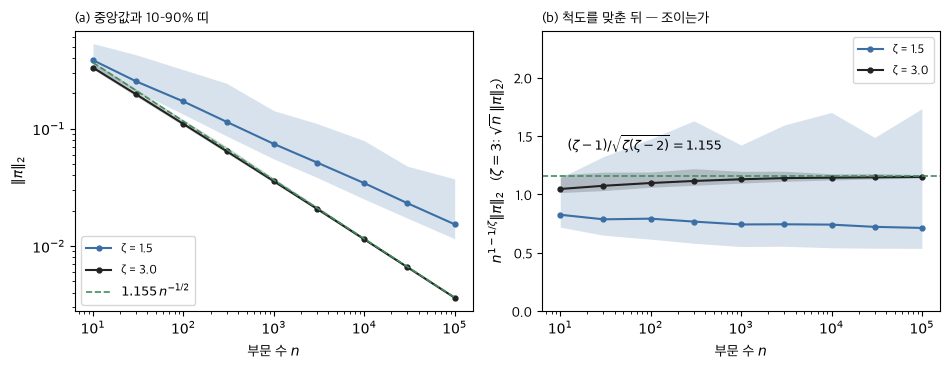
# 대조 표에 옮길 수치를 예측 항목 순서로 모은다
print(f'[예측 1] 최대 v_i = {SECTORS[int(np.argmax(v5))]} {v5.max():.4f} (열합 {d.max():.1f}), '
      f"합 1'v = {v5.sum():.4f} = 1/α, "
      f'||v||_2 = {nv:.4f} > {low:.4f} = 1/(α√n), '
      f'노이만 오차비 {ratio.min():.4f}–{ratio.max():.4f} (약 1-α = 0.5)')
r15 = tab[10 ** 3][1] / tab[10 ** 6][1]
r_un = tab[10 ** 3][0] / tab[10 ** 6][0]
print(f'[예측 2] ζ=1.5: {tab[10 ** 3][1]:.4f} → {tab[10 ** 6][1]:.4f} = {r15:.1f}분의 1 '
      f'(기울기 {-np.log(r15) / lg:+.3f}), '
      f'균등: {tab[10 ** 3][0]:.4f} → {tab[10 ** 6][0]:.4f} = {r_un:.1f}분의 1 '
      f'(기울기 {-np.log(r_un) / lg:+.3f})')
sel = [nsm.index(k) for k in (10 ** 2, 10 ** 3, 10 ** 4, 10 ** 5)]   # 본문 3절이 싣는 n
for zeta in (1.5, 3.0):
    med, q10, q90 = mc[zeta]
    sc = np.array(nsm, dtype=float) ** (1.0 - 1.0 / zeta) if zeta < 2 else np.sqrt(nsm)
    print(f'[예측 3] ζ={zeta} (n = 10^2, 10^3, 10^4, 10^5): '
          f'분위비 ' + ', '.join(f'{q90[i] / q10[i]:.2f}' for i in sel)
          + ', 척도 맞춘 중앙값 ' + ', '.join(f'{sc[i] * med[i]:.2f}' for i in sel)
          + (f' (극한 {lim3:.3f})' if zeta > 2 else ' (극한 상수 없음)'))
[예측 1] 최대 v_i = 에너지 0.5803 (열합 1.9), 합 1'v = 2.0000 = 1/α, ||v||_2 = 0.9172 > 0.8944 = 1/(α√n), 노이만 오차비 0.5000–0.5011 (약 1-α = 0.5)
[예측 2] ζ=1.5: 0.0857 → 0.0066 = 13.0분의 1 (기울기 -0.372), 균등: 0.0632 → 0.0020 = 31.6분의 1 (기울기 -0.500)
[예측 3] ζ=1.5 (n = 10^2, 10^3, 10^4, 10^5): 분위비 2.40, 2.58, 3.14, 3.23, 척도 맞춘 중앙값 0.79, 0.74, 0.74, 0.71 (극한 상수 없음)
[예측 3] ζ=3.0 (n = 10^2, 10^3, 10^4, 10^5): 분위비 1.12, 1.09, 1.05, 1.03, 척도 맞춘 중앙값 1.10, 1.13, 1.14, 1.15 (극한 1.155)
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w21-7)·(eq-w21-9)·(eq-w21-12)로, 2번은 (eq-w21-13)으로, 3번은 (eq-w21-15)·(eq-w21-17)·(eq-w21-18)로 돌아간다.