노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 칸을 먼저 채운다. 계산하지 않는다.
두 유형 모형()에서 로 늘릴 때 표본 평균 차이 는 34로 가는가 94로 가는가. 정규방정식으로 직접 푼 더미 회귀 기울기 은 와 모든 표본에서 정확히 같은가.
예측: ____
시뮬레이션의 잠재 을 신의 시점에서 써서 잰 는 34로 가는가. 으로 계산한 표본 Manski 경계의 폭은 에 따라 줄어드는가.
예측: ____
선형 IV , , , 2,000회 반복, 2단계 GMM. 바른 모형에서 인 비율과 의 평균은 얼마인가. 잘못된 모형(에 를 섞음)에서 그 비율은, 을 4배로 하면 평균은 몇 배가 되는가. 를 버려 로 하면 은 얼마인가.
예측: ____
2. 계산
패키지가 돌려주는 추정량은 답이 아니다. 잠재결과와 정규방정식과 모멘트를 직접 쌓는다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager

# 한국어 글꼴을 후보 목록에서 있는 것으로 고른다
_cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
_have = {f.name for f in font_manager.fontManager.ttflist}
for _f in _cands:
    if _f in _have:
        plt.rcParams['font.family'] = _f
        break
plt.rcParams['axes.unicode_minus'] = False

# 두 유형 직업훈련 모형의 잠재 임금(만원/월)과 선택 강도를 놓는다
y0H, y1H, y0L, y1L = 300.0, 330.0, 200.0, 250.0
s = 0.8
yL, yU = 150.0, 400.0
print('글꼴:', plt.rcParams['font.family'][0])
print(f'유형 H: (y0, y1) = ({y0H:.0f}, {y1H:.0f}),  유형 L: ({y0L:.0f}, {y1L:.0f}),  s = {s}')
글꼴: Apple SD Gothic Neo
유형 H: (y0, y1) = (300, 330), 유형 L: (200, 250), s = 0.8
모집단. 3절 수치 확인 1의 자리를 유형별 확률과 잠재 임금에서 직접 계산한다. 와 는 같은 모집단의 서로 다른 두 숫자다.
# 모집단의 칸 평균을 베이즈로 쌓는다 — 표본은 아직 없다
pi = 0.5 * s + 0.5 * (1.0 - s)              # Pr(D=1)
pH1 = 0.5 * s / pi                          # Pr(H | D=1)
pH0 = 0.5 * (1.0 - s) / (1.0 - pi)          # Pr(H | D=0)
mu11 = pH1 * y1H + (1 - pH1) * y1L          # E[Y1 | D=1] = E[Y | D=1]
mu01 = pH1 * y0H + (1 - pH1) * y0L          # E[Y0 | D=1] — 관측되지 않는다
mu00 = pH0 * y0H + (1 - pH0) * y0L          # E[Y0 | D=0] = E[Y | D=0]
mu10 = pH0 * y1H + (1 - pH0) * y1L          # E[Y1 | D=0] — 관측되지 않는다
Delta, tau_att, delta0 = mu11 - mu00, mu11 - mu01, mu01 - mu00
tau_ate = 0.5 * (y1H - y0H) + 0.5 * (y1L - y0L)
tau_atu, delta1 = mu10 - mu00, mu11 - mu10
lo_pop, hi_pop = mu11 - yU, mu11 - yL        # A2' 아래 식별집합
print(f'관측 칸  E[Y|D=1] = {mu11:.0f}   E[Y|D=0] = {mu00:.0f}   Δ = {Delta:.0f}')
print(f'잠재 칸  E[Y0|D=1] = {mu01:.0f}  E[Y1|D=0] = {mu10:.0f}')
print(f'분해     τ_ATT = {tau_att:.0f}  +  δ0 = {delta0:.0f}  =  {tau_att + delta0:.0f}')
print(f'이질성   τ_ATE = {tau_ate:.0f}  τ_ATU = {tau_atu:.0f}  δ1 = {delta1:.0f}   '
      f'τ_ATT - τ_ATE = {tau_att - tau_ate:.0f} = {(1 - pi) * (delta1 - delta0):.0f}')
print(f'사영 계수 Cov(Y,D) = {pi * (1 - pi) * Delta:.2f}  Var(D) = {pi * (1 - pi):.2f}  '
      f'β1 = {pi * (1 - pi) * Delta / (pi * (1 - pi)):.0f}')
print(f'식별집합 [{lo_pop:.0f}, {hi_pop:.0f}]  폭 {hi_pop - lo_pop:.0f}   '
      f'— 관측 차이 94는 효과 34의 {Delta / tau_att:.1f}배')
관측 칸 E[Y|D=1] = 314 E[Y|D=0] = 220 Δ = 94
잠재 칸 E[Y0|D=1] = 280 E[Y1|D=0] = 266
분해 τ_ATT = 34 + δ0 = 60 = 94
이질성 τ_ATE = 40 τ_ATU = 46 δ1 = 48 τ_ATT - τ_ATE = -6 = -6
사영 계수 Cov(Y,D) = 23.50 Var(D) = 0.25 β1 = 94
식별집합 [-86, 164] 폭 250 — 관측 차이 94는 효과 34의 2.8배
예측 1·2. A1을 그대로 쌓는다 — 유형을 반반 뽑고, 유형별 확률로 를 뽑고, 한 줄로 관측을 만든다. 은 의 정규방정식을 직접 풀고, 는 자료에 없는 을 신의 시점에서 쓴다.
# A1을 그대로 쌓는다 — 유형, 처치, 잠재결과, 그리고 관측되는 한 줄
rng = np.random.default_rng(22)
N = 100000
isH = rng.random(N) < 0.5
D = rng.random(N) < np.where(isH, s, 1.0 - s)
Y0 = np.where(isH, y0H, y0L)
Y1 = np.where(isH, y1H, y1L)
Y = np.where(D, Y1, Y0)                      # 관측은 이 한 줄뿐이다


def estimate(n):
    d, y = D[:n], Y[:n]
    m1, m0 = y[d].mean(), y[~d].mean()        # 두 집단 표본 평균
    X = np.column_stack([np.ones(n), d.astype(float)])
    b0, b1 = np.linalg.solve(X.T @ X, X.T @ y)   # 정규방정식 X'Xb = X'y
    att = (Y1[:n][d] - Y0[:n][d]).mean()      # 신의 시점 — 자료에는 없다
    return m1 - m0, b1, att, m1 - yU, m1 - yL


print(f'표본 안 처치 비율 π̂ = {D.mean():.4f}   H 비율 = {isH.mean():.4f}')
표본 안 처치 비율 π̂ = 0.5011 H 비율 = 0.5005
# 예측 1·2 — n을 10배씩 늘리며 Δ̂, β̂1, τ̂_ATT, 표본 Manski 경계를 쌓는다
print(f"{'n':>8}{'Δ̂':>11}{'β̂1':>11}{'|Δ̂-β̂1|':>12}{'τ̂_ATT':>11}"
      f"{'경계 하한':>12}{'경계 상한':>11}{'폭':>9}")
for n in [100, 1000, 10000, 100000]:
    dh, b1, att, lo, hi = estimate(n)
    print(f'{n:8d}{dh:11.5f}{b1:11.5f}{abs(dh - b1):12.2e}{att:11.5f}'
          f'{lo:12.3f}{hi:11.3f}{hi - lo:9.1f}')
print(f"{'모집단':>8}{Delta:11.5f}{Delta:11.5f}{0.0:12.2e}{tau_att:11.5f}"
      f'{lo_pop:12.3f}{hi_pop:11.3f}{hi_pop - lo_pop:9.1f}')
n Δ̂ β̂1 |Δ̂-β̂1| τ̂_ATT 경계 하한 경계 상한 폭
100 99.58651 99.58651 2.84e-14 33.82979 -85.319 164.681 250.0
1000 97.55587 97.55587 1.42e-14 33.23651 -82.946 167.054 250.0
10000 95.02551 95.02551 1.42e-14 33.93176 -85.727 164.273 250.0
100000 94.21932 94.21932 5.68e-14 33.97925 -85.917 164.083 250.0
모집단 94.00000 94.00000 0.00e+00 34.00000 -86.000 164.000 250.0
# 같은 표본의 앞부분만 잘라 쓰며 수렴 경로를 쌓는다
ns = np.unique(np.round(np.logspace(2, 5, 25)).astype(int))
res = np.array([estimate(int(n)) for n in ns])
gap = np.abs(res[:, 0] - res[:, 1]).max()
print(f'격자 {len(ns)}개 표본에서 최대 |Δ̂ - β̂1| = {gap:.2e}   '
      f'경계 폭의 최대 변동 = {np.ptp(res[:, 4] - res[:, 3]):.2e}')
fig, ax = plt.subplots(figsize=(7.0, 4.0))
ax.fill_between(ns, res[:, 3], res[:, 4], color='0.75', alpha=0.45,
                label='표본 Manski 경계 (폭 250)')
ax.plot(ns, res[:, 0], 'o-', ms=3, lw=1.2, color='k', label=r'$\hat\Delta$  관측 차이')
ax.plot(ns, res[:, 2], 'o-', ms=3, lw=1.2, color='#3b6ea5', label=r'$\hat\tau_{ATT}$  신의 시점')
ax.axhline(Delta, ls='--', lw=1.0, color='k')
ax.axhline(tau_att, ls='--', lw=1.0, color='#3b6ea5')
for v in (lo_pop, hi_pop):
    ax.axhline(v, ls=':', lw=1.0, color='0.4')
ax.text(1.2e5, Delta, ' 94', va='center', fontsize=9)
ax.text(1.2e5, tau_att, ' 34', va='center', fontsize=9, color='#3b6ea5')
ax.text(1.2e5, hi_pop, ' 164', va='center', fontsize=9, color='0.4')
ax.text(1.2e5, lo_pop, ' -86', va='center', fontsize=9, color='0.4')
ax.set_xscale('log')
ax.set_xlim(90, 1.9e5)
ax.set_xlabel('표본 크기 $n$')
ax.set_ylabel('임금 차이(만원/월)')
ax.set_title('표본은 94와 34를 모두 맞히지만, 자료만으로 허용되는 띠는 좁아지지 않는다')
ax.legend(loc='lower left', fontsize=8, framealpha=0.92)
plt.tight_layout()
plt.show()
격자 25개 표본에서 최대 |Δ̂ - β̂1| = 1.28e-13 경계 폭의 최대 변동 = 0.00e+00
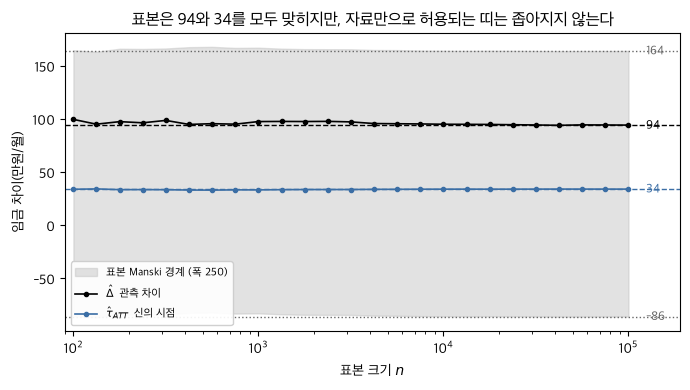
예측 3. 를 표준정규로 뽑아 , 로 두고, 1단계 ·2단계 의 GMM과 을 식 그대로 만든다.
# 선형 IV 자료와 2×2 가중행렬 대수를 직접 쌓는다
def draw(n, reps, wrong, rng):
    z1, z2 = rng.standard_normal((reps, n)), rng.standard_normal((reps, n))
    v, e = rng.standard_normal((reps, n)), rng.standard_normal((reps, n))
    x = z1 + 0.5 * z2 + v
    u = 0.5 * v + e + (0.3 * z2 if wrong else 0.0)   # 틀린 모형은 도구를 잔차에 섞는다
    return z1, z2, x, 1.5 * x + u


def Shat(z1, z2, x, y, th):                   # Ŝ = (1/n)Σ g_i g_i',  g_i = z_i(y_i - x_i θ)
    r = y - x * th[:, None]
    return np.mean((r * z1) ** 2, 1), np.mean(r * r * z1 * z2, 1), np.mean((r * z2) ** 2, 1)


def inv2(S):                                  # 2×2 역행렬을 손으로
    s11, s12, s22 = S
    det = s11 * s22 - s12 ** 2
    return s22 / det, -s12 / det, s11 / det


def quad(u, W, v):                            # u'Wv
    w11, w12, w22 = W
    return u[:, 0] * (w11 * v[:, 0] + w12 * v[:, 1]) + u[:, 1] * (w12 * v[:, 0] + w22 * v[:, 1])


a_pop = np.array([1.0, 0.5])                  # E[zx] = (1, 0.5)
b_pop = np.array([1.5, 1.05])                 # 틀린 모형의 E[zy]
print(f'틀린 모형의 두 비 = {b_pop[0] / a_pop[0]:.2f}, {b_pop[1] / a_pop[1]:.2f}   '
      f'W=I 유사참값 = {a_pop @ b_pop / (a_pop @ a_pop):.2f}')
틀린 모형의 두 비 = 1.50, 2.10 W=I 유사참값 = 1.62
# 1단계 W=I, 2단계 W=Ŝ^{-1}로 θ̂와 J_n을 식 그대로 만든다
def gmm(n, reps, wrong, seed):
    rng = np.random.default_rng(seed)
    z1, z2, x, y = draw(n, reps, wrong, rng)
    a = np.stack([np.mean(z1 * x, 1), np.mean(z2 * x, 1)], 1)   # a_n
    b = np.stack([np.mean(z1 * y, 1), np.mean(z2 * y, 1)], 1)   # b_n
    th1 = np.sum(a * b, 1) / np.sum(a * a, 1)                   # 1단계 W=I
    W = inv2(Shat(z1, z2, x, y, th1))
    th2 = quad(a, W, b) / quad(a, W, a)                         # 2단계 W=Ŝ^{-1}
    Wh = inv2(Shat(z1, z2, x, y, th2))                          # θ̂에서 Ŝ 재계산
    g = b - a * th2[:, None]                                    # ḡ_n(θ̂)
    th_j = b[:, 0] / a[:, 0]                                    # z2를 버려 q = p = 1
    g_j = b[:, 0] - a[:, 0] * th_j
    return th2, n * quad(g, Wh, g), th_j, n * g_j ** 2 / Shat(z1, z2, x, y, th_j)[0]


REPS = 2000
th_ok, J_ok, th_j, J_j = gmm(500, REPS, False, 22)
print(f'바른 모형 n=500 : θ̂ 평균 {th_ok.mean():.4f} (참값 1.5)   J̄ = {J_ok.mean():.3f}   '
      f'기각률 Pr(J>3.84) = {(J_ok > 3.84).mean():.3f}')
print(f'q=p=1 (z2 버림) : θ̂ 평균 {th_j.mean():.4f}   |J|의 최댓값 = {np.abs(J_j).max():.2e}   '
      f'— M_G = 0이므로 잔차가 없다')
바른 모형 n=500 : θ̂ 평균 1.4988 (참값 1.5) J̄ = 1.008 기각률 Pr(J>3.84) = 0.052
q=p=1 (z2 버림) : θ̂ 평균 1.4979 |J|의 최댓값 = 2.61e-29 — M_G = 0이므로 잔차가 없다
# 틀린 모형과 n 4배를 같은 계산으로 쌓는다
th_w5, J_w5, _, _ = gmm(500, REPS, True, 23)
th_w20, J_w20, _, _ = gmm(2000, REPS, True, 24)
th_o20, J_o20, _, _ = gmm(2000, REPS, False, 25)
rows = [('바른', 500, th_ok, J_ok), ('바른', 2000, th_o20, J_o20),
        ('틀린', 500, th_w5, J_w5), ('틀린', 2000, th_w20, J_w20)]
print(f"{'모형':>5}{'n':>7}{'θ̂ 평균':>11}{'J̄':>11}{'J 중앙값':>11}{'기각률':>10}")
for nm, n, th, J in rows:
    print(f'{nm:>5}{n:7d}{th.mean():11.4f}{J.mean():11.3f}{np.median(J):11.3f}'
          f'{(J > 3.84).mean():10.3f}')
print(f'\nJ̄ 비율  바른 {J_o20.mean() / J_ok.mean():.2f}배   '
      f'틀린 {J_w20.mean() / J_w5.mean():.2f}배  (n을 4배로 했다)')
모형 n θ̂ 평균 J̄ J 중앙값 기각률
바른 500 1.4988 1.008 0.468 0.052
바른 2000 1.5007 0.993 0.452 0.048
틀린 500 1.6194 27.326 26.904 1.000
틀린 2000 1.6197 105.842 105.149 1.000
J̄ 비율 바른 0.99배 틀린 3.87배 (n을 4배로 했다)
# 바른 모형의 J 분포를 χ²_1 밀도와 겹쳐 그린다 — 밀도는 식으로 직접 만든다
xg = np.linspace(0.02, 10.0, 400)
chi1 = np.exp(-xg / 2.0) / np.sqrt(2.0 * np.pi * xg)
fig, ax = plt.subplots(1, 2, figsize=(10.0, 3.8))
ax[0].hist(J_ok, bins=np.linspace(0, 10, 41), density=True, color='#3b6ea5', alpha=0.7,
           label=f'$J_n$ 시뮬레이션 (n=500, {REPS}회)')
ax[0].plot(xg, chi1, color='k', lw=1.5, label=r'$\chi^2_1$ 밀도')
ax[0].axvline(3.84, ls='--', lw=1.0, color='#c0392b')
ax[0].text(3.95, 0.45, f'3.84\n기각률 {(J_ok > 3.84).mean():.3f}', fontsize=8, color='#c0392b')
ax[0].set_xlabel('$J_n$')
ax[0].set_ylabel('밀도')
ax[0].set_title(f'(a) 바른 모형 — 평균 {J_ok.mean():.2f}, 남는 개수 q-p = 1')
ax[0].legend(fontsize=8)
lab = [f'{nm}\nn={n}' for nm, n, _, _ in rows]
val = [J.mean() for _, _, _, J in rows]
ax[1].bar(np.arange(4), val, 0.55, color=['#3b6ea5', '#3b6ea5', '#c0392b', '#c0392b'])
for i, v in enumerate(val):
    ax[1].text(i, v * 1.25, f'{v:.2f}', ha='center', fontsize=9)
ax[1].axhline(1.0, ls='--', lw=1.0, color='k')
ax[1].set_yscale('log')
ax[1].set_ylim(0.5, 420)
ax[1].set_xticks(np.arange(4))
ax[1].set_xticklabels(lab, fontsize=9)
ax[1].set_ylabel('$J_n$의 평균 (로그 축)')
ax[1].set_title('(b) 바른 모형은 n에 무관, 틀린 모형은 n에 비례')
plt.tight_layout()
plt.show()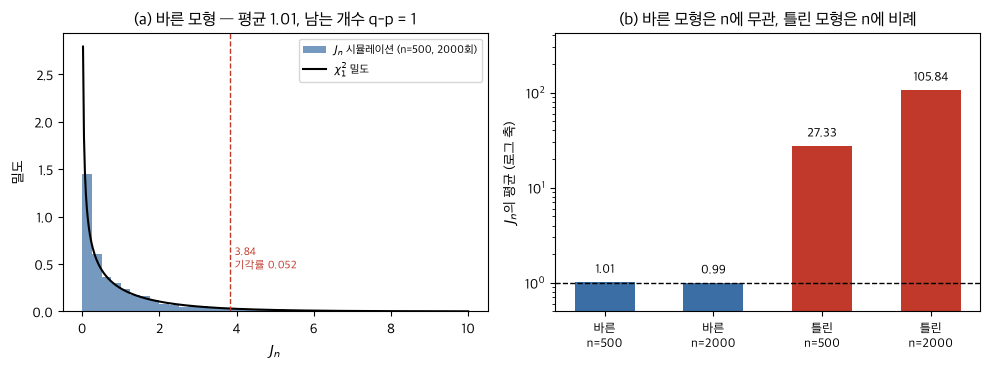
# 예측 항목 세 개에 대응하는 수치를 한자리에 모은다
d100, b100, a100, _, _ = estimate(100)
d5, b5, a5, lo5, hi5 = estimate(100000)
print(f'[예측 1] Δ̂: n=100에서 {d100:.3f} → n=1e5에서 {d5:.3f}   모집단 Δ = {Delta:.0f} '
      f'(34가 아니다).  최대 |Δ̂-β̂1| = {gap:.2e} — 대수 항등식, 남는 것은 부동소수 오차뿐')
print(f'[예측 2] τ̂_ATT: n=100에서 {a100:.3f} → n=1e5에서 {a5:.3f}   모집단 τ_ATT = {tau_att:.0f}.  '
      f'경계 [{lo5:.2f}, {hi5:.2f}], 폭 {hi5 - lo5:.1f} — 모집단 [{lo_pop:.0f}, {hi_pop:.0f}]')
print(f'[예측 3] 바른 모형 n=500: 기각률 {(J_ok > 3.84).mean():.3f}, J̄ = {J_ok.mean():.3f} '
      f'(q-p = 1).  틀린 모형 n=500: 기각률 {(J_w5 > 3.84).mean():.3f}, J̄ = {J_w5.mean():.2f} '
      f'→ n=2000에서 {J_w20.mean():.2f} ({J_w20.mean() / J_w5.mean():.2f}배).  '
      f'q=p=1: |J|의 최댓값 {np.abs(J_j).max():.2e}')
[예측 1] Δ̂: n=100에서 99.587 → n=1e5에서 94.219 모집단 Δ = 94 (34가 아니다). 최대 |Δ̂-β̂1| = 1.28e-13 — 대수 항등식, 남는 것은 부동소수 오차뿐
[예측 2] τ̂_ATT: n=100에서 33.830 → n=1e5에서 33.979 모집단 τ_ATT = 34. 경계 [-85.92, 164.08], 폭 250.0 — 모집단 [-86, 164]
[예측 3] 바른 모형 n=500: 기각률 0.052, J̄ = 1.008 (q-p = 1). 틀린 모형 n=500: 기각률 1.000, J̄ = 27.33 → n=2000에서 105.84 (3.87배). q=p=1: |J|의 최댓값 2.61e-29
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w22-5)·(eq-w22-7)로, 2번은 (eq-w22-9)로, 3번은 (eq-w22-15)로 돌아간다.