노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
코드를 쓰기 전에 아래 셋에 답한다. 계산하지 않는다.
1. 정상 형태. 규모 1 기업의 비율은 에 안쪽(표본 표준편차 ). 규모 2는 0.165–0.175. 평균 규모 은 에 — 항등식이다.
예측: ____
2. 꼬리 기울기. 표본 생존함수의 구간 로그-로그 기울기는 -1.05에서 -1.15 사이(정확 정상해는 -1.08, 점근 -1.11). 부터 잡으면 더 얕아진다((eq-w20-8)의 보정). 상위 1,000개의 순위–규모 기울기는 와 -1.0 사이 — 유한 절단이 큰 쪽을 깎는다. 최대 기업의 비중은 15–40%(시드 종속, 근처).
예측: ____
3. 과도기. 결정론적 (eq-w20-5)의 는 로그-로그 기울기 . 몬테카를로의 요동은 로만 줄어 과도기를 덮는다 — 표본에서는 보이지 않는다.
예측: ____
2. 계산
패키지가 돌려주는 분포는 답이 아니다. 단위 하나씩 쌓는 이산 과정, (eq-w20-6)의 점화, (eq-w20-5)의 오일러 적분, 정규방정식 하나를 직접 세운다.
# 도구를 올린다 — 값은 아래 셀들에서 직접 쌓는다.
import numpy as np
import matplotlib.pyplot as plt
from math import lgamma
from matplotlib import font_manager
from matplotlib.ticker import FixedLocator, FuncFormatter, NullFormatter

# 한국어 글꼴을 고른다.
CANDIDATES = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic',
              'Noto Sans CJK KR', 'Malgun Gothic']
installed = {f.name for f in font_manager.fontManager.ttflist}
for name in CANDIDATES:
    if name in installed:
        plt.rcParams['font.family'] = name
        break
plt.rcParams['axes.unicode_minus'] = False

# 로그축 눈금을 직접 만든다 — \mathdefault 의 유니코드 빼기표가 한국어 글꼴에 없다.
def log_ticks(ax, axis, exps):
    a = ax.xaxis if axis == 'x' else ax.yaxis
    a.set_major_locator(FixedLocator([10.0 ** e for e in exps]))
    a.set_major_formatter(FuncFormatter(
        lambda v, _: f'{v:g}' if 0 <= round(np.log10(v)) <= 2 else f'$10^{{{round(np.log10(v))}}}$'))
    a.set_minor_formatter(NullFormatter())

# 본문과 같은 파라미터를 둔다. (eq-w20-9): ζ = 1/(1-p), γ = 1+ζ
P = 0.1
ZETA = 1.0 / (1.0 - P)
GAMMA = 1.0 + ZETA
T_UNITS = 500_000
BLUE, RED, GREY = '#3b6ea5', '#c0392b', '#888888'
print('글꼴:', plt.rcParams['font.family'])
print(f'p = {P}   1-p = {1 - P:.1f}   ζ = {ZETA:.4f}   γ = {GAMMA:.4f}')
print(f'f_1* = 1/(2-p) = {1 / (2 - P):.4f}   평균 규모 1/p = {1 / P:.1f}')
글꼴: ['Apple SD Gothic Neo']
p = 0.1 1-p = 0.9 ζ = 1.1111 γ = 2.1111
f_1* = 1/(2-p) = 0.5263 평균 규모 1/p = 10.0
기준선. 먼저 (eq-w20-6)의 점화 로 정확한 정상 분포와 (eq-w20-10)의 생존함수 를 쌓는다. 표본은 이 선과 겨룬다.
# (eq-w20-6)의 점화로 정확한 정상 분포를 쌓는다: f_1 = 1/(2-p), f_k = f_{k-1}(k-1)/(k+ζ)
KMAX = 400_000
f = np.zeros(KMAX + 1)                 # f[k] = f_k, f[0] 은 쓰지 않는다 (N_0 ≡ 0)
f[1] = 1.0 / (2.0 - P)
for k in range(2, KMAX + 1):
    f[k] = f[k - 1] * (k - 1.0) / (k + ZETA)
ks_all = np.arange(KMAX + 1)
S_exact = ks_all * f / ZETA            # (eq-w20-10) S*(k) = k f_k / ζ


# 로그-로그 최소제곱 기울기를 정규방정식으로 직접 푼다.
def loglog_slope(x, y):
    lx, ly = np.log(np.asarray(x, float)), np.log(np.asarray(y, float))
    return float(np.sum((lx - lx.mean()) * (ly - ly.mean())) / np.sum((lx - lx.mean()) ** 2))


def slope_exact(lo, hi):
    kk = np.arange(lo, hi + 1)
    return loglog_slope(kk, S_exact[kk])


EX_5_200, EX_1_200 = slope_exact(5, 200), slope_exact(1, 200)
print(f'정확 f_1 = {f[1]:.4f}   f_2 = {f[2]:.4f}   f_5 = {f[5]:.5f}   Σf_k = {f.sum():.6f}')
print(f'정확 S*(1) = {S_exact[1]:.4f}   S*(10) = {S_exact[10]:.4f}   S*(100) = {S_exact[100]:.5f}')
print(f'정확 기울기 [5,200] = {EX_5_200:.4f}   [1,200] = {EX_1_200:.4f}   점근 -ζ = {-ZETA:.4f}')
정확 f_1 = 0.5263 f_2 = 0.1692 f_5 = 0.03162 Σf_k = 0.999999
정확 S*(1) = 0.4737 S*(10) = 0.0729 S*(100) = 0.00623
정확 기울기 [5,200] = -1.0792 [1,200] = -1.0515 점근 -ζ = -1.1111
예측 1·2. (eq-w20-12)의 이산 Simon 과정을 단위 하나씩 쌓는다. , 단위, 에 규모 1 기업 하나. 규모 비례 선택은 단위 하나를 균등하게 골라 그 소유 기업에 붙이는 것으로 구현한다(가중 추출 함수 금지).
# 이산 Simon 과정을 단위 하나씩 쌓는다 (eq-w20-12). 소유자 배열만으로 규모 비례 선택을 만든다.
CHECKS = [int(v) for v in np.unique(np.round(np.logspace(1, np.log10(T_UNITS), 40)))]


def simon(seed, T=T_UNITS, p=P, checks=CHECKS):
    rng = np.random.default_rng(seed)
    owner = np.zeros(T, dtype=np.int64)        # 단위 j 를 가진 기업 번호
    size = np.zeros(T, dtype=np.int64)         # 기업 i 의 규모
    r_new, r_pick = rng.random(T), rng.random(T)
    size[0], owner[0] = 1, 0
    nfirm, U, n1 = 1, 1, 1                     # 기업 수 · 단위 수 · 규모 1 기업 수
    traj, ci = [], 0
    for step in range(1, T):
        if r_new[step] < p:                    # 신생 기업이 규모 1로 들어온다
            size[nfirm] = 1
            owner[U] = nfirm
            nfirm += 1
            n1 += 1
        else:                                  # 단위 하나를 균등하게 골라 그 소유 기업에 붙인다
            i = owner[int(r_pick[step] * U)]
            if size[i] == 1:
                n1 -= 1
            size[i] += 1
            owner[U] = i
        U += 1
        if ci < len(checks) and U == checks[ci]:
            traj.append((U, n1 / nfirm))       # 규모 1 기업의 몫을 시간에 따라 기록한다
            ci += 1
    return size[:nfirm], U, np.array(traj)


sz0, U0, traj0 = simon(0)
print(f'시드 0 — 단위 U = {U0:,}   기업 N = {len(sz0):,}   최대 규모 = {sz0.max():,}')
시드 0 — 단위 U = 500,000 기업 N = 50,129 최대 규모 = 83,078
# 예측 1 — 규모 1·2의 몫과 평균 규모를 도수에서 직접 센다.
N0 = len(sz0)
f1_s = float(np.mean(sz0 == 1))
f2_s = float(np.mean(sz0 == 2))
mean_s = U0 / N0
sd1 = np.sqrt(f[1] * (1 - f[1]) / N0)
print(f"{'양':>10}{'표본':>12}{'정확':>12}{'어긋남':>12}")
print(f"{'f_1':>10}{f1_s:12.4f}{f[1]:12.4f}{f1_s - f[1]:+12.4f}")
print(f"{'f_2':>10}{f2_s:12.4f}{f[2]:12.4f}{f2_s - f[2]:+12.4f}")
print(f"{'U/N':>10}{mean_s:12.3f}{1 / P:12.3f}{mean_s - 1 / P:+12.3f}")
print(f'표본 표준편차 √(f_1(1-f_1)/N) = {sd1:.4f}   |f_1 어긋남| = {abs(f1_s - f[1]) / sd1:.2f} sd')
print(f'평균의 상대 어긋남 = {100 * (mean_s - 1 / P) / (1 / P):+.2f}%'
      '   — (eq-w20-4)의 항등식 N=ηt, U=(a+η)t')

# 같은 평균을 부분합으로 세면 훨씬 느리게 붙는다 ((eq-w20-16)의 꼬리 질량).
for K in [10 ** 2, 10 ** 3, 10 ** 4, 10 ** 5]:
    kk = np.arange(1, K + 1)
    print(f'  Σ(k≤{K:>6}) k f_k = {float((kk * f[1:K + 1]).sum()):6.3f}   (극한 {1 / P:.1f})')
양 표본 정확 어긋남
f_1 0.5251 0.5263 -0.0012
f_2 0.1704 0.1692 +0.0013
U/N 9.974 10.000 -0.026
표본 표준편차 √(f_1(1-f_1)/N) = 0.0022 |f_1 어긋남| = 0.55 sd
평균의 상대 어긋남 = -0.26% — (eq-w20-4)의 항등식 N=ηt, U=(a+η)t
Σ(k≤ 100) k f_k = 3.703 (극한 10.0)
Σ(k≤ 1000) k f_k = 5.117 (극한 10.0)
Σ(k≤ 10000) k f_k = 6.219 (극한 10.0)
Σ(k≤100000) k f_k = 7.072 (극한 10.0)
# 예측 2 — 표본 생존함수를 도수에서 쌓고 구간별 로그-로그 기울기를 잰다.
kmax_obs = int(sz0.max())
counts = np.bincount(sz0, minlength=kmax_obs + 1)[1:]     # counts[i] = 규모 i+1 인 기업 수
ks_obs = np.arange(1, kmax_obs + 1)
ccdf = 1.0 - np.cumsum(counts) / N0                        # Pr(K > k)


def band(lo, hi):
    m = (ks_obs >= lo) & (ks_obs <= hi) & (ccdf > 0)
    return loglog_slope(ks_obs[m], ccdf[m])


print(f"{'구간':>12}{'표본':>10}{'정확 S*':>10}")
print(f"{'[5, 200]':>12}{band(5, 200):10.4f}{EX_5_200:10.4f}")
print(f"{'[1, 200]':>12}{band(1, 200):10.4f}{EX_1_200:10.4f}")
print(f"{'[30, 1000]':>12}{band(30, 1000):10.4f}{slope_exact(30, 1000):10.4f}")
print(f'점근 -ζ = {-ZETA:.4f}')

# 순위-규모: 상위 1,000개 기업의 log(규모) 대 log(순위)
top = np.sort(sz0)[::-1][:1000].astype(float)
rank_slope = loglog_slope(np.arange(1, 1001), top)
print(f'순위-규모 기울기(상위 1,000) = {rank_slope:.4f}   (-1/ζ = {-1 / ZETA:.4f})')
print(f'최대 기업 규모 = {kmax_obs:,}   전체 단위 대비 비중 = {100 * kmax_obs / U0:.1f}%'
      f'   (t^(-p) = {100 * U0 ** (-P):.1f}%)')
구간 표본 정확 S*
[5, 200] -1.0588 -1.0792
[1, 200] -1.0349 -1.0515
[30, 1000] -1.0859 -1.1051
점근 -ζ = -1.1111
순위-규모 기울기(상위 1,000) = -0.9921 (-1/ζ = -0.9000)
최대 기업 규모 = 83,078 전체 단위 대비 비중 = 16.6% (t^(-p) = 26.9%)
# 표본 생존함수를 정확 S*(k)·점근과 한 그림에 겹친다.
obs = np.flatnonzero((counts > 0) & (ccdf > 0))
k_o, c_o = ks_obs[obs], ccdf[obs]
if len(k_o) > 400:                                   # 작은 k 가 촘촘하므로 로그 간격으로 솎는다
    pick = np.unique(np.round(np.logspace(0, np.log10(len(k_o) - 1), 400)).astype(int))
    k_o, c_o = k_o[pick], c_o[pick]
kg = np.unique(np.round(np.logspace(0, np.log10(kmax_obs), 300)).astype(int))

fig, ax = plt.subplots(figsize=(6.2, 4.1))
ax.loglog(k_o, c_o, '.', ms=3.5, color='k', alpha=0.8, label='표본 ($T=5\\times10^5$)')
ax.loglog(kg, S_exact[kg], color=RED, lw=1.5, label='정확 $S^{*}(k)=k\\,f_k/\\zeta$')
ax.loglog(kg, np.exp(lgamma(1 + ZETA)) * kg ** (-ZETA), ls=':', color=GREY, lw=1.3,
          label='점근 $\\Gamma(1+\\zeta)\\,k^{-\\zeta}$')
ax.axvspan(5, 200, color=BLUE, alpha=0.10)
ax.text(5.6, 0.75, '기울기를 잰 구간 [5, 200]', color=BLUE, fontsize=8)
ax.set_xlabel('규모 $k$ (로그)')
ax.set_ylabel('$\\Pr(K>k)$ (로그)')
ax.set_ylim(1e-6, 2)
log_ticks(ax, 'x', [0, 1, 2, 3, 4, 5])
log_ticks(ax, 'y', [-6, -5, -4, -3, -2, -1, 0])
ax.set_title(f'표본 생존함수와 정상해 — 표본 기울기 {band(5, 200):.3f}, 정확 {EX_5_200:.3f}',
             fontsize=10)
ax.legend(fontsize=8, loc='lower left')
fig.tight_layout()
plt.show()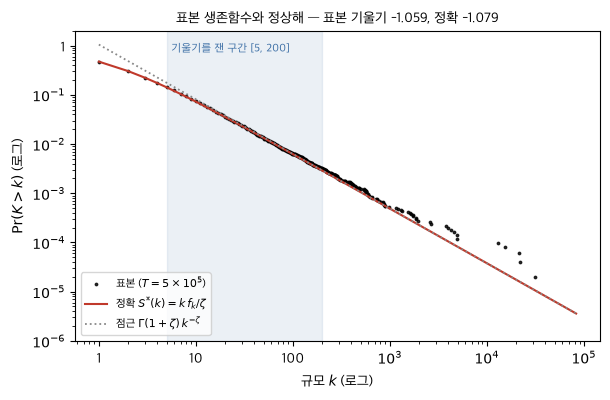
예측 3. (eq-w20-5)를 로그시간 오일러(, )로 적분해 의 로그-로그 기울기를 재고, 같은 양을 몬테카를로에서 잰다. 로 두면 이므로 두 세계의 눈금이 같아진다.
# 예측 3 — (eq-w20-5)를 로그시간 오일러로 적분한다. η=1 이면 n_k^* = f_k 다.
KCUT, DS, SMAX = 400, 1e-3, float(np.log(T_UNITS))
karr = np.arange(KCUT + 1, dtype=float)


def euler(k0):
    n = np.zeros(KCUT + 1)
    n[k0] = 1.0                                          # t=1 에 모든 질량을 k0 에 둔다
    nstep = int(round(SMAX / DS))
    ts, dev = np.empty(nstep + 1), np.empty(nstep + 1)
    for i in range(nstep + 1):
        ts[i] = np.exp(i * DS)
        dev[i] = abs(n[1] - f[1])
        dn = -(1.0 + (1.0 - P) * karr) * n               # 유출 + 형태 변환항
        dn[1:] += (1.0 - P) * karr[:-1] * n[:-1]         # k-1 에서 올라오는 유입
        dn[1] += 1.0                                     # 진입항 η=1
        n += DS * dn
        n[0] = 0.0
    return ts, dev


ts3, dev3 = euler(3)
ts1, dev1 = euler(1)                                     # 몬테카를로와 같은 출발
for tq in [10.0, 1e2, 1e3, 1e4]:
    j = int(np.argmin(np.abs(ts3 - tq)))
    print(f'  t = {ts3[j]:8.1f}   |n_1-n_1*| = {dev3[j]:.3e} (출발 k=3)'
          f'   {dev1[int(np.argmin(np.abs(ts1 - tq)))]:.3e} (출발 k=1)')
m = ts3 >= 10.0
print(f'로그-로그 기울기 [10, {T_UNITS:,.0f}] = {loglog_slope(ts3[m], dev3[m]):.4f}'
      f' · {loglog_slope(ts1[m], dev1[m]):.4f}   (-(2-p) = {-(2 - P):.4f})')
t = 10.0 |n_1-n_1*| = 6.593e-03 (출발 k=3) 5.934e-03 (출발 k=1)
t = 100.0 |n_1-n_1*| = 8.275e-05 (출발 k=3) 7.448e-05 (출발 k=1)
t = 1000.2 |n_1-n_1*| = 1.037e-06 (출발 k=3) 9.330e-07 (출발 k=1)
t = 9996.6 |n_1-n_1*| = 1.301e-08 (출발 k=3) 1.171e-08 (출발 k=1)
로그-로그 기울기 [10, 500,000] = -1.9018 · -1.9018 (-(2-p) = -1.9000)
# 예측 3 — 같은 양을 몬테카를로에서 잰다. 시드 여섯의 |f_1(t) - f_1^*| 를 쌓는다.
trajs = [traj0] + [simon(s)[2] for s in (1, 2, 3, 4, 5)]
tgrid = trajs[0][:, 0]
devs = np.array([np.abs(tr[:, 1] - f[1]) for tr in trajs])     # (시드, 시각)
rms = np.sqrt((devs ** 2).mean(axis=0))                        # 시드에 걸친 요동 크기
print(f"{'t':>9}{'결정론':>11}{'시드 0':>9}{'시드 1':>9}{'시드 2':>9}{'RMS(6)':>10}{'√(f(1-f)/pt)':>15}")
for tq in [1e2, 1e3, 1e4, 1e5, 5e5]:
    j = int(np.argmin(np.abs(tgrid - tq)))
    det = dev1[int(np.argmin(np.abs(ts1 - tgrid[j])))]
    print(f'{tgrid[j]:9.0f}{det:11.2e}' + ''.join(f'{devs[i, j]:9.4f}' for i in (0, 1, 2))
          + f'{rms[j]:10.4f}{np.sqrt(f[1] * (1 - f[1]) / (P * tgrid[j])):15.4f}')

mm = tgrid >= 100.0
MC_SLOPE = loglog_slope(tgrid[mm], rms[mm])
DET_SLOPE = loglog_slope(ts1[m], dev1[m])
print(f'요동 RMS의 로그-로그 기울기 = {MC_SLOPE:.3f} (-1/2 = -0.500)   '
      f'결정론 과도기 = {DET_SLOPE:.3f} (-(2-p) = {-(2 - P):.3f})')
print(f't = {T_UNITS:,}에서 결정론 {dev1[-1]:.1e} 대 요동 {rms[-1]:.4f}'
      f' — 요동이 과도기의 {rms[-1] / dev1[-1]:.0e}배다.')
t 결정론 시드 0 시드 1 시드 2 RMS(6) √(f(1-f)/pt)
92 8.72e-05 0.4263 0.0987 0.0737 0.2172 0.1646
1118 7.55e-07 0.0596 0.0718 0.0481 0.0549 0.0472
10284 1.11e-08 0.0006 0.0021 0.0528 0.0246 0.0156
94635 1.63e-10 0.0024 0.0029 0.0008 0.0060 0.0051
500000 6.88e-12 0.0012 0.0000 0.0037 0.0018 0.0022
요동 RMS의 로그-로그 기울기 = -0.521 (-1/2 = -0.500) 결정론 과도기 = -1.902 (-(2-p) = -1.900)
t = 500,000에서 결정론 6.9e-12 대 요동 0.0018 — 요동이 과도기의 3e+08배다.
# 결정론적 과도기와 몬테카를로 요동을 같은 축에 겹친다.
tt = np.logspace(1, np.log10(T_UNITS), 60)
fig, ax = plt.subplots(figsize=(6.2, 4.1))
ax.loglog(ts1[ts1 >= 2], dev1[ts1 >= 2], color='k', lw=1.4, label='결정론 (eq-w20-5), 출발 $k=1$')
ax.loglog(ts3[ts3 >= 2], dev3[ts3 >= 2], color='k', lw=1.0, ls='--', label='같은 계, 출발 $k=3$')
for i in range(len(trajs)):
    ax.loglog(tgrid, devs[i], 'o', ms=3.0, color=BLUE, alpha=0.5,
              label='몬테카를로 시드 0–5' if i == 0 else None)
ax.loglog(tgrid[mm], rms[mm], color=BLUE, lw=1.4, label='시드 여섯의 RMS')
ax.loglog(tt, dev1[0] * tt ** (-(2 - P)), ls=':', color=RED, lw=1.3,
          label='$t^{-(2-p)}=t^{-1.9}$')
ax.loglog(tt, np.sqrt(f[1] * (1 - f[1]) / (P * tt)), ls=':', color=GREY, lw=1.3,
          label='$\\sqrt{f_1(1-f_1)/(pt)}\\propto t^{-1/2}$')
ax.set_xlabel('시간 $t$ = 누적 단위 수 (로그)')
ax.set_ylabel('$|f_1(t)-f_1^{*}|$ (로그)')
ax.set_ylim(1e-13, 60)
log_ticks(ax, 'x', [1, 2, 3, 4, 5])
log_ticks(ax, 'y', [-12, -10, -8, -6, -4, -2, 0])
ax.set_title('과도기는 $t^{-1.9}$, 표본 요동은 $t^{-1/2}$ — 표본에서는 과도기가 보이지 않는다',
             fontsize=10)
ax.legend(fontsize=8, loc='lower left')
fig.tight_layout()
plt.show()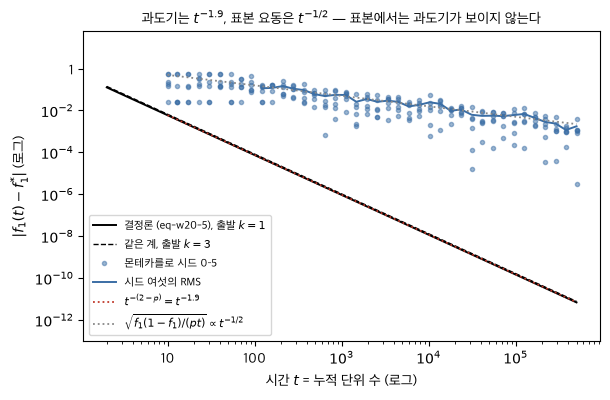
# 대조 표에 옮길 수치를 예측 항목 순서로 모은다.
print(f'예측 1 — f_1 {f1_s:.4f} (정확 {f[1]:.4f}, 어긋남 {abs(f1_s - f[1]) / sd1:.1f} sd) · '
      f'f_2 {f2_s:.4f} (정확 {f[2]:.4f}) · U/N {mean_s:.3f} '
      f'(1/p = {1 / P:.1f}, {100 * (mean_s - 1 / P) * P:+.2f}%)')
print(f'예측 2 — 기울기 [5,200] {band(5, 200):.3f} (정확 {EX_5_200:.3f}, 점근 {-ZETA:.3f}) · '
      f'[1,200] {band(1, 200):.3f} · 순위-규모 {rank_slope:.3f} (-1/ζ = {-1 / ZETA:.3f}) · '
      f'최대 기업 비중 {100 * kmax_obs / U0:.1f}%')
print(f'예측 3 — 결정론 기울기 {DET_SLOPE:.3f} (-(2-p) = {-(2 - P):.3f}) · '
      f'요동 RMS 기울기 {MC_SLOPE:.3f} (-1/2) · '
      f't=5×10^5 에서 결정론 {dev1[-1]:.1e} 대 요동 {rms[-1]:.4f}')
예측 1 — f_1 0.5251 (정확 0.5263, 어긋남 0.6 sd) · f_2 0.1704 (정확 0.1692) · U/N 9.974 (1/p = 10.0, -0.26%)
예측 2 — 기울기 [5,200] -1.059 (정확 -1.079, 점근 -1.111) · [1,200] -1.035 · 순위-규모 -0.992 (-1/ζ = -0.900) · 최대 기업 비중 16.6%
예측 3 — 결정론 기울기 -1.902 (-(2-p) = -1.900) · 요동 RMS 기울기 -0.521 (-1/2) · t=5×10^5 에서 결정론 6.9e-12 대 요동 0.0018
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
본문 확인: 어긋났으면 1번은 (eq-w20-6)·(eq-w20-7)로, 2번은 (eq-w20-8)·(eq-w20-10)으로, 3번은 (eq-w20-5)·(eq-w20-11)로 돌아간다.