
테마
16회 · 베이즈의 귀환 · 노트
8 오늘 — 벌점은 사전분포다
역사 Hoerl과 Kennard(1970)는 ridge를 공선성의 처방으로 내놓았고(13회), Tibshirani(1996)는 계수의 절댓값에 벌점을 주는 lasso로 변수 선택과 추정을 한 번에 했다. 두 벌점은 각각 정규 사전분포와 Laplace 사전분포의 사후 최빈값이다. 신경망의 weight decay도 같다. 계산 쪽에서는 물리학이 다시 들어왔다. Paul Langevin(1908)의 브라운 운동 방정식을 이산화하면 기울기를 따라 내려가며 잡음을 더하는 표집기가 된다. Roberts와 Tweedie(1996)는 여기에 MH 보정을 붙였고(MALA), Welling과 Teh(2011)는 미니배치 기울기로 그것을 큰 자료에 썼다(SGLD). 2019–2021년의 확산 생성모형은 자료의 로그밀도의 기울기, 곧 점수를 신경망으로 배워 Langevin 표집을 한다. 그 학습의 핵심 등식은 1956년 Robbins가 경험적 Bayes 논문에서 Tweedie의 것으로 소개한 공식이다.
8.1 ridge와 lasso의 사전분포
증명 전략 로그 사후밀도를 의 이차형식으로 쓰고 행렬의 제곱 완성으로 정규 밀도의 핵과 맞춘다. 정리 1.2(c)의 다차원판이다. 단계별 증명은 연습 8.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
13회에서 는 공선성을 다스리는 손잡이였다. 여기서는 잡음과 신호의 분산비 이다. 계수가 0 근처에 몰려 있다고 믿을수록(가 작을수록) 세게 줄인다. 5절의 James–Stein은 이 을 자료로 추정하고, 13회의 교차검증도 결국 같은 일을 다른 방법으로 한다.
증명 로그 사후밀도에 을 곱하면 위의 목적함수다. 이면 이므로 목적함수가 좌표별 의 합으로 갈라진다. 이것의 최소점은 15회 명제 8.3(b)의 계산 그대로 연성 임계값이다.
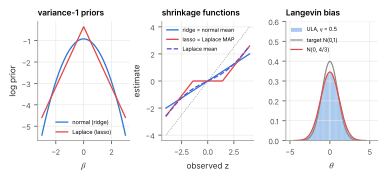
ridge는 모든 계수를 같은 비율로 줄이고 0으로 만들지 않는다. lasso는 작은 계수를 정확히 0으로 만든다. 15회에서 Huber 손실의 “이상치 몫”이 이 연성 임계값이었다. 다만 정확한 0은 MAP의 성질이지 사후분포의 성질이 아니다. Laplace 사전분포의 사후평균은 매끄러운 축소 함수이고 결코 0이 아니다(그림 8.1 가운데). Park과 Casella(2008)는 Laplace 분포가 정규의 척도 혼합이라는 사실(4회 예제 5.4)로 이 사후분포의 Gibbs 표집기를 만들었다(Bayes lasso).
8.2 Langevin 표집
MH는 목표밀도의 값만 쓴다. 기울기 를 쓰면 높은 밀도 쪽으로 제안을 기울일 수 있다.
정의 8.3 (비보정 Langevin 알고리즘) 걸음 크기 에서 , 를 ULA라 한다. 에는 정규화 상수가 들어가지 않는다.
의 연속시간 극한인 Langevin 확산은 를 정확히 정상분포로 갖는다. 그러나 에서 ULA의 정상분포는 가 아니다.
명제 8.4 (정규 목표에서 ULA의 치우침) 이고 이면 ULA의 정상분포는 이다.
증명 전략 정규 목표에서 ULA는 계수 의 AR(1)이다. 정상분산을 에서 푼다. 단계별 증명은 연습 8.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
에서 이면 정상분산이 , 이면 이다. 20만 걸음의 모의실험은 와 이다. 치우침을 없애는 방법은 둘이다. 걸음 크기를 줄이거나, Langevin 걸음을 MH의 제안 로 쓰고 정리 4.5의 받아들임 단계를 붙인다(MALA). SGLD는 를 미니배치로 추정한 값으로 바꾸고 으로 줄여 간다. 잡음을 더한 SGD다. 기울기를 쓰는 표집기의 다른 갈래인 Hamiltonian Monte Carlo는 Stan의 기본 알고리즘이다.
8.3 Tweedie의 공식과 확산모형
정리 8.5 (Tweedie의 공식) 이고 (임의의 사전분포)이며 가 의 주변밀도이면
증명 전략 주변밀도를 미분하면 정규 잡음의 밀도에서 이 내려온다. 그것을 로 나누면 사후평균에서 를 뺀 것이다.
조건 확인 2에는 적분 기호 아래의 미분이 필요하다. 는 에 대해 유계이므로 (상수)이고, 상수는 확률분포 에 대해 적분가능하다. 이 지배함수는 에도 에도 의존하지 않으므로 사전분포에 적률이 없어도 공식이 성립한다 [T6]. 은 에서 나온다.
사후평균을 구하는 데 사전분포가 필요 없다. 주변밀도 만 알면 되고, 은 관측된 들로 추정할 수 있다. 이것이 Robbins의 경험적 Bayes의 핵심이다. 이면 , 이므로 , 로 정리 5.4가 된다. 확산모형은 깨끗한 영상 에 잡음을 더한 에서 를 맞히는 신경망(잡음 제거기)을 학습한다. 제곱손실로 학습한 잡음 제거기는 사후평균을 근사하므로(정리 2.1), Tweedie의 공식으로 거꾸로 읽으면 점수 을 근사한다. 여러 잡음 수준의 점수로 Langevin 표집을 하면 새 영상이 나온다. Stein의 1956년과 Robbins의 1956년이 오늘의 생성모형 안에서 만난다.
연습문제
연습 8.1 (Robbins의 Poisson 공식 ★★) , 이면 임을 보여라(은 의 주변 확률질량함수). 사고 기록에서 작년에 사고를 번 낸 운전자의 올해 기대 사고 수를 사전분포 없이 추정하는 방법을 설명하라.
풀이
. 운전자 명 중 작년에 사고를 번 낸 사람의 수를 라 하면 이므로 가 추정값이다. 사전분포를 몰라도 되고, 사고를 많이 낸 사람의 올해 기대 사고 수가 작년보다 작다는 평균으로의 회귀가 자동으로 들어간다.
연습 8.2 (ULA의 안정성 ★) 명제 8.4에서 이면 연쇄가 발산함을 보여라. 정규 목표 에서 ULA가 안정하려면 걸음 크기가 의 어느 고윳값으로 제한되는가? 13회의 경사하강의 조건수와 비교하라.
풀이
이면 계수 이므로 이고 분산이 줄지 않는다(엄밀히는 에서 발산, 에서 잡음이 쌓인다). 에서 의 고유벡터 방향마다 AR(1)이 되므로 가 필요하다. 그 걸음으로 가장 긴 방향(분산 )을 가로지르려면 번의 걸음이 든다. 13회 정리 8.1의 경사하강이 조건수 에 묶이는 것과 같다.
연습 8.3 (ridge의 사후 신용구간 ★★) 명제 8.1에서 이면 의 95% 신용구간이 임을 보여라. 같은 가 0일 때와 클 때 이 구간의 빈도주의 포함확률을 비교하라.
풀이
, 이면 사후분포는 이므로 구간이 나온다. 이면 포함은 ()과 같다. 이면 에서 포함확률이 이다. 사전분포가 맞다면 에 대해 평균한 포함확률은 정확히 0.95이지만, 큰 계수에서는 구간이 0 쪽으로 끌려가 크게 빗나간다.
연습 8.4 (Laplace 사후평균은 0이 아니다 ★★) , Laplace이면 에서 이고 의 홀함수이며 증가함을 보여라. (힌트: Tweedie의 공식을 한 번 더 미분하면 이고, 은 짝함수다.)
풀이
Tweedie의 공식 를 미분하면 이다. 이므로 , 이고 이다. 따라서 으로 순증가한다. 사전분포와 잡음이 모두 대칭이라 은 짝함수, 은 홀함수이고 이다. 순증가하는 홀함수이므로 이면 0이 아니다. lasso의 MAP가 에서 정확히 0인 것과 대조된다.
연습 8.5 (ridge의 사후분포: 증명 ★★ 유도형) 명제 8.1를 다음 순서로 증명하라. 로 둔다.
- (a)
로그 사후밀도가 에 상수를 더한 것임을 보여라. 은 어디서 나오는가?
- (b)
괄호 안이 임을 전개해 보여라. 가 대칭이고 가역인 이유를 밝혀라.
- (c)
(b)가 의 밀도의 핵임을 확인하고(5회 정리 3.15), 정규분포의 평균과 최빈값이 같음을 써서 사후평균과 MAP가 ridge 추정량임을 결론지어라.
풀이
(a) 가능도는 , 사전밀도는 에 비례한다. 로그를 더하면 이므로 이다. (b) 이다. 로 두면 이고 이므로 두 식의 차는 로 에 무관하다. 는 대칭이고, 이면 이라 양정치이므로 가역이다. (c) 로그 사후밀도가 상수이므로 정밀도 행렬 , 평균 인 정규분포, 곧 이다(5회 정리 3.15). 정규밀도는 평균에서 최대이므로 사후평균과 MAP가 모두 , ridge 추정량이다.
연습 8.6 (ULA의 치우침: 증명 ★ 유도형) 명제 8.4를 다음 순서로 증명하라.
- (a)
을 넣어 , 임을 보여라.
- (b)
이면 임을 보여라.
- (c)
가 정상이면 이므로 이다. 이것을 풀어 을 얻어라.
풀이
(a) 상수이므로 이고 이다. (b) 이면 이므로 이다. (c) 와 가 독립이면 이다. 정상이면 , 곧 이다. 이므로 이다. 이면 는 어디서 출발하든 이 값으로 수렴하므로 정상분포는 하나다.