
테마
노트북 · 16회 · 베이즈의 귀환
베이즈의 귀환 MCMC와 Stein의 역설
| 강의노트 | 16_bayes_mcmc_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 16_bayes_mcmc_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Laplace의 파리 출생 기록(1745–1770, 남아 251,527 · 여아 241,945) · Arbuthnot의 런던 세례 기록 (HistData Arbuthnot) · Efron–Morris의 1970년 타율 (pscl EfronMorris) |
| 선수 지식 | 1–15회 (1회 Bayes 정리, 3회 전분산, 4회 베타와 당구대, 5회 축소, 7회 몬테카를로, 9회 Fisher 정보, 12회 Bayes 규칙, 13회 ridge) |
여는 질문. 1745년부터 1770년까지 파리에서 남아 251,527명, 여아 241,945명이 태어났다. 남아가 태어날 확률이 보다 크다는 것을 우리는 얼마나 확신할 수 있는가? 그리고 이 질문에 답하려면 확률이 무엇에 대한 것이어야 하는가?
이번 회차의 지도
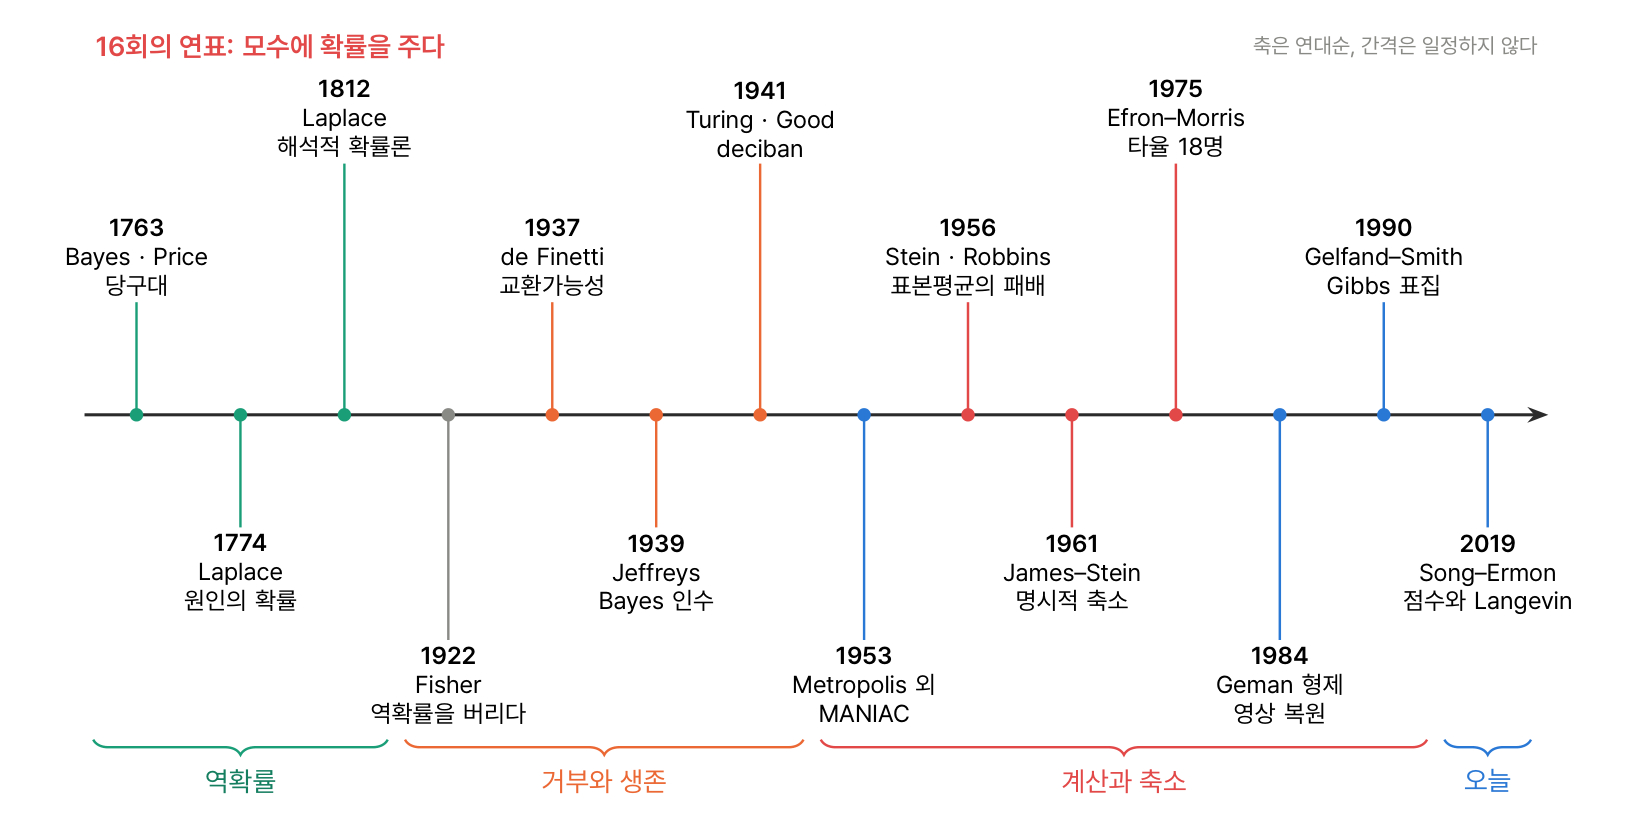
학습 목표
- 켤레 사전분포로 사후분포를 구하고, 파리 출생 자료의 를 정확한 계산과 Laplace 근사로 구한다.
- Bayes 추정량의 위험을 계산하고(minimax, 불편추정량은 Bayes가 아님), Jeffreys 사전분포의 불변성과 구간의 포함확률을 확인한다.
- Bayes 인수와 증거의 무게를 Arbuthnot과 Lindley의 자료로 계산한다.
- Metropolis–Hastings와 Gibbs 표집을 구현하고, 상세 균형·자기상관·을 확인한다.
- James–Stein의 위험을 정확한 공식과 모의실험으로 확인하고, 타율 자료로 경험적·계층 Bayes를 비교한다. ridge·lasso·Langevin·Tweedie를 사전분포의 언어로 확인한다.
정리 지도
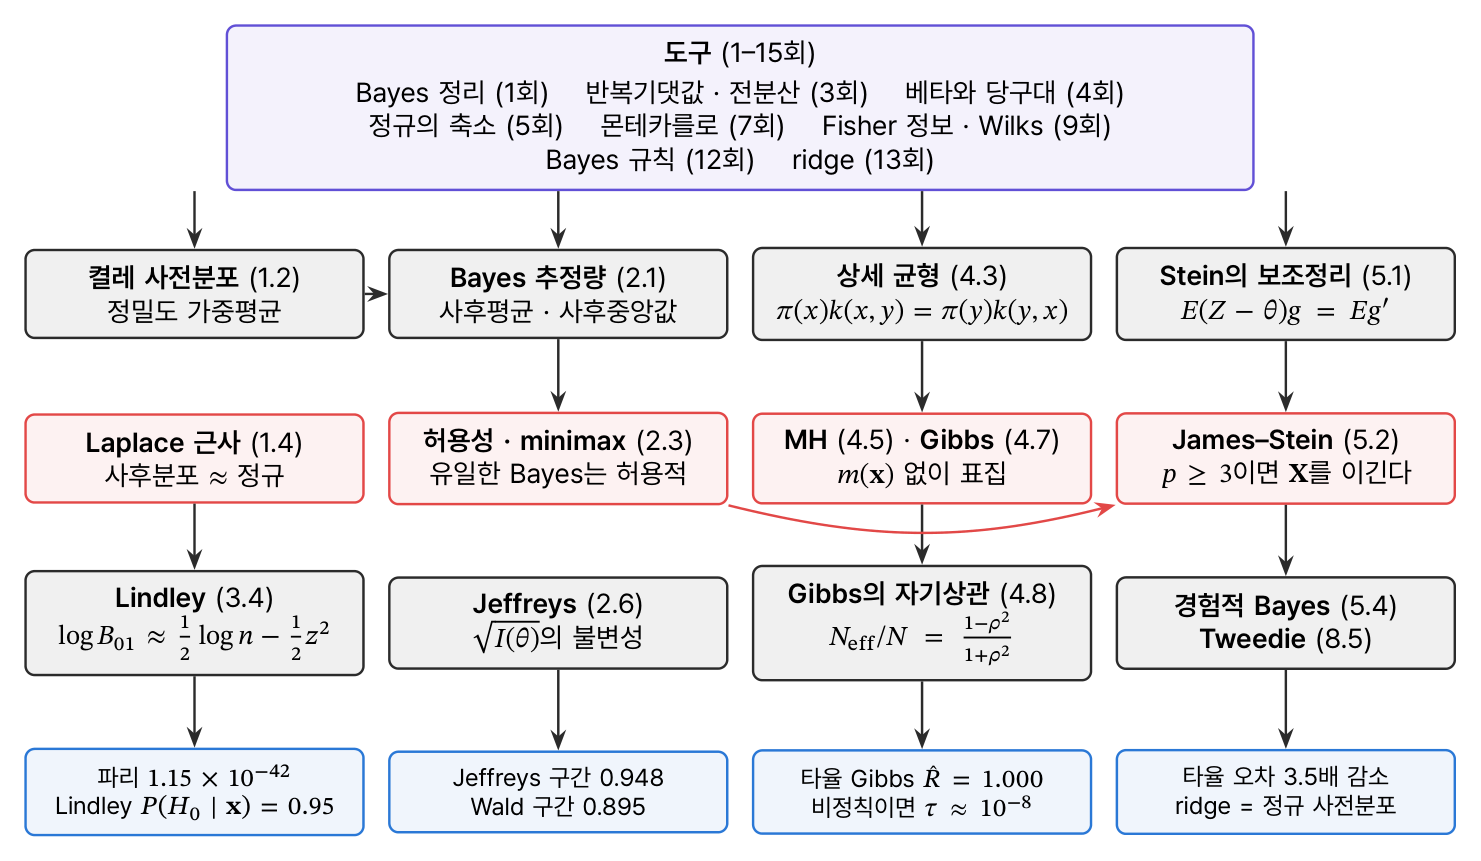
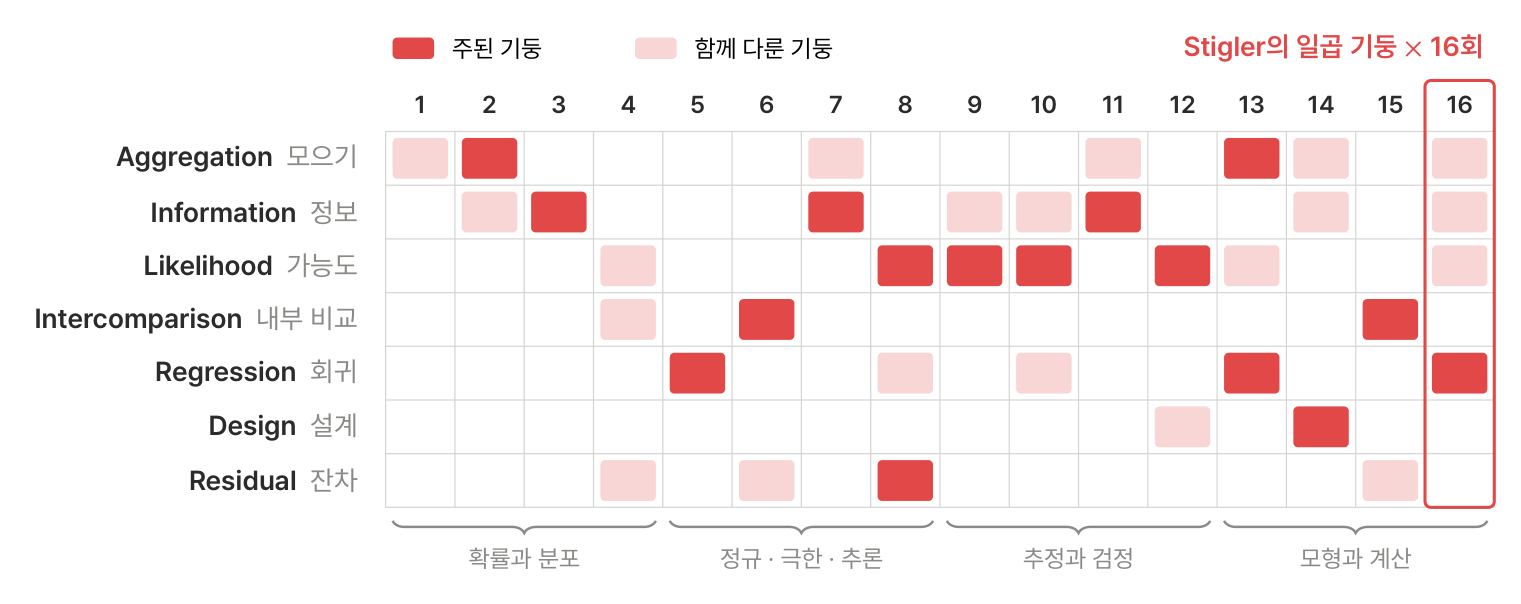
일곱 기둥 지도 (16회 전체)
0. 설정
이번 회차부터 모수도 확률변수다. 그림에서 모수의 사후분포는 청록(데이터 색)으로 그린다.
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, special, stats

SEED = 1763
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

def rhat(chains):
    """정의 4.9: 연쇄 m 개 (행) × 길이 n (열)"""
    m, n = chains.shape; W = chains.var(1, ddof=1).mean(); B = n * chains.mean(1).var(ddof=1)
    return math.sqrt(((n - 1) / n * W + B / n) / W)

def ess(x):
    """유효 표본 크기 N / (1 + 2 Σ ρ_k), 자기상관이 0.05 아래로 처음 떨어지는 시차까지 더한다"""
    x = x - x.mean(); n = len(x); f = np.fft.rfft(x, 2 * n)
    acf = np.fft.irfft(f * np.conj(f))[:n] / (np.arange(n, 0, -1) * x.var())
    s = 0.0
    for t in range(1, n):
        if acf[t] < 0.05: break
        s += acf[t]
    return n / (1 + 2 * s)

def mh1(logpdf, x0, step, n, seed):
    """알고리즘 4.4: 1차원 무작위 걸음 Metropolis"""
    g = np.random.default_rng(seed); x = x0; lp = logpdf(x); out = np.empty(n); acc = 0
    for i in range(n):
        xp = x + step * g.normal(); lpp = logpdf(xp)
        if math.log(g.random()) < lpp - lp: x, lp = xp, lpp; acc += 1
        out[i] = x
    return out, acc / n

B_PARIS, G_PARIS = 251527, 241945
ARB = load_rdata("Arbuthnot")
B_LON, G_LON = int(ARB.Males.sum()), int(ARB.Females.sum())
EM = load_rdata("EfronMorris", "pscl")
print(f"Arbuthnot {ARB.Year.min()}–{ARB.Year.max()} ({len(ARB)} years): boys {B_LON:,}, girls {G_LON:,}")
print(EM[["name", "team", "y", "p"]].head(3).to_string(index=False))
text
Arbuthnot 1629–1710 (82 years): boys 484,382, girls 453,841
            name  team     y     p
Roberto Clemente Pitts 0.400 0.346
  Frank Robinson  Balt 0.378 0.298
    Frank Howard  Wash 0.356 0.276
1. Laplace의 역확률 (1763–1812)
정의 1.1 사후분포 · 정리 1.2 켤레 사전분포 (베타–이항, 감마–Poisson, 정규–정규) · 예제 1.3 파리의 남아 · 명제 1.4 Laplace 근사.
정리 1.2의 세 경우를 수치 적분(사전분포 × 가능도를 정규화)과 비교한다.
python
# 정리 1.2: 세 켤레 쌍을 격자 위의 수치 사후분포와 대조
grid = np.linspace(1e-6, 1 - 1e-6, 200_001)
a0, b0, n0, s0 = 2.5, 4.0, 30, 11
post_num = stats.beta.pdf(grid, a0, b0) * stats.binom.pmf(s0, n0, grid); post_num /= np.trapezoid(post_num, grid)
err_a = np.max(np.abs(post_num - stats.beta.pdf(grid, a0 + s0, b0 + n0 - s0)))

lam = np.linspace(1e-6, 6, 200_001); xs_p = rng.poisson(1.7, 25); al, be = 2.0, 1.5
post_num = stats.gamma.pdf(lam, al, scale=1 / be) * np.exp(np.sum(stats.poisson.logpmf(xs_p[:, None], lam[None, :]), 0))
post_num /= np.trapezoid(post_num, lam)
err_b = np.max(np.abs(post_num - stats.gamma.pdf(lam, al + xs_p.sum(), scale=1 / (be + len(xs_p)))))

mu = np.linspace(-3, 5, 200_001); xs_n = rng.normal(1.2, 2.0, 12); m0, tau0, sig = 0.0, 1.5, 2.0
prec = len(xs_n) / sig**2 + 1 / tau0**2; mpost = (len(xs_n) / sig**2 * xs_n.mean() + m0 / tau0**2) / prec
post_num = stats.norm.pdf(mu, m0, tau0) * np.exp(np.sum(stats.norm.logpdf(xs_n[:, None], mu[None, :], sig), 0))
post_num /= np.trapezoid(post_num, mu)
err_c = np.max(np.abs(post_num - stats.norm.pdf(mu, mpost, 1 / math.sqrt(prec))))
print(f"max |numerical − conjugate|: beta {err_a:.1e}, gamma {err_b:.1e}, normal {err_c:.1e}")

# 연습 1.1 · 1.4: 사후평균은 가중평균, 다음 하나의 예측확률 = 사후평균 (몬테카를로)
w = (a0 + b0) / (a0 + b0 + n0)
pnext = np.mean(rng.binomial(1, rng.beta(a0 + s0, b0 + n0 - s0, 400_000)))
# 연습 1.2: 기병대 122 / 200, Γ(1, 1) 사전분포
gp = stats.gamma(123, scale=1 / 201); ci_g = gp.ppf([0.025, 0.975])
print(f"exercise 1.2: posterior mean {gp.mean():.3f}, 95% CI [{ci_g[0]:.3f}, {ci_g[1]:.3f}]")
report({"정리 1.2 (a) 베타–이항 = 수치 사후분포": err_a < 1e-6,
        "정리 1.2 (b) 감마–Poisson = 수치 사후분포": err_b < 1e-6,
        "정리 1.2 (c) 정규–정규 = 수치 사후분포 (정밀도 가중평균)": err_c < 1e-6,
        "연습 1.1: (a+s)/(a+b+n) = w·a/(a+b) + (1−w)·s/n": abs((a0 + s0) / (a0 + b0 + n0) - (w * a0 / (a0 + b0) + (1 - w) * s0 / n0)) < 1e-12,
        "연습 1.4: 사후예측확률 = 사후평균": within(pnext, (a0 + s0) / (a0 + b0 + n0), 0.5 / math.sqrt(400_000)),
        "연습 1.2: 사후평균 0.612, 95% 구간 [0.509, 0.725]": round(gp.mean(), 3) == 0.612 and np.allclose(np.round(ci_g, 3), [0.509, 0.725])})
text
max |numerical − conjugate|: beta 3.4e-14, gamma 1.1e-13, normal 1.0e-13text
exercise 1.2: posterior mean 0.612, 95% CI [0.509, 0.725]
  ✓  정리 1.2 (a) 베타–이항 = 수치 사후분포
  ✓  정리 1.2 (b) 감마–Poisson = 수치 사후분포
  ✓  정리 1.2 (c) 정규–정규 = 수치 사후분포 (정밀도 가중평균)
  ✓  연습 1.1: (a+s)/(a+b+n) = w·a/(a+b) + (1−w)·s/n
  ✓  연습 1.4: 사후예측확률 = 사후평균
  ✓  연습 1.2: 사후평균 0.612, 95% 구간 [0.509, 0.725]
예제 1.3. 균등 사전분포(Bayes의 당구대)로 파리와 런던의 사후분포를 구한다. 런던과 파리의 차이는 두 사후분포에서 독립으로 뽑아 계산한다.
python
a_p, b_p = B_PARIS + 1, G_PARIS + 1
lp_half = stats.beta.logcdf(0.5, a_p, b_p)
post_mean = a_p / (a_p + b_p); ci_p = stats.beta.ppf([0.025, 0.975], a_p, b_p)
p_lon = B_LON / (B_LON + G_LON)
g1 = np.random.default_rng(1)
pl = g1.beta(B_LON + 1, G_LON + 1, 400_000); pp = g1.beta(a_p, b_p, 400_000)
d_lp = pl - pp; ci_d = np.percentile(d_lp, [2.5, 97.5])
print(f"Paris: P(p <= 1/2 | data) = {math.exp(lp_half):.4e} (log10 {lp_half / math.log(10):.2f})")
print(f"Paris: posterior mean {post_mean:.5f}, 95% CI [{ci_p[0]:.5f}, {ci_p[1]:.5f}]")
print(f"London 1629–1710: p-hat {p_lon:.4f};  London − Paris {d_lp.mean():.4f} [{ci_d[0]:.4f}, {ci_d[1]:.4f}], P(London > Paris) = {np.mean(d_lp > 0)}")
report({"예제 1.3: P(p ≤ 1/2 | 자료) = 1.15 × 10^-42": f"{math.exp(lp_half):.2e}" == "1.15e-42",
        "예제 1.3: 사후평균 0.50971, 95% 구간 [0.50831, 0.51110]": round(post_mean, 5) == 0.50971 and np.allclose(np.round(ci_p, 5), [0.50831, 0.51110]),
        "예제 1.3: 런던 0.5163, 차이 0.0066 [0.0048, 0.0083]": round(p_lon, 4) == 0.5163 and round(d_lp.mean(), 4) == 0.0066 and np.allclose(np.round(ci_d, 4), [0.0048, 0.0083]),
        "런던의 비율이 더 크다 (모든 표본에서)": np.mean(d_lp > 0) == 1.0})
text
Paris: P(p <= 1/2 | data) = 1.1461e-42 (log10 -41.94)
Paris: posterior mean 0.50971, 95% CI [0.50831, 0.51110]
London 1629–1710: p-hat 0.5163;  London − Paris 0.0066 [0.0048, 0.0083], P(London > Paris) = 1.0
  ✓  예제 1.3: P(p ≤ 1/2 | 자료) = 1.15 × 10^-42
  ✓  예제 1.3: 사후평균 0.50971, 95% 구간 [0.50831, 0.51110]
  ✓  예제 1.3: 런던 0.5163, 차이 0.0066 [0.0048, 0.0083]
  ✓  런던의 비율이 더 크다 (모든 표본에서)
명제 1.4 (Laplace 근사). . 이항 가능도에서 이 커질 때 비가 1로 가는 것을 본다. 파리 자료의 꼬리확률은 정규근사로 이다(연습 1.3: 비 1.03). Bernstein–von Mises: 사후분포와 의 총변동 거리가 과 함께 줄어든다.
python
# 명제 1.4: ∫ p^s (1−p)^(n−s) dp = B(s+1, n−s+1) 와 Laplace 근사의 비
ratios = []
for n in [10, 100, 1000, 10_000, 100_000]:
    s = round(0.3 * n); ph = s / n
    exact = special.betaln(s + 1, n - s + 1)
    lap = s * math.log(ph) + (n - s) * math.log(1 - ph) + 0.5 * math.log(2 * math.pi * ph * (1 - ph) / n)
    ratios.append(math.exp(exact - lap))
print("exact / Laplace:", np.round(ratios, 5))
# 파리 자료의 정규근사 (연습 1.3)
ph = B_PARIS / (B_PARIS + G_PARIS); z = (0.5 - ph) / math.sqrt(ph * (1 - ph) / (B_PARIS + G_PARIS))
p_norm = stats.norm.cdf(z); ratio13 = math.exp(lp_half) / p_norm
skew = float(stats.beta.stats(a_p, b_p, moments="s"))
# Bernstein–von Mises: 총변동 거리 ½∫|beta − normal|
tvs = []
for n in [20, 200, 2000, 20_000]:
    s = round(0.3 * n); x = np.linspace(1e-6, 1 - 1e-6, 400_001); ph_ = s / n
    tvs.append(0.5 * np.trapezoid(np.abs(stats.beta.pdf(x, s + 1, n - s + 1) - stats.norm.pdf(x, ph_, math.sqrt(ph_ * (1 - ph_) / n))), x))
print(f"Paris: z = {z:.2f}, Φ(z) = {p_norm:.3e}, exact/normal = {ratio13:.3f}, skewness = {skew:.2e}")
print("TV(posterior, normal):", np.round(tvs, 4))
# 연습 2.5 (사후평균 − 사후중앙값)
mm = stats.beta.mean(a_p, b_p) - stats.beta.median(a_p, b_p)
print(f"exercise 2.5: mean − median = {mm:.3e}")
report({"명제 1.4: 정확한 적분 / Laplace 근사 → 1": abs(ratios[-1] - 1) < 1e-5 and all(np.diff(np.abs(np.array(ratios) - 1)) < 0),
        "본문: z = −13.64, Φ(z) = 1.11 × 10^-42, 정확한 값과 3% 차이": round(z, 2) == -13.64 and f"{p_norm:.2e}" == "1.11e-42" and round(ratio13, 2) == 1.03,
        "연습 1.3: 왜도 −1.1 × 10^-4 (왼쪽 꼬리가 길다)": round(skew, 5) == -0.00011,
        "Bernstein–von Mises: 총변동 거리가 줄어든다": all(np.diff(tvs) < 0) and tvs[-1] < 0.01,
        "연습 2.5: 사후평균 − 사후중앙값 = −1.31 × 10^-8": f"{mm:.2e}" == "-1.31e-08"})
text
exact / Laplace: [0.93794 0.99321 0.99931 0.99993 0.99999]
Paris: z = -13.64, Φ(z) = 1.113e-42, exact/normal = 1.030, skewness = -1.11e-04
TV(posterior, normal): [0.0567 0.0169 0.0052 0.0016]
exercise 2.5: mean − median = -1.312e-08
  ✓  명제 1.4: 정확한 적분 / Laplace 근사 → 1
  ✓  본문: z = −13.64, Φ(z) = 1.11 × 10^-42, 정확한 값과 3% 차이
  ✓  연습 1.3: 왜도 −1.1 × 10^-4 (왼쪽 꼬리가 길다)
  ✓  Bernstein–von Mises: 총변동 거리가 줄어든다
  ✓  연습 2.5: 사후평균 − 사후중앙값 = −1.31 × 10^-8
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
ax = axes[0]; x = np.linspace(0.505, 0.52, 2000)
ax.plot(x, stats.beta.pdf(x, a_p, b_p), color=C["data"], label="Paris 1745–1770")
ax.plot(x, stats.beta.pdf(x, B_LON + 1, G_LON + 1), color=C["stat"], label="London 1629–1710")
ax.set_xlabel("p = P(boy)"); ax.legend(); ax.set_title("posterior, uniform prior")
ax = axes[1]; ns = [10, 100, 1000, 10_000, 100_000]
ax.loglog(ns, np.abs(np.array(ratios) - 1), "o-", color=C["key"], label="|exact/Laplace − 1|")
ax.loglog(ns, 1 / np.array(ns), **THEORY, label="1/n")
ax.set_xlabel("n"); ax.legend(); ax.set_title("Laplace approximation error is O(1/n)")
plt.tight_layout(); plt.show()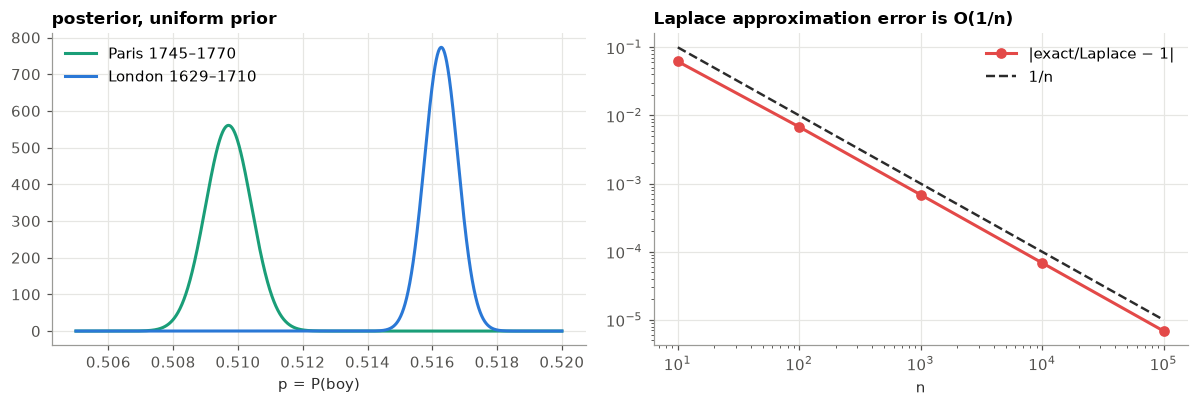
점선은 이다. Laplace 근사의 상대오차는 이고, Stirling 공식(5회 보조정리 1.1)의 보정항으로 상수까지 계산할 수 있다.
2. Bayes 추정과 Jeffreys 사전분포
정리 2.1 제곱손실 → 사후평균, 절대손실 → 사후중앙값 · 예제 2.2 이항의 Bayes 추정량과 minimax · 정리 2.3 허용성과 minimax · 명제 2.4 불편추정량은 Bayes가 아니다 · 정리 2.6 Jeffreys 사전분포의 불변성.
python
# 정리 2.1: 치우친 사후분포(감마)에서 사후 기대손실을 수치로 최소화
post = stats.gamma(3.0, scale=0.7); draws = post.rvs(400_000, random_state=rng)
a_sq = optimize.minimize_scalar(lambda a: np.mean((draws - a) ** 2), bounds=(0, 6), method="bounded").x
a_abs = optimize.minimize_scalar(lambda a: np.mean(np.abs(draws - a)), bounds=(0, 6), method="bounded").x
wfun = lambda t: 1 / t   # (c) 가중 제곱손실 w(θ) = 1/θ
a_w = optimize.minimize_scalar(lambda a: np.mean(wfun(draws) * (draws - a) ** 2), bounds=(0, 6), method="bounded").x
se_mean = draws.std() / math.sqrt(len(draws))

# 예제 2.2 · 연습 2.1: 이항 Bayes 추정량의 위험 (정확한 합)
def risk(p, n, a, b):
    s = np.arange(n + 1); return np.sum(stats.binom.pmf(s, n, p) * ((s + a) / (n + a + b) - p) ** 2)
n = 20; c = math.sqrt(n) / 2; ps = np.linspace(0.01, 0.99, 99)
R_formula = [(n * p * (1 - p) + (c - 2 * c * p) ** 2) / (n + 2 * c) ** 2 for p in ps]
R_exact = [risk(p, n, c, c) for p in ps]
R_mm = n / (4 * (n + math.sqrt(n)) ** 2)
cross = (1 - math.sqrt(1 - 4 * n * R_mm)) / 2
print(f"Thm 2.1: argmin squared {a_sq:.4f} (mean {post.mean():.4f}), absolute {a_abs:.4f} (median {post.median():.4f}), weighted {a_w:.4f} (E[w θ]/E[w] = {np.mean(wfun(draws) * draws) / np.mean(wfun(draws)):.4f})")
print(f"Ex 2.2: minimax risk {R_mm:.5f}, MLE max risk {0.25 / n:.4f}, MLE better for p < {cross:.3f} or p > {1 - cross:.3f}")
report({"정리 2.1 (a): 제곱손실의 최소점 = 사후평균": within(a_sq, draws.mean(), 1e-3, 1),
        "정리 2.1 (b): 절대손실의 최소점 = 사후중앙값": abs(a_abs - np.median(draws)) < 5e-3,
        "정리 2.1 (c): 가중 제곱손실 = E[wθ]/E[w]": abs(a_w - np.mean(wfun(draws) * draws) / np.mean(wfun(draws))) < 1e-3,
        "예제 2.2: 위험 공식 = 정확한 합": np.allclose(R_formula, R_exact),
        "예제 2.2: a = b = √n/2 이면 위험이 상수 0.00835 (정리 2.3 (b) minimax)": np.ptp(R_exact) < 1e-12 and round(R_mm, 5) == 0.00835,
        "연습 2.1: MLE 가 나은 곳 p < 0.212, p > 0.788": round(cross, 3) == 0.212})
text
Thm 2.1: argmin squared 2.1019 (mean 2.1000), absolute 1.8729 (median 1.8718), weighted 1.3989 (E[w θ]/E[w] = 1.3989)
Ex 2.2: minimax risk 0.00835, MLE max risk 0.0125, MLE better for p < 0.212 or p > 0.788
  ✓  정리 2.1 (a): 제곱손실의 최소점 = 사후평균
  ✓  정리 2.1 (b): 절대손실의 최소점 = 사후중앙값
  ✓  정리 2.1 (c): 가중 제곱손실 = E[wθ]/E[w]
  ✓  예제 2.2: 위험 공식 = 정확한 합
  ✓  예제 2.2: a = b = √n/2 이면 위험이 상수 0.00835 (정리 2.3 (b) minimax)
  ✓  연습 2.1: MLE 가 나은 곳 p < 0.212, p > 0.788
python
# 명제 2.4 · 연습 2.2: X̄ 는 Bayes 가 아니다 — μ ~ N(0, τ²), X_i | μ ~ N(μ, 1)
n, tau = 5, 2.0; R = 400_000
mus = rng.normal(0, tau, R); xbar = mus + rng.normal(0, 1 / math.sqrt(n), R)
pm = n * xbar / (n + 1 / tau**2)
bayes_risk_pm = np.mean((pm - mus) ** 2); bayes_risk_xbar = np.mean((xbar - mus) ** 2)
# 명제 2.4 의 두 계산: E[δθ] 를 θ 로 조건화하면 Eθ², X 로 조건화하면 Eδ² — 불편이면서 Bayes 일 수 없다
print(f"Bayes risk: posterior mean {bayes_risk_pm:.4f} (theory {tau**2 / (n * tau**2 + 1):.4f}), X̄ {bayes_risk_xbar:.4f} (1/n = {1 / n})")

# 정리 2.6: Jeffreys 의 불변성 — 베르누이에서 φ = log-odds 로 바꾼 두 길
phi = np.linspace(-6, 6, 1001); p_of = 1 / (1 + np.exp(-phi)); dp = p_of * (1 - p_of)
route1 = np.sqrt(1 / (p_of * (1 - p_of))) * dp            # θ 에서 Jeffreys → 변수변환
I_phi = p_of * (1 - p_of)                                   # 로지스틱 모수의 Fisher 정보
route2 = np.sqrt(I_phi)                                     # φ 에서 직접 Jeffreys
# 균등 사전분포는 불변이 아니다: p 균등 → φ 의 밀도 e^φ/(1+e^φ)² (로지스틱)
unif_phi = dp
# 예제 2.7 (c) 정규 척도: I(σ) = 2/σ² 를 점수의 분산으로
sig = 1.7; xs_ = rng.normal(0, sig, 1_000_000); score = -1 / sig + xs_**2 / sig**3
print(f"I(sigma) by simulation {score.var():.4f}, formula 2/sigma^2 = {2 / sig**2:.4f}")
report({"연습 2.2: 사후평균의 Bayes 위험 = τ²/(nτ²+1)": within(bayes_risk_pm, tau**2 / (n * tau**2 + 1), np.std((pm - mus) ** 2) / math.sqrt(R)),
        "명제 2.4: 불편인 X̄ 의 Bayes 위험 1/n 은 사후평균보다 크다": bayes_risk_xbar > bayes_risk_pm and within(bayes_risk_xbar, 1 / n, np.std((xbar - mus) ** 2) / math.sqrt(R)),
        "정리 2.6: 두 길의 Jeffreys 밀도가 같다 (로그오즈)": np.allclose(route1, route2),
        "균등 사전분포는 로그오즈에서 균등이 아니다 (로지스틱)": np.ptp(unif_phi) > 0.2,
        "예제 2.7 (c): I(σ) = 2/σ²": within(score.var(), 2 / sig**2, 0.002)})
text
Bayes risk: posterior mean 0.1898 (theory 0.1905), X̄ 0.1995 (1/n = 0.2)
I(sigma) by simulation 0.6963, formula 2/sigma^2 = 0.6920
  ✓  연습 2.2: 사후평균의 Bayes 위험 = τ²/(nτ²+1)
  ✓  명제 2.4: 불편인 X̄ 의 Bayes 위험 1/n 은 사후평균보다 크다
  ✓  정리 2.6: 두 길의 Jeffreys 밀도가 같다 (로그오즈)
  ✓  균등 사전분포는 로그오즈에서 균등이 아니다 (로지스틱)
  ✓  예제 2.7 (c): I(σ) = 2/σ²
python
# 본문 2.2절: Jeffreys 구간과 Wald 구간의 정확한 포함확률, n = 20, p ∈ [0.05, 0.95] 의 91 점
n = 20; ks = np.arange(n + 1)
lo = stats.beta.ppf(0.025, ks + 0.5, n - ks + 0.5); hi = stats.beta.ppf(0.975, ks + 0.5, n - ks + 0.5)
phk = ks / n; se = np.sqrt(phk * (1 - phk) / n); lw, hw = phk - 1.96 * se, phk + 1.96 * se
def coverage(p, l, h): return np.sum(stats.binom.pmf(ks, n, p) * ((l <= p) & (p <= h)))
ps91 = np.linspace(0.05, 0.95, 91)
cj = np.array([coverage(p, lo, hi) for p in ps91]); cw = np.array([coverage(p, lw, hw) for p in ps91])
print(f"Jeffreys: mean {cj.mean():.3f}, min {cj.min():.3f};  Wald: mean {cw.mean():.3f}, min {cw.min():.3f}")

# 연습 2.3: π(σ) ∝ 1/σ 이면 T/σ² | x ~ χ²_n — 사후분포에서 σ² 를 뽑아 확인
n3 = 8; x3 = rng.normal(0, 1.3, n3); T = np.sum(x3**2)
sig2_post = stats.invgamma(n3 / 2, scale=T / 2).rvs(200_000, random_state=rng)
ks_p = stats.kstest(T / sig2_post, stats.chi2(n3).cdf).pvalue
# 연습 2.4: Haldane — s = 0 이면 ∫_ε^1 p^{-1}(1−p)^{n−1} dp 가 log(1/ε) 처럼 커진다
hal = [integrate.quad(lambda p: p ** -1 * (1 - p) ** 9, eps, 1)[0] for eps in [1e-3, 1e-6, 1e-9]]
print(f"exercise 2.4: integral from eps = 1e-3, 1e-6, 1e-9: {np.round(hal, 2)}")
report({"본문: Jeffreys 평균 0.948, 최솟값 0.896": round(cj.mean(), 3) == 0.948 and round(cj.min(), 3) == 0.896,
        "본문: Wald 평균 0.895, 최솟값 0.639": round(cw.mean(), 3) == 0.895 and round(cw.min(), 3) == 0.639,
        "연습 2.3: T/σ² 의 사후분포는 χ²_n (KS)": ks_p > 0.001,
        "연습 2.4: s = 0 이면 Haldane 사후분포가 비정칙 (log 처럼 발산)": abs((hal[2] - hal[1]) - math.log(1e3)) < 0.01})
text
Jeffreys: mean 0.948, min 0.896;  Wald: mean 0.895, min 0.639
exercise 2.4: integral from eps = 1e-3, 1e-6, 1e-9: [ 4.09 10.99 17.89]
  ✓  본문: Jeffreys 평균 0.948, 최솟값 0.896
  ✓  본문: Wald 평균 0.895, 최솟값 0.639
  ✓  연습 2.3: T/σ² 의 사후분포는 χ²_n (KS)
  ✓  연습 2.4: s = 0 이면 Haldane 사후분포가 비정칙 (log 처럼 발산)
3. Fisher의 거부와 증거의 무게
정의 3.1 Bayes 인수 , 증거의 무게 (deciban) · 명제 3.2 사후 오즈 = 사전 오즈 × , 로그 Bayes 인수는 예측의 합 · 예제 3.3 Arbuthnot · 명제 3.4 · 예제 3.5 Lindley.
python
# 명제 3.2 (a): 두 단순가설에서 Bayes 정리로 직접 구한 사후 오즈 = 사전 오즈 × 가능도비
x = rng.normal(0.3, 1, 15); f0 = np.prod(stats.norm.pdf(x, 0, 1)); f1 = np.prod(stats.norm.pdf(x, 0.5, 1)); P0 = 0.7
post1 = (1 - P0) * f1 / ((1 - P0) * f1 + P0 * f0)
# 명제 3.2 (b): 베타–베르누이 주변 가능도 = 예측확률의 곱 (곱셈법칙)
bits = rng.binomial(1, 0.6, 40); a, b = 2.0, 3.0
m_direct = math.exp(special.betaln(a + bits.sum(), b + len(bits) - bits.sum()) - special.betaln(a, b))
m_seq, s = 1.0, 0
for k, xk in enumerate(bits):
    pk = (a + s) / (a + b + k); m_seq *= pk if xk else 1 - pk; s += xk
# 예제 3.3: Arbuthnot 의 해마다의 증거의 무게 (H1: p = 런던 전체의 비율, H0: p = 1/2)
p1 = B_LON / (B_LON + G_LON)
w_year = 10 * (ARB.Males * math.log10(p1 / 0.5) + ARB.Females * math.log10((1 - p1) / 0.5))
# 균등 대립가설의 Bayes 인수 (정확한 이항 계산)
def log10_B10_unif(x, n): return -(stats.binom.logpmf(x, n, 0.5) + math.log(n + 1)) / math.log(10)
lon10 = log10_B10_unif(B_LON, B_LON + G_LON)
print(f"London: total {w_year.sum():.0f} decibans, mean {w_year.mean():.1f} per year (LR {10 ** (w_year.mean() / 10):.0f}); uniform H1: log10 B10 = {lon10:.1f}")
report({"명제 3.2 (a): 사후 오즈 = 사전 오즈 × B10": abs(post1 / (1 - post1) - (1 - P0) / P0 * f1 / f0) < 1e-12 * f1 / f0,
        "명제 3.2 (b): 주변 가능도 = 예측확률의 곱": abs(m_direct / m_seq - 1) < 1e-10,
        "예제 3.3: 합 2159 deciban, 한 해 평균 26.3, 가능도비 약 400": round(w_year.sum()) == 2159 and round(w_year.mean(), 1) == 26.3 and 350 < 10 ** (w_year.mean() / 10) < 450,
        "예제 3.3: 균등 대립가설이면 log10 B10 = 213.0 (차이 29 deciban)": round(lon10, 1) == 213.0 and round(w_year.sum() - 10 * lon10) == 29,
        "8회: 부호검정 2^-82 ≈ 2 × 10^-25": f"{2.0 ** -82:.1e}" == "2.1e-25" and np.all(ARB.Males > ARB.Females)})
text
London: total 2159 decibans, mean 26.3 per year (LR 430); uniform H1: log10 B10 = 213.0
  ✓  명제 3.2 (a): 사후 오즈 = 사전 오즈 × B10
  ✓  명제 3.2 (b): 주변 가능도 = 예측확률의 곱
  ✓  예제 3.3: 합 2159 deciban, 한 해 평균 26.3, 가능도비 약 400
  ✓  예제 3.3: 균등 대립가설이면 log10 B10 = 213.0 (차이 29 deciban)
  ✓  8회: 부호검정 2^-82 ≈ 2 × 10^-25
python
# 예제 3.5 · 명제 3.4: Lindley 의 출생 자료
n, xb = 98_451, 49_581
z = (xb - n / 2) / math.sqrt(n / 4); pval = 2 * stats.norm.sf(abs(z))
logB01 = stats.binom.logpmf(xb, n, 0.5) + math.log(n + 1); post0 = 1 / (1 + math.exp(-logB01))
approx = -z**2 / 2 + 0.5 * math.log(n * 4 / (2 * math.pi))
print(f"z = {z:.2f}, p = {pval:.3f}, B01 = {math.exp(logB01):.1f}, P(H0|x) = {post0:.3f}; log B01 exact {logB01:.4f}, approx {approx:.4f}")
# 연습 3.3: 파리 — 명제 3.4 의 근사와 정확한 값
nP = B_PARIS + G_PARIS; z0 = 2 * math.sqrt(nP) * (B_PARIS / nP - 0.5)
par_apx = (z0**2 / 2 - 0.5 * math.log(4 * nP / (2 * math.pi))) / math.log(10); par_ex = log10_B10_unif(B_PARIS, nP)
print(f"Paris: z0 = {z0:.3f}, log10 B10 approx {par_apx:.2f}, exact {par_ex:.3f}")
# 연습 3.1: deciban 의 덧셈
db = 10 * math.log10(3) + 10 * math.log10(5); post_odds = (1 / 20) * 15
# 연습 3.2: 정규 평균의 Bayes 인수 — 공식과 수치 적분
nn, tau, xbar = 30, 0.8, 0.31
m1 = integrate.quad(lambda m: stats.norm.pdf(xbar, m, 1 / math.sqrt(nn)) * stats.norm.pdf(m, 0, tau), -10, 10, points=[0, xbar])[0]
m0 = stats.norm.pdf(xbar, 0, 1 / math.sqrt(nn)); zz = math.sqrt(nn) * xbar
B01_f = math.sqrt(1 + nn * tau**2) * math.exp(-zz**2 / 2 * nn * tau**2 / (1 + nn * tau**2))
B01_wide = [math.sqrt(1 + nn * t**2) * math.exp(-zz**2 / 2 * nn * t**2 / (1 + nn * t**2)) for t in [1, 10, 100, 1000]]
print(f"exercise 3.2: B01 numeric {m0 / m1:.6f}, formula {B01_f:.6f}; tau = 1, 10, 100, 1000: {np.round(B01_wide, 2)}")
report({"예제 3.5: z = 2.27, 양측 p = 0.023": round(z, 2) == 2.27 and round(pval, 3) == 0.023,
        "예제 3.5: B01 = 19.2, P(H0 | x) = 0.95": round(math.exp(logB01), 1) == 19.2 and round(post0, 2) == 0.95,
        "명제 3.4: 근사 2.9555 = 정확한 값 2.9555": round(approx, 4) == round(logB01, 4) == 2.9555,
        "연습 3.3: 근사 37.65, 정확한 값 37.656": round(par_apx, 2) == 37.65 and round(par_ex, 3) == 37.656 and round(z0, 3) == 13.640,
        "연습 3.1: 11.76 deciban, 사후확률 3/7": round(db, 2) == 11.76 and abs(post_odds / (1 + post_odds) - 3 / 7) < 1e-12,
        "연습 3.2: B01 공식 = 수치 적분": abs(m0 / m1 / B01_f - 1) < 1e-8,
        "연습 3.2: τ → ∞ 이면 B01 → ∞ (Bartlett)": all(np.diff(B01_wide) > 0) and B01_wide[-1] > 1000})
text
z = 2.27, p = 0.023, B01 = 19.2, P(H0|x) = 0.951; log B01 exact 2.9555, approx 2.9555
Paris: z0 = 13.640, log10 B10 approx 37.65, exact 37.656
exercise 3.2: B01 numeric 1.141910, formula 1.141910; tau = 1, 10, 100, 1000: [   1.38   12.97  129.58 1295.76]
  ✓  예제 3.5: z = 2.27, 양측 p = 0.023
  ✓  예제 3.5: B01 = 19.2, P(H0 | x) = 0.95
  ✓  명제 3.4: 근사 2.9555 = 정확한 값 2.9555
  ✓  연습 3.3: 근사 37.65, 정확한 값 37.656
  ✓  연습 3.1: 11.76 deciban, 사후확률 3/7
  ✓  연습 3.2: B01 공식 = 수치 적분
  ✓  연습 3.2: τ → ∞ 이면 B01 → ∞ (Bartlett)
python
# 연습 3.4: Pólya 항아리 — 길이 6 의 모든 순서의 확률을 정확히 계산
import itertools
a_u, b_u = 2, 3
def seq_prob(seq):
    w, bk, p = a_u, b_u, 1.0
    for x in seq:
        p *= (w if x else bk) / (w + bk)
        if x: w += 1
        else: bk += 1
    return p
probs = {}
for seq in itertools.product([0, 1], repeat=6):
    probs.setdefault(sum(seq), set()).add(round(seq_prob(seq), 15))
beta_int = {s: math.exp(special.betaln(a_u + s, b_u + 6 - s) - special.betaln(a_u, b_u)) for s in range(7)}
# 시뮬레이션: 항아리의 흰 공 비율의 극한은 Beta(a, b) (de Finetti 의 혼합분포)
g = np.random.default_rng(1937); lim = []
for _ in range(3000):
    w, bk = a_u, b_u
    for _ in range(400):
        if g.random() < w / (w + bk): w += 1
        else: bk += 1
    lim.append(w / (w + bk))
ks_urn = stats.kstest(lim, stats.beta(a_u, b_u).cdf, ).statistic
print(f"Pólya: distinct sequence probabilities per s: {[len(v) for v in probs.values()]}; KS(limit, Beta) = {ks_urn:.3f}")
report({"연습 3.4: 같은 s 의 모든 순서가 같은 확률 (교환가능)": all(len(v) == 1 for v in probs.values()),
        "연습 3.4: 그 확률 = ∫ p^s (1−p)^(n−s) Beta(a, b)(dp)": all(abs(next(iter(probs[s])) - beta_int[s]) < 1e-12 for s in range(7)),
        "de Finetti: 흰 공 비율의 극한은 Beta(a, b)": ks_urn < 0.04})
text
Pólya: distinct sequence probabilities per s: [1, 1, 1, 1, 1, 1, 1]; KS(limit, Beta) = 0.024
  ✓  연습 3.4: 같은 s 의 모든 순서가 같은 확률 (교환가능)
  ✓  연습 3.4: 그 확률 = ∫ p^s (1−p)^(n−s) Beta(a, b)(dp)
  ✓  de Finetti: 흰 공 비율의 극한은 Beta(a, b)
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
ax = axes[0]; ax.plot(ARB.Year, np.cumsum(w_year), color=C["key"])
ax.set_xlabel("year"); ax.set_ylabel("cumulative decibans"); ax.set_title(f"Arbuthnot: {w_year.sum():.0f} decibans for p = {p1:.3f}")
ax = axes[1]; ns = np.logspace(1, 7, 200)
xx = ns / 2 + 1.96 * np.sqrt(ns) / 2
lb = special.gammaln(ns + 2) - special.gammaln(xx + 1) - special.gammaln(ns - xx + 1) - ns * math.log(2)
ax.semilogx(ns, 1 / (1 + np.exp(-lb)), color=C["theta"], label="P(H0 | data), uniform H1")
ax.axhline(0.05, color=C["hist"], ls=":", label="p-value 0.05")
ax.set_xlabel("n"); ax.set_ylim(0, 1); ax.legend(); ax.set_title("Lindley: z = 1.96 held fixed")
plt.tight_layout(); plt.show()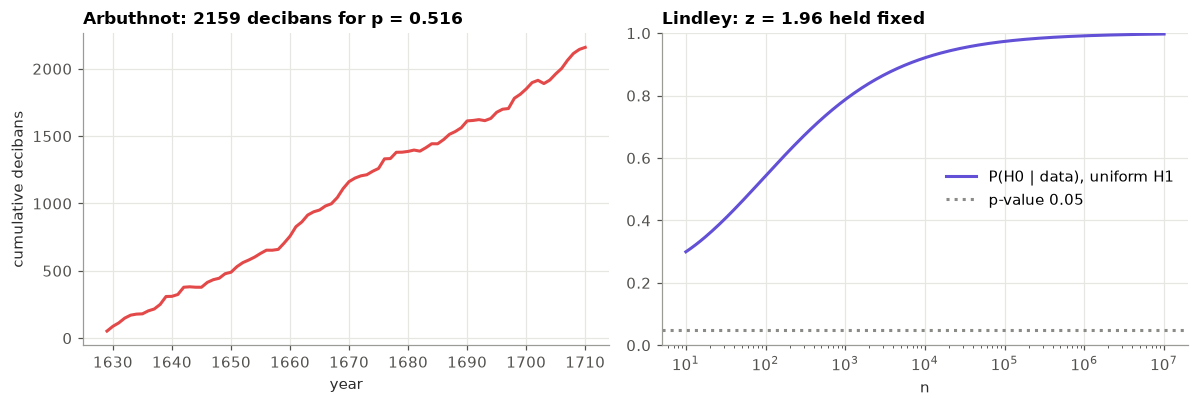
왼쪽: 82년 동안 증거가 해마다 거의 일정하게 쌓인다. Turing의 단위로 한 해에 약 26 deciban, 가능도비 약 400이다. 오른쪽: 유의확률이 0.05로 고정되어도 이 커지면 균등 대립가설에 대한 사후확률은 쪽으로 간다.
4. MCMC — 사후분포에서 뽑기
정리 4.3 상세 균형이면 정상분포 · 정리 4.5 MH는 상세 균형 · 정리 4.7 Gibbs는 받아들임 확률 1의 MH · 명제 4.8 상관 의 Gibbs는 계수 의 AR(1) · 정의 4.9 .
유한한 상태공간에서는 전이핵이 행렬이므로, 정리들을 행렬 계산으로 정확히 확인할 수 있다.
python
# 정리 4.5: 6 개 상태, 정규화하지 않은 목표, 비대칭 제안
pi_u = np.array([1.0, 4.0, 2.0, 7.0, 3.0, 0.5]); pi = pi_u / pi_u.sum(); S = len(pi)
Q = rng.dirichlet(np.ones(S), S)                      # q(x, ·): 아무 제안 행렬
K = np.zeros((S, S))
for i in range(S):
    for j in range(S):
        if i != j: K[i, j] = Q[i, j] * min(1, pi_u[j] * Q[j, i] / (pi_u[i] * Q[i, j]))   # 정규화 상수 없이
    K[i, i] = 1 - K[i].sum()
flow = pi[:, None] * K
# 정리 4.7: 3 × 4 결합분포의 Gibbs — 좌표마다의 핵
P2 = rng.dirichlet(np.ones(12)).reshape(3, 4); states = [(i, j) for i in range(3) for j in range(4)]; idx = {s_: k for k, s_ in enumerate(states)}
K1 = np.zeros((12, 12)); K2 = np.zeros((12, 12))
for (i, j) in states:
    for i2 in range(3): K1[idx[(i, j)], idx[(i2, j)]] = P2[i2, j] / P2[:, j].sum()      # θ1 | θ2
    for j2 in range(4): K2[idx[(i, j)], idx[(i, j2)]] = P2[i, j2] / P2[i, :].sum()      # θ2 | θ1
pv = np.array([P2[s_] for s_ in states])
# Gibbs 단계 = 제안이 완전 조건부분포인 MH: 받아들임 비 = 1
ratios = [pv[b_] * K1[b_, a_] / (pv[a_] * K1[a_, b_]) for a_ in range(12) for b_ in range(12) if K1[a_, b_] > 0 and a_ != b_]
Ksys = K1 @ K2; Krand = (K1 + K2) / 2
rev = lambda M: np.allclose(pv[:, None] * M, (pv[:, None] * M).T)
report({"정리 4.5: MH 핵은 상세 균형 (정규화 상수 없이)": np.allclose(flow, flow.T),
        "정리 4.3: 상세 균형이면 πK = π": np.allclose(pi @ K, pi),
        "정리 4.7: Gibbs 단계의 MH 받아들임 비는 모두 1": np.allclose(ratios, 1),
        "정리 4.7: 각 좌표 단계는 가역, 한 바퀴 K1K2 는 π 를 보존": rev(K1) and rev(K2) and np.allclose(pv @ Ksys, pv),
        "본문: 체계적 순서의 한 바퀴는 가역이 아니다": not rev(Ksys),
        "연습 4.5: 무작위 순서 (K1+K2)/2 는 가역": rev(Krand)})
text
  ✓  정리 4.5: MH 핵은 상세 균형 (정규화 상수 없이)
  ✓  정리 4.3: 상세 균형이면 πK = π
  ✓  정리 4.7: Gibbs 단계의 MH 받아들임 비는 모두 1
  ✓  정리 4.7: 각 좌표 단계는 가역, 한 바퀴 K1K2 는 π 를 보존
  ✓  본문: 체계적 순서의 한 바퀴는 가역이 아니다
  ✓  연습 4.5: 무작위 순서 (K1+K2)/2 는 가역
python
# 연습 4.1: 두 상태 연쇄
a_, b_ = 0.3, 0.1; P = np.array([[1 - a_, a_], [b_, 1 - b_]]); pis = np.array([b_, a_]) / (a_ + b_)
gap = [np.abs(np.linalg.matrix_power(P, k)[0] - pis).max() for k in [5, 10, 20]]
# 연습 4.2: 순환하는 세 상태 연쇄 — 균등이 정상분포지만 가역이 아니다
Pc = np.array([[0, 0.9, 0.1], [0.1, 0, 0.9], [0.9, 0.1, 0]]); u3 = np.ones(3) / 3
# 연습 4.4: 연쇄 평균이 모두 같으면 R̂ = √((n−1)/n)
ch = rng.normal(0, 1, (4, 50)); ch -= ch.mean(1, keepdims=True)
# 연습 4.3: 독립 제안 MH — 목표 t_3, 제안 N(0, 1) (가벼운 꼬리) 대 제안 t_1 (무거운 꼬리)
def indep_mh(logpi, prop, n, seed):
    g = np.random.default_rng(seed); x = 0.0; lw = logpi(x) - prop.logpdf(x); out = np.empty(n)
    for i in range(n):
        y = prop.rvs(random_state=g); lwy = logpi(y) - prop.logpdf(y)
        if math.log(g.random()) < lwy - lw: x, lw = y, lwy     # 받아들임 = min(1, w(y)/w(x))
        out[i] = x
    return out
logt3 = stats.t(3).logpdf
good = indep_mh(logt3, stats.t(1), 30_000, 1); bad = indep_mh(logt3, stats.norm(), 30_000, 1)
def longest_run(v):
    r = m = 1
    for i in range(1, len(v)):
        r = r + 1 if v[i] == v[i - 1] else 1; m = max(m, r)
    return m
print(f"two-state |P^k − π| at k = 5, 10, 20: {np.round(gap, 6)} vs |1−a−b|^k = {[round(0.6 ** k, 6) for k in [5, 10, 20]]}")
print(f"independence MH: KS to t3 good {stats.kstest(good, stats.t(3).cdf).statistic:.3f}; longest stuck run good {longest_run(good)}, bad {longest_run(bad)}")
report({"연습 4.1: 정상분포 (b, a)/(a+b), 상세 균형": np.allclose(pis @ P, pis) and abs(pis[0] * a_ - pis[1] * b_) < 1e-15,
        "연습 4.1: 수렴 속도 |1−a−b|^k": np.allclose([g_ / 0.6 ** k for g_, k in zip(gap, [5, 10, 20])], gap[0] / 0.6 ** 5),
        "연습 4.2: 균등이 정상분포, 상세 균형은 아니다": np.allclose(u3 @ Pc, u3) and not np.allclose(u3[:, None] * Pc, (u3[:, None] * Pc).T),
        "연습 4.4: 연쇄 평균이 같으면 R̂ = √((n−1)/n)": abs(rhat(ch) - math.sqrt(49 / 50)) < 1e-12,
        "연습 4.3: 무거운 꼬리의 제안은 목표에 맞는다": stats.kstest(good, stats.t(3).cdf).statistic < 0.02,
        "연습 4.3: 가벼운 꼬리의 제안은 꼬리에서 오래 갇힌다": longest_run(bad) > 5 * longest_run(good)})
text
two-state |P^k − π| at k = 5, 10, 20: [5.832e-02 4.535e-03 2.700e-05] vs |1−a−b|^k = [0.07776, 0.006047, 3.7e-05]
independence MH: KS to t3 good 0.006; longest stuck run good 7, bad 115
  ✓  연습 4.1: 정상분포 (b, a)/(a+b), 상세 균형
  ✓  연습 4.1: 수렴 속도 |1−a−b|^k
  ✓  연습 4.2: 균등이 정상분포, 상세 균형은 아니다
  ✓  연습 4.4: 연쇄 평균이 같으면 R̂ = √((n−1)/n)
  ✓  연습 4.3: 무거운 꼬리의 제안은 목표에 맞는다
  ✓  연습 4.3: 가벼운 꼬리의 제안은 꼬리에서 오래 갇힌다
명제 4.8. 상관 의 이변량 정규에서 체계적 Gibbs의 열은 계수 의 AR(1)이고, 잡음의 분산은 이다. 따라서 : 에서 .
python
res48 = {}
for rho in [0.5, 0.9, 0.99]:
    g = np.random.default_rng(7); n = 100_000; xch = np.empty(n); y = 0.0; sd = math.sqrt(1 - rho**2)
    for t in range(n):
        xv = g.normal(rho * y, sd); y = g.normal(rho * xv, sd); xch[t] = xv
    xc = xch[1000:]; ar1 = np.corrcoef(xc[:-1], xc[1:])[0, 1]; eta = xc[1:] - rho**2 * xc[:-1]
    res48[rho] = (ar1, eta.var(), ess(xc) / len(xc), (1 - rho**2) / (1 + rho**2))
for rho, (ar1, ev, ratio, th) in res48.items():
    print(f"rho = {rho}: lag-1 {ar1:.4f} (rho² {rho**2:.4f}), noise var {ev:.4f} (1−rho⁴ {1 - rho**4:.4f}), N_eff/N ≈ {ratio:.3f} (theory {th:.3f})")
report({"명제 4.8: 시차 1 자기상관 = ρ²": all(abs(r[0] - rho**2) < 0.01 for rho, r in res48.items()),
        "명제 4.8: 잡음의 분산 = 1 − ρ⁴": all(abs(r[1] / (1 - rho**4) - 1) < 0.02 for rho, r in res48.items()),
        "명제 4.8: N_eff/N ≈ (1−ρ²)/(1+ρ²) (자기상관의 합, 15% 안)": all(abs(r[2] / r[3] - 1) < 0.15 for r in res48.values()),
        "본문: 이론값 0.60, 0.105, 0.010": [round(r[3], 3) for r in res48.values()] == [0.6, 0.105, 0.01]})
text
rho = 0.5: lag-1 0.2508 (rho² 0.2500), noise var 0.9382 (1−rho⁴ 0.9375), N_eff/N ≈ 0.612 (theory 0.600)
rho = 0.9: lag-1 0.8122 (rho² 0.8100), noise var 0.3440 (1−rho⁴ 0.3439), N_eff/N ≈ 0.107 (theory 0.105)
rho = 0.99: lag-1 0.9810 (rho² 0.9801), noise var 0.0394 (1−rho⁴ 0.0394), N_eff/N ≈ 0.010 (theory 0.010)
  ✓  명제 4.8: 시차 1 자기상관 = ρ²
  ✓  명제 4.8: 잡음의 분산 = 1 − ρ⁴
  ✓  명제 4.8: N_eff/N ≈ (1−ρ²)/(1+ρ²) (자기상관의 합, 15% 안)
  ✓  본문: 이론값 0.60, 0.105, 0.010
5. Stein의 역설
보조정리 5.1 · 정리 5.2 · 따름정리 5.3 이면 는 허용적이지 않다 · 정리 5.4 경험적 Bayes: , Bayes 위험 .
은 비중심 카이제곱의 Poisson 혼합으로 정확히 계산된다(연습 5.3).
python
# 보조정리 5.1 · 연습 5.2: 수치 적분으로
th0 = 0.7
lhs = lambda g: integrate.quad(lambda z: (z - th0) * g(z) * stats.norm.pdf(z - th0), -np.inf, np.inf)[0]
rhs = lambda dg: integrate.quad(lambda z: dg(z) * stats.norm.pdf(z - th0), -np.inf, np.inf)[0]
pairs = [(np.sin, np.cos), (lambda z: z**3, lambda z: 3 * z**2), (lambda z: np.log1p(z**2), lambda z: 2 * z / (1 + z**2))]
ok51 = all(abs(lhs(g) - rhs(dg)) < 1e-8 for g, dg in pairs)
m2 = th0**2 + 1; m3 = th0**3 + 3 * th0
m2_num = integrate.quad(lambda z: z**2 * stats.norm.pdf(z - th0), -np.inf, np.inf)[0]
m3_num = integrate.quad(lambda z: z**3 * stats.norm.pdf(z - th0), -np.inf, np.inf)[0]
sign_lhs = 2 * integrate.quad(lambda z: z * stats.norm.pdf(z), 0, np.inf)[0]   # E[Z sign Z] = E|Z|
# 연습 5.1: E[1/χ²_p] = 1/(p−2), p ≤ 2 이면 발산
inv = {p: integrate.quad(lambda v: stats.chi2.pdf(v, p) / v, 0, np.inf)[0] for p in [3, 5, 10]}
div2 = [integrate.quad(lambda v: stats.chi2.pdf(v, 2) / v, eps, 50)[0] for eps in [1e-4, 1e-8]]

def einv(p, t2):
    """E[1/||X||²], X ~ N_p(θ, I), ||θ||² = t2 : Poisson(t2/2) 로 섞은 1/(p − 2 + 2K) 의 평균"""
    k = np.arange(0, 2000); return np.sum(stats.poisson.pmf(k, t2 / 2) / (p + 2 * k - 2))
def js_risk(p, t2): return p - (p - 2) ** 2 * einv(p, t2)
R10 = [js_risk(10, t2) for t2 in [0, 10, 100]]
# 정리 5.2: 몬테카를로와 대조 (p = 10, ||θ||² = 10)
p = 10; th = np.zeros(p); th[0] = math.sqrt(10); X = th + rng.standard_normal((200_000, p)); n2 = np.sum(X**2, 1)
loss = np.sum(((1 - (p - 2) / n2)[:, None] * X - th) ** 2, 1)
grid_t = np.linspace(0, 400, 81)
print(f"JS risk p = 10 at ||θ||² = 0, 10, 100: {np.round(R10, 2)};  MC at 10: {loss.mean():.3f} ± {loss.std() / math.sqrt(len(loss)):.3f}")
report({"보조정리 5.1: sin, z³, log(1+z²) 에서 등식": ok51,
        "연습 5.2 (a): EZ² = θ²+1, EZ³ = θ³+3θ": abs(m2 - m2_num) < 1e-8 and abs(m3 - m3_num) < 1e-8,
        "연습 5.2 (b): g = sign 이면 E|Z| = 0.80 ≠ E g' = 0": round(sign_lhs, 2) == 0.80,
        "연습 5.1: E[1/χ²_p] = 1/(p−2)": all(abs(v - 1 / (p_ - 2)) < 1e-8 for p_, v in inv.items()),
        "연습 5.1: p = 2 이면 발산 (ε 을 줄이면 계속 커진다)": div2[1] - div2[0] > 4,
        "정리 5.2: 정확한 위험 = 몬테카를로": within(loss.mean(), R10[1], loss.std() / math.sqrt(len(loss))),
        "본문: θ = 0 에서 위험 2, ||θ||² = 10, 100 에서 6.21, 9.40": np.allclose(np.round(R10, 2), [2.0, 6.21, 9.40]),
        "따름정리 5.3: 모든 ||θ|| 에서 위험 < p (p = 3, 10, 50)": all(js_risk(pp, t) < pp for pp in [3, 10, 50] for t in grid_t)})
text
JS risk p = 10 at ||θ||² = 0, 10, 100: [2.   6.21 9.4 ];  MC at 10: 6.221 ± 0.006
  ✓  보조정리 5.1: sin, z³, log(1+z²) 에서 등식
  ✓  연습 5.2 (a): EZ² = θ²+1, EZ³ = θ³+3θ
  ✓  연습 5.2 (b): g = sign 이면 E|Z| = 0.80 ≠ E g' = 0
  ✓  연습 5.1: E[1/χ²_p] = 1/(p−2)
  ✓  연습 5.1: p = 2 이면 발산 (ε 을 줄이면 계속 커진다)
  ✓  정리 5.2: 정확한 위험 = 몬테카를로
  ✓  본문: θ = 0 에서 위험 2, ||θ||² = 10, 100 에서 6.21, 9.40
  ✓  따름정리 5.3: 모든 ||θ|| 에서 위험 < p (p = 3, 10, 50)
python
# 연습 5.3: Jensen 상한과 선형 축소 하한의 차이 < 4
gap = max(p_ - (p_ - 2) ** 2 / (p_ + t) - p_ * t / (p_ + t) for p_ in [3, 10, 50, 500] for t in grid_t)
jensen = all(js_risk(p_, t) <= p_ - (p_ - 2) ** 2 / (p_ + t) + 1e-12 for p_ in [3, 10, 50] for t in grid_t)
# 연습 5.4: 양의 부분이 지배 (같은 난수로)
dom = []
for p_, t in [(3, 0.0), (3, 2.0), (10, 0.0), (10, 5.0)]:   # ||X||² < p−2 가 드물지 않은 θ
    th = np.zeros(p_); th[0] = math.sqrt(t); X = th + rng.standard_normal((200_000, p_)); n2 = np.sum(X**2, 1)
    l_js = np.sum(((1 - (p_ - 2) / n2)[:, None] * X - th) ** 2, 1); l_jp = np.sum((np.maximum(0, 1 - (p_ - 2) / n2)[:, None] * X - th) ** 2, 1)
    dd = l_js - l_jp; dom.append(dd.mean() - 4 * dd.std() / math.sqrt(len(dd)) > 0)   # 표본마다가 아니라 위험(평균)에서
# 연습 5.5: σ 를 모를 때 — ν S²/σ² ~ χ²_ν 독립
p_, nu, sig = 8, 6, 2.0; th = rng.normal(0, 1.5, p_)
X = th + sig * rng.standard_normal((200_000, p_)); S2u = sig**2 * rng.chisquare(nu, 200_000) / nu
a5 = (p_ - 2) * nu / (nu + 2); l55 = np.sum(((1 - a5 * S2u / np.sum(X**2, 1))[:, None] * X - th) ** 2, 1); bound55 = p_ * sig**2
# 정리 5.4: 경험적 Bayes — θ_i ~ N(0, τ²)
p_, tau2 = 10, 1.5; Bsh = 1 / (1 + tau2); R = 200_000
TH = rng.normal(0, math.sqrt(tau2), (R, p_)); X = TH + rng.standard_normal((R, p_)); n2 = np.sum(X**2, 1)
eb = (p_ - 2) / n2; l_js = np.sum(((1 - eb)[:, None] * X - TH) ** 2, 1); l_b = np.sum(((1 - Bsh) * X - TH) ** 2, 1)
slope = np.polyfit(X.ravel(), TH.ravel(), 1)[0]
print(f"E[(p−2)/||X||²] = {eb.mean():.4f} (B = {Bsh:.4f});  Bayes risk JS {l_js.mean():.3f} (theory {p_ * (1 - Bsh) + 2 * Bsh:.3f}), Bayes {l_b.mean():.3f} (theory {p_ * (1 - Bsh):.3f})")
print(f"unknown σ: risk {l55.mean():.2f} < p σ² = {bound55:.0f};  regression slope of θ on X {slope:.4f} (τ²/(1+τ²) = {tau2 / (1 + tau2):.4f})")
report({"연습 5.3: Jensen 상한이 성립": jensen,
        "연습 5.3: 상한 − 선형 축소 하한 < 4": gap < 4,
        "연습 5.4: 양의 부분 James–Stein 의 위험이 더 작다 (네 θ 에서)": all(dom),
        "연습 5.5: σ 를 모르는 축소의 위험 < p σ²": l55.mean() + 4 * l55.std() / math.sqrt(len(l55)) < bound55,
        "정리 5.4 (b): E[(p−2)/||X||²] = B": within(eb.mean(), Bsh, eb.std() / math.sqrt(R)),
        "정리 5.4 (c): James–Stein 의 Bayes 위험 = p(1−B) + 2B": within(l_js.mean(), p_ * (1 - Bsh) + 2 * Bsh, l_js.std() / math.sqrt(R)),
        "정리 5.4 (a): Bayes 위험 = p(1−B)": within(l_b.mean(), p_ * (1 - Bsh), l_b.std() / math.sqrt(R)),
        "Galton (Stigler 1990): θ 를 X 에 회귀한 기울기 = 1 − B": abs(slope - (1 - Bsh)) < 0.005})
text
E[(p−2)/||X||²] = 0.4012 (B = 0.4000);  Bayes risk JS 6.803 (theory 6.800), Bayes 5.998 (theory 6.000)
unknown σ: risk 20.19 < p σ² = 32;  regression slope of θ on X 0.5996 (τ²/(1+τ²) = 0.6000)
  ✓  연습 5.3: Jensen 상한이 성립
  ✓  연습 5.3: 상한 − 선형 축소 하한 < 4
  ✓  연습 5.4: 양의 부분 James–Stein 의 위험이 더 작다 (네 θ 에서)
  ✓  연습 5.5: σ 를 모르는 축소의 위험 < p σ²
  ✓  정리 5.4 (b): E[(p−2)/||X||²] = B
  ✓  정리 5.4 (c): James–Stein 의 Bayes 위험 = p(1−B) + 2B
  ✓  정리 5.4 (a): Bayes 위험 = p(1−B)
  ✓  Galton (Stigler 1990): θ 를 X 에 회귀한 기울기 = 1 − B
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
ax = axes[0]; tt = np.linspace(0, 60, 121)
for p_, col in [(3, C["data"]), (10, C["stat"]), (50, C["key"])]:
    ax.plot(tt, [js_risk(p_, t) / p_ for t in tt], color=col, label=f"p = {p_}")
ax.axhline(1, color=C["hist"], ls=":", label="X (MLE)")
ax.set_xlabel("||θ||²"); ax.set_ylabel("risk / p"); ax.legend(); ax.set_title("James–Stein risk relative to X")
ax = axes[1]; idx_ = rng.choice(R, 300, replace=False)
ax.scatter(X[idx_, 0], TH[idx_, 0], s=8, color=C["data"], alpha=0.5)
u = np.linspace(-5, 5, 2); ax.plot(u, u, color=C["hist"], label="θ̂ = X"); ax.plot(u, (1 - Bsh) * u, color=C["key"], label=f"E(θ|X) = {1 - Bsh:.2f} X")
ax.set_xlabel("X"); ax.set_ylabel("θ"); ax.legend(); ax.set_title("shrinkage is Galton's regression")
plt.tight_layout(); plt.show()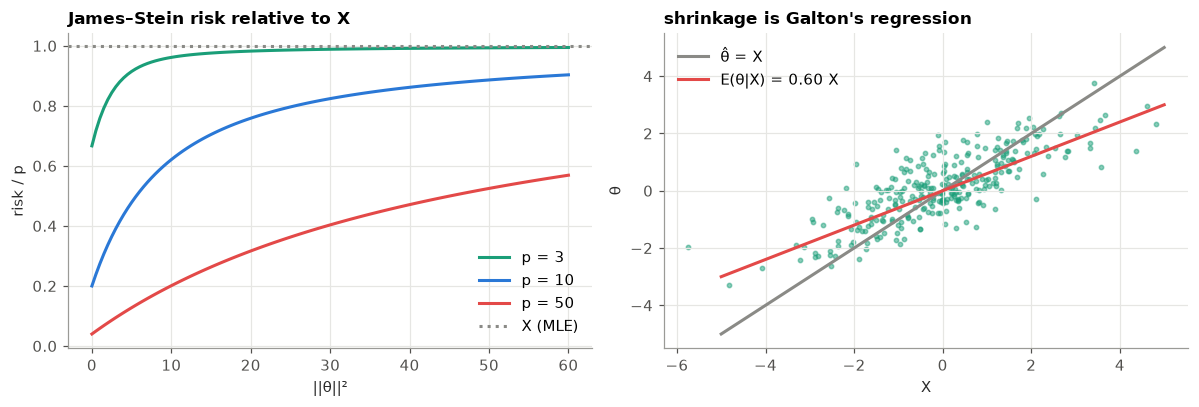
왼쪽: 차원이 클수록 원점 근처에서 위험의 비가 작다(에서 위험은 차원과 무관하게 2). 오른쪽: 를 에 회귀한 직선의 기울기가 이다.
6. Efron–Morris의 타율
예제 6.1 18명의 타율과 James–Stein · 명제 6.2 계층 정규모형의 완전 조건부분포.
는 1970년 첫 45타석의 타율, 는 그 시즌 나머지의 타율이다. 를 모든 선수에 쓴다.
python
y = EM.y.to_numpy(float); ptrue = EM.p.to_numpy(float); k = len(y); ybar = y.mean()
s2 = ybar * (1 - ybar) / 45; SSy = np.sum((y - ybar) ** 2)
c = 1 - (k - 3) * s2 / SSy; js = ybar + c * (y - ybar)
tse_mle, tse_js = np.sum((y - ptrue) ** 2), np.sum((js - ptrue) ** 2)
better = np.abs(js - ptrue) < np.abs(y - ptrue); worse = EM.name[~better].tolist()
tab = pd.DataFrame({"player": EM.name, "y": y.round(3), "JS": js.round(3), "p": ptrue.round(3)})
print(tab.to_string(index=False))
print(f"ybar {ybar:.4f}, sigma² {s2:.6f}, SS {SSy:.4f}, c {c:.3f};  TSE: y {tse_mle:.4f}, JS {tse_js:.4f} (ratio {tse_mle / tse_js:.2f}); JS better for {better.sum()}/18, worse: {worse}")
# 노트의 표 (예제 6.1) — 소수 셋째 자리
note_js = {"Roberto Clemente": .294, "Frank Robinson": .289, "Frank Howard": .285, "Jay Johnstone": .280, "Ken Berry": .275, "Jim Spencer": .275,
           "Don Kessinger": .270, "Luis Alvarado": .266, "Ron Santo": .261, "Ron Swoboda": .261, "Del Unser": .256, "Billy Williams": .256,
           "George Scott": .256, "Rico Petrocelli": .256, "Ellie Rodriguez": .256, "Bert Campaneris": .252, "Thurman Munson": .247, "Max Alvis": .242}
# 분산안정화 변환 (Efron–Morris 가 실제로 쓴 척도)
xa = math.sqrt(45) * np.arcsin(2 * y - 1); tha = math.sqrt(45) * np.arcsin(2 * ptrue - 1)
ca = 1 - (k - 3) / np.sum((xa - xa.mean()) ** 2); ja = xa.mean() + ca * (xa - xa.mean())
ratio_a = np.sum((xa - tha) ** 2) / np.sum((ja - tha) ** 2)
# 연습 6.2: 적률추정량
tau2_hat = max(0.0, SSy / (k - 1) - s2)
print(f"arcsine: c {ca:.3f}, ratio {ratio_a:.2f};  exercise 6.2: tau² hat {tau2_hat:.6f}, tau hat {math.sqrt(tau2_hat):.3f}")
report({"예제 6.1: ȳ 0.2654, σ² 0.004332, Σ(y−ȳ)² 0.0825, c 0.212": (round(ybar, 4), round(s2, 6), round(SSy, 4), round(c, 3)) == (0.2654, 0.004332, 0.0825, 0.212),
        "예제 6.1: 노트의 표 = 계산 (18명)": all(round(v, 3) == note_js[nm] for nm, v in zip(EM.name, js)),
        "예제 6.1: 제곱오차 0.0754 대 0.0213, 3.5배": round(tse_mle, 4) == 0.0754 and round(tse_js, 4) == 0.0213 and round(tse_mle / tse_js, 1) == 3.5,
        "예제 6.1: 16명에서 JS 가 낫고 Swoboda, Rodriguez 만 나빠진다": better.sum() == 16 and sorted(worse) == ["Ellie Rodriguez", "Ron Swoboda"],
        "연습 6.1: Clemente .294 (실제 .346), Munson .247 (실제 .316)": round(js[0], 3) == 0.294 and round(js[16], 3) == 0.247 and EM.name[16] == "Thurman Munson",
        "본문: 분산안정화 척도에서 c 0.209, 비 3.52": round(ca, 3) == 0.209 and round(ratio_a, 2) == 3.52,
        "연습 6.2: τ̂² = 0.000521, τ̂ = 0.023": round(tau2_hat, 6) == 0.000521 and round(math.sqrt(tau2_hat), 3) == 0.023})
text
          player     y    JS     p
Roberto Clemente 0.400 0.294 0.346
  Frank Robinson 0.378 0.289 0.298
    Frank Howard 0.356 0.285 0.276
   Jay Johnstone 0.333 0.280 0.222
       Ken Berry 0.311 0.275 0.273
     Jim Spencer 0.311 0.275 0.270
   Don Kessinger 0.289 0.270 0.263
   Luis Alvarado 0.267 0.266 0.210
       Ron Santo 0.244 0.261 0.269
     Ron Swoboda 0.244 0.261 0.230
       Del Unser 0.222 0.256 0.264
  Billy Williams 0.222 0.256 0.256
    George Scott 0.222 0.256 0.303
 Rico Petrocelli 0.222 0.256 0.264
 Ellie Rodriguez 0.222 0.256 0.226
 Bert Campaneris 0.200 0.252 0.285
  Thurman Munson 0.178 0.247 0.316
       Max Alvis 0.156 0.242 0.200
ybar 0.2654, sigma² 0.004332, SS 0.0825, c 0.212;  TSE: y 0.0754, JS 0.0213 (ratio 3.54); JS better for 16/18, worse: ['Ron Swoboda', 'Ellie Rodriguez']
arcsine: c 0.209, ratio 3.52;  exercise 6.2: tau² hat 0.000521, tau hat 0.023
  ✓  예제 6.1: ȳ 0.2654, σ² 0.004332, Σ(y−ȳ)² 0.0825, c 0.212
  ✓  예제 6.1: 노트의 표 = 계산 (18명)
  ✓  예제 6.1: 제곱오차 0.0754 대 0.0213, 3.5배
  ✓  예제 6.1: 16명에서 JS 가 낫고 Swoboda, Rodriguez 만 나빠진다
  ✓  연습 6.1: Clemente .294 (실제 .346), Munson .247 (실제 .316)
  ✓  본문: 분산안정화 척도에서 c 0.209, 비 3.52
  ✓  연습 6.2: τ̂² = 0.000521, τ̂ = 0.023
명제 6.2와 Gibbs 표집. 세 완전 조건부분포를 차례로 뽑는다. 흩어진 출발점의 연쇄 4개를 각 6000번, 처음 1000번을 버린다. 먼저 의 완전 조건부분포(역감마)를 격자 위의 수치 계산과 대조한다.
python
# 명제 6.2: τ² | θ, μ ~ 역감마((k−1)/2, SS/2) — τ 에 평평한 사전분포를 τ² 로 옮긴 격자 계산과 대조
th_ = rng.normal(0.265, 0.03, k); mu_ = 0.266; SS_ = np.sum((th_ - mu_) ** 2)
t2g = np.linspace(1e-6, 0.01, 200_001)
dens = t2g ** (-k / 2) * np.exp(-SS_ / (2 * t2g)) * t2g ** -0.5      # τ^{-k} e^{-SS/2τ²} × dτ/dτ²
dens /= np.trapezoid(dens, t2g)
err_ig = np.max(np.abs(dens - stats.invgamma.pdf(t2g, (k - 1) / 2, scale=SS_ / 2))) / dens.max()
# 주변 가능도: y_i | μ, τ ~ N(μ, σ² + τ²)
mu0, tau0 = 0.26, 0.03; ysim = rng.normal(mu0, tau0, 400_000) + rng.normal(0, math.sqrt(s2), 400_000)

def gibbs_hb(seed, n_iter, burn=0, improper=False, fixed_init=False):
    g = np.random.default_rng(seed)
    if fixed_init: mu, tau2 = 0.27, 0.001
    else: mu, tau2 = g.normal(0.27, 0.05), g.uniform(0.0005, 0.01)
    shape = k / 2 if improper else (k - 1) / 2
    th_o, mu_o, tau_o = [], [], []
    for it in range(n_iter):
        v = 1 / (1 / s2 + 1 / tau2); m = v * (y / s2 + mu / tau2); th = g.normal(m, math.sqrt(v))
        mu = g.normal(th.mean(), math.sqrt(tau2 / k))
        ss = np.sum((th - mu) ** 2); tau2 = 1 / g.gamma(shape, 2 / ss)
        if it >= burn: th_o.append(th); mu_o.append(mu); tau_o.append(math.sqrt(tau2))
    return np.array(th_o), np.array(mu_o), np.array(tau_o)

res = [gibbs_hb(s, 6000, 1000) for s in range(4)]
mu_ch = np.array([r[1] for r in res]); tau_ch = np.array([r[2] for r in res])
th_post = np.concatenate([r[0] for r in res]).mean(axis=0)
tse_hb = np.sum((th_post - ptrue) ** 2); maxdiff = np.max(np.abs(th_post - js))
print(f"Gibbs: Rhat mu {rhat(mu_ch):.4f}, tau {rhat(tau_ch):.4f}; posterior mean mu {mu_ch.mean():.4f}, median tau {np.median(tau_ch):.4f}")
print(f"HB: TSE {tse_hb:.4f}, max |HB − JS| {maxdiff:.4f}")
report({"명제 6.2: τ² 의 완전 조건부분포 = 역감마 (격자)": err_ig < 1e-4,
        "명제 6.2: 주변분포 y ~ N(μ, σ² + τ²)": within(ysim.var(), s2 + tau0**2, ysim.var() * math.sqrt(2 / len(ysim))),
        "본문: R̂ = 1.000 (μ, τ)": round(rhat(mu_ch), 3) == 1.000 and round(rhat(tau_ch), 3) == 1.000,
        "본문: μ 의 사후평균 0.2656, τ 의 사후중앙값 0.0298": round(mu_ch.mean(), 4) == 0.2656 and round(np.median(tau_ch), 4) == 0.0298,
        "본문: 계층 Bayes 의 제곱오차 0.0213 = JS, 최대 차이 0.0006": round(tse_hb, 4) == 0.0213 and round(maxdiff, 4) == 0.0006})
text
Gibbs: Rhat mu 1.0002, tau 0.9999; posterior mean mu 0.2656, median tau 0.0298
HB: TSE 0.0213, max |HB − JS| 0.0006
  ✓  명제 6.2: τ² 의 완전 조건부분포 = 역감마 (격자)
  ✓  명제 6.2: 주변분포 y ~ N(μ, σ² + τ²)
  ✓  본문: R̂ = 1.000 (μ, τ)
  ✓  본문: μ 의 사후평균 0.2656, τ 의 사후중앙값 0.0298
  ✓  본문: 계층 Bayes 의 제곱오차 0.0213 = JS, 최대 차이 0.0006
python
# 같은 사후분포를 주변 가능도의 Metropolis 로: (μ, log τ), 사전분포 τ 에 평평 → log τ 의 야코비안 +log τ
def logpost(mu, lt):
    v = s2 + math.exp(2 * lt); return -0.5 * np.sum(np.log(v) + (y - mu) ** 2 / v) + lt
def mh2(seed, n_iter=20_000, step=(0.01, 0.5)):
    g = np.random.default_rng(seed); xv = np.array([g.normal(0.27, 0.03), g.normal(math.log(0.03), 1)]); lp = logpost(*xv); out = []; acc = 0
    for _ in range(n_iter):
        prop = xv + g.normal(0, 1, 2) * step; lpp = logpost(*prop)
        if math.log(g.random()) < lpp - lp: xv, lp = prop, lpp; acc += 1
        out.append(xv.copy())
    return np.array(out)[2000:], acc / n_iter
mres = [mh2(10 + s) for s in range(4)]
mu_mh = np.array([r[0][:, 0] for r in mres]); lt_mh = np.array([r[0][:, 1] for r in mres]); accs = [r[1] for r in mres]
print(f"MH: acceptance {np.round(accs, 2)}, Rhat mu {rhat(mu_mh):.4f}, log tau {rhat(lt_mh):.4f}; mean mu {mu_mh.mean():.4f}, median tau {np.median(np.exp(lt_mh)):.4f}")
# 연습 6.4: π(μ, τ) ∝ 1/τ 이면 비정칙 — h(τ) = ∫ ∏ φ(y_i; μ, σ²+τ²) dμ 의 τ → 0 극한이 양수
def h(t):
    v = s2 + t**2; return math.sqrt(2 * math.pi * v / k) * np.exp(-0.5 * np.sum((y - ybar) ** 2) / v - 0.5 * k * np.log(2 * math.pi * v))
int_eps = [integrate.quad(lambda t: h(t) / t, eps, 0.2, limit=200)[0] / h(0) for eps in [1e-3, 1e-6, 1e-9]]
print(f"exercise 6.4: ∫_eps^0.2 h/τ dτ / h(0) for eps = 1e-3, 1e-6, 1e-9: {np.round(int_eps, 2)}")
report({"본문: 받아들임 비율 0.69": all(round(a_, 2) == 0.69 for a_ in accs),
        "본문: R̂ 1.000 (μ), 1.003 (log τ)": round(rhat(mu_mh), 3) == 1.000 and round(rhat(lt_mh), 3) == 1.003,
        "본문: μ 0.2659, τ 의 사후중앙값 0.0286": round(mu_mh.mean(), 4) == 0.2659 and round(np.median(np.exp(lt_mh)), 4) == 0.0286,
        "Gibbs 와 MH 의 μ 가 몬테카를로 오차 안에서 같다": abs(mu_mh.mean() - mu_ch.mean()) < 0.002,
        "연습 6.4: 1/τ 사전분포에서 적분이 log(1/ε) 처럼 발산": abs((int_eps[2] - int_eps[1]) - math.log(1e3)) < 0.05})
text
MH: acceptance [0.69 0.69 0.69 0.69], Rhat mu 1.0003, log tau 1.0027; mean mu 0.2659, median tau 0.0286
exercise 6.4: ∫_eps^0.2 h/τ dτ / h(0) for eps = 1e-3, 1e-6, 1e-9: [ 4.12 11.03 17.94]
  ✓  본문: 받아들임 비율 0.69
  ✓  본문: R̂ 1.000 (μ), 1.003 (log τ)
  ✓  본문: μ 0.2659, τ 의 사후중앙값 0.0286
  ✓  Gibbs 와 MH 의 μ 가 몬테카를로 오차 안에서 같다
  ✓  연습 6.4: 1/τ 사전분포에서 적분이 log(1/ε) 처럼 발산
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
ax = axes[0]
for yi, ji, pi_ in zip(y, js, ptrue):
    ax.plot([yi, ji], [2, 1], color=C["stat"], lw=0.8); ax.plot([ji, pi_], [1, 0], color=C["hist"], lw=0.7, ls=":")
ax.plot(y, np.full(k, 2), "o", color=C["data"]); ax.plot(js, np.ones(k), "o", color=C["key"]); ax.plot(ptrue, np.zeros(k), "o", color=C["ink"])
ax.set_yticks([0, 1, 2]); ax.set_yticklabels(["rest of season", "James–Stein", "first 45 AB"]); ax.set_xlabel("batting average")
ax.set_title("Efron–Morris 1975")
ax = axes[1]; bins = np.linspace(0, 0.14, 57)
ax.hist(tau_ch.ravel(), bins=bins, density=True, color=C["stat"], alpha=0.45, label="Gibbs")
hm, edges = np.histogram(np.exp(lt_mh.ravel()), bins=bins, density=True)
ax.plot((edges[1:] + edges[:-1]) / 2, hm, color=C["key"], label="Metropolis (marginal)")
ax.set_xlabel("τ"); ax.legend(); ax.set_title("posterior of τ")
plt.tight_layout(); plt.show()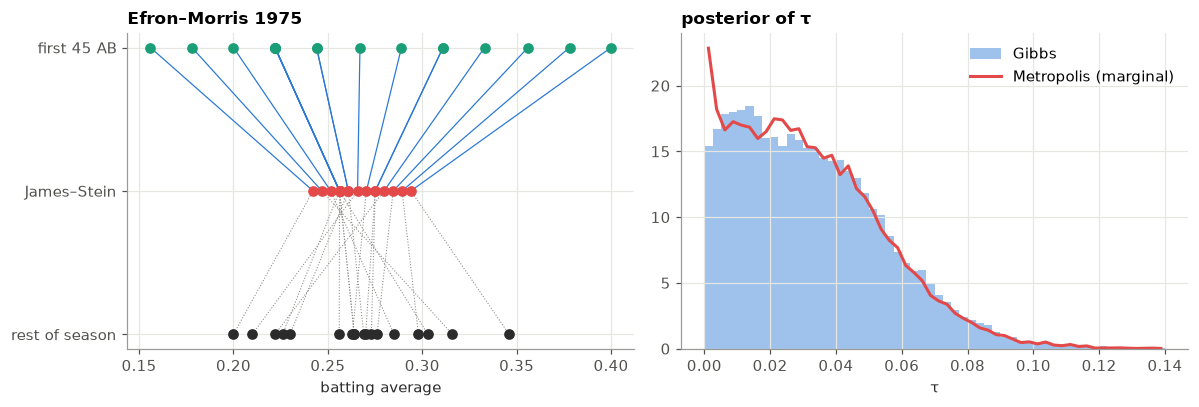
7. 베이즈가 실패할 때
주의 1 비정칙 사후분포에서도 Gibbs는 돈다 · 주의 2 은 갇힌 연쇄를 보지 못한다 · 제안 폭과 ESS · 계산 코드의 점검 (SBC) · 주의 3 합계의 위험과 개별 위험.
python
# 주의 1: π(τ²) ∝ 1/τ² 이면 τ² 의 완전 조건부분포는 역감마(k/2, SS/2) 로 정칙이지만 결합 사후분포는 비정칙
lt_prop = np.log10(gibbs_hb(2026, 20_000, fixed_init=True)[2])
lt_imp = np.log10(gibbs_hb(2026, 20_000, improper=True, fixed_init=True)[2])
print(f"proper: median log10 tau {np.median(lt_prop):.2f};  improper: median {np.median(lt_imp):.2f}, frac tau < 1e-4 {np.mean(lt_imp < -4):.3f}, min {lt_imp.min():.1f}")
# 주의 2: 봉우리 둘
def bimodal(d): return lambda x: np.logaddexp(stats.norm.logpdf(x, -d, 1), stats.norm.logpdf(x, d, 1)) + math.log(0.5)
r_split3 = rhat(np.array([mh1(bimodal(3), x0, 0.5, 5000, s)[0] for s, x0 in enumerate([-3.0, -3.0, 3.0, 3.0])]))
ch4 = np.array([mh1(bimodal(3), x0, 4.0, 5000, 10 + s)[0] for s, x0 in enumerate([-3.0, -3.0, 3.0, 3.0])])
ch6 = np.array([mh1(bimodal(6), -6.0, 0.5, 5000, 20 + s)[0] for s in range(4)])
r_split6 = rhat(np.array([mh1(bimodal(6), x0, 0.5, 5000, s)[0] for s, x0 in enumerate([-6.0, -6.0, 6.0, 6.0])]))
print(f"d = 3: split start Rhat {r_split3:.2f}; step 4 Rhat {rhat(ch4):.4f}, mean {ch4.mean():.3f}")
print(f"d = 6: same start Rhat {rhat(ch6):.3f}, mean {ch6.mean():.2f}; split start Rhat {r_split6:.1f}")
report({"주의 1: 비정칙이면 τ 의 중앙값 10^-8, 85% 가 10^-4 아래, 최소 10^-15": round(np.median(lt_imp)) == -8 and round(np.mean(lt_imp < -4), 2) == 0.85 and round(lt_imp.min()) == -15,
        "주의 1: 정칙이면 중앙값 10^-1.54 = 0.029": round(np.median(lt_prop), 2) == -1.54 and round(10 ** np.median(lt_prop), 3) == 0.029,
        "주의 2: d = 3, 흩어진 출발 R̂ 1.21": round(r_split3, 2) == 1.21,
        "주의 2: 걸음 폭 4 이면 R̂ 1.0006, 평균 −0.015": round(rhat(ch4), 4) == 1.0006 and round(ch4.mean(), 3) == -0.015,
        "주의 2: d = 6, 같은 출발이면 R̂ 1.001 인데 평균 −6.04": round(rhat(ch6), 3) == 1.001 and round(ch6.mean(), 2) == -6.04,
        "주의 2: d = 6, 흩어진 출발이면 R̂ 6.9": round(r_split6, 1) == 6.9})
text
proper: median log10 tau -1.54; improper: median -8.00, frac tau < 1e-4 0.851, min -15.3text
d = 3: split start Rhat 1.21; step 4 Rhat 1.0006, mean -0.015
d = 6: same start Rhat 1.001, mean -6.04; split start Rhat 6.9
  ✓  주의 1: 비정칙이면 τ 의 중앙값 10^-8, 85% 가 10^-4 아래, 최소 10^-15
  ✓  주의 1: 정칙이면 중앙값 10^-1.54 = 0.029
  ✓  주의 2: d = 3, 흩어진 출발 R̂ 1.21
  ✓  주의 2: 걸음 폭 4 이면 R̂ 1.0006, 평균 −0.015
  ✓  주의 2: d = 6, 같은 출발이면 R̂ 1.001 인데 평균 −6.04
  ✓  주의 2: d = 6, 흩어진 출발이면 R̂ 6.9
python
# 제안 폭과 ESS: N(0,1) 을 2만 번
tab_scale = {}
for step in [0.1, 2.4, 20]:
    xs_, a_ = mh1(lambda x: -0.5 * x * x, 0.0, step, 20_000, 7); tab_scale[step] = (round(a_, 2), round(ess(xs_)))
print("step: (acceptance, ESS)", tab_scale)
# 연습 7.3: 걸음 폭의 양 극단에서 시차 1 자기상관 → 1
def lag1(step):
    xs_ = mh1(lambda x: -0.5 * x * x, 0.0, step, 20_000, 3)[0]; return np.corrcoef(xs_[:-1], xs_[1:])[0, 1]
l1 = {s_: round(lag1(s_), 3) for s_ in [0.01, 2.4, 200]}
print("lag-1 autocorrelation:", l1)
# 계산 코드의 점검 (SBC): Beta(2,2), n = 20, L = 99, 5000 번
def sbc(post_ab, reps=5000, L=99, n=20, seed=2018):
    g = np.random.default_rng(seed); ranks = np.empty(reps, int)
    for r in range(reps):
        p = g.beta(2, 2); s = g.binomial(n, p); a_, b_ = post_ab(s, n); ranks[r] = np.sum(g.beta(a_, b_, L) < p)
    cnt = np.bincount(ranks // 10, minlength=10); return cnt, stats.chisquare(cnt).pvalue
cnt_ok, p_ok = sbc(lambda s, n: (2 + s, 2 + n - s))
cnt_dbl, p_dbl = sbc(lambda s, n: (2 + 2 * s, 2 + 2 * (n - s)))
cnt_pri, p_pri = sbc(lambda s, n: (1 + s, 1 + n - s))
print(f"SBC correct {cnt_ok} p = {p_ok:.2f};  double-count {cnt_dbl} p = {p_dbl:.1e};  wrong prior p = {p_pri:.2f}")
report({"표: 받아들임 비율 0.97, 0.44, 0.07": [v[0] for v in tab_scale.values()] == [0.97, 0.44, 0.07],
        "표: 유효 표본 크기 45, 5011, 941": [v[1] for v in tab_scale.values()] == [45, 5011, 941],
        "연습 7.3: 두 극단에서 시차 1 자기상관이 0.95 이상, 중간에서는 작다": l1[0.01] > 0.95 and l1[200] > 0.95 and l1[2.4] < 0.8,
        "SBC: 올바른 코드의 유의확률 0.15": round(p_ok, 2) == 0.15,
        "SBC: 두 번 센 코드는 양 끝 839, 883 의 U 자, 유의확률 10^-146": cnt_dbl[0] == 839 and cnt_dbl[-1] == 883 and round(math.log10(p_dbl)) == -146,
        "SBC: 사전분포 Beta(1,1) 오류는 잡지 못한다 (유의확률 0.56)": round(p_pri, 2) == 0.56})
text
step: (acceptance, ESS) {0.1: (0.97, 45), 2.4: (0.44, 5011), 20: (0.07, 941)}
lag-1 autocorrelation: {0.01: np.float64(1.0), 2.4: np.float64(0.633), 200: np.float64(0.993)}
SBC correct [495 473 487 487 475 534 486 551 485 527] p = 0.15;  double-count [839 512 349 379 377 361 385 416 499 883] p = 1.4e-146;  wrong prior p = 0.56
  ✓  표: 받아들임 비율 0.97, 0.44, 0.07
  ✓  표: 유효 표본 크기 45, 5011, 941
  ✓  연습 7.3: 두 극단에서 시차 1 자기상관이 0.95 이상, 중간에서는 작다
  ✓  SBC: 올바른 코드의 유의확률 0.15
  ✓  SBC: 두 번 센 코드는 양 끝 839, 883 의 U 자, 유의확률 10^-146
  ✓  SBC: 사전분포 Beta(1,1) 오류는 잡지 못한다 (유의확률 0.56)
python
# 주의 3 · 연습 7.2: θ = (a, 0, …, 0) 에서 합계의 위험과 첫 성분의 위험
g = np.random.default_rng(1977); comp = {}
for p_, a_ in [(10, 5), (50, 5), (50, 10)]:
    th = np.zeros(p_); th[0] = a_; X = th + g.standard_normal((200_000, p_)); n2 = np.sum(X**2, 1)
    est = (1 - (p_ - 2) / n2)[:, None] * X
    comp[(p_, a_)] = (np.mean(np.sum((est - th) ** 2, 1)), np.mean((est[:, 0] - a_) ** 2))
for key, (tot, c1) in comp.items(): print(f"p = {key[0]}, a = {key[1]}: total {tot:.2f}, first component {c1:.2f}")
# p → ∞ 이면 첫 성분의 위험 → a²
th = np.zeros(2000); th[0] = 5; X = th + g.standard_normal((20_000, 2000)); n2 = np.sum(X**2, 1)
c1_big = np.mean(((1 - 1998 / n2) * X[:, 0] - 5) ** 2)
# 연습 7.1: Haldane 사후분포 Beta(s, n−s) 의 평균 = s/n
report({"주의 3: p = 50, a = 5 에서 합계 18.1, 첫 성분 11.2": round(comp[(50, 5)][0], 1) == 18.1 and round(comp[(50, 5)][1], 1) == 11.2,
        "연습 7.2: 축소 인자 ≈ (a²+1)/(p+a²) = 0.35": round((25 + 1) / (50 + 25), 2) == 0.35,
        "연습 7.2: p = 2000 이면 첫 성분의 위험이 a² = 25 에 가깝다": abs(c1_big - 25) < 1.5,
        "연습 7.2: 합계 위험 ≤ a² + 4": all(tot <= key[1] ** 2 + 4 for key, (tot, c1) in comp.items()),
        "연습 7.1: Beta(s, n−s) 의 평균 = s/n": abs(stats.beta.mean(7, 13) - 7 / 20) < 1e-15})
text
p = 10, a = 5: total 7.96, first component 2.68
p = 50, a = 5: total 18.14, first component 11.24
p = 50, a = 10: total 34.28, first component 11.72
text
  ✓  주의 3: p = 50, a = 5 에서 합계 18.1, 첫 성분 11.2
  ✓  연습 7.2: 축소 인자 ≈ (a²+1)/(p+a²) = 0.35
  ✓  연습 7.2: p = 2000 이면 첫 성분의 위험이 a² = 25 에 가깝다
  ✓  연습 7.2: 합계 위험 ≤ a² + 4
  ✓  연습 7.1: Beta(s, n−s) 의 평균 = s/n
python
fig, axes = plt.subplots(1, 3, figsize=(12, 3.4))
ax = axes[0]; ax.plot(lt_prop, color=C["data"], lw=0.4, label="π(τ) ∝ 1"); ax.plot(lt_imp, color=C["key"], lw=0.4, label="π(τ²) ∝ 1/τ²")
ax.set_xlabel("iteration"); ax.set_ylabel("log10 τ"); ax.legend(); ax.set_title("improper posterior")
ax = axes[1]; ax.plot(ch6.T, lw=0.4); ax.set_xlabel("iteration"); ax.set_title("4 chains from −6: Rhat ≈ 1, all wrong")
ax = axes[2]
for j, (step, col) in enumerate([(0.1, C["theta"]), (2.4, C["data"]), (20, C["key"])]):
    ax.plot(mh1(lambda x: -0.5 * x * x, 0.0, step, 20_000, 7)[0][:500] + 9 * (1 - j), color=col, lw=0.7, label=f"step {step}")
ax.set_yticks([]); ax.legend(loc="center left", bbox_to_anchor=(1.0, 0.5)); ax.set_title("proposal scale")
plt.tight_layout(); plt.show()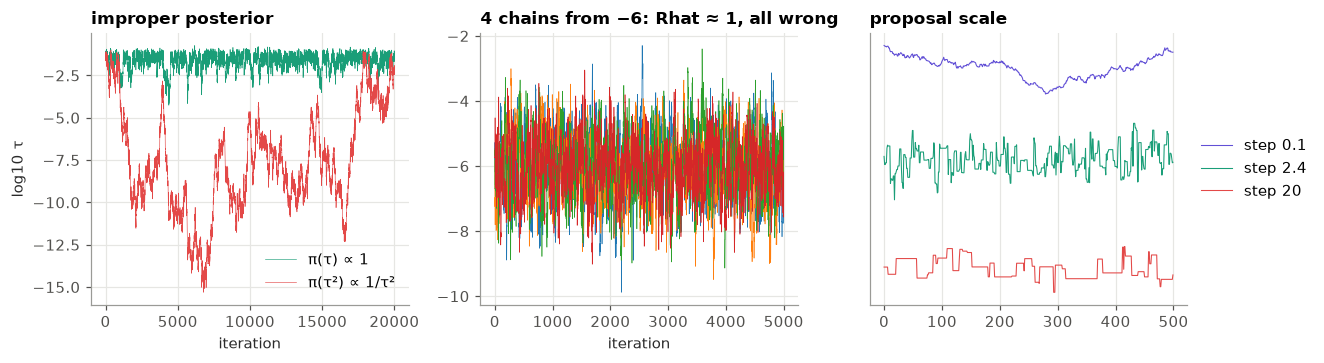
8. 오늘 — 벌점은 사전분포다
명제 8.1 ridge = 정규 사전분포의 사후평균, · 명제 8.2 lasso = Laplace 사전분포의 MAP, 직교 설계에서 연성 임계값 · 명제 8.4 ULA의 정상분산 · 정리 8.5 Tweedie의 공식 .
python
# 명제 8.1: 5회의 조건부 정규 공식으로 구한 사후분포 = ridge
n, p_, sig, tau = 30, 5, 1.3, 0.7; lam = sig**2 / tau**2
Xd = rng.normal(size=(n, p_)); yv = Xd @ rng.normal(0, tau, p_) + rng.normal(0, sig, n)
ridge = np.linalg.solve(Xd.T @ Xd + lam * np.eye(p_), Xd.T @ yv); Vr = sig**2 * np.linalg.inv(Xd.T @ Xd + lam * np.eye(p_))
Syy = tau**2 * Xd @ Xd.T + sig**2 * np.eye(n); Sby = tau**2 * Xd.T          # Cov(y), Cov(β, y)
cond_mean = Sby @ np.linalg.solve(Syy, yv); cond_cov = tau**2 * np.eye(p_) - Sby @ np.linalg.solve(Syy, Sby.T)
# 명제 8.2: 직교 설계의 lasso = 연성 임계값 — KKT 조건과 무작위 섭동
Q_, _ = np.linalg.qr(rng.normal(size=(n, p_))); yl = Q_ @ np.array([3.0, -0.4, 1.5, 0.2, -2.2]) + rng.normal(0, 0.5, n); lam_l = 1.0
zl = Q_.T @ yl; bl = np.sign(zl) * np.maximum(np.abs(zl) - lam_l, 0)
obj = lambda b: 0.5 * np.sum((yl - Q_ @ b) ** 2) + lam_l * np.sum(np.abs(b))
grad = Q_.T @ (yl - Q_ @ bl)
kkt = all(abs(grad[j] - lam_l * np.sign(bl[j])) < 1e-10 if bl[j] != 0 else abs(grad[j]) <= lam_l + 1e-12 for j in range(p_))
perturb = min(obj(bl + 0.05 * rng.normal(size=p_)) - obj(bl) for _ in range(2000))
# weight decay: w ← (1 − ηλ) w − η ∇L 는 L + (λ/2)||w||² 의 경사하강
w0 = rng.normal(size=4); gL = rng.normal(size=4); eta_, lam_w = 0.1, 0.3
print(f"lasso: z = {np.round(zl, 2)} → beta = {np.round(bl, 2)}; min objective increase under perturbation {perturb:.2e}")
report({"명제 8.1: 사후평균 = 조건부 정규 공식 = ridge": np.allclose(ridge, cond_mean),
        "명제 8.1: 사후공분산 = σ²(X'X + λI)^{-1}": np.allclose(Vr, cond_cov),
        "명제 8.2: 연성 임계값이 KKT 조건을 만족": kkt and np.sum(bl == 0) >= 1,
        "명제 8.2: 섭동하면 목적함수가 커진다 (최소점)": perturb > 0,
        "weight decay = (λ/2)||w||² 를 더한 경사하강": np.allclose((1 - eta_ * lam_w) * w0 - eta_ * gL, w0 - eta_ * (gL + lam_w * w0))})
text
lasso: z = [ 2.58 -0.03  1.85 -0.19 -2.62] → beta = [ 1.58 -0.    0.85 -0.   -1.62]; min objective increase under perturbation 4.95e-03
  ✓  명제 8.1: 사후평균 = 조건부 정규 공식 = ridge
  ✓  명제 8.1: 사후공분산 = σ²(X'X + λI)^{-1}
  ✓  명제 8.2: 연성 임계값이 KKT 조건을 만족
  ✓  명제 8.2: 섭동하면 목적함수가 커진다 (최소점)
  ✓  weight decay = (λ/2)||w||² 를 더한 경사하강
python
# 연습 8.4: Laplace 사전분포(분산 1)의 사후평균 — 0 이 아니고, 홀함수이고, 도함수 = 사후분산
b_ = 1 / math.sqrt(2)
def post_mom(z):
    f = lambda t, k_: t**k_ * stats.norm.pdf(z - t) * stats.laplace.pdf(t, scale=b_)
    m0 = integrate.quad(f, -15, 15, args=(0,), points=[0, z])[0]; m1 = integrate.quad(f, -15, 15, args=(1,), points=[0, z])[0]
    m2 = integrate.quad(f, -15, 15, args=(2,), points=[0, z])[0]
    return m1 / m0, m2 / m0 - (m1 / m0) ** 2, m0
zs = np.linspace(-4, 4, 81); pm_ = np.array([post_mom(z)[0] for z in zs])
h_ = 1e-4; deriv = [(post_mom(z + h_)[0] - post_mom(z - h_)[0]) / (2 * h_) for z in [0.3, 1.0, 2.5]]; pvar = [post_mom(z)[1] for z in [0.3, 1.0, 2.5]]
# 정리 8.5: Tweedie — 같은 사전분포에서 E(θ|x) 와 x + σ² (log m)'(x)
tw = [abs(post_mom(z)[0] - (z + (math.log(post_mom(z + h_)[2]) - math.log(post_mom(z - h_)[2])) / (2 * h_))) for z in [-2.0, 0.4, 1.7, 3.0]]
# 정규 사전분포이면 Tweedie = (1 − B) x (정리 5.4)
s_, t_ = 1.0, 1.5; xg = 2.3; dlogm = -xg / (s_**2 + t_**2)
print(f"Laplace posterior mean at z = 0.5, 1, 2, 3: {np.round([post_mom(z)[0] for z in [0.5, 1, 2, 3]], 3)}; lasso MAP: {np.round(np.sign([0.5, 1, 2, 3]) * np.maximum(np.abs([0.5, 1, 2, 3]) - 1 / b_, 0), 3)}")
report({"연습 8.4: z ≠ 0 이면 사후평균 ≠ 0": np.all(np.abs(pm_[zs != 0]) > 1e-6),
        "연습 8.4: 홀함수, 순증가": np.allclose(pm_, -pm_[::-1]) and np.all(np.diff(pm_) > 0),
        "연습 8.4: d/dz E(β|z) = Var(β|z)": np.allclose(deriv, pvar, atol=1e-5),
        "정리 8.5: Tweedie 의 공식 (Laplace 사전분포)": max(tw) < 1e-6,
        "정리 8.5: 정규 사전분포이면 (1 − B) x": abs(xg + s_**2 * dlogm - (1 - s_**2 / (s_**2 + t_**2)) * xg) < 1e-12})
text
Laplace posterior mean at z = 0.5, 1, 2, 3: [0.183 0.384 0.904 1.658]; lasso MAP: [0.    0.    0.586 1.586]
  ✓  연습 8.4: z ≠ 0 이면 사후평균 ≠ 0
  ✓  연습 8.4: 홀함수, 순증가
  ✓  연습 8.4: d/dz E(β|z) = Var(β|z)
  ✓  정리 8.5: Tweedie 의 공식 (Laplace 사전분포)
  ✓  정리 8.5: 정규 사전분포이면 (1 − B) x
python
# 연습 8.1: Robbins 의 Poisson 공식 — θ ~ Γ(α, 율 β) 이면 m 은 음이항이고 (x+1)m(x+1)/m(x) = (α+x)/(β+1)
al, be = 3.0, 2.0; nb = stats.nbinom(al, be / (be + 1))
rob_exact = [(x + 1) * nb.pmf(x + 1) / nb.pmf(x) for x in range(6)]; post_true = [(al + x) / (be + 1) for x in range(6)]
# 자료에서: 운전자 100만 명, 사전분포를 모른 채 (x+1) N_{x+1} / N_x
g = np.random.default_rng(1956); th = g.gamma(al, 1 / be, 1_000_000); xx = g.poisson(th); Nx = np.bincount(xx)
rob_emp = [(x + 1) * Nx[x + 1] / Nx[x] for x in range(5)]
print(f"Robbins from data: {np.round(rob_emp, 3)};  posterior means {np.round(post_true[:5], 3)}")
# 연습 8.3: ridge 신용구간의 빈도주의 포함확률 (X'X = I, λ = 1)
lam = 1.0
cov_f = [stats.norm.cdf(bs * lam + 1.96 * math.sqrt(1 + lam)) - stats.norm.cdf(bs * lam - 1.96 * math.sqrt(1 + lam)) for bs in [0, 1, 2, 3]]
g = np.random.default_rng(83); R = 400_000; sig = 1.0; tau = sig / math.sqrt(lam)
beta = g.normal(0, tau, R); z = beta + g.normal(0, sig, R)
cover_bayes = np.mean(np.abs(z / (1 + lam) - beta) <= 1.96 * sig / math.sqrt(1 + lam))
print(f"exercise 8.3: coverage at beta/sigma = 0,1,2,3: {np.round(cov_f, 3)}; averaged over the prior {cover_bayes:.4f}")
report({"연습 8.1: Robbins 공식 = 사후평균 (음이항, 정확히)": np.allclose(rob_exact, post_true),
        "연습 8.1: 사전분포 없이 자료로 추정 (상대오차 5% 안)": np.all(np.abs(np.array(rob_emp) / post_true[:5] - 1) < 0.05),
        "연습 8.3: 포함확률 0.994, 0.962, 0.780, 0.410": np.allclose(np.round(cov_f, 3), [0.994, 0.962, 0.780, 0.410]),
        "연습 8.3: 사전분포로 평균하면 정확히 0.95": within(cover_bayes, 0.95, math.sqrt(0.95 * 0.05 / R))})
text
Robbins from data: [1.001 1.338 1.669 1.999 2.33 ];  posterior means [1.    1.333 1.667 2.    2.333]
exercise 8.3: coverage at beta/sigma = 0,1,2,3: [0.994 0.962 0.78  0.41 ]; averaged over the prior 0.9497
  ✓  연습 8.1: Robbins 공식 = 사후평균 (음이항, 정확히)
  ✓  연습 8.1: 사전분포 없이 자료로 추정 (상대오차 5% 안)
  ✓  연습 8.3: 포함확률 0.994, 0.962, 0.780, 0.410
  ✓  연습 8.3: 사전분포로 평균하면 정확히 0.95
명제 8.4 (ULA의 치우침). 을 목표로 를 20만 걸음 돌린다. MH 보정을 붙인 MALA는 치우침이 없다. 연습 8.2: 이면 발산한다.
python
def ula(eta, n=200_000, seed=3, sig2=1.0):
    g = np.random.default_rng(seed); x = 0.0; xs_ = np.empty(n)
    for i in range(n):
        x = x - eta * x / sig2 + math.sqrt(2 * eta) * g.normal(); xs_[i] = x
    return xs_
v_sim = {eta: ula(eta)[1000:].var() for eta in [0.1, 0.5]}; v_th = {eta: 1 / (1 - eta / 2) for eta in [0.1, 0.5]}
def mala(eta, n=200_000, seed=3):
    g = np.random.default_rng(seed); x = 0.0; xs_ = np.empty(n); acc = 0
    logpi = lambda u: -0.5 * u * u; grad = lambda u: -u
    logq = lambda a_, b_: -((a_ - b_ - eta * grad(b_)) ** 2) / (4 * eta)          # log q(b → a)
    for i in range(n):
        y_ = x + eta * grad(x) + math.sqrt(2 * eta) * g.normal()
        if math.log(g.random()) < logpi(y_) + logq(x, y_) - logpi(x) - logq(y_, x): x = y_; acc += 1
        xs_[i] = x
    return xs_, acc / n
xm, acc_m = mala(0.5)
blow = ula(2.1, n=400)
print(f"ULA variance: eta 0.1 {v_sim[0.1]:.3f} (theory {v_th[0.1]:.3f}), eta 0.5 {v_sim[0.5]:.3f} (theory {v_th[0.5]:.3f});  MALA eta 0.5: var {xm[1000:].var():.3f}, acceptance {acc_m:.2f}")
report({"명제 8.4: 정상분산 이론값 1.053, 1.333": round(v_th[0.1], 3) == 1.053 and round(v_th[0.5], 3) == 1.333,
        "본문: 모의실험 1.045, 1.328": round(v_sim[0.1], 3) == 1.045 and round(v_sim[0.5], 3) == 1.328,
        "MALA: MH 보정으로 치우침이 사라진다": abs(xm[1000:].var() - 1) < 0.03,
        "연습 8.2: η = 2.1 > 2σ² 이면 발산": abs(blow[-1]) > 1e6})
text
ULA variance: eta 0.1 1.045 (theory 1.053), eta 0.5 1.328 (theory 1.333);  MALA eta 0.5: var 0.996, acceptance 0.92
  ✓  명제 8.4: 정상분산 이론값 1.053, 1.333
  ✓  본문: 모의실험 1.045, 1.328
  ✓  MALA: MH 보정으로 치우침이 사라진다
  ✓  연습 8.2: η = 2.1 > 2σ² 이면 발산
python
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
ax = axes[0]
ax.plot(zs, zs / 2, color=C["stat"], label="ridge = normal posterior mean")
ax.plot(zs, np.sign(zs) * np.maximum(np.abs(zs) - 1 / b_, 0), color=C["key"], label="lasso = Laplace MAP")
ax.plot(zs, pm_, color=C["theta"], ls="--", label="Laplace posterior mean")
ax.plot(zs, zs, color=C["hist"], ls=":", lw=1)
ax.set_xlabel("observed z"); ax.set_ylabel("estimate"); ax.legend(); ax.set_title("three shrinkage rules, prior variance 1")
ax = axes[1]; u = np.linspace(-4.5, 4.5, 300)
ax.hist(ula(0.5)[1000:], bins=80, density=True, color=C["stat"], alpha=0.4, label="ULA, η = 0.5")
ax.hist(xm[1000:], bins=80, density=True, histtype="step", color=C["data"], label="MALA, η = 0.5")
ax.plot(u, stats.norm.pdf(u), color=C["ink"], lw=1.2, label="target N(0,1)")
ax.plot(u, stats.norm.pdf(u, 0, math.sqrt(4 / 3)), color=C["key"], lw=1.2, label="N(0, 4/3)")
ax.set_xlabel("θ"); ax.legend(fontsize=8); ax.set_title("Langevin: bias and its correction")
plt.tight_layout(); plt.show()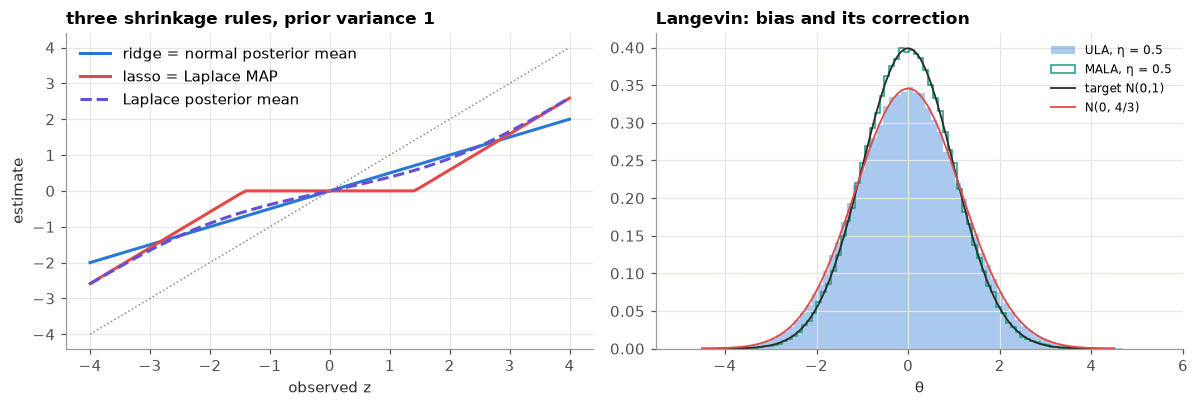
9. 정리 · 연습문제 지도 · 과정을 마치며
| 내용 | 확인한 셀 | |
|---|---|---|
| 사후분포 (1.1–1.4) | 세 켤레 쌍 = 수치 사후분포, 파리 , 0.50971 , 런던 0.5163, 차이 0.0066, Laplace 근사의 , 정규근사 | 1절 |
| Bayes 추정 (2.1–2.7) | 손실별 최소점, minimax 위험 0.00835, 의 Bayes 위험, Jeffreys 불변성, 포함확률 0.948 · 0.896 대 0.895 · 0.639 | 2절 |
| Bayes 인수 (3.1–3.5) | 예측의 곱, Arbuthnot 2159 deciban, 213.0, Lindley 19.2 · 0.95 · 2.9555, Pólya 항아리 | 3절 |
| MCMC (4.1–4.9) | 행렬로 본 상세 균형, Gibbs = 받아들임 1, 비가역 한 바퀴, AR(1) , | 4절 |
| Stein (5.1–5.4) | Stein 보조정리, 정확한 위험 2 · 6.21 · 9.40, 양의 부분, 경험적 Bayes , Galton의 기울기 | 5절 |
| 타율 (6.1–6.2) | 노트의 표, 3.5배, 16/18, 역감마 조건부분포, Gibbs와 MH (, 0.2656 · 0.0298, 0.69) | 6절 |
| 실패 (7) | 비정칙 , 1.21 · 1.001 · 6.9, 제안 폭 표, SBC, 개별 위험 11.2 | 7절 |
| 오늘 (8.1–8.5) | ridge = 조건부 정규, lasso의 KKT, Laplace 사후평균, Tweedie, Robbins, ULA 1.045 · 1.328, MALA | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 사후분포 | 1.1 ★ · 1.2 감마–Poisson ★ · 1.3 Laplace 근사의 오차 ★★ · 1.4 예측분포 ★★ | 1절 |
| 2 Bayes 추정 | 2.1 minimax ★ · 2.2 ★ · 2.3 척도와 카이제곱 ★★ · 2.4 Haldane ★★ · 2.5 ★ · 2.6 불편추정량은 Bayes가 아니다 ★★ (유도형) | 1–2절 |
| 3 Bayes 인수 | 3.1 deciban ★ · 3.2 정규 평균 ★★ · 3.3 파리 ★ · 3.4 Pólya ★★ | 3절 |
| 4 MCMC | 4.1 ★ · 4.2 ★ · 4.3 독립 제안 ★★ · 4.4 ★ · 4.5 무작위 순서 ★★ · 4.6 Gibbs는 MH ★ · 4.7 상관된 정규의 Gibbs ★★ (유도형) | 4절 |
| 5 Stein | 5.1 ★ · 5.2 ★★ · 5.3 비중심 카이제곱 ★★ · 5.4 양의 부분 ★★ · 5.5 ★★ · 5.6 경험적 Bayes 해석 ★★ (유도형) | 5절 |
| 6 타율 | 6.1 Clemente ★ · 6.2 ★ · 6.3 ★★ · 6.4 의 실패 ★★ | 6절 |
| 7 실패 | 7.1 ★★ · 7.2 성분 하나 ★★ · 7.3 ★ | 7절 |
| 8 오늘 | 8.1 Robbins ★★ · 8.2 ★ · 8.3 ★★ · 8.4 ★★ · 8.5 ridge의 사후분포 ★★ · 8.6 ULA의 치우침 ★ (유도형) | 8절 |
과정을 마치며. 이 과정은 1회 Pascal과 Fermat의 판돈에서 시작해 4회의 당구대를 거쳐 이번 회차의 사후분포로 돌아왔다. 열여섯 개의 노트북은 모두 같은 원칙을 따랐다. 정리는 강의노트에서 증명하고, 여기서는 그 정리가 말하는 숫자를 원자료와 시뮬레이션으로 다시 얻는다. 일곱 기둥 지도(맨 위)에서 보듯 Stigler의 일곱 기둥이 모두 칠해졌다. Laplace가 손으로 한 계산, Fisher가 거부한 사전분포, Turing이 더한 deciban, Metropolis의 몬테카를로, Stein의 축소, Robbins의 경험적 Bayes는 오늘의 ridge·lasso·weight decay·확산모형 안에 그대로 살아 있다.
10. 워크북 검산
워크북(16_bayes_mcmc_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A1a", "3/5")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/5,0.6)나 식의 문자열("theta**4 + 6*theta**2 + 3")로 넣는다. 소문항은 번호 뒤에 붙인다("A10c"). 는lam, 는theta, 는e로 쓴다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 시뮬레이션으로 한 번 더 — 사후확률이나 위험이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 켤레 공식을 쓰지 않고, 사전분포에서 모수를 뽑아 자료를 만들고 관측과 같은 경우만 남기는 방식(거절 표집)이나 연쇄를 직접 돌리는 방식이다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A1a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A2a A2b A3a A3b A4a A4b A4c A4d A5a A5b A5c A6a A6b A6c A7a A7b A7c A8a A8b A9a A9b A10a A10b A10c A11a A11b A11c A12 A13a A13b A13c A14a A14b A14c C3b C4c C6b C8c C9 D1a D1b D1c D2c D3c D3d D3e D4c D4d
A1a: 아직 답을 넣지 않았다. 예: check('A1a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None,
    "A4a": None, "A4b": None, "A4c": None, "A4d": None, "A5a": None, "A5b": None, "A5c": None,
    "A6a": None, "A6b": None, "A6c": None, "A7a": None, "A7b": None, "A7c": None, "A8a": None, "A8b": None,
    "A9a": None, "A9b": None, "A10a": None, "A10b": None, "A10c": None, "A11a": None, "A11b": None, "A11c": None,
    "A12": None, "A13a": None, "A13b": None, "A13c": None, "A14a": None, "A14b": None, "A14c": None,
    "C3b": None, "C4c": None, "C6b": None, "C8c": None, "C9": None,
    "D1a": None, "D1b": None, "D1c": None, "D2c": None, "D3c": None, "D3d": None, "D3e": None, "D4c": None, "D4d": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 방법 |
|---|---|---|
sim_A2() |
A2(b) 사후예측확률 | 사전분포에서 , 자료 5개 → 합이 10인 경우만 남긴다 |
sim_A7() |
A7(c) | 가설 → → → 인 경우만 남긴다 |
sim_A11() |
A11(a) 전이확률 | Gibbs 연쇄를 직접 돌린다 |
sim_A13() |
A13(c) 위험 | 에서 James–Stein의 손실 평균 |
sim_A14() |
A14(c) Bayes 위험 | 에서 James–Stein의 손실 평균 |
sim_C9(x) |
C9 사후평균 | 가 근처인 경우만 남긴다 |
sim_D1() |
D1(b) | 사전분포 → → 인 경우만 남긴다 |
sim_D3(r) |
D3(c)(e) | Metropolis 연쇄를 직접 돌린다 |
sim_D4() |
D4(d) | 의 Gibbs 표집 |
python
def _mean_se(v):
    v = np.asarray(v, dtype=float)
    return v.mean(), v.std(ddof=1) / np.sqrt(len(v))


def sim_A2(n=600_000):
    lam = rng.gamma(2.0, 1.0, size=n)
    x = rng.poisson(lam[:, None], size=(n, 6))
    keep = x[:, :5].sum(axis=1) == 10
    return _mean_se(x[keep, 5] == 0)


def sim_A7(n=1_000_000):
    h0 = rng.random(n) < 0.5
    p = np.where(h0, 0.5, rng.random(n))
    s = rng.binomial(10, p)
    return _mean_se(h0[s == 8])


def sim_A11(steps=200_000):
    J = np.array([[.4, .1], [.2, .3]])
    py_x = J / J.sum(axis=1, keepdims=True)
    px_y = (J / J.sum(axis=0, keepdims=True)).T
    x, moves = 0, []
    for _ in range(steps):
        y = int(rng.random() < py_x[x, 1])
        x_new = int(rng.random() < px_y[y, 1])
        if x == 0:
            moves.append(x_new)
        x = x_new
    return _mean_se(moves)


def sim_A13(n=400_000, p=5):
    X = rng.standard_normal((n, p))
    js = (1 - (p - 2) / (X ** 2).sum(axis=1, keepdims=True)) * X
    return _mean_se((js ** 2).sum(axis=1))


def sim_A14(n=400_000, p=10, tau2=4.0):
    theta = rng.normal(0, np.sqrt(tau2), size=(n, p))
    X = theta + rng.standard_normal((n, p))
    js = (1 - (p - 2) / (X ** 2).sum(axis=1, keepdims=True)) * X
    return _mean_se(((js - theta) ** 2).sum(axis=1))


def sim_C9(x, n=4_000_000, h=0.02):
    theta = np.where(rng.random(n) < 0.5, 1.0, -1.0)
    X = theta + rng.standard_normal(n)
    return _mean_se(theta[np.abs(X - x) < h])


def sim_D1(n=1_000_000):
    lam = rng.gamma(1.0, 1.0, size=n)
    T = rng.poisson(10 * lam)
    return _mean_se(np.exp(-lam[T == 12]))


def sim_D3(r, steps=200_000):
    """(P(0에 머문다 | 0), 0에서 1로 처음 옮기기까지의 평균 걸음 수)"""
    k, stays, waits, wait = 0, [], [], 0
    for _ in range(steps):
        y = k + (1 if rng.random() < 0.5 else -1)
        if y >= 0 and rng.random() < min(1.0, r ** (y - k)):
            k_new = y
        else:
            k_new = k
        if k == 0:
            stays.append(k_new == 0)
            wait += 1
            if k_new == 1:
                waits.append(wait)
                wait = 0
        k = k_new
    return _mean_se(stays), _mean_se(waits)


def sim_D4(iters=60_000, n=10, xbar=5.0, s=2.0):
    mu, out = xbar, []
    for _ in range(iters):
        ss = (n - 1) * s ** 2 + n * (xbar - mu) ** 2
        sig2 = (ss / 2) / rng.gamma(n / 2)            # 역감마(n/2, ss/2)
        mu = rng.normal(xbar, np.sqrt(sig2 / n))
        out.append(mu > 6)
    est, _ = _mean_se(out[1000:])
    return est, ess(np.asarray(out[1000:], float))
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A2(), "A2b")
assert _close(sim_A7(), "A7c")
assert _close(sim_A11(), "A11a")
assert _close(sim_A13(), "A13c")
assert _close(sim_A14(), "A14c")
assert _close(sim_C9(0.7), "C9", x=0.7)
assert _close(sim_D1(), "D1b")
_stay, _wait = sim_D3(0.5)
assert _close(_stay, "D3c", r=0.5) and _close(_wait, "D3e", r=0.5)
_p, _neff = sim_D4()
assert abs(_p - _value("D4d")) <= 4 * np.sqrt(_p * (1 - _p) / _neff)
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"], locals={"e": sp.E})))