Skip to content

16회 · 베이즈의 귀환 · 노트

1 Laplace의 역확률 (1763–1812) ​

역사 Thomas Bayes의 논문은 그가 죽은 뒤 1763년 Richard Price가 발표했다. 당구대의 공이 멈춘 자리처럼 모르는 확률 pp에 균등 사전분포를 주고, 관측 뒤의 분포를 구했다. 11년 뒤 25세의 Laplace는 Bayes를 모른 채 같은 원리를 “사건으로부터 원인의 확률”이라 부르며 일반화했다. 그는 이 계산을 출생 기록에 썼다. 파리의 1745–1770년 기록에서 남아가 여아보다 많은 것이 우연인지, 런던의 남아 비율이 파리보다 큰 것이 우연인지를 물었다. 적분이 손으로 되지 않자, 가능도의 꼭대기 근처를 정규곡선으로 근사하는 방법을 만들었다. 오늘 “Laplace 근사”라 부르는 것이다. 1812년의 확률의 해석적 이론은 이 모든 것을 담았다.

1.1 사후분포와 켤레 사전분포 ​

정의 1.1 (사후분포) 모수 θ\cdat\theta가 사전분포 π\pi를 따르고, θ=θ\cdat\theta=\theta가 주어졌을 때 자료가 f(x∣θ)f(\x\mid\theta)를 따른다고 하자. 자료가 주어졌을 때 θ\cdat\theta의 조건부분포

π(θ∣x)=π(θ) f(x∣θ)m(x),m(x)=∫π(θ′)f(x∣θ′) dθ′\pi(\theta\mid\x)=\frac{\pi(\theta)\,f(\x\mid\theta)}{m(\x)},\qquad m(\x)=\int\pi(\theta^\prime)f(\x\mid\theta^\prime)\,d\theta^\prime

를 사후분포라 한다. 1회 정리 5.5(Bayes 정리)의 밀도판이다.

사후분포는 가능도에 사전분포를 곱한 것에 비례한다. 9회의 MLE가 가능도의 꼭대기 하나를 고른다면, 베이즈 추론은 가능도의 모양 전체를 사전분포로 가중해 분포로 남긴다. 사전분포가 평평하면 사후분포의 꼴은 가능도의 꼴과 같다.

정리 1.2 (켤레 사전분포) 

  1. (a)

    (베타–이항) p∼Beta(a,b)\cdat p\sim\mathrm{Beta}(a,b), S∣p∼b(n,p)S\mid p\sim\mathrm b(n,p)이면 p∣S=s∼Beta(a+s, b+n−s)\cdat p\mid S=s\sim\mathrm{Beta}(a+s,\allowbreak \ b+n-s).

  2. (b)

    (감마–Poisson) λ∼Γ(α, 율 β)\cdat\lambda\sim\Gamma(\alpha,\allowbreak \ \text{율 }\beta), X1,…,Xn∣λ∼iidPoi(λ)X_1,\allowbreak \dots,\allowbreak X_n\mid\lambda\iid\mathrm{Poi}(\lambda)이면 λ∣x∼Γ(α+∑xi, 율 β+n)\cdat\lambda\mid\x\sim\Gamma(\alpha+\sum x_i,\allowbreak \ \text{율 }\beta+n).

  3. (c)

    (정규–정규) μ∼N(m,τ2)\cdat\mu\sim\N(m,\tau^2), X1,…,Xn∣μ∼iidN(μ,σ2)X_1,\allowbreak \dots,\allowbreak X_n\mid\mu\iid\N(\mu,\allowbreak \sigma^2) (σ2\sigma^2은 앎)이면

    μ∣x∼N((n/σ2)xˉ+(1/τ2)mn/σ2+1/τ2, 1n/σ2+1/τ2).\cdat\mu\mid\x\sim\N\Bigl(\frac{(n/\sigma^2)\bar x+(1/\tau^2)m}{n/\sigma^2+1/\tau^2},\ \frac1{n/\sigma^2+1/\tau^2}\Bigr).

증명 전략 사후밀도는 π(θ)f(x∣θ)\pi(\theta)f(\x\mid\theta)에 비례한다. θ\theta에 의존하는 인수만 모아 이미 아는 분포의 밀도의 핵(상수배를 뺀 부분)과 맞춘다. 밀도는 적분이 1이므로 상수는 저절로 정해진다.

(a)

  1. π(p∣s)∝pa−1(1−p)b−1⋅(ns)ps(1−p)n−s∝pa+s−1(1−p)b+n−s−1\pi(p\mid s)\propto p^{a-1}(1-p)^{b-1}\cdot\binom nsp^s(1-p)^{n-s}\propto p^{a+s-1}(1-p)^{b+n-s-1}이다.정의 1.1

  2. 이것은 Beta(a+s, b+n−s)\mathrm{Beta}(a+s,\,b+n-s)의 핵이다.4회 정의 4.1, 정리 4.5

(b)

  1. 관측이 독립이므로 f(x∣λ)=∏iλxie−λ/xi!f(\x\mid\lambda)=\prod_i\lambda^{x_i}e^{-\lambda}/x_i!이다.3회 정의 3.1

  2. λ\lambda에 의존하는 인수만 남기면

    π(λ∣x)∝λα−1e−βλ⋅λ∑xie−nλ=λα+∑xi−1e−(β+n)λ.\pi(\lambda\mid\x)\propto\lambda^{\alpha-1}e^{-\beta\lambda}\cdot\lambda^{\sum x_i}e^{-n\lambda}=\lambda^{\alpha+\sum x_i-1}e^{-(\beta+n)\lambda} .
    지수법칙
  3. 이것은 모양 α+∑xi\alpha+\sum x_i, 율 β+n\beta+n인 감마분포의 핵이다.4회 정의 3.6

(c)

  1. 가능도의 μ\mu에 대한 부분은 exp⁡{−n2σ2(μ−xˉ)2}\exp\{-\tfrac n{2\sigma^2}(\mu-\bar x)^2\}이다.∑i(xi−μ)2=∑i(xi−xˉ)2+n(xˉ−μ)2\sum_i(x_i-\mu)^2=\sum_i(x_i-\bar x)^2+n(\bar x-\mu)^2

  2. 사전밀도를 곱하면 지수는 −n2σ2(μ−xˉ)2−12τ2(μ−m)2-\tfrac n{2\sigma^2}(\mu-\bar x)^2-\tfrac1{2\tau^2}(\mu-m)^2이다.정의 1.1

  3. P=n/σ2+1/τ2P=n/\sigma^2+1/\tau^2, M=((n/σ2)xˉ+m/τ2)/PM=\bigl((n/\sigma^2)\bar x+m/\tau^2\bigr)/P로 두고 μ\mu에 대해 제곱을 완성하면

    −n2σ2(μ−xˉ)2−12τ2(μ−m)2=−P2(μ−M)2+(μ에 무관한 상수).-\frac n{2\sigma^2}(\mu-\bar x)^2-\frac1{2\tau^2}(\mu-m)^2=-\frac P2(\mu-M)^2+(\mu\text{에 무관한 상수}) .
    μ2\mu^2, μ\mu의 계수 비교
  4. 이것은 N(M,1/P)\N(M,1/P)의 핵이다. 5회 연습 1.6의 계산과 같다.5회 정의 1.7

(c)의 사후평균은 자료의 평균 xˉ\bar x를 사전평균 mm 쪽으로 축소한 것이다. 축소의 비율은 두 정보의 비, 곧 n/σ2n/\sigma^2 대 1/τ21/\tau^2다. 자료가 많아지면 사전분포의 몫은 사라진다. 5회 따름정리 2.2(Galton의 2단 quincunx)와 같은 식이고, 5절의 James–Stein이 이 식으로 돌아온다.

예제 1.3 (파리의 남아) 균등 사전분포(Bayes의 당구대)로 남아 251,527명, 여아 241,945명을 넣으면 p∣자료∼Beta(251528, 241946)\cdat p\mid\text{자료}\sim\mathrm{Beta}(251528,\allowbreak \ 241946)이다. 사후평균은 0.509710.50971, 95% 신용구간은 [0.50831, 0.51110][0.50831,\ 0.51110]이고

P(p≤12 ∣ 자료)=1.15×10−42P\bigl(\cdat p\le\tfrac12\ \big|\ \text{자료}\bigr)=1.15\times10^{-42}

이다. Laplace의 결론대로, 남아가 더 많이 태어난다는 것은 사실상 확실하다. 같은 계산을 Arbuthnot(1710)의 런던 세례 기록(1629–1710년, 남아 484,382명, 여아 453,841명)에 하면 런던의 남아 비율은 0.5163이고, 사후분포에서 런던과 파리의 차이는 0.0066, 95% 구간 [0.0048, 0.0083][0.0048,\ 0.0083]이다. 런던의 비율이 더 크다는 것도 우연이 아니다(그림 1.1). Laplace가 비교에 쓴 런던 자료는 다른 기간의 것이지만 결론은 같았다.

1.2 Laplace 근사 ​

명제 1.4 (Laplace 근사) hh가 꼭대기 θ^\hat\theta에서 두 번 미분가능하고 h′′(θ^)<0h^{\prime\prime}(\hat\theta)<0이며, 꼭대기 밖에서는 hh가 h(θ^)h(\hat\theta)보다 일정량 이상 작다고 하자. n→∞n\to\infty일 때

∫enh(θ) dθ∼enh(θ^)2πn ∣h′′(θ^)∣.\int e^{n h(\theta)}\,d\theta\sim e^{nh(\hat\theta)}\sqrt{\frac{2\pi}{n\,|h^{\prime\prime}(\hat\theta)|}} .

따라서 사후밀도 ∝enh(θ)\propto e^{nh(\theta)}는 N(θ^, 1/(n∣h′′(θ^)∣))\N\bigl(\hat\theta,\allowbreak \ 1/(n|h^{\prime\prime}(\hat\theta)|)\bigr)로 근사된다.

증명 θ^\hat\theta 근처에서 nh(θ)≈nh(θ^)−n2∣h′′(θ^)∣(θ−θ^)2nh(\theta)\approx nh(\hat\theta)-\tfrac n2|h^{\prime\prime}(\hat\theta)|(\theta-\hat\theta)^2이고, 오른쪽의 지수를 적분하면 정규 적분(3회)이 된다. 꼭대기에서 δ\delta 이상 떨어진 곳의 적분은 en(h(θ^)−c)e^{n(h(\hat\theta)-c)}보다 작아 상대적으로 사라진다. 나머지 항을 다루는 세부는 Stirling 공식(5회 보조정리 1.1)의 증명과 같다.

이항 가능도에서 h(p)=p^log⁡p+(1−p^)log⁡(1−p)h(p)=\hat p\log p+(1-\hat p)\log(1-p)이므로 θ^=p^\hat\theta=\hat p, 1/(n∣h′′∣)=p^(1−p^)/n1/(n|h^{\prime\prime}|)=\hat p(1-\hat p)/n이다. 파리의 자료에 쓰면 (0.5−p^)/p^(1−p^)/n=−13.64(0.5-\hat p)/\sqrt{\hat p(1-\hat p)/n}=-13.64이고 Φ(−13.64)=1.11×10−42\Phi(-13.64)=1.11\times10^{-42}로, 정확한 값 1.15×10−421.15\times10^{-42}와 3% 차이다. 정규분포의 13.613.6 표준편차 밖의 꼬리를 이 정도로 맞춘다는 것이 놀랍다. 사후분포가 MLE를 중심으로, 9회의 Fisher 정보의 역수를 분산으로 하는 정규분포에 가까워진다는 것이 일반적인 사실이다.

증명 없이 쓰는 사실 (Bernstein–von Mises 정리) 정칙 모수모형에서, 참값에서 양의 밀도를 갖는 사전분포를 쓰면 사후분포와 N(θ^MLE, In(θ0)−1)\N\bigl(\hat\theta_{\mathrm{MLE}},\allowbreak \ I_n(\theta_0)^{-1}\bigr)의 총변동 거리는 확률적으로 0으로 간다. 표본이 크면 베이즈 신용구간과 9회의 Wald 신뢰구간이 같아진다. 증명에는 9회의 MLE 점근론과 사후분포의 꼬리를 묶는 조건이 필요하다.
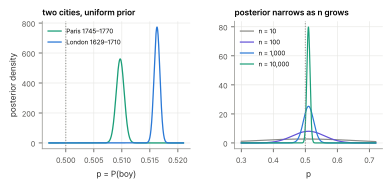
그림 1.1. 왼쪽: 파리(1745–1770)와 런던(1629–1710)의 남아 출생 확률의 사후분포. 회색 점선은 1/2이다. 두 분포 모두 1/2에서 수십 표준편차 떨어져 있고 서로도 겹치지 않는다. 오른쪽: 균등 사전분포에서 자료가 늘 때 사후분포가 좁아지는 모습(파리의 처음 n명을 같은 비율로 축소한 가상의 자료).
그림 1.1 왼쪽: 파리(1745–1770)와 런던(1629–1710)의 남아 출생 확률의 사후분포. 회색 점선은 1/21/2이다. 두 분포 모두 1/21/2에서 수십 표준편차 떨어져 있고 서로도 겹치지 않는다. 오른쪽: 균등 사전분포에서 자료가 늘 때 사후분포가 좁아지는 모습(파리의 처음 nn명을 같은 비율로 축소한 가상의 자료).
연습문제

연습 1.1 (사후평균은 가중평균 ★) 베타–이항에서 사후평균 a+sa+b+n\tfrac{a+s}{a+b+n}이 사전평균 aa+b\tfrac a{a+b}와 표본비율 s/ns/n의 가중평균이고, 무게가 a+ba+b+n\tfrac{a+b}{a+b+n}과 na+b+n\tfrac n{a+b+n}임을 보여라. a+ba+b를 “사전 표본 크기”라 부르는 이유는?

풀이

a+sa+b+n=a+ba+b+n⋅aa+b+na+b+n⋅sn\frac{a+s}{a+b+n}=\frac{a+b}{a+b+n}\cdot\frac a{a+b}+\frac n{a+b+n}\cdot\frac sn. 사전분포 Beta(a,b)\mathrm{Beta}(a,b)는 성공 aa번, 실패 bb번을 이미 본 것처럼 작용한다. 관측 nn개와 “가상의 관측” a+ba+b개의 비율로 무게가 나뉘므로 a+ba+b를 사전 표본 크기라 부른다. 균등 사전분포는 가상의 관측 2개(성공 1, 실패 1)다.

연습 1.2 (감마–Poisson ★) 4회의 기병대 자료(200군단·년에 사망 122건)에 Γ(1, 율 1)\Gamma(1,\ \text{율 }1) 사전분포를 주고 λ\lambda의 사후평균과 95% 신용구간을 구하라. MLE 0.61과 비교하라.

풀이

정리 1.2(b)로 사후분포는 Γ(1+122, 율 1+200)=Γ(123, 201)\Gamma(1+122,\allowbreak \ \text{율 }1+200)=\Gamma(123,\allowbreak \ 201)이다. 사후평균은 123/201=0.612123/201=0.612, 95% 신용구간은 [0.509, 0.725][0.509,\ 0.725]이다. 관측 200개에 비해 사전분포의 가상 관측이 1개라 MLE 0.610.61과 거의 같다.

연습 1.3 (Laplace 근사의 오차 ★★) 파리의 자료에서 정규근사의 꼬리확률 1.11×10−421.11\times10^{-42}와 정확한 값 1.15×10−421.15\times10^{-42}의 상대오차가 3% 정도인 이유를, 베타분포가 꼬리에서 정규분포와 어떻게 다른지(치우침)로 설명하라.

풀이

Beta(251528,241946)\mathrm{Beta}(251528,241946)의 치우침(왜도)은 −1.1×10⁻⁴-1.1\times10^{-4}로 왼쪽 꼬리가 조금 더 길다. p≤12p\le\tfrac12는 왼쪽 꼬리이므로 정확한 확률이 정규근사보다 크다(1.1461.146 대 1.1131.113, 비 1.0301.030). 왜도 γ\gamma의 효과는 Edgeworth 전개에서 대략 γ(z3−3z)/6\gamma(z^3-3z)/6의 상대 보정으로 나타나는데, z≈13.6z\approx13.6이면 z3≈2500z^3\approx2500이라 10−410^{-4}의 왜도도 수 퍼센트의 차이를 만든다. 꼬리가 멀수록 정규근사의 상대오차가 커진다.

연습 1.4 (예측분포 ★★) 베타–이항에서 다음 하나가 성공일 사후예측확률이 사후평균 a+sa+b+n\tfrac{a+s}{a+b+n}임을 보여라. a=b=1a=b=1이면 4회 따름정리 4.6(계승규칙)이다.

풀이

P(Xn+1=1∣x)=∫p π(p∣x)dp=E(p∣x)=a+sa+b+nP(X_{n+1}=1\mid\x)=\int p\,\pi(p\mid\x)dp=E(p\mid\x)=\frac{a+s}{a+b+n}. a=b=1a=b=1이면 s+1n+2\frac{s+1}{n+2}로 Laplace의 계승규칙이다.

이 회차에서 읽은 절 0개 · 회차 차례