Skip to content

16회 · 베이즈의 귀환 · 노트

3 Fisher의 거부와 증거의 무게 ​

역사 Fisher는 1922년 논문에서 역확률을 “완전히 버려야 할 것”이라 썼다. 균등 사전분포가 모수화에 달려 있다는 것(2절)과, 사전분포가 관측되지 않는다는 것이 이유였다. 그는 그 자리에 가능도와 유의확률을, Neyman과 Pearson은 오류율을 놓았다(8·12회). 케임브리지의 지구물리학자 Harold Jeffreys는 홀로 다른 길을 갔다. 그의 Theory of Probability(1939)는 가설 검정을 사후확률로 다시 세웠다. 귀무가설에 사전확률 덩어리를 주고, 두 가설의 주변 가능도의 비, 곧 Bayes 인수로 판정했다. 1940–41년 Bletchley Park에서 Alan Turing은 Enigma의 설정을 좁히기 위해 같은 양을 썼다. 그는 가능도비의 상용로그를 “ban”, 그 10분의 1을 “deciban”이라 부르고 단서마다 더했다. 조수였던 I. J. Good은 전쟁 뒤 이것을 “증거의 무게”로 정리했다(1950). 미국에서 Wald가 같은 시기에 축차확률비 검정(12회)을 만든 것은 우연이 아니다. 두 사람 모두 로그 가능도비를 증거가 들어오는 대로 더했다.

3.1 Bayes 인수 ​

정의 3.1 (Bayes 인수) 두 모형 H0:θ∼π0H_0:\theta\sim\pi_0, H1:θ∼π1H_1:\theta\sim\pi_1의 주변 가능도 mj(x)=∫f(x∣θ)πj(θ)dθm_j(\x)=\int f(\x\mid\theta)\pi_j(\theta)d\theta의 비

B10(x)=m1(x)m0(x)B_{10}(\x)=\frac{m_1(\x)}{m_0(\x)}

를 H1H_1의 H0H_0에 대한 Bayes 인수라 한다. 단순가설(πj\pi_j가 한 점)이면 Bayes 인수는 가능도비다. 10log⁡10B1010\log_{10}B_{10}을 증거의 무게(단위 deciban)라 한다.

명제 3.2 (사후 오즈와 증거의 덧셈) 

  1. (a)

    사전확률이 P(H0),P(H1)P(H_0),P(H_1)이면 P(H1∣x)P(H0∣x)=P(H1)P(H0)⋅B10(x)\dfrac{P(H_1\mid\x)}{P(H_0\mid\x)}=\dfrac{P(H_1)}{P(H_0)}\cdot B_{10}(\x).

  2. (b)

    자료가 차례로 들어오면 log⁡B10(x1:n)=∑k=1nlog⁡m1(xk∣x1:k−1)m0(xk∣x1:k−1)\log B_{10}(\x_{1:n})=\sum_{k=1}^n\log\dfrac{m_1(\x_k\mid\x_{1:k-1})}{m_0(\x_k\mid\x_{1:k-1})}이다. 단순가설이고 관측이 독립이면 각 항은 그 관측의 로그 가능도비다.

증명 (a) P(Hj∣x)∝P(Hj)mj(x)P(H_j\mid\x)\propto P(H_j)m_j(\x)(1회 정리 5.5). (b) mj(x1:n)=∏kmj(xk∣x1:k−1)m_j(\x_{1:n})=\prod_km_j(\x_k\mid\x_{1:k-1})(곱셈법칙)의 로그를 취한다. 단순가설이면 mj(xk∣x1:k−1)=f(xk∣θj)m_j(\x_k\mid\x_{1:k-1})=f(\x_k\mid\theta_j).

(b)는 Turing의 방법이자 12회 정의 4.1의 축차확률비 검정이다. 증거는 단서마다 더해지고, 누적 무게가 미리 정한 문턱을 넘으면 결정한다. Good에 따르면 Turing은 1 deciban을 사람이 직관으로 느낄 수 있는 가장 작은 증거의 변화로 보았다. 10 deciban은 가능도비 10, 20 deciban은 100이다.

예제 3.3 (Arbuthnot의 증거의 무게) 8회에서 Arbuthnot의 82년은 부호검정의 유의확률 2−82≈2×10−252^{-82}\approx2\times10^{-25}로 읽었다. 이번에는 해마다의 출생 수를 다 써서 H1:p=0.516H_1:p=0.516(런던 전체의 비율)과 H0:p=12H_0:p=\tfrac12의 증거의 무게를 잰다. 남아 btb_t명, 여아 gtg_t명인 해의 무게는 10[btlog⁡100.5160.5+gtlog⁡100.4840.5]10\bigl[b_t\log_{10}\tfrac{0.516}{0.5}+g_t\log_{10}\tfrac{0.484}{0.5}\bigr]이다. 82년의 합은 2159 deciban이고 한 해에 평균 26.3 deciban이다. 한 해의 기록만으로도 가능도비가 약 400이다(그림 3.1). H1H_1을 하나의 값이 아니라 균등 사전분포 p∼U(0,1)p\sim\mathrm U(0,1)로 두면 log⁡10B10=213.0\log_{10}B_{10}=213.0, 곧 2130 deciban이다. 29 deciban 차이는 H1H_1이 pp를 미리 알지 못해 치르는 값이다.

3.2 Lindley의 역설 ​

명제 3.4 (점 귀무가설의 Bayes 인수) H0:θ=θ0H_0:\theta=\theta_0, H1:θ∼π1H_1:\theta\sim\pi_1(θ0\theta_0에서 연속이고 양수)라 하고, 정칙 모형에서 zn=nI(θ0)(θ^n−θ0)z_n=\sqrt{nI(\theta_0)}(\hat\theta_n-\theta_0)라 하자. nn이 크면

log⁡B01=−zn22+12log⁡nI(θ0)2π−log⁡π1(θ0)+oP(1).\log B_{01}=-\frac{z_n^2}{2}+\frac12\log\frac{nI(\theta_0)}{2\pi}-\log\pi_1(\theta_0)+o_P(1).

따라서 znz_n을 고정하면 B01→∞B_{01}\to\infty이다. 유의확률이 0.05로 같아도 nn이 클수록 자료는 H0H_0을 지지한다.

증명 명제 1.4로 m1(x)≈f(x∣θ^)π1(θ^)2π/(nI(θ^))m_1(\x)\approx f(\x\mid\hat\theta)\pi_1(\hat\theta)\sqrt{2\pi/(nI(\hat\theta))}이다. m0(x)=f(x∣θ0)m_0(\x)=f(\x\mid\theta_0)이고, 9회 정리 5.2(Wilks)의 증명에서 2log⁡f(x∣θ^)f(x∣θ0)=zn2+oP(1)2\log\frac{f(\x\mid\hat\theta)}{f(\x\mid\theta_0)}=z_n^2+o_P(1)이다. 비를 취하고 θ^→θ0\hat\theta\to\theta_0을 쓴다.

상수를 버리면 log⁡B01≈12log⁡n−12zn2\log B_{01}\approx\tfrac12\log n-\tfrac12z_n^2이다. 모수가 dd개 더 많은 모형과 비교하면 d2log⁡n\tfrac d2\log n이 되고, 이것이 Schwarz(1978)의 BIC다. AIC(10회 연습 6.3)의 벌점 dd와 달리 nn과 함께 커진다.

예제 3.5 (Lindley의 출생 자료) 어느 도시에서 남아 49,581명, 여아 48,870명이 태어났다(n=98,451n=98{,}451). H0:p=12H_0:p=\tfrac12의 정규근사 검정통계량은 z=2.27z=2.27, 양측 유의확률은 0.0230.023이다. 5% 수준에서 기각한다. 그러나 H1:p∼U(0,1)H_1:p\sim\mathrm U(0,1)의 Bayes 인수는 B01=(nx)2−n(n+1)=19.2B_{01}=\binom n x2^{-n}(n+1)=19.2이고, 두 가설에 반씩 사전확률을 주면 P(H0∣x)=0.95P(H_0\mid\x)=0.95다. 명제 3.4의 근사도 log⁡B01=2.9555\log B_{01}=2.9555로 정확한 값 2.95552.9555와 소수 넷째 자리까지 맞는다.

두 답이 다른 이유는 질문이 다르기 때문이다. 유의확률은 H0H_0 아래에서 이만큼 극단적인 자료의 확률을 묻는다. Bayes 인수는 H0H_0과 구체적인 대립가설이 각각 이 자료를 얼마나 잘 예측했는지 묻는다. 균등 대립가설은 p=0.3p=0.3이나 p=0.9p=0.9에도 무게를 주므로, 0.50360.5036이라는 관측은 H1H_1에게도 놀랍다. 그렇다고 Bayes 인수가 옳은 것도 아니다. π1\pi_1을 넓히면 B01B_{01}은 한없이 커진다(연습 3.2). 검정의 답은 대립가설을 무엇으로 두느냐에 달려 있다.

증명 없이 쓰는 사실 (de Finetti의 표현정리) 0–1 수열 X1,X2,…X_1,X_2,\dots의 결합분포가 순서를 바꿔도 같으면(교환가능), 어떤 분포 μ\mu가 있어 P(X1=x1,…,Xn=xn)=∫01ps(1−p)n−sμ(dp)P(X_1=x_1,\allowbreak \dots,\allowbreak X_n=x_n)=\int_0^1p^s(1-p)^{n-s}\mu(dp)이다(s=∑xis=\sum x_i). 곧 “모르는 pp가 있고 그 아래에서 독립”이라는 Bayes 모형은, 관측의 교환가능성이라는 믿음에서 저절로 나온다. de Finetti(1937)와 Savage(1954)는 이것으로 사전분포를 주관적 믿음의 표현으로 정당화했다.
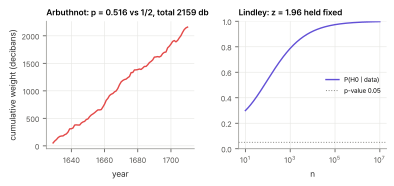
그림 3.1. 왼쪽: Arbuthnot 자료에서 H_1:p=0.516 대 H_0:p=tfrac12의 누적 증거의 무게(deciban). 해마다 약 26 deciban씩 쌓인다. 오른쪽: 검정통계량을 z=1.96(유의확률 0.05)으로 고정했을 때 n에 따른 P(H_0|x)(H_1은 균등, 사전확률 반반). 유의확률은 그대로인데 사후확률
그림 3.1 왼쪽: Arbuthnot 자료에서 H1:p=0.516H_1:p=0.516 대 H0:p=12H_0:p=\tfrac12의 누적 증거의 무게(deciban). 해마다 약 26 deciban씩 쌓인다. 오른쪽: 검정통계량을 z=1.96z=1.96(유의확률 0.05)으로 고정했을 때 nn에 따른 P(H0∣x)P(H_0\mid\x)(H1H_1은 균등, 사전확률 반반). 유의확률은 그대로인데 사후확률은 1로 간다.
연습문제

연습 3.1 (deciban의 덧셈 ★) 독립인 두 단서의 가능도비가 3과 5다. 각각의 무게와 합친 무게를 deciban으로 구하고, 사전 오즈가 1:201:20일 때 사후 오즈를 구하라.

풀이

10log⁡103=4.7710\log_{10}3=4.77, 10log⁡105=6.9910\log_{10}5=6.99이고 합은 11.7611.76 deciban, 곧 가능도비 15다. 사후 오즈는 120×15=34\frac1{20}\times15=\frac34, 사후확률은 3/7=0.433/7=0.43이다.

연습 3.2 (정규 평균의 Bayes 인수 ★★) X1,…,Xn∣μ∼iidN(μ,1)X_1,\allowbreak \dots,\allowbreak X_n\mid\mu\iid\N(\mu,\allowbreak 1), H0:μ=0H_0:\mu=0, H1:μ∼N(0,τ2)H_1:\mu\sim\N(0,\tau^2)이면

B01=1+nτ2 exp⁡(−z22⋅nτ21+nτ2),z=nxˉB_{01}=\sqrt{1+n\tau^2}\,\exp\Bigl(-\frac{z^2}2\cdot\frac{n\tau^2}{1+n\tau^2}\Bigr),\qquad z=\sqrt n\bar x

임을 보여라. zz와 nn을 고정하고 τ→∞\tau\to\infty로 보내면 어떻게 되는가?

풀이

xˉ\bar x가 충분통계량이므로 그 분포만 비교하면 된다. H0H_0에서 Xˉ∼N(0,1/n)\bar X\sim\N(0,1/n), H1H_1에서 주변분포는 N(0,τ2+1/n)\N(0,\tau^2+1/n)이다. 밀도의 비는

B01=τ2+1/n1/nexp⁡{−xˉ22(n−1τ2+1/n)}=1+nτ2exp⁡{−z22⋅nτ21+nτ2}.B_{01}=\sqrt{\frac{\tau^2+1/n}{1/n}}\exp\Bigl\{-\frac{\bar x^2}2\Bigl(n-\frac1{\tau^2+1/n}\Bigr)\Bigr\}=\sqrt{1+n\tau^2}\exp\Bigl\{-\frac{z^2}2\cdot\frac{n\tau^2}{1+n\tau^2}\Bigr\}.

τ→∞\tau\to\infty이면 지수 부분은 e−z2/2e^{-z^2/2}로 가고 1+nτ2→∞\sqrt{1+n\tau^2}\to\infty이므로 B01→∞B_{01}\to\infty다. 대립가설을 한없이 흐리게 하면 어떤 자료도 귀무가설을 지지한다(Bartlett의 역설). 비정칙 사전분포로는 Bayes 인수를 정의할 수 없다.

연습 3.3 (파리의 Bayes 인수 ★) 파리의 자료에서 H0:p=12H_0:p=\tfrac12 대 H1:p∼U(0,1)H_1:p\sim\mathrm U(0,1)의 log⁡10B10\log_{10}B_{10}을 명제 3.4의 근사로 구하라(z=13.64z=13.64). 노트북의 정확한 값은 37.66이다.

풀이

I(12)=4I(\tfrac12)=4, π1≡1\pi_1\equiv1, z=2n(p^−12)=13.640z=2\sqrt n(\hat p-\tfrac12)=13.640이므로 log⁡B10≈z22−12log⁡4n2π=93.03−6.33=86.70\log B_{10}\approx\frac{z^2}2-\frac12\log\frac{4n}{2\pi}=93.03-6.33=86.70, 상용로그로 37.6537.65다. 정확한 값 37.65637.656과 소수 둘째 자리까지 맞는다.

연습 3.4 (Pólya 항아리 ★★) 흰 공 aa개, 검은 공 bb개의 항아리에서 공을 꺼내 같은 색 공 하나를 더해 돌려놓는다. nn번 중 흰 공이 ss번인 특정 순서의 확률이 순서에 무관하고 ∫01ps(1−p)n−sBeta(a,b)(dp)\int_0^1p^s(1-p)^{n-s}\mathrm{Beta}(a,\allowbreak b)(dp)임을 보여라.

풀이

처음 kk번 중 흰 공이 jj번 나왔다면 항아리에는 흰 공 a+ja+j개, 검은 공 b+k−jb+k-j개가 있다. 특정 순서의 확률은 분자에 흰 공 차례마다 a,a+1,…,a+s−1a,a+1,\dots,a+s-1, 검은 공 차례마다 b,…,b+n−s−1b,\dots,b+n-s-1이 나오고 분모는 (a+b)(a+b+1)⋯(a+b+n−1)(a+b)(a+b+1)\cdots(a+b+n-1)이므로 순서에 무관하다. 그 값은 Γ(a+s)Γ(b+n−s)Γ(a)Γ(b)⋅Γ(a+b)Γ(a+b+n)=B(a+s,b+n−s)B(a,b)=∫01ps(1−p)n−sBeta(a,b)(dp)\frac{\Gamma(a+s)\Gamma(b+n-s)}{\Gamma(a)\Gamma(b)}\cdot\frac{\Gamma(a+b)}{\Gamma(a+b+n)}=\frac{B(a+s,b+n-s)}{B(a,b)}=\int_0^1p^s(1-p)^{n-s}\mathrm{Beta}(a,\allowbreak b)(dp)이다.

이 회차에서 읽은 절 0개 · 회차 차례