
테마
10회 · 숨은 변수와 EM · 노트
6 부숴보기 — 무한대의 가능도와 성분의 수
6.1 가능도가 무한대로 가는 점
명제 6.1 (혼합 가능도는 유계가 아니다) 분산이 성분마다 다른 정규 혼합에서 이다.
증명 전략 한 성분의 평균을 관측 하나에 놓고 그 분산을 0으로 보낸다. 나머지 관측은 다른 성분이 받쳐 주어 로그밀도가 아래로 유계로 남는다. 단계별 증명은 연습 6.4(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.
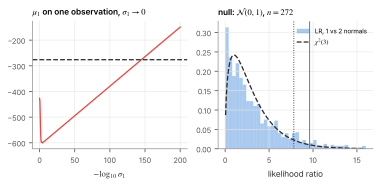
엄밀한 뜻의 MLE, 곧 가능도의 최댓값은 없다. 한 성분이 관측 하나에 달라붙어 분산을 0으로 줄이면 가능도는 끝없이 커진다(그림 6.1). 그래도 Kiefer(1978)는 내부에 일치하는 근이 있음을 보였다(9회 정리 1.6의 혼합판). EM이 실제로 찾는 것은 이 근 근처의 국소 최대점이다. 다만 반복 중에 한 성분의 가 1 근처로 줄면 그 성분은 특이점으로 끌려간다. 처방은 셋이다. (1) 모든 성분의 분산을 같게 둔다. 그러면 가능도가 유계다(연습 6.1). (2) 로 제약한다(Hathaway, 1985). (3) 분산에 사전분포나 벌점을 준다(16회).
6.2 성분은 몇 개인가
한 정규()와 두 정규의 혼합()을 가능도비로 비교하고 싶다. 모수의 차이는 셋(, 둘째 평균, 둘째 분산)이므로 을 쓰고 싶어진다. 그러나 Wilks 정리(9회 정리 5.2, 정리 1.8)의 조건이 두 군데서 깨진다.
귀무가설 “”은 (경계, 9회 연습 6.3) 또는 로 쓰인다. 한 모형이 모수공간의 여러 곳에 나타난다.
이면 가 가능도에 나타나지 않는다. 귀무가설 아래에서 식별되지 않는 모수가 있다. 그래서 정보 행렬이 특이하고, 테일러 전개의 바탕이 무너진다.
Hartigan(1985)은 평균이 유계가 아니면 이 가능도비가 귀무가설 아래에서 일 때 확률적으로 무한대로 간다는 것을 보였다(아주 느리게). 실전의 처방은 모수적 부트스트랩이다. 귀무가설 모형에서 자료를 여러 번 만들어 같은 가능도비를 계산하고, 그 분포에서 관측값의 위치를 읽는다(15회). 인 표준정규 자료로 1,000번 해 보면 가능도비의 95% 분위수는 약 9.6이고, 의 임계값 7.81을 넘는 비율은 약 0.10이다. 을 그대로 쓰면 크기 0.05의 검정이 실제로는 0.10의 검정이 되어 성분을 너무 자주 더한다. Old Faithful의 290이나 게의 52.7은 어느 기준으로도 압도적이다.
6.3 느린 수렴
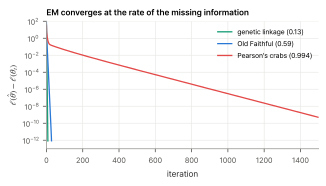
정리 3.6의 비율을 세 예제에서 비교하면 EM의 성격이 드러난다. 유전 연관은 0.13, Old Faithful은 0.59, Pearson의 게는 0.994다(그림 6.2). 게에서 비율 를 의 정밀도로 얻으려면 1,700번 넘게 돌려야 한다. 겹친 성분은 이름표의 정보가 대부분 사라진 경우이므로, 느린 수렴은 알고리즘의 결함이라기보다 자료가 모수를 잘 정하지 못한다는 신호다(예제 5.4). EM을 가속하는 방법(Aitken 가속, 몇 번의 EM 뒤에 Newton으로 바꾸기 등)이 있지만, 표준오차가 크다는 사실은 바뀌지 않는다.
연습문제
연습 6.1 (같은 분산이면 유계 ★★) 모든 성분의 분산이 같은 인 혼합에서 서로 다른 관측값이 개보다 많으면 로그가능도가 위로 유계임을 보여라. (힌트: 이면 어떤 성분 평균에도 놓이지 않는 관측의 밀도가 0으로 간다.)
풀이
이면 어떤 와도 같지 않은 관측 의 혼합 밀도는 (는 가장 가까운 평균까지의 거리)이다. 서로 다른 값이 개보다 많으면 그런 관측이 늘 있다. 그 관측의 로그밀도가 로 가는 속도()가 평균 위의 관측의 증가 속도()보다 빠르므로 위로 유계다. (가 0으로 가는 경우도 가 많아야 개의 값에만 붙을 수 있다는 것으로 같은 논증이 된다.)
연습 6.2 (분산의 비 제약 ★★★) 서로 다른 관측값이 2개보다 많을 때, 로 제약하면 두 성분 혼합의 로그가능도가 유계임을 보여라. (힌트: 이면 이다.)
풀이
이면 이다. 그러면 연습 6.1의 논증이 그대로 쓰여, 어느 평균에도 붙지 않은 관측의 밀도가 지수적으로 0으로 간다. 두 분산이 모두 0에서 떨어져 있으면 밀도는 이하로 유계다.
연습 6.3 (성분 수의 정보 기준 ★) Old Faithful의 분출 시간에 의 정규 혼합을 맞추고 AIC 와 BIC 을 비교하라(노트북). 어느 를 고르는가?
풀이
로그가능도는 에서 , , 이고 모수의 수는 이다. AIC는 846.8, 562.7, 551.8로 을, BIC는 854.1, 580.8, 580.6으로 와 3을 거의 같게 본다. 셋째 성분(비율 0.15, 평균 3.73, 표준편차 0.54)은 긴 분출 무리의 왼쪽 꼬리를 맞춘다. 정보 기준도 성분 수의 문제를 완전히 풀지 못한다(6.2절).
연습 6.4 (혼합 가능도는 유계가 아니다: 증명 ★ 유도형) 두 성분 정규 혼합 에서 명제 6.1를 다음 순서로 증명하라.
- (a)
혼합 밀도는 두 항 각각보다 크거나 같음을 보여라.
- (b)
로 두고 , , 을 고정한다. (a)를 관측 1에는 첫 항으로, 나머지 관측에는 둘째 항으로 써서 를 보여라.
- (c)
이면 오른쪽이 로 감을 보여라. 둘째 합이 에 의존하지 않는다는 것이 어디에 쓰이는가?
- (d)
두 성분의 분산이 같다는 제약 아래에서는 왜 (b)의 논증이 막히는지 설명하라(연습 6.1).
풀이
(a) 두 항이 모두 0 이상이므로 합은 각 항보다 크거나 같다. (b) 관측 1에는 첫 항, 나머지에는 둘째 항을 쓰면 이고, 이다. (c) 첫 항 은 에서 로 가고, 둘째 합은 에 의존하지 않는 유한한 값이다. 둘째 합이 고정되어 있어야 첫 항의 발산이 다른 관측의 손실로 상쇄되지 않는다. (d) 분산이 같으면 일 때 이어서 둘째 합의 각 항이 로 간다. 어느 평균에도 놓이지 않은 관측의 로그밀도는 의 속도로 줄어 의 증가를 이긴다(연습 6.1의 풀이).