
테마
노트북 · 10회 · 숨은 변수와 EM
숨은 변수와 EM 보이지 않는 것을 채우는 알고리즘
| 강의노트 | 10_em_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 10_em_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Weldon의 나폴리 게 1,000마리 (Pearson 1894; R mixdist::pearson의 묶음표를 그대로 옮김) · Old Faithful 272번 분출 (datasets faithful) · DLR의 유전 연관 자료 (125, 18, 20, 34) · The Federalist의 may (vcd Federalist) |
| 선수 지식 | 1–9회 (2회 Jensen·Gibbs, 4회 혼합분포, 5회 조건부 정규, 7회 다변량 CLT, 9회 최대가능도·Wilks) |
여는 질문. 나폴리 만의 게 1,000마리를 쟀더니 이마 폭의 분포가 한쪽으로 기울어 있다. 두 무리가 섞여 있는 것은 아닐까? 그런데 어느 게가 어느 무리인지는 아무도 모른다. 이름표가 없는 자료에서 두 무리의 평균과 비율을 추정할 수 있는가?
이번 회차의 지도
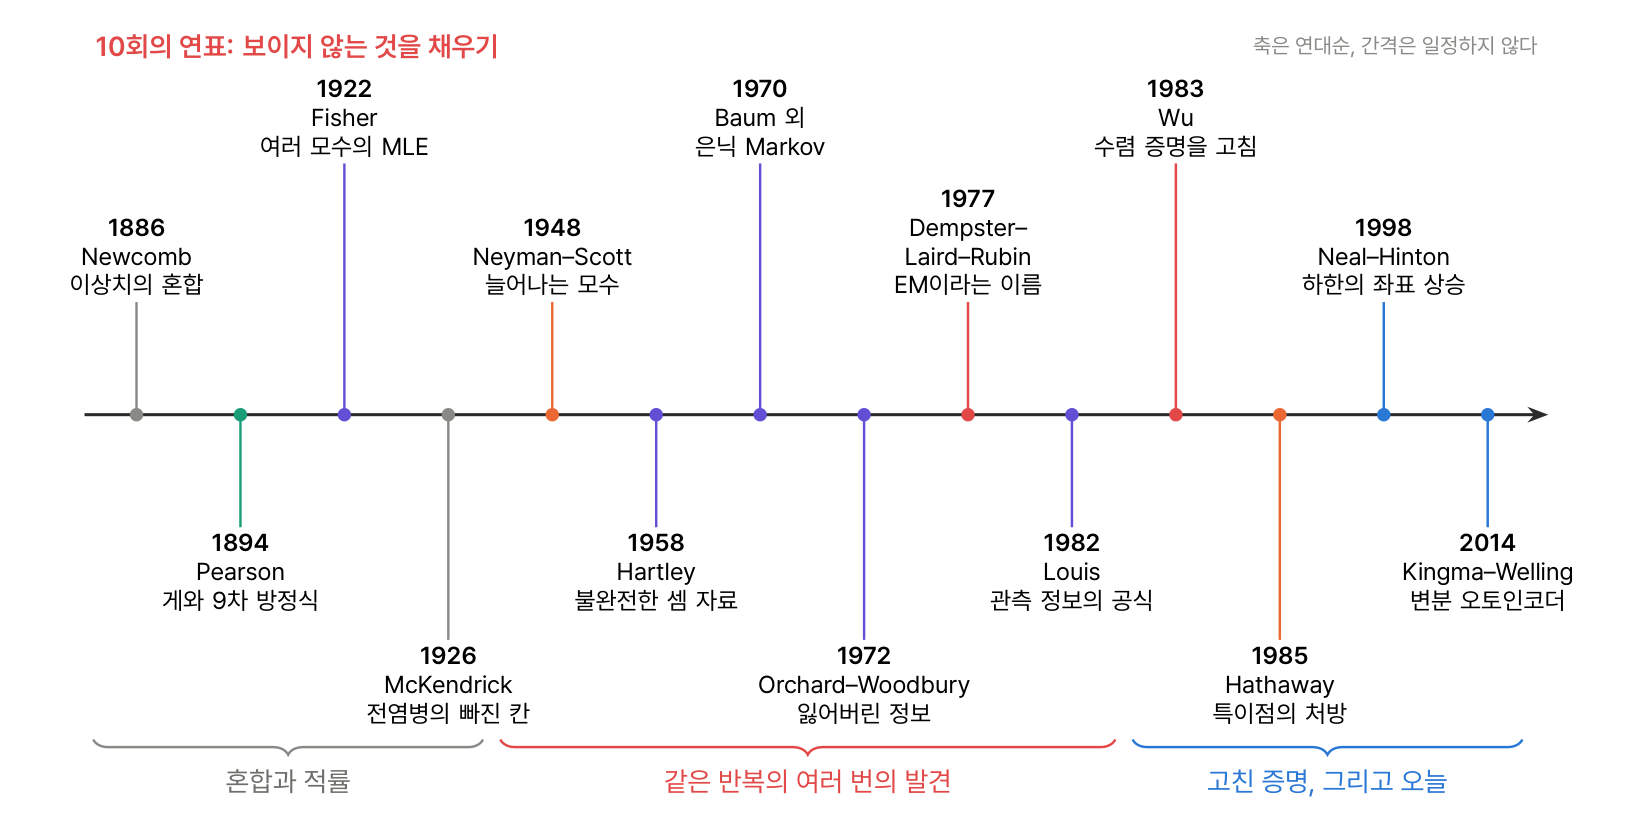
학습 목표
- 정보 행렬과 다변량 점근정규성을 시뮬레이션으로 확인하고, 귀찮은 모수의 대가(Schur 보수)를 숫자로 본다.
- 프로파일 가능도와 그 Wilks 정리를 확인한다.
- EM을 구현해 단조성, ELBO 분해, 잃어버린 정보와 수렴 속도를 유전 연관 자료에서 하나하나 확인한다.
- 정규 혼합의 EM을 클래스로 만들어 Pearson의 적률법, 일반 최적화와 비교한다.
- 특이점, 성분 수 검정, 느린 수렴, Neyman–Scott의 고침, -평균과 ELBO를 코드로 본다.
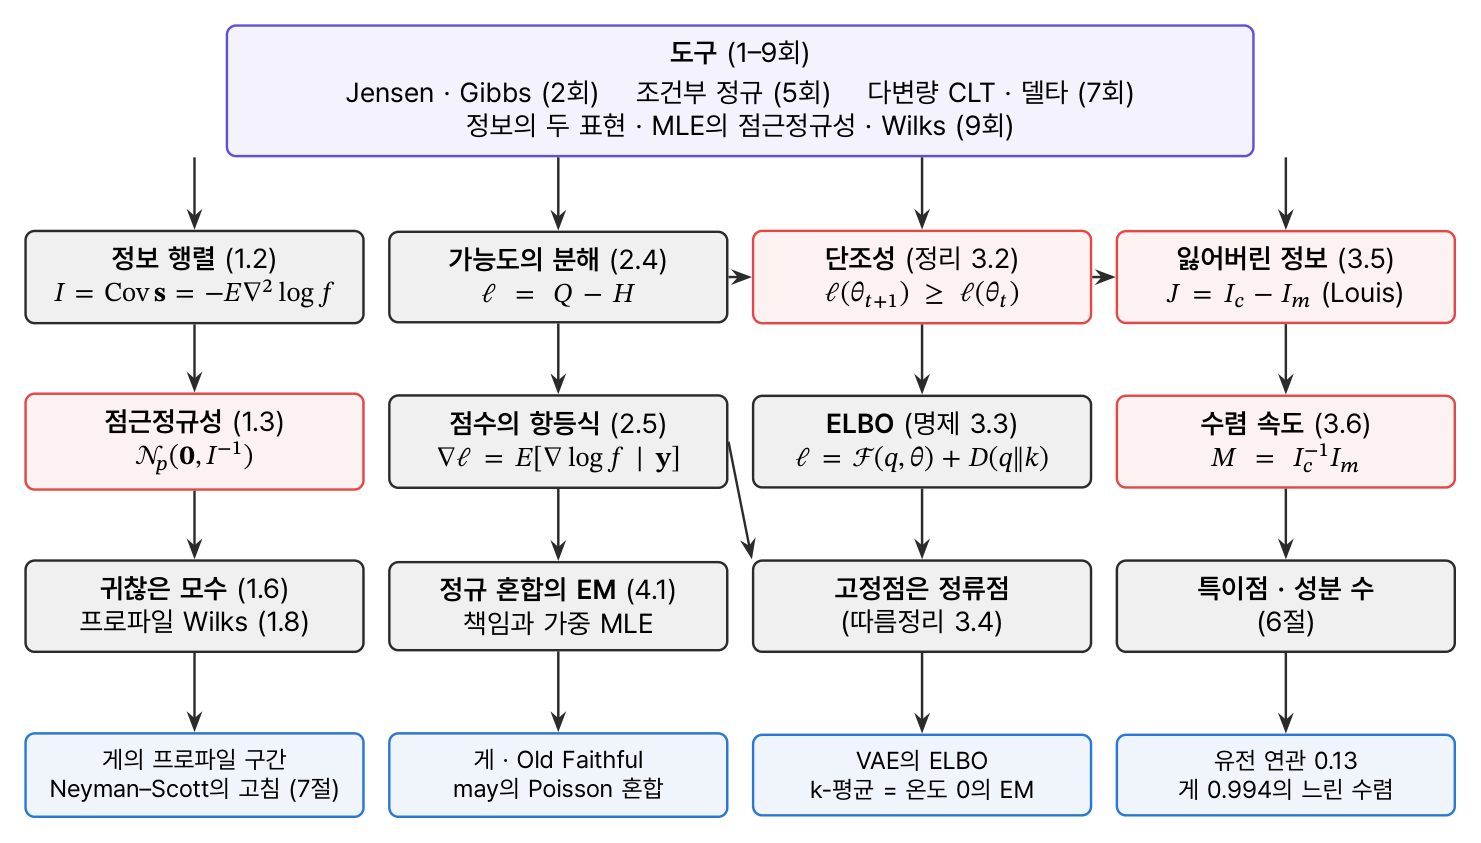
정리 지도
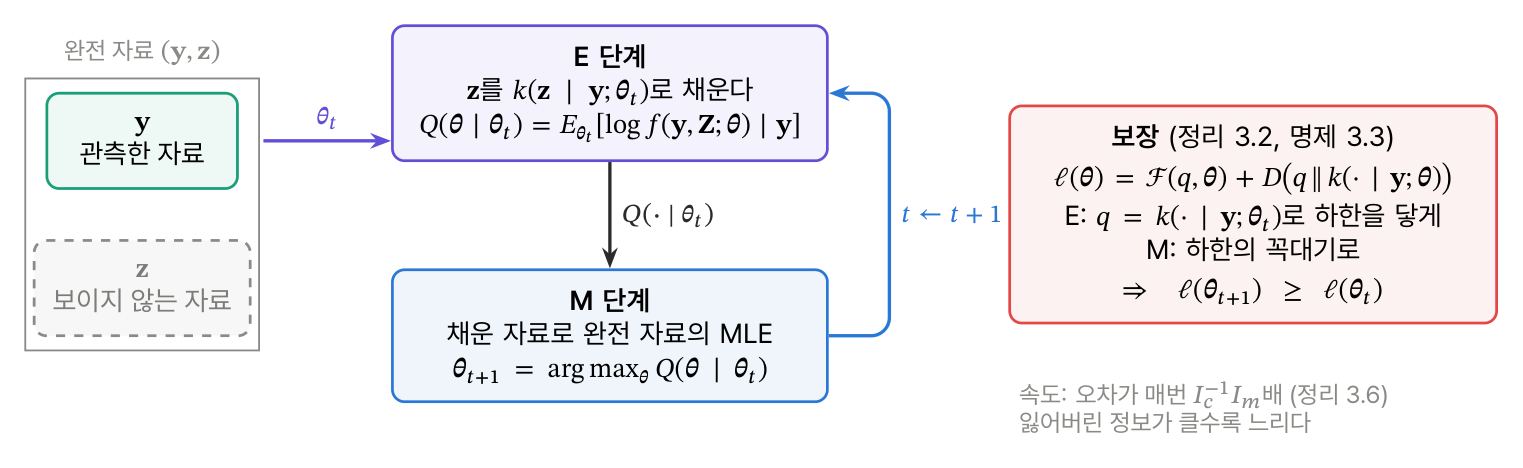
EM의 한 바퀴
0. 설정
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse
from scipy import integrate, optimize, special, stats

SEED = 1977
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se

def num_hessian(f, x0, h=1e-5):
    """중앙차분 헤세 행렬 — 관측 정보 J = −∇²ℓ 을 구할 때 쓴다"""
    x0 = np.asarray(x0, float); k = len(x0); H = np.zeros((k, k)); E = np.eye(k) * h
    for i in range(k):
        for j in range(k):
            H[i, j] = (f(x0 + E[i] + E[j]) - f(x0 + E[i] - E[j]) - f(x0 - E[i] + E[j]) + f(x0 - E[i] - E[j])) / (4 * h * h)
    return H
1. 여러 모수의 가능도
정의 1.1 · 정리 1.2 · 정리 1.3 · 따름정리 1.4 신뢰타원체, 다변량 델타 · 보조정리 1.5 · 정리 1.6 · 정의 1.7 · 정리 1.8 프로파일 가능도와 그 Wilks 정리 · 예제 1.9 정규 평균의 프로파일 = 검정.
python
# 정리 1.2 · 1.3: 감마(α, β) — 정보 행렬의 두 표현, 그리고 MLE 의 공분산 ≈ I⁻¹/n
alpha, beta = 2.0, 1.5
I_gam = np.array([[special.polygamma(1, alpha), 1 / beta], [1 / beta, alpha / beta**2]])
x = rng.gamma(alpha, beta, 2_000_000)
S = np.vstack([-special.digamma(alpha) - math.log(beta) + np.log(x), -alpha / beta + x / beta**2])   # 점수 벡터
Hmean = np.array([[-special.polygamma(1, alpha), -1 / beta], [-1 / beta, alpha / beta**2 - 2 * x.mean() / beta**3]])

def gamma_mle(G):
    """프로파일 방정식 log α − ψ(α) = log x̄ − mean(log x) 를 Newton 으로 (연습 1.4), β = x̄/α"""
    s = np.log(G.mean(1)) - np.log(G).mean(1)
    a = (3 - s + np.sqrt((s - 3) ** 2 + 24 * s)) / (12 * s)
    for _ in range(30):
        a = a - (np.log(a) - special.digamma(a) - s) / (1 / a - special.polygamma(1, a))
    return a, G.mean(1) / a

n, R = 400, 20_000
a_hat, b_hat = gamma_mle(rng.gamma(alpha, beta, (R, n)))
cov_mle = n * np.cov(np.vstack([a_hat, b_hat]))
print("I (이론):\n", I_gam.round(4), "\nCov(점수) (시뮬레이션):\n", np.cov(S).round(4), "\n−E∇² log f:\n", (-Hmean).round(4))
print("n Cov(MLE) (n = 400):\n", cov_mle.round(3), "\nI⁻¹:\n", np.linalg.inv(I_gam).round(3))
# 따름정리 1.4 (a): 신뢰타원체의 포함확률
D = np.vstack([a_hat - alpha, b_hat - beta]).T
Iplug = np.array([[[special.polygamma(1, a), 1 / b], [1 / b, a / b**2]] for a, b in zip(a_hat[:5000], b_hat[:5000])])
Q = n * np.einsum("ri,rij,rj->r", D[:5000], Iplug, D[:5000])
cover = np.mean(Q <= stats.chi2.ppf(0.95, 2))
report({"정리 1.2: Cov(점수) = −E∇² log f = I (1% 안)": np.allclose(np.cov(S), I_gam, rtol=0.01) and np.allclose(-Hmean, I_gam, rtol=0.01),
        "정리 1.3: n Cov(α̂, β̂) ≈ I⁻¹ (n = 400, 6% 안)": np.allclose(cov_mle, np.linalg.inv(I_gam), rtol=0.06),
        "따름정리 1.4 (a): 95% 신뢰타원체의 포함확률 ≈ 0.95 (±0.015)": abs(cover - 0.95) < 0.015})
text
I (이론):
 [[0.6449 0.6667]
 [0.6667 0.8889]]
Cov(점수) (시뮬레이션):
 [[0.6454 0.6674]
 [0.6674 0.8907]]
−E∇² log f:
 [[0.6449 0.6667]
 [0.6667 0.8895]]
n Cov(MLE) (n = 400):
 [[ 7.133 -5.246]
 [-5.246  4.991]]
I⁻¹:
 [[ 6.9   -5.175]
 [-5.175  5.006]]
  ✓  정리 1.2: Cov(점수) = −E∇² log f = I (1% 안)
  ✓  정리 1.3: n Cov(α̂, β̂) ≈ I⁻¹ (n = 400, 6% 안)
  ✓  따름정리 1.4 (a): 95% 신뢰타원체의 포함확률 ≈ 0.95 (±0.015)
python
# 보조정리 1.5 · 정리 1.6: 귀찮은 모수의 대가 — Schur 보수
def schur_cost(I, r):
    """앞의 r 개가 관심 모수일 때 (I⁻¹)_ψψ 와 I_ψψ⁻¹"""
    A, B, Cm = I[:r, :r], I[:r, r:], I[r:, r:]
    S = A - B @ np.linalg.solve(Cm, B.T)
    return np.linalg.inv(S), np.linalg.inv(A)

inv_full, inv_known = schur_cost(I_gam, 1)
I_norm = np.diag([1 / 4.0, 1 / (2 * 16.0)])            # N(μ, σ²=4): 직교
nf, nk = schur_cost(I_norm, 1)
# 보조정리 1.5 의 최소화: 무작위 v 로 이차형식을 재도 Schur 값보다 작아지지 않는다
u = np.array([0.7])
qmin = (u @ np.linalg.inv(inv_full) @ u)
vs = rng.normal(0, 3, (20_000, 1))
q_rand = np.array([np.r_[u, v] @ I_gam @ np.r_[u, v] for v in vs])
v_star = -np.linalg.solve(I_gam[1:, 1:], I_gam[1:, :1] @ u)
print(f"감마: β 를 알면 n Var(α̂) = {inv_known[0, 0]:.3f}, 모르면 {inv_full[0, 0]:.3f} (×{inv_full[0, 0] / inv_known[0, 0]:.2f});  정규 (μ, σ²): {nk[0, 0]:.1f} = {nf[0, 0]:.1f}")
report({"정리 1.6: 감마의 대가 1.55 → 6.90 (9회 연습 3.3)": abs(inv_known[0, 0] - 1.551) < 1e-3 and abs(inv_full[0, 0] - 6.900) < 1e-3,
        "정리 1.6: 직교하면 대가가 없다 (정규)": abs(nf[0, 0] - nk[0, 0]) < 1e-12,
        "보조정리 1.5: min_v 이차형식 = uᵀ S u, 최소점 v* = −I_λλ⁻¹ I_λψ u": q_rand.min() >= qmin - 1e-12 and abs(np.r_[u, v_star] @ I_gam @ np.r_[u, v_star] - qmin) < 1e-12})
text
감마: β 를 알면 n Var(α̂) = 1.551, 모르면 6.900 (×4.45);  정규 (μ, σ²): 4.0 = 4.0
  ✓  정리 1.6: 감마의 대가 1.55 → 6.90 (9회 연습 3.3)
  ✓  정리 1.6: 직교하면 대가가 없다 (정규)
  ✓  보조정리 1.5: min_v 이차형식 = uᵀ S u, 최소점 v* = −I_λλ⁻¹ I_λψ u
python
# 정리 1.8 · 예제 1.9 · 연습 1.5: 프로파일 가능도비 — 정규 평균 (σ² 귀찮은 모수), 두 표본 차
def profile_lr_mean(x, mu0):
    n = len(x); s2 = x.var()
    return n * math.log(1 + (x.mean() - mu0) ** 2 / s2)

n = 15
X = rng.normal(3, 2, (50_000, n))
s2 = X.var(1); t = (X.mean(1) - 3) / (X.std(1, ddof=1) / math.sqrt(n))
Lam = n * np.log1p((X.mean(1) - 3) ** 2 / s2)
size_chi2 = np.mean(Lam > stats.chi2.ppf(0.95, 1))
# 두 표본: Λ = (m+n) log(1 + t²/(m+n−2))
m_, n_ = 8, 12
xa, ya = rng.normal(0, 1, m_), rng.normal(0.5, 1, n_)
def nll_two(par, psi):
    lam, ls2 = par
    return -(np.sum(stats.norm.logpdf(xa, lam + psi, math.exp(ls2 / 2))) + np.sum(stats.norm.logpdf(ya, lam, math.exp(ls2 / 2))))
full = optimize.minimize(lambda p: nll_two(p[:2], p[2]), [0, 0, 0], method="BFGS").fun
prof = optimize.minimize(lambda p: nll_two(p, 0.0), [0, 0], method="BFGS").fun
t2 = stats.ttest_ind(xa, ya, equal_var=True).statistic
print(f"n = 15: χ²(1) 임계값을 쓴 크기 {size_chi2:.4f};  두 표본: 2Δℓ = {2 * (prof - full):.6f}, (m+n) log(1 + t²/(m+n−2)) = {(m_ + n_) * math.log1p(t2**2 / (m_ + n_ - 2)):.6f}")
report({"예제 1.9: Λ = n log(1 + t²/(n−1)) (모든 표본에서)": np.allclose(Lam, n * np.log1p(t**2 / (n - 1))),
        "예제 1.9: Λ 는 |t| 의 증가함수 — t 분포 임계값과 같은 기각역": np.array_equal(Lam > n * math.log1p(stats.t.ppf(0.975, n - 1) ** 2 / (n - 1)), np.abs(t) > stats.t.ppf(0.975, n - 1)),
        "정리 1.8: χ²(1) 근사의 크기 ≈ 0.05 (n = 15 에서 약간 크다, 0.05–0.07)": 0.05 < size_chi2 < 0.07,
        "연습 1.5: 두 표본의 프로파일 가능도비 = (m+n) log(1 + t²/(m+n−2))": abs(2 * (prof - full) - (m_ + n_) * math.log1p(t2**2 / (m_ + n_ - 2))) < 1e-5})
text
n = 15: χ²(1) 임계값을 쓴 크기 0.0633;  두 표본: 2Δℓ = 13.801590, (m+n) log(1 + t²/(m+n−2)) = 13.801590
  ✓  예제 1.9: Λ = n log(1 + t²/(n−1)) (모든 표본에서)
  ✓  예제 1.9: Λ 는 |t| 의 증가함수 — t 분포 임계값과 같은 기각역
  ✓  정리 1.8: χ²(1) 근사의 크기 ≈ 0.05 (n = 15 에서 약간 크다, 0.05–0.07)
  ✓  연습 1.5: 두 표본의 프로파일 가능도비 = (m+n) log(1 + t²/(m+n−2))
python
# 연습 1.1 · 1.3: (μ, σ) 의 정보 diag(1/σ², 2/σ²), 변동계수 ĉ = σ̂/x̄ 의 점근분산 c²(c² + 1/2)/n
mu, sig = 5.0, 2.0
xs = rng.normal(mu, sig, 2_000_000)
sc = np.vstack([(xs - mu) / sig**2, -1 / sig + (xs - mu) ** 2 / sig**3])
n = 200
Xc = rng.normal(mu, sig, (50_000, n))
c_hat = Xc.std(1) / Xc.mean(1); c0 = sig / mu
print(f"Cov(점수) = {np.cov(sc).round(4).tolist()};  n Var(ĉ) = {n * c_hat.var():.4f}, 이론 {c0**2 * (c0**2 + 0.5):.4f}")
report({"연습 1.1: (μ, σ) 의 정보 diag(1/σ², 2/σ²)": np.allclose(np.cov(sc), np.diag([1 / sig**2, 2 / sig**2]), atol=2e-3),
        "연습 1.3: n Var(ĉ) ≈ c²(c² + 1/2) (3% 안)": abs(n * c_hat.var() / (c0**2 * (c0**2 + 0.5)) - 1) < 0.03})
text
Cov(점수) = [[0.2501, -0.0004], [-0.0004, 0.501]]; n Var(ĉ) = 0.1053, 이론 0.1056text
  ✓  연습 1.1: (μ, σ) 의 정보 diag(1/σ², 2/σ²)
  ✓  연습 1.3: n Var(ĉ) ≈ c²(c² + 1/2) (3% 안)
📝 연습 1.1–1.5 (강의노트): 정규의 정보 행렬, 블록 역행렬, 변동계수, 감마의 프로파일 가능도, 두 표본의 평균 차.
2. 보이지 않는 자료의 가능도
정의 2.1 , · 예제 2.2 숨은 자료의 네 얼굴 · 예제 2.3 유전 연관 · 보조정리 2.4 · 명제 2.5 .
python
# 예제 2.3 · 연습 2.1–2.2: 유전 연관 자료 (Rao 1965 → DLR 1977)
y_link = np.array([125, 18, 20, 34])
probs = lambda t: np.array([0.5 + t / 4, (1 - t) / 4, (1 - t) / 4, t / 4])
ll_link = lambda t: float(np.sum(y_link * np.log(probs(t))))
th_closed = (15 + math.sqrt(53809)) / 394
th_num = optimize.minimize_scalar(lambda t: -ll_link(t), bounds=(0.01, 0.99), method="bounded", options=dict(xatol=1e-12)).x
# 완전 자료: 첫 칸을 (x1, x2) 로 나누면 x2 | y ~ Bin(125, θ/(2+θ)), 완전 자료 MLE (x2 + 34)/(x2 + 72)
th = 0.6
sims = rng.multinomial(197, [0.5, th / 4, (1 - th) / 4, (1 - th) / 4, th / 4], 400_000)   # 다섯 칸: x1, x2, y2, y3, y4
first = sims[:, 0] + sims[:, 1]
sel = first == 125
q = th / (2 + th)
print(f"θ̂: 닫힌 꼴 {th_closed:.6f}, 수치 {th_num:.6f};  x2 | (첫 칸 = 125) 의 평균 {sims[sel, 1].mean():.3f} (이론 {125 * q:.3f}), 분산 {sims[sel, 1].var():.3f} (이론 {125 * q * (1 - q):.3f})")
report({"예제 2.3 · 연습 2.1: 197θ² − 15θ − 68 = 0 의 양의 근 0.6268 = 수치 최대점": abs(th_closed - th_num) < 1e-8 and abs(th_closed - 0.6268) < 5e-5
            and abs(197 * th_closed**2 - 15 * th_closed - 68) < 1e-10,
        "연습 2.2: x2 | y ~ Bin(125, θ/(2+θ)) (조건부 시뮬레이션, 평균·분산 4 se 안)": within(sims[sel, 1].mean(), 125 * q, math.sqrt(125 * q * (1 - q) / sel.sum()))
            and abs(sims[sel, 1].var() / (125 * q * (1 - q)) - 1) < 0.1})
text
θ̂: 닫힌 꼴 0.626821, 수치 0.626821;  x2 | (첫 칸 = 125) 의 평균 28.885 (이론 28.846), 분산 21.893 (이론 22.189)
  ✓  예제 2.3 · 연습 2.1: 197θ² − 15θ − 68 = 0 의 양의 근 0.6268 = 수치 최대점
  ✓  연습 2.2: x2 | y ~ Bin(125, θ/(2+θ)) (조건부 시뮬레이션, 평균·분산 4 se 안)
python
# 보조정리 2.4 · 명제 2.5: 분해 ℓ = Q − H 와 점수의 항등식 — 유전 연관 자료에서 직접
def Q_link(t, tp):
    """Q(θ|θ') = E_θ'[log f(y, x2; θ) | y] 에서 θ 에 의존하는 항 (다항계수는 뺐다)"""
    qp = tp / (2 + tp); Ex2 = 125 * qp
    return (125 - Ex2) * math.log(0.5) + Ex2 * math.log(t / 4) + 38 * math.log((1 - t) / 4) + 34 * math.log(t / 4)

def H_link(t, tp):
    """H(θ|θ') = E_θ'[log k(x2 | y; θ)], x2 | y ~ Bin(125, θ/(2+θ))"""
    qp = tp / (2 + tp); q = t / (2 + t)
    k = np.arange(126); w = stats.binom.pmf(k, 125, qp)
    return float(np.sum(w * stats.binom.logpmf(k, 125, q)))

def ll_link_full(t):
    """관측 가능도 (다항계수 포함) — 분해의 양변을 같은 상수로 맞추려고"""
    return float(stats.multinomial.logpmf(y_link, 197, probs(t)))

# Q 의 다항계수를 기댓값으로 다루는 대신, ℓ − (Q − H) 가 θ 에 무관한 상수임을 확인한다
gaps_by_tp = {tp: [ll_link_full(t) - (Q_link(t, tp) - H_link(t, tp)) for t in (0.3, 0.5, 0.7, 0.9)] for tp in (0.4, 0.6)}
# 점수의 항등식: ℓ'(θ) = ∂Q(θ|θ')/∂θ at θ' = θ
h = 1e-6
score_obs = (ll_link(0.55 + h) - ll_link(0.55 - h)) / (2 * h)
score_Q = (Q_link(0.55 + h, 0.55) - Q_link(0.55 - h, 0.55)) / (2 * h)
print("ℓ − (Q − H), θ' 마다 θ 에 따라:", {tp: np.round(v, 10).tolist() for tp, v in gaps_by_tp.items()})
print(f"명제 2.5: ℓ'(0.55) = {score_obs:.6f},  ∂Q/∂θ|θ'=θ = {score_Q:.6f}")
report({"보조정리 2.4: ℓ(θ) − [Q(θ|θ') − H(θ|θ')] 는 θ 에 무관 (θ' 를 고정하면 상수)": all(np.ptp(v) < 1e-8 for v in gaps_by_tp.values()),
        "명제 2.5: 관측 점수 = 완전 자료 점수의 조건부 기댓값": abs(score_obs - score_Q) < 1e-5})
text
ℓ − (Q − H), θ' 마다 θ 에 따라: {0.4: [251.6435300616, 251.6435300616, 251.6435300616, 251.6435300616], 0.6: [262.7251226206, 262.7251226206, 262.7251226206, 262.7251226206]}
명제 2.5: ℓ'(0.55) = 26.393345,  ∂Q/∂θ|θ'=θ = 26.393345
  ✓  보조정리 2.4: ℓ(θ) − [Q(θ|θ') − H(θ|θ')] 는 θ 에 무관 (θ' 를 고정하면 상수)
  ✓  명제 2.5: 관측 점수 = 완전 자료 점수의 조건부 기댓값
한마디. 위 셀의 상수 차이는 에서 다항계수의 기댓값을 계산하지 않았기 때문이다. 다항계수는 에 의존하지 않으므로 EM에 아무 영향이 없다. EM이 쓰는 것은 를 에 대해 최대화하는 것뿐이기 때문이다.
📝 연습 2.1–2.5 (강의노트): 유전 연관의 이차방정식, 숨은 칸의 조건부분포, 중도절단된 지수분포, 혼합의 점수, 묶음 자료.
3. EM 알고리즘
알고리즘 3.1 E: , M: · 정리 3.2 · 명제 3.3 · 따름정리 3.4 고정점 = 정류점 · 정리 3.5 , (Louis) · 정리 3.6 · 예제 3.7 유전 연관의 EM.
python
class LinkageEM:
    """예제 3.7: 유전 연관 자료의 EM — E 단계는 x2 의 조건부 기댓값, M 단계는 이항 비율"""
    def __init__(self, y):
        self.y = np.asarray(y)

    def e_step(self, t):
        return self.y[0] * t / (2 + t)

    def m_step(self, x2):
        return (x2 + self.y[3]) / (x2 + self.y[1] + self.y[2] + self.y[3])

    def run(self, t0, iters=30):
        path = [t0]
        for _ in range(iters):
            path.append(self.m_step(self.e_step(path[-1])))
        return np.array(path)

path = LinkageEM(y_link).run(0.5)
err = np.abs(path - th_closed)
ratios = err[1:8] / err[:7]
lls = np.array([ll_link(t) for t in path])
# 정리 3.5 · 연습 3.2: 정보의 분해와 Louis 공식
th_ = th_closed
J = 125 / (2 + th_) ** 2 + 38 / (1 - th_) ** 2 + 34 / th_**2
x2h = 125 * th_ / (2 + th_)
I_c = (x2h + 34) / th_**2 + 38 / (1 - th_) ** 2
q = th_ / (2 + th_)
I_m_louis = 125 * q * (1 - q) / th_**2                        # Var(완전 자료 점수 | y) = Var(x2 | y)/θ²
emap = lambda t: LinkageEM(y_link).m_step(LinkageEM(y_link).e_step(t))
slope = (emap(th_ + 1e-6) - emap(th_ - 1e-6)) / 2e-6
print("EM 경로:", np.round(path[:6], 4), "\n오차의 비:", np.round(ratios, 4))
print(f"J = {J:.1f}, I_c = {I_c:.1f}, I_m = I_c − J = {I_c - J:.1f} (Louis {I_m_louis:.1f}),  I_m/I_c = {(I_c - J) / I_c:.4f},  EM 사상의 기울기 {slope:.4f},  se = {1 / math.sqrt(J):.4f}")
report({"정리 3.2: 매 반복 ℓ 이 줄지 않는다": np.all(np.diff(lls) >= -1e-12),
        "예제 3.7: 경로 0.6082, 0.6243, 0.6265, 0.6268": np.allclose(path[1:5], [0.6082, 0.6243, 0.6265, 0.6268], atol=5e-5),
        "정리 3.5: J = 377.5, I_c = 435.3, I_m = 57.8, Louis 공식과 일치": abs(J - 377.5) < 0.05 and abs(I_c - 435.3) < 0.05 and abs(I_c - J - I_m_louis) < 1e-9,
        "정리 3.6 · 연습 3.2: 오차의 비 → I_m/I_c = 0.1328 = EM 사상의 기울기": abs(ratios[-1] - 0.1328) < 1e-4 and abs(slope - (I_c - J) / I_c) < 1e-7,
        "예제 3.7: 표준오차 1/√J = 0.0515": abs(1 / math.sqrt(J) - 0.0515) < 5e-5,
        "따름정리 3.4: 고정점에서 ℓ' = 0": abs((ll_link(path[-1] + 1e-6) - ll_link(path[-1] - 1e-6)) / 2e-6) < 1e-5})
text
EM 경로: [0.5    0.6082 0.6243 0.6265 0.6268 0.6268]
오차의 비: [0.1465 0.1346 0.133  0.1328 0.1328 0.1328 0.1328]
J = 377.5, I_c = 435.3, I_m = I_c − J = 57.8 (Louis 57.8),  I_m/I_c = 0.1328,  EM 사상의 기울기 0.1328,  se = 0.0515
  ✓  정리 3.2: 매 반복 ℓ 이 줄지 않는다
  ✓  예제 3.7: 경로 0.6082, 0.6243, 0.6265, 0.6268
  ✓  정리 3.5: J = 377.5, I_c = 435.3, I_m = 57.8, Louis 공식과 일치
  ✓  정리 3.6 · 연습 3.2: 오차의 비 → I_m/I_c = 0.1328 = EM 사상의 기울기
  ✓  예제 3.7: 표준오차 1/√J = 0.0515
  ✓  따름정리 3.4: 고정점에서 ℓ' = 0
python
# 명제 3.3: ELBO 분해 ℓ = F(q, θ) + D(q ‖ k) — 아무 q 에 대해, 숨은 칸 x2 의 분포 q 를 무작위로 골라
def elbo_link(qvec, t):
    """F(q, θ) = E_q log f(y, x2; θ) − E_q log q(x2), 완전 자료의 다항 로그확률 그대로"""
    k = np.arange(126)
    logf = (special.gammaln(198) - special.gammaln(125 - k + 1) - special.gammaln(k + 1) - sum(special.gammaln(v + 1) for v in (18, 20, 34))
            + (125 - k) * math.log(0.5) + k * math.log(t / 4) + 38 * math.log((1 - t) / 4) + 34 * math.log(t / 4))
    nz = qvec > 0
    return float(np.sum(qvec[nz] * (logf[nz] - np.log(qvec[nz]))))

k = np.arange(126)
checks = []
for t in (0.3, 0.6268, 0.8):
    post = stats.binom.pmf(k, 125, t / (2 + t))
    for _ in range(5):
        qv = rng.dirichlet(np.ones(126))
        kl = float(np.sum(qv * (np.log(qv) - np.log(post))))
        checks.append(abs(elbo_link(qv, t) + kl - ll_link_full(t)) < 1e-8 and elbo_link(qv, t) <= ll_link_full(t))
    checks.append(abs(elbo_link(post, t) - ll_link_full(t)) < 1e-8)        # q = k 이면 하한이 닿는다
report({"명제 3.3: 아무 q 에서나 ℓ = F + D(q‖k), F ≤ ℓ, q = k(·|y;θ) 이면 등호": all(checks)})

# 그림 3.2: 하한들이 θ_t 에서 ℓ 에 닿고, 그 꼭대기가 다음 반복점
tt = np.linspace(0.2, 0.95, 300)
fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
axes[0].plot(tt, [ll_link_full(t) for t in tt], color=C["ink"], label="ℓ(θ)")
p_ = LinkageEM(y_link).run(0.2, 3)
for t0, col in zip(p_[:3], SERIES):
    post = stats.binom.pmf(k, 125, t0 / (2 + t0))
    axes[0].plot(tt, [elbo_link(post, t) for t in tt], ls="--", color=col, lw=1.3)
    axes[0].plot(t0, ll_link_full(t0), "o", color=col)
axes[0].set_ylim(ll_link_full(0.2) - 8, ll_link_full(th_closed) + 2); axes[0].set_xlabel("θ"); axes[0].legend()
axes[0].set_title("lower bounds F(q_t, θ) touching ℓ at θ_t")
axes[1].semilogy(np.abs(LinkageEM(y_link).run(0.2, 16) - th_closed), "o-", color=C["stat"])
axes[1].set_xlabel("iteration t"); axes[1].set_title("|θ_t − θ̂|: a straight line of slope log 0.1328")
plt.tight_layout(); plt.show()
text
✓ 명제 3.3: 아무 q 에서나 ℓ = F + D(q‖k), F ≤ ℓ, q = k(·|y;θ) 이면 등호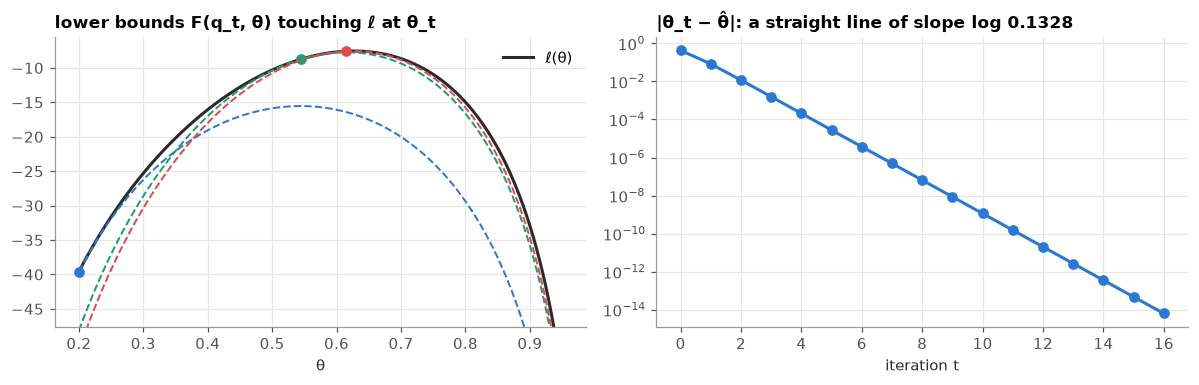
python
# 연습 2.3 · 3.3: 중도절단된 지수분포 — EM 의 고정점은 Σy/r, 수렴 비율은 절단된 비율 (n−r)/n
n, theta, c = 60, 2.0, 2.5
T = rng.exponential(theta, n); y_c = np.minimum(T, c); cens = T > c; r = int((~cens).sum())
mle = y_c.sum() / r
th = 1.0; traj = [th]
for _ in range(400):
    th = (y_c.sum() + (n - r) * th) / n                   # E: E[T | T > c] = c + θ (무기억성),  M: 평균
    traj.append(th)
traj = np.array(traj)
rat = (traj[11] - mle) / (traj[10] - mle)
nll_c = lambda t: r * math.log(t) + y_c.sum() / t
th_direct = optimize.minimize_scalar(nll_c, bounds=(0.1, 20), method="bounded", options=dict(xatol=1e-12)).x
print(f"절단 {n - r}/{n}; EM → {traj[-1]:.6f}, Σy/r = {mle:.6f}, 직접 최대화 {th_direct:.6f};  수렴 비율 {rat:.4f} = (n−r)/n = {(n - r) / n:.4f}")
# 연습 3.4: 일반화 EM — M 단계 대신 Q 를 조금만 올려도 (반걸음) 단조
th = 1.0; ll_g = []
for _ in range(60):
    full = (y_c.sum() + (n - r) * th) / n
    th = th + 0.5 * (full - th)                            # Q 는 θ 에 대해 단봉이므로 반걸음도 Q 를 늘린다
    ll_g.append(-nll_c(th))
report({"연습 2.3: 관측 가능도의 MLE = Σy/r": abs(th_direct - mle) < 1e-6,
        "연습 3.3: EM 의 고정점 = Σy/r, 수렴 비율 = 절단 비율": abs(traj[-1] - mle) < 1e-10 and abs(rat - (n - r) / n) < 1e-9,
        "연습 3.4: 일반화 EM 도 ℓ 을 줄이지 않는다": np.all(np.diff(ll_g) >= -1e-12)})
text
절단 17/60; EM → 2.112631, Σy/r = 2.112631, 직접 최대화 2.112631;  수렴 비율 0.2833 = (n−r)/n = 0.2833
  ✓  연습 2.3: 관측 가능도의 MLE = Σy/r
  ✓  연습 3.3: EM 의 고정점 = Σy/r, 수렴 비율 = 절단 비율
  ✓  연습 3.4: 일반화 EM 도 ℓ 을 줄이지 않는다
그림 읽기. 왼쪽의 점선들이 명제 3.3의 하한 다. 각 하한은 지금의 반복점에서 로그가능도에 닿고, 그 꼭대기가 다음 반복점이다. 하한을 깔고 오르기를 되풀이하니 가능도는 결코 줄지 않는다. 오른쪽은 오차의 로그가 직선, 곧 선형 수렴이다. 기울기는 잃어버린 정보의 비율 0.1328이다. 숨은 칸 가 정보의 13%를 가져갔다.
📝 연습 3.1–3.4 (강의노트): 는 제자리에서 최대, 유전 연관의 수렴 속도, 중도절단의 EM, 일반화 EM.
4. 정규 혼합의 EM
명제 4.1 책임 , M 단계는 무게 단 비율·평균·분산 · 알고리즘 4.2 logsumexp로 안전하게 · 명제 4.3 이름표 바꾸기 · 예제 4.4 같은 곳에서 출발하면 갈라지지 않는다.
차원, 성분, 관측마다 무게(도수)를 줄 수 있는 클래스 하나로 이 절과 다음 절을 모두 푼다.
python
class GaussianMixtureEM:
    """알고리즘 4.2: 정규 혼합의 EM. 관측마다 무게 w (묶음 자료의 도수) 를 줄 수 있다"""
    def __init__(self, K, tol=1e-10, max_iter=20_000):
        self.K, self.tol, self.max_iter = K, tol, max_iter

    def _log_joint(self, Y):
        # a_ik = log π_k + log φ(y_i; μ_k, Σ_k)
        return np.column_stack([np.log(self.pi[k]) + stats.multivariate_normal.logpdf(Y, self.mu[k], self.Sigma[k], allow_singular=False)
                                for k in range(self.K)]).reshape(len(Y), self.K)

    def e_step(self, Y):
        a = self._log_joint(Y)
        lse = special.logsumexp(a, axis=1)
        return np.exp(a - lse[:, None]), lse                    # 책임, 관측마다의 log g(y_i)

    def m_step(self, Y, R, w):
        Rw = R * w[:, None]; nk = Rw.sum(0)
        self.pi = nk / w.sum()
        self.mu = (Rw.T @ Y) / nk[:, None]
        self.Sigma = np.array([((Rw[:, k, None] * (Y - self.mu[k])).T @ (Y - self.mu[k])) / nk[k] for k in range(self.K)])

    def fit(self, Y, mu0, Sigma0=None, pi0=None, w=None):
        Y = np.asarray(Y, float).reshape(len(Y), -1); d = Y.shape[1]
        w = np.ones(len(Y)) if w is None else np.asarray(w, float)
        self.mu = np.asarray(mu0, float).reshape(self.K, d)
        cov = np.atleast_2d(np.cov(Y.T, aweights=w))
        self.Sigma = np.array([cov] * self.K) if Sigma0 is None else np.asarray(Sigma0, float).reshape(self.K, d, d)
        self.pi = np.full(self.K, 1 / self.K) if pi0 is None else np.asarray(pi0, float)
        self.loglik = []
        for it in range(self.max_iter):
            R, lse = self.e_step(Y)
            self.loglik.append(float(np.sum(w * lse)))
            if it > 0 and self.loglik[-1] - self.loglik[-2] < self.tol:
                break
            self.m_step(Y, R, w)
        self.n_iter = it
        return self

    def params_1d(self):
        """1차원 두 성분을 (π1, μ1, σ1, μ2, σ2) 로, 평균이 작은 쪽을 첫째로"""
        o = np.argsort(self.mu[:, 0])
        return np.array([self.pi[o[0]], self.mu[o[0], 0], math.sqrt(self.Sigma[o[0], 0, 0]), self.mu[o[1], 0], math.sqrt(self.Sigma[o[1], 0, 0])])

# 검증: 알고 있는 혼합에서 자료를 만들고 되찾는다
true = dict(pi=0.3, m1=-1.0, s1=0.5, m2=2.0, s2=1.0)
z = rng.random(5000) < true["pi"]
ysim = np.where(z, rng.normal(true["m1"], true["s1"], 5000), rng.normal(true["m2"], true["s2"], 5000))
gm = GaussianMixtureEM(2).fit(ysim, mu0=[[0.0], [1.0]])
est = gm.params_1d()
def nll_mix(th, y, w=None):
    p = special.expit(th[0]); w = np.ones(len(y)) if w is None else w
    return -np.sum(w * np.logaddexp(math.log(p) + stats.norm.logpdf(y, th[1], math.exp(th[2])), math.log(1 - p) + stats.norm.logpdf(y, th[3], math.exp(th[4]))))
bf = optimize.minimize(nll_mix, [0, -0.5, 0, 1.5, 0], args=(ysim,), method="BFGS")
bf_par = np.array([special.expit(bf.x[0]), bf.x[1], math.exp(bf.x[2]), bf.x[3], math.exp(bf.x[4])])
print("참값", list(true.values()), "\nEM  ", est.round(4), f"({gm.n_iter}번)", "\nBFGS", bf_par.round(4))
report({"정리 3.2: 혼합의 EM 도 ℓ 을 줄이지 않는다": np.all(np.diff(gm.loglik) >= -1e-9),
        "명제 4.1: EM 과 BFGS (일반 최적화) 가 같은 MLE": np.allclose(est, bf_par, atol=1e-4),
        "참값 근처 (n = 5000, 각 모수 0.06 안)": np.allclose(est, list(true.values()), atol=0.06)})
text
참값 [0.3, -1.0, 0.5, 2.0, 1.0]
EM   [ 0.2912 -1.0005  0.5067  2.017   0.9855] (62번)
BFGS [ 0.2912 -1.0005  0.5067  2.017   0.9855]
  ✓  정리 3.2: 혼합의 EM 도 ℓ 을 줄이지 않는다
  ✓  명제 4.1: EM 과 BFGS (일반 최적화) 가 같은 MLE
  ✓  참값 근처 (n = 5000, 각 모수 0.06 안)
python
# 명제 4.3 · 예제 4.4 · 연습 4.2 · 4.4: 이름표, 대칭의 함정, logsumexp
th_hat = np.array([special.logit(est[0]), est[1], math.log(est[2]), est[3], math.log(est[4])])
th_swap = np.array([special.logit(1 - est[0]), est[3], math.log(est[4]), est[1], math.log(est[2])])
# 같은 값에서 출발: 두 성분이 영원히 같다
gs = GaussianMixtureEM(2).fit(ysim, mu0=[[ysim.mean()], [ysim.mean()]], pi0=[0.3, 0.7])
same = np.allclose(gs.mu[0], gs.mu[1]) and np.allclose(gs.Sigma[0], gs.Sigma[1])
# 그 점에서 혼합 로그가능도의 기울기는 0 (연습 4.2)
th_sym = np.array([special.logit(0.3), ysim.mean(), math.log(ysim.std()), ysim.mean(), math.log(ysim.std())])
grad = optimize.approx_fprime(th_sym, nll_mix, 1e-6, ysim)
# logsumexp 없이 계산하면
a = np.array([-1000.0, -1001.0])
with np.errstate(divide="ignore"):
    naive = np.log(np.sum(np.exp(a)))
print(f"같은 출발점: 두 성분 평균 {gs.mu.ravel().round(4)}, 반복 {gs.n_iter}번 뒤에도 같다 = {same};  그 점의 기울기 최댓값 {np.abs(grad).max():.2e}")
print(f"log(e^-1000 + e^-1001): 그대로 {naive}, logsumexp {special.logsumexp(a):.4f}")
report({"명제 4.3: 이름표를 바꿔도 로그가능도가 같다": abs(nll_mix(th_hat, ysim) - nll_mix(th_swap, ysim)) < 1e-9,
        "예제 4.4: 같은 곳에서 출발하면 갈라지지 않는다": same,
        "연습 4.2: 그 점은 정류점 (기울기 ≈ 0)": np.abs(grad).max() < 1e-2,
        "연습 4.4: 그대로는 −inf, logsumexp 는 −999.687": naive == -np.inf and abs(special.logsumexp(a) + 999.6867) < 1e-4})
text
같은 출발점: 두 성분 평균 [1.1382 1.1382], 반복 2번 뒤에도 같다 = True;  그 점의 기울기 최댓값 3.00e-03
log(e^-1000 + e^-1001): 그대로 -inf, logsumexp -999.6867
  ✓  명제 4.3: 이름표를 바꿔도 로그가능도가 같다
  ✓  예제 4.4: 같은 곳에서 출발하면 갈라지지 않는다
  ✓  연습 4.2: 그 점은 정류점 (기울기 ≈ 0)
  ✓  연습 4.4: 그대로는 −inf, logsumexp 는 −999.687
📝 연습 4.1–4.4 (강의노트): M 단계의 유도, 같은 출발점, Poisson 혼합, logsumexp.
5. 데이터로 — 게, 간헐천, 그리고 "may"
예제 5.1–5.4 Pearson의 게: 자료, 적률법의 두 해, EM의 MLE, 비율의 프로파일 가능도 · 예제 5.5 Old Faithful · 예제 5.6 may의 두 Poisson 혼합 대 음이항.
게 자료는 R 패키지 mixdist의 pearson 표를 그대로 옮겼다. 첫 열은 칸의 오른쪽 경계이고, 첫 칸과 마지막 칸은 열려 있다.
python
# 예제 5.1: Weldon 의 게 1,000 마리 (Pearson 1894) — 이마 폭 / 몸길이, 0.004 폭의 칸
crab_right = np.array([0.5835, 0.5875, 0.5915, 0.5955, 0.5995, 0.6035, 0.6075, 0.6115, 0.6155, 0.6195,
                       0.6235, 0.6275, 0.6315, 0.6355, 0.6395, 0.6435, 0.6475, 0.6515, 0.6555, 0.6595,
                       0.6635, 0.6675, 0.6715, 0.6755, 0.6795, 0.6835, 0.6875, 0.6915, np.inf])
crab_freq = np.array([1, 3, 5, 2, 7, 10, 13, 19, 20, 25, 40, 31, 60, 62, 54, 74, 84, 86, 96, 85,
                      75, 47, 43, 24, 19, 9, 5, 0, 1], float)
crab_mid = np.r_[crab_right[:-1] - 0.002, crab_right[-2] + 0.002]          # 열린 끝 칸은 폭 0.004 로 본다
w = crab_freq / crab_freq.sum()
m_c = np.sum(w * crab_mid); sd_c = math.sqrt(np.sum(w * (crab_mid - m_c) ** 2)); zc = (crab_mid - m_c) / sd_c
skew_c, exk_c = np.sum(w * zc**3), np.sum(w * zc**4) - 3
edges = np.r_[-np.inf, crab_right]

def grouped_nll(par):
    """연습 5.3: 묶음 자료의 가능도 Σ n_j log P(a_j < Y ≤ b_j)"""
    p, m1, s1, m2, s2 = par
    F = p * stats.norm.cdf(edges, m1, s1) + (1 - p) * stats.norm.cdf(edges, m2, s2)
    return -np.sum(crab_freq * np.log(np.maximum(np.diff(F), 1e-300)))

one = optimize.minimize(lambda t: grouped_nll((1.0, t[0], math.exp(t[1]), 0.0, 1.0)), [m_c, math.log(sd_c)], method="Nelder-Mead", options=dict(xatol=1e-10, fatol=1e-12))
print(f"n = {int(crab_freq.sum())}, 평균 {m_c:.4f}, sd {sd_c:.4f}, 왜도 {skew_c:.2f}, 초과첨도 {exk_c:.2f}")
report({"예제 5.1: 평균 0.6447, sd 0.0191, 왜도 −0.50, 초과첨도 0.06": abs(m_c - 0.6447) < 5e-5 and abs(sd_c - 0.0191) < 5e-5 and abs(skew_c + 0.50) < 0.005 and abs(exk_c - 0.06) < 0.005})
text
n = 1000, 평균 0.6447, sd 0.0191, 왜도 -0.50, 초과첨도 0.06
  ✓  예제 5.1: 평균 0.6447, sd 0.0191, 왜도 −0.50, 초과첨도 0.06
python
# 예제 5.2 · 연습 5.1–5.2: Pearson 의 적률법 — 다섯 적률 방정식의 모든 해를 찾는다 (표준화한 단위에서)
def normal_raw_moments(mu, s, K=6):
    """연습 5.1: m_k(μ, σ) = E(μ + σZ)^k"""
    return np.array([sum(math.comb(k, j) * mu ** (k - j) * s**j * (special.factorial2(j - 1, exact=True) if j > 0 else 1)
                         for j in range(0, k + 1, 2)) for k in range(1, K + 1)])

def mix_moments(par, K=6):
    p, m1, s1, m2, s2 = par
    return p * normal_raw_moments(m1, s1, K) + (1 - p) * normal_raw_moments(m2, s2, K)

zmom = np.array([np.sum(w * zc**k) for k in range(1, 7)])
g = np.random.default_rng(1894)
roots = []
for _ in range(3000):
    st = [g.uniform(0.05, 0.95), g.normal(-0.5, 1), math.log(g.uniform(0.2, 1.2)), g.normal(0.5, 1), math.log(g.uniform(0.2, 1.2))]
    f = lambda q: mix_moments((q[0], q[1], math.exp(min(max(q[2], -30), 30)), q[3], math.exp(min(max(q[4], -30), 30))), 5) - zmom[:5]
    with np.errstate(all="ignore"):
        sol = optimize.root(f, st, method="hybr")
    if sol.success and np.all(np.isfinite(sol.x)) and np.max(np.abs(f(sol.x))) < 1e-10 and 0 < sol.x[0] < 1:
        p, a1, l1, a2, l2 = sol.x
        if a1 > a2:
            p, a1, l1, a2, l2 = 1 - p, a2, l2, a1, l1
        cand = np.array([p, m_c + sd_c * a1, sd_c * math.exp(l1), m_c + sd_c * a2, sd_c * math.exp(l2)])
        if not any(np.allclose(cand, r_, atol=1e-6) for r_ in roots):
            roots.append(cand)
roots = sorted(roots, key=lambda r_: r_[0])
m6 = [mix_moments((r_[0], (r_[1] - m_c) / sd_c, r_[2] / sd_c, (r_[3] - m_c) / sd_c, r_[4] / sd_c))[5] for r_ in roots]
se_m6 = math.sqrt((np.sum(w * zc**12) - zmom[5] ** 2) / 1000)
print(pd.DataFrame(roots, columns=["π", "μ1", "σ1", "μ2", "σ2"]).assign(m6=m6).round(4).to_string())
print(f"표본의 6차 표준적률 {zmom[5]:.2f} (표준오차 ≈ {se_m6:.1f})")
report({"예제 5.2: 다섯 적률을 맞추는 해는 둘 — π = 0.424, 0.533 (Pearson 의 손 계산 0.4145, 0.5328)": len(roots) == 2 and abs(roots[0][0] - 0.424) < 5e-4 and abs(roots[1][0] - 0.533) < 5e-4,
        "예제 5.2: 해 1 = (0.6311, 0.0180, 0.6547, 0.0124)": np.allclose(roots[0][1:], [0.6311, 0.0180, 0.6547, 0.0124], atol=5e-5),
        "예제 5.2: 6차 적률 16.17, 16.41 대 표본 15.52 — 해 1 이 더 가깝다": np.allclose(m6, [16.17, 16.41], atol=5e-3) and abs(zmom[5] - 15.52) < 5e-3 and abs(m6[0] - zmom[5]) < abs(m6[1] - zmom[5]),
        "연습 5.2: 6차 적률의 표준오차 ≈ 2.6 ≫ 두 해의 차 0.24": abs(se_m6 - 2.6) < 0.05 and se_m6 > 10 * abs(m6[1] - m6[0])})
text
        π      μ1      σ1      μ2      σ2       m6
0  0.4241  0.6311  0.0180  0.6547  0.0124  16.1651
1  0.5330  0.6350  0.0191  0.6558  0.0115  16.4144
표본의 6차 표준적률 15.52 (표준오차 ≈ 2.6)
  ✓  예제 5.2: 다섯 적률을 맞추는 해는 둘 — π = 0.424, 0.533 (Pearson 의 손 계산 0.4145, 0.5328)
  ✓  예제 5.2: 해 1 = (0.6311, 0.0180, 0.6547, 0.0124)
  ✓  예제 5.2: 6차 적률 16.17, 16.41 대 표본 15.52 — 해 1 이 더 가깝다
  ✓  연습 5.2: 6차 적률의 표준오차 ≈ 2.6 ≫ 두 해의 차 0.24
python
# 예제 5.3: EM (칸의 가운데 값 + 도수 무게) — 네 시작점, 수렴 속도, 묶음 가능도의 직접 최대화
fits = [GaussianMixtureEM(2, tol=1e-12).fit(crab_mid, mu0=[[a], [b]], Sigma0=[[[s**2]], [[t**2]]], pi0=[p, 1 - p], w=crab_freq)
        for p, a, s, b, t in [(0.4145, 0.633, 0.018, 0.656, 0.0125), (0.5, 0.63, 0.02, 0.66, 0.01), (0.2, 0.62, 0.02, 0.65, 0.015), (0.8, 0.64, 0.02, 0.66, 0.01)]]
pars = np.array([f_.params_1d() for f_ in fits]); iters = [f_.n_iter for f_ in fits]
crab_em = pars[0]

def em_map(theta):
    """한 번의 EM 을 모수 → 모수 사상으로 (정리 3.6 의 M 을 수치미분으로 구하려고)"""
    p, m1, s1, m2, s2 = theta
    gm_ = GaussianMixtureEM(2); gm_.pi = np.array([p, 1 - p]); gm_.mu = np.array([[m1], [m2]]); gm_.Sigma = np.array([[[s1**2]], [[s2**2]]])
    R, _ = gm_.e_step(crab_mid.reshape(-1, 1)); gm_.m_step(crab_mid.reshape(-1, 1), R, crab_freq)
    return np.array([gm_.pi[0], gm_.mu[0, 0], math.sqrt(gm_.Sigma[0, 0, 0]), gm_.mu[1, 0], math.sqrt(gm_.Sigma[1, 0, 0])])

Jac = np.column_stack([(em_map(crab_em + e_) - em_map(crab_em - e_)) / (2 * e_.max()) for e_ in np.diag(1e-7 * np.maximum(np.abs(crab_em), 1e-3))])
eig = np.sort(np.abs(np.linalg.eigvals(Jac)))[::-1]
gr = optimize.minimize(lambda t: grouped_nll((special.expit(t[0]), t[1], math.exp(t[2]), t[3], math.exp(t[4]))),
                       [special.logit(0.45), 0.6326, math.log(0.0186), 0.6547, math.log(0.0125)], method="Nelder-Mead",
                       options=dict(xatol=1e-10, fatol=1e-12, maxiter=40_000, maxfev=40_000))
grouped_mle = np.array([special.expit(gr.x[0]), gr.x[1], math.exp(gr.x[2]), gr.x[3], math.exp(gr.x[4])])
print("네 시작점의 도착점:\n", pars.round(4), "\n반복 수:", iters)
print(f"EM 사상의 고유값 (절댓값): {eig.round(4)};  한 자릿수에 {math.log(0.1) / math.log(eig[0]):.0f}번")
print("묶음 가능도의 직접 최대화:", grouped_mle.round(4), f";  한 정규 대 혼합 2Δℓ = {2 * (one.fun - gr.fun):.1f}")
report({"예제 5.3: 네 시작점 모두 (0.433, 0.6317, 0.0183, 0.6546, 0.0126)": np.allclose(pars, [0.4327, 0.6317, 0.0183, 0.6546, 0.0126], atol=2e-4),
        "예제 5.3: 1,200–1,900 번 반복": all(1100 < i < 2000 for i in iters),
        "예제 5.3 · 정리 3.6: EM 사상의 가장 큰 고유값 0.9936 — 한 자릿수에 약 360번": abs(eig[0] - 0.9936) < 2e-4 and 340 < math.log(0.1) / math.log(eig[0]) < 380,
        "예제 5.3: 묶음 가능도의 MLE (0.453, 0.6326, 0.0186, 0.6547, 0.0125)": np.allclose(grouped_mle, [0.4528, 0.6326, 0.0186, 0.6547, 0.0125], atol=2e-4),
        "예제 5.1: 한 정규보다 혼합이 2Δℓ = 52.7 높다": abs(2 * (one.fun - gr.fun) - 52.7) < 0.05})
text
네 시작점의 도착점:
 [[0.4327 0.6317 0.0183 0.6546 0.0126]
 [0.4327 0.6317 0.0183 0.6546 0.0126]
 [0.4327 0.6317 0.0183 0.6546 0.0126]
 [0.4327 0.6317 0.0183 0.6546 0.0126]]
반복 수: [1212, 1584, 1890, 1691]
EM 사상의 고유값 (절댓값): [0.9936 0.8689 0.3518 0.     0.    ];  한 자릿수에 359번
묶음 가능도의 직접 최대화: [0.4528 0.6326 0.0186 0.6547 0.0125] ;  한 정규 대 혼합 2Δℓ = 52.7
  ✓  예제 5.3: 네 시작점 모두 (0.433, 0.6317, 0.0183, 0.6546, 0.0126)
  ✓  예제 5.3: 1,200–1,900 번 반복
  ✓  예제 5.3 · 정리 3.6: EM 사상의 가장 큰 고유값 0.9936 — 한 자릿수에 약 360번
  ✓  예제 5.3: 묶음 가능도의 MLE (0.453, 0.6326, 0.0186, 0.6547, 0.0125)
  ✓  예제 5.1: 한 정규보다 혼합이 2Δℓ = 52.7 높다
python
# 예제 5.4: 비율 π 의 프로파일 가능도 (묶음 가능도, 정리 1.8)
def profile_pi(p0, start):
    r_ = optimize.minimize(lambda t: grouped_nll((p0, t[0], math.exp(t[1]), t[2], math.exp(t[3]))), start, method="Nelder-Mead",
                           options=dict(xatol=1e-10, fatol=1e-12, maxiter=20_000))
    return r_.fun, r_.x

start = [grouped_mle[1], math.log(grouped_mle[2]), grouped_mle[3], math.log(grouped_mle[4])]
dev = lambda p0: 2 * (profile_pi(p0, start)[0] - gr.fun)
lo = optimize.brentq(lambda p0: dev(p0) - stats.chi2.ppf(0.95, 1), 0.05, 0.45)
hi = optimize.brentq(lambda p0: dev(p0) - stats.chi2.ppf(0.95, 1), 0.46, 0.85)
grid = np.linspace(0.1, 0.82, 37)
devs = [dev(p0) for p0 in grid]
print(f"95% 프로파일 구간 [{lo:.3f}, {hi:.3f}];  Pearson 의 두 해에서 프로파일 가능도비 {dev(0.4145):.2f}, {dev(0.5328):.2f}")
report({"예제 5.4: π 의 95% 구간 [0.175, 0.687]": abs(lo - 0.175) < 1e-3 and abs(hi - 0.687) < 1e-3,
        "예제 5.4: Pearson 의 두 해 0.41 과 0.53 이 모두 구간 안 (0.05, 0.30)": abs(dev(0.4145) - 0.05) < 0.01 and abs(dev(0.5328) - 0.30) < 0.01})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
axes[0].bar(crab_mid, crab_freq / 1000 / 0.004, width=0.004, color=C["data"], alpha=0.35, edgecolor="white")
xx = np.linspace(0.575, 0.70, 400)
mixd = lambda q: q[0] * stats.norm.pdf(xx, q[1], q[2]) + (1 - q[0]) * stats.norm.pdf(xx, q[3], q[4])
axes[0].plot(xx, mixd(roots[0]), color=C["stat"], lw=1.5, label="MoM root 1")
axes[0].plot(xx, mixd(roots[1]), color=C["theta"], lw=1.5, ls=":", label="MoM root 2")
axes[0].plot(xx, mixd(crab_em), color=C["key"], lw=1.5, ls="--", label="EM MLE")
axes[0].set_title("Weldon's crabs and three fits"); axes[0].legend(fontsize=8)
axes[1].plot(grid, -np.array(devs) / 2, color=C["ink"])
axes[1].axhline(-stats.chi2.ppf(0.95, 1) / 2, color=C["hist"], ls=":")
for pp in (0.4145, 0.5328):
    axes[1].axvline(pp, color=C["stat"], lw=0.8)
axes[1].set_xlabel("π"); axes[1].set_title("profile log-likelihood of π: flat")
plt.tight_layout(); plt.show()
text
95% 프로파일 구간 [0.175, 0.687];  Pearson 의 두 해에서 프로파일 가능도비 0.05, 0.30
  ✓  예제 5.4: π 의 95% 구간 [0.175, 0.687]
  ✓  예제 5.4: Pearson 의 두 해 0.41 과 0.53 이 모두 구간 안 (0.05, 0.30)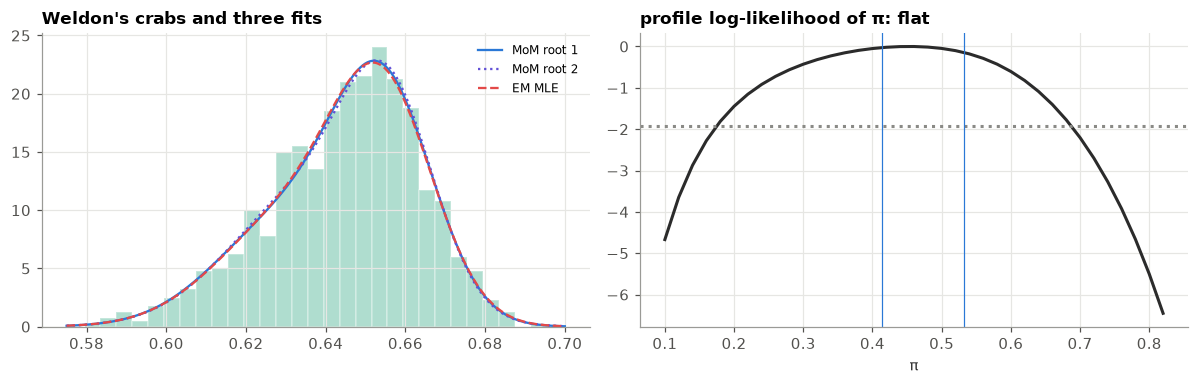
그림 읽기. 왼쪽의 세 곡선은 눈으로는 구별되지 않는다. 오른쪽의 프로파일 가능도는 그 이유를 보여 준다. 비율 를 0.2에서 0.65 사이 어디에 두어도 나머지 네 모수가 맞춰 주어 가능도가 거의 떨어지지 않는다. Pearson이 두 해 사이에서 망설인 것도, EM이 수천 번 걸리는 것도(고유값 0.9936) 이 평평함 때문이다.
python
# 예제 5.5 · 연습 5.4 · 6.3: Old Faithful
fa = load_rdata("faithful", "datasets")
er = fa.eruptions.to_numpy(float)
gm_f = GaussianMixtureEM(2, tol=1e-12).fit(er, mu0=[[2.0], [4.0]], Sigma0=[[[0.25]], [[0.25]]])
pf = gm_f.params_1d()
th_f = np.array([special.logit(pf[0]), pf[1], math.log(pf[2]), pf[3], math.log(pf[4])])
bf = optimize.minimize(nll_mix, th_f + 0.05, args=(er,), method="BFGS")
# 표준오차: 자연 모수 (π, μ1, σ1, μ2, σ2) 에서 수치 헤세 행렬의 역
nll_nat = lambda q: -np.sum(np.log(q[0] * stats.norm.pdf(er, q[1], q[2]) + (1 - q[0]) * stats.norm.pdf(er, q[3], q[4])))
se_f = np.sqrt(np.diag(np.linalg.inv(num_hessian(nll_nat, pf))))
ll1 = np.sum(stats.norm.logpdf(er, er.mean(), er.std()))
# 2차원
Y2 = fa[["eruptions", "waiting"]].to_numpy(float)
gm2 = GaussianMixtureEM(2).fit(Y2, mu0=[[2.0, 55.0], [4.5, 80.0]])
corr_k = [gm2.Sigma[k][0, 1] / math.sqrt(gm2.Sigma[k][0, 0] * gm2.Sigma[k][1, 1]) for k in range(2)]
# 성분 수: K = 1, 2, 3 의 AIC · BIC (여러 시작점 중 최대)
ic = {}
for K, base in [(1, [3.5]), (2, [2.0, 4.3]), (3, [1.9, 3.5, 4.4])]:
    best = max((GaussianMixtureEM(K, tol=1e-10).fit(er, mu0=np.array(base) + (np.random.default_rng(j).normal(0, 0.2, K) if j else 0))
                for j in range(10)), key=lambda f_: f_.loglik[-1])
    p_ = 3 * K - 1; L = best.loglik[-1]
    ic[K] = dict(loglik=L, AIC=-2 * L + 2 * p_, BIC=-2 * L + p_ * math.log(len(er)))
ic = pd.DataFrame(ic).T
print("1차원 EM:", pf.round(4), f"ℓ = {gm_f.loglik[-1]:.2f}, {gm_f.n_iter}번;  표준오차 {se_f.round(3)}")
print(f"2차원: 비율 {np.sort(gm2.pi).round(3)}, 성분 안의 상관 {np.round(sorted(corr_k), 2)}, 전체 상관 {np.corrcoef(Y2.T)[0, 1]:.2f}")
print(ic.round(2).to_string())
report({"예제 5.5: (0.348, 2.019, 0.236, 4.273, 0.437), ℓ = −276.36": np.allclose(pf, [0.348, 2.019, 0.236, 4.273, 0.437], atol=5e-4) and abs(gm_f.loglik[-1] + 276.36) < 0.005,
        "예제 5.5: BFGS 와 소수 넷째 자리까지 같다": np.allclose([special.expit(bf.x[0]), bf.x[1], math.exp(bf.x[2]), bf.x[3], math.exp(bf.x[4])], pf, atol=5e-5),
        "예제 5.5: 한 정규보다 145 높다": abs(gm_f.loglik[-1] - ll1 - 145.06) < 0.05,
        "예제 5.5: 표준오차 (0.029, 0.026, 0.023, 0.034, 0.027)": np.allclose(se_f, [0.029, 0.026, 0.023, 0.034, 0.027], atol=6e-4),
        "예제 5.5 · 연습 5.4: 2차원 비율 0.356 / 0.644, 성분 안의 상관 0.29 · 0.38 (전체 0.90)": np.allclose(np.sort(gm2.pi), [0.356, 0.644], atol=1e-3) and np.allclose(sorted(corr_k), [0.29, 0.38], atol=0.005),
        "연습 6.3: AIC 는 K = 3, BIC 는 K = 2 와 3 이 거의 같다 (580.75 대 580.63)": ic.AIC.idxmin() == 3 and abs(ic.BIC[2] - 580.75) < 0.01 and abs(ic.BIC[3] - 580.63) < 0.01})
text
1차원 EM: [0.3484 2.0186 0.2356 4.2733 0.4371] ℓ = -276.36, 29번;  표준오차 [0.029 0.026 0.023 0.034 0.027]
2차원: 비율 [0.356 0.644], 성분 안의 상관 [0.29 0.38], 전체 상관 0.90
   loglik     AIC     BIC
1 -421.42  846.83  854.05
2 -276.36  562.72  580.75
3 -267.89  551.78  580.63
  ✓  예제 5.5: (0.348, 2.019, 0.236, 4.273, 0.437), ℓ = −276.36
  ✓  예제 5.5: BFGS 와 소수 넷째 자리까지 같다
  ✓  예제 5.5: 한 정규보다 145 높다
  ✓  예제 5.5: 표준오차 (0.029, 0.026, 0.023, 0.034, 0.027)
  ✓  예제 5.5 · 연습 5.4: 2차원 비율 0.356 / 0.644, 성분 안의 상관 0.29 · 0.38 (전체 0.90)
  ✓  연습 6.3: AIC 는 K = 3, BIC 는 K = 2 와 3 이 거의 같다 (580.75 대 580.63)
python
fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
xx = np.linspace(1.2, 5.6, 400)
axes[0].hist(er, bins=np.arange(1.5, 5.6, 0.2), density=True, color=C["data"], alpha=0.35, edgecolor="white")
axes[0].plot(xx, pf[0] * stats.norm.pdf(xx, pf[1], pf[2]) + (1 - pf[0]) * stats.norm.pdf(xx, pf[3], pf[4]), color=C["key"])
axes[0].set_xlabel("eruption (min)"); axes[0].set_title("Old Faithful: two-normal fit")
r1 = pf[0] * stats.norm.pdf(xx, pf[1], pf[2]) / (pf[0] * stats.norm.pdf(xx, pf[1], pf[2]) + (1 - pf[0]) * stats.norm.pdf(xx, pf[3], pf[4]))
axes[1].plot(xx, r1, color=C["stat"]); axes[1].set_xlabel("eruption (min)"); axes[1].set_title("responsibility of the short group")
R2, _ = gm2.e_step(Y2)
axes[2].scatter(Y2[:, 0], Y2[:, 1], c=R2[:, 0], cmap="coolwarm", s=8)
for k in range(2):
    vals, vecs = np.linalg.eigh(gm2.Sigma[k]); ang = math.degrees(math.atan2(vecs[1, 1], vecs[0, 1]))
    for nsd in (1, 2):
        axes[2].add_patch(Ellipse(gm2.mu[k], 2 * nsd * math.sqrt(vals[1]), 2 * nsd * math.sqrt(vals[0]), angle=ang, fill=False, color=C["ink"], lw=1))
axes[2].set_xlabel("eruption (min)"); axes[2].set_ylabel("waiting (min)"); axes[2].set_title("2-D mixture (color = responsibility)")
plt.tight_layout(); plt.show()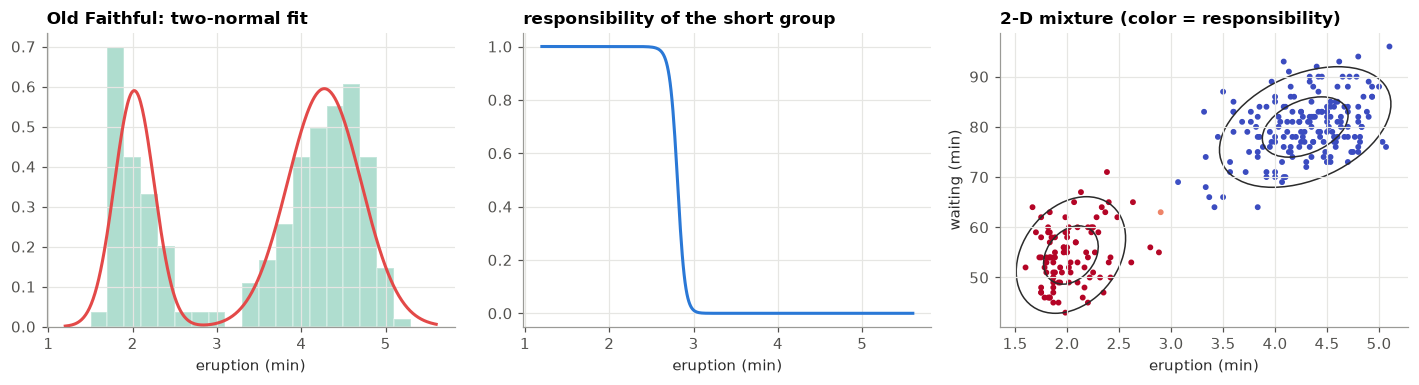
python
# 예제 5.6 · 연습 4.3: The Federalist 의 may — 두 Poisson 의 혼합 (EM) 대 음이항 대 Poisson
fe = load_rdata("Federalist", "vcd")
kk = fe.nMay.to_numpy(); ff = fe.Freq.to_numpy().astype(float)
p, l1, l2 = 0.5, 0.2, 1.5
ll_hist = []
for _ in range(5000):
    a1 = p * stats.poisson.pmf(kk, l1); a2 = (1 - p) * stats.poisson.pmf(kk, l2)
    ll_hist.append(np.sum(ff * np.log(a1 + a2)))
    rr = a1 / (a1 + a2)                                                       # E: 책임
    p = np.sum(ff * rr) / ff.sum(); l1 = np.sum(ff * rr * kk) / np.sum(ff * rr); l2 = np.sum(ff * (1 - rr) * kk) / np.sum(ff * (1 - rr))   # M
ll_mix2 = np.sum(ff * np.log(p * stats.poisson.pmf(kk, l1) + (1 - p) * stats.poisson.pmf(kk, l2)))
xb = np.sum(kk * ff) / ff.sum()
ll_poi = np.sum(ff * stats.poisson.logpmf(kk, xb))
nb = optimize.minimize(lambda q: -np.sum(ff * stats.nbinom.logpmf(kk, math.exp(q[0]), special.expit(q[1]))), [0.2, 0.6], method="Nelder-Mead",
                       options=dict(xatol=1e-10, fatol=1e-12, maxiter=5000))
expected = ff.sum() * (p * stats.poisson.pmf(kk, l1) + (1 - p) * stats.poisson.pmf(kk, l2))
print(f"두 Poisson 혼합: π = {p:.3f}, λ = ({l1:.3f}, {l2:.3f});  기대도수 {expected.round(1).tolist()} 대 관측 {ff.astype(int).tolist()}")
print(f"로그가능도: 혼합 {ll_mix2:.2f} (모수 3), 음이항 {-nb.fun:.2f} (모수 2), Poisson {ll_poi:.2f} (모수 1)")
report({"예제 5.6: π = 0.697, λ = (0.279, 1.524)": abs(p - 0.697) < 5e-4 and abs(l1 - 0.279) < 5e-4 and abs(l2 - 1.524) < 5e-4,
        "예제 5.6: 혼합 −291.52 < 음이항 −291.26, 둘 다 Poisson −302.90 보다 훨씬 높다": abs(ll_mix2 + 291.52) < 0.005 and abs(nb.fun - 291.26) < 0.005 and abs(ll_poi + 302.90) < 0.005,
        "정리 3.2: Poisson 혼합의 EM 도 단조": np.all(np.diff(ll_hist) >= -1e-9)})
text
두 Poisson 혼합: π = 0.697, λ = (0.279, 1.524);  기대도수 [155.4, 64.9, 25.5, 10.7, 3.9, 1.2, 0.3] 대 관측 [156, 63, 29, 8, 4, 1, 1]
로그가능도: 혼합 -291.52 (모수 3), 음이항 -291.26 (모수 2), Poisson -302.90 (모수 1)
  ✓  예제 5.6: π = 0.697, λ = (0.279, 1.524)
  ✓  예제 5.6: 혼합 −291.52 < 음이항 −291.26, 둘 다 Poisson −302.90 보다 훨씬 높다
  ✓  정리 3.2: Poisson 혼합의 EM 도 단조
📝 연습 5.1–5.4 (강의노트): 적률의 방정식, 여섯째 적률로 고르기, 묶음 가능도, 2차원 Old Faithful.
6. 부숴보기 — 무한대의 가능도와 성분의 수
명제 6.1 분산이 성분마다 다른 정규 혼합에서 · 6.2절 한 정규 대 두 정규: 가능도비는 이 아니다 · 6.3절 느린 수렴 = 잃어버린 정보.
python
# 명제 6.1 · 그림 6.1 왼쪽: Old Faithful 의 한 관측에 첫 성분을 놓고 σ1 → 0
vals, counts = np.unique(er, return_counts=True)
y0 = vals[counts == 1][np.argmin(np.abs(vals[counts == 1] - 4.0))]
nlog = np.linspace(0, 200, 401)                                       # −log10 σ1
with np.errstate(over="ignore"):                                      # 다른 관측의 ((y − y0)/σ1)² 은 무한대 → 밀도 0 이 맞다
    ll_sing = np.array([np.sum(np.logaddexp(math.log(0.5) + stats.norm.logpdf(er, y0, 10.0 ** -k),
                                             math.log(0.5) + stats.norm.logpdf(er, er.mean(), er.std()))) for k in nlog])
cross = nlog[np.argmax(ll_sing > gm_f.loglik[-1])]
slope = (ll_sing[-1] - ll_sing[-101]) / (nlog[-1] - nlog[-101])
# 연습 6.1: 분산이 같으면 유계 — 같은 σ 를 줄이면 가능도는 −∞ 로
ll_eq = [np.sum(np.logaddexp(math.log(0.5) + stats.norm.logpdf(er, y0, s), math.log(0.5) + stats.norm.logpdf(er, 4.27, s))) for s in (0.5, 0.1, 0.01)]
print(f"최솟값 {ll_sing.min():.1f}, EM 의 국소 최대점 {gm_f.loglik[-1]:.2f} 을 넘는 곳: σ1 ≈ 10^-{cross:.0f};  기울기 {slope:.3f} (= ln 10 = {math.log(10):.3f})")
print("같은 분산을 줄이면:", np.round(ll_eq, 1))
report({"명제 6.1: σ1 → 0 이면 ℓ → ∞ (−log σ1 의 속도: 10배마다 ln 10)": abs(slope - math.log(10)) < 1e-6 and ll_sing[-1] > gm_f.loglik[-1],
        "그림 6.1: 그 '최대'는 σ1 ≈ 10^-145 에서야 EM 의 국소 최대점을 넘는다": abs(cross - 145) <= 1,
        "연습 6.1: 같은 분산이면 σ → 0 에서 ℓ → −∞": ll_eq[0] > ll_eq[1] > ll_eq[2]})
text
최솟값 -600.5, EM 의 국소 최대점 -276.36 을 넘는 곳: σ1 ≈ 10^-145;  기울기 2.303 (= ln 10 = 2.303)
같은 분산을 줄이면: [-9.2730000e+02 -1.9139600e+04 -1.9327438e+06]
  ✓  명제 6.1: σ1 → 0 이면 ℓ → ∞ (−log σ1 의 속도: 10배마다 ln 10)
  ✓  그림 6.1: 그 '최대'는 σ1 ≈ 10^-145 에서야 EM 의 국소 최대점을 넘는다
  ✓  연습 6.1: 같은 분산이면 σ → 0 에서 ℓ → −∞
python
# 6.2절 · 그림 6.1 오른쪽: H0 (한 정규, n = 272) 에서 한 정규 대 두 정규의 가능도비
def em_two(x, par, iters=400):
    """작은 EM: 분산의 바닥 0.05 로 특이점에 빠지지 않게 한다 (6.1절의 처방 2의 단순한 판)"""
    p_, a1, b1, a2, b2 = par
    for _ in range(iters):
        A = p_ * stats.norm.pdf(x, a1, b1); B = (1 - p_) * stats.norm.pdf(x, a2, b2)
        r = A / (A + B); n1 = r.sum(); n2 = len(x) - n1
        if n1 < 2 or n2 < 2:
            break
        p_ = n1 / len(x); a1 = np.sum(r * x) / n1; a2 = np.sum((1 - r) * x) / n2
        b1 = max(math.sqrt(np.sum(r * (x - a1) ** 2) / n1), 0.05); b2 = max(math.sqrt(np.sum((1 - r) * (x - a2) ** 2) / n2), 0.05)
    A = p_ * stats.norm.pdf(x, a1, b1); B = (1 - p_) * stats.norm.pdf(x, a2, b2)
    return np.sum(np.log(A + B))

g = np.random.default_rng(1985)
LRs = []
for _ in range(1000):
    x = g.standard_normal(272)
    l1 = np.sum(stats.norm.logpdf(x, x.mean(), x.std()))
    l2 = max(em_two(x, (0.5, np.quantile(x, a), 1.0, np.quantile(x, b), 1.0)) for a, b in [(0.25, 0.75), (0.1, 0.6), (0.4, 0.9)])
    LRs.append(max(2 * (l2 - l1), 0.0))
LRs = np.array(LRs)
q95, size3 = np.quantile(LRs, 0.95), np.mean(LRs > stats.chi2.ppf(0.95, 3))
print(f"H0 아래 가능도비: 평균 {LRs.mean():.2f}, 95% 분위수 {q95:.2f} (χ²(3): {stats.chi2.ppf(0.95, 3):.2f}),  χ²(3) 임계값을 넘는 비율 {size3:.3f}")
report({"6.2절: 95% 분위수 ≈ 9.6 > 7.81, χ²(3) 을 쓰면 실제 크기 ≈ 0.10": abs(q95 - 9.6) < 0.1 and abs(size3 - 0.098) < 0.005})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))
axes[0].plot(nlog, ll_sing, color=C["key"]); axes[0].axhline(gm_f.loglik[-1], **THEORY)
axes[0].set_xlabel("−log10 σ1"); axes[0].set_title("a component sitting on one point: ℓ → ∞")
qq = np.linspace(0.05, 16, 300)
axes[1].hist(LRs, bins=np.linspace(0, 16, 41), density=True, color=C["stat"], alpha=0.4, label="LR under H0")
axes[1].plot(qq, stats.chi2.pdf(qq, 3), **THEORY, label="χ²(3)"); axes[1].legend()
axes[1].set_title("1 vs 2 normals: not χ²(3)")
plt.tight_layout(); plt.show()
text
H0 아래 가능도비: 평균 3.25, 95% 분위수 9.61 (χ²(3): 7.81),  χ²(3) 임계값을 넘는 비율 0.098
  ✓  6.2절: 95% 분위수 ≈ 9.6 > 7.81, χ²(3) 을 쓰면 실제 크기 ≈ 0.10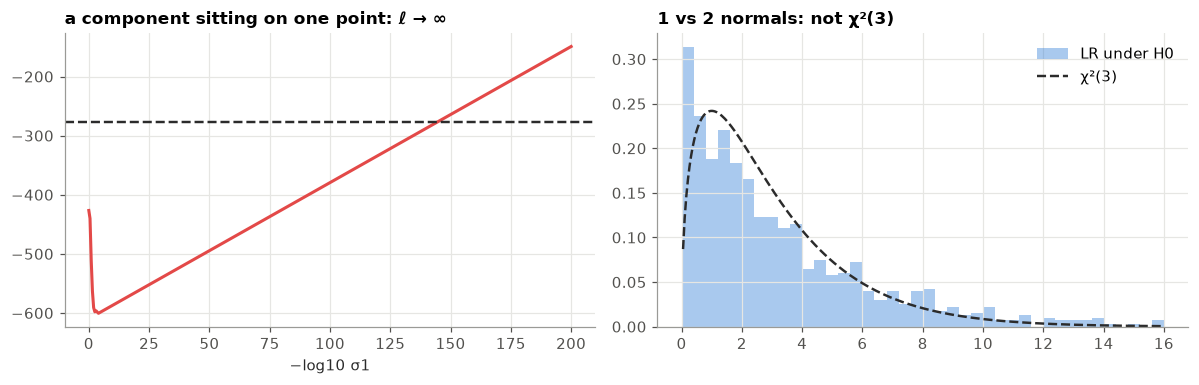
python
# 6.3절 · 그림 6.2: 세 예제의 수렴 속도 — 최종 ℓ 과의 차의 로그가 직선, 기울기 = 잃어버린 정보의 비율
crab_long = GaussianMixtureEM(2, tol=-1, max_iter=3000).fit(crab_mid, mu0=[[0.63], [0.66]], Sigma0=[[[4e-4]], [[1e-4]]], pi0=[0.5, 0.5], w=crab_freq)
link_ll = np.array([ll_link(t) for t in LinkageEM(y_link).run(0.5, 12)])
rates = {}
for name, h, t0 in [("genetic linkage", link_ll, 2), ("Old Faithful", np.array(gm_f.loglik), 10), ("Pearson's crabs", np.array(crab_long.loglik), 1000)]:
    gap = h.max() - h
    rates[name] = (gap[t0 + 1] / gap[t0]) ** 0.5            # ℓ 의 차는 오차의 제곱에 비례하므로 제곱근이 오차의 비율
print({k: round(float(v), 3) for k, v in rates.items()})
report({"6.3절: 수렴 비율 — 유전 연관 0.13, Old Faithful 0.59, 게 0.994": abs(rates["genetic linkage"] - 0.133) < 0.005 and abs(rates["Old Faithful"] - 0.589) < 0.01 and abs(rates["Pearson's crabs"] - 0.9936) < 0.001})

fig, ax = plt.subplots(figsize=(9, 3.4))
for (name, h), col in zip([("genetic linkage", link_ll), ("Old Faithful", np.array(gm_f.loglik)), ("Pearson's crabs", np.array(crab_long.loglik))], [C["data"], C["stat"], C["key"]]):
    gap = h.max() - h; keep = gap > 1e-13
    ax.semilogy(np.arange(len(h))[keep], gap[keep], color=col, label=f"{name} ({rates[name]:.3f})")
ax.set_xlim(0, 1500); ax.set_xlabel("iteration"); ax.set_ylabel("ℓ(θ̂) − ℓ(θ_t)"); ax.legend(); ax.set_title("EM converges at the rate of the missing information")
plt.tight_layout(); plt.show()
text
{'genetic linkage': 0.133, 'Old Faithful': 0.592, "Pearson's crabs": 0.994}
  ✓  6.3절: 수렴 비율 — 유전 연관 0.13, Old Faithful 0.59, 게 0.994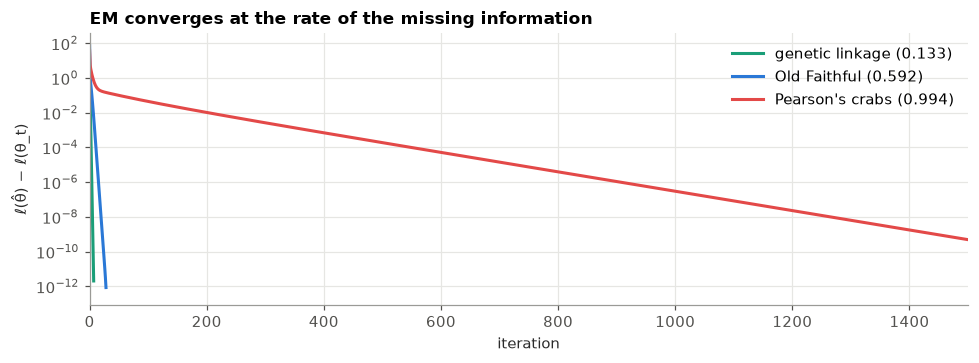
그림 읽기. 세 직선의 기울기가 정리 3.6의 비율이다. 로그가능도의 차는 모수 오차의 제곱에 비례하므로, 그림의 기울기는 비율의 제곱이다. 유전 연관(잃어버린 정보 13%)은 몇 번 만에, Old Faithful(59%)은 수십 번 만에 끝나지만, 두 성분이 겹친 게(99.4%)는 1,500번을 돌려도 아직 내려가는 중이다.
📝 연습 6.1–6.3 (강의노트): 같은 분산이면 유계, 분산의 비 제약, 성분 수의 정보 기준.
7. 고치기 — Neyman–Scott를 숨은 변수로
정의 7.1 임의효과 · 명제 7.2 , · 예제 7.3 EM으로 풀기, E 단계는 축소.
python
class RandomEffectsEM:
    """예제 7.3: X_ij = μ_i + ε_ij, μ_i ~ N(m, τ²) 를 숨은 자료로 놓은 EM"""
    def fit(self, X, iters=500):
        m, t2, s2 = X.mean(), X.mean(1).var(), X.var()
        J = X.shape[1]
        for _ in range(iters):
            v = 1 / (1 / t2 + J / s2)                              # E: μ_i | x_i ~ N(μ̃_i, v)
            mt = v * (m / t2 + X.sum(1) / s2)
            m = mt.mean(); t2 = np.mean((mt - m) ** 2 + v)          # M
            s2 = np.mean(((X - mt[:, None]) ** 2).sum(1) + J * v) / J
        self.m, self.tau2, self.sigma2, self.post_mean, self.post_var = m, t2, s2, mt, v
        return self

n, sigma2, tau2 = 2000, 4.0, 9.0
g7 = np.random.default_rng(1948)                                          # 예제 7.3 의 자료 (Neyman–Scott 1948)
mu_i = g7.normal(5, 3, n)
X = mu_i[:, None] + g7.normal(0, 2, (n, 2))
re = RandomEffectsEM().fit(X)
D, S = X[:, 0] - X[:, 1], X.sum(1)
closed = dict(sigma2=np.sum(D**2) / (2 * n), m=S.mean() / 2, tau2=(S.var() - 2 * np.sum(D**2) / (2 * n)) / 4)
fixed = np.sum(D**2) / (4 * n)
# 연습 7.3: 축소 계수 B = τ²/(τ² + σ²/2)
B = re.tau2 / (re.tau2 + re.sigma2 / 2)
shrink_ok = np.allclose(re.post_mean, re.m + B * (X.mean(1) - re.m))
# 명제 7.2: D 와 S 는 무상관 (독립)
print(f"EM: σ̂² = {re.sigma2:.3f}, τ̂² = {re.tau2:.3f}, m̂ = {re.m:.3f};  닫힌 꼴 {closed['sigma2']:.3f}, {closed['tau2']:.3f}, {closed['m']:.3f};  고정효과 MLE {fixed:.3f}")
print(f"corr(D, S) = {np.corrcoef(D, S)[0, 1]:.4f},  축소 계수 B = {B:.3f}")
se_s2 = math.sqrt(2 * sigma2**2 / n)                                       # Var(ΣD²/(2n)) = 2σ⁴/n
report({"예제 7.3: EM 은 3.93 (참값 4 의 1 se 안), 고정효과 MLE 는 1.97 (σ²/2 = 2 근처)": abs(re.sigma2 - 3.933) < 5e-4 and abs(fixed - 1.966) < 5e-4
            and within(re.sigma2, sigma2, se_s2, k=2) and within(fixed, sigma2 / 2, se_s2 / 2, k=2),
        "명제 7.2: EM 의 고정점 = 닫힌 꼴의 MLE": abs(re.sigma2 - closed["sigma2"]) < 1e-8 and abs(re.tau2 - closed["tau2"]) < 1e-8 and abs(re.m - closed["m"]) < 1e-8,
        "명제 7.2: D 와 S 는 무상관": abs(np.corrcoef(D, S)[0, 1]) < 4 / math.sqrt(n),
        "연습 7.3: E 단계의 평균 = m + B(x̄_i − m), B = τ²/(τ² + σ²/2)": shrink_ok})
text
EM: σ̂² = 3.933, τ̂² = 9.235, m̂ = 4.958;  닫힌 꼴 3.933, 9.235, 4.958;  고정효과 MLE 1.966
corr(D, S) = 0.0126,  축소 계수 B = 0.824
  ✓  예제 7.3: EM 은 3.93 (참값 4 의 1 se 안), 고정효과 MLE 는 1.97 (σ²/2 = 2 근처)
  ✓  명제 7.2: EM 의 고정점 = 닫힌 꼴의 MLE
  ✓  명제 7.2: D 와 S 는 무상관
  ✓  연습 7.3: E 단계의 평균 = m + B(x̄_i − m), B = τ²/(τ² + σ²/2)
📝 연습 7.1–7.3 (강의노트): 차와 합, E 단계, 축소.
8. Beautiful insights — 하한과 온도
8.1절 ELBO , VAE · 명제 8.1 이면 책임 → 가장 가까운 평균, 곧 -평균 · 8.3절 Baum–Welch, 전문가 혼합.
python
# 연습 8.1: 정규끼리의 KL D(N(μ, s²) ‖ N(0,1)) = ½(μ² + s² − 1 − log s²) — 수치적분과 대조
def kl_normal_std(mu, s):
    return 0.5 * (mu**2 + s**2 - 1 - math.log(s**2))
kl_num = lambda mu, s: integrate.quad(lambda z: stats.norm.pdf(z, mu, s) * (stats.norm.logpdf(z, mu, s) - stats.norm.logpdf(z)), -30, 30)[0]
# 8.1절: 재모수화 z = μ + sε 로 만든 ELBO 의 몬테카를로 추정 — 장난감 모형 x | z ~ N(z, 1), z ~ N(0, 1), 관측 x = 1.5
x_obs = 1.5
def elbo_mc(mu, s, R=200_000, gen=np.random.default_rng(8)):
    z = mu + s * gen.standard_normal(R)
    return np.mean(stats.norm.logpdf(x_obs, z, 1)) - kl_normal_std(mu, s)
log_evidence = stats.norm.logpdf(x_obs, 0, math.sqrt(2))                 # 정확한 log p(x): x ~ N(0, 2)
post_mu, post_s = x_obs / 2, math.sqrt(0.5)                               # 정확한 사후분포 N(x/2, 1/2)
print(f"log p(x) = {log_evidence:.4f};  ELBO(정확한 사후) = {elbo_mc(post_mu, post_s):.4f};  ELBO(틀린 q = N(0, 1)) = {elbo_mc(0.0, 1.0):.4f}")
report({"연습 8.1: KL 공식 = 수치적분": all(abs(kl_normal_std(m_, s_) - kl_num(m_, s_)) < 1e-7 for m_, s_ in [(0.5, 0.7), (-1, 2.0), (0, 1.0)]),
        "명제 3.3 · 8.1절: q 가 정확한 사후분포이면 ELBO = log p(x), 아니면 그보다 작다 (차 = KL)":
            abs(elbo_mc(post_mu, post_s) - log_evidence) < 0.01 and elbo_mc(0.0, 1.0) < log_evidence - 0.1})
text
log p(x) = -1.8280;  ELBO(정확한 사후) = -1.8280;  ELBO(틀린 q = N(0, 1)) = -2.5419
  ✓  연습 8.1: KL 공식 = 수치적분
  ✓  명제 3.3 · 8.1절: q 가 정확한 사후분포이면 ELBO = log p(x), 아니면 그보다 작다 (차 = KL)
python
# 명제 8.1 · 연습 8.2 · 8.3: k-평균 = 온도 0 의 EM
def kmeans(Y, mu0, iters=100):
    mu = np.array(mu0, float); W_hist = []
    for _ in range(iters):
        d2 = ((Y[:, None, :] - mu[None]) ** 2).sum(-1)
        c = d2.argmin(1); W_hist.append(d2[np.arange(len(Y)), c].sum())
        new = np.array([Y[c == k].mean(0) for k in range(len(mu))])
        if np.allclose(new, mu):
            break
        mu = new
    return mu, c, np.array(W_hist)

Ys = (Y2 - Y2.mean(0)) / Y2.std(0)                                      # 두 변수의 척도를 맞춘다
mu_k, c_k, W_hist = kmeans(Ys, Ys[[0, 1]])
# 같은 평균에서 책임을 온도 σ² 로 계산하면 σ → 0 에서 k-평균의 배정이 된다
def resp(Y, mu, s2):
    a = -((Y[:, None, :] - mu[None]) ** 2).sum(-1) / (2 * s2)
    return np.exp(a - special.logsumexp(a, axis=1, keepdims=True))
hard = np.eye(2)[c_k]
gaps = {s2: np.abs(resp(Ys, mu_k, s2) - hard).max() for s2 in (1.0, 0.1, 0.01, 0.001)}
# 연습 8.3: 1차원 두 성분 (π = ½, 같은 σ) 의 책임은 로지스틱
yy = np.linspace(-3, 3, 7); m1, m2, s = -1.0, 1.5, 0.8
r_direct = stats.norm.pdf(yy, m1, s) / (stats.norm.pdf(yy, m1, s) + stats.norm.pdf(yy, m2, s))
r_logit = 1 / (1 + np.exp(-(m1 - m2) / s**2 * (yy - (m1 + m2) / 2)))
# EM 과 k-평균의 배정 비교 (표준화한 2차원 Old Faithful)
gm_s = GaussianMixtureEM(2).fit(Ys, mu0=mu_k)
R_s, _ = gm_s.e_step(Ys)
agree = np.mean(R_s.argmax(1) == c_k)
agree = max(agree, 1 - agree)                                            # 이름표 바꾸기 (명제 4.3) 를 감안
print("σ² 에 따른 max|책임 − 딱딱한 배정|:", {k: f"{v:.1e}" for k, v in gaps.items()})
print(f"k-평균 목적함수: {W_hist.round(2).tolist()};  EM 과 k-평균의 배정 일치율 {agree:.3f} ({int(round((1 - agree) * len(Ys)))}개 다름)")
report({"명제 8.1: σ² → 0 이면 책임이 k-평균의 배정으로 간다": gaps[1.0] > gaps[0.1] > gaps[0.01] and gaps[0.001] < 1e-6,
        "연습 8.2: k-평균의 목적함수는 줄기만 한다": np.all(np.diff(W_hist) <= 1e-12),
        "연습 8.3: 같은 σ, π = ½ 이면 책임 = 로지스틱 함수": np.allclose(r_direct, r_logit),
        "8.2절: 잘 떨어진 무리에서는 EM 과 k-평균이 거의 같게 배정한다 (97% 이상)": agree > 0.97})
text
σ² 에 따른 max|책임 − 딱딱한 배정|: {1.0: '4.9e-01', 0.1: '4.0e-01', 0.01: '1.5e-02', 0.001: '5.2e-19'}
k-평균 목적함수: [149.02, 79.66, 79.61, 79.58];  EM 과 k-평균의 배정 일치율 0.996 (1개 다름)
  ✓  명제 8.1: σ² → 0 이면 책임이 k-평균의 배정으로 간다
  ✓  연습 8.2: k-평균의 목적함수는 줄기만 한다
  ✓  연습 8.3: 같은 σ, π = ½ 이면 책임 = 로지스틱 함수
  ✓  8.2절: 잘 떨어진 무리에서는 EM 과 k-평균이 거의 같게 배정한다 (97% 이상)
한마디. 책임은 거리의 음수를 로 나눈 softmax이고, 은 9회 8.3절의 온도와 같은 역할을 한다. 온도를 내리면 부드러운 배정(EM)이 딱딱한 배정(-평균)이 된다. Old Faithful처럼 무리가 잘 떨어져 있으면 두 방법의 배정이 거의 같다. 272개 가운데 경계 근처의 한 점만 다르다. 그러나 -평균은 무리의 모양(공분산)과 크기(비율)를 추정하지 않는다.
📝 연습 8.1–8.3 (강의노트): ELBO의 두 얼굴, -평균은 내려간다, 온도와 책임.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| 여러 모수 (1.2–1.9) | 감마의 정보 행렬과 MLE 공분산, 신뢰타원체, Schur 보수의 대가, 프로파일 가능도비 = | 1절 |
| 불완전 자료 (2.1–2.5) | 유전 연관의 닫힌 꼴과 숨은 칸의 조건부분포, , 점수의 항등식 | 2절 |
| EM (3.1–3.7) | LinkageEM, 단조성, ELBO 분해, 과 Louis 공식, 비율 0.1328, 중도절단의 EM |
3절 |
| 정규 혼합 (4.1–4.4) | GaussianMixtureEM (무게·차원·logsumexp), BFGS 대조, 이름표, 대칭의 함정 |
4절 |
| 데이터 (5.1–5.6) | 게의 적률법 두 해와 6차 적률, EM과 고유값 0.9936, 묶음 가능도, 의 프로파일 구간, Old Faithful, may의 Poisson 혼합 | 5절 |
| 부숴보기 (6) | 의 특이점(), 성분 수의 가능도비, 세 수렴 속도 | 6절 |
| 고치기 (7) | RandomEffectsEM, 닫힌 꼴 대조, 축소 |
7절 |
| 오늘 (8) | KL 공식과 ELBO, -평균 = 온도 0의 EM | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 여러 모수 | 1.1 ★ · 1.2 ★ · 1.3 변동계수 ★★ · 1.4 감마의 프로파일 ★★ · 1.5 두 표본 ★★ · 1.6 정보 행렬의 두 표현 ★ · 1.7 신뢰영역과 함수 ★★ (유도형) | 1절 |
| 2 불완전 자료 | 2.1 ★ · 2.2 ★ · 2.3 중도절단 ★★ · 2.4 혼합의 점수 ★★ · 2.5 묶음 ★★ · 2.6 점수의 항등식 ★★ (유도형) | 2–3절 |
| 3 EM | 3.1 ★ · 3.2 수렴 속도 ★★ · 3.3 중도절단의 EM ★★★ · 3.4 일반화 EM ★ · 3.5 증거 하한 ★ · 3.6 고정점 ★★ (유도형) | 3절 |
| 4 정규 혼합 | 4.1 M 단계 ★★ · 4.2 같은 출발점 ★★ · 4.3 Poisson 혼합 ★★ · 4.4 logsumexp ★ | 4–5절 |
| 5 데이터 | 5.1 적률 ★★ · 5.2 6차 적률 ★ · 5.3 묶음 가능도 ★★ · 5.4 2차원 ★ | 5절 |
| 6 부숴보기 | 6.1 같은 분산 ★★ · 6.2 분산의 비 ★★★ · 6.3 AIC·BIC ★ · 6.4 유계가 아님 ★ (유도형) | 5–6절 |
| 7 고치기 | 7.1 차와 합 ★★ · 7.2 E 단계 ★★ · 7.3 축소 ★ · 7.4 임의효과의 MLE ★★ (유도형) | 7절 |
| 8 오늘 | 8.1 ELBO ★★ · 8.2 -평균 ★★ · 8.3 온도 ★ · 8.4 딱딱한 EM ★ (유도형) | 8절 |
다음 회 (11회) — 충분성: 자료를 줄이는 법 (1920 → 1955). EM의 M 단계에는 충분통계량의 기댓값만 있으면 되었다. 정규 혼합에서는 , , 이 전부였다. 자료 전체 대신 몇 개의 요약만 알아도 정보를 잃지 않는다는 것이 Fisher의 충분성이다. 11회는 Eddington과 Fisher의 표준편차 논쟁(1920)에서 출발해 인수분해 정리, Rao–Blackwell, Lehmann–Scheffé를 증명하고, 8회의 독일 전차 추정량이 왜 최선인지 보인다.
10. 워크북 검산
워크북(10_em_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A3a", "3/8")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/8,0.375)나 식의 문자열("v*(1+z^2/2)")로 넣는다. 소문항은"A11c"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다.- 반복과 시뮬레이션으로 한 번 더 — EM을 끝까지 돌려야 하는 문항(A7, A8, C8, D1, D2, D4)과 확률이 답인 문항(C6, D3)을 위해 함수를 정의해 두었다. 함수는 정의만 했고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B와 C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A3a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2 A3a A3b A3c A4a A4b A4c A5 A6 A7a A7b A8 A9a A9b A9c A10 A11a A11b A11c A12a A12b A12c A12d A13a A13b A14a A14b A14c C1c C6a C8d C9b D1d D1e D2d D2e D2f D2g D3d D3e D4d D4e D4f D4g
A3a: 아직 답을 넣지 않았다. 예: check('A3a', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다. 식으로 된 답(A5, C6a)은 문항에 적힌 기호(v, z)로 쓴다.
python
mine = {
    "A1a": None, "A1b": None, "A2": None, "A3a": None, "A3b": None, "A3c": None,
    "A4a": None, "A4b": None, "A4c": None, "A5": None, "A6": None, "A7a": None, "A7b": None, "A8": None,
    "A9a": None, "A9b": None, "A9c": None, "A10": None, "A11a": None, "A11b": None, "A11c": None,
    "A12a": None, "A12b": None, "A12c": None, "A12d": None, "A13a": None, "A13b": None,
    "A14a": None, "A14b": None, "A14c": None,
    "C1c": None, "C6a": None, "C8d": None, "C9b": None,
    "D1d": None, "D1e": None, "D2d": None, "D2e": None, "D2f": None, "D2g": None,
    "D3d": None, "D3e": None, "D4d": None, "D4e": None, "D4f": None, "D4g": None,
}
check_all(mine)
text
0/0 맞음10.2 반복 함수와 시뮬레이션 함수
반복 함수는 반복점의 목록을 돌려준다. 시뮬레이션 함수는 (추정값, 표준오차)를 돌려준다. 손으로 한두 번 돌린 값이 목록의 처음과 같은지, 수렴값이 최종답과 같은지 본다.
| 함수 | 문항 | 하는 일 |
|---|---|---|
em_linkage(y, theta0, steps) |
A7, A8 | 유전 연관 모형의 EM. 오차의 비가 수렴 비율이다 |
em_weights(y, f1, f2, pi0, steps) |
C8 | 성분을 아는 혼합의 비율 |
em_truncpois(ybar, lam0, steps) |
D1 | 0이 기록되지 않는 Poisson |
em_coins(heads, m, a0, b0, steps) |
D2 | 동전 두 개 |
em_abo(counts, p0, q0, steps) |
D4 | ABO 유전자 빈도 |
sim_profbias(n, v, reps) |
C6 | 프로파일 점수의 평균 |
sim_mixinfo(mu, pi, n) |
D3 | 점수의 제곱의 평균 = 정보 |
python
def em_linkage(y, theta0, steps):
    """범주 확률 (1/2+θ/4, (1-θ)/4, (1-θ)/4, θ/4) 모형의 EM 반복점"""
    y1, y2, y3, y4 = y
    out, t = [theta0], theta0
    for _ in range(steps):
        x2 = y1 * t / (2 + t)                       # E 단계
        t = (x2 + y4) / (x2 + y4 + y2 + y3)          # M 단계
        out.append(t)
    return out


def em_weights(y, f1, f2, pi0, steps):
    """알려진 두 밀도 f1, f2의 혼합에서 비율만 추정하는 EM"""
    y = np.asarray(y, dtype=float)
    a, b = f1(y), f2(y)
    out, p = [pi0], pi0
    for _ in range(steps):
        p = np.mean(p * a / (p * a + (1 - p) * b))
        out.append(p)
    return out


def em_truncpois(ybar, lam0, steps):
    """0이 기록되지 않는 Poisson: λ ← ȳ(1 - e^{-λ})"""
    out, lam = [lam0], lam0
    for _ in range(steps):
        lam = ybar * (1 - np.exp(-lam))
        out.append(lam)
    return out


def em_coins(heads, m, a0, b0, steps):
    """동전 두 개(고르는 확률 1/2): (θ_A, θ_B) 반복점"""
    h = np.asarray(heads)
    out, a, b = [(a0, b0)], a0, b0
    for _ in range(steps):
        la, lb = a ** h * (1 - a) ** (m - h), b ** h * (1 - b) ** (m - h)
        w = la / (la + lb)
        a, b = (w * h).sum() / (w * m).sum(), ((1 - w) * h).sum() / ((1 - w) * m).sum()
        out.append((a, b))
    return out


def em_abo(counts, p0, q0, steps):
    """ABO 유전자 빈도: counts = (A, B, AB, O)"""
    nA, nB, nAB, nO = counts
    n = sum(counts)
    out, p, q = [(p0, q0)], p0, q0
    for _ in range(steps):
        r = 1 - p - q
        nAA, nBB = nA * p * p / (p * p + 2 * p * r), nB * q * q / (q * q + 2 * q * r)
        p = (2 * nAA + (nA - nAA) + nAB) / (2 * n)
        q = (2 * nBB + (nB - nBB) + nAB) / (2 * n)
        out.append((p, q))
    return out


def sim_profbias(n, v, reps=100_000):
    """N(0, v) 표본 n개에서 프로파일 점수 -n/(2v) + SS/(2v²)의 평균"""
    x = rng.normal(0, np.sqrt(v), size=(reps, n))
    ss = ((x - x.mean(axis=1, keepdims=True)) ** 2).sum(axis=1)
    sc = -n / (2 * v) + ss / (2 * v * v)
    return sc.mean(), sc.std(ddof=1) / np.sqrt(reps)


def sim_mixinfo(mu, pi, n=N_SIM):
    """π N(0,1) + (1-π) N(μ,1)에서 점수 (f1-f2)/g 의 제곱의 평균"""
    z = rng.random(n) < pi
    y = np.where(z, rng.normal(0, 1, n), rng.normal(mu, 1, n))
    f1, f2 = stats.norm.pdf(y, 0, 1), stats.norm.pdf(y, mu, 1)
    s2 = ((f1 - f2) / (pi * f1 + (1 - pi) * f2)) ** 2
    return s2.mean(), s2.std(ddof=1) / np.sqrt(n)
python
# 자체 검사 (출력 없음): 반복 함수와 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _near(x, key, tol=1e-6, **pt):
    return abs(x - _value(key, **pt)) <= tol * max(1.0, abs(_value(key, **pt)))

_fl = em_linkage((1997, 906, 904, 32), 1 / 20, 400)
assert _near(_fl[1], "A7a") and _near(_fl[-1], "A7b")
assert _near((_fl[16] - _fl[-1]) / (_fl[15] - _fl[-1]), "A8", 1e-4)
assert _near(em_weights([0, 0.5, 2], lambda t: stats.norm.pdf(t, 0, 1), lambda t: stats.norm.pdf(t, 2, 1), 0.5, 3000)[-1], "C8d")
_tp = em_truncpois(2.0, 2.0, 3000)
assert _near(_tp[-1], "D1d") and _near((_tp[12] - _tp[-1]) / (_tp[11] - _tp[-1]), "D1e", 1e-4)
_co = em_coins([5, 9, 8, 4, 7], 10, 0.6, 0.5, 5000)
assert _near(_co[1][0], "D2d") and _near(_co[1][1], "D2e") and _near(_co[-1][0], "D2f", 1e-5) and _near(_co[-1][1], "D2g", 1e-5)
_ab = em_abo((186, 38, 13, 284), 1 / 3, 1 / 3, 2000)
assert _near(_ab[1][0], "D4d") and _near(_ab[1][1], "D4e") and _near(_ab[-1][0], "D4f") and _near(_ab[-1][1], "D4g")
_m, _se = sim_profbias(7, 2.0)
assert abs(_m - _value("C6a", v=2.0)) <= 4 * _se
_m, _se = sim_mixinfo(3.0, 0.5)
assert abs(_m - _value("D3d")) <= 4 * _se
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))