
테마
10회 · 숨은 변수와 EM · 노트
0 들어가며
여는 질문. 나폴리 만의 게 1,000마리를 쟀더니 이마 폭의 분포가 한쪽으로 기울어 있다. 두 무리가 섞여 있는 것은 아닐까? 그런데 어느 게가 어느 무리인지는 아무도 모른다. 이름표가 없는 자료에서 두 무리의 평균과 비율을 추정할 수 있는가?
4회 5.3절에서 이 질문을 남겨 두었다. 동물학자 Weldon은 나폴리 만의 게 1,000마리에서 “이마”의 폭과 몸길이의 비를 쟀다. 분포의 왜도는 으로 정규에서 뚜렷이 벗어나 있었다. 그는 진화가 일어나는 중이라면, 곧 한 종이 두 무리로 갈라지는 중이라면 이런 모양이 나올 것이라 생각했고, Karl Pearson에게 분석을 부탁했다. Pearson(1894)은 두 정규분포의 혼합에 다섯 개의 모수를 놓고, 자료의 처음 다섯 적률을 모형의 적률과 같게 하는 방정식을 9차 방정식 하나로 줄여 손으로 풀었다. 근이 둘 나왔고, 그는 여섯째 적률로 하나를 골랐다.
이 노트는 같은 문제를 다르게 푼다. 각 게가 어느 무리에서 왔는지를 “보이지 않는 자료”로 보면, 보이지 않는 것을 지금의 추정값으로 채우고(E), 채운 자료로 모수를 다시 추정하기(M)를 되풀이할 수 있다. 이 생각은 McKendrick(1926), Hartley(1958), Baum(1970) 등이 여러 번 따로 찾아냈고, Dempster, Laird, Rubin(1977)이 하나의 이론으로 묶어 EM 알고리즘이라 불렀다.
먼저 9회의 이론을 여러 모수로 완성한다. 정보 행렬, 다변량 점근정규성, 귀찮은 모수가 있을 때의 프로파일 가능도를 다룬다(1절). 2절은 불완전 자료의 가능도를 세우고, 3절은 EM이 가능도를 결코 줄이지 않음을 Gibbs 부등식으로 증명한다. 수렴 속도가 “잃어버린 정보의 비율”로 정해진다는 것도 3절에서 보인다. 4절은 정규 혼합의 EM을 유도하고, 5절은 Pearson의 게, Old Faithful 간헐천, The Federalist에 쓴다. 6절은 혼합 가능도가 무한대로 가는 특이점과 성분 수 검정의 어려움을 보고, 7절은 9회의 Neyman–Scott 문제를 EM으로 고친다. 8절에서는 같은 하한이 변분 오토인코더의 ELBO가 되고, -평균이 “딱딱한” EM이 됨을 본다.
학습 목표
- 1.
정보 행렬과 다변량 점근정규성을 증명하고, 귀찮은 모수가 분산을 키움을 Schur 보수로 보인다.
- 2.
프로파일 가능도를 정의하고, 귀찮은 모수가 있을 때의 Wilks 정리를 증명한다.
- 3.
불완전 자료의 가능도를 세우고, EM의 단조성과 ELBO 분해를 Gibbs 부등식으로 증명한다.
- 4.
잃어버린 정보의 원리(Louis 공식)와 EM의 선형 수렴 속도를 유도하고 수치로 확인한다.
- 5.
정규 혼합의 EM을 유도·구현해 Pearson의 적률법과 비교하고, 특이점과 성분 수 검정의 함정을 본다.
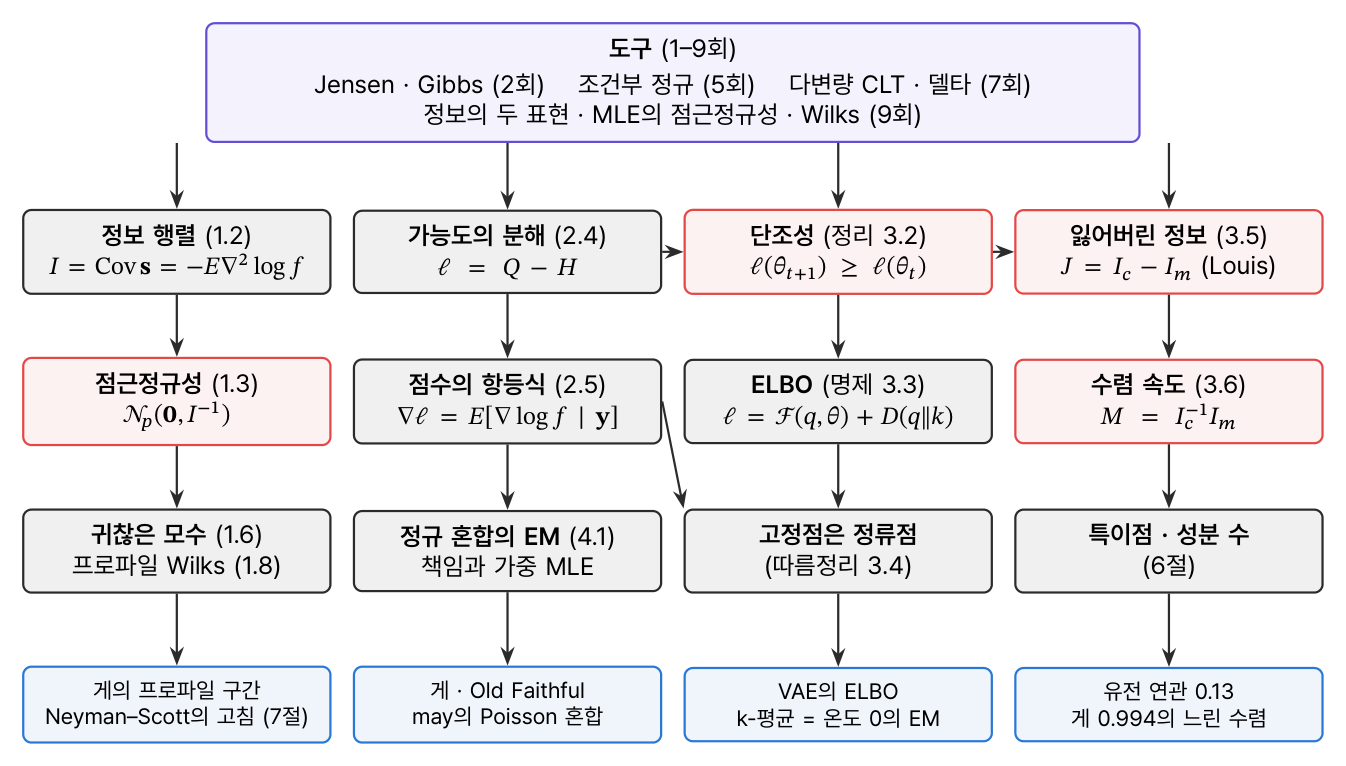
0.1 1–9회에서 가져오는 것
0.2 표기
모수는 벡터 이고, 한 관측의 점수 벡터는 , 로그가능도의 기울기와 헤세 행렬은 , 로 쓴다. 2절부터는 관측한 자료 와 보이지 않는 자료 를 나누고, 둘을 합친 를 완전 자료라 부른다. 완전 자료의 밀도는 , 관측 자료의 밀도는 , 관측이 주어질 때 숨은 자료의 조건부 밀도는 이다.