
테마
10회 · 숨은 변수와 EM · 노트
5 데이터로 — 게, 간헐천, 그리고 “may”
5.1 Weldon의 게와 Pearson의 9차 방정식 (1894)
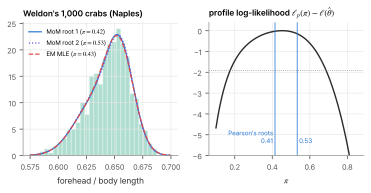
예제 5.1 (자료) Weldon의 1,000마리는 몸길이에 대한 이마 폭의 비를 0.004 폭의 칸 29개에 묶어 기록했다(R 패키지 mixdist의 pearson). 칸의 가운데 값으로 계산하면 평균 0.6447, 표준편차 0.0191, 왜도 , 초과첨도 0.06이다. 왼쪽 꼬리가 길다. 한 정규를 묶음 자료의 가능도로 맞추면 로그가능도가 두 정규의 혼합보다 26.4 낮다(). 자료는 한 정규보다 혼합을 강하게 지지한다. 다만 이 비교의 영분포는 이 아니다(6.2절).
예제 5.2 (Pearson의 적률법) 혼합 의 처음 다섯 적률을 표본의 것과 같게 놓으면 미지수 다섯의 다항 연립방정식이 된다. Pearson은 이것을 9차 방정식 하나로 줄여 손으로 풀었고, 쓸 만한 해 두 개를 얻었다(첫 성분의 비율 0.4145와 0.5328). 같은 연립방정식을 수치로 풀면 다음 두 해가 나온다.
| 6차 표준적률 | ||||||
|---|---|---|---|---|---|---|
| 해 1 | 0.424 | 0.6311 | 0.0180 | 0.6547 | 0.0124 | 16.17 |
| 해 2 | 0.533 | 0.6350 | 0.0191 | 0.6558 | 0.0115 | 16.41 |
| 표본 | 15.52 |
비율이 Pearson의 손 계산과 조금 다른 것은 묶음을 다루는 방식(칸의 가운데 값, 열린 양 끝 칸) 때문이다. 다섯 적률로는 두 해를 가를 수 없다. Pearson은 여섯째 적률이 표본에 더 가까운 해 1을 골랐다. 우리 계산에서도 해 1이 더 가깝다.
예제 5.3 (최대가능도와 EM) 칸의 가운데 값에 칸의 도수를 무게로 주고 명제 4.1의 EM을 돌리면, 서로 다른 네 시작점이 모두 같은 점 , , , , 으로 간다. 적률법의 해 1과 가깝다. 그런데 로그가능도의 증가가 아래로 내려갈 때까지 1,200–1,900번을 반복해야 한다. MLE에서 EM 사상의 야코비 행렬(정리 3.6의 )을 수치로 구하면 가장 큰 고유값이 0.9936이다. 한 번 반복할 때마다 오차가 0.64%씩만 줄어서, 한 자릿수를 얻는 데 약 360번이 든다. 두 성분이 거의 겹쳐 있어서 이름표가 정보를 거의 다 가져갔기 때문이다. 묶음을 정확히 반영한 가능도 를 직접 최대화하면 , , , , 로, 가운데 값을 쓴 것과 거의 같다.
예제 5.4 (비율의 프로파일 가능도) 묶음 가능도에서 를 고정하고 나머지 넷을 최대화한 프로파일 가능도(정의 1.7)는 아주 평평하다(그림 5.1). 정리 1.8의 95% 구간 은 이다. Pearson의 두 해 0.41과 0.53은 모두 그 안에 있다(프로파일 가능도비 0.05와 0.30). 자료는 “두 무리가 섞여 있다”는 것은 강하게 말하지만, 얼마나 섞여 있는지는 거의 말하지 않는다. 귀찮은 모수 넷의 대가다(정리 1.6). Pearson이 두 해 가운데 하나를 고르기 어려웠던 것도, 혼합 분석 프로그램 MIX(Macdonald)의 예제가 이 자료에서 비율을 0.5로 고정해 두는 것도 같은 이유다. EM이 느린 것은 이 평평함의 다른 얼굴이다(정리 3.6).
5.2 Old Faithful 간헐천
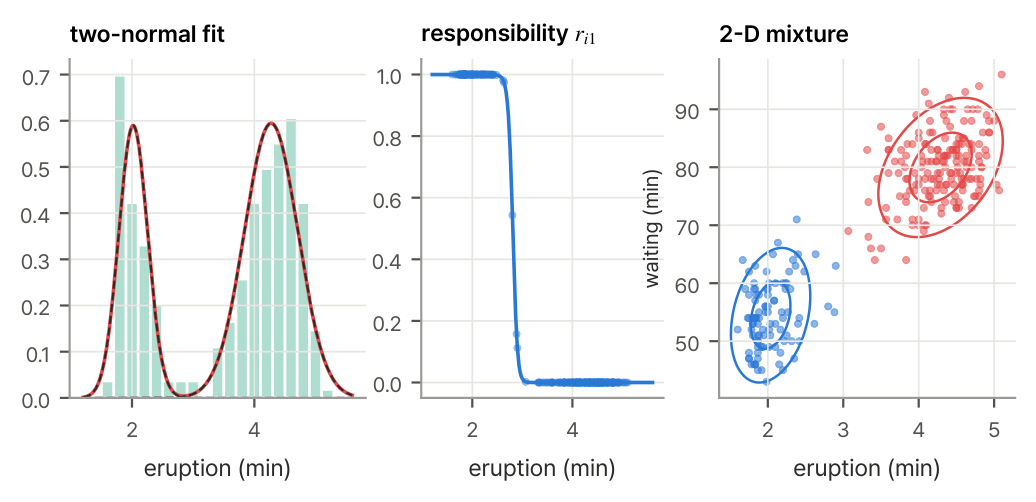
예제 5.5 (분출 시간의 두 무리) 미국 Yellowstone 국립공원의 Old Faithful 간헐천에서 잰 272번의 분출 시간(분, datasets::faithful)은 2분 근처와 4.5분 근처에 봉우리가 있다. 두 정규의 혼합을 EM으로 맞추면
이고, 이다(한 정규보다 145 높다). 29번의 반복으로 수렴하고, EM 사상의 가장 큰 고유값은 0.589다. 두 무리가 잘 떨어져 있어 이름표의 대부분이 자료에서 거의 확실히 정해지므로 잃어버린 정보가 적다. 관측 정보(수치 헤세 행렬)의 역행렬로 만든 표준오차는 이다. 이 결과는 일반 목적의 최적화(BFGS)로 가능도를 직접 최대화한 것과 소수 넷째 자리까지 같다. 분출 시간과 다음 분출까지의 대기 시간을 함께 쓰면 2차원 혼합이 되고, 두 무리의 비율은 0.644와 0.356이다(그림 5.2).
5.3 The Federalist의 “may”, 다시
예제 5.6 (두 Poisson의 혼합 대 음이항) 9회 예제 6.3에서 Madison의 글 262조각의 may 개수는 Poisson보다 흩어져 있었고, 음이항이 잘 맞았다. 음이항은 “조각마다 위험률이 감마분포를 따르는” Poisson의 혼합이다(4회 5.2절). 위험률이 두 값 중 하나라고 보면 두 Poisson의 혼합이 되고, EM(연습 4.3)으로 , , 를 얻는다. 기대도수는 으로 관측 에 잘 맞는다. 로그가능도는 로, 모수가 셋인데도 모수가 둘인 음이항()보다 조금 낮다. 자료는 “주제가 두 종류”보다 “주제마다 조금씩 다르다”를 약간 더 좋아한다. 두 모형 모두 Poisson()보다는 훨씬 낫다.
연습문제
연습 5.1 (적률의 방정식 ★★) 혼합 의 차 원점 적률이 임을 보이고, 를 쓰라().
풀이
(전확률). , , , .
연습 5.2 (여섯째 적률로 고르기 ★) 예제 5.2의 두 해의 6차 표준적률이 16.17과 16.41임을 노트북으로 확인하라. 다섯 적률을 맞춘 두 해를 여섯째 적률로 가르는 것이 왜 약한 기준인가? (6차 적률의 표준오차를 생각하라.)
풀이
6차 표준적률의 표준오차를 으로 어림하면 약 2.6인데, 두 해의 차이는 0.24다. 여섯째 적률은 다섯 적률보다 훨씬 흔들리는 통계량이어서 이 기준으로는 두 해를 거의 가를 수 없다. 프로파일 가능도(예제 5.4)도 같은 말을 한다.
연습 5.3 (묶음 가능도 ★★) 칸 의 도수가 이면 가능도가 임을 설명하고, 칸이 좁아지면 이것이 가운데 값에서의 밀도로 만든 가능도와 상수배만 다름을 보여라.
풀이
각 관측은 어느 칸에 들어갔는지만 알려 주므로 칸 의 확률 가 그 관측의 가능도다. 폭 의 칸이면 (는 가운데 값)이므로 가능도는 이고, 은 모수에 의존하지 않는다.
연습 5.4 (2차원 Old Faithful ★) 분출 시간과 대기 시간의 2차원 혼합을 노트북으로 맞추고, 두 성분의 상관계수를 구하라. 한 성분 안에서도 두 변수가 상관되어 있는가?
풀이
두 성분의 상관계수는 0.29(짧은 분출)와 0.38(긴 분출)이다. 전체 상관계수 0.90의 대부분은 무리 사이의 차이에서 온다. 무리 안의 상관은 약하다. 5회의 Galton 자료와 8회의 Berkeley에서 본 것처럼, 섞인 집단의 상관은 집단 안의 상관과 다를 수 있다.