Skip to content

10회 · 숨은 변수와 EM · 노트

3 EM 알고리즘 ​

3.1 알고리즘과 단조성 ​

알고리즘 3.1 (EM (Dempster–Laird–Rubin, 1977)) 시작값 θ0\boldsymbol\theta_0에서 t=0,1,2,…t=0,1,2,\dots에 대해 다음을 되풀이한다.

  1. E

    지금의 추정값으로 숨은 자료의 조건부분포 k(⋅∣y;θt)k(\cdot\mid\y;\boldsymbol\theta_t)를 구하고 Q(θ∣θt)=Eθt[log⁡f(y,Z;θ)∣y]Q(\boldsymbol\theta\mid\boldsymbol\theta_t)=E_{\boldsymbol\theta_t}[\log f(\y,\allowbreak \Z;\boldsymbol\theta)\mid\y]를 만든다.

  2. M

    θt+1=arg⁡max⁡θQ(θ∣θt)\boldsymbol\theta_{t+1}=\arg\max_{\boldsymbol\theta}Q(\boldsymbol\theta\mid\boldsymbol\theta_t).

ℓ(θt+1)−ℓ(θt)\ell(\boldsymbol\theta_{t+1})-\ell(\boldsymbol\theta_t)이 충분히 작아지면 멈춘다.

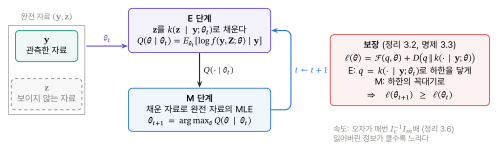
완전 자료 모형이 지수족이면 log⁡f\log f는 충분통계량에 대해 선형이므로, E 단계는 “충분통계량의 조건부 기댓값을 구하기”이고 M 단계는 “그 기댓값을 완전 자료의 MLE 공식에 넣기”다. 유전 연관 자료에서는 E 단계가 x2(t)=125⋅θt2+θtx_2^{(t)}=125\cdot\tfrac{\theta_t}{2+\theta_t}, M 단계가 θt+1=x2(t)+34x2(t)+72\theta_{t+1}=\tfrac{x_2^{(t)}+34}{x_2^{(t)}+72}이다(연습 2.2). 한 바퀴의 그림이 그림 3.1이다.

그림 3.1. EM의 한 바퀴. 완전 자료 가운데 z가 보이지 않는다. E 단계는 지금의 추정값으로 z의 조건부분포를 구해 Q를 만들고, M 단계는 Q를 최대화한다. 오른쪽은 이 반복이 가능도를 줄이지 않는 이유와 그 속도다.
그림 3.1 EM의 한 바퀴. 완전 자료 가운데 z\mathbf z가 보이지 않는다. E 단계는 지금의 추정값으로 z\mathbf z의 조건부분포를 구해 QQ를 만들고, M 단계는 QQ를 최대화한다. 오른쪽은 이 반복이 가능도를 줄이지 않는 이유와 그 속도다.

정리 3.2 (EM은 가능도를 줄이지 않는다) EM의 반복은 ℓ(θt+1)≥ℓ(θt)\ell(\boldsymbol\theta_{t+1})\ge\ell(\boldsymbol\theta_t)를 만족한다. 등호는 Q(θt+1∣θt)=Q(θt∣θt)Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)=Q(\boldsymbol\theta_t\mid\boldsymbol\theta_t)이고 k(⋅∣y;θt+1)=k(⋅∣y;θt)k(\cdot\mid\y;\boldsymbol\theta_{t+1})=k(\cdot\mid\y;\boldsymbol\theta_t)일 때뿐이다.

증명 전략 보조정리 2.4로 가능도의 증가를 QQ의 증가와 HH의 변화로 나눈다. QQ는 M 단계가 늘리고, HH는 Gibbs 부등식으로 제자리에서 가장 크다.

  1. 보조정리 2.4를 θ′=θt\boldsymbol\theta'=\boldsymbol\theta_t로 두고 θt+1\boldsymbol\theta_{t+1}과 θt\boldsymbol\theta_t에 쓴 두 식을 빼면

    ℓ(θt+1)−ℓ(θt)=[Q(θt+1∣θt)−Q(θt∣θt)]−[H(θt+1∣θt)−H(θt∣θt)].\ell(\boldsymbol\theta_{t+1})-\ell(\boldsymbol\theta_t)=\bigl[Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)-Q(\boldsymbol\theta_t\mid\boldsymbol\theta_t)\bigr]-\bigl[H(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)-H(\boldsymbol\theta_t\mid\boldsymbol\theta_t)\bigr] .
    보조정리 2.4
  2. 첫 괄호는 0 이상이다. θt+1\boldsymbol\theta_{t+1}은 Q(⋅∣θt)Q(\cdot\mid\boldsymbol\theta_t)의 최대점이다.M 단계

  3. 둘째 괄호를 기댓값 하나로 쓴다.

    H(θ∣θt)−H(θt∣θt)=Eθt[log⁡k(Z∣y;θ)k(Z∣y;θt)∣y]=−D(k(⋅∣y;θt) ∥ k(⋅∣y;θ)).H(\boldsymbol\theta\mid\boldsymbol\theta_t)-H(\boldsymbol\theta_t\mid\boldsymbol\theta_t)=E_{\boldsymbol\theta_t}\Bigl[\log\frac{k(\Z\mid\y;\boldsymbol\theta)}{k(\Z\mid\y;\boldsymbol\theta_t)}\Bigm|\y\Bigr]=-D\bigl(k(\cdot\mid\y;\boldsymbol\theta_t)\,\big\|\,k(\cdot\mid\y;\boldsymbol\theta)\bigr) .
    HH와 DD의 정의
  4. D≥0D\ge0이므로 둘째 괄호는 0 이하이다.Gibbs 부등식, 2회 정리 8.3

  5. 따라서 ℓ(θt+1)−ℓ(θt)≥0\ell(\boldsymbol\theta_{t+1})-\ell(\boldsymbol\theta_t)\ge0이다.1 2 4

  6. 등호는 두 괄호가 모두 0일 때, 곧 Q(θt+1∣θt)=Q(θt∣θt)Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)=Q(\boldsymbol\theta_t\mid\boldsymbol\theta_t)이고 k(⋅∣y;θt+1)=k(⋅∣y;θt)k(\cdot\mid\y;\boldsymbol\theta_{t+1})=k(\cdot\mid\y;\boldsymbol\theta_t)일 때뿐이다.Gibbs의 등호 조건

조건 확인 보조정리 2.4의 첫 등식은 k(z∣y;θ)>0k(\z\mid\y;\boldsymbol\theta)>0인 곳에서 성립한다. k(⋅∣y;θt)>0k(\cdot\mid\y;\boldsymbol\theta_t)>0인 곳에서 k(⋅∣y;θt+1)>0k(\cdot\mid\y;\boldsymbol\theta_{t+1})>0이어야 1의 평균을 취할 수 있다. 숨은 자료의 받침이 모수에 의존하지 않으면 성립한다. QQ와 HH는 유한하다고 가정한다. 3의 계산은 9회 보조정리 1.4와 같다.

증명에서 M 단계가 한 일은 QQ를 늘린 것뿐이다. 그래서 QQ를 완전히 최대화하지 않고 늘리기만 해도(예: Newton 한 걸음) 단조성은 그대로다. 이것을 일반화 EM(GEM)이라 한다.

3.2 하한을 오르는 알고리즘 ​

명제 3.3 (증거 하한 (ELBO)) z\z 위의 아무 확률밀도 qq에 대해

ℓ(θ)=F(q,θ)+D(q ∥ k(⋅∣y;θ)),F(q,θ)=Eq[log⁡f(y,Z;θ)]−Eq[log⁡q(Z)].\ell(\boldsymbol\theta)=\mathcal F(q,\boldsymbol\theta)+D\bigl(q\,\big\|\,k(\cdot\mid\y;\boldsymbol\theta)\bigr),\qquad \mathcal F(q,\boldsymbol\theta)=E_q\bigl[\log f(\y,\Z;\boldsymbol\theta)\bigr]-E_q\bigl[\log q(\Z)\bigr].

따라서 ℓ(θ)≥F(q,θ)\ell(\boldsymbol\theta)\ge\mathcal F(q,\allowbreak \boldsymbol\theta)이고, 등호는 q=k(⋅∣y;θ)q=k(\cdot\mid\y;\boldsymbol\theta)일 때다.

증명 전략 완전 밀도를 f=g⋅kf=g\cdot k로 쓰고 아무 분포 qq로 평균한 뒤, 양변에서 Eqlog⁡qE_q\log q를 뺀다. 남는 항이 Kullback–Leibler 발산이다. 단계별 증명은 연습 3.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

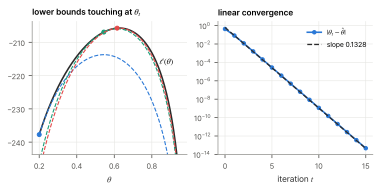
이 명제는 EM을 한 함수 F(q,θ)\mathcal F(q,\allowbreak \boldsymbol\theta)를 번갈아 최대화하는 좌표 상승으로 보여 준다(Neal–Hinton, 1998). E 단계는 θt\boldsymbol\theta_t를 고정하고 qq에 대해 최대화한다. 답은 q=k(⋅∣y;θt)q=k(\cdot\mid\y;\boldsymbol\theta_t)이고, 하한이 그 점에서 가능도에 닿는다. M 단계는 qq를 고정하고 θ\boldsymbol\theta에 대해 최대화한다. Eqlog⁡qE_q\log q는 θ\boldsymbol\theta에 의존하지 않으므로 이것은 Q(θ∣θt)Q(\boldsymbol\theta\mid\boldsymbol\theta_t)의 최대화다. 가능도 아래에 그 점에서 닿는 하한을 깔고, 하한의 꼭대기로 옮기고, 그 점에서 다시 하한을 까는 것이다(그림 3.2). 8절에서 qq를 신경망으로 근사하면 변분 오토인코더가 된다.

따름정리 3.4 (EM의 고정점은 정류점이다) θt→θ∗\boldsymbol\theta_t\to\boldsymbol\theta^* (내점)이고 QQ가 두 인수에 대해 연속미분가능하면 ∇ℓ(θ∗)=0\nabla\ell(\boldsymbol\theta^*)=\mathbf 0이다.

증명 전략 M 단계의 1계 조건에서 t→∞t\to\infty로 극한을 취하고, 명제 2.5로 그 극한을 관측 점수로 읽는다. 단계별 증명은 연습 3.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

가정 주의 정류점은 극대점이 아닐 수도 있다. EM은 가능도를 늘리기만 하므로 극소점에 머무는 일은 드물지만(9회 4절의 Newton과 다르다), 국소 최대점이나 안장점에 멈출 수 있다. 원논문의 수렴 증명에는 틀린 단계가 있었고, Wu(1983)가 정확한 조건을 정리했다. 실전에서는 여러 시작점에서 돌려 가능도가 가장 높은 것을 고른다.

3.3 잃어버린 정보와 수렴 속도 ​

숨은 자료를 보지 못해서 정보를 얼마나 잃었는가? 완전 자료의 정보에서 관측 자료의 정보를 뺀 것이다. 이 직관을 정확히 쓴 것이 다음 정리다.

정리 3.5 (잃어버린 정보의 원리 (Orchard–Woodbury 1972, Louis 1982)) 관측 정보 J(θ)=−∇2ℓ(θ)J(\boldsymbol\theta)=-\nabla^2\ell(\boldsymbol\theta)는

J(θ)=Ic(θ∣y)−Im(θ∣y)J(\boldsymbol\theta)=I_c(\boldsymbol\theta\mid\y)-I_m(\boldsymbol\theta\mid\y)

로 쓰인다. 여기서 Ic(θ∣y)=−Eθ[∇2log⁡f(y,Z;θ)∣y]I_c(\boldsymbol\theta\mid\y)=-E_{\boldsymbol\theta}\bigl[\nabla^2\log f(\y,\allowbreak \Z;\boldsymbol\theta)\mid\y\bigr]는 완전 자료 정보의 조건부 기댓값이고,

Im(θ∣y)=−Eθ[∇2log⁡k(Z∣y;θ)∣y]=Cov⁡θ(∇log⁡f(y,Z;θ)∣y)I_m(\boldsymbol\theta\mid\y)=-E_{\boldsymbol\theta}\bigl[\nabla^2\log k(\Z\mid\y;\boldsymbol\theta)\mid\y\bigr]=\Cov_{\boldsymbol\theta}\bigl(\nabla\log f(\y,\Z;\boldsymbol\theta)\bigm|\y\bigr)

는 잃어버린 정보다(둘째 등식이 Louis 공식).

증명 전략 보조정리 2.4의 첫 등식 ℓ=log⁡f−log⁡k\ell=\log f-\log k를 두 번 미분하고 숨은 자료의 조건부분포로 평균한다. 둘째 등식은 kk가 z\z의 밀도라는 것과 정리 1.2의 두 표현이다.

  1. 모든 z\z에서 ℓ(θ)=log⁡f(y,z;θ)−log⁡k(z∣y;θ)\ell(\boldsymbol\theta)=\log f(\y,\allowbreak \z;\boldsymbol\theta)-\log k(\z\mid\y;\boldsymbol\theta)이다.보조정리 2.4

  2. 두 번 미분하면 −∇2ℓ(θ)=−∇2log⁡f(y,z;θ)+∇2log⁡k(z∣y;θ)-\nabla^2\ell(\boldsymbol\theta)=-\nabla^2\log f(\y,\allowbreak \z;\boldsymbol\theta)+\nabla^2\log k(\z\mid\y;\boldsymbol\theta)이다.1

  3. 왼쪽은 z\z에 의존하지 않으므로 Z∼k(⋅∣y;θ)\Z\sim k(\cdot\mid\y;\boldsymbol\theta)로 평균해도 그대로다. 따라서 J(θ)=Ic(θ∣y)−Im(θ∣y)J(\boldsymbol\theta)=I_c(\boldsymbol\theta\mid\y)-I_m(\boldsymbol\theta\mid\y)이다.IcI_c, ImI_m의 정의

  4. θ\boldsymbol\theta마다 k(⋅∣y;θ)k(\cdot\mid\y;\boldsymbol\theta)는 z\z의 밀도이므로 정리 1.2를 이 모형에 쓸 수 있다. E[∇log⁡k∣y]=0E[\nabla\log k\mid\y]=\mathbf 0이고 −E[∇2log⁡k∣y]=Cov⁡(∇log⁡k∣y)-E[\nabla^2\log k\mid\y]=\Cov(\nabla\log k\mid\y)이다.정리 1.2

  5. ∇log⁡k(z∣y;θ)=∇log⁡f(y,z;θ)−∇ℓ(θ)\nabla\log k(\z\mid\y;\boldsymbol\theta)=\nabla\log f(\y,\allowbreak \z;\boldsymbol\theta)-\nabla\ell(\boldsymbol\theta)이고 둘째 항은 z\z에 대해 상수다.1을 한 번 미분

  6. 상수를 빼도 공분산은 같으므로 Im(θ∣y)=Cov⁡(∇log⁡f(y,Z;θ)∣y)I_m(\boldsymbol\theta\mid\y)=\Cov\bigl(\nabla\log f(\y,\allowbreak \Z;\boldsymbol\theta)\bigm|\y\bigr)이다.4 5

조건 확인 4에서 ∫k dz=1\int k\,d\z=1을 적분 기호 아래에서 두 번 미분한다 [T6]. 정리 1.2의 정칙조건이 숨은 자료의 조건부 모형에서도 성립한다고 가정한다.

정리 3.6 (EM의 수렴 속도 (DLR 1977)) θt→θ^\boldsymbol\theta_t\to\hat{\boldsymbol\theta} (내점, J(θ^)≻0J(\hat{\boldsymbol\theta})\succ0)이고 QQ가 두 번 연속미분가능하며 Ic=Ic(θ^∣y)≻0I_c=I_c(\hat{\boldsymbol\theta}\mid\y)\succ0이면

θt+1−θ^=M (θt−θ^)+o(∥θt−θ^∥),M=Ic−1Im.\boldsymbol\theta_{t+1}-\hat{\boldsymbol\theta}=M\,(\boldsymbol\theta_t-\hat{\boldsymbol\theta})+o\bigl(\|\boldsymbol\theta_t-\hat{\boldsymbol\theta}\|\bigr),\qquad M=I_c^{-1}I_m .

MM의 고유값은 모두 [0,1)[0,1)에 있다. 모수가 하나이면 M=Im/IcM=I_m/I_c는 잃어버린 정보의 비율이다.

증명 전략 M 단계의 1계 조건 ∇1Q(θt+1∣θt)=0\nabla_1Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)=\mathbf 0을 고정점 (θ^,θ^)(\hat{\boldsymbol\theta},\allowbreak \hat{\boldsymbol\theta}) 주위에서 일차 전개하고, 두 미분 행렬을 −Ic-I_c와 ImI_m으로 읽는다. ∇1\nabla_1, ∇2\nabla_2는 QQ의 첫 인수와 둘째 인수에 대한 미분이고, 아래 미분은 모두 (θ^,θ^)(\hat{\boldsymbol\theta},\allowbreak \hat{\boldsymbol\theta})에서 잰다.

  1. ∇1Q(θ^∣θ^)=∇ℓ(θ^)=0\nabla_1Q(\hat{\boldsymbol\theta}\mid\hat{\boldsymbol\theta})=\nabla\ell(\hat{\boldsymbol\theta})=\mathbf 0이다.명제 2.5, 따름정리 3.4

  2. M 단계의 조건을 일차 전개한다. δt=θt−θ^\boldsymbol\delta_t=\boldsymbol\theta_t-\hat{\boldsymbol\theta}로 쓰면

    0=∇1Q(θt+1∣θt)=∇12Q δt+1+∇2∇1Q δt+o(∥δt+1∥+∥δt∥).\mathbf 0=\nabla_1Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)=\nabla_1^2Q\,\boldsymbol\delta_{t+1}+\nabla_2\nabla_1Q\,\boldsymbol\delta_t+o\bigl(\|\boldsymbol\delta_{t+1}\|+\|\boldsymbol\delta_t\|\bigr) .
    Q∈C2Q\in C^2, 1, [T8]
  3. ∇12Q(θ^∣θ^)=Eθ^[∇2log⁡f(y,Z;θ^)∣y]=−Ic\nabla_1^2Q(\hat{\boldsymbol\theta}\mid\hat{\boldsymbol\theta})=E_{\hat{\boldsymbol\theta}}[\nabla^2\log f(\y,\allowbreak \Z;\hat{\boldsymbol\theta})\mid\y]=-I_c이다.QQ의 정의, [T6]

  4. 보조정리 2.4로 Q(θ∣θ′)=ℓ(θ)+H(θ∣θ′)Q(\boldsymbol\theta\mid\boldsymbol\theta')=\ell(\boldsymbol\theta)+H(\boldsymbol\theta\mid\boldsymbol\theta')이므로

    ∇1Q(θ∣θ′)=∇ℓ(θ)+∫∇log⁡k(z∣y;θ) k(z∣y;θ′) dz.\nabla_1Q(\boldsymbol\theta\mid\boldsymbol\theta')=\nabla\ell(\boldsymbol\theta)+\int\nabla\log k(\z\mid\y;\boldsymbol\theta)\,k(\z\mid\y;\boldsymbol\theta')\,d\z .
    보조정리 2.4
  5. 4를 θ′\boldsymbol\theta'로 미분하고 θ=θ′=θ^\boldsymbol\theta=\boldsymbol\theta'=\hat{\boldsymbol\theta}로 두면, ∇k=k ∇log⁡k\nabla k=k\,\nabla\log k이므로 ∇2∇1Q=E[∇log⁡k ∇log⁡k′∣y]=Im\nabla_2\nabla_1Q=E[\nabla\log k\,\nabla\log k\T\mid\y]=I_m이다.정리 3.5의 4

  6. 2에 3 5를 넣으면 Icδt+1=Imδt+o(∥δt+1∥+∥δt∥)I_c\boldsymbol\delta_{t+1}=I_m\boldsymbol\delta_t+o(\|\boldsymbol\delta_{t+1}\|+\|\boldsymbol\delta_t\|)이다. IcI_c가 가역이므로 δt+1=O(∥δt∥)\boldsymbol\delta_{t+1}=O(\|\boldsymbol\delta_t\|)이고, 나머지항은 o(∥δt∥)o(\|\boldsymbol\delta_t\|)이다. 곧 δt+1=Mδt+o(∥δt∥)\boldsymbol\delta_{t+1}=M\boldsymbol\delta_t+o(\|\boldsymbol\delta_t\|)이다.Ic≻0I_c\succ0

  7. M=Ic−1(Ic−J)=1−Ic−1JM=I_c^{-1}(I_c-J)=\mathbf 1-I_c^{-1}J이다. MM은 대칭행렬 Ic−1/2ImIc−1/2I_c^{-1/2}I_mI_c^{-1/2}와 닮음이므로 고유값이 실수이고, Im⪰0I_m\succeq0이므로 0 이상이다. 1−M\mathbf 1-M은 Ic−1/2JIc−1/2≻0I_c^{-1/2}JI_c^{-1/2}\succ0과 닮음이므로 고유값이 1보다 작다.정리 3.5, J≻0J\succ0

조건 확인 QQ가 (θ^,θ^)(\hat{\boldsymbol\theta},\allowbreak \hat{\boldsymbol\theta}) 근처에서 두 번 연속미분가능해야 2의 전개가 성립한다. 3과 5에서는 미분과 조건부 기댓값의 순서를 바꾼다 [T6].

정리는 EM의 성격을 한 문장으로 말한다. 숨은 자료가 정보를 많이 가져갈수록 EM은 느리다. Newton은 이차 수렴하지만(9회 연습 4.2), EM은 선형 수렴이고 그 비율이 잃어버린 정보의 비율이다. 대신 EM은 헤세 행렬을 구하지 않고, 걸음마다 가능도가 늘며, 모수의 제약(확률의 합이 1, 분산이 양수)을 M 단계가 저절로 지킨다.

예제 3.7 (유전 연관 자료의 EM) θ0=0.5\theta_0=0.5에서 EM은 0.6082, 0.6243, 0.6265, 0.6268,…0.6082,\allowbreak \ 0.6243,\allowbreak \ 0.6265,\allowbreak \ 0.6268,\allowbreak \dots로 간다. 오차의 비 ∣θt+1−θ^∣∣θt−θ^∣\tfrac{|\theta_{t+1}-\hat\theta|}{|\theta_t-\hat\theta|}는 0.1465, 0.1346, 0.1330, 0.1328, 0.13280.1465,\allowbreak \ 0.1346,\allowbreak \ 0.1330,\allowbreak \ 0.1328,\allowbreak \ 0.1328로 모인다. 정리 3.5로 계산하면 θ^=0.6268\hat\theta=0.6268에서 관측 정보 J=377.5J=377.5, 완전 자료 정보 Ic=435.3I_c=435.3, 잃어버린 정보 Im=57.8I_m=57.8이고, Im/Ic=0.1328I_m/I_c=0.1328이 정확히 그 비다(DLR의 표 1). ImI_m은 Louis 공식으로 Var⁡(x2∣y)/θ^2\Var(x_2\mid\y)/\hat\theta^2이다(연습 3.2). θ^\hat\theta의 표준오차는 1/377.5=0.05151/\sqrt{377.5}=0.0515이다.

연습문제

연습 3.1 (HH는 제자리에서 최대 ★) H(θ∣θ′)≤H(θ′∣θ′)H(\boldsymbol\theta\mid\boldsymbol\theta')\le H(\boldsymbol\theta'\mid\boldsymbol\theta')를 Jensen 부등식으로 직접 보여라.

풀이

H(θ∣θ′)−H(θ′∣θ′)=Eθ′log⁡k(Z;θ)k(Z;θ′)≤log⁡Eθ′k(Z;θ)k(Z;θ′)=log⁡∫k(z;θ) dz≤0H(\boldsymbol\theta\mid\boldsymbol\theta')-H(\boldsymbol\theta'\mid\boldsymbol\theta')=E_{\boldsymbol\theta'}\log\tfrac{k(\Z;\boldsymbol\theta)}{k(\Z;\boldsymbol\theta')}\le\log E_{\boldsymbol\theta'}\tfrac{k(\Z;\boldsymbol\theta)}{k(\Z;\boldsymbol\theta')}=\log\int k(\z;\boldsymbol\theta)\,d\z\le0 (Jensen, log⁡\log는 오목).

연습 3.2 (유전 연관의 수렴 속도 ★★) 유전 연관 자료에서 EM 사상 θ↦125θ/(2+θ)+34125θ/(2+θ)+72\theta\mapsto\tfrac{125\theta/(2+\theta)+34}{125\theta/(2+\theta)+72}의 θ^\hat\theta에서의 미분계수가 Im/Ic=0.1328I_m/I_c=0.1328임을 확인하라. Louis 공식 Im=Var⁡(x2∣y)/θ2I_m=\Var(x_2\mid\y)/\theta^2도 확인하라.

풀이

EM 사상 T(θ)=u(θ)+34u(θ)+72T(\theta)=\tfrac{u(\theta)+34}{u(\theta)+72}, u=125θ2+θu=\tfrac{125\theta}{2+\theta}에서 T′=38u′(u+72)2T'=\tfrac{38u'}{(u+72)^2}, u′=250(2+θ)2u'=\tfrac{250}{(2+\theta)^2}. θ^=0.6268\hat\theta=0.6268에서 u=29.83u=29.83, u′=36.23u'=36.23이므로 T′=38⋅36.23101.832=0.1328T'=\tfrac{38\cdot36.23}{101.83^2}=0.1328. Louis: q=θ^/(2+θ^)=0.2386q=\hat\theta/(2+\hat\theta)=0.2386, Var⁡(x2∣y)=125q(1−q)=22.71\Var(x_2\mid\y)=125q(1-q)=22.71, Im=22.71/0.62682=57.8I_m=22.71/0.6268^2=57.8. Ic=u+34θ^2+38(1−θ^)2=162.4+272.9=435.3I_c=\tfrac{u+34}{\hat\theta^2}+\tfrac{38}{(1-\hat\theta)^2}=162.4+272.9=435.3이고 57.8/435.3=0.132857.8/435.3=0.1328.

연습 3.3 (중도절단의 EM ★★★) 연습 2.3에서 EM 반복이 θt+1=1n(∑yi+(n−r)θt)\theta_{t+1}=\tfrac1n\bigl(\sum y_i+(n-r)\theta_t\bigr)임을 보여라. 고정점이 MLE ∑yi/r\sum y_i/r이고, 수렴 비율이 절단된 비율 (n−r)/n(n-r)/n임을 보여라. 이것이 Im/IcI_m/I_c와 같음을 확인하라.

풀이

E 단계: E[Ti∣Ti>c]=c+θtE[T_i\mid T_i>c]=c+\theta_t이므로 완전 자료 합의 기댓값은 ∑yi+(n−r)θt\sum y_i+(n-r)\theta_t. M 단계는 완전 자료 MLE(합/n/n)이다. 고정점 θ=1n(∑yi+(n−r)θ)\theta=\tfrac1n(\sum y_i+(n-r)\theta)를 풀면 θ=∑yi/r\theta=\sum y_i/r. 사상의 미분이 (n−r)/n(n-r)/n이다. θ^\hat\theta에서 Ic=E[−ℓc′′∣y]=−nθ2+2(∑yi+(n−r)θ)θ3=nθ2I_c=E[-\ell_c''\mid y]=-\tfrac n{\theta^2}+\tfrac{2(\sum y_i+(n-r)\theta)}{\theta^3}=\tfrac n{\theta^2}, J=rθ2J=\tfrac r{\theta^2}이므로 Im/Ic=(n−r)/nI_m/I_c=(n-r)/n.

연습 3.4 (일반화 EM ★) M 단계 대신 Q(θt+1∣θt)≥Q(θt∣θt)Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)\ge Q(\boldsymbol\theta_t\mid\boldsymbol\theta_t)인 아무 θt+1\boldsymbol\theta_{t+1}을 고르면 정리 3.2의 결론이 그대로임을 보여라.

풀이

정리 3.2의 증명에서 M 단계가 쓰인 곳은 첫 괄호가 0 이상이라는 것뿐이다.

연습 3.5 (증거 하한의 증명 ★ 유도형) 명제 3.3를 다음 순서로 증명하라.

  1. (a)

    모든 z\z에서 log⁡f(y,z;θ)=ℓ(θ)+log⁡k(z∣y;θ)\log f(\y,\allowbreak \z;\boldsymbol\theta)=\ell(\boldsymbol\theta)+\log k(\z\mid\y;\boldsymbol\theta)임을 보이고, 양변을 Z∼q\Z\sim q로 평균하라.

  2. (b)

    양변에서 Eqlog⁡q(Z)E_q\log q(\Z)를 빼서 F(q,θ)=ℓ(θ)−D(q ∥ k(⋅∣y;θ))\mathcal F(q,\allowbreak \boldsymbol\theta)=\ell(\boldsymbol\theta)-D\bigl(q\,\|\,k(\cdot\mid\y;\boldsymbol\theta)\bigr)를 얻어라.

  3. (c)

    Gibbs 부등식(2회 정리 8.3)으로 부등식과 등호 조건을 얻어라.

  4. (d)

    (c)에서 θ=θt\boldsymbol\theta=\boldsymbol\theta_t를 고정하고 qq에 대해 F\mathcal F를 최대화하면 답이 무엇인지 적어라. 이것이 E 단계다.

풀이

(a) f(y,z;θ)=g(y;θ) k(z∣y;θ)f(\y,\allowbreak \z;\boldsymbol\theta)=g(\y;\boldsymbol\theta)\,k(\z\mid\y;\boldsymbol\theta)에 로그를 취한다. 평균하면 Eqlog⁡f(y,Z;θ)=ℓ(θ)+Eqlog⁡k(Z∣y;θ)E_q\log f(\y,\allowbreak \Z;\boldsymbol\theta)=\ell(\boldsymbol\theta)+E_q\log k(\Z\mid\y;\boldsymbol\theta)이다. ℓ\ell은 z\z에 의존하지 않으므로 평균해도 그대로다. (b) 양변에서 Eqlog⁡qE_q\log q를 빼면 F(q,θ)=ℓ(θ)+Eqlog⁡k(Z∣y;θ)q(Z)=ℓ(θ)−D(q ∥ k(⋅∣y;θ))\mathcal F(q,\allowbreak \boldsymbol\theta)=\ell(\boldsymbol\theta)+E_q\log\tfrac{k(\Z\mid\y;\boldsymbol\theta)}{q(\Z)}=\ell(\boldsymbol\theta)-D\bigl(q\,\|\,k(\cdot\mid\y;\boldsymbol\theta)\bigr). (c) Gibbs 부등식으로 D≥0D\ge0이고 등호는 q=k(⋅∣y;θ)q=k(\cdot\mid\y;\boldsymbol\theta)일 때뿐이다. 따라서 ℓ≥F\ell\ge\mathcal F이고 등호 조건도 같다. (d) θt\boldsymbol\theta_t를 고정하면 ℓ(θt)\ell(\boldsymbol\theta_t)는 상수이므로 F\mathcal F의 최대화는 D(q∥k(⋅∣y;θt))D(q\|k(\cdot\mid\y;\boldsymbol\theta_t))의 최소화이고, 답은 q=k(⋅∣y;θt)q=k(\cdot\mid\y;\boldsymbol\theta_t)다. 숨은 자료의 조건부분포를 구하는 것이 E 단계다.

연습 3.6 (고정점은 정류점: 증명 ★★ 유도형) 따름정리 3.4를 다음 순서로 증명하라.

  1. (a)

    θt+1\boldsymbol\theta_{t+1}이 내점이면 M 단계의 1계 조건 ∇1Q(θt+1∣θt)=0\nabla_1Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)=\mathbf 0이 성립하는 이유를 적어라.

  2. (b)

    ∇1Q\nabla_1Q가 두 인수에 대해 연속이고 (θt+1,θt)→(θ∗,θ∗)(\boldsymbol\theta_{t+1},\allowbreak \boldsymbol\theta_t)\to(\boldsymbol\theta^*,\allowbreak \boldsymbol\theta^*)이므로 ∇1Q(θ∗∣θ∗)=0\nabla_1Q(\boldsymbol\theta^*\mid\boldsymbol\theta^*)=\mathbf 0임을 보여라.

  3. (c)

    명제 2.5로 ∇ℓ(θ∗)=0\nabla\ell(\boldsymbol\theta^*)=\mathbf 0을 결론지어라.

  4. (d)

    예제 4.4의 점은 EM의 고정점이면서 정류점이다. 정류점이 최대점일 필요가 없음을 이 예로 설명하라.

풀이

(a) θt+1\boldsymbol\theta_{t+1}은 Q(⋅∣θt)Q(\cdot\mid\boldsymbol\theta_t)의 최대점이고 내점이며 QQ가 미분가능하므로, 최대점에서 기울기는 0\mathbf 0이다. (b) ∇1Q\nabla_1Q가 두 인수에 대해 연속이므로 0=∇1Q(θt+1∣θt)→∇1Q(θ∗∣θ∗)\mathbf 0=\nabla_1Q(\boldsymbol\theta_{t+1}\mid\boldsymbol\theta_t)\to\nabla_1Q(\boldsymbol\theta^*\mid\boldsymbol\theta^*)이다. (c) 명제 2.5의 둘째 등식에서 θ=θ∗\boldsymbol\theta=\boldsymbol\theta^*로 두면 ∇ℓ(θ∗)=∇1Q(θ∗∣θ∗)=0\nabla\ell(\boldsymbol\theta^*)=\nabla_1Q(\boldsymbol\theta^*\mid\boldsymbol\theta^*)=\mathbf 0이다. (d) 예제 4.4에서 모든 성분이 같은 (yˉ,σ^2)(\bar y,\hat\sigma^2)인 점은 EM이 떠나지 않는 고정점이고, 연습 4.2으로 정류점이다. 그러나 두 성분의 평균을 반대 방향으로 조금 벌리면 가능도가 늘어나는 자료가 많으므로(대개 안장점) 최대점이 아니다. 따름정리는 극한이 정류점이라는 것만 말한다.

이 회차에서 읽은 절 0개 · 회차 차례