
테마
16회 · 베이즈의 귀환 · 노트
6 Efron–Morris의 타율
역사 Stein의 정리는 20년 가까이 수학적 호기심으로 남았다. 실제 자료에서 쓰면 어떻게 되는가? Efron과 Morris(1975)는 야구를 골랐다. 1970년 시즌에 타석에 45번 선 메이저리그 타자 18명의 타율로 그 시즌 나머지의 타율을 예측했다. 나머지 시즌의 수백 타석이 “참값” 노릇을 하므로 추정량을 채점할 수 있었다. 1977년 그들은 Scientific American에 “통계학의 Stein 역설”을 써서 이 결과를 일반 독자에게 알렸다. 표 속 이름들은 야구팬에게 낯익다. 그 해 Roberto Clemente는 첫 45타석에서 18안타를 쳤다.
6.1 자료와 James–Stein
선수 의 첫 45타석 타율을 , 그 시즌 나머지의 타율을 라 하자. 이고 정규근사로 , 로 둔다. 18명 모두에 같은 을 쓰는 단순화다.
예제 6.1 (18명의 타율) , (), 이다. 5절의 평균을 향한 James–Stein()의 축소 인자는
이다. 각 선수의 편차를 평균에서 21%만 남기고 79%를 줄인다. 결과는 표와 같다.
| 선수 | JS | 선수 | JS | ||||
|---|---|---|---|---|---|---|---|
| Clemente | .400 | .294 | .346 | Swoboda | .244 | .261 | .230 |
| F. Robinson | .378 | .289 | .298 | Unser | .222 | .256 | .264 |
| Howard | .356 | .285 | .276 | Williams | .222 | .256 | .256 |
| Johnstone | .333 | .280 | .222 | Scott | .222 | .256 | .303 |
| Berry | .311 | .275 | .273 | Petrocelli | .222 | .256 | .264 |
| Spencer | .311 | .275 | .270 | Rodriguez | .222 | .256 | .226 |
| Kessinger | .289 | .270 | .263 | Campaneris | .200 | .252 | .285 |
| Alvarado | .267 | .266 | .210 | Munson | .178 | .247 | .316 |
| Santo | .244 | .261 | .269 | Alvis | .156 | .242 | .200 |
제곱오차의 합 은 가 , James–Stein이 으로 3.5배 작다. 18명 중 16명에서 James–Stein이 더 가깝다. 나빠진 둘은 Swoboda와 Rodriguez로, 평균보다 조금 낮게 출발해 실제로도 낮게 끝난 선수들이다. Clemente의 은 로 깎였고 실제는 이었다. Munson은 에서 로 올려졌고 실제는 이었다.
이항의 분산이 에 달려 있다는 것이 마음에 걸리면 7회의 분산안정화 변환 을 쓸 수 있다. 그러면 이고, Efron과 Morris가 실제로 쓴 것이 이것이다. 이 척도에서 축소 인자는 , 제곱오차의 비는 로 거의 같다.
6.2 계층 Bayes와 Gibbs 표집
경험적 Bayes는 을 추정한 뒤 그것이 참값인 양 썼다. 완전한 Bayes는 와 에도 사전분포를 주어 그 불확실성까지 사후분포에 넣는다.
명제 6.2 (계층 정규모형의 완전 조건부분포) 명의 선수에 대해 라 하면
또 를 적분하면 이다.
증명 결합밀도는 이다. 에 대해서는 정리 1.2(c)(, 사전평균 )이다. 에 대해서는 . 에 대해서는 , 이고, 의 평평한 사전분포를 으로 바꾸면 야코비안 이 붙어 , 곧 모양 의 역감마다. 마지막은 독립 정규의 합(5회).
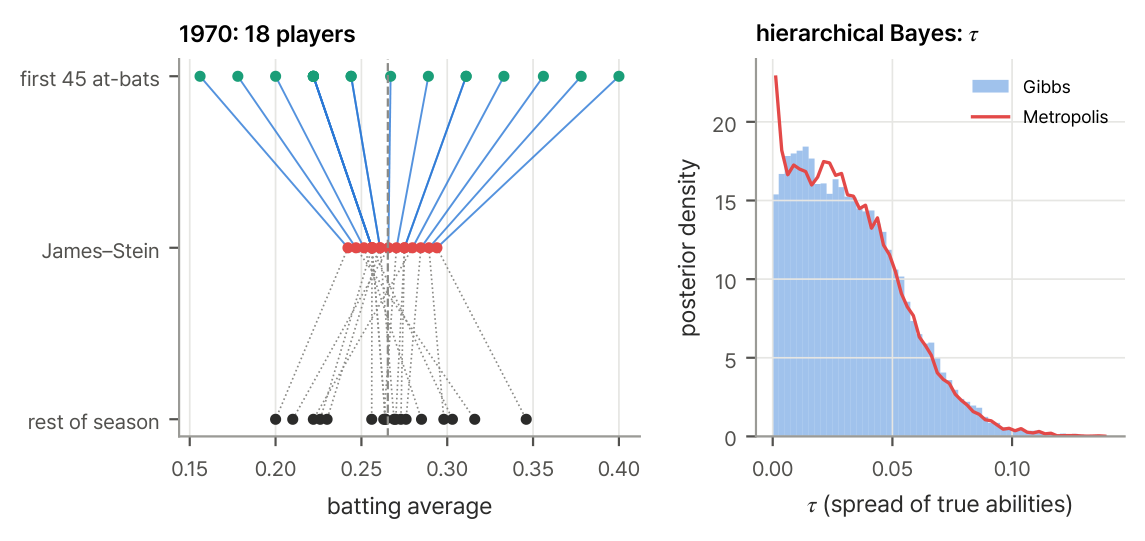
명제의 세 줄을 차례로 뽑으면 Gibbs 표집이다(알고리즘 4.6). 흩어진 출발점에서 연쇄 4개를 각 6000번 돌리고 처음 1000번을 버렸다. 은 와 모두 이다. 의 사후평균은 , 의 사후중앙값은 이다. 선수들의 실제 능력은 표준편차 3푼 정도로만 흩어져 있고, 45타석의 표본 표준편차 이 그 두 배가 넘는다. 관측된 흩어짐의 대부분은 운이다. 그래서 강하게 줄인다.
의 사후평균을 추정값으로 쓰면 제곱오차의 합은 으로 James–Stein과 같고, 두 추정값의 차이는 가장 큰 것도 이다. 같은 사후분포를 다른 알고리즘으로 확인할 수 있다. 명제의 마지막 줄의 주변 가능도로 에 대한 무작위 걸음 Metropolis를 돌리면(야코비안 때문에 로그 사후밀도에 가 더해진다) 받아들임 비율 0.69, 1.000과 1.003, 의 사후평균 0.2659, 의 사후중앙값 0.0286이다. 두 알고리즘은 몬테카를로 오차 안에서 같은 답을 낸다(그림 6.1).
세 추정량의 차이 James–Stein은 공식 하나, 경험적 Bayes는 의 점추정, 계층 Bayes는 의 사후분포 전체를 쓴다. 18명처럼 가 크면 셋은 거의 같다. 가 작거나 이 0 근처이면 차이가 난다. 경험적 Bayes는 으로 모두 평균으로 합쳐 버리지만, 계층 Bayes는 가 0이 아닐 가능성을 남긴다. 이 차이는 사후 신용구간의 폭에서 가장 크게 나타난다.
연습문제
연습 6.1 (Clemente의 손 계산 ★) 예제 6.1의 , , 으로 를 구하고 Clemente와 Munson의 James–Stein 추정값을 계산하라.
풀이
. Clemente: . Munson: .
연습 6.2 (주변 가능도 ★) 명제 6.2의 마지막 줄을 증명하라. 이것을 써서 의 적률추정량 을 구하고 타율 자료에서 계산하라.
풀이
에서 두 괄호는 독립인 , 이므로 . 따라서 이다. 타율 자료에서 , , 이다. 계층 Bayes의 사후중앙값 보다 작다. 사후분포는 가 더 클 가능성까지 반영한다.
연습 6.3 (왜 인가 ★★) 에서 평균을 향한 축소 의 위험을 구하라. (힌트: 직교변환으로 을 차원의 정규벡터로 보고 정리 5.2을 차원에 쓴다. 방향의 위험은 1이다.)
풀이
를 첫 열로 하는 직교행렬 로 라 하면 , 는 의 좌표이고 이다. 추정량은 을 그대로 두고 에 차원의 James–Stein()을 쓴 것이다. 위험은 (, 곧 ).
연습 6.4 ( 사전분포의 실패 ★★) 계층 모형에서 (척도 모수의 Jeffreys)를 쓰면 사후분포가 비정칙임을 보여라. (힌트: 일 때 주변 가능도 는 양의 극한을 갖는다. 는?)
풀이
를 적분한 사후밀도는 이다. 로 적분한 값 는 일 때 양의 유한한 극한 (분산 의 정규 가능도를 로 적분한 것)을 갖는다. 따라서 . 사후분포는 비정칙이다. 평평한 에서는 같은 적분이 이고, 쪽은 로 이면 유한하다.