Skip to content

16회 · 베이즈의 귀환 · 노트

5 Stein의 역설 ​

역사 1955년 Berkeley의 제3회 수리통계 심포지엄에서 Charles Stein은 정규 평균 pp개를 동시에 추정할 때 p≥3p\ge3이면 표본평균이 허용적이지 않다는 것을 보였다. 모든 곳에서 표본평균보다 위험이 작은 추정량이 있다는 것이다. 표본평균은 불편이고, 최대가능도이고, 최소분산이고, minimax였다. 아무도 믿으려 하지 않았다. 6년 뒤 Stein은 대학원생 Willard James와 함께 그런 추정량을 명시적으로 적었다(1961). 같은 1955년 심포지엄에서 Herbert Robbins는 “경험적 Bayes”를 발표했다. 많은 비슷한 문제를 함께 풀면 사전분포를 자료에서 추정할 수 있다는 생각이었다. 두 생각이 같은 것임을 보인 것은 1970년대 Bradley Efron과 Carl Morris였다. Stigler(1990)는 여기에 한 줄을 더했다. James–Stein 추정량은 Galton의 회귀다.

이 절에서 X∼Np(θ,Ip)\X\sim\N_p(\btheta,I_p)이고 손실은 ∥δ−θ∥2=∑i(δi−θi)2\|\delta-\btheta\|^2=\sum_i(\delta_i-\theta_i)^2이다. X\X 자신의 위험은 E∥X−θ∥2=pE\|\X-\btheta\|^2=p로 θ\btheta에 무관하다.

5.1 Stein의 보조정리와 James–Stein 정리 ​

보조정리 5.1 (Stein의 보조정리) Z∼N(θ,1)Z\sim\N(\theta,1)이고 gg가 절대연속이며 E∣g′(Z)∣<∞E|g^\prime(Z)|<\infty이면 E[(Z−θ)g(Z)]=E[g′(Z)]E[(Z-\theta)g(Z)]=E[g^\prime(Z)]이다. 다차원에서 X∼Np(θ,I)\X\sim\N_p(\btheta,I)이고 g:Rp→Rp\mathbf g:\mathbb R^p\to\mathbb R^p가 적당히 매끄러우면 E[(X−θ)′g(X)]=E[∇ ⁣⋅g(X)]E[(\X-\btheta)\T\mathbf g(\X)]=E[\nabla\!\cdot\mathbf g(\X)]이다.

증명 전략 부분적분을 Fubini로 한다. 정규밀도를 φ(z)=∫z∞uφ(u) du\varphi(z)=\int_z^\infty u\varphi(u)\,du로 쓰면 E[g′(Z)]E[g^\prime(Z)]는 이중적분이 되고, 적분 순서를 바꾸면 g′g^\prime의 적분이 gg로 돌아온다.

  1. Z−θ∼N(0,1)Z-\theta\sim\N(0,1)이고 gg 대신 g(⋅+θ)g(\cdot+\theta)를 쓰면 되므로 θ=0\theta=0으로 둔다.평행이동

  2. 표준정규밀도는 φ′(u)=−uφ(u)\varphi^\prime(u)=-u\varphi(u)이므로 z>0z>0에서 φ(z)=∫z∞uφ(u) du\varphi(z)=\int_z^\infty u\varphi(u)\,du, z<0z<0에서 φ(z)=−∫−∞zuφ(u) du\varphi(z)=-\int_{-\infty}^zu\varphi(u)\,du이다.미적분의 기본정리, φ(±∞)=0\varphi(\pm\infty)=0

  3. 양의 쪽에서 적분 순서를 바꾼다.

    ∫0∞g′(z)φ(z) dz=∫0∞g′(z)∫z∞uφ(u) du dz=∫0∞uφ(u)∫0ug′(z) dz du.\int_0^\infty g^\prime(z)\varphi(z)\,dz=\int_0^\infty g^\prime(z)\int_z^\infty u\varphi(u)\,du\,dz=\int_0^\infty u\varphi(u)\int_0^ug^\prime(z)\,dz\,du .
    Fubini [T6]
  4. gg가 절대연속이므로 ∫0ug′(z) dz=g(u)−g(0)\int_0^ug^\prime(z)\,dz=g(u)-g(0)이고, 양의 쪽은 ∫0∞uφ(u)(g(u)−g(0))du\int_0^\infty u\varphi(u)\bigl(g(u)-g(0)\bigr)du이다.절대연속의 정의

  5. 음의 쪽도 같은 계산으로 ∫−∞0g′φ=∫−∞0uφ(u)(g(u)−g(0))du\int_{-\infty}^0g^\prime\varphi=\int_{-\infty}^0u\varphi(u)\bigl(g(u)-g(0)\bigr)du이다.2의 둘째 식

  6. 더하면 E[g′(Z)]=E[Z(g(Z)−g(0))]=E[Zg(Z)]E[g^\prime(Z)]=E[Z(g(Z)-g(0))]=E[Zg(Z)]이다.EZ=0EZ=0

  7. 다차원에서는 좌표 ii마다 나머지 좌표를 고정하고 6을 XiX_i에 쓴 뒤, 나머지 좌표에 대해 기댓값을 취해 ii에 대해 더한다.독립, 3회 정리 2.5

조건 확인 3에서 적분 순서를 바꾸려면 피적분함수의 절댓값을 이중으로 적분한 값이 유한해야 한다. 그 값은 ∫0∞∣g′(z)∣∫z∞uφ(u) du dz=∫0∞∣g′(z)∣φ(z) dz\int_0^\infty|g^\prime(z)|\int_z^\infty u\varphi(u)\,du\,dz=\int_0^\infty|g^\prime(z)|\varphi(z)\,dz이므로 가정 E∣g′(Z)∣<∞E|g^\prime(Z)|<\infty가 바로 그 조건이다 [T6]. 4의 절대연속성이 깨지면 등식이 틀린다(연습 5.2(b)의 sign\mathrm{sign}). 6에서 E∣Zg(Z)∣<∞E|Zg(Z)|<\infty는 3–5의 적분이 유한하다는 것에서 나온다.

정리 5.2 (James–Stein) p≥3p\ge3이면 δJS(X)=(1−p−2∥X∥2)X\delta_{\mathrm{JS}}(\X)=\Bigl(1-\dfrac{p-2}{\|\X\|^2}\Bigr)\X의 위험은

R(θ,δJS)=p−(p−2)2 Eθ[1∥X∥2]<p모든 θ.R(\btheta,\delta_{\mathrm{JS}})=p-(p-2)^2\,E_{\btheta}\Bigl[\frac1{\|\X\|^2}\Bigr]<p\qquad\text{모든 }\btheta .

증명 전략 δJS=X−g(X)\delta_{\mathrm{JS}}=\X-\mathbf g(\X)로 쓰고 손실을 전개한다. 모르는 θ\btheta가 들어 있는 교차항을 Stein의 보조정리로 θ\btheta가 없는 기댓값으로 바꾼다.

  1. g(x)=(p−2)x/∥x∥2\mathbf g(\x)=(p-2)\x/\|\x\|^2로 두면 δJS=X−g(X)\delta_{\mathrm{JS}}=\X-\mathbf g(\X)이다.정의

  2. 손실을 전개한다.

    ∥δJS−θ∥2=∥X−θ∥2−2(X−θ)′g(X)+∥g(X)∥2.\|\delta_{\mathrm{JS}}-\btheta\|^2=\|\X-\btheta\|^2-2(\X-\btheta)\T\mathbf g(\X)+\|\mathbf g(\X)\|^2 .
    ∥u−v∥2\|u-v\|^2의 전개
  3. ∂i(xi/∥x∥2)=(∥x∥2−2xi2)/∥x∥4\partial_i\bigl(x_i/\|\x\|^2\bigr)=(\|\x\|^2-2x_i^2)/\|\x\|^4을 ii에 대해 더하면 ∇ ⁣⋅g(x)=(p−2)2/∥x∥2\nabla\!\cdot\mathbf g(\x)=(p-2)^2/\|\x\|^2이다.몫의 미분

  4. 교차항은 E[(X−θ)′g(X)]=E[∇ ⁣⋅g(X)]=(p−2)2E[1/∥X∥2]E[(\X-\btheta)\T\mathbf g(\X)]=E[\nabla\!\cdot\mathbf g(\X)]=(p-2)^2E[1/\|\X\|^2]이다.보조정리 5.1, 3

  5. 마지막 항은 ∥g(X)∥2=(p−2)2/∥X∥2\|\mathbf g(\X)\|^2=(p-2)^2/\|\X\|^2이다.1

  6. 기댓값을 더하면

    R(θ,δJS)=p−2(p−2)2E[1∥X∥2]+(p−2)2E[1∥X∥2]=p−(p−2)2E[1∥X∥2].R(\btheta,\delta_{\mathrm{JS}})=p-2(p-2)^2E\Bigl[\frac1{\|\X\|^2}\Bigr]+(p-2)^2E\Bigl[\frac1{\|\X\|^2}\Bigr]=p-(p-2)^2E\Bigl[\frac1{\|\X\|^2}\Bigr] .
    E∥X−θ∥2=pE\|\X-\btheta\|^2=p
  7. p≥3p\ge3이면 0<E[1/∥X∥2]<∞0<E[1/\|\X\|^2]<\infty이므로 위험은 pp보다 작다.연습 5.1, 5.3

조건 확인 보조정리 5.1를 쓰려면 g\mathbf g의 각 좌표가 거의 모든 좌표 직선 위에서 절대연속이고 E∣∂igi(X)∣<∞E|\partial_ig_i(\X)|<\infty여야 한다. g\mathbf g는 원점에서만 특이하고 ∣∂igi(x)∣≤3(p−2)/∥x∥2|\partial_ig_i(\x)|\le3(p-2)/\|\x\|^2이다. ∥x∥−2\|\x\|^{-2}을 원점 근처의 pp차원 공에서 적분하면 극좌표로 ∫01r−2rp−1dr=∫01rp−3dr<∞\int_0^1r^{-2}r^{p-1}dr=\int_0^1r^{p-3}dr<\infty이므로 p≥3p\ge3에서 적분가능하다 [T7]. 7의 상계는 ∥X∥2\|\X\|^2이 K∼Poi(∥θ∥2/2)K\sim\mathrm{Poi}(\|\btheta\|^2/2)로 섞인 χp+2K2\chi^2_{p+2K}라는 것에서 E[1/∥X∥2]=E[1/(p−2+2K)]≤1/(p−2)E[1/\|\X\|^2]=E[1/(p-2+2K)]\le1/(p-2)로 나온다.

따름정리 5.3 (Stein (1956)) p≥3p\ge3이면 제곱손실에서 X\X는 허용적이지 않다.

θ=0\btheta=\mathbf0이면 ∥X∥2∼χp2\|\X\|^2\sim\chi^2_p이고 E[1/χp2]=1/(p−2)E[1/\chi^2_p]=1/(p-2)(연습 5.1)이므로 위험은 p−(p−2)=2p-(p-2)=2다. 차원이 1000이어도 위험이 2다. ∥θ∥\|\btheta\|가 커지면 위험은 pp로 다시 올라가지만 넘지 않는다. ∥X∥2\|\X\|^2은 비중심 카이제곱이고 E[1/∥X∥2]E[1/\|\X\|^2]은 Poisson 가중합으로 정확히 계산된다(연습 5.3). p=10p=10에서 ∥θ∥2=0, 10, 100\|\btheta\|^2=0,\ 10,\ 100이면 위험은 2, 6.21, 9.402,\ 6.21,\ 9.40이다(그림 5.1). p=1,2p=1,2에서는 X\X가 허용적이다(Blyth의 방법, 증명은 생략).

어디로 줄이는지는 중요하지 않다. 임의의 점 ν\boldsymbol\nu를 향해 ν+(1−p−2∥X−ν∥2)(X−ν)\boldsymbol\nu+\bigl(1-\frac{p-2}{\|\X-\boldsymbol\nu\|^2}\bigr)(\X-\boldsymbol\nu)로 줄여도 같은 정리가 성립한다. 줄일 곳을 자료의 평균 Xˉ1\bar X\mathbf 1로 고르면 자유도 하나를 써서 p−2p-2가 p−3p-3이 되고,

δEM(X)=Xˉ1+(1−p−3∑i(Xi−Xˉ)2)(X−Xˉ1)\delta_{\mathrm{EM}}(\X)=\bar X\mathbf 1+\Bigl(1-\frac{p-3}{\sum_i(X_i-\bar X)^2}\Bigr)(\X-\bar X\mathbf 1)

는 p≥4p\ge4에서 X\X를 지배한다. 6절의 Efron–Morris 추정량이다. 축소 인자가 음수가 되는 것을 막은 δJS+=max⁡(0,1−p−2∥X∥2)X\delta_{\mathrm{JS}}^+=\max\bigl(0,\allowbreak 1-\frac{p-2}{\|\X\|^2}\bigr)\X는 δJS\delta_{\mathrm{JS}}를 다시 지배한다(연습 5.4).

5.2 경험적 Bayes — 왜 줄이는가 ​

정리 5.4 (James–Stein의 경험적 Bayes 해석) θi∼iidN(0,τ2)\theta_i\iid\N(0,\tau^2), Xi∣θ∼N(θi,1)X_i\mid\btheta\sim\N(\theta_i,\allowbreak 1) (독립)이라 하자.

  1. (a)

    Bayes 추정량은 E(θi∣X)=(1−B)XiE(\theta_i\mid\X)=(1-B)X_i, B=11+τ2B=\dfrac1{1+\tau^2}이고 Bayes 위험은 p(1−B)p(1-B)이다.

  2. (b)

    주변분포에서 Xi∼iidN(0,1+τ2)X_i\iid\N(0,1+\tau^2)이고 E[p−2∥X∥2]=BE\Bigl[\dfrac{p-2}{\|\X\|^2}\Bigr]=B이다. 곧 δJS\delta_{\mathrm{JS}}는 모르는 BB를 불편추정량으로 바꿔 넣은 Bayes 추정량이다.

  3. (c)

    δJS\delta_{\mathrm{JS}}의 Bayes 위험은 p(1−B)+2Bp(1-B)+2B이다. 사전분포를 모르는 값은 τ\tau와 pp에 상관없이 2B≤22B\le2다.

증명 전략 (a)는 켤레 사전분포(정리 1.2(c)), (b)는 독립 정규의 합과 역카이제곱의 평균, (c)는 정리 5.2의 위험을 사전분포로 적분하는 것이다. 단계별 증명은 연습 5.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

Bayes 추정량은 τ2\tau^2을 알아야 한다. 그러나 pp개의 XiX_i가 모두 같은 τ2\tau^2의 정보를 담고 있다. 하나하나는 자기 θi\theta_i를 알려 주지만, 함께 모이면 θi\theta_i들이 얼마나 흩어져 있는지를 알려 준다. 이것이 Robbins의 경험적 Bayes이고, 3회의 전분산 공식 VarXi=EVar(Xi∣θi)+Var θi=1+τ2\mathrm{Var}X_i=E\mathrm{Var}(X_i\mid\theta_i)+\mathrm{Var}\,\theta_i=1+\tau^2에서 τ2\tau^2을 거꾸로 읽는 것이다.

Galton의 회귀로 읽기 (Stigler 1990) (θi,Xi)(\theta_i,X_i)의 산점도를 생각하자. XX를 θ\theta에 회귀하면 기울기는 1이다(XX는 불편). 우리가 원하는 것은 거꾸로 θ\theta를 XX에 회귀한 직선이고, 그 기울기는 Cov(θ,X)/VarX=τ2/(1+τ2)=1−B<1\mathrm{Cov}(\theta,\allowbreak X)/\mathrm{Var}X=\tau^2/(1+\tau^2)=1-B<1이다. Galton이 키에서 본 평균으로의 회귀(5회 따름정리 2.2)다. θi\theta_i를 관측하지 못하므로 이 회귀를 직접 맞출 수는 없지만, 기울기는 VarX\mathrm{Var}X만으로 정해지고 그것은 XiX_i들의 흩어짐으로 추정된다. 표본평균은 “잘못된” 회귀선을 쓴 추정량이다(그림 5.1 오른쪽).
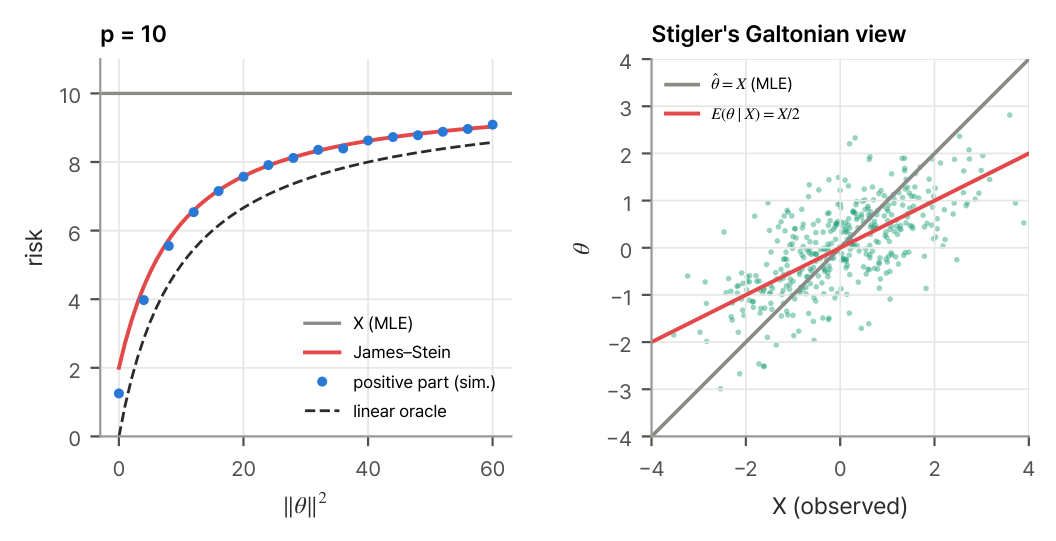
그림 5.1. 왼쪽: p=10에서 |btheta|²에 따른 위험. X(회색, 10), James–Stein(정확한 값), 양의 부분 James–Stein(모의실험), 선형 축소의 이론적 하한 p|btheta|²/(p+|btheta|²)(점선). 오른쪽: θ_i~N(0,1), X_i~N(θ_i,1)의 산점도. X를 θ에 회귀한 직선(기울
그림 5.1 왼쪽: p=10p=10에서 ∥θ∥2\|\btheta\|^2에 따른 위험. X\X(회색, 10), James–Stein(정확한 값), 양의 부분 James–Stein(모의실험), 선형 축소의 이론적 하한 p∥θ∥2/(p+∥θ∥2)p\|\btheta\|^2/(p+\|\btheta\|^2)(점선). 오른쪽: θi∼N(0,1)\theta_i\sim\N(0,1), Xi∼N(θi,1)X_i\sim\N(\theta_i,1)의 산점도. XX를 θ\theta에 회귀한 직선(기울기 1)과 θ\theta를 XX에 회귀한 직선(기울기 12\tfrac12). James–Stein은 뒤의 직선을 자료로 추정한다.
연습문제

연습 5.1 (역카이제곱의 평균 ★) V∼χp2V\sim\chi^2_p이면 E[1/V]=1/(p−2)E[1/V]=1/(p-2) (p≥3p\ge3)임을 감마함수로 보여라. p≤2p\le2이면 왜 무한한가?

풀이

E[1/V]=∫0∞v−1vp/2−1e−v/22p/2Γ(p/2)dv=2p/2−1Γ(p/2−1)2p/2Γ(p/2)=12(p/2−1)=1p−2E[1/V]=\int_0^\infty v^{-1}\frac{v^{p/2-1}e^{-v/2}}{2^{p/2}\Gamma(p/2)}dv=\frac{2^{p/2-1}\Gamma(p/2-1)}{2^{p/2}\Gamma(p/2)}=\frac1{2(p/2-1)}=\frac1{p-2}. 피적분함수는 0 근처에서 vp/2−2v^{p/2-2}이므로 p/2−2≤−1p/2-2\le-1, 곧 p≤2p\le2이면 적분이 발산한다. 1·2차원에서 ∥X∥\|\X\|가 0 근처에 올 확률이 충분히 커서 1/∥X∥21/\|\X\|^2의 평균이 무한하다는 것이 James–Stein이 3차원에서 시작하는 이유다.

연습 5.2 (Stein 보조정리의 쓰임 ★★) (a) g(z)=zg(z)=z와 g(z)=z2g(z)=z^2에 보조정리 5.1를 적용해 N(θ,1)\N(\theta,1)의 둘째·셋째 적률을 구하라. (b) g(z)=sign(z)g(z)=\mathrm{sign}(z)이면 θ=0\theta=0에서 등식이 성립하지 않음을 보여라. 어느 조건이 깨졌는가? James–Stein의 g\mathbf g는 원점에서 미분가능하지 않은데 왜 괜찮은가?

풀이

(a) g(z)=zg(z)=z: E[(Z−θ)Z]=1E[(Z-\theta)Z]=1이므로 EZ2=θ2+1EZ^2=\theta^2+1. g(z)=z2g(z)=z^2: E[(Z−θ)Z2]=2EZ=2θE[(Z-\theta)Z^2]=2EZ=2\theta이므로 EZ3=θEZ2+2θ=θ3+3θEZ^3=\theta EZ^2+2\theta=\theta^3+3\theta. (b) 왼쪽은 E[Z sign(Z)]=E∣Z∣=2/π=0.80E[Z\,\mathrm{sign}(Z)]=E|Z|=\sqrt{2/\pi}=0.80, 오른쪽은 g′=0g^\prime=0 (거의 모든 곳)이므로 0이다. gg가 0에서 뛰어 절대연속이 아니다. 증명의 ∫0ug′=g(u)−g(0)\int_0^ug^\prime=g(u)-g(0)이 깨진다. James–Stein의 g\mathbf g는 원점 한 점에서만 특이하고, 원점을 지나지 않는 거의 모든 좌표 직선 위에서 매끄러우며, 도함수가 ∥x∥−2\|\x\|^{-2} 정도라 p≥3p\ge3에서 적분가능하다. 이 조건에서 다차원 보조정리가 성립한다(Stein 1981).

연습 5.3 (비중심 카이제곱 ★★) ∥X∥2\|\X\|^2(X∼Np(θ,I)\X\sim\N_p(\btheta,I))의 분포는 K∼Poi(∥θ∥2/2)K\sim\mathrm{Poi}(\|\btheta\|^2/2)로 섞은 χp+2K2\chi^2_{p+2K}임을 받아들이고, E[1/∥X∥2]=E[1/(p−2+2K)]E[1/\|\X\|^2]=E\bigl[1/(p-2+2K)\bigr]을 보여라. Jensen 부등식으로 R(θ,δJS)≤p−(p−2)2p+∥θ∥2R(\btheta,\allowbreak \delta_{\mathrm{JS}})\le p-\frac{(p-2)^2}{p+\|\btheta\|^2}임을 보이고, 이것과 선형 축소의 하한 p∥θ∥2p+∥θ∥2\frac{p\|\btheta\|^2}{p+\|\btheta\|^2}의 차이가 4를 넘지 않음을 보여라.

풀이

E[1/∥X∥2]=E[E(1/χp+2K2∣K)]=E[1/(p+2K−2)]E[1/\|\X\|^2]=E\bigl[E(1/\chi^2_{p+2K}\mid K)\bigr]=E[1/(p+2K-2)](연습 5.1). 1/x1/x는 볼록이므로 Jensen으로 E[1/∥X∥2]≥1/E∥X∥2=1/(p+∥θ∥2)E[1/\|\X\|^2]\ge1/E\|\X\|^2=1/(p+\|\btheta\|^2)이고, 위험은 p−(p−2)2p+∥θ∥2p-\frac{(p-2)^2}{p+\|\btheta\|^2} 이하다. t=∥θ∥2t=\|\btheta\|^2이라 하면

p−(p−2)2p+t−ptp+t=p2+pt−(p−2)2−ptp+t=4(p−1)p+t≤4(p−1)p<4.p-\frac{(p-2)^2}{p+t}-\frac{pt}{p+t}=\frac{p^2+pt-(p-2)^2-pt}{p+t}=\frac{4(p-1)}{p+t}\le\frac{4(p-1)}p<4 .

선형 축소의 하한은 min⁡cE∥cX−θ∥2=min⁡c{c2p+(1−c)2t}\min_cE\|c\X-\btheta\|^2=\min_c\{c^2p+(1-c)^2t\}이다. James–Stein은 θ\btheta를 모르고도 이 하한에서 4 이내에 있다.

연습 5.4 (양의 부분 ★★) δJS+\delta_{\mathrm{JS}}^+가 δJS\delta_{\mathrm{JS}}를 지배함을 보여라. (힌트: ∥X∥2<p−2\|\X\|^2<p-2인 사건에서 δJS=−cX\delta_{\mathrm{JS}}=-c\X (c>0c>0)이고 δJS+=0\delta^+_{\mathrm{JS}}=\mathbf 0이다. 이 사건에서 ∥−cX−θ∥2−∥θ∥2=c2∥X∥2+2cX′θ\|{-c\X}-\btheta\|^2-\|\btheta\|^2=c^2\|\X\|^2+2c\X\T\btheta이고, X′θ\X\T\btheta의 조건부 기댓값의 부호를 따진다.)

풀이

두 추정량은 A={∥X∥2<p−2}A=\{\|\X\|^2<p-2\} 밖에서 같다. AA에서 c=p−2∥X∥2−1>0c=\frac{p-2}{\|\X\|^2}-1>0이고 손실의 차이는 ∥−cX−θ∥2−∥θ∥2=c2∥X∥2+2cX′θ\|{-c\X}-\btheta\|^2-\|\btheta\|^2=c^2\|\X\|^2+2c\X\T\btheta이다. 첫 항은 양수다. ∥X∥=r\|\X\|=r이 주어지면 X\X는 반지름 rr의 구 위에서 ex′θe^{\x\T\btheta}에 비례하는 밀도를 가지므로, x\x와 그것을 θ\btheta에 수직인 평면에 대칭시킨 점을 짝지으면 x′θ>0\x\T\btheta>0인 쪽의 밀도가 더 크다. 따라서 E[X′θ∣∥X∥]≥0E[\X\T\btheta\mid\|\X\|]\ge0이고, AA는 ∥X∥\|\X\|로만 정해지므로 E[(c2∥X∥2+2cX′θ)1A]>0E[(c^2\|\X\|^2+2c\X\T\btheta)\mathbf 1_A]>0이다.

연습 5.5 (분산을 모를 때 ★★) Xi∣θi∼N(θi,σ2)X_i\mid\theta_i\sim\N(\theta_i,\allowbreak \sigma^2)이고 σ2\sigma^2을 모르지만 σ2\sigma^2의 추정량 S2S^2이 있어 νS2/σ2∼χν2\nu S^2/\sigma^2\sim\chi^2_\nu이고 X\X와 독립이라 하자. (1−(p−2)νν+2⋅S2∥X∥2)X\bigl(1-\frac{(p-2)\nu}{\nu+2}\cdot\frac{S^2}{\|\X\|^2}\bigr)\X의 위험이 pσ2p\sigma^2보다 작음을 보여라. (힌트: E[S2]E[S^2], E[S4]E[S^4]을 쓴다.)

풀이

X∼Np(θ,σ2I)\X\sim\N_p(\btheta,\sigma^2I)에서 보조정리는 E[(X−θ)′g]=σ2E[∇ ⁣⋅g]E[(\X-\btheta)\T\mathbf g]=\sigma^2E[\nabla\!\cdot\mathbf g]이다. δ=X−aS2X/∥X∥2\delta=\X-aS^2\X/\|\X\|^2의 위험은 S2S^2과 X\X의 독립성으로

pσ2−2aσ2E[S2](p−2)E∥X∥−2+a2E[S4]E∥X∥−2=pσ2−σ4E∥X∥−2[2a(p−2)−a2ν+2ν]p\sigma^2-2a\sigma^2E[S^2](p-2)E\|\X\|^{-2}+a^2E[S^4]E\|\X\|^{-2}=p\sigma^2-\sigma^4E\|\X\|^{-2}\Bigl[2a(p-2)-a^2\frac{\nu+2}\nu\Bigr]

이다(ES2=σ2ES^2=\sigma^2, ES4=σ4(ν+2)/νES^4=\sigma^4(\nu+2)/\nu). 괄호는 a=(p−2)νν+2a=\frac{(p-2)\nu}{\nu+2}에서 최대 (p−2)2νν+2>0\frac{(p-2)^2\nu}{\nu+2}>0이다. ν→∞\nu\to\infty이면 σ2\sigma^2을 아는 경우로 돌아간다.

연습 5.6 (경험적 Bayes 해석: 증명 ★★ 유도형) 정리 5.4를 다음 순서로 증명하라.

  1. (a)

    정리 1.2(c)에 n=1n=1, σ2=1\sigma^2=1, 사전평균 0을 넣어 θi\theta_i의 사후평균과 사후분산을 구하고, 정리 2.1(a)로 Bayes 위험이 p(1−B)p(1-B)임을 보여라. 좌표들이 독립이라는 것은 어디에 쓰이는가?

  2. (b)

    Xi=θi+ϵiX_i=\theta_i+\epsilon_i의 주변분포가 N(0,1+τ2)\N(0,1+\tau^2)임을 보이고, ∥X∥2=(1+τ2)V\|\X\|^2=(1+\tau^2)V, V∼χp2V\sim\chi^2_p에서 E[p−2∥X∥2]=BE\bigl[\frac{p-2}{\|\X\|^2}\bigr]=B를 얻어라(연습 5.1).

  3. (c)

    정리 5.2의 위험을 θ\btheta의 사전분포로 적분하면 E[1/∥X∥2]E[1/\|\X\|^2]이 주변분포의 기댓값이 됨을 설명하고(3회 정리 2.5), Bayes 위험 p(1−B)+2Bp(1-B)+2B를 얻어라.

풀이

(a) 정리 1.2(c)에 n=1n=1, σ2=1\sigma^2=1, m=0m=0을 넣으면 정밀도는 1+1/τ21+1/\tau^2이고 사후평균은 Xi1+1/τ2=τ21+τ2Xi=(1−B)Xi\frac{X_i}{1+1/\tau^2}=\frac{\tau^2}{1+\tau^2}X_i=(1-B)X_i, 사후분산은 τ21+τ2=1−B\frac{\tau^2}{1+\tau^2}=1-B이다. θi\theta_i들과 XiX_i들이 좌표마다 독립이라 θi\theta_i의 사후분포는 XiX_i만으로 정해진다. 정리 2.1(a)로 각 좌표의 최소 사후 기대손실은 사후분산이고, 합의 기댓값이 Bayes 위험 p(1−B)p(1-B)이다. (b) Xi=θi+ϵiX_i=\theta_i+\epsilon_i에서 θi∼N(0,τ2)\theta_i\sim\N(0,\tau^2)와 ϵi∼N(0,1)\epsilon_i\sim\N(0,1)이 독립이므로 Xi∼N(0,1+τ2)X_i\sim\N(0,1+\tau^2)이고 서로 독립이다. ∥X∥2=(1+τ2)V\|\X\|^2=(1+\tau^2)V, V=∑iXi2/(1+τ2)∼χp2V=\sum_iX_i^2/(1+\tau^2)\sim\chi^2_p이므로 E[p−2∥X∥2]=p−21+τ2E[1/V]=11+τ2=BE\bigl[\frac{p-2}{\|\X\|^2}\bigr]=\frac{p-2}{1+\tau^2}E[1/V]=\frac1{1+\tau^2}=B이다(연습 5.1). (c) Bayes 위험은 EπR(θ,δJS)=p−(p−2)2Eπ[Eθ(1/∥X∥2)]E_\pi R(\btheta,\allowbreak \delta_{\mathrm{JS}})=p-(p-2)^2E_\pi\bigl[E_{\btheta}(1/\|\X\|^2)\bigr]이고, 반복기댓값으로 안쪽은 X\X의 주변분포에 대한 기댓값 E[1/∥X∥2]=Bp−2E[1/\|\X\|^2]=\frac{B}{p-2}이다. 따라서 p−(p−2)B=p(1−B)+2Bp-(p-2)B=p(1-B)+2B이다.

이 회차에서 읽은 절 0개 · 회차 차례