
테마
16회 · 베이즈의 귀환 · 노트
7 베이즈가 실패할 때
역사 Gibbs 표집이 퍼지자 새로운 종류의 오류가 나타났다. Hobert와 Casella(1996)는 계층 선형모형에서 널리 쓰이던 비정칙 사전분포가 비정칙 사후분포를 낳는데도, 모든 완전 조건부분포는 정칙이어서 Gibbs 표집이 아무 경고 없이 돌아간다는 것을 보였다. 출력은 그럴듯한 숫자였지만 그 숫자가 근사하는 분포는 존재하지 않았다. Gelman(2006)은 분산 모수의 사전분포가 집단이 적을 때 결론을 좌우한다는 것을 보였다. Stein의 축소도 오해를 낳았다. Efron과 Morris는 처음부터 James–Stein이 합계의 위험을 줄일 뿐 개별 선수를 보호하지는 않는다고 경고했다.
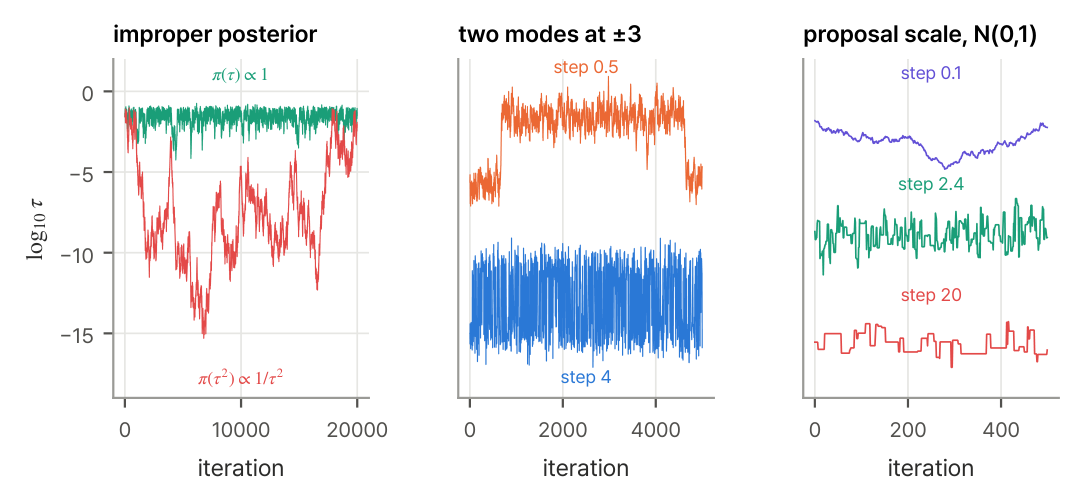
가정 주의 주의 1 — 사후분포가 존재하는가비정칙 사전분포를 쓰면 사후분포가 정칙인지 따로 증명해야 한다. 연습 2.4의 Haldane 사전분포는 성공이 하나도 없으면 비정칙 사후분포를 준다. 계층 모형에서 을 쓰면 의 완전 조건부분포는 역감마로 정칙이지만 결합 사후분포는 비정칙이다(연습 6.4과 같은 논리). 타율 자료에서 이 Gibbs 표집을 2만 번 돌리면 연쇄는 멈추지 않고 돈다. 그러나 의 중앙값은 이고, 85%의 시간을 에서 보내며, 한때 까지 내려간다. 정칙 사전분포 로 같은 일을 하면 중앙값은 다(그림 7.1 왼쪽). 연쇄가 0 근처의 무한한 질량에 빨려 들어가는 것이다.
7.1 봉우리가 여럿일 때
가정 주의 주의 2 — 은 갇힌 연쇄를 보지 못한다목표가 이고 걸음 폭이 0.5인 무작위 걸음 Metropolis를 생각하자. 에서 두 연쇄는 , 두 연쇄는 에서 출발해 5000번 돌리면 로 수렴하지 않았음을 알린다. 걸음 폭을 4로 넓히면 이고 평균은 로 참값 0에 가깝다. 그러나 에서 네 연쇄를 모두 에서 출발시키면 인데 평균은 다. 연쇄들은 왼쪽 봉우리에 갇혀 서로 완벽하게 일치한다. 같은 에서 출발점을 흩어 놓으면 다. 이 쓸모 있으려면 출발점이 목표분포보다 넓게 흩어져 있어야 한다.
봉우리가 여럿인 사후분포는 드물지 않다. 10회의 혼합모형은 성분의 이름표를 바꿔도 가능도가 같아 개의 봉우리를 갖는다. 신경망의 가중치도 그렇다. 봉우리 사이를 건너는 방법으로 온도를 바꿔 가며 여러 연쇄를 돌리는 병렬 담금질(parallel tempering)과, 다음 절의 기울기 정보를 쓰는 방법들이 있다.
7.2 제안 폭과 유효 표본 크기
무작위 걸음 Metropolis의 걸음 폭은 받아들임 비율과 걸음의 크기를 맞바꾼다. 을 목표로 2만 번 돌리면 결과는 이렇다.
| 걸음 폭 | 0.1 | 2.4 | 20 |
|---|---|---|---|
| 받아들임 비율 | 0.97 | 0.44 | 0.07 |
| 유효 표본 크기 | 45 | 5011 | 941 |
걸음이 너무 작으면 거의 다 받아들이지만 제자리걸음이고, 너무 크면 거의 다 거절해 같은 값을 반복한다. 받아들임 비율 97%는 좋은 소식이 아니다.
증명 없이 쓰는 사실 (최적 척도 (Roberts–Gelman–Gilks 1997)) 독립 성분의 차원 목표에서 정규 제안 의 효율은 일 때 에서 최대이고, 그때 받아들임 비율은 다. 1차원에서는 약 가 최적이다. 차원이 커지면 걸음 폭을 로 줄여야 하므로 독립 표본 하나를 얻는 데 번의 걸음이 든다. 기울기를 쓰는 방법(Langevin, Hamiltonian)은 이 의존성을 줄인다(8절).
7.3 계산 코드의 점검
사후분포를 계산하는 코드가 맞는지는 8회 8절의 생각으로 점검할 수 있다(Talts 외 2018). 사전분포에서 를 뽑고, 그것으로 자료를 만들고, 코드로 사후표본 개를 뽑는다. 코드가 맞으면 의 결합분포에서 와 사후표본들은 가 주어졌을 때 같은 분포에서 나온 개의 교환가능한 값이므로, 사후표본들 사이에서 의 순위는 위의 균등분포를 따른다. 사전분포 , , 로 5000번 되풀이해 순위를 열 칸에 나누었다.
올바른 코드 : 카이제곱 적합도 검정의 유의확률 0.15. 균등하다.
자료를 두 번 센 코드 : 양 끝 칸이 839와 883(기댓값 500)인 U자이고 유의확률은 이다. 사후분포가 너무 좁으면 참값이 사후표본의 바깥으로 자주 떨어진다.
사전분포를 로 잘못 넣은 코드: 유의확률 0.56. 이 정도의 사전분포 오류는 5000번으로도 잡지 못한다.
점검은 계산의 오류를 잡지만, 작은 모형의 오류까지 잡는 것은 아니다.
7.4 축소가 개인을 해칠 때
가정 주의 주의 3 — 합계의 위험과 개별 위험James–Stein 정리는 을 줄인다. 개별 성분의 위험은 오히려 커질 수 있다. 이고 이면, James–Stein의 합계 위험은 18.1로 의 50보다 훨씬 작다. 그러나 첫 성분의 위험은 11.2로, 의 위험 1의 열 배가 넘는다. 나머지 49개가 0이라 이 작고, 그래서 튀는 하나까지 0 쪽으로 세게 끌어당기기 때문이다. 타율 표의 Clemente가 이런 선수다. 그가 정말로 다른 선수들과 다르다면, 평균으로 끌어당기는 것은 그에게 불리하다. Efron과 Morris는 한 성분이 움직일 수 있는 양에 상한을 두는 “제한된 이동” 추정량을 제안했다.
축소의 정당성은 성분들이 교환가능하다는 판단, 곧 사전에 어느 선수가 더 잘 칠지 모른다는 판단에서 온다(3절의 de Finetti). Clemente가 이미 내셔널리그 타격왕에 네 번 오른 선수라는 것을 안다면 그 정보를 사전분포에 넣어야 한다. 서로 관계없는 양들(예컨대 타율, 수입차 비율, 강수량)을 한 묶음으로 줄여도 합계 위험은 줄지만, 그 합계는 누구에게도 의미 없는 손실이다.
가정 주의 주의 4 — 사전분포의 민감도표본이 크면 사전분포는 잊힌다(Bernstein–von Mises). 그러나 (1) 점 귀무가설의 Bayes 인수는 대립가설의 사전분포의 폭에 끝까지 의존하고(연습 3.2), (2) 계층 모형에서 집단의 수 가 작으면 의 사후분포는 의 사전분포에 크게 의존한다. 보고서에는 사전분포를 바꿨을 때 결론이 얼마나 움직이는지 함께 적어야 한다.
연습문제
연습 7.1 (비정칙 사후분포 판별 ★★) Haldane 사전분포 에서 를 관측할 때 사후분포가 정칙일 필요충분조건은 임을 보여라. 이때 사후평균은 MLE 과 같음을 보여라.
풀이
사후밀도는 이고, 이 유한할 필요충분조건은 , , 곧 이다. 이때 사후분포는 이고 평균은 이다.
연습 7.2 (성분 하나의 위험 ★★) 이고 이면 James–Stein의 첫 성분 의 위험이 에 가까워짐을 대수의 법칙으로 설명하라. 합계 위험은 에 비해 어떻게 되는가?
풀이
이고 대수의 법칙으로 이다. 축소 인자는 이므로 첫 성분은 0으로 가고 위험은 으로 간다. 합계 위험은 근처에서 많아야 4 위(연습 5.3), 곧 이하로 에 비해 아주 작다. , 에서는 축소 인자가 대략 라 첫 성분의 위험이 11.2에 머문다.
연습 7.3 (받아들임 비율의 함정 ★) 걸음 폭 이면 무작위 걸음 Metropolis의 받아들임 비율은 1로 가지만 연쇄의 시차 1 자기상관도 1로 감을 설명하라. 이면 어떻게 되는가?
풀이
이면 이라 거의 다 받아들이지만 이 작아 시차 1 자기상관이 1로 간다. 이면 제안이 대부분 밀도가 거의 0인 곳에 떨어져 거절되고, 연쇄가 같은 값에 머물러 역시 자기상관이 1로 간다. 두 극단 모두 이다.