Skip to content

16회 · 베이즈의 귀환 · 노트

2 Bayes 추정과 Jeffreys 사전분포 ​

역사 Laplace(1774)는 사후분포에서 값 하나를 고를 때 “오차의 절댓값의 기댓값”을 줄이는 값, 곧 사후중앙값을 골랐다. Gauss(1809)는 평평한 사전분포의 사후 최빈값으로 최소제곱을 정당화했다(5회). Wald(1950)는 이것들을 손실함수의 언어로 묶었다(12회). 남은 문제는 사전분포였다. Bayes와 Laplace의 균등분포는 모수를 어떻게 쓰느냐에 따라 달라진다. pp에 균등이면 p2p^2에는 균등이 아니다. Fisher가 1922년 역확률을 버린 이유 중 하나가 이것이었다. Harold Jeffreys는 1946년 이 반론에 답했다. 사전분포를 Fisher 자신의 정보량으로 만들면 모수를 바꿔 써도 결론이 같다.

2.1 손실함수와 Bayes 추정량 ​

12회 정의 5.1의 언어를 다시 쓴다. 추정량 δ\delta의 위험은 R(θ,δ)=EθL(θ,δ(X))R(\theta,\allowbreak \delta)=E_\theta L(\theta,\allowbreak \delta(\X)), 사전분포 π\pi에 대한 Bayes 위험은 r(π,δ)=∫R(θ,δ)π(θ)dθr(\pi,\allowbreak \delta)=\int R(\theta,\allowbreak \delta)\pi(\theta)d\theta이다. 12회 정리 5.2에 따라 Bayes 추정량은 x\x마다 사후 기대손실을 최소화하는 값이다.

정리 2.1 (Bayes 추정량) 사후분포 π(θ∣x)\pi(\theta\mid\x)에 대해

  1. (a)

    제곱손실 L=(θ−a)2L=(\theta-a)^2의 Bayes 추정량은 사후평균 E(θ∣x)E(\cdat\theta\mid\x)이고, 최소 사후 기대손실은 사후분산이다.

  2. (b)

    절대손실 L=∣θ−a∣L=|\theta-a|의 Bayes 추정량은 사후중앙값이다.

  3. (c)

    가중 제곱손실 L=w(θ)(θ−a)2L=w(\theta)(\theta-a)^2의 Bayes 추정량은 E(w(θ)θ∣x)/E(w(θ)∣x)E(w(\cdat\theta)\cdat\theta\mid\x)/E(w(\cdat\theta)\mid\x)이다.

증명 전략 x\x를 고정하면 사후 기대손실은 aa 하나의 함수다. 그 함수를 펼쳐 최소점을 찾는다. (a)는 제곱을 평균과 편차로 나누고, (b)는 미분하고, (c)는 aa의 이차식으로 쓴다.

(a)

  1. m=E(θ∣x)m=E(\cdat\theta\mid\x)로 두고 θ−a=(θ−m)+(m−a)\cdat\theta-a=(\cdat\theta-m)+(m-a)를 제곱해 사후 기대값을 취한다.

    E[(θ−a)2∣x]=E[(θ−m)2∣x]+2(m−a)E[θ−m∣x]+(m−a)2.E[(\cdat\theta-a)^2\mid\x]=E[(\cdat\theta-m)^2\mid\x]+2(m-a)E[\cdat\theta-m\mid\x]+(m-a)^2 .
    선형성
  2. 가운데 항은 E[θ−m∣x]=0E[\cdat\theta-m\mid\x]=0이라 사라진다. 3회 정리 2.8과 같은 계산이다.mm의 정의

  3. 남은 것은 Var⁡(θ∣x)+(m−a)2\Var(\cdat\theta\mid\x)+(m-a)^2이고, a=ma=m에서 최소이며 최솟값은 사후분산이다.(m−a)2≥0(m-a)^2\ge0

(b)

  1. g(a)=E[∣θ−a∣∣x]=∫−∞a(a−θ)π(θ∣x) dθ+∫a∞(θ−a)π(θ∣x) dθg(a)=E[|\cdat\theta-a|\mid\x]=\int_{-\infty}^a(a-\theta)\pi(\theta\mid\x)\,d\theta+\int_a^\infty(\theta-a)\pi(\theta\mid\x)\,d\theta이다.절댓값을 부호로 나눈다

  2. aa로 미분하면 적분 끝점에서 나오는 항은 (a−a)π(a∣x)=0(a-a)\pi(a\mid\x)=0이라 사라지고

    g′(a)=∫−∞aπ(θ∣x) dθ−∫a∞π(θ∣x) dθ=P(θ<a∣x)−P(θ>a∣x).g^\prime(a)=\int_{-\infty}^a\pi(\theta\mid\x)\,d\theta-\int_a^\infty\pi(\theta\mid\x)\,d\theta=P(\cdat\theta<a\mid\x)-P(\cdat\theta>a\mid\x) .
  3. g′g^\prime은 aa에 대해 증가하고, 사후중앙값 m~\tilde m에서 g′(m~)=12−12=0g^\prime(\tilde m)=\tfrac12-\tfrac12=0이다.분포함수의 단조성

  4. a<m~a<\tilde m이면 g′≤0g^\prime\le0, a>m~a>\tilde m이면 g′≥0g^\prime\ge0이므로 gg는 m~\tilde m에서 최소다.평균값 정리

(c)

  1. h(a)=E[w(θ)(θ−a)2∣x]=E[wθ2∣x]−2aE[wθ∣x]+a2E[w∣x]h(a)=E[w(\cdat\theta)(\cdat\theta-a)^2\mid\x]=E[w\cdat\theta^2\mid\x]-2aE[w\cdat\theta\mid\x]+a^2E[w\mid\x]이다.전개, 선형성

  2. E[w∣x]>0E[w\mid\x]>0이면 hh는 위로 볼록한 이차식이고, 꼭짓점 a=E[wθ∣x]/E[w∣x]a=E[w\cdat\theta\mid\x]/E[w\mid\x]에서 최소다.h′(a)=0h^\prime(a)=0

조건 확인 (a)는 E(θ2∣x)<∞E(\cdat\theta^2\mid\x)<\infty, (b)는 E(∣θ∣∣x)<∞E(|\cdat\theta|\mid\x)<\infty, (c)는 E(wθ2∣x)<∞E(w\cdat\theta^2\mid\x)<\infty를 쓴다. 그렇지 않으면 사후 기대손실이 모든 aa에서 무한하다. (b)의 미분은 적분 구간의 끝이 aa에 달린 경우의 미분이다. 사후밀도가 있으면 미적분의 기본정리로 끝점의 항을, 피적분함수 a−θa-\theta의 aa-미분 1로 나머지를 얻는다 [T6]. 사후분포에 밀도가 없어도 gg는 볼록이고 같은 결론이 오른쪽·왼쪽 미분으로 나온다.

0–1 손실 L=1{∣θ−a∣>ϵ}L=\mathbf 1\{|\theta-a|>\epsilon\}에서 ϵ→0\epsilon\to0이면 Bayes 추정량은 사후 최빈값(MAP)으로 간다. 평평한 사전분포의 MAP는 MLE다. 손실함수가 바뀌면 같은 사후분포에서 다른 점추정량이 나온다는 것이 핵심이다. 사후분포가 대칭이면 셋은 같다.

예제 2.2 (이항의 Bayes 추정량) Beta(a,b)\mathrm{Beta}(a,b) 사전분포에서 사후평균 δa,b=S+an+a+b\delta_{a,b}=\tfrac{S+a}{n+a+b}의 위험은 편향과 분산으로 나누어

R(p,δa,b)=np(1−p)+(a−(a+b)p)2(n+a+b)2R(p,\delta_{a,b})=\frac{np(1-p)+\bigl(a-(a+b)p\bigr)^2}{(n+a+b)^2}

이다. a=b=n/2a=b=\sqrt n/2로 고르면 분자의 p2p^2항과 pp항이 지워져 R=n4(n+n)2R=\tfrac{n}{4(n+\sqrt n)^2}, pp에 무관한 상수가 된다. n=20n=20이면 이 위험은 0.008350.00835이고, MLE S/nS/n의 위험 p(1−p)/20p(1-p)/20의 최댓값 0.01250.0125보다 작다. 대신 p<0.212p<0.212나 p>0.788p>0.788에서는 MLE가 낫다.

정리 2.3 (Bayes 추정량의 두 성질) 

  1. (a)

    (허용성) 유한한 Bayes 위험을 갖는 Bayes 추정량이 유일하면, 그것은 허용적이다. 곧 모든 θ\theta에서 위험이 같거나 작고 어떤 θ\theta에서 더 작은 추정량은 없다.

  2. (b)

    (minimax) Bayes 추정량의 위험이 θ\theta에 무관한 상수이면 그것은 minimax다.

증명 전략 (a)는 귀류법이다 [T2]. 지배하는 추정량이 있으면 그것도 Bayes 추정량이 되어 유일성과 부딪친다. (b)는 “최댓값은 평균보다 작지 않다”를 한 번 쓴다.

(a)

  1. δ′\delta^\prime이 δπ\delta_\pi를 지배한다고 하자. 모든 θ\theta에서 R(θ,δ′)≤R(θ,δπ)R(\theta,\allowbreak \delta^\prime)\le R(\theta,\allowbreak \delta_\pi)이고 어떤 θ0\theta_0에서 부등호가 엄격하다.귀류 가정 [T2]

  2. 양변을 π\pi로 적분하면 r(π,δ′)≤r(π,δπ)r(\pi,\allowbreak \delta^\prime)\le r(\pi,\allowbreak \delta_\pi)이다.적분의 단조성

  3. δπ\delta_\pi는 Bayes 위험을 최소로 하므로 r(π,δ′)=r(π,δπ)r(\pi,\allowbreak \delta^\prime)=r(\pi,\allowbreak \delta_\pi), 곧 δ′\delta^\prime도 Bayes 추정량이다.12회 정리 5.2

  4. 유일성으로 δ′=δπ\delta^\prime=\delta_\pi이고, 두 위험은 모든 θ\theta에서 같다. 1의 θ0\theta_0과 모순이다.가정: 유일

(b)

  1. 임의의 δ\delta에 대해 sup⁡θR(θ,δ)≥∫R(θ,δ)π(θ) dθ=r(π,δ)\sup_\theta R(\theta,\allowbreak \delta)\ge\int R(\theta,\allowbreak \delta)\pi(\theta)\,d\theta=r(\pi,\allowbreak \delta)이다.평균은 최댓값을 넘지 않는다

  2. r(π,δ)≥r(π,δπ)r(\pi,\allowbreak \delta)\ge r(\pi,\allowbreak \delta_\pi)이다.δπ\delta_\pi는 Bayes

  3. R(θ,δπ)≡cR(\theta,\delta_\pi)\equiv c이므로 r(π,δπ)=c=sup⁡θR(θ,δπ)r(\pi,\allowbreak \delta_\pi)=c=\sup_\theta R(\theta,\allowbreak \delta_\pi)이다. 따라서 sup⁡θR(θ,δ)≥sup⁡θR(θ,δπ)\sup_\theta R(\theta,\allowbreak \delta)\ge\sup_\theta R(\theta,\allowbreak \delta_\pi)이다.위험이 상수

조건 확인 (a)의 3에서 r(π,δπ)<∞r(\pi,\delta_\pi)<\infty를 쓴다. Bayes 위험이 무한하면 모든 추정량의 Bayes 위험이 ∞\infty라 2와 3이 아무것도 말하지 않는다. 유일성 대신 다음 조건을 써도 된다. 모든 추정량의 위험이 θ\theta에 연속이고 π\pi가 모든 열린구간에 양의 확률을 주면, 1의 엄격한 부등호가 θ0\theta_0의 한 근방에서 성립하므로 2의 부등호가 엄격해지고, δπ\delta_\pi가 Bayes라는 것과 모순이다.

따라서 예제 2.2의 δn/2,n/2\delta_{\sqrt n/2,\sqrt n/2}는 minimax다. 허용성은 이 회차의 중심 개념이다. 허용적이지 않은 추정량은 다른 추정량에 “모든 곳에서 진다”. 5절은 표본평균이 세 차원 이상에서 바로 그런 추정량임을 보인다.

명제 2.4 (불편추정량은 Bayes가 아니다) 제곱손실에서 δ(X)\delta(\X)가 불편이면서(E(δ∣θ)=θE(\delta\mid\cdat\theta)=\cdat\theta) Bayes 추정량이고(δ=E(θ∣X)\delta=E(\cdat\theta\mid\X)) 둘째 적률이 유한하면, Bayes 위험은 E(δ−θ)2=0E(\delta-\cdat\theta)^2=0이다.

증명 전략 (θ,X)(\cdat\theta,\X)의 결합분포에서 E(δθ)E(\delta\cdat\theta)를 두 가지 조건화로 계산한다(3회 정리 2.5). 한 번은 불편성, 한 번은 Bayes 추정량의 정의를 쓴다. 단계별 증명은 연습 2.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

11회의 UMVUE는 사실상 어떤 정칙 사전분포의 Bayes 추정량도 아니다. 예컨대 Xˉ\bar X는 정규 사전분포 N(m,τ2)\N(m,\tau^2)의 사후평균(정리 1.2(c))의 τ→∞\tau\to\infty 극한일 뿐이다. 이런 극한을 일반화 Bayes 추정량이라 한다. 극한은 허용성을 물려받지 않을 수 있다.

2.2 Jeffreys 사전분포 ​

균등 사전분포는 모수화에 달려 있다. p∼U(0,1)p\sim\mathrm U(0,1)이면 로그오즈 ψ=log⁡p1−p\psi=\log\frac p{1-p}의 밀도는 eψ/(1+eψ)2e^\psi/(1+e^\psi)^2(로지스틱)이고 균등이 아니다. 어느 모수화에서 “모름”을 균등으로 나타내야 하는가? Jeffreys의 답은 모수화를 고르지 않는 규칙이었다.

정의 2.5 (Jeffreys 사전분포) 한 관측의 Fisher 정보 I(θ)I(\theta)(9회 정의 2.1)에 대해 πJ(θ)∝I(θ)\pi_J(\theta)\propto\sqrt{I(\theta)}를 Jeffreys 사전분포라 한다. 다차원이면 πJ(θ)∝det⁡I(θ)\pi_J(\boldsymbol\theta)\propto\sqrt{\det I(\boldsymbol\theta)}이다.

정리 2.6 (Jeffreys 사전분포의 불변성) ϕ=h(θ)\phi=h(\theta)가 미분가능한 단조함수이면, θ\theta에서 Jeffreys 사전분포를 만들어 ϕ\phi로 변수변환한 밀도는 ϕ\phi에서 직접 만든 Jeffreys 사전분포와 같다.

증명 전략 두 밀도를 각각 계산해 같은 식이 나옴을 보인다. 하나는 Fisher 정보가 모수를 바꿀 때 어떻게 변하는지에서, 다른 하나는 밀도의 변수변환 공식에서 나온다.

  1. θ=h−1(ϕ)\theta=h^{-1}(\phi)로 쓰면 연쇄법칙으로 ∂∂ϕlog⁡f(x∣ϕ)=∂∂θlog⁡f(x∣θ)⋅dθdϕ\dfrac{\partial}{\partial\phi}\log f(x\mid\phi)=\dfrac{\partial}{\partial\theta}\log f(x\mid\theta)\cdot\dfrac{d\theta}{d\phi}이다.연쇄법칙

  2. 제곱해 기댓값을 취하면 dθdϕ\dfrac{d\theta}{d\phi}는 관측에 무관한 상수이므로

    Iϕ(ϕ)=E[(∂∂θlog⁡f)2](dθdϕ)2=Iθ(θ)(dθdϕ)2.I_\phi(\phi)=E\Bigl[\Bigl(\frac{\partial}{\partial\theta}\log f\Bigr)^2\Bigr]\Bigl(\frac{d\theta}{d\phi}\Bigr)^2=I_\theta(\theta)\Bigl(\frac{d\theta}{d\phi}\Bigr)^2 .
  3. 제곱근을 취하면 Iϕ(ϕ)=Iθ(θ) ∣dθdϕ∣\sqrt{I_\phi(\phi)}=\sqrt{I_\theta(\theta)}\,\Bigl|\dfrac{d\theta}{d\phi}\Bigr|이다.u2=∣u∣\sqrt{u^2}=|u|

  4. 밀도 πJ(θ)∝Iθ(θ)\pi_J(\theta)\propto\sqrt{I_\theta(\theta)}를 단조변환 ϕ=h(θ)\phi=h(\theta)로 옮긴 밀도는 πJ(h−1(ϕ)) ∣dθ/dϕ∣\pi_J(h^{-1}(\phi))\,|d\theta/d\phi|이고, 이것이 3의 오른쪽이다.2회 정리 4.3 [T7]

조건 확인 hh는 미분가능하고 도함수가 0이 아니어야 한다(그래야 dθ/dϕd\theta/d\phi가 존재한다). 2는 9회의 정칙 조건 아래에서 IθI_\theta가 유한할 때의 식이다. Jeffreys 사전분포가 비정칙이면 두 밀도는 상수배를 빼고 같다는 뜻이다. 변수변환 공식은 상수배와 함께 성립하므로 결론이 그대로다.

예제 2.7 (Jeffreys 사전분포의 예) 

  1. (a)

    베르누이: I(p)=1p(1−p)I(p)=\frac1{p(1-p)}이므로 πJ(p)∝p−1/2(1−p)−1/2\pi_J(p)\propto p^{-1/2}(1-p)^{-1/2}, 곧 Beta(12,12)\mathrm{Beta}(\tfrac12,\allowbreak \tfrac12)(arcsine 분포). ϕ=arcsin⁡p\phi=\arcsin\sqrt p로 쓰면 IϕI_\phi가 상수이므로, Jeffreys 사전분포는 7회의 분산안정화 척도 위의 균등분포다.

  2. (b)

    Poisson: I(λ)=1/λI(\lambda)=1/\lambda이므로 πJ∝λ−1/2\pi_J\propto\lambda^{-1/2}. 비정칙이지만 사후분포 Γ(∑xi+12, 율 n)\Gamma(\sum x_i+\tfrac12,\allowbreak \ \text{율 }n)은 ∑xi=0\sum x_i=0이어도 정칙이다.

  3. (c)

    정규 위치 N(μ,1)\N(\mu,1): II가 상수이므로 평평한 사전분포. 정규 척도 N(0,σ2)\N(0,\sigma^2): I(σ)=2/σ2I(\sigma)=2/\sigma^2이므로 πJ∝1/σ\pi_J\propto1/\sigma, 곧 log⁡σ\log\sigma에 평평하다.

Jeffreys 사전분포의 신용구간은 빈도주의의 기준으로도 좋다. b(20,p)\mathrm b(20,p)에서 Beta(s+12, 20−s+12)\mathrm{Beta}(s+\tfrac12,\allowbreak \ 20-s+\tfrac12)의 2.5%·97.5% 분위수를 Jeffreys 구간이라 하자. p∈[0.05,0.95]p\in[0.05,0.95]의 91개 점에서 정확한 포함확률을 계산하면 평균 0.9480.948, 최솟값 0.8960.896이다. 8회의 Wald 구간 p^±1.96p^(1−p^)/n\hat p\pm1.96\sqrt{\hat p(1-\hat p)/n}은 평균 0.8950.895, 최솟값 0.6390.639다(그림 2.1). 끝 근처에서 Wald 구간은 p^=0\hat p=0일 때 길이가 0이 되어 실패한다. 사전분포의 12\tfrac12이 그 구멍을 막는다.

증명 없이 쓰는 사실 (다차원의 어려움과 기준 사전분포) 다차원에서 det⁡I\sqrt{\det I}는 문제를 일으킨다. N(μ,σ2)\N(\mu,\sigma^2)에서 det⁡I∝1/σ2\sqrt{\det I}\propto1/\sigma^2를 쓰면 σ2\sigma^2의 사후분포의 자유도가 n−1n-1이 아니라 nn이 된다. Jeffreys 자신도 위치와 척도를 따로 다뤄 1/σ1/\sigma를 권했다. Bernardo(1979)의 기준 사전분포는 관심 모수와 장애 모수를 나누어 이 문제를 체계적으로 푼다.
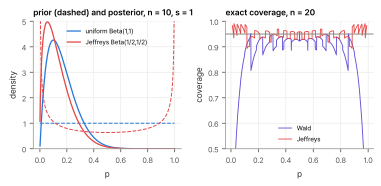
그림 2.1. 왼쪽: 같은 자료에 균등(Beta(1,1))과 Jeffreys(Beta(tfrac12,tfrac12)) 사전분포를 쓴 사후분포. 오른쪽: n=20에서 Jeffreys 구간과 Wald 구간의 정확한 포함확률. 회색 선은 0.95다. Wald 구간은 p가 끝에 가까울수록 무너진다.
그림 2.1 왼쪽: 같은 자료에 균등(Beta(1,1)\mathrm{Beta}(1,1))과 Jeffreys(Beta(12,12)\mathrm{Beta}(\tfrac12,\allowbreak \tfrac12)) 사전분포를 쓴 사후분포. 오른쪽: n=20n=20에서 Jeffreys 구간과 Wald 구간의 정확한 포함확률. 회색 선은 0.95다. Wald 구간은 pp가 끝에 가까울수록 무너진다.
연습문제

연습 2.1 (minimax 추정량 ★) 예제 2.2의 위험 공식을 유도하고, a=b=n/2a=b=\sqrt n/2에서 위험이 상수임을 확인하라. n=20n=20에서 MLE가 minimax 추정량보다 나은 pp의 범위를 구하라.

풀이

δa,b−p=S−npn+a+b+a−(a+b)pn+a+b\delta_{a,b}-p=\frac{S-np}{n+a+b}+\frac{a-(a+b)p}{n+a+b}이고 첫 항의 평균은 0, 분산은 np(1−p)(n+a+b)2\frac{np(1-p)}{(n+a+b)^2}이므로 위험 공식이 나온다. a=b=ca=b=c이면 분자는 np−np2+c2(1−2p)2=c2+(n−4c2)p−(n−4c2)p2np-np^2+c^2(1-2p)^2=c^2+(n-4c^2)p-(n-4c^2)p^2이고 c=n/2c=\sqrt n/2에서 pp항이 사라져 n/4n/4가 남는다. MLE가 나은 곳은 p(1−p)20<0.00835\frac{p(1-p)}{20}<0.00835, 곧 p(1−p)<0.167p(1-p)<0.167이므로 p<0.212p<0.212 또는 p>0.788p>0.788이다.

연습 2.2 (Xˉ\bar X는 Bayes가 아니다 ★) X1,…,Xn∣μ∼iidN(μ,1)X_1,\allowbreak \dots,\allowbreak X_n\mid\mu\iid\N(\mu,\allowbreak 1), μ∼N(0,τ2)\cdat\mu\sim\N(0,\tau^2)에서 명제 2.4를 써서 Xˉ\bar X가 Bayes 추정량이 아님을 보여라. 사후평균의 Bayes 위험을 구하고 τ→∞\tau\to\infty일 때의 극한을 말하라.

풀이

Xˉ\bar X는 불편이고, EXˉ2<∞E\bar X^2<\infty이다. Bayes 추정량이라면 Bayes 위험이 0이어야 하지만 Xˉ\bar X의 위험은 1/n>01/n>0이다. 사후평균은 nXˉn+1/τ2\frac{n\bar X}{n+1/\tau^2}이고 Bayes 위험은 사후분산 1n+1/τ2=τ2nτ2+1\frac1{n+1/\tau^2}=\frac{\tau^2}{n\tau^2+1}이다. τ→∞\tau\to\infty이면 1/n1/n으로, Xˉ\bar X의 위험으로 간다. Xˉ\bar X는 Bayes 추정량들의 극한(일반화 Bayes)이다.

연습 2.3 (정규 척도와 카이제곱 ★★) X1,…,Xn∣σ2∼iidN(0,σ2)X_1,\allowbreak \dots,\allowbreak X_n\mid\sigma^2\iid\N(0,\allowbreak \sigma^2), π(σ)∝1/σ\pi(\sigma)\propto1/\sigma이면 ∑Xi2/σ2∣x∼χn2\sum X_i^2/\sigma^2\mid\x\sim\chi^2_n임을 보여라. 따라서 95% 신용구간은 6회 연습 2.5의 카이제곱 신뢰구간(평균을 알아 자유도가 nn인 판)과 같다.

풀이

π(σ)∝1/σ\pi(\sigma)\propto1/\sigma를 σ2\sigma^2으로 바꾸면 π(σ2)∝1/σ2\pi(\sigma^2)\propto1/\sigma^2이다. T=∑Xi2T=\sum X_i^2이라 하면 사후밀도는 (σ2)−1(σ2)−n/2e−T/(2σ2)(\sigma^2)^{-1}(\sigma^2)^{-n/2}e^{-T/(2\sigma^2)}이고, U=T/σ2U=T/\sigma^2으로 바꾸면(dσ2∝U−2dUd\sigma^2\propto U^{-2}dU) Un/2−1e−U/2U^{n/2-1}e^{-U/2}, 곧 χn2\chi^2_n이다. 따라서 P(χn,0.9752≤T/σ2≤χn,0.0252)=0.95P\bigl(\chi^2_{n,0.975}\le T/\sigma^2\le\chi^2_{n,0.025}\bigr)=0.95를 σ2\sigma^2에 대해 풀면 6회의 구간과 같은 식이 된다. 사후확률의 문장과 신뢰구간의 문장이 숫자까지 일치하는 예다.

연습 2.4 (로그오즈의 균등 ★★) 로그오즈 ψ\psi에 평평한(비정칙) 사전분포를 주면 pp의 사전분포는 ∝p−1(1−p)−1\propto p^{-1}(1-p)^{-1}(Haldane)이다. 이것을 보이고, s=0s=0일 때 사후분포가 비정칙임을 보여라.

풀이

ψ=log⁡p1−p\psi=\log\frac p{1-p}이면 dψdp=1p(1−p)\frac{d\psi}{dp}=\frac1{p(1-p)}이므로 ψ\psi의 평평한 밀도는 pp에서 1p(1−p)\frac1{p(1-p)}이다. s=0s=0이면 사후밀도는 p−1(1−p)n−1p^{-1}(1-p)^{n-1}이고 ∫0ϵp−1dp=∞\int_0^\epsilon p^{-1}dp=\infty이므로 정규화할 수 없다.

연습 2.5 (절대손실의 Laplace ★) 파리의 사후분포 Beta(251528,241946)\mathrm{Beta}(251528,241946)에서 사후평균과 사후중앙값의 차이는 10−610^{-6}보다 작다. 그 이유를 사후분포의 치우침으로 설명하라.

풀이

베타분포의 평균과 중앙값의 차이는 대략 왜도 ×\times 표준편차/6/6이다. 왜도가 −1.1×10⁻⁴-1.1\times10^{-4}, 표준편차가 7.1×10−47.1\times10^{-4}이므로 차이는 약 1.3×10−81.3\times10^{-8}이다. 노트북의 정확한 값도 −1.31×10⁻⁸-1.31\times10^{-8}이다. 사후분포가 거의 대칭이므로 제곱손실과 절대손실이 같은 답을 낸다.

연습 2.6 (불편추정량은 Bayes가 아니다: 증명 ★★ 유도형) 명제 2.4를 다음 순서로 증명하라. (θ,X)(\cdat\theta,\X)의 결합분포에서 기댓값을 잡는다.

  1. (a)

    θ\cdat\theta로 조건화하고 불편성 E(δ∣θ)=θE(\delta\mid\cdat\theta)=\cdat\theta를 써서 E(δθ)=Eθ2E(\delta\cdat\theta)=E\cdat\theta^2을 보여라.

  2. (b)

    X\X로 조건화하고 δ=E(θ∣X)\delta=E(\cdat\theta\mid\X)를 써서 E(δθ)=Eδ2E(\delta\cdat\theta)=E\delta^2을 보여라.

  3. (c)

    (a)와 (b)로 E(δ−θ)2=0E(\delta-\cdat\theta)^2=0을 얻어라. 둘째 적률이 유한하다는 가정은 어디에 쓰이는가?

  4. (d)

    결론을 대우로 바꿔 말하라. Bayes 위험이 양수인 모형에서는 어느 추정량도 불편이면서 Bayes일 수 없다.

풀이

(a) E(δθ)=E[θE(δ∣θ)]=E[θ⋅θ]=Eθ2E(\delta\cdat\theta)=E\bigl[\cdat\theta E(\delta\mid\cdat\theta)\bigr]=E[\cdat\theta\cdot\cdat\theta]=E\cdat\theta^2. 첫 등호는 반복기댓값(3회 정리 2.5)이고 θ\cdat\theta는 θ\cdat\theta가 주어지면 상수라 밖으로 나온다. (b) E(δθ)=E[δE(θ∣X)]=E[δ⋅δ]=Eδ2E(\delta\cdat\theta)=E\bigl[\delta E(\cdat\theta\mid\X)\bigr]=E[\delta\cdot\delta]=E\delta^2. δ\delta는 X\X의 함수이므로 X\X가 주어지면 상수다. (c) E(δ−θ)2=Eδ2−2E(δθ)+Eθ2=Eδ2−2Eδ2+Eδ2E(\delta-\cdat\theta)^2=E\delta^2-2E(\delta\cdat\theta)+E\cdat\theta^2=E\delta^2-2E\delta^2+E\delta^2에서 (a)로 Eθ2=E(δθ)=Eδ2E\cdat\theta^2=E(\delta\cdat\theta)=E\delta^2이므로 0이다. 둘째 적률의 유한성은 세 기댓값이 모두 유한해 전개와 반복기댓값을 쓸 수 있게 한다(∣δθ∣≤12(δ2+θ2)|\delta\cdat\theta|\le\frac12(\delta^2+\cdat\theta^2)). (d) Bayes 위험이 0이 아니면, 곧 E(δ−θ)2>0E(\delta-\cdat\theta)^2>0이면, δ\delta는 불편이거나 Bayes이거나 둘 중 하나만일 수 있다. 정규 평균처럼 모든 추정량의 Bayes 위험이 양수인 모형에서는 불편추정량이 Bayes 추정량이 되지 못한다.

이 회차에서 읽은 절 0개 · 회차 차례