Skip to content

12회 · 최적 검정과 결정 · 노트

5 결정이론 — 검정과 분류를 하나로 ​

역사 Wald는 축차검정을 만든 뒤 한 걸음 더 나아갔다. 추정, 검정, 분류는 모두 “자료를 보고 행동을 고르는” 일이고, 행동의 대가를 손실함수로 쓰면 하나의 이론이 된다. 그의 통계적 결정함수(1950)는 게임이론(von Neumann–Morgenstern 1944)의 언어로 통계학을 다시 썼다. Bayes 규칙과 minimax 규칙이 그 이론의 두 기둥이다.

5.1 손실, 위험, Bayes 규칙 ​

정의 5.1 (결정 문제) 행동의 집합 A\mathcal A, 손실함수 L(θ,a)≥0L(\theta,a)\ge0, 결정규칙 δ:x↦a\delta:\x\mapsto a가 주어질 때 δ\delta의 위험은 R(θ,δ)=EθL(θ,δ(X))R(\theta,\allowbreak \delta)=E_\theta L(\theta,\allowbreak \delta(\X))이다. 사전분포 π\pi에 대한 Bayes 위험은 r(π,δ)=∫R(θ,δ) π(dθ)r(\pi,\allowbreak \delta)=\int R(\theta,\allowbreak \delta)\,\pi(d\theta)이고, 이것을 최소화하는 규칙이 Bayes 규칙이다. sup⁡θR(θ,δ)\sup_\theta R(\theta,\delta)를 최소화하는 규칙은 minimax 규칙이다.

추정에서는 A=Ω\mathcal A=\Omega이고 L(θ,a)=(θ−a)2L(\theta,a)=(\theta-a)^2이면 위험이 평균제곱오차다(9회, 11회). 검정에서는 A={0,1}\mathcal A=\{0,1\}(받아들임, 기각)이고 LL은 두 오류의 비용이다.

정리 5.2 (Bayes 규칙은 사후 기대손실을 줄인다) 사후분포 π(θ∣x)\pi(\theta\mid\x)가 있으면, 각 x\x에서 사후 기대손실 ∫L(θ,a)π(dθ∣x)\int L(\theta,\allowbreak a)\pi(d\theta\mid\x)를 최소화하는 aa를 고르는 규칙은 Bayes 규칙이다.

증명 전략 Bayes 위험의 적분 순서를 바꿔 x\x마다의 사후 기대손실을 주변밀도로 평균한 꼴로 쓴다. 그러면 적분을 최소화하는 일이 x\x마다의 최소화로 나뉜다.

  1. r(π,δ)=∫ ⁣ ⁣∫L(θ,δ(x))f(x;θ) dx π(dθ)r(\pi,\allowbreak \delta)=\int\!\!\int L\bigl(\theta,\allowbreak \delta(\x)\bigr)f(\x;\theta)\,d\x\,\pi(d\theta)이다.정의 5.1

  2. f(x;θ) π(dθ)=π(dθ∣x) m(x)f(\x;\theta)\,\pi(d\theta)=\pi(d\theta\mid\x)\,m(\x) (mm은 x\x의 주변밀도)이므로 적분 순서를 바꾸면

    r(π,δ)=∫[∫L(θ,δ(x)) π(dθ∣x)]m(x) dx.r(\pi,\delta)=\int\Bigl[\int L\bigl(\theta,\delta(\x)\bigr)\,\pi(d\theta\mid\x)\Bigr]m(\x)\,d\x .
    조건 확인, 3회 정리 2.5
  3. 사후 기대손실을 최소화하는 규칙을 δπ\delta_\pi라 하면, 모든 x\x에서 대괄호는 δπ(x)\delta_\pi(\x)일 때 가장 작다.δπ\delta_\pi의 정의

  4. m≥0m\ge0으로 3의 부등식을 적분하면 모든 δ\delta에 대해 r(π,δ)≥r(π,δπ)r(\pi,\allowbreak \delta)\ge r(\pi,\allowbreak \delta_\pi)이다.적분의 단조성

조건 확인 L≥0L\ge0이므로 2의 순서 바꾸기는 적분가능성의 가정 없이 Tonelli로 정당하다 [T6]. 양쪽이 모두 ∞\infty일 수도 있는데, 그때 4는 뜻이 없다. 그래서 Bayes 규칙을 말할 때는 r(π,δ)<∞r(\pi,\delta)<\infty인 규칙이 하나는 있다고 가정한다.

따름정리 5.3 (Bayes 검정은 가능도비 검정이다) H0:f0H_0:f_0 대 H1:f1H_1:f_1, 사전확률 π0,π1\pi_0,\pi_1, 1종 오류의 비용 cIc_{\mathrm I}, 2종 오류의 비용 cIIc_{\mathrm{II}}(맞으면 비용 0)이면 Bayes 규칙은

f1(x)f0(x)>π0cIπ1cII 이면 기각\frac{f_1(\x)}{f_0(\x)}>\frac{\pi_0c_{\mathrm I}}{\pi_1c_{\mathrm{II}}}\ \text{이면 기각}

이다. 곧 Neyman–Pearson 검정이다. 거꾸로 모든 Neyman–Pearson 검정은 어떤 사전확률과 비용에 대한 Bayes 검정이다.

증명 전략 두 행동(기각, 받아들임)의 사후 기대손실을 각각 쓰고 작은 쪽을 고른다(정리 5.2). 공통 인수 m(x)m(\x)를 지우면 가능도비와 임계값의 비교가 남는다. 단계별 증명은 연습 5.5(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

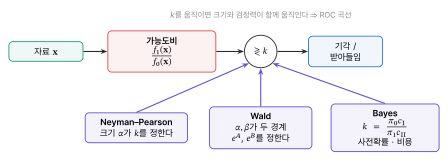
Neyman–Pearson의 α\alpha는 사전확률과 비용을 말하지 않고 임계값 kk를 정하는 방법이었다. 결정이론은 그 kk 뒤에 “두 가설을 얼마나 믿는가 ×\times 두 오류가 얼마나 비싼가”가 숨어 있음을 보여 준다(그림 5.1).

그림 5.1. 이번 회차의 세 이론은 모두 가능도비를 임계값과 비교한다. 다른 것은 임계값을 정하는 방법이다. 크기 α로(Neyman–Pearson), 두 오류율의 목표로(Wald), 사전확률과 비용으로(Bayes) 정한다.
그림 5.1 이번 회차의 세 이론은 모두 가능도비를 임계값과 비교한다. 다른 것은 임계값을 정하는 방법이다. 크기 α\alpha로(Neyman–Pearson), 두 오류율의 목표로(Wald), 사전확률과 비용으로(Bayes) 정한다.

5.2 Bayes 분류와 선형판별분석 ​

정리 5.4 (Bayes 분류기) KK개의 무리가 사전확률 πk\pi_k로 섞여 있고 무리 kk의 밀도가 fkf_k이면, 오분류 확률을 최소화하는 규칙은 x\x를 arg⁡max⁡kπkfk(x)\arg\max_k\pi_kf_k(\x)에 배정하는 것이다.

증명 전략 0–1 손실의 사후 기대손실을 사후확률로 쓰고 정리 5.2을 쓴다. 사후확률은 베이즈 정리로 πkfk(x)\pi_kf_k(\x)에 비례한다. 단계별 증명은 연습 5.6(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

따름정리 5.5 (선형판별분석) fk=Np(μk,Σ)f_k=\N_p(\bmu_k,\Sigma) (공분산이 같음)이면 Bayes 분류기는 판별함수

δk(x)=x′Σ−1μk−12μk′Σ−1μk+log⁡πk\delta_k(\x)=\x\T\Sigma^{-1}\bmu_k-\tfrac12\bmu_k\T\Sigma^{-1}\bmu_k+\log\pi_k

가 가장 큰 kk를 고른다. 두 무리이면 경계는 초평면 w′x=c\mathbf w\T\x=c, w=Σ−1(μ1−μ0)\mathbf w=\Sigma^{-1}(\bmu_1-\bmu_0)이고, π0=π1\pi_0=\pi_1이면 오분류 확률은 Φ(−Δ/2)\Phi(-\Delta/2)이다. Δ2=(μ1−μ0)′Σ−1(μ1−μ0)\Delta^2=(\bmu_1-\bmu_0)\T\Sigma^{-1}(\bmu_1-\bmu_0)은 Mahalanobis 거리의 제곱이다.

증명 전략 로그 점수 log⁡πkfk(x)\log\pi_kf_k(\x)를 전개하면 이차항이 무리에 무관해 빠진다. 오분류 확률은 판별 점수 w′X\mathbf w\T\X가 정규분포라는 것에서 나온다.

  1. log⁡πkfk(x)=log⁡πk−12(x−μk)′Σ−1(x−μk)−12log⁡det⁡(2πΣ)\log\pi_kf_k(\x)=\log\pi_k-\tfrac12(\x-\bmu_k)\T\Sigma^{-1}(\x-\bmu_k)-\tfrac12\log\det(2\pi\Sigma)이다.다변량 정규 밀도, 5회

  2. 전개하면 −12x′Σ−1x+x′Σ−1μk−12μk′Σ−1μk-\tfrac12\x\T\Sigma^{-1}\x+\x\T\Sigma^{-1}\bmu_k-\tfrac12\bmu_k\T\Sigma^{-1}\bmu_k이다. 첫 항과 log⁡det⁡\log\det 항은 kk에 무관하므로 남는 것이 δk(x)\delta_k(\x)이다.Σ−1\Sigma^{-1}은 대칭

  3. Bayes 분류기는 arg⁡max⁡kπkfk(x)=arg⁡max⁡kδk(x)\arg\max_k\pi_kf_k(\x)=\arg\max_k\delta_k(\x)를 고른다.정리 5.4, log⁡\log는 증가함수

  4. 두 무리이면 δ1(x)>δ0(x)\delta_1(\x)>\delta_0(\x)은 w′x>c\mathbf w\T\x>c와 같다. w=Σ−1(μ1−μ0)\mathbf w=\Sigma^{-1}(\bmu_1-\bmu_0), c=12w′(μ0+μ1)+log⁡π0π1c=\tfrac12\mathbf w\T(\bmu_0+\bmu_1)+\log\tfrac{\pi_0}{\pi_1}이다.2의 차, μ1′Σ−1μ1−μ0′Σ−1μ0=w′(μ0+μ1)\bmu_1\T\Sigma^{-1}\bmu_1-\bmu_0\T\Sigma^{-1}\bmu_0=\mathbf w\T(\bmu_0+\bmu_1)

  5. 무리 0의 X\X에 대해 w′X∼N(w′μ0, w′Σw)\mathbf w\T\X\sim\N(\mathbf w\T\bmu_0,\allowbreak \ \mathbf w\T\Sigma\mathbf w)이고 w′Σw=(μ1−μ0)′Σ−1(μ1−μ0)=Δ2\mathbf w\T\Sigma\mathbf w=(\bmu_1-\bmu_0)\T\Sigma^{-1}(\bmu_1-\bmu_0)=\Delta^2이다.5회 정리 A

  6. π0=π1\pi_0=\pi_1이면 c−w′μ0=12w′(μ1−μ0)=12Δ2c-\mathbf w\T\bmu_0=\tfrac12\mathbf w\T(\bmu_1-\bmu_0)=\tfrac12\Delta^2이므로 P0(w′X>c)=1−Φ(Δ/2)=Φ(−Δ/2)P_0(\mathbf w\T\X>c)=1-\Phi(\Delta/2)=\Phi(-\Delta/2)이다. 무리 1에서도 대칭으로 같다.5, 표준화

공분산이 무리마다 다르면 x′Σk−1x\x\T\Sigma_k^{-1}\x 항이 남아 경계가 이차곡면이 된다(이차판별분석, 연습 5.3). Fisher(1936)는 정규분포를 가정하지 않고 같은 방향 w\mathbf w에 이르렀다.

명제 5.6 (Fisher의 판별 기준) (w′(μ1−μ0))2/w′Σw\bigl(\mathbf w\T(\bmu_1-\bmu_0)\bigr)^2/\mathbf w\T\Sigma\mathbf w (무리 사이의 거리 대 무리 안의 흩어짐)를 최대화하는 방향은 w∝Σ−1(μ1−μ0)\mathbf w\propto\Sigma^{-1}(\bmu_1-\bmu_0)이다.

증명 전략 Σ1/2\Sigma^{1/2}로 좌표를 바꿔 분모를 보통의 길이로 만들고 Cauchy–Schwarz 부등식(3회 정리 4.4)을 쓴다 [T4]. 단계별 증명은 연습 5.7(유도형)에서 직접 쓴다. 완성된 증명은 그 연습의 풀이에 있다.

연습문제

연습 5.1 (Bayes 검정의 임계값 ★) 의료 검사에서 질병의 유병률이 1%이고, 놓친 환자(2종 오류)의 비용이 잘못 경보한 건강인(1종 오류)의 50배라면 가능도비 임계값은 얼마인가?

풀이

k=π0cIπ1cII=0.99⋅10.01⋅50=1.98k=\tfrac{\pi_0c_{\mathrm I}}{\pi_1c_{\mathrm{II}}}=\tfrac{0.99\cdot1}{0.01\cdot50}=1.98. 가능도비가 약 2를 넘으면 양성으로 부른다. 유병률이 낮으면 비용이 커도 임계값이 1보다 크다.

연습 5.2 (판별의 오류율 ★★) 따름정리 5.5에서 사전확률이 다르면(π0≠π1\pi_0\ne\pi_1) 경계가 어떻게 움직이는지 쓰고, 오분류 확률을 구하라.

풀이

경계는 w′x=12w′(μ0+μ1)+log⁡π0π1\mathbf w\T\x=\tfrac12\mathbf w\T(\bmu_0+\bmu_1)+\log\tfrac{\pi_0}{\pi_1}로 사전확률이 작은 쪽으로 밀린다. η=log⁡(π0/π1)\eta=\log(\pi_0/\pi_1)이면 오분류 확률은 π0Φ(−Δ2−ηΔ)+π1Φ(−Δ2+ηΔ)\pi_0\Phi\bigl(-\tfrac\Delta2-\tfrac\eta\Delta\bigr)+\pi_1\Phi\bigl(-\tfrac\Delta2+\tfrac\eta\Delta\bigr)이다.

연습 5.3 (이차판별 ★) 1차원에서 f0=N(0,1)f_0=\N(0,1), f1=N(0,4)f_1=\N(0,4), π0=π1\pi_0=\pi_1이면 Bayes 분류기가 ∣x∣>c|x|>c이면 무리 1로 배정함을 보이고 cc를 구하라.

풀이

log⁡f1f0=−log⁡2−x28+x22=3x28−log⁡2>0\log\tfrac{f_1}{f_0}=-\log2-\tfrac{x^2}8+\tfrac{x^2}2=\tfrac{3x^2}8-\log2>0이면 무리 1이므로 ∣x∣>c=83log⁡2=1.36|x|>c=\sqrt{\tfrac83\log2}=1.36.

연습 5.4 (minimax 검정 ★★) H0:N(0,1)H_0:\N(0,1) 대 H1:N(1,1)H_1:\N(1,1)을 관측 하나로 검정할 때 두 오류의 확률의 최댓값을 최소화하는 검정은 x>12x>\tfrac12이면 기각임을 보이고, 이것이 π0=π1\pi_0=\pi_1인 Bayes 검정과 같음을 확인하라.

풀이

x>cx>c에서 기각하면 두 오류는 1−Φ(c)1-\Phi(c)와 Φ(c−1)\Phi(c-1)이다. 앞은 감소, 뒤는 증가하므로 최댓값은 두 값이 같은 c=12c=\tfrac12에서 최소(둘 다 0.309)다. π0=π1\pi_0=\pi_1, 같은 비용의 Bayes 검정은 f1/f0=ex−1/2>1f_1/f_0=e^{x-1/2}>1, 곧 x>12x>\tfrac12로 같다.

연습 5.5 (Bayes 검정은 가능도비 검정이다: 증명 ★ 유도형) 따름정리 5.3를 다음 순서로 증명하라.

  1. (a)

    맞으면 비용이 0이므로, 기각의 사후 기대손실이 cI π(H0∣x)c_{\mathrm I}\,\pi(H_0\mid\x)이고 받아들임의 것이 cII π(H1∣x)c_{\mathrm{II}}\,\pi(H_1\mid\x)임을 보여라.

  2. (b)

    베이즈 정리로 π(Hj∣x)=πjfj(x)/m(x)\pi(H_j\mid\x)=\pi_jf_j(\x)/m(\x)를 넣고, 정리 5.2에 따라 기각이 나은 조건이 f1(x)/f0(x)>π0cI/(π1cII)f_1(\x)/f_0(\x)>\pi_0c_{\mathrm I}/(\pi_1c_{\mathrm{II}})임을 얻어라. 두 손실이 같은 점에서는 어느 행동을 골라도 된다.

  3. (c)

    거꾸로 임계값 k>0k>0이 주어지면 π0cI/(π1cII)=k\pi_0c_{\mathrm I}/(\pi_1c_{\mathrm{II}})=k가 되는 사전확률과 비용이 있음을 보여라.

풀이

(a) 기각(a=1a=1)하면 H0H_0이 참일 때만 비용 cIc_{\mathrm I}가 생기므로 사후 기대손실은 cIπ(H0∣x)c_{\mathrm I}\pi(H_0\mid\x)이다. 받아들이면(a=0a=0) H1H_1이 참일 때만 비용 cIIc_{\mathrm{II}}가 생기므로 cIIπ(H1∣x)c_{\mathrm{II}}\pi(H_1\mid\x)이다. (b) π(Hj∣x)=πjfj(x)/m(x)\pi(H_j\mid\x)=\pi_jf_j(\x)/m(\x), m=π0f0+π1f1m=\pi_0f_0+\pi_1f_1이다. 정리 5.2로 Bayes 규칙은 작은 쪽을 고르므로 cIπ0f0(x)<cIIπ1f1(x)c_{\mathrm I}\pi_0f_0(\x)<c_{\mathrm{II}}\pi_1f_1(\x), 곧 f1(x)/f0(x)>π0cI/(π1cII)f_1(\x)/f_0(\x)>\pi_0c_{\mathrm I}/(\pi_1c_{\mathrm{II}})일 때 기각한다. m(x)>0m(\x)>0인 공통 인수는 비교에 영향이 없다. 두 값이 같으면 어느 쪽을 골라도 사후 기대손실이 같으므로 경계에서는 확률화해도 Bayes 규칙이다. (c) 예를 들어 cI=cII=1c_{\mathrm I}=c_{\mathrm{II}}=1로 두고 π0/π1=k\pi_0/\pi_1=k, 곧 π0=k1+k\pi_0=\tfrac k{1+k}, π1=11+k\pi_1=\tfrac1{1+k}로 고르면 된다. 따라서 임계값 k>0k>0의 Neyman–Pearson 검정은 이 사전확률에 대한 Bayes 검정이다.

연습 5.6 (Bayes 분류기: 증명 ★ 유도형) 정리 5.4를 증명하라.

  1. (a)

    0–1 손실 L(k,a)=1{a≠k}L(k,a)=1\{a\ne k\}에서 행동 aa의 사후 기대손실이 1−P(무리 a∣x)1-P(\text{무리 }a\mid\x)임을 보여라.

  2. (b)

    베이즈 정리로 P(무리 a∣x)=πafa(x)/∑jπjfj(x)P(\text{무리 }a\mid\x)=\pi_af_a(\x)/\sum_j\pi_jf_j(\x)임을 쓰고, 정리 5.2로 결론을 얻어라.

  3. (c)

    Bayes 위험이 오분류 확률과 같음을 확인하라.

풀이

(a) 행동 aa의 손실은 참인 무리가 aa가 아닐 때 1이므로 사후 기대손실은 ∑k≠aP(무리 k∣x)=1−P(무리 a∣x)\sum_{k\ne a}P(\text{무리 }k\mid\x)=1-P(\text{무리 }a\mid\x)이다. (b) 베이즈 정리(1회 정리 5.5)로 P(무리 a∣x)=πafa(x)/∑jπjfj(x)P(\text{무리 }a\mid\x)=\pi_af_a(\x)/\sum_j\pi_jf_j(\x)이고 분모는 aa에 무관하다. 사후 기대손실을 최소화하는 것은 πafa(x)\pi_af_a(\x)를 최대화하는 것이므로, 정리 5.2로 arg⁡max⁡kπkfk(x)\arg\max_k\pi_kf_k(\x)가 Bayes 규칙이다. (c) 0–1 손실의 위험은 R(k,δ)=Pk(δ(X)≠k)R(k,\allowbreak \delta)=P_k(\delta(\X)\ne k)이고, Bayes 위험 ∑kπkR(k,δ)\sum_k\pi_kR(k,\delta)는 무리를 무작위로 뽑고 분류할 때 틀릴 확률이다.

연습 5.7 (Fisher의 판별 기준: 증명 ★★ 유도형) 명제 5.6를 다음 순서로 증명하라. Σ\Sigma는 양의 정치다.

  1. (a)

    Σ=QΛQ′\Sigma=Q\Lambda Q\T (고유분해)로 Σ1/2=QΛ1/2Q′\Sigma^{1/2}=Q\Lambda^{1/2}Q\T를 정의하고, Σ1/2\Sigma^{1/2}이 대칭이며 역행렬 Σ−1/2\Sigma^{-1/2}를 가짐을 보여라.

  2. (b)

    v=Σ1/2w\mathbf v=\Sigma^{1/2}\mathbf w, d=Σ−1/2(μ1−μ0)\mathbf d=\Sigma^{-1/2}(\bmu_1-\bmu_0)로 두면 기준이 (v′d)2/∥v∥2(\mathbf v\T\mathbf d)^2/\|\mathbf v\|^2임을 보여라.

  3. (c)

    Cauchy–Schwarz 부등식으로 기준이 ∥d∥2=Δ2\|\mathbf d\|^2=\Delta^2 이하이고, 등호가 v∝d\mathbf v\propto\mathbf d, 곧 w∝Σ−1(μ1−μ0)\mathbf w\propto\Sigma^{-1}(\bmu_1-\bmu_0)일 때뿐임을 보여라.

풀이

(a) Σ\Sigma가 대칭 양의 정치이므로 Σ=QΛQ′\Sigma=Q\Lambda Q\T (QQ 직교, Λ\Lambda 대각, 대각원소 양수)이다. Σ1/2=QΛ1/2Q′\Sigma^{1/2}=Q\Lambda^{1/2}Q\T는 대칭이고 Σ1/2Σ1/2=QΛQ′=Σ\Sigma^{1/2}\Sigma^{1/2}=Q\Lambda Q\T=\Sigma이며, Σ−1/2=QΛ−1/2Q′\Sigma^{-1/2}=Q\Lambda^{-1/2}Q\T가 역행렬이다. (b) w′(μ1−μ0)=w′Σ1/2Σ−1/2(μ1−μ0)=v′d\mathbf w\T(\bmu_1-\bmu_0)=\mathbf w\T\Sigma^{1/2}\Sigma^{-1/2}(\bmu_1-\bmu_0)=\mathbf v\T\mathbf d이고 w′Σw=w′Σ1/2Σ1/2w=∥v∥2\mathbf w\T\Sigma\mathbf w=\mathbf w\T\Sigma^{1/2}\Sigma^{1/2}\mathbf w=\|\mathbf v\|^2이다. (c) Cauchy–Schwarz로 (v′d)2≤∥v∥2∥d∥2(\mathbf v\T\mathbf d)^2\le\|\mathbf v\|^2\|\mathbf d\|^2이므로 기준은 ∥d∥2=(μ1−μ0)′Σ−1(μ1−μ0)=Δ2\|\mathbf d\|^2=(\bmu_1-\bmu_0)\T\Sigma^{-1}(\bmu_1-\bmu_0)=\Delta^2 이하이다. 등호는 v=td\mathbf v=t\mathbf d일 때뿐이고, 그때 w=Σ−1/2v=tΣ−1(μ1−μ0)\mathbf w=\Sigma^{-1/2}\mathbf v=t\Sigma^{-1}(\bmu_1-\bmu_0)이다. 기준은 w\mathbf w의 길이에 무관하므로 방향만 정해진다.

이 회차에서 읽은 절 0개 · 회차 차례