
테마
12회 · 최적 검정과 결정 · 노트
6 데이터로 — Fisher의 붓꽃 (1936)
역사 식물학자 Edgar Anderson은 붓꽃 세 종(setosa, versicolor, virginica)을 50송이씩 모아(그 가운데 둘은 캐나다 Gaspé 반도에서) 꽃받침과 꽃잎의 길이와 너비를 쟀다(1935). 그는 virginica와 versicolor의 관계를 진화의 관점에서 연구하고 있었다. Fisher(1936)는 이 자료로 “여러 측정값을 하나의 일차결합으로 묶어 종을 가장 잘 가르는 법”을 보였다. 그 일차결합이 명제 5.6의 판별함수다. 같은 해 인도의 Mahalanobis는 무리 사이의 거리 를 정의했다. Fisher의 논문은 Annals of Eugenics(우생학 연보)에 실렸다. 통계학의 많은 도구가 우생학의 맥락에서 태어났다는 사실도 이 자료의 역사의 일부다.
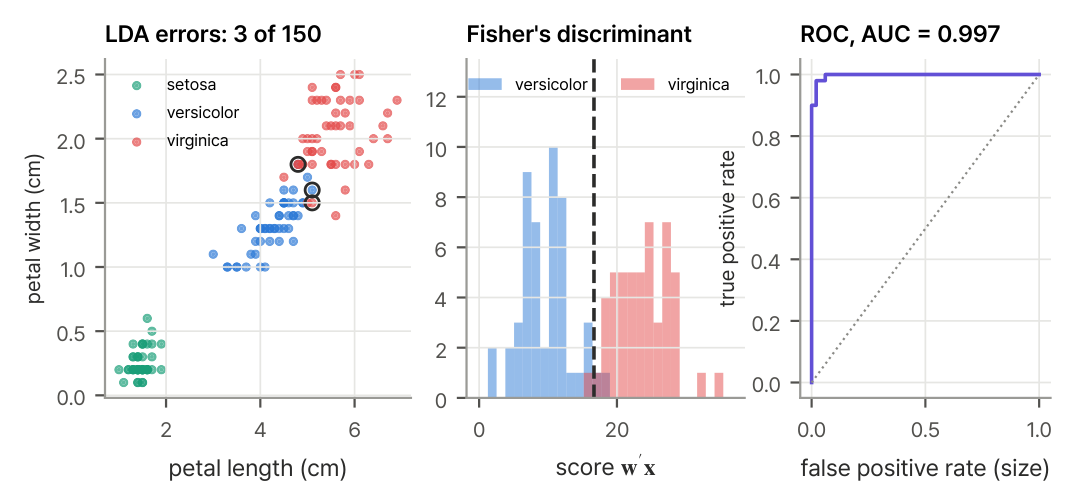
예제 6.1 (세 종의 선형판별분석) 네 측정값(꽃받침 길이·너비, 꽃잎 길이·너비, cm)으로 따름정리 5.5의 판별함수를 만든다. 평균은 종마다 따로, 공분산은 세 종을 합쳐 추정한다(자유도 ). 같은 자료로 분류하면 150송이 가운데 3송이를 틀린다. setosa는 50송이 모두 맞고, versicolor 2송이가 virginica로, virginica 1송이가 versicolor로 간다. 자료를 하나씩 빼고 나머지로 만든 판별함수로 뺀 것을 분류해도(leave-one-out) 3송이를 틀린다. setosa는 다른 두 종에서 Mahalanobis 거리로 9.5와 13.4만큼 떨어져 있어 가르기가 쉽고, versicolor와 virginica 사이는 4.1뿐이다.
예제 6.2 (versicolor 대 virginica) 두 종만으로 명제 5.6의 방향을 구하면
(꽃받침 길이, 꽃받침 너비, 꽃잎 길이, 꽃잎 너비)이다. 꽃잎이 길고 넓을수록, 꽃받침이 짧고 좁을수록 virginica 쪽이다. 두 종의 Mahalanobis 거리는 이므로 정규 모형 아래의 오분류 확률은 이다. 실제로 두 평균의 중점을 경계로 쓰면 100송이 가운데 3송이를 틀린다. 경계를 움직이면 “virginica를 virginica로 맞히는 비율”(검정력)과 “versicolor를 virginica로 잘못 부르는 비율”(크기)이 함께 움직인다. 그 궤적이 ROC 곡선이고(8절), 곡선 아래 넓이는 0.997이다(그림 6.1).
연습문제
연습 6.2 (같은 자료로 재면 ★) 같은 자료로 판별함수를 만들고 같은 자료로 오류율을 재면 왜 낙관적인가? leave-one-out이 그 문제를 어떻게 줄이는가?
풀이
판별함수는 같은 자료의 오류를 줄이도록 맞춰졌으므로, 같은 자료로 잰 오류율은 새 자료에서의 오류율보다 작게 나온다(과적합). leave-one-out은 각 송이를 그것이 빠진 자료로 만든 규칙으로 분류하므로 그 낙관을 거의 없앤다. 붓꽃처럼 모수(평균 12개, 공분산 10개)에 비해 자료가 많으면 차이가 작다.