
테마
12회 · 최적 검정과 결정 · 노트
0 들어가며
여는 질문. -값이 작다는 것은 무엇을 말하고, 무엇을 말하지 않는가? 같은 자료로 검정을 여러 가지 만들 수 있다면, 그 가운데 “가장 좋은” 검정은 무엇이며 어떤 뜻에서 가장 좋은가?
8회에서 -값과 검정의 크기, 검정력을 정의했다. 그때는 검정 통계량을 그때그때 골랐다. 이항 검정은 성공 수로, 검정은 표본평균으로 했다. 왜 그 통계량이어야 하는가? Jerzy Neyman과 Egon Pearson은 1928년부터 이 질문을 붙잡았다. 그들은 검정을 “두 가지 오류의 균형”으로 다시 썼다. 귀무가설이 참인데 기각하는 오류의 확률(크기)을 미리 묶고, 그 안에서 대립가설이 참일 때 기각할 확률(검정력)을 최대로 하자는 것이다. 1933년 그들은 그런 검정이 가능도비로 기각역을 정하는 검정임을 증명했다. 이것이 Neyman–Pearson 보조정리다.
Fisher는 이 관점을 끝까지 거부했다. 그에게 유의성 검정은 한 번의 실험에서 증거의 크기를 재는 귀납 추론이었다. 반복되는 결정의 오류율을 관리하는 귀납 행동이 아니었다. 두 사람의 다툼은 오늘의 -값 논쟁에도 그대로 남아 있다. 이 노트는 Neyman–Pearson의 길을 따라간다. 보조정리에서 출발해 한쪽 가설의 균일최강력 검정(Karlin–Rubin, 2절)과 일반화 가능도비 검정(3절)에 이른다. 2차대전의 군수품 검사에서 태어난 Wald의 축차검정(4절)을 지나 결정이론으로 검정과 분류를 하나로 묶는다(5절). 6절에서는 Fisher(1936)의 붓꽃 자료로 판별분석을 유도한다. 7절은 -값이 말하지 않는 것(효과크기, Lindley의 역설)을 보고, 8절은 같은 수학이 ROC 곡선과 온라인 A/B 테스트에 있음을 본다.
학습 목표
- 1.
Neyman–Pearson 보조정리를 증명하고, 확률화 검정이 왜 필요한지 이산분포에서 계산한다.
- 2.
단조가능도비를 갖는 족에서 Karlin–Rubin 정리로 한쪽 균일최강력 검정을 구하고, 양쪽 가설에는 그런 검정이 없음을 본다.
- 3.
축차확률비 검정을 구현하고 Wald 경계와 평균 표본수를 증명·확인한다.
- 4.
손실·위험·Bayes 규칙으로 검정과 분류를 통일하고, 정규 모형에서 선형판별분석을 유도한다.
- 5.
붓꽃 자료에 판별분석을 쓰고 ROC 곡선을 그리며, 효과크기와 Lindley의 역설로 -값의 한계를 안다.
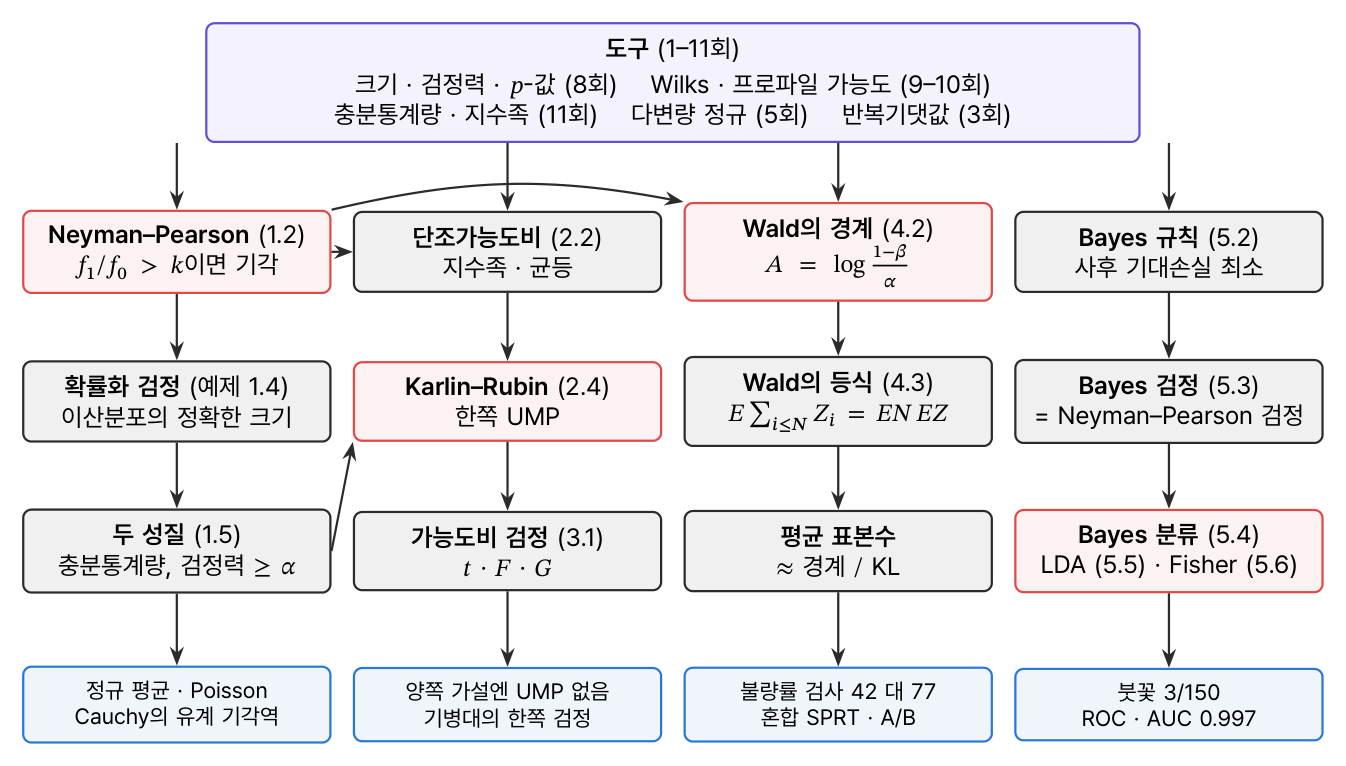
0.1 1–11회에서 가져오는 것
| 앞 회차 | 내용 |
|---|---|
| 5회 정리 A · C | 다변량 정규의 선형변환과 조건부분포 |
| 8회 정의 3.1 · 3.2, 정리 3.5 · 4.2 | 검정, 크기와 검정력, 구간과 검정의 쌍대성, -값의 균등성 |
| 8회 예제 7.1 | 결과를 보며 멈추면 1종 오류가 커진다 |
| 9회 정리 5.2 · 10회 정리 1.8 | Wilks 정리, 귀찮은 모수가 있는 프로파일 가능도비 |
| 11회 정리 1.3 · 4.5 | 인수분해 정리, 지수족의 완비충분통계량 |
0.2 표기
자료 의 밀도는 이다. 검정은 검정함수 로 쓴다. 는 자료가 일 때 을 기각할 확률이다. 보통의 검정은 0 또는 1의 값만 갖고, 경계에서만 0과 1 사이의 값을 갖는 것을 확률화 검정이라 한다. 크기는 , 검정력 함수는 이다(8회 정의 3.2).