
테마
노트북 · 12회 · 최적 검정과 결정
최적 검정과 결정 가장 좋은 기각역을 찾아서
| 강의노트 | 12_optimal_tests_notes.pdf — 같은 절 번호, 같은 정리 번호. 증명은 노트에, 확인은 여기에 |
| 워크북 | 12_optimal_tests_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 10절의 check()로 검산 |
| 원자료 | Anderson–Fisher의 붓꽃 150송이 (datasets iris) · 기병대 (vcd VonBort) · 군수품 검사와 A/B 테스트 (시뮬레이션) |
| 선수 지식 | 1–11회 (8회 검정·크기·검정력·-값, 9회 가능도비·Wilks, 10회 프로파일 가능도, 11회 충분통계량·지수족) |
여는 질문. -값이 작다는 것은 무엇을 말하고, 무엇을 말하지 않는가? 같은 자료로 검정을 여러 가지 만들 수 있다면, 그 가운데 "가장 좋은" 검정은 무엇이며 어떤 뜻에서 가장 좋은가?
이번 회차의 지도
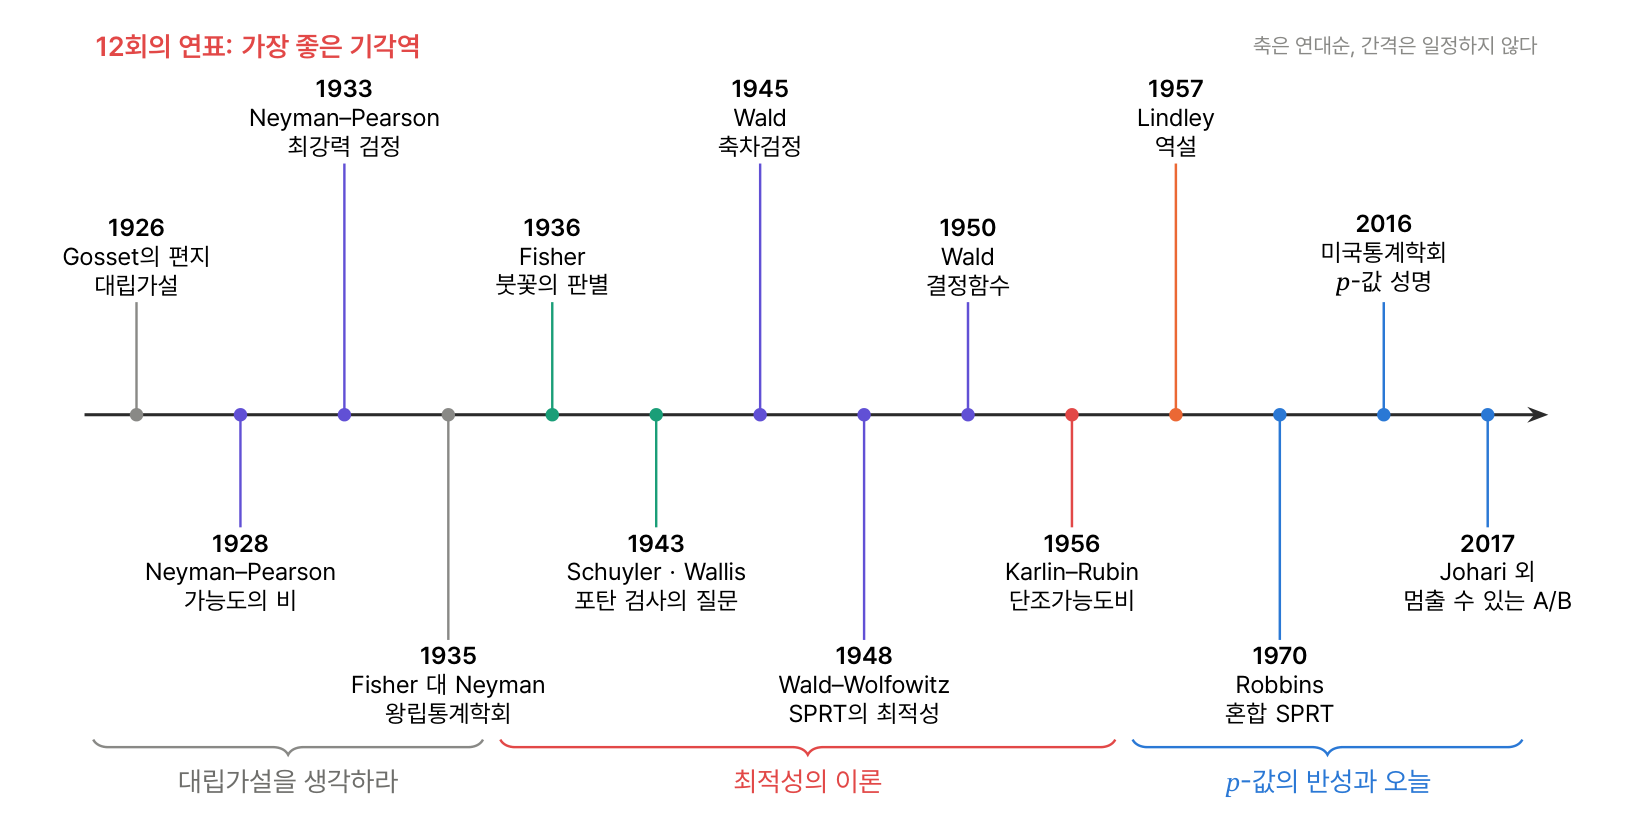
학습 목표
- Neyman–Pearson 검정을 구현하고, 가능한 모든 검정 가운데 최강력임을 선형계획법으로 확인한다. 이산분포의 확률화를 계산한다.
- Karlin–Rubin의 한쪽 UMP 검정과 그 검정력 함수를 만들고, 양쪽 가설에서 UMP가 없음을 숫자로 본다.
SPRT클래스로 Wald의 경계·평균 표본수·Wald의 등식을 시뮬레이션으로 확인한다.- 선형판별분석을 직접 구현해 붓꽃에 쓰고, Fisher의 기준을 수치 최적화로 확인하며 ROC 곡선을 그린다.
- 효과크기, Lindley의 역설, 엿보기와 혼합 SPRT를 코드로 재현한다.
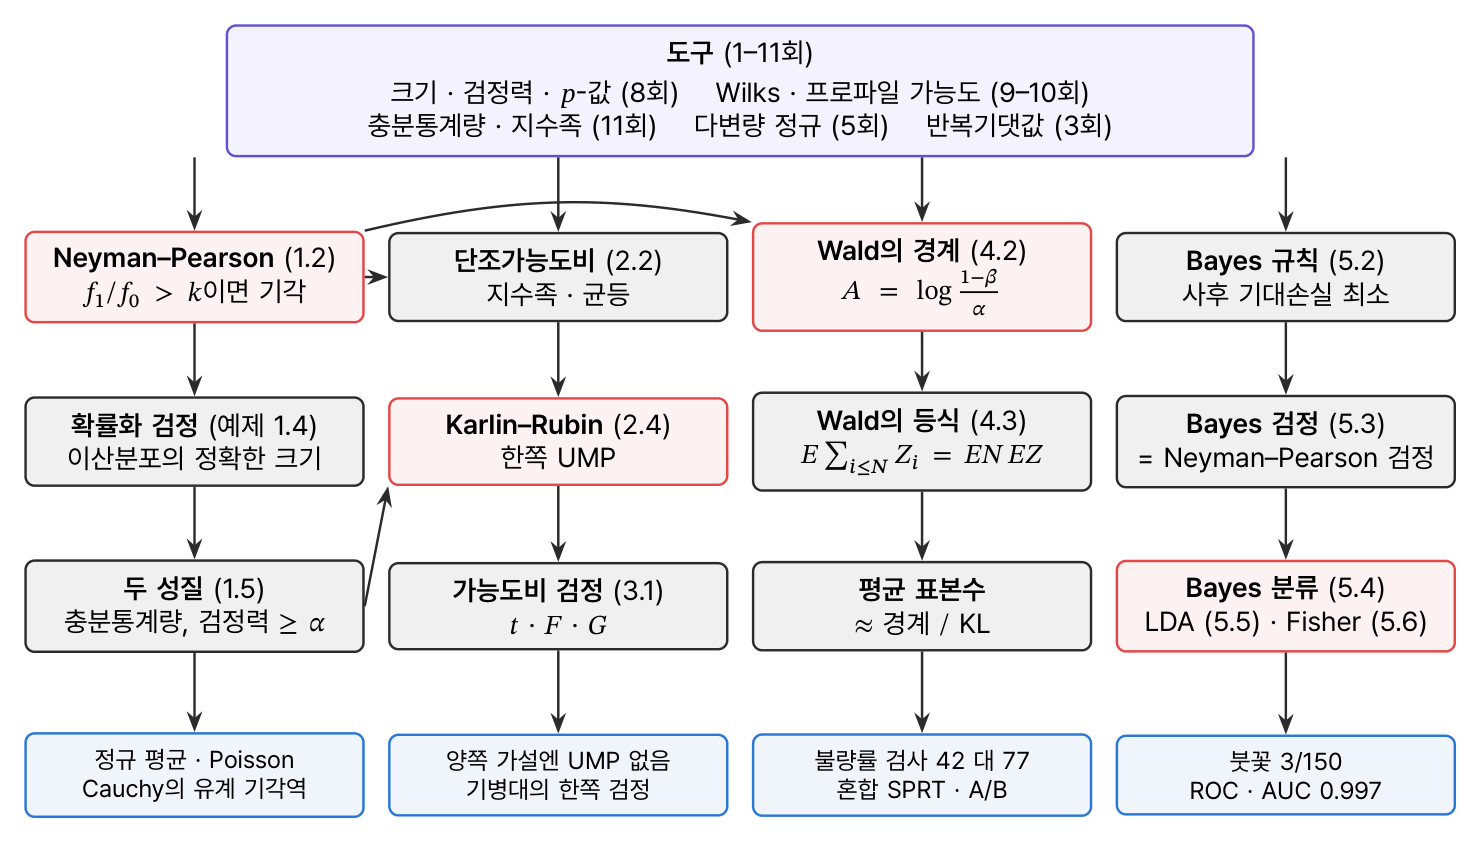
정리 지도
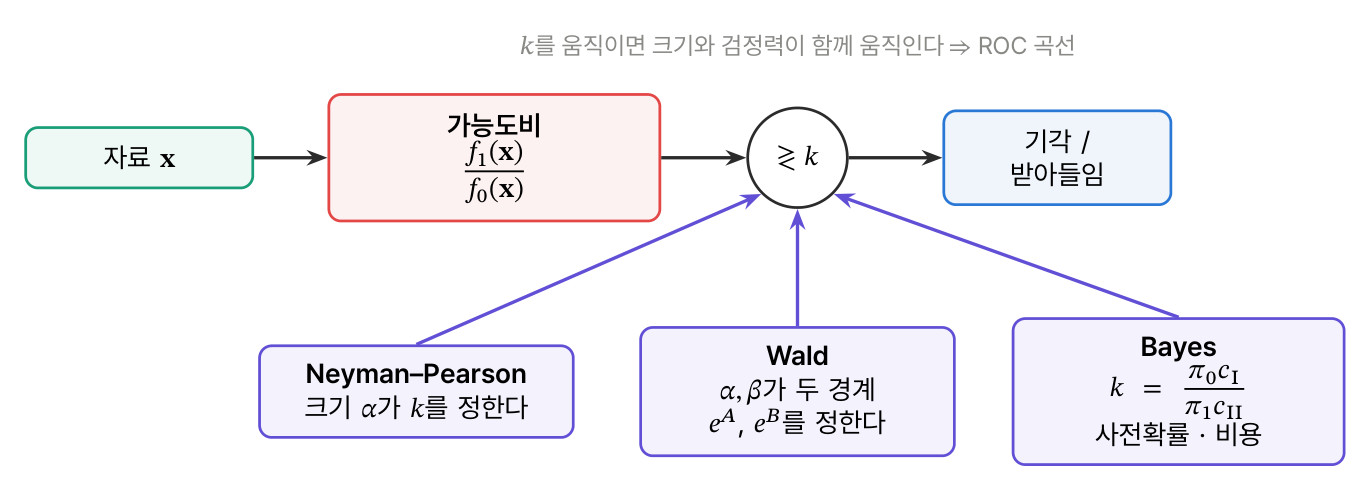
임계값을 정하는 세 방법
0. 설정
python
%matplotlib inline
import math
from pathlib import Path

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import integrate, optimize, special, stats

SEED = 1933
N_SIM = 200_000
rng = np.random.default_rng(SEED)

C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
SERIES = [C["stat"], C["data"], C["key"], C["theta"]]
THEORY = dict(color=C["ink"], ls="--", lw=1.6)
plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/{}/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")

def load_rdata(item, package="HistData"):
    path = DATA_DIR / (f"{item}.csv" if package == "HistData" else f"{package}_{item}.csv")
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(package, item)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"

def within(est, truth, se, k=4):
    return abs(est - truth) <= k * se
1. Neyman–Pearson 보조정리
정의 1.1 최강력 검정 · 정리 1.2 이면 기각, 경계에서 로 확률화 · 예제 1.3 정규 평균 · 예제 1.4 Poisson의 확률화 · 따름정리 1.5 충분통계량의 함수, 검정력 .
이산 표본공간에서는 검정함수 이 유한 개의 숫자이므로, "크기 아래 검정력 최대"는 선형계획법 문제다. 그 해가 Neyman–Pearson 검정과 같은지 본다.
python
def np_test(f0, f1, alpha):
    """정리 1.2: 이산 표본공간 위의 크기 α 최강력 검정 φ (가능도비가 큰 점부터 채우고 경계에서 확률화)"""
    f0, f1 = np.asarray(f0, float), np.asarray(f1, float)
    with np.errstate(divide="ignore", invalid="ignore"):
        r = np.where(f0 > 0, f1 / f0, np.inf)
    phi = np.zeros_like(f0); budget = alpha
    for k in np.unique(r)[::-1]:                     # 가능도비가 큰 값부터
        idx = r == k; mass = f0[idx].sum()
        if mass <= budget + 1e-15:
            phi[idx] = 1.0; budget -= mass
        else:
            phi[idx] = budget / mass; break           # 경계: 확률화
    return phi

# 예제 1.4: X1..X5 ~ Poi(λ), H0 λ=1 대 H1 λ=2 — 충분통계량 T ~ Poi(5λ) 위에서
t = np.arange(0, 60)
f0, f1 = stats.poisson.pmf(t, 5), stats.poisson.pmf(t, 10)
phi = np_test(f0, f1, 0.05)
gamma = phi[9]; size = np.sum(phi * f0); power = np.sum(phi * f1)
power_nr = stats.poisson.sf(9, 10)
# 선형계획법: max Σ φ f1  s.t. Σ φ f0 ≤ α, 0 ≤ φ ≤ 1
lp = optimize.linprog(-f1, A_ub=[f0], b_ub=[0.05], bounds=[(0, 1)] * len(t), method="highs")
print(f"NP: T ≥ 10 기각, T = 9 에서 γ = {gamma:.3f};  크기 {size:.4f}, 검정력 {power:.4f} (확률화 없이 {power_nr:.4f}, 크기 {stats.poisson.sf(9, 5):.4f})")
print(f"선형계획법의 최대 검정력 {-lp.fun:.4f}")
report({"예제 1.4: P(T≥10) = 0.0318, P(T≥9) = 0.0681, γ = 0.501": abs(stats.poisson.sf(9, 5) - 0.0318) < 5e-5 and abs(stats.poisson.sf(8, 5) - 0.0681) < 5e-5 and abs(gamma - 0.501) < 5e-4,
        "예제 1.4 · 연습 1.2: 검정력 0.605 (확률화), 0.542 (T ≥ 10 만)": abs(power - 0.605) < 5e-4 and abs(power_nr - 0.542) < 5e-4,
        "정리 1.2 (b)(c): 가능한 모든 검정 가운데 (선형계획법) 최대 검정력 = Neyman–Pearson, 확률이 있는 점에서 φ 도 같다":
            abs(-lp.fun - power) < 1e-7 and np.allclose(lp.x[f0 + f1 > 1e-6], phi[f0 + f1 > 1e-6], atol=1e-6),
        "따름정리 1.5 (b): 검정력 ≥ 크기": power >= size})
text
NP: T ≥ 10 기각, T = 9 에서 γ = 0.501;  크기 0.0500, 검정력 0.6048 (확률화 없이 0.5421, 크기 0.0318)
선형계획법의 최대 검정력 0.6048
  ✓  예제 1.4: P(T≥10) = 0.0318, P(T≥9) = 0.0681, γ = 0.501
  ✓  예제 1.4 · 연습 1.2: 검정력 0.605 (확률화), 0.542 (T ≥ 10 만)
  ✓  정리 1.2 (b)(c): 가능한 모든 검정 가운데 (선형계획법) 최대 검정력 = Neyman–Pearson, 확률이 있는 점에서 φ 도 같다
  ✓  따름정리 1.5 (b): 검정력 ≥ 크기
python
# 예제 1.3 · 연습 1.1 · 1.3 · 1.4: 정규, 지수, Cauchy, 균등
n = 10
c_norm = stats.norm.ppf(0.95) / math.sqrt(n); pow_norm = stats.norm.sf(stats.norm.ppf(0.95) - math.sqrt(n))
# 연습 1.1: Exp(평균 1) 대 Exp(평균 2), n = 10 — Σx > χ²_{2n,α}/2
c_exp = stats.chi2.ppf(0.95, 2 * n) / 2
size_exp = stats.gamma.sf(c_exp, n, scale=1.0)
# 연습 1.3: Cauchy(0) 대 Cauchy(1) 관측 하나 — 기각역 {r > k} 는 유계인 구간
xg = np.linspace(-200, 200, 2_000_001)
r = stats.cauchy.pdf(xg, 1) / stats.cauchy.pdf(xg)
size_of = lambda k: np.trapezoid(stats.cauchy.pdf(xg) * (r > k), xg)
k_c = optimize.brentq(lambda k: size_of(k) - 0.05, 1.001, r.max() - 1e-9)
region = xg[r > k_c]
pow_c = np.trapezoid(stats.cauchy.pdf(xg, 1) * (r > k_c), xg)
tail_pow = stats.cauchy.sf(stats.cauchy.isf(0.05), 1)                  # \"x 가 크면 기각\" 의 검정력
# 연습 1.4: U(0,1) 대 U(0,2), n = 5 — 두 최강력 검정
n5, a = 5, 0.05
U2 = rng.uniform(0, 2, (N_SIM, n5)); U1 = rng.uniform(0, 1, (N_SIM, n5))
tA = lambda U: U.max(1) > (1 - a) ** (1 / n5)
tB = lambda U: (U.max(1) > 1) | (U.min(1) > 1 - a ** (1 / n5))
print(f"정규: x̄ > {c_norm:.3f}, 검정력 {pow_norm:.3f};  지수: Σx > {c_exp:.3f} (크기 {size_exp:.4f});  Cauchy: k = {k_c:.3f}, 기각역 [{region.min():.2f}, {region.max():.2f}], 검정력 {pow_c:.3f} (꼬리 기각역은 {tail_pow:.3f})")
report({"예제 1.3: x̄ > 0.520, μ1 = 1 에서 검정력 0.935": abs(c_norm - 0.520) < 5e-4 and abs(pow_norm - 0.935) < 5e-4,
        "연습 1.1: Σx > χ²_{2n, 0.05}/2 의 크기 = 0.05": abs(size_exp - 0.05) < 1e-10,
        "연습 1.3: Cauchy 의 최강력 기각역은 유계 [1.37, 1.94], 검정력 0.130 > 꼬리 기각역의 검정력": abs(region.min() - 1.37) < 0.01 and abs(region.max() - 1.94) < 0.01 and abs(pow_c - 0.130) < 2e-3 and pow_c > tail_pow,
        "연습 1.4: 두 최강력 검정의 크기 0.05, 검정력 1 − (1−α)2^{-n}":
            all(within(t_(U1).mean(), a, math.sqrt(a * (1 - a) / N_SIM)) and within(t_(U2).mean(), 1 - (1 - a) / 2**n5, 0.001 / 4) for t_ in (tA, tB))})
text
정규: x̄ > 0.520, 검정력 0.935;  지수: Σx > 15.705 (크기 0.0500);  Cauchy: k = 2.527, 기각역 [1.37, 1.94], 검정력 0.129 (꼬리 기각역은 0.059)
  ✓  예제 1.3: x̄ > 0.520, μ1 = 1 에서 검정력 0.935
  ✓  연습 1.1: Σx > χ²_{2n, 0.05}/2 의 크기 = 0.05
  ✓  연습 1.3: Cauchy 의 최강력 기각역은 유계 [1.37, 1.94], 검정력 0.130 > 꼬리 기각역의 검정력
  ✓  연습 1.4: 두 최강력 검정의 크기 0.05, 검정력 1 − (1−α)2^{-n}
📝 연습 1.1–1.4 (강의노트): 지수분포, 확률화의 검정력, Cauchy의 최강력 검정, 균등분포.
2. 균일최강력 검정과 단조가능도비
정의 2.1 · 2.2 UMP, 단조가능도비 · 예제 2.3 지수족과 균등 · 정리 2.4 (Karlin–Rubin) 꼴이 한쪽 UMP, 검정력 함수는 단조 · 예제 2.5 양쪽 가설에는 UMP가 없다.
python
# 정리 2.4: 이항 (n = 20, H0: p ≤ 0.3) — 대립가설의 어느 p1 에 대해서도 같은 NP 검정, 검정력 단조
nb, p0 = 20, 0.3
k = np.arange(nb + 1)
f0b = stats.binom.pmf(k, nb, p0)
tests = {p1: np_test(f0b, stats.binom.pmf(k, nb, p1), 0.05) for p1 in (0.35, 0.5, 0.7, 0.9)}
same = all(np.allclose(v, tests[0.35]) for v in tests.values())
phi_b = tests[0.35]
pgrid = np.linspace(0.01, 0.99, 99)
pow_b = np.array([np.sum(phi_b * stats.binom.pmf(k, nb, p)) for p in pgrid])
c_b = int(np.min(k[phi_b == 1]))
# 예제 2.5: n = 25 정규 평균, 한쪽 대 양쪽
n = 25
one = lambda mu: stats.norm.sf(1.645 - mu * math.sqrt(n))
two = lambda mu: stats.norm.sf(1.96 - mu * math.sqrt(n)) + stats.norm.cdf(-1.96 - mu * math.sqrt(n))
mus = np.linspace(-1, 1, 401)
print(f"이항: K ≥ {c_b} 기각, K = {c_b - 1} 에서 γ = {phi_b[c_b - 1]:.3f};  정규: μ = 0.4 에서 한쪽 {one(0.4):.3f} 양쪽 {two(0.4):.3f}, μ = −0.3 에서 한쪽 {one(-0.3):.4f} 양쪽 {two(-0.3):.3f}")
report({"정리 2.4: p1 = 0.35, 0.5, 0.7, 0.9 모두 같은 최강력 검정 (UMP)": same,
        "정리 2.4: 검정력 함수가 단조증가, p0 에서 크기 0.05": np.all(np.diff(pow_b) >= -1e-12) and abs(np.sum(phi_b * f0b) - 0.05) < 1e-12,
        "예제 2.5: μ = 0.4 에서 한쪽 0.639 > 양쪽 0.516, μ = −0.3 에서 한쪽 0.0008 < 양쪽 0.323": abs(one(0.4) - 0.639) < 5e-4 and abs(two(0.4) - 0.516) < 5e-4 and abs(one(-0.3) - 0.0008) < 5e-5 and abs(two(-0.3) - 0.323) < 5e-4,
        "연습 2.4: 양쪽 검정은 불편 (최솟값이 μ = 0 에서 0.05), 한쪽 검정은 μ < 0 에서 0.05 미만": abs(two(0.0) - 0.05) < 1e-4 and all(two(m) >= two(0.0) - 1e-12 for m in mus) and one(-0.1) < 0.05})
text
이항: K ≥ 10 기각, K = 9 에서 γ = 0.031;  정규: μ = 0.4 에서 한쪽 0.639 양쪽 0.516, μ = −0.3 에서 한쪽 0.0008 양쪽 0.323
  ✓  정리 2.4: p1 = 0.35, 0.5, 0.7, 0.9 모두 같은 최강력 검정 (UMP)
  ✓  정리 2.4: 검정력 함수가 단조증가, p0 에서 크기 0.05
  ✓  예제 2.5: μ = 0.4 에서 한쪽 0.639 > 양쪽 0.516, μ = −0.3 에서 한쪽 0.0008 < 양쪽 0.323
  ✓  연습 2.4: 양쪽 검정은 불편 (최솟값이 μ = 0 에서 0.05), 한쪽 검정은 μ < 0 에서 0.05 미만
python
# 연습 2.1–2.3: 정규 분산의 UMP, 균등의 UMP, 기병대의 한쪽 UMP
# 연습 2.1: N(0, σ²), n = 10, H0 σ² ≤ 1: Σx² > χ²_{10, 0.05}
c_var = stats.chi2.ppf(0.95, 10)
# 연습 2.2: U(0, θ), H0 θ ≤ 1: X_(n) > (1−α)^{1/n}
U = rng.uniform(0, 1, (N_SIM, 6)); size_u = np.mean(U.max(1) > 0.95 ** (1 / 6))
# 연습 2.3: 기병대, H0 λ ≤ 0.61 — T ~ Poi(280·0.61) 에서 P(T ≥ c) ≤ 0.05 인 최소 c
vb = load_rdata("VonBort", "vcd"); T_obs = int(vb.deaths.sum())
mu0 = 280 * 0.61
c_p = int(stats.poisson.isf(0.05, mu0)) + 1
while stats.poisson.sf(c_p - 2, mu0) <= 0.05:
    c_p -= 1
p_one = stats.poisson.sf(T_obs - 1, mu0)
print(f"정규 분산: Σx² > {c_var:.2f};  균등: 크기 {size_u:.4f};  기병대: T ≥ {c_p} 이면 기각 (크기 {stats.poisson.sf(c_p - 1, mu0):.4f}), 관측 T = {T_obs}, 한쪽 p = {p_one:.3f}")
report({"연습 2.1: Σx² > χ²_{10,0.05} = 18.31": abs(c_var - 18.307) < 1e-3,
        "연습 2.2: X_(n) > (1−α)^{1/n} 의 크기 0.05": within(size_u, 0.05, math.sqrt(0.0475 / N_SIM)),
        "연습 2.3: 기병대 — T ≥ 194 이면 기각 (크기 0.043), T = 196 이므로 기각 (한쪽 p ≈ 0.03)": c_p == 194 and abs(stats.poisson.sf(c_p - 1, mu0) - 0.043) < 5e-4 and T_obs >= c_p and abs(p_one - 0.03) < 0.005})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
axes[0].plot(mus, [one(m) for m in mus], color=C["stat"], label="one-sided")
axes[0].plot(mus, [two(m) for m in mus], color=C["key"], label="two-sided")
axes[0].axhline(0.05, color=C["hist"], ls=":"); axes[0].set_xlabel("μ"); axes[0].set_title("no UMP for H1: μ ≠ 0"); axes[0].legend()
axes[1].plot(pgrid, pow_b, color=C["stat"]); axes[1].axvline(p0, color=C["hist"], ls=":"); axes[1].axhline(0.05, color=C["hist"], ls=":")
axes[1].set_xlabel("p"); axes[1].set_title("Karlin–Rubin: binomial UMP power, n = 20")
plt.tight_layout(); plt.show()
text
정규 분산: Σx² > 18.31;  균등: 크기 0.0490;  기병대: T ≥ 194 이면 기각 (크기 0.0434), 관측 T = 196, 한쪽 p = 0.031
  ✓  연습 2.1: Σx² > χ²_{10,0.05} = 18.31
  ✓  연습 2.2: X_(n) > (1−α)^{1/n} 의 크기 0.05
  ✓  연습 2.3: 기병대 — T ≥ 194 이면 기각 (크기 0.043), T = 196 이므로 기각 (한쪽 p ≈ 0.03)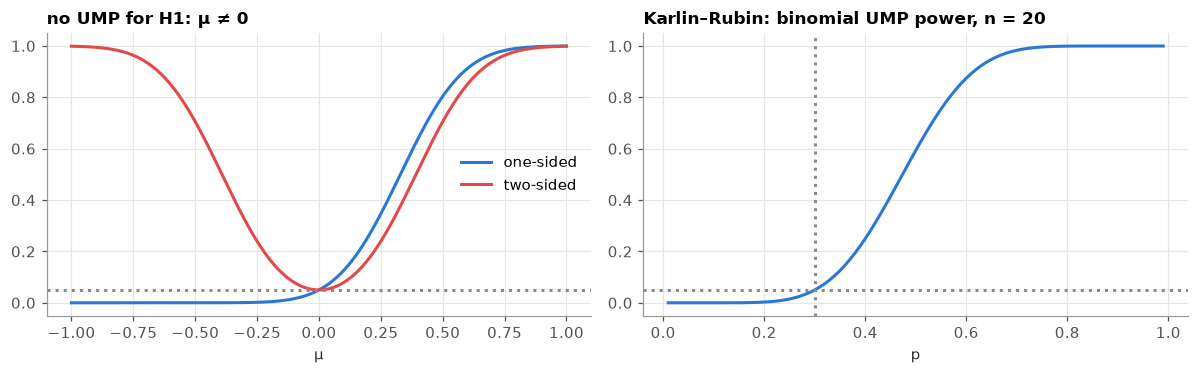
그림 읽기. 왼쪽: 한쪽 검정(파랑)은 에서 양쪽 검정(빨강)보다 강하지만 에서는 거의 0이다. 어느 하나가 모든 에서 이길 수 없으므로 양쪽 가설의 UMP는 없다. 오른쪽: 단조가능도비 덕분에 이항 검정의 검정력은 와 함께 단조증가한다. 그래서 전체에서의 크기가 경계 에서의 크기와 같다.
📝 연습 2.1–2.4 (강의노트): 지수족의 단조가능도비, 균등분포, Poisson의 UMP, 불편성.
3. 가능도비 검정
정의 3.1 · 예제 3.2 ·두 표본 ·분산의 비·는 모두 LRT · 3절의 상자: Fisher 대 Neyman.
일반 목적의 최적화로 두 가설 아래의 최대가능도를 구해 를 만들고, 그것이 교과서의 통계량과 같은 기각역을 주는지 본다.
python
def lrt_stat(nll_h0, x0_h0, nll_h1, x0_h1):
    """정의 3.1: −2 log λ = 2[min NLL(H0) − min NLL(H1)], 두 최소화는 수치로"""
    r0 = optimize.minimize(nll_h0, x0_h0, method="Nelder-Mead", options=dict(xatol=1e-10, fatol=1e-12, maxiter=20_000))
    r1 = optimize.minimize(nll_h1, x0_h1, method="Nelder-Mead", options=dict(xatol=1e-10, fatol=1e-12, maxiter=20_000))
    return 2 * (r0.fun - r1.fun)

# 예제 3.2 (a): 한 표본 t — −2 log λ = n log(1 + t²/(n−1))
x = rng.normal(0.4, 1.3, 12); n = len(x)
nll = lambda m, ls: -np.sum(stats.norm.logpdf(x, m, math.exp(ls)))
L_t = lrt_stat(lambda p: nll(0.0, p[0]), [0.0], lambda p: nll(p[0], p[1]), [x.mean(), 0.0])
t_ = stats.ttest_1samp(x, 0).statistic
# 예제 3.2 (c) · 연습 3.2: 분산의 비 — λ ∝ F^{m/2}/(mF + n)^{(m+n)/2}
a_, b_ = rng.normal(0, 1, 15), rng.normal(0, 1.8, 20); m, nn = len(a_), len(b_)
nll2 = lambda ma, mb, la, lb: -(np.sum(stats.norm.logpdf(a_, ma, math.exp(la))) + np.sum(stats.norm.logpdf(b_, mb, math.exp(lb))))
L_F = lrt_stat(lambda p: nll2(p[0], p[1], p[2], p[2]), [a_.mean(), b_.mean(), 0.0], lambda p: nll2(*p), [a_.mean(), b_.mean(), 0.0, 0.0])
F = a_.var() / b_.var()                                                  # MLE 분산 (n 으로 나눔)
L_F_formula = -2 * (m / 2 * math.log(F) - (m + nn) / 2 * math.log((m * F + nn) / (m + nn)))
# 연습 3.1: 두 지수분포의 평균이 같은가 — λ 는 u = m x̄/(m x̄ + n ȳ) 의 함수
xe, ye = rng.exponential(1.0, 10), rng.exponential(1.6, 14); me, ne = len(xe), len(ye)
u = me * xe.mean() / (me * xe.mean() + ne * ye.mean())
L_e_formula = -2 * (me * math.log(u) + ne * math.log(1 - u) + (me + ne) * math.log(me + ne) - me * math.log(me) - ne * math.log(ne))
nlle = lambda t1, t2: -(np.sum(stats.expon.logpdf(xe, scale=math.exp(t1))) + np.sum(stats.expon.logpdf(ye, scale=math.exp(t2))))
L_e = lrt_stat(lambda p: nlle(p[0], p[0]), [0.0], lambda p: nlle(*p), [0.0, 0.0])
print(f"t: −2 log λ = {L_t:.6f}, n log(1 + t²/(n−1)) = {n * math.log1p(t_**2 / (n - 1)):.6f};  F: {L_F:.6f} 대 {L_F_formula:.6f};  지수: {L_e:.6f} 대 {L_e_formula:.6f}")
report({"예제 3.2 (a): 한 표본 t 검정은 LRT": abs(L_t - n * math.log1p(t_**2 / (n - 1))) < 1e-6,
        "예제 3.2 (c) · 연습 3.2: 분산의 LRT 는 F 의 함수": abs(L_F - L_F_formula) < 1e-6,
        "연습 3.1: 두 지수분포의 LRT 는 u = m x̄/(m x̄ + n ȳ) 의 함수": abs(L_e - L_e_formula) < 1e-6,
        "연습 3.3: 단순 대 단순이면 λ = min(1, f0/f1)": all(abs(min(1.0, a / b) - a / max(a, b)) < 1e-15 for a, b in [(0.2, 0.5), (0.7, 0.1)])})
text
t: −2 log λ = 1.069600, n log(1 + t²/(n−1)) = 1.069600;  F: 3.891007 대 3.891007;  지수: 2.250089 대 2.250089
  ✓  예제 3.2 (a): 한 표본 t 검정은 LRT
  ✓  예제 3.2 (c) · 연습 3.2: 분산의 LRT 는 F 의 함수
  ✓  연습 3.1: 두 지수분포의 LRT 는 u = m x̄/(m x̄ + n ȳ) 의 함수
  ✓  연습 3.3: 단순 대 단순이면 λ = min(1, f0/f1)
📝 연습 3.1–3.3 (강의노트): 두 지수분포, 분산의 비, 단순가설의 LRT.
4. 축차확률비 검정 — Wald (1945)
정의 4.1 , 이면 계속 · 정리 4.2 (Wald의 경계) , · 보조정리 4.3 (Wald의 등식) · 예제 4.4 불량률 검사.
python
class SPRT:
    """정의 4.1: Bernoulli 의 축차확률비 검정 (p0 대 p1). 경로는 1 이면 +log(p1/p0), 0 이면 +log(q1/q0)"""
    def __init__(self, p0, p1, alpha, beta):
        self.A, self.B = math.log((1 - beta) / alpha), math.log(beta / (1 - alpha))
        self.up, self.down = math.log(p1 / p0), math.log((1 - p1) / (1 - p0))
        self.p0, self.p1 = p0, p1

    def run(self, p, gen, R):
        """R 번 돌려 (표본수 N, H1 택 여부, 멈출 때의 Λ_N) 를 돌려준다 — 한 번에 많은 경로를 함께 굴린다"""
        lam = np.zeros(R); N = np.zeros(R, int); alive = np.ones(R, bool)
        while alive.any():
            x = gen.random(alive.sum()) < p
            lam[alive] += np.where(x, self.up, self.down); N[alive] += 1
            alive[alive] = (lam[alive] > self.B) & (lam[alive] < self.A)
        return N, lam >= self.A, lam

    def wald_asn(self, alpha, beta):
        """넘침을 무시한 Wald 의 근사 E0 N, E1 N (Wald 의 등식 E Λ_N = E N · E Z 에서)"""
        mu0 = self.p0 * self.up + (1 - self.p0) * self.down; mu1 = self.p1 * self.up + (1 - self.p1) * self.down
        return ((1 - alpha) * self.B + alpha * self.A) / mu0, (beta * self.B + (1 - beta) * self.A) / mu1

s = SPRT(0.05, 0.15, 0.05, 0.10)
g = np.random.default_rng(1945)
out = {p: s.run(p, g, 40_000) for p in (0.05, 0.10, 0.15)}
asn = {p: o[0].mean() for p, o in out.items()}; rej = {p: o[1].mean() for p, o in out.items()}
w0, w1 = s.wald_asn(0.05, 0.10)
# 보조정리 4.3 (Wald 의 등식): E Λ_N = E N · E Z — 두 쪽을 같은 표본으로 (차의 표준오차로 판정)
wald_eq = {}
for p, (N, _, lam) in out.items():
    EZ = p * s.up + (1 - p) * s.down
    diff = lam - N * EZ
    wald_eq[p] = within(diff.mean(), 0.0, diff.std() / math.sqrt(len(N)))
# 고정 표본: 크기 ≤ 0.05, 검정력 ≥ 0.9 인 가장 작은 n
for nf in range(20, 200):
    cf = min(k for k in range(nf + 1) if stats.binom.sf(k - 1, nf, 0.05) <= 0.05)
    if stats.binom.sf(cf - 1, nf, 0.15) >= 0.9:
        break
z_a, z_b = stats.norm.ppf(0.95), stats.norm.ppf(0.90)
n_normal = ((z_a * math.sqrt(0.05 * 0.95) + z_b * math.sqrt(0.15 * 0.85)) / 0.10) ** 2
print(f"A = {s.A:.3f}, B = {s.B:.3f}, 불량 +{s.up:.3f}, 양품 {s.down:.3f}")
print(f"평균 표본수: p = 0.05 → {asn[0.05]:.1f} (Wald {w0:.1f}), 0.10 → {asn[0.10]:.1f}, 0.15 → {asn[0.15]:.1f} (Wald {w1:.1f});  실제 오류율 α' = {rej[0.05]:.3f}, β' = {1 - rej[0.15]:.3f}")
print(f"고정 표본: n = {nf}, K ≥ {cf} 이면 기각;  정규근사로는 n ≈ {n_normal:.1f}")
report({"예제 4.4: A = 2.890, B = −2.251": abs(s.A - 2.890) < 5e-4 and abs(s.B + 2.251) < 5e-4,
        "예제 4.4: 평균 표본수 41.9 (p = 0.05), 39.1 (p = 0.15), Wald 근사 39.3 · 33.8": abs(asn[0.05] - 41.9) < 0.6 and abs(asn[0.15] - 39.1) < 0.6 and abs(w0 - 39.3) < 0.05 and abs(w1 - 33.8) < 0.05,
        "정리 4.2: 실제 오류율 ≤ α/(1−β), β/(1−α) (0.035, 0.096)": rej[0.05] <= 0.05 / 0.9 and 1 - rej[0.15] <= 0.10 / 0.95 and abs(rej[0.05] - 0.035) < 0.004 and abs(1 - rej[0.15] - 0.096) < 0.005,
        "보조정리 4.3: E Λ_N = E N · E Z (p = 0.05, 0.10, 0.15)": all(wald_eq.values()),
        "예제 4.4 · 연습 4.4: 고정 표본 77 (K ≥ 8), 정규근사 67": nf == 77 and cf == 8 and abs(n_normal - 66.6) < 0.2,
        "예제 4.4: 평균 표본수는 중간 p = 0.1 근처에서 가장 크다 (약 60)": asn[0.10] > max(asn[0.05], asn[0.15]) and 55 < asn[0.10] < 66})
text
A = 2.890, B = -2.251, 불량 +1.099, 양품 -0.111
평균 표본수: p = 0.05 → 41.7 (Wald 39.3), 0.10 → 60.8, 0.15 → 39.4 (Wald 33.8);  실제 오류율 α' = 0.034, β' = 0.095
고정 표본: n = 77, K ≥ 8 이면 기각;  정규근사로는 n ≈ 66.6
  ✓  예제 4.4: A = 2.890, B = −2.251
  ✓  예제 4.4: 평균 표본수 41.9 (p = 0.05), 39.1 (p = 0.15), Wald 근사 39.3 · 33.8
  ✓  정리 4.2: 실제 오류율 ≤ α/(1−β), β/(1−α) (0.035, 0.096)
  ✓  보조정리 4.3: E Λ_N = E N · E Z (p = 0.05, 0.10, 0.15)
  ✓  예제 4.4 · 연습 4.4: 고정 표본 77 (K ≥ 8), 정규근사 67
  ✓  예제 4.4: 평균 표본수는 중간 p = 0.1 근처에서 가장 크다 (약 60)
python
# 연습 4.1: 멈춤시각이 아니면 Wald 의 등식이 깨진다 — Z2 를 엿보고 N 을 정한다
Z = rng.choice([-1.0, 1.0], (N_SIM, 2))
N_peek = np.where(Z[:, 1] > 0, 2, 1)
S_peek = np.where(N_peek == 2, Z.sum(1), Z[:, 0])
# 연습 4.2: 정규 평균의 SPRT 는 Σx 가 두 평행선 사이에 있으면 계속
delta, A_, B_ = 0.5, math.log(9), math.log(1 / 9)
xs = rng.normal(0, 1, 200); Sn = np.cumsum(xs); nn = np.arange(1, 201)
lam_n = delta * Sn - nn * delta**2 / 2
inside_lam = (lam_n > B_) & (lam_n < A_)
inside_lines = (Sn > B_ / delta + nn * delta / 2) & (Sn < A_ / delta + nn * delta / 2)
print(f"엿본 N: E ΣZ = {S_peek.mean():.3f} (이론 1/2), E N · E Z = {N_peek.mean() * 0:.1f}")
report({"연습 4.1: 엿보면 E Σ_{i≤N} Z_i = 1/2 ≠ E N · E Z = 0": within(S_peek.mean(), 0.5, S_peek.std() / math.sqrt(N_SIM)),
        "연습 4.2: 'Λ_n 이 (B, A) 안' ⇔ 'Σx 가 두 평행선 사이'": np.array_equal(inside_lam, inside_lines)})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
g2 = np.random.default_rng(7)
for p, col in [(0.05, C["stat"]), (0.15, C["key"]), (0.10, C["theta"])]:
    for _ in range(2):
        lam, path = 0.0, [0.0]
        while s.B < lam < s.A:
            lam += s.up if g2.random() < p else s.down; path.append(lam)
        axes[0].step(range(len(path)), path, where="post", color=col, lw=1)
axes[0].axhline(s.A, **THEORY); axes[0].axhline(s.B, **THEORY); axes[0].set_xlabel("n"); axes[0].set_title("SPRT paths")
ps = [0.02, 0.05, 0.08, 0.10, 0.12, 0.15, 0.2]
axes[1].plot(ps, [s.run(p, g2, 5000)[0].mean() for p in ps], "o-", color=C["stat"], label="SPRT")
axes[1].axhline(77, **THEORY, label="fixed n = 77"); axes[1].set_xlabel("p"); axes[1].set_title("average sample number"); axes[1].legend()
plt.tight_layout(); plt.show()
text
엿본 N: E ΣZ = 0.502 (이론 1/2), E N · E Z = 0.0
  ✓  연습 4.1: 엿보면 E Σ_{i≤N} Z_i = 1/2 ≠ E N · E Z = 0
  ✓  연습 4.2: 'Λ_n 이 (B, A) 안' ⇔ 'Σx 가 두 평행선 사이'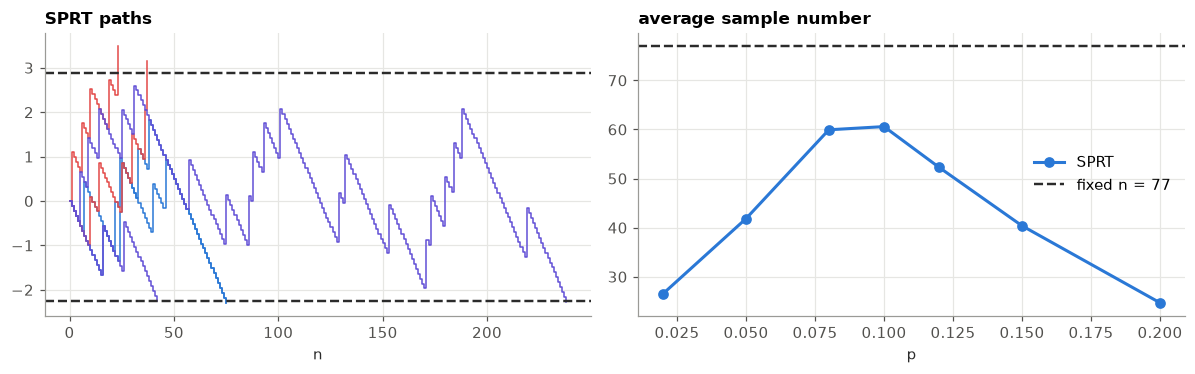
그림 읽기. 불량품 하나는 경로를 1.10만큼 올리고 양품 하나는 0.11만큼 내린다. 그래서 불량률이 낮으면 천천히 아래 경계로, 높으면 몇 번의 불량으로 빠르게 위 경계로 간다. 같은 오류율을 고정 표본 검정은 77개로 얻는다. SPRT는 대부분의 에서 그 절반 남짓이면 되고, 가장 어려운 중간()에서도 약 60개다.
📝 연습 4.1–4.4 (강의노트): Wald의 등식, 정규 평균의 SPRT, 멈출 확률, 고정 표본의 크기.
5. 결정이론 — 검정과 분류를 하나로
정의 5.1 손실·위험·Bayes·minimax · 정리 5.2 Bayes 규칙은 사후 기대손실 최소 · 따름정리 5.3 Bayes 검정 = 가능도비 검정, · 정리 5.4 Bayes 분류기 · 따름정리 5.5 LDA, 오류 · 명제 5.6 Fisher의 기준.
python
# 따름정리 5.3 · 연습 5.1 · 5.4: Bayes 검정의 임계값, minimax 검정
k_med = 0.99 * 1 / (0.01 * 50)
# 연습 5.4: N(0,1) 대 N(1,1), 관측 하나 — 두 오류의 최댓값을 최소화하는 c
c_mm = optimize.minimize_scalar(lambda c: max(stats.norm.sf(c), stats.norm.cdf(c - 1)), bounds=(-2, 3), method="bounded").x
# Bayes 위험을 직접 최소화해도 (π0 = π1, 같은 비용) 같은 c
bayes_risk = lambda c: 0.5 * stats.norm.sf(c) + 0.5 * stats.norm.cdf(c - 1)
c_bayes = optimize.minimize_scalar(bayes_risk, bounds=(-2, 3), method="bounded").x
# 연습 5.3: N(0,1) 대 N(0,4) 이면 |x| > c
c_qda = optimize.brentq(lambda x: stats.norm.pdf(x, 0, 2) - stats.norm.pdf(x), 0.1, 5)
print(f"의료 검사의 임계값 k = {k_med:.2f};  minimax c = {c_mm:.4f}, Bayes c = {c_bayes:.4f}, 오류 {stats.norm.sf(c_mm):.4f};  QDA |x| > {c_qda:.3f}")
report({"연습 5.1: 유병률 1%, 비용 50배 → k = 1.98": abs(k_med - 1.98) < 1e-12,
        "연습 5.4: minimax 검정 x > 1/2 = 같은 사전확률의 Bayes 검정, 두 오류 0.309": abs(c_mm - 0.5) < 1e-4 and abs(c_bayes - 0.5) < 1e-4 and abs(stats.norm.sf(0.5) - 0.3085) < 1e-4,
        "연습 5.3: 이차판별의 경계 |x| = √(8 log 2 / 3) = 1.36": abs(c_qda - math.sqrt(8 * math.log(2) / 3)) < 1e-9})
text
의료 검사의 임계값 k = 1.98;  minimax c = 0.5000, Bayes c = 0.5000, 오류 0.3085;  QDA |x| > 1.360
  ✓  연습 5.1: 유병률 1%, 비용 50배 → k = 1.98
  ✓  연습 5.4: minimax 검정 x > 1/2 = 같은 사전확률의 Bayes 검정, 두 오류 0.309
  ✓  연습 5.3: 이차판별의 경계 |x| = √(8 log 2 / 3) = 1.36
python
class LDA:
    """따름정리 5.5: 무리별 평균, 합동 공분산, 사전확률 → 선형 판별함수 δ_k(x)"""
    def fit(self, X, y):
        self.classes = np.unique(y); K = len(self.classes); n = len(X)
        self.mu = np.array([X[y == c].mean(0) for c in self.classes])
        self.Sigma = sum((X[y == c] - m).T @ (X[y == c] - m) for c, m in zip(self.classes, self.mu)) / (n - K)
        self.prior = np.array([np.mean(y == c) for c in self.classes])
        return self

    def scores(self, X):
        Si = np.linalg.inv(self.Sigma)
        return X @ Si @ self.mu.T - 0.5 * np.sum(self.mu @ Si * self.mu, 1) + np.log(self.prior)

    def predict(self, X):
        return self.classes[self.scores(X).argmax(1)]

ir = load_rdata("iris", "datasets")
X = ir.iloc[:, :4].to_numpy(float); y = ir.Species.to_numpy()
lda = LDA().fit(X, y)
pred = lda.predict(X)
conf = pd.crosstab(pd.Series(y, name="true"), pd.Series(pred, name="predicted"))
loo = sum(LDA().fit(np.delete(X, i, 0), np.delete(y, i)).predict(X[i:i + 1])[0] != y[i] for i in range(len(y)))
Si = np.linalg.inv(lda.Sigma)
D = {(a, b): math.sqrt((lda.mu[i] - lda.mu[j]) @ Si @ (lda.mu[i] - lda.mu[j])) for i, a in enumerate(lda.classes) for j, b in enumerate(lda.classes) if i < j}
# 정리 5.4: 같은 판별을 Bayes 분류기 argmax π_k f_k(x) (다변량 정규 밀도) 로 직접 — 같은 답
dens = np.column_stack([lda.prior[k] * stats.multivariate_normal.pdf(X, lda.mu[k], lda.Sigma) for k in range(3)])
print(conf.to_string()); print(f"leave-one-out 오류 {loo}/150;  Mahalanobis 거리:", {f"{a[:4]}–{b[:4]}": round(v, 2) for (a, b), v in D.items()})
report({"예제 6.1: 같은 자료로 3/150 틀림 (versicolor 2 → virginica, virginica 1 → versicolor)": (pred != y).sum() == 3 and conf.loc["versicolor", "virginica"] == 2 and conf.loc["virginica", "versicolor"] == 1,
        "예제 6.1: leave-one-out 도 3/150": loo == 3,
        "예제 6.1: Mahalanobis 거리 9.5, 13.4 (setosa 와), 4.1 (versicolor–virginica)": np.allclose([D[("setosa", "versicolor")], D[("setosa", "virginica")], D[("versicolor", "virginica")]], [9.48, 13.39, 4.15], atol=0.01),
        "정리 5.4: LDA 판별함수 = Bayes 분류기 argmax π_k f_k(x)": np.array_equal(lda.classes[dens.argmax(1)], pred)})
text
predicted   setosa  versicolor  virginica
true
setosa          50           0          0
versicolor       0          48          2
virginica        0           1         49
text
leave-one-out 오류 3/150;  Mahalanobis 거리: {'seto–vers': 9.48, 'seto–virg': 13.39, 'vers–virg': 4.15}
  ✓  예제 6.1: 같은 자료로 3/150 틀림 (versicolor 2 → virginica, virginica 1 → versicolor)
  ✓  예제 6.1: leave-one-out 도 3/150
  ✓  예제 6.1: Mahalanobis 거리 9.5, 13.4 (setosa 와), 4.1 (versicolor–virginica)
  ✓  정리 5.4: LDA 판별함수 = Bayes 분류기 argmax π_k f_k(x)
python
# 예제 6.2 · 명제 5.6 · 연습 6.1: versicolor 대 virginica — Fisher 의 방향, Δ, ROC
sel = y != "setosa"; Xs = X[sel]; ys = (y[sel] == "virginica").astype(int)
m1, m0 = Xs[ys == 1].mean(0), Xs[ys == 0].mean(0)
Sw = ((Xs[ys == 1] - m1).T @ (Xs[ys == 1] - m1) + (Xs[ys == 0] - m0).T @ (Xs[ys == 0] - m0)) / (len(Xs) - 2)
w = np.linalg.solve(Sw, m1 - m0)
Delta = math.sqrt((m1 - m0) @ w)
# 명제 5.6: Fisher 의 기준을 일반 최적화로 최대화하면 같은 방향
J = lambda v: -((v @ (m1 - m0)) ** 2) / (v @ Sw @ v)
v_opt = optimize.minimize(J, np.ones(4), method="BFGS").x
cosine = abs(v_opt @ w) / (np.linalg.norm(v_opt) * np.linalg.norm(w))
s = Xs @ w; thr = (m1 + m0) @ w / 2
err_mid = np.sum((s > thr) != ys)
std_gap = (s[ys == 1].mean() - s[ys == 0].mean()) / math.sqrt(((s[ys == 1] - s[ys == 1].mean()) ** 2).sum() / 98 + ((s[ys == 0] - s[ys == 0].mean()) ** 2).sum() / 98)
ts = np.sort(np.r_[s, -np.inf, np.inf])[::-1]
fpr = np.array([np.mean(s[ys == 0] > t) for t in ts]); tpr = np.array([np.mean(s[ys == 1] > t) for t in ts])
auc_trap = np.trapezoid(tpr, fpr)
auc_mw = np.mean(s[ys == 1][:, None] > s[ys == 0][None, :])
print(f"w = {np.round(w, 2)};  Δ = {Delta:.2f}, Φ(−Δ/2) = {stats.norm.cdf(-Delta / 2):.3f};  중점 경계의 오류 {err_mid}/100;  AUC {auc_trap:.4f} (Mann–Whitney {auc_mw:.4f})")
report({"예제 6.2: w = (−3.56, −5.58, 6.97, 12.39)": np.allclose(w, [-3.56, -5.58, 6.97, 12.39], atol=0.005),
        "명제 5.6: Fisher 의 기준의 최대점은 Σ⁻¹(μ1 − μ0) 방향 (cos = 1)": cosine > 1 - 1e-6,
        "예제 6.2 · 연습 6.1: Δ = 3.77, 점수의 표준화한 차 = Δ, Φ(−Δ/2) = 0.030": abs(Delta - 3.77) < 0.005 and abs(std_gap - Delta) < 1e-9 and abs(stats.norm.cdf(-Delta / 2) - 0.030) < 5e-4,
        "예제 6.2: 중점 경계에서 3/100 틀림, AUC 0.997 = P(점수1 > 점수0) (연습 8.2)": err_mid == 3 and abs(auc_trap - 0.997) < 5e-4 and abs(auc_trap - auc_mw) < 1e-12})

fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
for c_, col in [("setosa", C["data"]), ("versicolor", C["stat"]), ("virginica", C["key"])]:
    axes[0].scatter(X[y == c_, 2], X[y == c_, 3], s=10, color=col, label=c_)
axes[0].scatter(X[pred != y, 2], X[pred != y, 3], s=60, facecolors="none", edgecolors=C["ink"])
axes[0].set_xlabel("petal length"); axes[0].set_ylabel("petal width"); axes[0].legend(fontsize=8); axes[0].set_title("LDA: 3 errors")
axes[1].hist(s[ys == 0], bins=25, alpha=0.5, color=C["stat"], label="versicolor"); axes[1].hist(s[ys == 1], bins=25, alpha=0.5, color=C["key"], label="virginica")
axes[1].axvline(thr, **THEORY); axes[1].legend(fontsize=8); axes[1].set_title("Fisher's discriminant score")
axes[2].plot(fpr, tpr, color=C["theta"]); axes[2].plot([0, 1], [0, 1], color=C["hist"], ls=":")
axes[2].set_xlabel("false positive rate"); axes[2].set_ylabel("true positive rate"); axes[2].set_title(f"ROC (AUC {auc_trap:.3f})")
plt.tight_layout(); plt.show()
text
w = [-3.56 -5.58  6.97 12.39];  Δ = 3.77, Φ(−Δ/2) = 0.030;  중점 경계의 오류 3/100;  AUC 0.9972 (Mann–Whitney 0.9972)
  ✓  예제 6.2: w = (−3.56, −5.58, 6.97, 12.39)
  ✓  명제 5.6: Fisher 의 기준의 최대점은 Σ⁻¹(μ1 − μ0) 방향 (cos = 1)
  ✓  예제 6.2 · 연습 6.1: Δ = 3.77, 점수의 표준화한 차 = Δ, Φ(−Δ/2) = 0.030
  ✓  예제 6.2: 중점 경계에서 3/100 틀림, AUC 0.997 = P(점수1 > 점수0) (연습 8.2)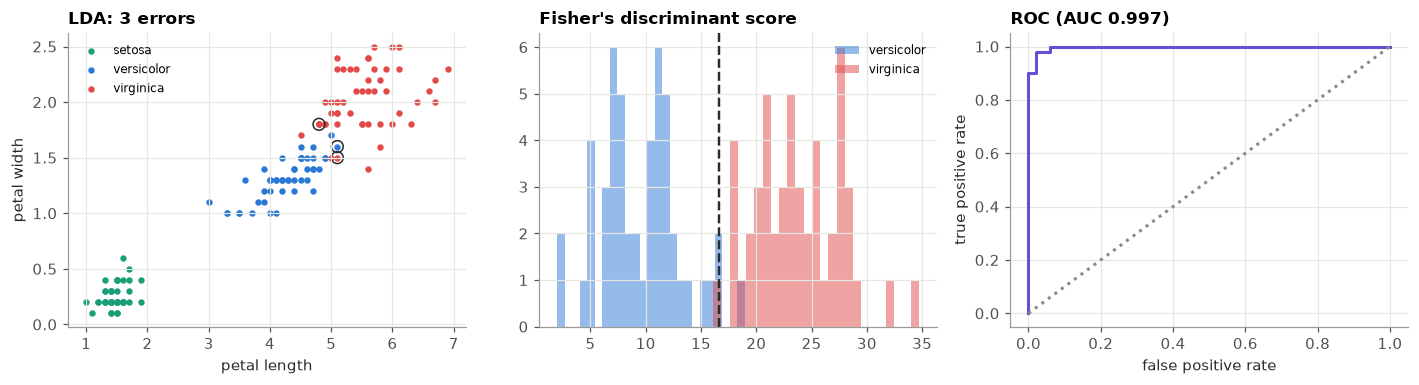
python
# 따름정리 5.5 · 연습 5.2: 오분류 확률 Φ(−Δ/2) 와 사전확률이 다를 때 — 시뮬레이션으로
mu0v, mu1v = np.zeros(2), np.array([1.5, 1.0]); Sig = np.array([[1.0, 0.3], [0.3, 1.0]])
wv = np.linalg.solve(Sig, mu1v - mu0v); Dv = math.sqrt((mu1v - mu0v) @ wv)
def lda_error(pi0, R=400_000, gen=np.random.default_rng(1936)):
    lab = gen.random(R) > pi0                                              # True = 무리 1
    Xv = np.where(lab[:, None], mu1v, mu0v) + gen.multivariate_normal(np.zeros(2), Sig, R)
    cut = 0.5 * wv @ (mu0v + mu1v) + math.log(pi0 / (1 - pi0))
    return np.mean((Xv @ wv > cut) != lab)
eta = math.log(0.8 / 0.2)
theory_eq = stats.norm.cdf(-Dv / 2)
theory_uneq = 0.8 * stats.norm.cdf(-Dv / 2 - eta / Dv) + 0.2 * stats.norm.cdf(-Dv / 2 + eta / Dv)
e_eq, e_uneq = lda_error(0.5), lda_error(0.8)
print(f"Δ = {Dv:.3f}: π0 = 0.5 오류 {e_eq:.4f} (이론 {theory_eq:.4f});  π0 = 0.8 오류 {e_uneq:.4f} (이론 {theory_uneq:.4f})")
report({"따름정리 5.5: 오분류 확률 = Φ(−Δ/2)": within(e_eq, theory_eq, math.sqrt(theory_eq * (1 - theory_eq) / 400_000)),
        "연습 5.2: 사전확률이 다르면 π0Φ(−Δ/2 − η/Δ) + π1Φ(−Δ/2 + η/Δ)": within(e_uneq, theory_uneq, math.sqrt(theory_uneq * (1 - theory_uneq) / 400_000))})
text
Δ = 1.607: π0 = 0.5 오류 0.2107 (이론 0.2108); π0 = 0.8 오류 0.1430 (이론 0.1430)text
  ✓  따름정리 5.5: 오분류 확률 = Φ(−Δ/2)
  ✓  연습 5.2: 사전확률이 다르면 π0Φ(−Δ/2 − η/Δ) + π1Φ(−Δ/2 + η/Δ)
그림 읽기. \emph{setosa}(초록)는 꽃잎만으로도 완전히 떨어져 있고, 어려운 것은 \emph{versicolor}와 \emph{virginica}의 경계다. 판별 점수의 두 히스토그램이 조금 겹치고, 겹친 곳의 세 송이가 틀린 것이다. ROC 곡선은 왼쪽 위 모서리에 거의 붙어 있다. 경계를 조금 움직이면 거짓양성 하나를 참양성 하나와 바꿀 수 있다. 어느 쪽이 나은지는 데이터가 아니라 두 오류의 비용이 정한다(따름정리 5.3).
📝 연습 5.1–5.4, 6.1–6.2 (강의노트): Bayes 검정의 임계값, 판별의 오류율, 이차판별, minimax 검정, 판별 방향의 해석, 같은 자료로 재면.
7. 부숴보기 — -값이 말하지 않는 것
예제 7.1 A/B 테스트의 0.1%포인트: , · 예제 7.2 Lindley의 역설: 같은 이 에서는 .
python
# 예제 7.1 · 연습 7.1: 효과는 작고 표본은 크다
def ab_test(pa, pb, n):
    se = math.sqrt(pa * (1 - pa) / n + pb * (1 - pb) / n); d = pb - pa
    return d / se, 2 * stats.norm.sf(d / se), (d - 1.96 * se, d + 1.96 * se)
z_big, p_big, ci_big = ab_test(0.100, 0.101, 1_000_000)
z_small, p_small, ci_small = ab_test(0.100, 0.101, 10_000)
# 실제로 자료를 만들어 보면 (참 차이 0.001)
g = np.random.default_rng(2016)
clicks = g.binomial(1_000_000, [0.100, 0.101], size=(2000, 2)) / 1_000_000
z_sim = (clicks[:, 1] - clicks[:, 0]) / math.sqrt(2 * 0.1 * 0.9 / 1_000_000)
print(f"100만 명씩: z = {z_big:.2f}, p = {p_big:.3f}, 95% 구간 [{ci_big[0]:.4f}, {ci_big[1]:.4f}];  1만 명씩: z = {z_small:.2f}, 구간 [{ci_small[0]:.4f}, {ci_small[1]:.4f}]")
print(f"시뮬레이션: 참 차이 0.1%포인트, 100만 명씩이면 {np.mean(np.abs(z_sim) > 1.96):.0%} 가 유의")
report({"예제 7.1: z = 2.35, p = 0.019, 구간 [0.0002, 0.0018]": abs(z_big - 2.35) < 0.005 and abs(p_big - 0.019) < 5e-4 and np.allclose(ci_big, (0.0002, 0.0018), atol=5e-5),
        "연습 7.1: 1만 명씩이면 z = 0.24, 구간 [−0.0073, 0.0093]": abs(z_small - 0.24) < 0.005 and np.allclose(ci_small, (-0.0073, 0.0093), atol=5e-5)})
text
100만 명씩: z = 2.35, p = 0.019, 95% 구간 [0.0002, 0.0018];  1만 명씩: z = 0.24, 구간 [-0.0073, 0.0093]
시뮬레이션: 참 차이 0.1%포인트, 100만 명씩이면 66% 가 유의
  ✓  예제 7.1: z = 2.35, p = 0.019, 구간 [0.0002, 0.0018]
  ✓  연습 7.1: 1만 명씩이면 z = 0.24, 구간 [−0.0073, 0.0093]
python
# 예제 7.2 · 연습 7.2: Lindley 의 역설 — z = 2 를 고정하고 n 을 키운다
def bayes_factor01(z, n, tau2=1.0):
    return math.sqrt(1 + n * tau2) * math.exp(-z**2 / 2 * n * tau2 / (1 + n * tau2))

def bf_numeric(xbar, n, tau2=1.0):
    """연습 7.2 의 유도를 수치적분으로: f(x̄|H1) = ∫ φ(x̄; μ, 1/n) φ(μ; 0, τ²) dμ"""
    h = 12 / math.sqrt(n)                                                    # 피적분함수는 x̄ 둘레 폭 1/√n 의 뾰족한 봉우리
    f1 = integrate.quad(lambda m: stats.norm.pdf(xbar, m, 1 / math.sqrt(n)) * stats.norm.pdf(m, 0, math.sqrt(tau2)), xbar - h, xbar + h, limit=400)[0]
    return stats.norm.pdf(xbar, 0, 1 / math.sqrt(n)) / f1

rows = []
for n in (100, 10_000, 1_000_000):
    b = bayes_factor01(2.0, n)
    rows.append(dict(n=n, xbar=2 / math.sqrt(n), BF01=b, numeric=bf_numeric(2 / math.sqrt(n), n), P_H0=b / (1 + b)))
lind = pd.DataFrame(rows).set_index("n")
print(lind.to_string(float_format=lambda v: f"{v:.4g}"))
report({"예제 7.2: B01 = 1.4, 13.5, 135": np.allclose(lind.BF01, [1.387, 13.54, 135.3], rtol=2e-3),
        "연습 7.2: 닫힌 꼴 = 수치적분": np.allclose(lind.BF01, lind.numeric, rtol=1e-6),
        "예제 7.2: n = 10⁶ 에서 P(H0 | x) = 0.993 (사전확률 반반), 그런데 p = 0.046": abs(lind.P_H0.iloc[-1] - 0.993) < 5e-4 and abs(2 * stats.norm.sf(2.0) - 0.0455) < 1e-4})
text
         xbar  BF01  numeric   P_H0
n
100       0.2 1.387    1.387 0.5811
10000    0.02 13.54    13.54 0.9312
1000000 0.002 135.3    135.3 0.9927
  ✓  예제 7.2: B01 = 1.4, 13.5, 135
  ✓  연습 7.2: 닫힌 꼴 = 수치적분
  ✓  예제 7.2: n = 10⁶ 에서 P(H0 | x) = 0.993 (사전확률 반반), 그런데 p = 0.046
📝 연습 7.1–7.3 (강의노트): 구간으로 보고하기, Lindley의 Bayes 인수, -값의 오독.
8. Beautiful insights — ROC와 멈출 수 있는 검정
8.1절 가능도비의 ROC가 모든 점수의 ROC보다 위에 있다, AUC = Mann–Whitney · 8.2절 엿보기의 함정과 혼합 SPRT (Ville의 부등식).
python
# 8.1절 · 연습 8.1: 가능도비의 ROC 가 위에 있다 — f0 = N(0,1), f1 = N(1, 2²) 이면 가능도비는 x 에 단조가 아니다
g = np.random.default_rng(1)
x0 = g.normal(0, 1, 200_000); x1 = g.normal(1, 2, 200_000)
llr = lambda x: stats.norm.logpdf(x, 1, 2) - stats.norm.logpdf(x, 0, 1)
def roc(s0, s1, grid):
    return np.array([np.mean(s0 > t) for t in grid]), np.array([np.mean(s1 > t) for t in grid])
f_raw, t_raw = roc(x0, x1, np.linspace(-8, 10, 600))
f_llr, t_llr = roc(llr(x0), llr(x1), np.linspace(-3, 30, 600))
# 같은 크기에서 비교: 크기 0.05, 0.1, 0.2
def power_at(fpr, tpr, a):
    ok = fpr <= a
    return tpr[ok].max()
cmp = {a: (power_at(f_raw, t_raw, a), power_at(f_llr, t_llr, a)) for a in (0.05, 0.1, 0.2)}
auc_raw = np.trapezoid(t_raw[::-1], f_raw[::-1]); auc_llr = np.trapezoid(t_llr[::-1], f_llr[::-1])
print({a: f"x 자체 {r:.3f} 대 가능도비 {l:.3f}" for a, (r, l) in cmp.items()}, f";  AUC {auc_raw:.3f} 대 {auc_llr:.3f}")
report({"연습 8.1: 같은 크기에서 가능도비 점수의 검정력이 x 자체보다 크다": all(l >= r - 0.003 for r, l in cmp.values()) and cmp[0.05][1] > cmp[0.05][0] + 0.01,
        "8.1절: 가능도비의 AUC 가 더 크다": auc_llr > auc_raw})
text
{0.05: 'x 자체 0.372 대 가능도비 0.400', 0.1: 'x 자체 0.442 대 가능도비 0.475', 0.2: 'x 자체 0.527 대 가능도비 0.574'} ;  AUC 0.673 대 0.744
  ✓  연습 8.1: 같은 크기에서 가능도비 점수의 검정력이 x 자체보다 크다
  ✓  8.1절: 가능도비의 AUC 가 더 크다
python
# 8.2절: 엿보기 대 혼합 SPRT — 귀무가설이 참일 때 (표준정규), 1만 개까지 관측마다 본다
gp = np.random.default_rng(2017)
R, nmax, tau2 = 2000, 10_000, 0.01
Zs = gp.standard_normal((R, nmax)); Ssum = np.cumsum(Zs, axis=1); nn = np.arange(1, nmax + 1)
peek_every = (np.abs(Ssum / np.sqrt(nn))[:, 9:] > 1.96).any(1).mean()
looks = np.arange(99, nmax, 100)
peek_100 = (np.abs(Ssum[:, looks] / np.sqrt(looks + 1)) > 1.96).any(1).mean()
logM = -0.5 * np.log1p(nn * tau2) + tau2 * Ssum**2 / (2 * (1 + nn * tau2))
fpr_msprt = (logM >= math.log(20)).any(1).mean()
# 효과 0.05 (표준편차 단위) 가 있을 때 혼합 SPRT 의 검정력과 멈추는 시점
Z1 = gp.standard_normal((R, nmax)) + 0.05; S1 = np.cumsum(Z1, axis=1)
logM1 = -0.5 * np.log1p(nn * tau2) + tau2 * S1**2 / (2 * (1 + nn * tau2))
hit = logM1 >= math.log(20)
power_msprt = hit.any(1).mean(); stop_med = np.median(hit.argmax(1)[hit.any(1)] + 1)
# Ville: 같은 혼합 마틴게일이 c 를 넘을 확률 ≤ 1/c (c = 5, 10, 20)
ville = {c: (logM >= math.log(c)).any(1).mean() for c in (5, 10, 20)}
print(f"엿보기: 100개마다 {peek_100:.3f}, 관측마다 {peek_every:.3f};  혼합 SPRT 거짓양성 {fpr_msprt:.3f};  효과 0.05: 검정력 {power_msprt:.3f}, 멈춤의 중앙값 {stop_med:.0f}")
print("Ville: P(sup M ≥ c) =", {c: round(float(v), 3) for c, v in ville.items()})
report({"8.2절: 100개마다 엿보면 38%, 관측마다 59% 가 거짓 유의": abs(peek_100 - 0.38) < 0.03 and abs(peek_every - 0.59) < 0.03,
        "8.2절: 혼합 SPRT 의 거짓양성 ≤ 0.05 (약 4%)": fpr_msprt <= 0.05 + 2 * math.sqrt(0.05 * 0.95 / R) and abs(fpr_msprt - 0.04) < 0.01,
        "8.2절: 효과 0.05 면 1만 개 안에 약 98% 기각, 멈춤의 중앙값 약 2,900": abs(power_msprt - 0.98) < 0.015 and abs(stop_med - 2900) < 300,
        "연습 8.3 (Ville): P(sup M_n ≥ c) ≤ 1/c (c = 5, 10, 20)": all(v <= 1 / c + 2 * math.sqrt(1 / c / R) for c, v in ville.items())})

fig, axes = plt.subplots(1, 2, figsize=(11, 3.5))
for i in range(30):
    axes[0].plot(nn[::20], (Ssum[i] / np.sqrt(nn))[::20], color=C["stat"], lw=0.5, alpha=0.6)
axes[0].axhline(1.96, **THEORY); axes[0].axhline(-1.96, **THEORY); axes[0].set_xscale("log")
axes[0].set_title(f"peeking at z: {peek_every:.0%} cross ±1.96"); axes[0].set_xlabel("n")
for i in range(30):
    axes[1].plot(nn[::20], np.exp(logM[i, ::20]), color=C["key"], lw=0.5, alpha=0.6)
axes[1].axhline(20, **THEORY); axes[1].set_xscale("log"); axes[1].set_yscale("log")
axes[1].set_title(f"mixture SPRT: {fpr_msprt:.1%} cross 1/α = 20"); axes[1].set_xlabel("n")
plt.tight_layout(); plt.show()
text
엿보기: 100개마다 0.379, 관측마다 0.596;  혼합 SPRT 거짓양성 0.041;  효과 0.05: 검정력 0.975, 멈춤의 중앙값 2849
Ville: P(sup M ≥ c) = {5: 0.16, 10: 0.081, 20: 0.041}
  ✓  8.2절: 100개마다 엿보면 38%, 관측마다 59% 가 거짓 유의
  ✓  8.2절: 혼합 SPRT 의 거짓양성 ≤ 0.05 (약 4%)
  ✓  8.2절: 효과 0.05 면 1만 개 안에 약 98% 기각, 멈춤의 중앙값 약 2,900
  ✓  연습 8.3 (Ville): P(sup M_n ≥ c) ≤ 1/c (c = 5, 10, 20)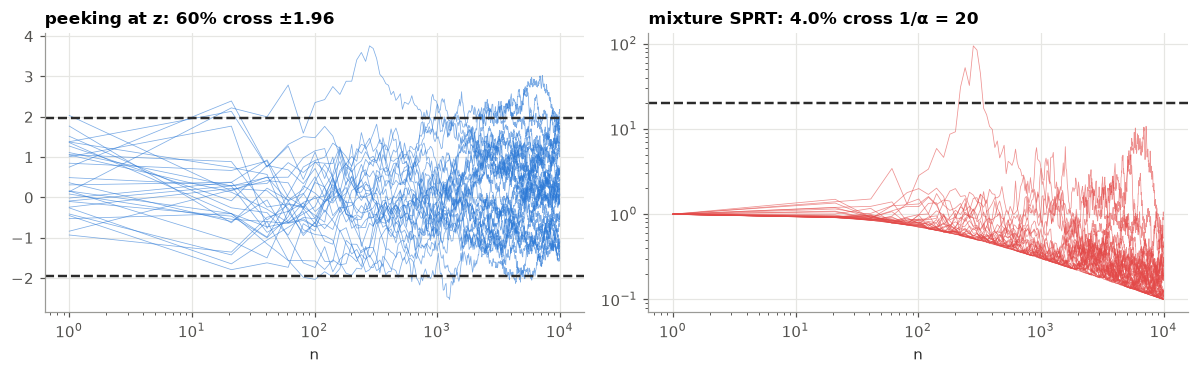
그림 읽기. 왼쪽: 귀무가설이 참이어도 통계량의 경로는 언젠가 을 넘는다(반복 로그의 법칙). 관측마다 보며 "유의해지면 멈추기"를 하면 1만 개 안에 60% 가까이가 거짓 발견이다. 오른쪽: 혼합 SPRT의 은 평균 1인 마틴게일이어서 대부분 1 아래로 가라앉고, 20을 넘는 경로는 5% 미만이다. 언제 보든 언제 멈추든 크기가 지켜진다.
📝 연습 8.1–8.3 (강의노트): 가능도비의 ROC, AUC와 순위, Ville의 부등식.
9. 정리 · 연습문제 지도 · 다음 회
| 내용 | 확인한 셀 | |
|---|---|---|
| Neyman–Pearson (1.1–1.5) | np_test와 선형계획법의 일치, Poisson의 확률화 (γ = 0.501), Cauchy의 유계 기각역, 균등의 여러 최강력 검정 |
1절 |
| UMP (2.1–2.5) | 이항의 UMP가 에 무관, 검정력의 단조성, 양쪽 가설의 반례, 기병대의 한쪽 검정 () | 2절 |
| LRT (3.1–3.2) | 수치 최적화로 만든 = , , 두 지수분포 | 3절 |
| SPRT (4.1–4.4) | SPRT: 평균 표본수 42·61·39 대 고정 77, 실제 오류율, Wald의 등식과 엿본 의 반례 |
4절 |
| 결정이론 (5.1–5.6) | Bayes·minimax 검정, LDA = Bayes 분류기, Fisher의 기준의 수치 최대화, |
5절 |
| 붓꽃 (6) | 3/150 (leave-one-out도 3), , , ROC·AUC 0.997 | 5절 |
| 부숴보기 (7) | A/B의 와 구간, Lindley의 | 7절 |
| 오늘 (8) | 가능도비 ROC의 우월, 엿보기 59% 대 혼합 SPRT 4%, Ville | 8절 |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 1 Neyman–Pearson | 1.1 ★ · 1.2 ★ · 1.3 Cauchy ★★ · 1.4 균등 ★★ · 1.5 최강력 검정의 성질 증명 ★★ (유도형) | 1절 |
| 2 UMP | 2.1 ★ · 2.2 ★★ · 2.3 기병대 ★ · 2.4 불편성 ★★ | 2절 |
| 3 LRT | 3.1 ★★ · 3.2 ★★ · 3.3 ★ | 3절 |
| 4 SPRT | 4.1 Wald의 등식 ★★ · 4.2 ★★ · 4.3 멈출 확률 ★★★ · 4.4 ★ | 4절 |
| 5 결정이론 | 5.1 ★ · 5.2 ★★ · 5.3 ★ · 5.4 minimax ★★ · 5.5 Bayes 검정 ★ · 5.6 Bayes 분류기 ★ · 5.7 Fisher의 기준 ★★ (유도형) | 5절 |
| 6 붓꽃 | 6.1 ★ · 6.2 ★ | 5절 |
| 7 부숴보기 | 7.1 ★ · 7.2 Lindley ★★ · 7.3 ★ | 7절 |
| 8 오늘 | 8.1 ROC ★★ · 8.2 AUC ★ · 8.3 Ville ★★★ | 5·8절 |
다음 회 (13회) — 최소제곱: Legendre–Gauss에서 Gauss–Markov까지 (1749 → 1943). 관측이 다른 변수의 일차함수에 오차가 더해진 것이라는 선형모형으로 넘어간다. Mayer의 달 관측(미지수 3개에 방정식 27개)에서 출발해 최소제곱을 사영의 기하로 다시 세우고, Gauss–Markov 정리와 · 검정을 증명한다. 이번 회차의 가능도비 검정이 거기서 검정이 된다.
10. 워크북 검산
워크북(12_optimal_tests_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A2b", 답)— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(0.271,"39/400")나 식의 문자열("log(10/9)")로 넣는다. 소문항은"A3c"처럼 번호 뒤에 붙인다. 정규분포표나 표에서 읽은 값은 문항마다 정한 허용오차(대개 0.5%) 안이면 맞다고 본다.- 시뮬레이션으로 한 번 더 — 검정의 크기와 검정력, 기대 탈출 시각, 위험이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 임계값을 넣으면 그 검정의 크기와 검정력을 Monte Carlo로 돌려준다. 함수는 정의만 해 두었고 부르지 않았다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A2b")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A1c A2a A2b A3a A3b A3c A3d A4 A5b A5c A6a A6b A7a A7b A8 A9a A9b A9c A10a A10b A10c A11a A11b A12a A12b A12c A12d A13a A13b A14a A14b A14c C3 C4 C5 C8b C8c D1a D1b D2a D2b D3a D3b D3c D3d D3e D3f D4a D4b D4c
A2b: 아직 답을 넣지 않았다. 예: check('A2b', '3/8')
10.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A1c": None, "A2a": None, "A2b": None,
    "A3a": None, "A3b": None, "A3c": None, "A3d": None, "A4": None, "A5b": None, "A5c": None,
    "A6a": None, "A6b": None, "A7a": None, "A7b": None, "A8": None, "A9a": None, "A9b": None, "A9c": None,
    "A10a": None, "A10b": None, "A10c": None, "A11a": None, "A11b": None,
    "A12a": None, "A12b": None, "A12c": None, "A12d": None, "A13a": None, "A13b": None,
    "A14a": None, "A14b": None, "A14c": None,
    "C3": None, "C4": None, "C5": None, "C8b": None, "C8c": None,
    "D1a": None, "D1b": None, "D2a": None, "D2b": None,
    "D3a": None, "D3b": None, "D3c": None, "D3d": None, "D3e": None, "D3f": None,
    "D4a": None, "D4b": None, "D4c": None,
}
check_all(mine)
text
0/0 맞음10.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)(또는 그 쌍)를 돌려준다. 손으로 구한 임계값을 인자로 넣고, 손으로 구한 크기와 검정력이 추정값 ± 3 × 표준오차 안에 드는지 본다.
| 함수 | 문항 | 돌려주는 것 |
|---|---|---|
sim_A1(c, gamma) |
A1 베르누이 | 확률화 검정의 (크기, 검정력) |
sim_A2(c) |
A2 지수 관측 하나 | (크기, 검정력) |
sim_A6(c) |
A6 지수 평균 | 의 크기, 의 검정력 |
sim_A13() |
A13 ROC | AUC |
sim_C3(theta) |
C3 균등 양쪽 검정 | 의 검정력 |
sim_C4(n) |
C4 균등의 가능도비 | 로 맞춘 검정의 실제 크기 |
sim_C5(a, b) |
C5 대칭 걸음 | 탈출 시각의 평균 |
sim_D1(c, theta) |
D1 이동한 지수 | 검정력 |
sim_D2() |
D2 두 Poisson | |
sim_D4(t) |
D4 비용이 있는 분류 | Bayes 위험 |
python
def _mean_se(x):
    x = np.asarray(x, dtype=float)
    return x.mean(), x.std(ddof=1) / np.sqrt(len(x))


def sim_A1(c, gamma, n=N_SIM):
    def reject(p):
        t = rng.binomial(10, p, size=n)
        return (t >= c) | ((t == c - 1) & (rng.random(n) < gamma))
    return _mean_se(reject(0.2)), _mean_se(reject(0.5))


def sim_A2(c, n=N_SIM):
    return _mean_se(rng.exponential(1.0, n) < c), _mean_se(rng.exponential(1 / 3, n) < c)


def sim_A6(c, n=N_SIM):
    def reject(theta):
        return rng.exponential(theta, size=(n, 10)).sum(axis=1) > c
    return _mean_se(reject(2.0)), _mean_se(reject(4.0))


def sim_A13(n=N_SIM):
    return _mean_se(rng.normal(1, 1, n) > rng.normal(0, 1, n))


def sim_C3(theta, n_obs=5, alpha=0.05, n=N_SIM):
    mx = (rng.random((n, n_obs)) * theta).max(axis=1)
    return _mean_se((mx > 1) | (mx <= alpha ** (1 / n_obs)))


def sim_C4(n_obs=10, n=N_SIM):
    mx = rng.random((n, n_obs)).max(axis=1)              # θ0 = 1
    return _mean_se(-2 * n_obs * np.log(mx) > stats.chi2(1).isf(0.05))


def sim_C5(a, b, n=40_000):
    s = np.zeros(n, dtype=int)
    steps = np.zeros(n, dtype=int)
    alive = np.ones(n, dtype=bool)
    while alive.any():
        s[alive] += np.where(rng.random(alive.sum()) < 0.5, 1, -1)
        steps[alive] += 1
        alive &= (s > -a) & (s < b)
    return _mean_se(steps)


def sim_D1(c, theta, n_obs=10, n=N_SIM):
    mn = (theta + rng.exponential(1.0, size=(n, n_obs))).min(axis=1)
    return _mean_se(mn > c)


def sim_D2(n=1_000_000):
    x, y = rng.poisson(8, n), rng.poisson(8, n)              # H0 아래 공통 λ 는 아무 값이나 된다
    keep = (x + y) == 16
    return _mean_se(x[keep] >= 12)


def sim_D4(t, n=N_SIM):
    group = rng.random(n) < 0.2                              # True = 무리 1
    x = rng.normal(np.where(group, 2.0, 0.0), 1.0)
    loss = np.where(group, 5.0 * (x <= t), 1.0 * (x > t))
    return _mean_se(loss)
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

(_s1, _p1) = sim_A1(int(_value("A1a")), _value("A1b"))
assert abs(_s1[0] - 0.05) <= 4 * _s1[1] and _close(_p1, "A1c")
(_s2, _p2) = sim_A2(_value("A2a"))
assert abs(_s2[0] - 0.1) <= 4 * _s2[1] and _close(_p2, "A2b")
(_s6, _p6) = sim_A6(_value("A6a"))
assert abs(_s6[0] - 0.05) <= 4 * _s6[1] and _close(_p6, "A6b")
assert _close(sim_A13(), "A13b")
assert _close(sim_C3(0.8), "C3")
assert _close(sim_C4(), "C4")
assert _close(sim_C5(3, 5), "C5")
assert _close(sim_D1(_value("D1a"), 0.2), "D1b")
assert _close(sim_D2(), "D2b")
assert _close(sim_D4(_value("D4a")), "D4b")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))