E1 · 회귀에서 변수를 통제하고 관측을 빼는 계산#
1. 네 관측을 한 직선으로 설명하기#
활동량 \(t=(0,1,2,3)^T\)에서 산출량 \(y=(1,2,2,5)^T\)를 관측했다고 합시다. 활동량과 산출량은 각각 정한 기준 단위의 수치이며 네 관측은 교육용 자료입니다. \(y_i\approx a+bt_i\)라는 직선으로 요약하려고 합니다. 이 장의 사영·삭제 공식은 고정된 자료의 대수이며, 분산을 말할 때만 확률모형을 별도로 붙입니다.
정규방정식은 \(4a+6b=10\), \(6a+14b=21\)입니다. 첫 식에 \(3/2\)를 곱해 둘째 식에서 빼면 \(5b=6\)이므로 \(b=6/5\). 다시 첫 식에 넣어 \(a=7/10\)을 얻습니다.
잔차의 합은 \((3+1-11+7)/10=0\), 활동량과의 내적도 \((0+1-22+21)/10=0\)입니다. 잔차제곱합은 \((9+1+121+49)/100=9/5\)입니다. 두 직교식 때문에 어떤 계수 변화 \(d\)를 더해도
입니다. 이 항등식이 최소제곱의 최적성을 설명합니다.
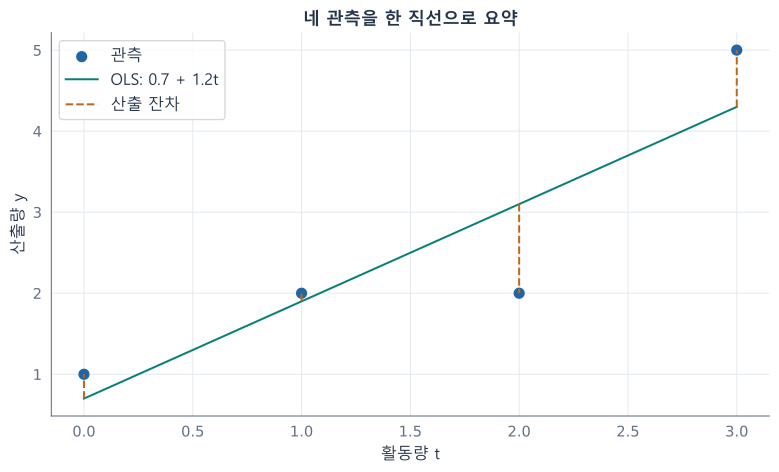
그림 131 세로 선분은 관측 산출량과 적합값의 차이이다. 이 평면에서 직선까지의 최단거리를 최소화하는 것이 아니라 산출 좌표의 잔차제곱합을 최소화한다. 직교사영이 일어나는 공간은 아래에서 다루는 관측값 공간 \(\mathbb R^4\)이다.#
2. 계수의 이름이 바뀌어도 적합값은 같다#
이 자료의 사영행렬은
첫 적합값은 \((7\cdot1+4\cdot2+1\cdot2-2\cdot5)/10=7/10\)입니다. 대칭행렬이지만 모든 성분이 비음수인 평균행렬은 아닙니다. \(P^2=P\), \(P^T=P\)이며 상은 \(\operatorname{col}X\)입니다. 잔차를 만드는 \(M=I-P\)도 직교사영이고 그 상은 \(\ker X^T\)입니다.
활동량을 \(s=t-3/2\)로 중심화하면 같은 직선을 \(5/2+(6/5)s\)로 씁니다. 절편 숫자는 바뀌었지만 적합값과 잔차는 같습니다. 일반적으로 가역 \(B\)에 \(XB\)와 \(X\)는 같은 열공간을 생성하므로 사영행렬이 같습니다. 계수는 \(B^{-1}\widehat\beta\)로 바뀝니다.
사영의 대각합은 \(7/10+3/10+3/10+7/10=2\)입니다. 이는 열공간 차원과 같습니다. 잔차공간은 차원 \(4-2=2\)입니다. 자유도는 단순히 식에 적힌 문자 개수가 아니라 사용한 공간의 차원입니다. 열이 중복되면 열 수 대신 계수를 세어야 합니다.
3. 변수를 추가하면 제곱오차가 줄어드는 이유#
절편만 쓰는 공간 \(S=\operatorname{span}\{\mathbf1\}\)는 직선 공간 \(T=\operatorname{span}\{\mathbf1,t\}\) 안에 있습니다. 절편만 쓴 적합은 \(\bar y=5/2\)이고 제곱오차는
직선으로 바꾸면 \(9/5\)이므로 줄어든 양은 \(36/5\)입니다. \(P_T-P_S\)는 \(T\cap S^\perp\) 위의 직교사영이므로
설명변수를 추가했을 때 표본 내 잔차제곱합이 감소하는 것은 이 대수의 결과입니다. 새 변수의 인과적 타당성이나 새 표본의 예측 개선을 뜻하지는 않습니다. 절편이 있고 중심화 총제곱합이 양수이면 \(R^2=1-\|e\|^2/\|y-\bar y\mathbf1\|^2\)도 단조 증가합니다. 이 예에서는 \(R^2=1-(9/5)/9=4/5\)입니다.
4. 통제변수의 성분을 먼저 빼는 FWL#
\(X=[X_1\ X_2]\)가 완전 열계수라고 합시다. \(X_1\)은 이미 통제할 변수, \(X_2\)는 계수를 알고 싶은 변수입니다. \(P_1\)은 \(X_1\)의 사영, \(M_1=I-P_1\)입니다. 첫 정상방정식에서
를 구해 둘째 식에 대입하면
따라서 \(\widetilde y=M_1y\)를 \(\widetilde X_2=M_1X_2\)에 회귀해도 \(\widehat\beta_2\)가 같습니다. 결과변수뿐 아니라 관심 설명변수에서도 통제변수 성분을 빼야 합니다. 처음 예에서 \(X_1=\mathbf1\)이면 \(\widetilde t=(-3/2,-1/2,1/2,3/2)^T\), \(\widetilde y=(-3/2,-1/2,-1/2,5/2)^T\)이고
기울기는 다시 \(6/5\)입니다. 이는 E0의 모집단 FWL의 기댓값 내적을 표본 내적으로 바꾼 계산입니다.
지역을 통제하는 경우도 직접 계산할 수 있습니다. 두 지역의 활동량을 \((0,1)\)과 \((2,4)\), 산출량을 \((1,2)\)와 \((3,6)\)으로 정합니다. 지역별 평균을 빼면
분자는 \(1/4+1/4+3/2+3/2=7/2\), 분모는 \(1/4+1/4+1+1=5/2\)라 기울기는 \(7/5\)입니다. 각 지역의 절편은 평균 산출에서 기울기 곱 평균 활동을 빼어 \(4/5,3/10\)입니다. 지역 사이 평균 차이는 기울기의 근거에서 제외되고 지역 안의 활동 변동만 남았습니다.
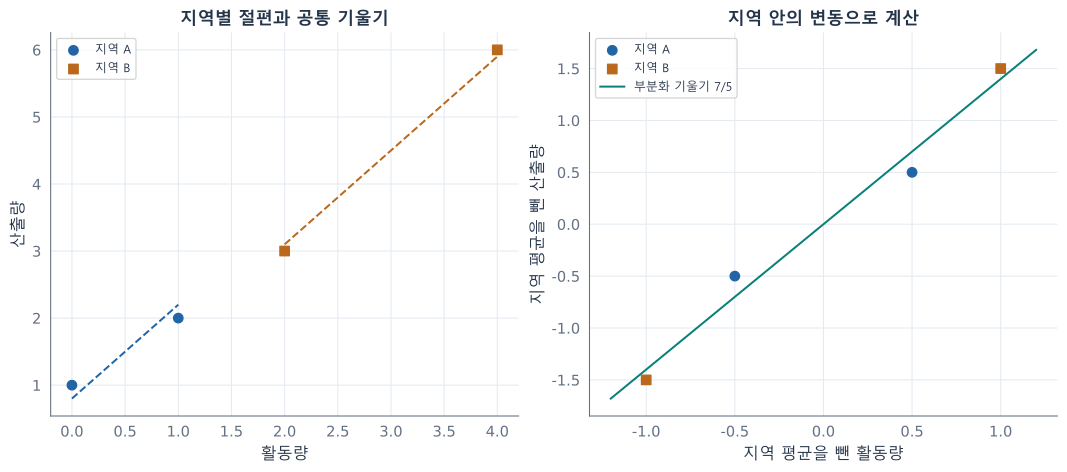
그림 132 색과 기호가 두 지역을 구별한다. 오른쪽의 각 지역 중심은 원점으로 이동하며 기울기 7/5는 지역 내 변동으로 계산한다. 두 패널의 가로·세로 축은 각각 같은 단위를 사용하고 표시 범위는 중심화에 맞춰 다르다.#
5. 계수가 같아도 표준오차 계산은 끝나지 않았다#
이제 \(y=X\beta+u\), \(E[u\mid X]=0\), \(\operatorname{Var}(u\mid X)=\sigma^2I\)를 가정합니다. 이 장의 분산식은 \(X\)를 고정하거나 조건부로 본 결과입니다. FWL 계수의 분산은
하지만 잔차화한 오차는 \(M_1u\)로 공분산이 \(\sigma^2M_1\)입니다. 독립 관측 \(n\)개가 새로 생긴 것이 아닙니다. 공통 잔차 \(e\)에 쓰는 불편 분산추정량은 \(s^2=\|e\|^2/(n-k)\), \(k=\operatorname{rank}X\)입니다.
처음 예에서 \(s^2=(9/5)/2=9/10\)이고 기울기 표준오차는 \(\sqrt{(9/10)/5}=3/\sqrt{50}\)입니다. 중심화 회귀를 절편 없는 하나의 변수 회귀로만 보고 분모를 \(4-1=3\)으로 쓰면 \(s^2=3/5\)가 되어 작게 추정합니다. 통제변수에 쓴 차원도 세어야 합니다.
QR은 이 부분화를 순차적으로 수행합니다. 먼저 \(q_1=\mathbf1/2\)로 상수 성분을 제거하고, \(q_2=(t-3\mathbf1/2)/\sqrt5\)로 남은 활동 성분을 정규화합니다. \(P=q_1q_1^T+q_2q_2^T\)입니다. 일반 QR의 각 열도 앞 열들이 설명한 부분을 뺀 뒤 만든 직교 좌표이며, 원래 계수는 삼각계 \(R\widehat\beta=Q^Ty\)로 복원합니다. 순차 제곱합은 비직교 설명변수의 순서에 의존할 수 있지만 전체 공간의 적합은 같습니다.
6. 계수가 유일하지 않을 때 무엇을 추정할 수 있는가#
절편과 두 지역의 더미를 모두 넣으면 \(X=[\mathbf1,d_A,d_B]\)이고 \(\mathbf1=d_A+d_B\)입니다. 계수에 \(c(1,-1,-1)^T\)를 더해도 적합값이 바뀌지 않습니다. 따라서 절편 하나만의 값은 자료로 구별할 수 없습니다. 반면 지역 A의 예측평균 \(\beta_0+\beta_A\)와 지역 차이 \(\beta_B-\beta_A\)는 이 변화에 영향을 받지 않습니다.
일반적으로 \(a^T\beta\)가 모든 동등한 계수에서 같을 필요충분조건은 \(a\perp\ker X\), 곧 \(a\in\operatorname{ran}X^T\)입니다. 이것을 추정가능한 선형함수라 합니다. \(a=X^Tw\)이면 \(w^Ty\)가 불편추정량입니다. 서로 다른 일반화역으로 구한 최소제곱해의 \(a^T\widehat\beta\)는 같습니다. 모든 불편추정량 자체가 같다는 뜻은 아닙니다.
최소노름 해를 택하는 여러 SVD 라이브러리는 서로 같은 계수를 반환할 수 있습니다. 계수결핍이라고 구현마다 반드시 다른 값이 나오는 것은 아닙니다. 해의 비유일성을 보이려면 핵 벡터를 직접 더하면 됩니다.
import numpy as np
import scipy.linalg as la
t=np.arange(4.);y=np.array([1.,2.,2.,5.])
X=np.column_stack([np.ones(4),t]);Q,R=la.qr(X,mode='economic')
b=la.solve_triangular(R,Q.T@y);P=Q@Q.T;e=y-X@b
assert np.allclose(b,[.7,1.2]) and np.isclose(e@e,1.8)
tc=t-t.mean();yc=y-y.mean()
assert np.isclose(tc@yc/(tc@tc),b[1])
B=np.array([[1.,-1.5],[0.,1.]])
Q2=la.qr(X@B,mode='economic')[0]
assert np.allclose(P,Q2@Q2.T)
D=np.column_stack([np.ones(4),[1,1,0,0],[0,0,1,1]])
bd=la.lstsq(D,y)[0];other=bd+np.array([2.,-2.,-2.])
assert np.allclose(D@bd,D@other)
assert np.isclose(np.array([0.,-1.,1.])@bd,np.array([0.,-1.,1.])@other)
print('사영·중심화 FWL·재모수화·추정가능함수 확인')
사영·중심화 FWL·재모수화·추정가능함수 확인
7. 한 관측을 빼면 직선은 얼마나 바뀔까#
\(h_i=P_{ii}\)를 레버리지라 부릅니다. 처음 예에서는 \((7,3,3,7)/10\)입니다. \(\sum h_i=k\), \(0\le h_i\le1\)이며 레버리지는 \(X\)만으로 결정됩니다. 반응 \(y\)가 바뀌어도 같으므로 큰 잔차와 같은 개념이 아닙니다.
관측 \(i\)를 제거한 설계가 여전히 완전 열계수이고 \(x_i^T\)가 \(X\)의 \(i\)번째 행이면
네 삭제 예측오차는 \((1,1/7,-11/7,7/3)\)입니다. 따라서
마지막 관측의 전체 적합 잔차는 \(7/10\)이지만 삭제 후 예측오차는 \(7/3\)입니다. 그 관측이 포함된 상태의 좋은 적합만으로 외부 예측을 평가할 수 없는 이유입니다. \(h_i=1\)이면 그 관측을 빼면서 계수가 줄어 공식의 분모가 0이 됩니다. 이는 작은 분모를 임의로 잘라 해결할 문제가 아닙니다.
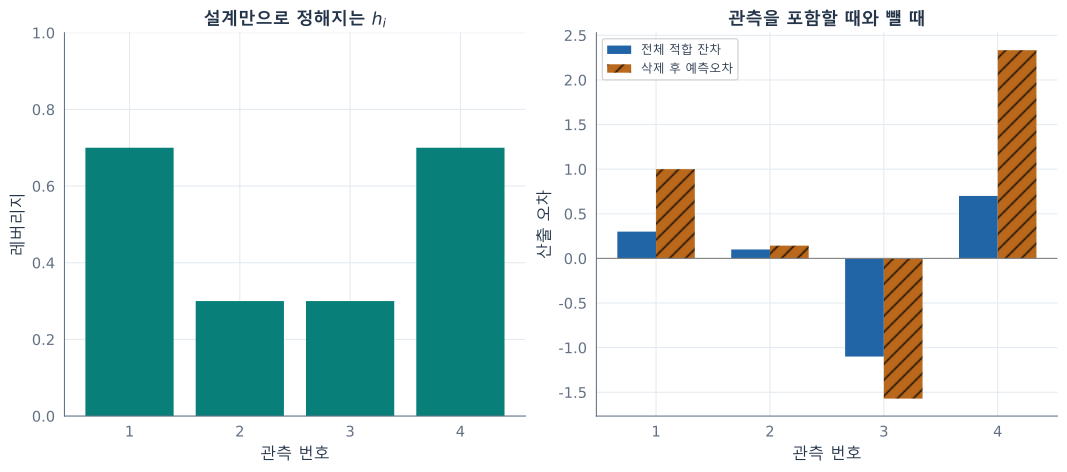
그림 133 레버리지는 설계의 성질이며 잔차는 반응에도 의존한다. 오른쪽 두 막대는 같은 산출 단위로 표시했다. 끝점의 삭제오차가 커지는 이유는 본문의 \(1-h_i\) 분모로 계산한다.#
h=np.sum(Q*Q,axis=1)
loo=[]
for i in range(4):
    keep=np.arange(4)!=i
    bi=la.lstsq(X[keep],y[keep])[0]
    loo.append(y[i]-X[i]@bi)
assert np.allclose(loo,e/(1-h))
assert np.isclose(np.dot(loo,loo),3940/441)
J=np.array([0,1]);keep=np.array([2,3])
deleted=la.lstsq(X[keep],y[keep])[0]
block=la.solve(np.eye(2)-P[np.ix_(J,J)],e[J])
assert np.allclose(y[J]-X[J]@deleted,block)
print('명시적 재적합과 LOO·블록 삭제 공식 일치:',loo)
명시적 재적합과 LOO·블록 삭제 공식 일치: [np.float64(1.0000000000000007), np.float64(0.1428571428571428), np.float64(-1.571428571428572), np.float64(2.333333333333334)]
단일 관측 삭제는 rank-one 갱신, 집합 \(J\) 삭제는 rank-\(|J|\) 갱신입니다. 블록 예측오차는 \((I-P_{JJ})^{-1}e_J\)이며 남은 설계가 완전 열계수일 때만 정의됩니다. 모든 LOO를 빠르게 계산할 수 있지만 계산비용이 항상 \(O(k^2)\)뿐인 것은 아닙니다. 최초 QR에 대략 \(O(nk^2)\), 레버리지와 모든 예측오차의 출력에도 \(n\)에 의존하는 비용이 듭니다.
8. 레버리지 보정과 재표집에서 남는 조건#
등분산 모형에서 \(E[e_i^2\mid X]=\sigma^2(1-h_i)\)입니다. 잔차를 오차 자체처럼 쓰면 분산을 작게 측정합니다. \(S=X^TX\)라 할 때 HC 계열 공분산 추정량은
꼴이고, HC0는 \(\omega_i=e_i^2\), HC1은 \(ne_i^2/(n-k)\), HC2는 \(e_i^2/(1-h_i)\), HC3는 \(e_i^2/(1-h_i)^2\)를 씁니다. HC2의 등분산 불편성은 위 기대식에서 나오며, 일반 이분산에서 유한표본 정확 검정을 보장하지는 않습니다. HC3의 분모는 LOO 잔차와 연결됩니다.
고정 설계의 wild 재표집은 \(y_i^*=x_i^T\widehat\beta+\widetilde e_i v_i\)로 반응을 바꿉니다. 여기서 독립 승수는 \(E^*v_i=0\), \(E^*v_i^2=1\)입니다. 계수 변화는 \(S^{-1}\sum_i x_i\widetilde e_i v_i\)이고 조건부 공분산은 같은 샌드위치 식입니다. 이것은 반응의 재표집이며 매번 설계행렬을 rank-one 수정한다는 뜻은 아닙니다. 검정의 점근 타당성과 작은 표본 보정은 독립성·레버리지·적률 등의 추가 이론을 요구합니다.
자기수반성을 버린 멱등행렬도 있습니다. \(T=\begin{pmatrix}1&1\\0&0\end{pmatrix}\)는 \(T^2=T\)이나 \(T^T\ne T\)이고 \(\|Te_2\|=1\), \(e_2-Te_2=(-1,1)^T\)가 상에 직교하지 않습니다. 이는 사각사영이며 유클리드 최소제곱 사영의 피타고라스와 분산 공식을 그대로 적용할 수 없습니다.
9. 연습과 전체 풀이#
1. 처음 자료의 절편을 중심화 좌표로 바꾸어 구하세요.
풀이. \(t=s+3/2\)이므로 \(7/10+(6/5)t=7/10+9/5+(6/5)s=5/2+(6/5)s\). 적합값은 같고 절편은 평균 활동 수준의 예측으로 의미가 바뀝니다.
2. 원래 자료에 \(t^2\)를 추가하면 잔차제곱합이 증가할 수 있나요?
풀이. 기존 열공간이 새 열공간에 포함되므로 증가하지 않습니다. 감소가 0일 수도 있습니다. 이 결론은 확률분포나 모형의 정확성을 요구하지 않습니다.
3. 지역 예의 기울기를 알고 각 지역 절편과 잔차를 구하세요.
풀이. 절편은 \(3/2-(7/5)(1/2)=4/5\), \(9/2-(7/5)3=3/10\). 적합은 \((.8,2.2,3.1,5.9)\), 잔차는 \((.2,-.2,-.1,.1)\)이고 제곱합은 \(1/10\)입니다. 네 관측에 독립 열 세 개라 잔차 자유도는 1입니다.
4. 절편과 모든 지역 더미의 설계에서 지역 A 평균은 추정가능한가요?
풀이. \(a=(1,1,0)^T\)는 핵 벡터 \((1,-1,-1)^T\)와 내적이 0입니다. 따라서 추정가능합니다. 절편만 고르는 \((1,0,0)^T\)는 내적 1이므로 아닙니다.
5. 첫 관측을 제거한 회귀의 첫 위치 예측값을 구하세요.
풀이. \(e_1/(1-h_1)=(3/10)/(3/10)=1\)이 삭제 예측오차입니다. 원래 관측이 1이므로 삭제 후 예측은 0입니다.
6. \(X=I_n\)이면 관측 삭제 공식에 무슨 일이 생기나요?
풀이. \(P=I_n\), 모든 \(h_i=1\), 잔차는 0입니다. 관측 하나를 제거하면 그 관측만 담당하던 계수가 식별되지 않습니다. \(0/0\)을 삭제오차 0으로 해석할 수 없습니다.
7. 중심화 잔차 회귀에서 분산추정량의 분모를 3으로 쓰면 기울기 분산이 얼마인가요?
풀이. \(s^2=(9/5)/3=3/5\), 기울기 분산은 \((3/5)/5=3/25\). 올바른 값은 \((9/10)/5=9/50\)입니다. 계수가 같아도 자유도 처리는 별도입니다.
8. \(h_i<1\)일 때 HC0, HC2, HC3의 행렬 순서를 설명하세요.
풀이. \(0<1-h_i\le1\)이므로 각 가중치가 순서대로 증가합니다. 차이는 비음수 배수 \(x_ix_i^T\)의 합이고 \(S^{-1}\) 합동변환도 PSD를 보존합니다. 따라서 \(\widehat V_{HC0}\preceq\widehat V_{HC2}\preceq\widehat V_{HC3}\). HC1이 이 순서의 고정 위치에 있다는 결론은 나오지 않습니다.
10. 지금까지의 내용을 수학의 언어로 정리해 봅시다#
이제 계산의 근거를 일반 설계에 대해 증명합니다. 전치와 직교성은 이 장의 실수 유클리드 내적 기준입니다.
정리 1. 사영자의 유일성, 계수와 대각합#
부분공간 \(S\)에는 상이 \(S\)인 대칭 멱등행렬이 유일합니다. 임의 멱등행렬의 대각합은 계수와 같습니다. 직교사영 \(P\)에는 \(0\le P_{ii}\le1\)이고 \(\sum_iP_{ii}=\dim S\)입니다.
증명. \(S\)의 정규직교 기저행렬 \(Q\)에 \(P=QQ^T\)를 두면 대칭·멱등이며 상이 \(S\)입니다. 다른 대칭 멱등 \(T\)는 \(s\in S\)에 \(Ts=s\)이고 \(v\in S^\perp\)에 \(\langle Tv,s\rangle=\langle v,Ts\rangle=0\)입니다. \(Tv\in S\)이므로 \(Tv=0\). 직교분해의 양쪽에서 \(T=P\)여서 유일합니다.
계수와 대각합의 첫 증명은 \(v=Pv+(I-P)v\)에서 \(\mathbb R^n=\operatorname{ran}P\oplus\ker P\)를 얻는 것입니다. 그 기저에서 행렬은 \(\operatorname{diag}(I_r,0)\)입니다. 둘째로 최소다항식은 \(t(t-1)\)의 약수이고 중근이 없어서 대각화 가능하며 고윳값은 0과 1뿐입니다. 1의 개수가 계수와 대각합입니다. 셋째로 직교사영의 경우 \(\operatorname{tr}(QQ^T)=\operatorname{tr}(Q^TQ)=r\). 마지막 증명은 대칭성을 사용합니다. \(P_{ii}=e_i^TPe_i=\|Pe_i\|^2\)이고 직교분해에서 이 값은 0과 1 사이입니다. ∎
정리 2. 중첩 사영의 차이#
\(S\subseteq T\)이면 \(P_TP_S=P_SP_T=P_S\)이고 \(P_T-P_S\)는 \(T\cap S^\perp\) 위 직교사영입니다.
증명. \(P_Sv\in T\)라 첫 곱은 \(P_S\)이며 전치하여 둘째 곱도 같습니다. 차이는 대칭이고 제곱하면 \(P_T-2P_S+P_S=P_T-P_S\)입니다. 그 출력은 \(T\)에 속하고 \(P_S\)를 곱하면 0이므로 \(S^\perp\)에도 속합니다. 역으로 \(v\in T\cap S^\perp\)이면 차이를 곱한 결과가 \(v\)여서 상이 정확히 그 교집합입니다. \(P_Ty=P_Sy+(P_T-P_S)y\)는 직교합이므로 적합 노름 단조성과 잔차제곱합 분해를 얻습니다. ∎
정리 3. FWL의 두 증명과 분산#
완전 열계수 \([X_1\ X_2]\)에서 4절의 FWL 식과 5절의 조건부 분산식이 성립합니다.
첫 증명: 블록 소거. 전체 정규방정식의 첫 블록에서 \(\beta_1\)을 풀어 둘째 블록에 넣으면 \(X_2^T[I-X_1(X_1^TX_1)^{-1}X_1^T]X_2\beta_2=X_2^TM_1y\). \(a^TX_2^TM_1X_2a=\|M_1X_2a\|^2\)가 0이면 \(X_2a\in\operatorname{col}X_1\)이고 전체 열독립성에서 \(a=0\). 따라서 이 Gram은 PD여서 유일해를 줍니다.
둘째 증명: 직교분해. \(X_2=P_1X_2+M_1X_2\)에서 첫 부분은 \(X_1\) 공간에, 둘째 부분은 그 직교여공간에 있습니다. 두 열공간의 직교직합이 전체 열공간입니다. 고정 \(\beta_2\)에서 \(X_1\beta_1\)을 최적으로 택하면 잔차가 \(M_1(y-X_2\beta_2)\)가 됩니다. 남은 최소화는 \(M_1y\)를 \(M_1X_2\)에 회귀하는 문제이고, 첫 공간의 계수만 복원하면 전체 해입니다.
분산을 위해 \(K=(X_2^TM_1X_2)^{-1}X_2^TM_1\)라 두면 \(\widehat\beta_2-\beta_2=Ku\). 따라서 \(\operatorname{Var}(\widehat\beta_2\mid X)=\sigma^2KK^T=\sigma^2(X_2^TM_1X_2)^{-1}\)입니다. 전체 잔차 \(e=Mu\)에 \(E[e^Te\mid X]=\operatorname{tr}(M\sigma^2I)=\sigma^2(n-k)\)이므로 분산추정량의 분모도 얻습니다. ∎
정리 4. 계수결핍 설계의 추정가능성#
\(a^T\beta\)가 \(X\beta\)만으로 정해질 필요충분조건은 \(a\in\operatorname{ran}X^T\)입니다. 이는 \(E[y]=X\beta\)인 모든 \(\beta\)에 선형불편추정량이 존재하는 조건과 같습니다. 이 경우 일반화역으로 얻은 최소제곱 추정함수는 일반화역 선택에 무관합니다.
증명. 동등한 계수의 차이는 \(\ker X\)입니다. \(a^T\)가 모든 차이를 소거할 조건은 \(a\in(\ker X)^\perp=\operatorname{ran}X^T\)입니다. \(a=X^Tw\)이면 \(E[w^Ty]=a^T\beta\). 반대로 \(w^Ty\)가 모든 \(\beta\)에 불편이면 \(w^TX=a^T\)여야 합니다.
\(S=X^TX\), \(SGS=S\)인 \(G\)를 잡겠습니다. \(X^Ty\in\operatorname{ran}S\)이므로 \(SGX^Ty=X^Ty\)이고 \(GX^Ty\)는 최소제곱해입니다. 두 최소제곱해의 차이는 \(\ker S=\ker X\)에 있으므로 \(a^T\)로 평가한 결과가 같습니다. 두 추정함수가 표본마다 같으므로 그 분산도 같습니다. 또한 \(a\in\operatorname{ran}S\)이면 \(a^TGS=a^T\)이고, 역으로 이 등식은 \(a^T\)가 \(S\)의 행공간에 있음을 뜻합니다. ∎
정리 5. 관측 삭제와 레버리지 분모#
완전 열계수 \(X\)에서 한 관측 삭제 후에도 완전 열계수일 필요충분조건은 \(h_i<1\)이며, 7절의 단일·블록 삭제 공식이 성립합니다.
증명. \(S=X^TX\succ0\), \(x=x_i\), \(h=x^TS^{-1}x\)라 쓰겠습니다. 삭제한 Gram은 \(S-xx^T=S^{1/2}(I-vv^T)S^{1/2}\), \(v=S^{-1/2}x\)입니다. \(\|v\|^2=h\le1\)이며 \(I-vv^T\)의 고윳값은 \(1-h\)와 나머지 1이므로 가역일 조건이 \(h<1\)입니다. 직접 곱하면
여기에 삭제 우변 \(X^Ty-xy_i=S\widehat\beta-xy_i\)를 곱하면 \(\widehat\beta_{(-i)}=\widehat\beta-S^{-1}xe_i/(1-h)\). 원래 관측에서 평가한 오차는 \(e_i+h_ie_i/(1-h_i)=e_i/(1-h_i)\)입니다.
블록에서도 삭제 정규방정식을 원래 정규방정식에서 빼면 \((S-X_J^TX_J)(\widehat\beta_{(-J)}-\widehat\beta)=-X_J^Te_J\). 또는 이를 \(S\)에 대해 정리해 \(\widehat\beta_{(-J)}-\widehat\beta=-S^{-1}X_J^Tr_J\)로 쓰되 \(r_J=y_J-X_J\widehat\beta_{(-J)}\)라 두면, 대입하여 \(r_J=e_J+P_{JJ}r_J\). 따라서 \(r_J=(I-P_{JJ})^{-1}e_J\)입니다. 가역성은 \(S-X_J^TX_J\)의 PD와 동치이며 이는 남은 설계의 완전 열계수 조건입니다. ∎
정리 6. 잔차제곱의 기대와 wild 공분산#
증명. 등분산에서 \(e=Mu\), \(M^2=M=M^T\)이므로 \(E[ee^T\mid X]=\sigma^2M\). 대각을 읽으면 \(E[e_i^2\mid X]=\sigma^2(1-h_i)\)입니다. 따라서 HC2의 가운데 행렬의 기대는 \(\sigma^2\sum_i x_ix_i^T=\sigma^2S\)여서 공분산 추정량의 기대는 \(\sigma^2S^{-1}\)입니다. wild 계수변화의 외적을 평균하면 \(E^*[v_iv_j]=0\)인 교차항은 사라지고 \(S^{-1}\sum_i x_ix_i^T\widetilde e_i^2S^{-1}\)만 남습니다. 이는 재표집의 조건부 공분산 항등식이며 분포 근사의 타당성까지 증명하는 것은 아닙니다. ∎
실무에서 한 행동 |
선형대수의 식 |
|---|---|
설명변수의 단위를 바꿈 |
열공간을 보존하는 재모수화 |
지역 차이를 통제함 |
\(M_1\)으로 양쪽 변수를 부분화 |
같은 예측을 내는 계수를 구별함 |
\(\ker X\)와 추정가능함수 |
한 관측의 외부 예측을 계산함 |
rank-one 삭제와 \(1-h_i\) |
잔차 분산의 축소를 보정함 |
\(E[e_i^2\mid X]=\sigma^2(1-h_i)\) |
회귀계수와 잔차의 대수적 관계를 구했습니다. 다음 장에서는 오차에 확률 가정을 추가하여, 제약을 검사하는 제곱합이 어떤 분포를 갖는지 살펴봅니다. E2로 이어 읽기.