
테마
노트북 · 5회 · 정규분포의 탄생과 Galton의 타원
정규분포의 탄생과 Galton의 타원
| 역사 | Stigler, The History of Statistics (1986) — 4장 Gauss–Laplace 종합 · 5장 Quetelet · 8장 Galton |
| 강의노트 | 05_normal_galton_notes.pdf — 같은 절 번호, 같은 정리 번호. 절마다 연습문제와 부록 풀이 |
| 워크북 | 05_normal_galton_workbook.pdf — 손으로 푸는 34문항. 다 푼 뒤 맨 끝 9절의 check()로 검산 |
| 선수 지식 | 1–4회 (2회 mgf · 3회 야코비안·전분산 공식·가우스 적분 · 4회 감마와 χ²) |
여는 질문. 키 큰 부모의 자녀는 왜 부모보다 덜 클까? 그리고 키 큰 자녀의 부모는 왜 자녀보다 덜 클까?
두 번째 질문은 시간을 거슬러 올라간다. 자녀가 부모를 끌어당길 수는 없다. 이번 시간이 끝날 때 두 질문은 같은 답을 갖는다. 답은 생물학이 아니라 타원 하나의 기하다.
이번 회차의 지도
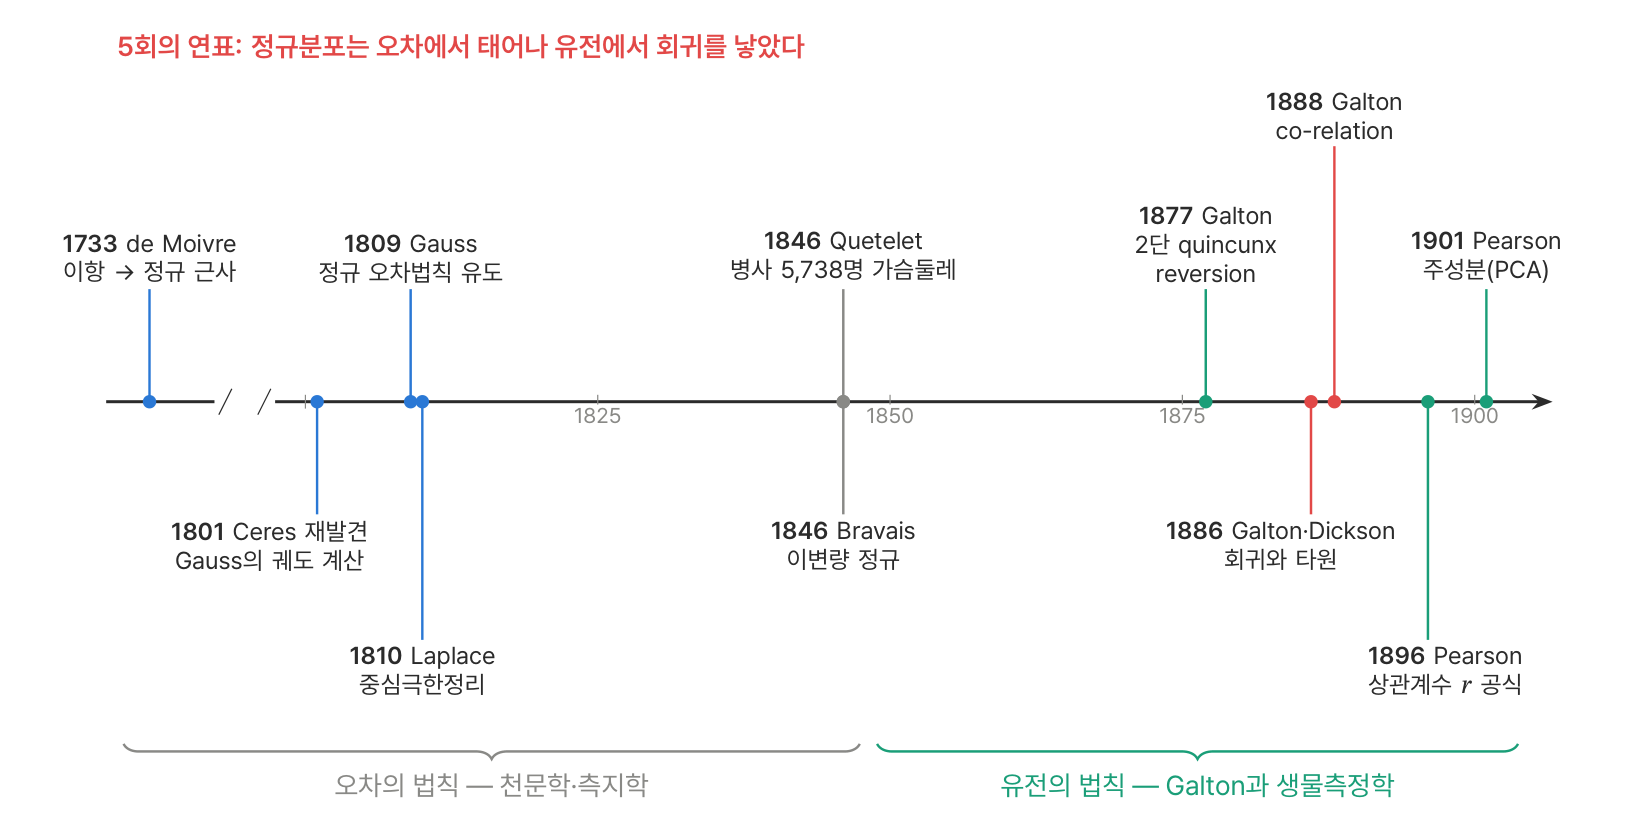
정규분포는 처음에 오차의 분포였다. de Moivre는 동전 던지기의 근사로(1733), Gauss는 천문 관측 오차의 법칙으로(1809), Laplace는 작은 오차들의 합의 극한으로(1810) 정규분포에 도달했다. 19세기 후반 Galton은 같은 분포를 사람의 변이와 유전에 썼고, 그 과정에서 회귀와 상관이 태어났다(1886, 1888). 이번 시간은 두 시대를 하나의 수학, 곧 다변량 정규분포의 조건부분포로 묶는다.
학습 목표
- 정규분포가 태어난 세 경로(de Moivre 근사, Gauss의 특성화, Laplace의 CLT)를 수학으로 설명한다.
- 다변량 정규분포를 mgf로 정의하고 선형변환·독립·조건부·이차형식 네 정리를 증명한다.
- 조건부분포 공식에서 평균으로의 회귀를 유도하고 Galton의 1886년 원자료로 확인한다.
MVN클래스를 numpy만으로 구현해 scipy와 대조하고, 가정을 하나씩 빼서 정리가 무너지는 것을 본다.- 같은 공식이 GP 회귀, PCA, 백색화, VAE에서 어떻게 다시 나타나는지 설명한다.
과목 색 범례 (16회 내내 같은 뜻)
| 색 | 뜻 | 이번 회차의 예 |
|---|---|---|
| ■ 보라 | 모수 (고정된 미지수) | |
| ■ 청록 | 데이터 · 확률변수 | , 표본점, Galton의 928명 |
| ■ 파랑 | 통계량 · 추정량 | , 추정 회귀선 |
| ■ 빨강 | 핵심 결론 | 조건부분포 공식, 회귀 |
| ■ 주황 | 가정 (빼면 정리가 무너진다) | 결합정규 |
| ┅ 검정 점선 | 그림 속 이론 분포 | 정규 밀도, 밀도 |
이번 회차 정리들의 의존 관계 — 화살표는 "증명에 쓰인다"는 뜻이다.
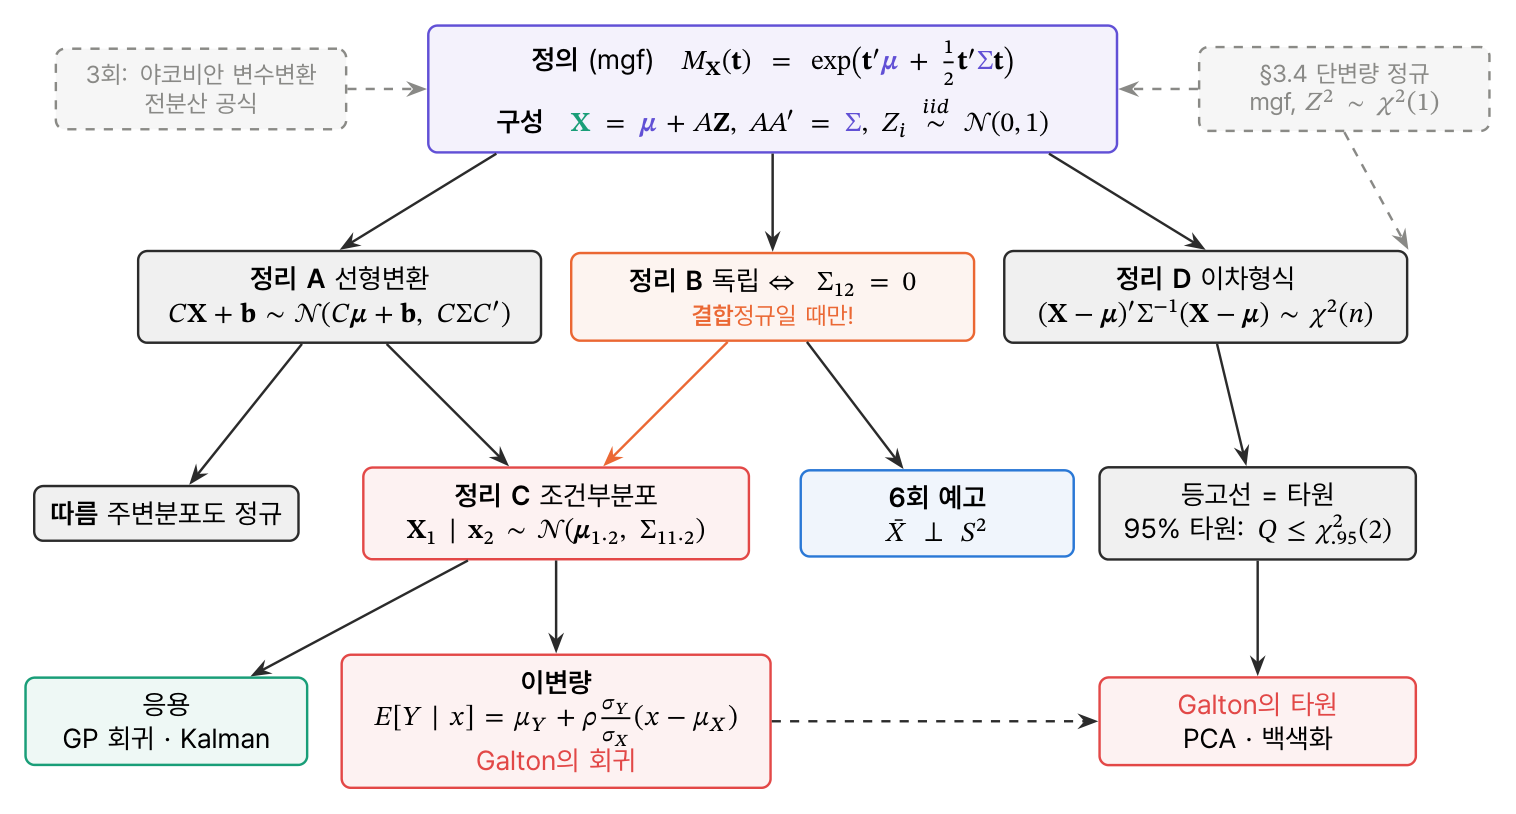
읽는 법. 각 절은 역사 → 정의·정리 → 증명 → 코드로 확인 → 📝 연습 순서다. 증명은 한 줄마다 이유를 붙였다. 줄마다 "왜 이 등호가 성립하는가"를 스스로 말할 수 있어야 한다. 📝 표시의 연습문제 번호는 강의노트 PDF의 번호이고, 풀이는 PDF 부록 A에 있다.
0. 설정과 복습
0.0 설정
Legend13 노트북처럼 맨 위에 대문자 설정을 모은다. 원자료는 R의 HistData 패키지(Rdatasets 미러)에서 받아 data/에 캐시한다.
python
%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from pathlib import Path
from scipy import stats, optimize, special

SEED = 2026          # 재현성
N_SIM = 100_000      # Monte Carlo 반복 수
N_BIG = 1_000_000    # 조건부 확인용 큰 표본
rng = np.random.default_rng(SEED)

# 과목 색 범례 — 그림에서 이론(참) 곡선은 검정 점선
C = dict(data="#1a9e78", stat="#2a78d6", key="#e34948", assume="#eb6834",
         theta="#6250d6", ink="#2b2b2b", hist="#8a8a86", grid="#e6e6e3")
THEORY = dict(color=C["ink"], ls="--", lw=1.6)

plt.rcParams.update({
    "figure.dpi": 110, "figure.figsize": (8, 4.2), "mathtext.fontset": "stix",
    "axes.spines.top": False, "axes.spines.right": False,
    "axes.grid": True, "grid.color": C["grid"], "grid.linewidth": 0.8,
    "axes.edgecolor": "#9a9a96", "axes.labelcolor": C["ink"],
    "xtick.color": "#52514e", "ytick.color": "#52514e",
    "axes.titleweight": "bold", "axes.titlesize": 11, "axes.titlelocation": "left",
    "legend.frameon": False, "lines.linewidth": 2,
})

RDATASETS = "https://raw.githubusercontent.com/vincentarelbundock/Rdatasets/master/csv/HistData/{}.csv"
DATA_DIR = Path("../../data") if Path("../../.git").exists() else Path("data")   # 레포 안이면 공용 data/

def load_histdata(name):
    """HistData 원자료: 로컬 캐시 → 없으면 Rdatasets에서 받아 캐시"""
    path = DATA_DIR / f"{name}.csv"
    if not path.exists():
        DATA_DIR.mkdir(parents=True, exist_ok=True)
        pd.read_csv(RDATASETS.format(name)).drop(columns="rownames").to_csv(path, index=False)
    return pd.read_csv(path)

def report(checks):
    """대조 결과 표 — torchinfo.summary 자리"""
    for name, ok in checks.items():
        print(f"  {'✓' if ok else '✗'}  {name}")
    assert all(checks.values()), "대조 실패"
0.1 선수 지식 복습
이번 회차 내내 쓰는 도구 세 가지. 모두 앞 회차에서 증명했다(2회 3절, 3회 정리 2.5·2.6·3.4·5.1).
보조정리 0.1 (mgf). 가 의 근방에서 존재하면 (a) 유일성 — mgf가 같으면 분포가 같다. (b) 적률 — , 특히 에서 , . (c) . (d) . 벡터에서도 가 분포를 결정하고, 이면 이다.
보조정리 0.2 (변수변환). 가 일대일이고 역변환 의 야코비안이 이면
보조정리 0.3 (반복기댓값과 전분산). , 그리고
전분산 공식은 이 노트에서 세 번 다른 얼굴로 나온다. 2.2절의 2단 quincunx, 3.5절의 조건부분포(피타고라스 정리), 5.3절의 혼합분포다.
📝 연습 0.1–0.2 (강의노트): 극좌표의 야코비안, 전분산 공식의 증명.
1. 정규분포는 어떻게 태어났나
정규분포에 이르는 길은 셋이다. 이항분포의 근사(de Moivre), "평균이 최선"이라는 요구(Gauss), 작은 오차들의 합의 극한(Laplace). 앞의 둘을 여기서 증명하고, 셋째는 7회(중심극한정리)로 넘긴다.
1.1 de Moivre (1733): 이항분포의 근사로서
1733년 11월, 런던의 프랑스 망명 수학자 Abraham de Moivre는 짧은 라틴어 소논문 Approximatio ad Summam Terminorum Binomii (a+b)ⁿ in Seriem expansi를 지인들에게 돌렸다(1738년 The Doctrine of Chances 2판에 영어로 실렸다). 물음은 동전을 번 던질 때 앞면 수가 근처의 구간에 들 확률이었다. 이 수천이면 이항계수를 하나하나 더할 수 없었다. de Moivre는 의 급수 전개를 썼고(그 상수 는 Stirling이 찾았다), 주로 를 다뤘다. 그 답에 오늘날의 정규밀도가 처음 나타났다.
보조정리 1.1 (Stirling). . 실제로 비율 은 약 이다.
정리 1.2 (국소 de Moivre–Laplace). , , 로 두면, 임의의 에 대해 인 들에서 균등하게
python
# 보조정리 1.1 확인: Stirling 비율 ≈ 1 + 1/(12m)
for m in [5, 10, 20, 50]:
    ratio = special.factorial(m) / (np.sqrt(2 * np.pi * m) * (m / np.e) ** m)
    print(f"m = {m:3d}:  m!/Stirling = {ratio:.5f}    1 + 1/(12m) = {1 + 1/(12*m):.5f}")
text
m =   5:  m!/Stirling = 1.01678    1 + 1/(12m) = 1.01667
m =  10:  m!/Stirling = 1.00837    1 + 1/(12m) = 1.00833
m =  20:  m!/Stirling = 1.00418    1 + 1/(12m) = 1.00417
m =  50:  m!/Stirling = 1.00167    1 + 1/(12m) = 1.00167
증명. 로 둔다. 이므로 이고, 와 는 모두 에 비례해 커진다.
1단계 — Stirling 대입. 세 계승에 보조정리 1.1을 넣으면 이므로
2단계 — (가) 앞인수. 이므로 (가) .
3단계 — (나)의 로그. , 로 두면 이다. , ()을 넣고 전개한다.
나머지항은 이다. 두 줄을 더하면 가 소거되고
4단계 — 합치기. 이므로 (나) . 모든 오차항은 에만 의존하므로 균등하다.
한 걸음 더. 3단계에서 항을 끝까지 모으면 계수가 이다(연습 1.1). 이면 이 항이 사라져 근사가 한 차수 더 빨리 좋아진다. 아래 오른쪽 그림의 기울기로 확인한다.
python
# 정리 1.2: 이항 pmf(막대) vs 정규밀도(점선), 그리고 최대 절대오차의 감소 속도
fig, axes = plt.subplots(1, 4, figsize=(13, 3.3), gridspec_kw=dict(width_ratios=[1, 1, 1, 1.25]))
for ax, n in zip(axes[:3], [10, 40, 160]):
    k = np.arange(n + 1)
    ax.bar(k, stats.binom.pmf(k, n, 0.5), color=C["data"], width=0.85, label="Binomial pmf")
    x = np.linspace(0, n, 600)
    s = np.sqrt(n) / 2
    ax.plot(x, stats.norm.pdf(x, n / 2, s), **THEORY, label="normal approx.")
    ax.set_xlim(n / 2 - 4 * s, n / 2 + 4 * s)
    ax.set_title(f"n = {n}, p = 1/2"); ax.set_xlabel("k")
axes[0].set_ylim(0, 0.36)
axes[0].legend(loc="upper left", fontsize=8)

ax = axes[3]
ns = np.unique(np.logspace(1, 4, 25).astype(int))
for p, col in [(0.5, C["stat"]), (0.2, C["key"])]:
    err = np.array([np.max(np.abs(stats.binom.pmf(np.arange(n + 1), n, p)
                                  - stats.norm.pdf(np.arange(n + 1), n * p, np.sqrt(n * p * (1 - p))))) for n in ns])
    slope = np.polyfit(np.log(ns), np.log(err), 1)[0]
    ax.loglog(ns, err, "o-", color=col, ms=4, lw=1.5)
    ax.text(12, 0.25 if p == 0.2 else 3e-7, f"p = {p}: slope {slope:.2f}", color=col, fontsize=9)  # 직접 라벨, 선과 떨어진 빈 곳
ax.set_ylim(1e-8, 1); ax.set_title("max |pmf − approx|"); ax.set_xlabel("n")
plt.tight_layout(); plt.show()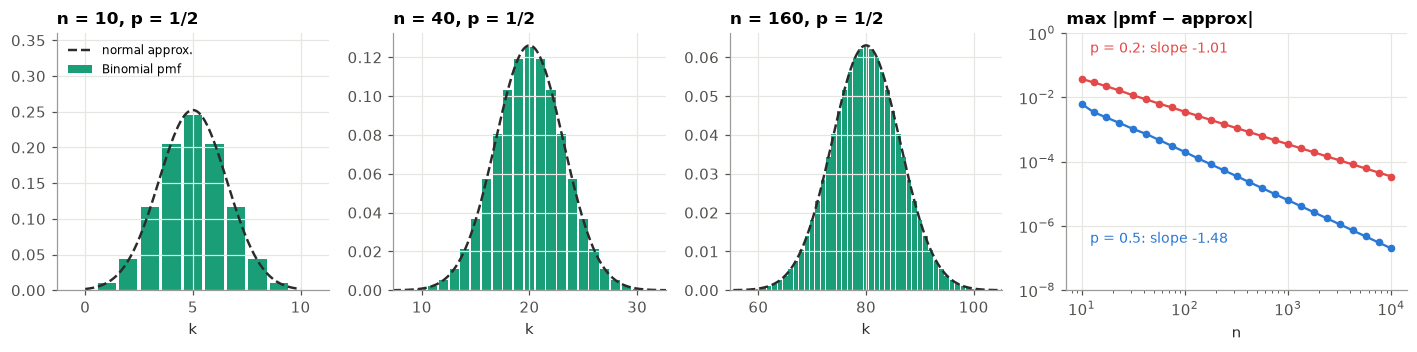
그림 읽기. 에서도 막대 꼭대기가 점선에 붙는다. 오른쪽에서 최대 오차는 일 때 기울기 약 , 일 때 약 로 줄어든다. 상대오차 에 밀도 크기 를 곱하면 절대오차 이고, 대칭이면 항이 사라져 한 차수 더 줄어든다.
따름정리 1.3 (적분형 de Moivre–Laplace). 이면 .
증명. 인접한 의 간격은 이므로 정리 1.2에 의해
오른쪽 합은 연속함수 의 리만 합이고 이다.
연속성 보정. 정수값 사건 는 실수축에서 의 칸을 차지한다. 그래서 가 훨씬 정확하다.
python
# 연속성 보정: n = 100, p = 1/2, P(45 <= S <= 55)
n, p = 100, 0.5
s = np.sqrt(n * p * (1 - p))
exact = stats.binom.cdf(55, n, p) - stats.binom.cdf(44, n, p)
no_cc = stats.norm.cdf((55 - n * p) / s) - stats.norm.cdf((45 - n * p) / s)
cc = stats.norm.cdf((55.5 - n * p) / s) - stats.norm.cdf((44.5 - n * p) / s)
print(f"exact {exact:.5f}   normal (no correction) {no_cc:.5f}   normal (continuity correction) {cc:.5f}")
text
exact 0.72875 normal (no correction) 0.68269 normal (continuity correction) 0.72867📝 연습 1.1–1.3 (강의노트): 3차 항의 계수 유도, 의 수치 비교, Stirling의 상수 를 de Moivre 정리를 거꾸로 써서 구하기.
1.2 Gauss (1809): "평균이 가장 그럴듯하다"면 오차는 정규다
1801년 1월 1일 Piazzi가 발견한 소행성 Ceres는 6주쯤 관측된 뒤 태양 빛 속으로 사라졌다. 24세의 Gauss는 그 짧은 호로 궤도를 계산했고, 그해 말 Ceres는 Gauss가 예측한 자리 근처에서 다시 발견되었다. Gauss는 1809년 Theoria Motus Corporum Coelestium에서 이 방법을 정리하며 오차분포를 거꾸로 이끌어 냈다. 관측자들이 늘 쓰던 산술평균이 "가장 그럴듯한 값"이 되려면, 오차는 어떤 분포여야 하는가?
보조정리 1.4 (Cauchy 함수방정식). 가 연속이고 ()이면 , .
증명. ① 이면 . 귀납법으로 (), 이면 . 따라서 정수에서 . ② 이므로 유리수에서 . ③ 유리수열 를 잡으면 연속성으로 .
정리 1.5 (Gauss의 특성화). 위치모형 , 에서 은 미분가능하고 는 연속이라 하자. 모든 과 모든 표본에서 가능도 가 에서 최대라면
증명.
- 1차 조건. 내부 최대점이므로 .
- 합이 0인 모든 수열. 합이 0인 에 대해 표본을 로 잡으면 이므로 .
- 함수방정식. 이면 . 의 로 . 의 로 .
- 풀기. 보조정리 1.4로 , 곧 이고 적분하면 .
- 상수. 이려면 이므로 . (§1.4 (i))에서 .
순환을 끊은 Laplace. Gauss는 "평균이 최선 정규"를 보였고, 정규를 가정해 최소제곱(13회)을 정당화했다. 그러면 평균이 최선이라는 전제는 어디서 오는가? 1810년 Laplace의 중심극한정리가 이 순환을 끊었다. 오차가 작은 독립 원인 여럿의 합이면 그 분포는 가정하지 않아도 정규에 가깝다(7회). Stigler는 이 결합을 Gauss–Laplace 종합이라 부른다.
아래 그림은 정리의 대우(對偶)를 보여 준다. 오차가 정규가 아니면 가능도의 꼭대기는 평균이 아니다.
python
x = stats.laplace.rvs(size=15, random_state=7) + 1.0       # 참 θ = 1, Laplace 오차
theta = np.linspace(-1, 3, 801)
ll_norm = -0.5 * ((x[:, None] - theta) ** 2).sum(axis=0)     # 정규 로그가능도 (σ = 1)
ll_lap = -np.abs(x[:, None] - theta).sum(axis=0)              # Laplace 로그가능도 (b = 1)

fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(theta, ll_norm - ll_norm.max(), color=C["stat"], label="normal model: parabola")
ax.plot(theta, ll_lap - ll_lap.max(), color=C["assume"], label="Laplace model: piecewise linear")
ax.axvline(x.mean(), color=C["stat"], lw=1, ls=":")
ax.axvline(np.median(x), color=C["assume"], lw=1, ls=":")
ax.plot(x, np.full_like(x, -9.3), "|", color=C["data"], ms=14, mew=2, label="data")
ax.text(0.64, 0.62, f"peak of normal model = mean {x.mean():.2f}\npeak of Laplace model = median {np.median(x):.2f}",
        transform=ax.transAxes, va="top", fontsize=9, color=C["ink"])
ax.set_ylim(-10, 0.8); ax.set_xlabel(r"$\theta$"); ax.set_ylabel("log-likelihood − max")
ax.set_title("Gauss's question: which error law makes the mean the most likely value?")
ax.legend(loc="lower right", fontsize=8)
plt.tight_layout(); plt.show()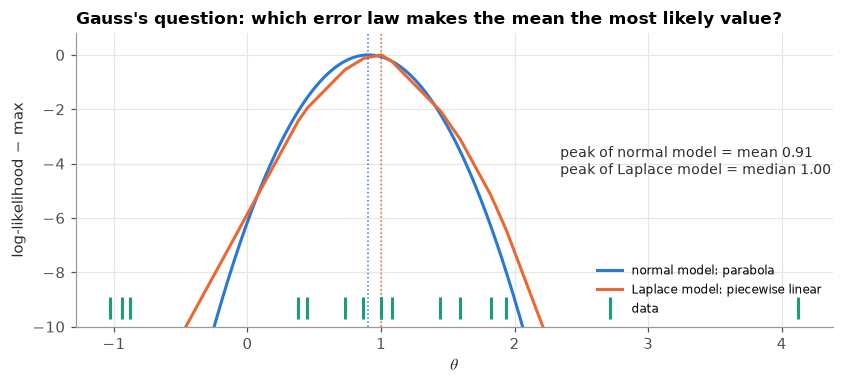
그림 읽기. 정규 모형의 로그가능도는 포물선이고 꼭대기는 평균이다. Laplace 분포(이중지수)라면 로그가능도는 꺾은선이고 꼭대기는 중앙값이다. 이 분포는 Laplace가 1774년에 처음 제안한 오차곡선이다. 15회(중앙값·L1 회귀)와 16회(lasso의 사전분포)에서 다시 만난다.
왜 이 필요했나. 증명의 3단계는 세 점짜리 표본으로 덧셈 공식을 얻는다. 만 요구하면 부족하다. 대칭이고 로그오목인 밀도는 무엇이든 두 점의 가운데에서 가능도가 최대이기 때문이다. 로지스틱 분포로 확인한다(연습 1.5).
python
# 로지스틱 오차: (log f)'(u) = -tanh(u/2)  →  ℓ'(θ) = Σ tanh((x_i - θ)/2)
score = lambda th, xs: np.sum(np.tanh((np.asarray(xs) - th) / 2))
two = [0.0, 3.0]; three = [0.0, 0.0, 3.0]
print(f"n = 2  sample {two}:   ℓ'(mean) = {score(np.mean(two), two):+.4f}   → 평균이 MLE")
mle3 = optimize.brentq(lambda th: score(th, three), -5, 5)
print(f"n = 3  sample {three}: ℓ'(mean) = {score(np.mean(three), three):+.4f}   → MLE = {mle3:.4f}, 평균 = 1.0")
text
n = 2  sample [0.0, 3.0]:   ℓ'(mean) = +0.0000   → 평균이 MLE
n = 3  sample [0.0, 0.0, 3.0]: ℓ'(mean) = -0.1626   → MLE = 0.8394, 평균 = 1.0
📝 연습 1.4–1.6 (강의노트): Laplace 오차의 MLE는 중앙값, 로지스틱으로 와 비교, 정규 사전분포에서 사후 최빈값(축소의 예고).
1.3 Quetelet (1846): 오차의 분포가 사람에게 쓰이다
벨기에의 천문학자 Adolphe Quetelet는 1846년 Lettres sur la théorie des probabilités에서 스코틀랜드 병사 5,738명의 가슴둘레 표(원자료는 1817년 Edinburgh Medical and Surgical Journal)에 정규분포를 맞췄다. 그는 사람의 신체가 **평균인(l'homme moyen)**을 중심으로 관측오차처럼 흩어진다고 주장했다. 천문학의 오차법칙이 처음으로 사람들 사이의 변이에 쓰인 순간이다. 이 성공은 동시에 "자연의 모든 것은 정규"라는 과신을 낳았다. §5에서 그 과신을 부순다.
예제 1.6 (구간화된 자료의 정규 적합). 값 의 도수를 , 라 하면
python
chest = load_histdata("ChestSizes")                     # Quetelet (1846) 표
QUETELET_1846 = {33: 3, 34: 18, 35: 81, 36: 185, 37: 420, 38: 749, 39: 1073, 40: 1079,
                 41: 934, 42: 658, 43: 370, 44: 92, 45: 50, 46: 21, 47: 4, 48: 1}
assert dict(zip(chest.chest, chest["count"])) == QUETELET_1846   # 원전 표와 대조

xj, fj = chest.chest.to_numpy(float), chest["count"].to_numpy(float)
N = fj.sum()
mu_hat = (fj * xj).sum() / N
sd_hat = np.sqrt((fj * (xj - mu_hat) ** 2).sum() / N)
expected = N * (stats.norm.cdf(xj + 0.5, mu_hat, sd_hat) - stats.norm.cdf(xj - 0.5, mu_hat, sd_hat))
print(f"N = {N:.0f},  mu_hat = {mu_hat:.3f} in,  sd_hat = {sd_hat:.3f} in,  Sheppard-corrected sd = {np.sqrt(sd_hat**2 - 1/12):.3f}")

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
ax = axes[0]
ax.bar(xj, fj, color=C["data"], width=0.85, label="Quetelet's counts")
xx = np.linspace(32, 49, 400)
ax.plot(xx, N * stats.norm.pdf(xx, mu_hat, sd_hat), **THEORY, label="fitted normal")
ax.plot(xj, expected, "o", color=C["ink"], ms=4, label="expected counts")
ax.set_xlabel("chest girth (inches)"); ax.set_ylabel("soldiers")
ax.set_title("Scottish soldiers, n = 5,738"); ax.legend(fontsize=8)

ax = axes[1]
upper = xj[:-1] + 0.5
ax.plot(upper, stats.norm.ppf(np.cumsum(fj)[:-1] / N), "o", color=C["data"], ms=5, label="data")
ax.plot(upper, (upper - mu_hat) / sd_hat, **THEORY, label=r"$(x-\hat\mu)/\hat\sigma$")
ax.set_xlabel("class upper boundary (inches)"); ax.set_ylabel(r"$\Phi^{-1}$(cumulative proportion)")
ax.set_title("normal probability plot"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()

# 8회 예고: Pearson의 χ² 적합도 (기대도수 < 5 인 양 끝을 합친다, 추정 모수 2개 → 자유도 k − 1 − 2)
o, e = list(fj), list(expected)
while e[0] < 5:                       # 첫 칸을 둘째 칸에 더하고 지운다 (pop 을 += 의 오른쪽에 쓰면 칸이 밀린다)
    o[1] += o[0]; e[1] += e[0]; del o[0], e[0]
while e[-1] < 5:
    o[-2] += o[-1]; e[-2] += e[-1]; del o[-1], e[-1]
o, e = np.array(o), np.array(e)
chi2 = ((o - e) ** 2 / e).sum(); df = len(o) - 1 - 2
print(f"[8회 예고] Pearson chi^2 = {chi2:.1f}, df = {df}, p = {stats.chi2.sf(chi2, df):.3g}  (칸 {len(o)}개)")
print("칸별 (O − E)/√E:", np.round((o - e) / np.sqrt(e), 2))
text
N = 5738, mu_hat = 39.832 in, sd_hat = 2.049 in, Sheppard-corrected sd = 2.029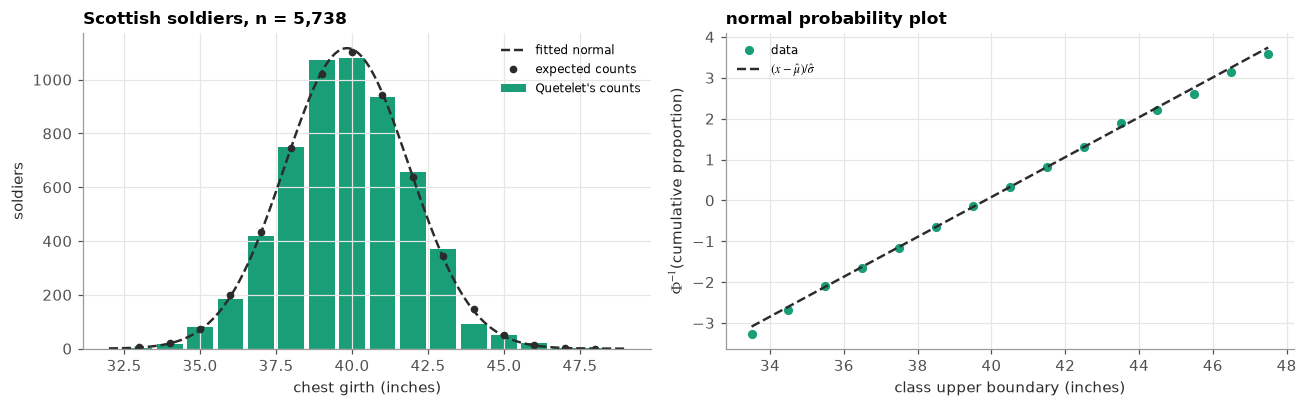
text
[8회 예고] Pearson chi^2 = 35.0, df = 10, p = 0.000126  (칸 13개)
칸별 (O − E)/√E: [-0.91  1.   -1.01 -0.66  0.05  1.65 -0.7  -0.3   0.75  1.47 -4.44  0.15
  2.43]
그림 읽기. 정규확률그림이 거의 직선이고 기대도수(검은 점)가 막대 꼭대기에 붙는다. 그런데 적합도 검정은 정규를 기각한다(, 자유도 10, ). 이나 되면 눈에 보이지 않는 작은 어긋남도 잡힌다. 가장 큰 기여는 44인치 칸(관측 92, 기대 146)이다. 기각은 "정규가 쓸모없다"는 뜻이 아니고, 기각하지 못함도 참이라는 증명이 아니다(8회). 1인치로 반올림한 자료는 꼬리의 작은 어긋남을 가린다. 반올림 오차가 와 독립인 라면 이다(Sheppard 보정, 연습 1.8). 위에 보정한 표준편차를 함께 출력했다.
📝 연습 1.7–1.8 (강의노트): Quetelet 표 직접 계산, Sheppard 보정의 증명과 가정.
1.4 단변량 정규분포
정의 1.7. 의 밀도는 . 표준정규의 밀도와 분포함수는 .
정리 1.8 (네 가지 사실). (i) . (ii) , 따라서 , , . (iii) . (iv) 독립 이면 .
증명 (i). . 피적분함수가 양수이므로 Tonelli 정리로 이중적분을 반복적분으로 바꾸고, 극좌표(야코비안 )로
증명 (ii). 지수를 에 대해 완전제곱한다.
첫 항은 평균 인 정규밀도의 지수라 (i)에 의해 적분하면 가 나온다. 따라서 . 에서 , . 의 계수를 비교하면 .
증명 (iii). 에서 . 미분하면
곧 의 밀도다. mgf로도: ().
증명 (iv). 독립성과 보조정리 0.1(c)(d)로 .
따름정리 1.9. . (mgf .) — §3 정리 D의 재료.
python
z = rng.standard_normal(N_SIM)
fig, axes = plt.subplots(1, 2, figsize=(12, 3.6))

ax = axes[0]                                   # (ii) mgf: Monte Carlo 평균 vs 닫힌형
MU, SIG = 1.0, 0.5
xs = MU + SIG * z
t = np.linspace(-2, 2, 21)
ax.plot(t, [np.exp(ti * xs).mean() for ti in t], "o", color=C["stat"], ms=5, label=r"Monte Carlo $\overline{e^{tX}}$")
tt = np.linspace(-2, 2, 200)
ax.plot(tt, np.exp(MU * tt + 0.5 * SIG**2 * tt**2), **THEORY, label=r"$\exp(\mu t+\sigma^2t^2/2)$")
ax.set_xlabel("t"); ax.set_title(r"(ii) mgf of $\mathcal{N}(1, 0.5^2)$"); ax.legend(fontsize=8)

ax = axes[1]                                   # (iii) Z^2 ~ chi^2(1)
w = z**2
ax.hist(w, bins=np.linspace(0, 6, 61), density=True, color=C["data"], label=r"$Z^2$ (simulated)")
ww = np.linspace(0.02, 6, 300)
ax.plot(ww, stats.chi2.pdf(ww, 1), **THEORY, label=r"$\chi^2(1)$ density")
ax.set_ylim(0, 1.6); ax.set_xlabel("w"); ax.set_title(r"(iii) $Z^2\sim\chi^2(1)$"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()

lin = 2 * rng.normal(1, 2, N_SIM) - 3 * rng.normal(-1, 1, N_SIM) + 1     # (iv) 2X1 - 3X2 + 1
print("(iv) mean, var  simulated:", lin.mean().round(3), lin.var().round(3), "  theory: 6, 25")
print("(ii) E(Z^4) simulated:", (z**4).mean().round(3), "  theory: 3")
print("(iii) KS test p-value vs chi2(1):", round(stats.kstest(w, stats.chi2(1).cdf).pvalue, 3))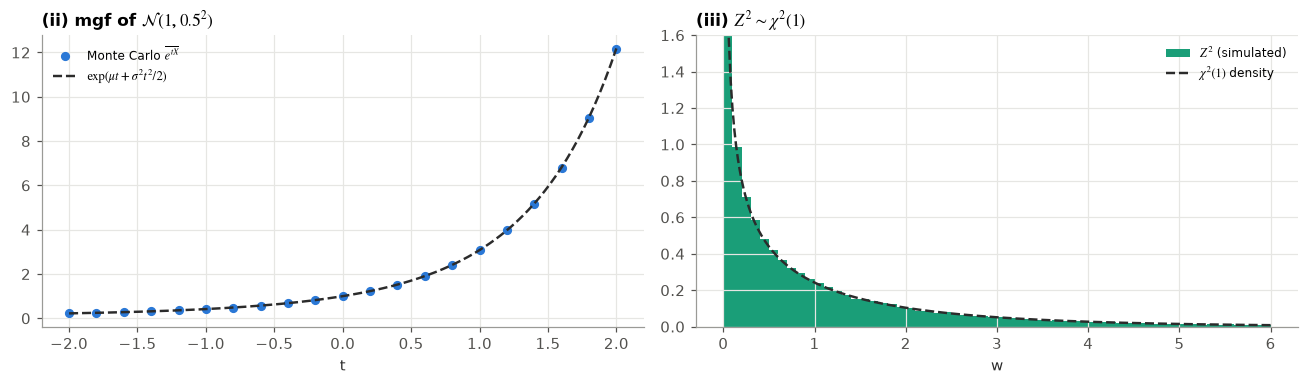
text
(iv) mean, var  simulated: 6.0 25.12   theory: 6, 25
(ii) E(Z^4) simulated: 2.949   theory: 3
(iii) KS test p-value vs chi2(1): 0.729
📝 연습 1.9–1.12 (강의노트): 짝수 적률 과 Stein 항등식, 로그정규, Mills 비 부등식 , 합성곱으로 직접 증명하는 정규합.
2. Galton의 문제: 변이는 어떻게 유전되는가
Francis Galton(1822–1911)은 Darwin의 사촌이었다. Hereditary Genius(1869) 이후 그의 관심은 하나였다. 변이는 어떻게 다음 세대로 전해지는가? Stigler(8장)에 따르면 Galton을 괴롭힌 것은 역설이었다. 사람의 키는 부모를 닮는데도 인구 전체의 키 분포는 세대가 지나도 거의 변하지 않는다. 닮음과 안정을 동시에 설명하는 수학이 필요했다.
2.1 Quincunx (1873): 작은 충격의 합이 종을 만든다
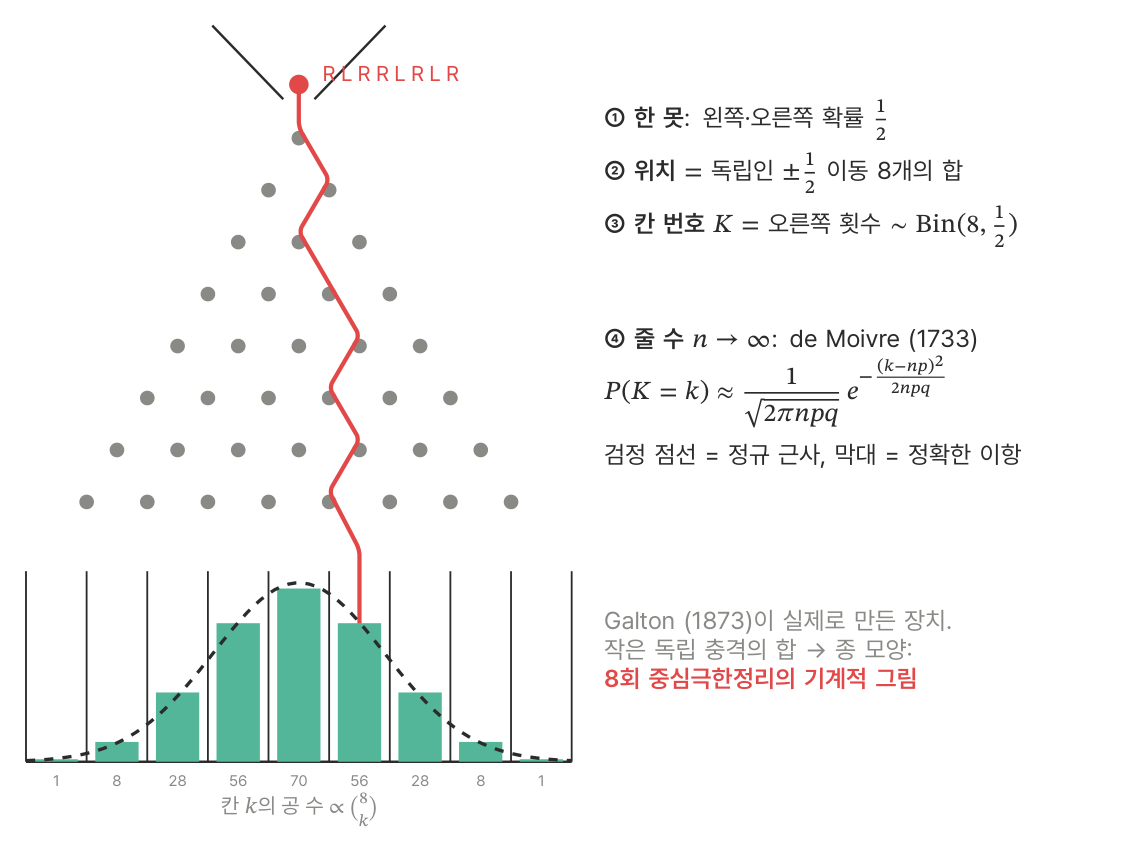
공이 번째 못에서 오른쪽으로 가면 , 왼쪽이면 이다. 못마다 독립이고 확률이 씩이면 줄을 지난 위치는
이고 정리 1.2에 의해 이다. 장치 자체가 "작은 독립 충격의 합은 정규"라는 중심극한정리(7회)의 기계적 그림이다.
python
ROWS, BALLS = 16, 20_000
steps = rng.choice([-0.5, 0.5], size=(BALLS, ROWS))       # 못마다 ±1/2
paths = np.cumsum(steps, axis=1)
final = paths[:, -1]

fig, axes = plt.subplots(1, 2, figsize=(12, 3.8), gridspec_kw=dict(width_ratios=[1, 1.2]))
ax = axes[0]
for i in range(40):
    ax.plot(np.r_[0, paths[i]], np.arange(ROWS + 1), color=C["data"], alpha=0.35, lw=1)
ax.plot(np.r_[0, paths[0]], np.arange(ROWS + 1), color=C["key"], lw=2, label="one ball")
ax.invert_yaxis(); ax.set_xlabel("position"); ax.set_ylabel("row")
ax.set_title("40 ball paths"); ax.legend(fontsize=8, loc="lower left")

ax = axes[1]
ax.hist(final, bins=np.arange(-ROWS / 2, ROWS / 2 + 1.5) - 0.5, density=True, color=C["data"], label=f"{BALLS:,} balls")
xx = np.linspace(-ROWS / 2, ROWS / 2, 400)
ax.plot(xx, stats.norm.pdf(xx, 0, np.sqrt(ROWS) / 2), **THEORY, label=r"$\mathcal{N}(0,\ n/4)$")
ax.set_xlabel("final position"); ax.set_title(f"after {ROWS} rows"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()
print(f"P(center) simulated {np.mean(final == 0):.4f}   exact {special.comb(16, 8) / 2**16:.4f}   normal {1/np.sqrt(8*np.pi):.4f}")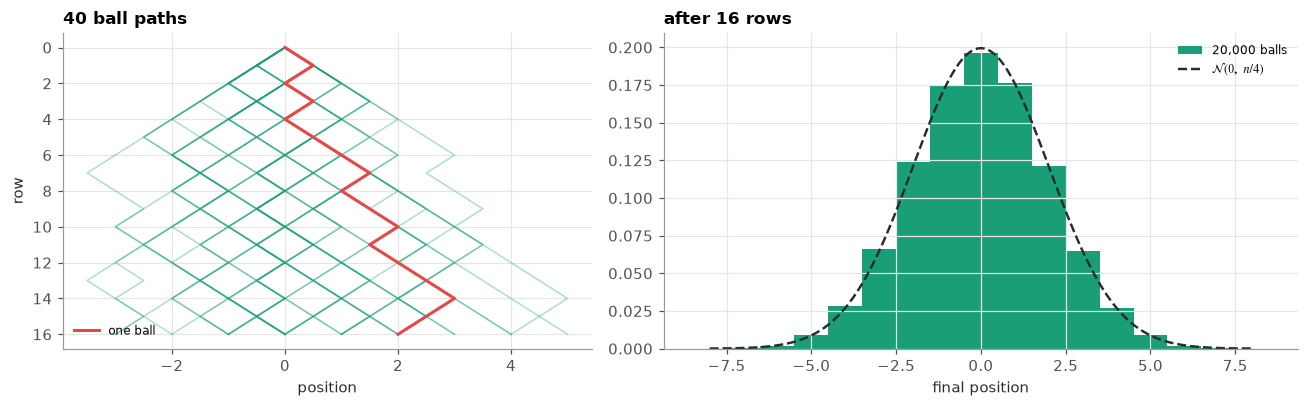
text
P(center) simulated 0.1963 exact 0.1964 normal 0.1995📝 연습 2.1–2.2 (강의노트): 가운데 칸의 확률, 기울어진 판.
2.2 2단 quincunx (1877): 정규를 정규로 섞으면 다시 정규
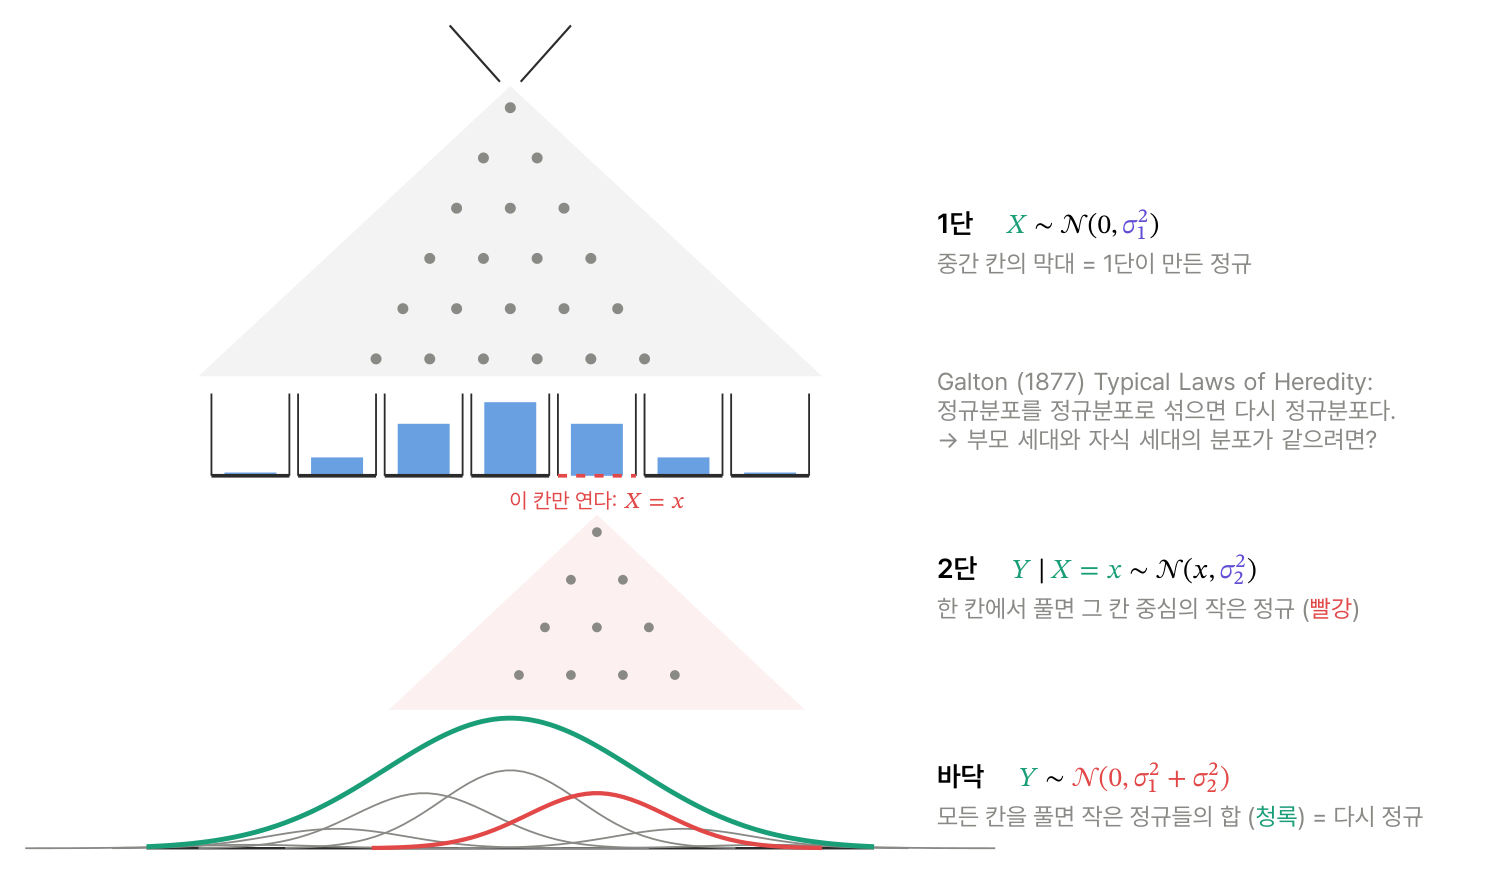
1877년 왕립연구소 강연 Typical Laws of Heredity에서 Galton은 중간에 칸을 단 quincunx를 보였다. 1단을 지난 공은 중간 칸에 멈춘다. 칸 하나만 열면 그 칸 아래에 작은 종이 생기고, 모든 칸을 열면 작은 종들이 합쳐져 처음과 같은 모양의 큰 종이 된다.
정리 2.1 (정규의 정규 혼합). , 이면 (a) . (b) 는 이변량 정규이고 , .
증명 (a). 반복기댓값과 정리 1.8 (ii)로
증명 (b). 로 두자. 가 주어지면 이고 이 조건부분포가 에 의존하지 않으므로 . 이므로
이는 §3 정의 3.4의 이변량 정규 mgf다.
분산만 보면 전분산 공식 그대로다: .
이제 2단 quincunx를 거꾸로 읽자. 바닥의 위치 만 보고 공이 어느 중간 칸에서 왔는지 추측한다면?
따름정리 2.2 (거꾸로 본 조건부분포 — 축소).
증명. 베이즈 정리로 이고, 에 의존하는 부분만 모으면
의 이차식이므로 정규밀도이고, 완전제곱하면 분산 , 평균 .
축소(shrinkage). 바닥의 위치를 그대로 중간 칸의 추측으로 쓰지 않고 중심 쪽으로 배 줄인다. 이것이 Galton의 회귀이고, 동시에 사전분포 ·관측 의 베이즈 사후평균이다. 16회에서 Stein의 축소추정량이 바로 이 구조임을 본다.
python
S1, S2 = 1.2, 0.8
x1 = rng.normal(0, S1, N_SIM)              # 1단: 중간 칸 위치
y1 = x1 + rng.normal(0, S2, N_SIM)         # 2단: 바닥 위치
B_theory = S1**2 / (S1**2 + S2**2)

fig, axes = plt.subplots(1, 2, figsize=(13, 4), gridspec_kw=dict(width_ratios=[1.4, 1]))
ax = axes[0]                               # 정리 2.1: 섞으면 다시 정규
edges = np.linspace(-5, 5, 81); bw = edges[1] - edges[0]
ax.hist(y1, bins=edges, density=True, color=C["data"], alpha=0.35, label="all compartments released")
for lo, col in [(-1.25, C["stat"]), (0.75, C["assume"])]:
    sel = (x1 > lo) & (x1 < lo + 0.5)      # 중간 칸 하나만 연다
    ax.hist(y1[sel], bins=edges, weights=np.full(sel.sum(), 1 / (N_SIM * bw)), histtype="step", lw=2, color=col,
            label=f"only compartment [{lo:+.2f}, {lo+0.5:+.2f}]: share {sel.mean():.3f}")
yy = np.linspace(-5, 5, 400)
ax.plot(yy, stats.norm.pdf(yy, 0, np.hypot(S1, S2)), **THEORY, label=r"$\mathcal{N}(0,\ \sigma_1^2+\sigma_2^2)$")
ax.set_xlabel("y"); ax.set_title("Theorem 2.1: forward"); ax.legend(fontsize=8, loc="upper left")

ax = axes[1]                               # 따름정리 2.2: 거꾸로 읽으면 축소
ax.scatter(y1[:3000], x1[:3000], s=3, color=C["hist"], alpha=0.4, edgecolors="none")
ax.plot([-5, 5], [-5, 5], color=C["hist"], ls=":", lw=1, label="x = y")
ax.plot([-5, 5], [-5 * B_theory, 5 * B_theory], color=C["key"], lw=2, label=f"E[X | Y = y] = {B_theory:.3f} y")
ax.set_xlim(-5, 5); ax.set_ylim(-4, 4); ax.set_aspect("equal")
ax.set_xlabel("bottom position y"); ax.set_ylabel("middle compartment x"); ax.set_title("Corollary 2.2: backward")
ax.legend(fontsize=8, loc="upper left")
plt.tight_layout(); plt.show()

slope_hat = np.cov(x1, y1)[0, 1] / y1.var()
near = np.abs(y1 - 2.0) < 0.05
print(f"Var(Y): simulated {y1.var():.4f}   theory {S1**2 + S2**2:.4f}")
print(f"slope of E[X|Y]: simulated {slope_hat:.4f}   theory B = {B_theory:.4f}")
print(f"X | Y ≈ 2: mean {x1[near].mean():.3f} (theory {2*B_theory:.3f}), var {x1[near].var():.3f} (theory {S1**2*S2**2/(S1**2+S2**2):.3f})")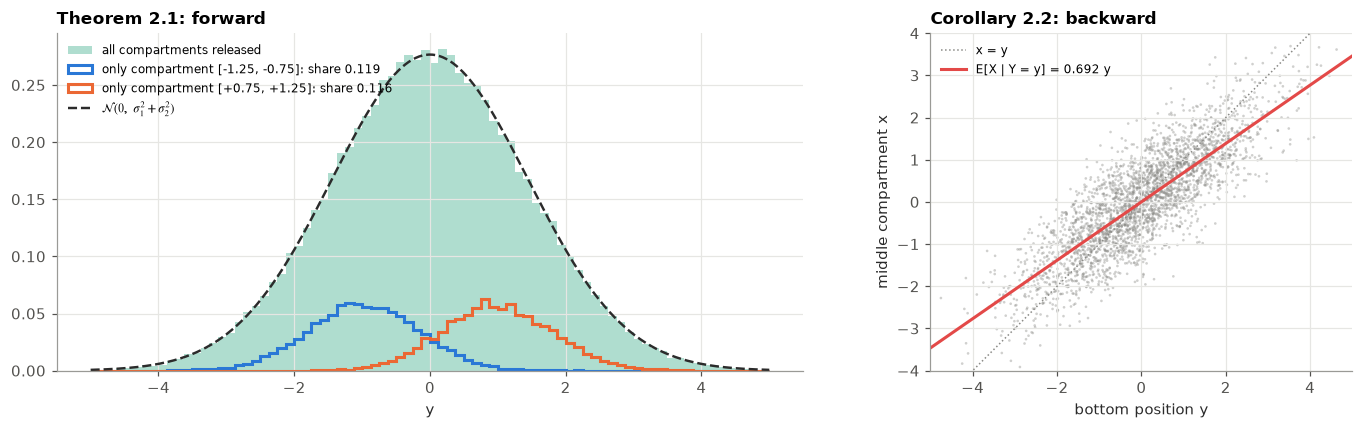
text
Var(Y): simulated 2.0698   theory 2.0800
slope of E[X|Y]: simulated 0.6919   theory B = 0.6923
X | Y ≈ 2: mean 1.408 (theory 1.385), var 0.449 (theory 0.443)
📝 연습 2.3–2.4 (강의노트): 기울기로 확인, 측정을 번 하면(정밀도가 더해진다).
2.3 세대 간 분산의 수수께끼와 reversion
부모의 편차가 전부 물려지고 독립 잡음 가 더해진다면(), 이므로 분산은 세대마다 커져야 한다. 실제로는 그렇지 않다.
명제 2.3 (안정은 회귀를 강요한다). , , , , 일 때 이면
증명. 에서 . 또 이고 .
회귀는 생물학적인 힘이 아니라, 분포가 안정하다는 사실의 대수적 귀결이다. Galton은 1877년 스위트피 씨앗 실험에서 이 계수를 reversion이라 불렀고, 1886년 사람의 키에서 regression이라 다시 불렀다.
python
GEN, POP = 10, 50_000
SIGMA, SIGMA_E = 2.5, 1.5
r = np.sqrt(1 - SIGMA_E**2 / SIGMA**2)
h_full = rng.normal(0, SIGMA, POP)          # C = P + E
h_rev = h_full.copy()                       # C = rP + E
sd_full, sd_rev = [h_full.std()], [h_rev.std()]
for g in range(GEN):
    h_full = h_full + rng.normal(0, SIGMA_E, POP)
    h_rev = r * h_rev + rng.normal(0, SIGMA_E, POP)
    sd_full.append(h_full.std()); sd_rev.append(h_rev.std())

g = np.arange(GEN + 1)
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(g, sd_full, "o", color=C["assume"], label="C = P + E   (full inheritance)")
ax.plot(g, np.sqrt(SIGMA**2 + g * SIGMA_E**2), **THEORY)
ax.plot(g, sd_rev, "o", color=C["stat"], label=f"C = rP + E,  r = {r:.2f}")
ax.plot(g, np.full_like(g, SIGMA, dtype=float), **THEORY, label="theory")
ax.set_xlabel("generation"); ax.set_ylabel("SD of height deviation")
ax.set_title("Proposition 2.3: stability of the population forces regression"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()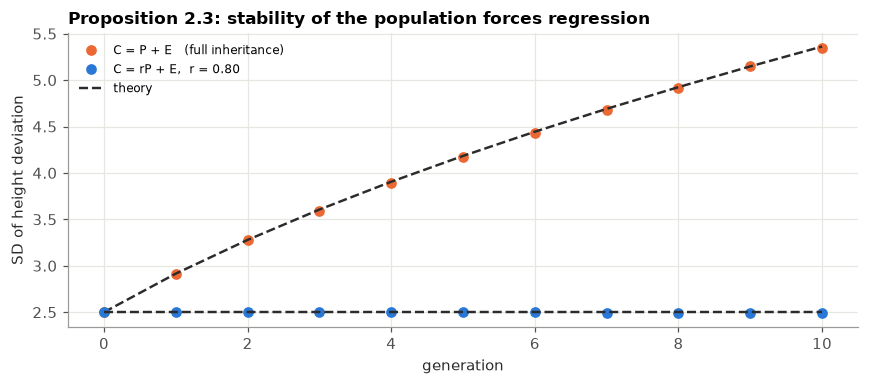
Galton의 실제 자료는 한 부모가 아니라 중간부모(아버지와 1.08배 한 어머니 키의 평균)를 썼다. 이 차이가 Galton의 유명한 두 숫자 과 을 설명한다.
예제 2.4 (중간부모 모형). 아버지 와 (×1.08 한) 어머니 가 독립 , 중간부모 , 자녀 , 라 하자. 이고 안정 조건은 이다.
Galton의 을 넣으면 상관 , 한 부모 기울기 . Galton(1886)이 보고한 두 숫자가 정확히 이것이다. 시뮬레이션과 1886년 원자료로 확인한다.
python
BETA, MU, SD = 2/3, 68.0, 2.5
SD_E = SD * np.sqrt(1 - BETA**2 / 2)                       # 안정 조건
F = rng.normal(MU, SD, N_SIM); Mo = rng.normal(MU, SD, N_SIM)
Mp = (F + Mo) / 2
Ch = MU + BETA * (Mp - MU) + rng.normal(0, SD_E, N_SIM)

slope = lambda x, y: np.cov(x, y)[0, 1] / np.var(x, ddof=1)
print(f"Var(child)/Var(parent)       simulated {Ch.var()/F.var():.3f}   theory 1 (stable)")
print(f"slope on mid-parent          simulated {slope(Mp, Ch):.3f}   theory beta = {BETA:.3f}")
print(f"slope on one parent          simulated {slope(F, Ch):.3f}   theory beta/2 = {BETA/2:.3f}")
print(f"Corr(child, mid-parent)      simulated {np.corrcoef(Mp, Ch)[0,1]:.3f}   theory beta/sqrt(2) = {BETA/np.sqrt(2):.3f}")

gal = load_histdata("Galton")
print(f"\nGalton 1886 data: Corr = {gal.corr().iloc[0,1]:.3f},  Var(mid-parent)/Var(child) = {gal.parent.var()/gal.child.var():.3f} (model: 1/2)")
text
Var(child)/Var(parent)       simulated 0.994   theory 1 (stable)
slope on mid-parent          simulated 0.669   theory beta = 0.667
slope on one parent          simulated 0.333   theory beta/2 = 0.333
Corr(child, mid-parent)      simulated 0.473   theory beta/sqrt(2) = 0.471

Galton 1886 data: Corr = 0.459,  Var(mid-parent)/Var(child) = 0.504 (model: 1/2)
📝 연습 2.5–2.6 (강의노트): 중간부모가 설명하는 분산(), 부부의 키가 상관될 때(동류 교배).
2.4 Galton (1886): 928명의 표와 동심 타원
1886년 논문 Regression towards Mediocrity in Hereditary Stature에서 Galton은 205가족의 성인 자녀 928명의 키를 중간부모 키와 함께 표로 만들었다. 남녀를 한 표에 넣으려고 여성의 키에 1.08을 곱했다(§5.3에서 검토). Galton은 같은 도수의 칸을 이으면 비슷한 모양의 동심 타원이 된다는 것을 알아챘다. 케임브리지의 수학자 J. D. Hamilton Dickson에게 이유를 묻자, Dickson은 이변량 정규분포의 식(예제 3.7)으로 답했다.
python
galton = load_histdata("Galton")           # parent = 중간부모 키, child = 자녀 키 (딸 ×1.08), 단위 inch
XY = galton[["parent", "child"]].to_numpy()
m = XY.mean(axis=0)
S = np.cov(XY.T, bias=True)                # MLE (분모 n)
sx, sy = np.sqrt(np.diag(S)); rho = S[0, 1] / (sx * sy)
b_yx = S[0, 1] / S[0, 0]                   # E[child | parent] 기울기
b_xy = S[0, 1] / S[1, 1]                   # E[parent | child] 기울기
display(pd.DataFrame({"mean": m, "sd": [sx, sy]}, index=["mid-parent x", "child y"]).round(3))
print(f"n = {len(galton)}, corr r = {rho:.3f}, slope b(y|x) = {b_yx:.3f} (Galton: about 2/3), slope b(x|y) = {b_xy:.3f}")| mean | sd | |
|---|---|---|
| mid-parent x | 68.308 | 1.786 |
| child y | 68.088 | 2.517 |
text
n = 928, corr r = 0.459, slope b(y|x) = 0.646 (Galton: about 2/3), slope b(x|y) = 0.326python
# Galton 1886 Plate X 재구성: 칸 도수 + 동심 타원 + 두 회귀선 + 접점
counts = galton.groupby(["parent", "child"]).size()
gx, gy = np.meshgrid(np.linspace(62.5, 74.5, 300), np.linspace(60.5, 75.5, 300))
D = np.stack([gx - m[0], gy - m[1]], axis=-1)
Q = np.einsum("...i,ij,...j->...", D, np.linalg.inv(S), D)   # Mahalanobis 제곱

fig, ax = plt.subplots(figsize=(8.2, 8.6))
for (px, cy), n in counts.items():
    ax.text(px, cy, str(n), ha="center", va="center", fontsize=7.5, color=C["data"], fontweight="bold")
cs = ax.contour(gx, gy, Q, levels=[1, 2.25, 4, 6.25], colors=C["ink"], linewidths=1, linestyles="--")
ax.clabel(cs, fmt={1: "c=1", 2.25: "c=1.5", 4: "c=2", 6.25: "c=2.5"}, fontsize=7)

xline = np.linspace(62.5, 74.5, 2); yline = np.linspace(60.5, 75.5, 2)
ax.plot(xline, m[1] + b_yx * (xline - m[0]), color=C["stat"], lw=2.2, label=f"E[child | parent], slope {b_yx:.2f}")
ax.plot(m[0] + b_xy * (yline - m[1]), yline, color=C["key"], lw=2.2, label=f"E[parent | child] = a + {b_xy:.2f}·child")
ax.plot(xline, m[1] + (sy / sx) * (xline - m[0]), color=C["hist"], lw=1.2, ls=":", label="SD line")
c = 2.0                                                    # c = 2 타원의 접점
vt = np.array([[m[0] + s * c * sx, m[1] + s * rho * c * sy] for s in (-1, 1)])
ht = np.array([[m[0] + s * rho * c * sx, m[1] + s * c * sy] for s in (-1, 1)])
ax.plot(*vt.T, "o", ms=9, mfc="white", mec=C["stat"], mew=2.2, label="vertical tangency (c = 2)")
ax.plot(*ht.T, "s", ms=8, mfc="white", mec=C["key"], mew=2.2, label="horizontal tangency (c = 2)")
ax.set_xlim(62.5, 74.5); ax.set_ylim(60.5, 75.5); ax.set_aspect("equal")
ax.set_xlabel("mid-parent height (inches)"); ax.set_ylabel("adult child height (inches)")
ax.set_title("Galton (1886) reconstructed: 928 children, fitted bivariate normal")
ax.legend(fontsize=8, loc="upper center", bbox_to_anchor=(0.5, -0.07), ncol=2)
plt.tight_layout(); plt.show()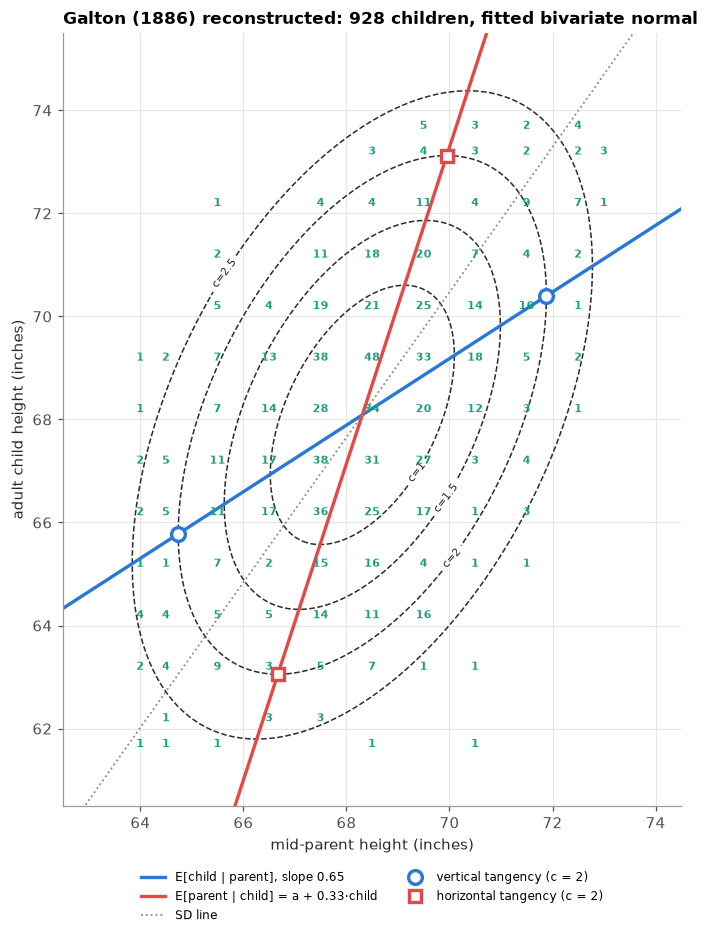
그림 읽기.
- 청록 숫자(칸 도수)는 가운데가 진하고 바깥으로 옅어지며 점선 타원(적합한 이변량 정규의 등고선)과 같은 모양으로 퍼진다. Galton이 본 동심 타원이다.
- 파란 선 의 기울기는 약 0.65로 1보다 작다. Galton은 이를 약 로 읽었다.
- 빨간 선 도 반대 방향으로 평균을 향해 당겨진다. 여는 질문의 두 번째 절반이다.
- 두 회귀선은 타원의 수직 접점(○)과 수평 접점(□)을 지난다. 우연이 아니다. 정리 3.20에서 증명한다.
예제 2.5 (예측과 거꾸로 예측). 조건부 평균은 , 조건부 표준편차는 이다.
python
resid_sd = sy * np.sqrt(1 - rho**2)
for xp in [64, 66, 72]:
    pred = m[1] + b_yx * (xp - m[0])
    print(f"mid-parent {xp} in → E[child] = {pred:.2f} in,  95% prediction interval [{pred - 1.96*resid_sd:.2f}, {pred + 1.96*resid_sd:.2f}]")
print(f"child 73 in → E[mid-parent] = {m[0] + b_xy * (73 - m[1]):.2f} in")
text
mid-parent 64 in → E[child] = 65.30 in,  95% prediction interval [60.92, 69.69]
mid-parent 66 in → E[child] = 66.60 in,  95% prediction interval [62.21, 70.98]
mid-parent 72 in → E[child] = 70.47 in,  95% prediction interval [66.09, 74.86]
child 73 in → E[mid-parent] = 69.91 in
📝 연습 2.7 (강의노트): 중간부모 66인치 가족의 예측구간 — 위 셀의 두 번째 줄로 확인할 수 있다. 이 구간이 정당하려면 어떤 가정이 필요한가?
3. 다변량 정규분포
Galton의 타원을 설명하려면 정규분포를 여러 변수로 넓혀야 한다. 목표는 정리 A–D(지도 그림)를 엄밀하게 세우는 것이다. 먼저 필요한 행렬 도구를 증명과 함께 정리한다.
3.1 행렬 준비
확률벡터 의 평균 , 공분산 , 곧 .
보조정리 3.1. , . 특히 이므로 는 반정치다.
보조정리 3.2 (스펙트럼 분해·제곱근·Cholesky). 대칭 반정치 ( 직교, ). 는 대칭이고 . 이면 이고, 대각원소가 양수인 하삼각 로 (Cholesky)이다.
정규분포를 구성할 때는 인 행렬 하나만 있으면 된다. 도 도 그런 다.
보조정리 3.3 (블록 행렬과 Schur 보수). , 가역, , , 이면 (a) (b) (c) (d) (e)
증명. , 이다.
여기에 를 오른쪽에 곱하면 (2,1) 블록이 이 되어 (a). 이므로 (b). 가 가역이라 (c). (a)에서 , 를 블록 곱하면 (d). , 이므로 (e).
이 보조정리 하나가 정리 C의 두 번째 증명, 정밀도행렬 표현(정리 3.15), 행렬식 공식을 모두 준다. 수치로 먼저 확인한다.
python
# 보조정리 3.3 수치 확인 (무작위 5x5 양정치 행렬, 블록 2 + 3)
A_ = rng.normal(size=(5, 5)); Sig_ = A_ @ A_.T + np.eye(5)
i1, i2 = [0, 1], [2, 3, 4]
S11, S12, S22 = Sig_[np.ix_(i1, i1)], Sig_[np.ix_(i1, i2)], Sig_[np.ix_(i2, i2)]
B_ = S12 @ np.linalg.inv(S22)
Schur = S11 - B_ @ S12.T
T_ = np.block([[np.eye(2), -B_], [np.zeros((3, 2)), np.eye(3)]])
Inv = np.linalg.inv(Sig_)
x_ = rng.normal(size=5)
report({
    "(a) T Σ T' = diag(Schur, Σ22)": np.allclose(T_ @ Sig_ @ T_.T, np.block([[Schur, np.zeros((2, 3))], [np.zeros((3, 2)), S22]])),
    "(b) |Σ| = |Σ22| |Schur|": np.isclose(np.linalg.det(Sig_), np.linalg.det(S22) * np.linalg.det(Schur)),
    "(d) (Σ^-1)_11 = Schur^-1": np.allclose(Inv[np.ix_(i1, i1)], np.linalg.inv(Schur)),
    "(d) (Σ^-1)_12 = -Schur^-1 B": np.allclose(Inv[np.ix_(i1, i2)], -np.linalg.inv(Schur) @ B_),
    "(e) quadratic form splits": np.isclose(x_ @ Inv @ x_,
        (x_[i1] - B_ @ x_[i2]) @ np.linalg.solve(Schur, x_[i1] - B_ @ x_[i2]) + x_[i2] @ np.linalg.solve(S22, x_[i2])),
})
text
  ✓  (a) T Σ T' = diag(Schur, Σ22)
  ✓  (b) |Σ| = |Σ22| |Schur|
  ✓  (d) (Σ^-1)_11 = Schur^-1
  ✓  (d) (Σ^-1)_12 = -Schur^-1 B
  ✓  (e) quadratic form splits
📝 연습 3.1–3.2 (강의노트): 에서 직접 확인, 정밀도행렬의 블록 .
3.2 정의 · 구성 · 밀도
정의 3.4 (mgf에 의한 정의). 차원 확률벡터 의 mgf가 모든 에서
이면( 대칭 반정치) 라 쓴다.
왜 mgf로 정의하는가. (a) 가 특이해 밀도가 없는 경우까지 포함한다(§5.4). (b) 정리 A가 한 줄로 끝난다. (c) mgf가 분포를 결정한다. 단점은 그런 분포가 존재함을 따로 보여야 한다는 것이다.
정리 3.5 (존재와 모수의 의미). , 이면 이고 , .
증명.
그런 는 보조정리 3.2로 항상 존재한다. 평균과 공분산은 보조정리 3.1에 를 넣으면 나온다.
분포는 가 아니라 에만 의존한다. 이 구성이 그대로 샘플러다(§4의 rvs, 자리에 Cholesky 인수 ).
정리 3.6 (밀도). 이면
증명. 로 잡으면 는 일대일이고 역변환 의 야코비안은 . 의 밀도 에서 . 보조정리 0.2로 결론.
예제 3.7 (이변량 — Dickson의 식). , 이면 , . , 로 쓰면
지수의 이차형식 이 상수인 곡선이 Galton의 타원이다.
python
fig, axes = plt.subplots(1, 3, figsize=(12, 4))
g_ = np.linspace(-3.2, 3.2, 250); gx_, gy_ = np.meshgrid(g_, g_)
for ax, r_ in zip(axes, [-0.7, 0.0, 0.7]):
    mv = stats.multivariate_normal([0, 0], [[1, r_], [r_, 1]])
    pts = mv.rvs(500, random_state=1)
    ax.scatter(*pts.T, s=6, color=C["data"], alpha=0.5, edgecolors="none")
    ax.contour(gx_, gy_, mv.pdf(np.dstack([gx_, gy_])), levels=5, colors=C["ink"], linewidths=1, linestyles="--")
    ax.set_title(rf"$\rho = {r_}$"); ax.set_aspect("equal"); ax.set_xlim(-3.2, 3.2); ax.set_ylim(-3.2, 3.2); ax.set_xlabel("x")
axes[0].set_ylabel("y")
plt.tight_layout(); plt.show()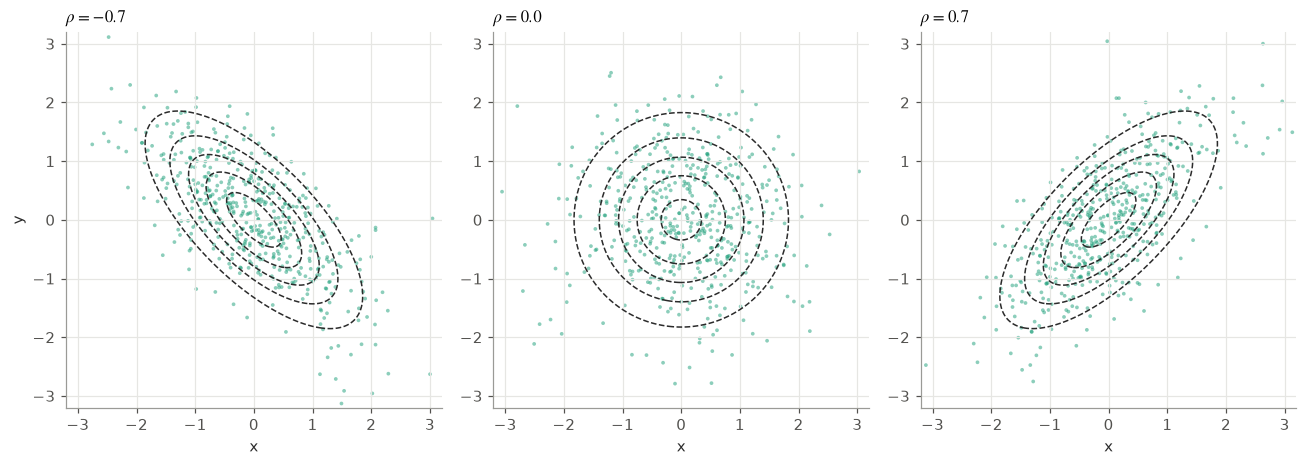
📝 연습 3.3–3.4 (강의노트): 인수분해 , 사분면 확률 .
3.3 정리 A — 선형변환
정리 3.8 (정리 A). , 는 , 이면 .
증명. .
따름정리 3.9 (주변분포). 으로 . 결합정규의 주변분포는 모두 정규다. 역은 거짓이다(§5.1).
그러면 무엇이 결합정규를 판정하는가? 답은 "모든 선형결합"이다.
정리 3.10 (Cramér–Wold 판정). 가 결합정규 모든 에 대해 가 (분산 0을 포함한) 단변량 정규.
증명. () 정리 A에서 . () 각 가 정규이므로 가 존재하고 이므로
📝 연습 3.5–3.6 (강의노트): 선형결합 하나의 분포, 특이 공분산과 상수 선형결합.
3.4 정리 B — 독립 ⇔ 무상관 (단, 결합정규일 때만)
정리 3.11 (정리 B). 이면 .
증명. () 독립이면 공분산은 0. () 로 나누면 . 이면 로 쪼개지고, 결합 mgf가 주변 mgf의 곱이므로 독립이다.
가정 주의. 가정은 "과 가 각각 정규"가 아니라 "가 결합정규"다. 증명에서 결합 mgf의 식을 쓴 곳이 바로 이 가정이다. §5.1에서 이 가정을 빼면 무상관이지만 종속인 정규 쌍이 생긴다.
따름정리 3.12. 결합정규의 성분이 상호 독립 가 대각. 결합정규에서는 쌍별 무상관이 상호 독립을 준다. 6회에서 이것으로 정규표본의 를 증명한다.
📝 연습 3.7 (강의노트): 분산이 같으면 .
3.5 정리 C — 조건부분포 (이번 회차의 핵심)
정리 3.13 (정리 C). , 이면
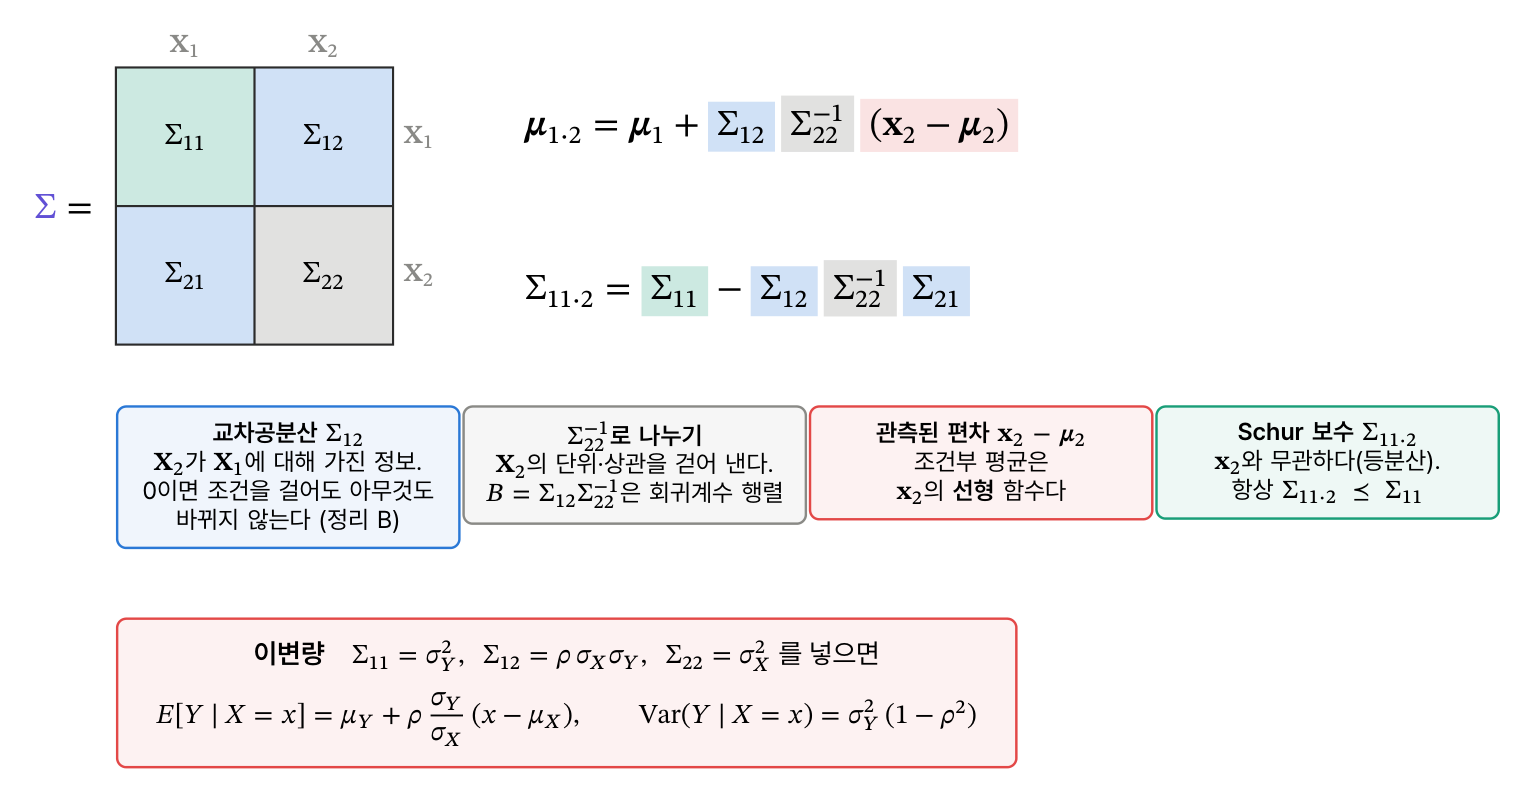
증명 1 (무상관 분해). , .
- 결합정규. (는 보조정리 3.3의 블록 행렬)이므로 정리 A에 의해 결합정규다.
- 무상관. — 의 정의 그대로.
- 독립. 1과 2에 정리 B를 쓰면 .
- 모수. , 그리고 보조정리 3.1로
- 조건부. 이고 는 와 독립이므로, 로 조건을 걸어도 의 분포는 그대로다. 따라서 .
기하로 보기. 내적 에서 는 의 직교사영, 는 그 잔차다.
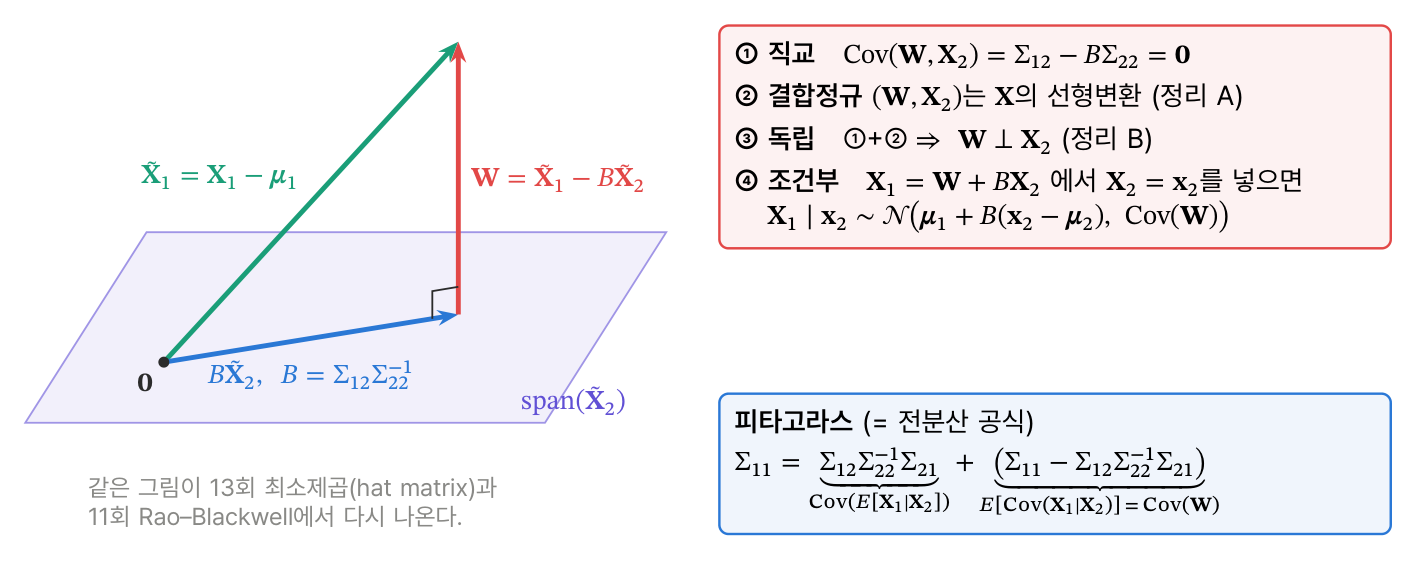
증명 2 (밀도의 비, ). 에 보조정리 3.3 (e)와 (b)를 쓰면 결합밀도가 두 정규밀도의 곱으로 쪼개진다.
따름정리 3.14 (세 성질). (a) 선형성 . (b) 등분산 는 에 무관. (c) 피타고라스 , 따라서 : 조건을 걸면 불확실성이 줄어든다.
정리 3.15 (정밀도행렬 표현). 을 같게 나누면 .
증명. 보조정리 3.3 (d)에서 , 이므로 .
조건부 독립과 정밀도의 0. , 나머지로 두면 이고 역행렬의 비대각원소는 . 따라서 (연습 3.11). 의 0은 주변 무상관, 의 0은 조건부 무상관이다. 가우시안 그래프 모형과 graphical lasso가 이 사실 위에 서 있다.
예제 3.16 (3×3 손계산). , 에서 :
이면 . 검산: , 이므로 ✓, ✓, ✓, ✓.
읽을거리. 이므로 (결합정규). 그런데 를 알면 의 계수가 이다(). 주변으로는 독립인데 조건부로는 종속 — 공통의 자손 를 통한 연결이다. §4.3에서 코드로 확인한다.
📝 연습 3.8–3.11 (강의노트): 다른 조건 걸기, 조건을 더 걸면 분산이 준다, 최선의 예측 vs 최선의 선형 예측, 조건부 독립 .
3.6 정리 D — 이차형식과 확률 타원
정리 3.17 (정리 D). , 이면 .
증명. (정리 A). 따름정리 3.12로 는 독립 이고 (따름정리 1.9).
따름정리 3.18 (확률 타원). 에 대해 . 는 고유벡터 방향으로 반지름 인 타원체이고, 이면
증명. 로 회전하면 이므로 조건이 . 는 평균 2인 지수분포. 넓이는 .
95% 타원은 . 밀도가 만의 함수이므로 등고선이 곧 확률 타원이다.
📝 연습 3.12–3.13 (강의노트): Galton의 95% 타원(반지름 6.64, 3.61인치, 넓이 75.2), 모든 방향을 동시에 — Scheffé 동시구간의 원형.
3.7 이변량의 경우 — 회귀식, 그리고 접점
따름정리 3.19 (이변량 회귀식). 정리 C에 , , 를 넣으면
표준화하면 이고 자리를 바꿔도 .
이면 양쪽 방향 모두 평균 쪽으로 당겨진다. 는 가 설명하는 분산의 비율이다. 회귀는 인과의 방향이 아니라 대칭적인 기하다. 이것이 여는 질문의 답이다.
정리 3.20 (접점의 자취). 회귀선 는 등고 타원들의 수직 접점의 자취이고, 는 수평 접점의 자취다.
증명 1 (조건부밀도). 고정된 에서 이고 는 에서 유일하게 최대다. 따라서 수직선 는 볼록집합 와 한 점에서만 만나는 받침선이고, 매끄러운 타원에서 받침선은 접선이다.
증명 2 (음함수 미분). 등고선 에서 접선이 수직 가 수평 :
이면 의 고유벡터가 (고유값 )와 이므로 장축은 기울기 1의 'SD 선'이다. 두 회귀선은 그 양쪽에 놓인다.
python
# 정리 3.20: 표준화 이변량 정규, rho = 0.6
RHO = 0.6
t = np.linspace(0, 2 * np.pi, 400)
lam, V = np.linalg.eigh(np.array([[1, RHO], [RHO, 1]]))
fig, ax = plt.subplots(figsize=(6.4, 6.4))
for cc in [1, 1.5, 2, 2.5]:
    ax.plot(*((V * np.sqrt(lam)) @ np.vstack([np.cos(t), np.sin(t)]) * cc), color=C["ink"], lw=1, ls="--")  # 반지름 c·sqrt(λ)
    ax.plot([-cc, cc], [-RHO * cc, RHO * cc], "o", ms=8, mfc="white", mec=C["stat"], mew=2)
    ax.plot([-RHO * cc, RHO * cc], [-cc, cc], "s", ms=7, mfc="white", mec=C["key"], mew=2)
    ax.plot([cc, cc], [RHO * cc - 0.45, RHO * cc + 0.45], color=C["stat"], lw=1)    # 수직 접선 조각
xs_ = np.array([-3, 3])
ax.plot(xs_, RHO * xs_, color=C["stat"], lw=2.2, label=r"$E[Z_Y\mid Z_X=z]=\rho z$")
ax.plot(RHO * xs_, xs_, color=C["key"], lw=2.2, label=r"$E[Z_X\mid Z_Y=z]=\rho z$")
ax.plot(xs_, xs_, color=C["hist"], lw=1.2, ls=":", label="major axis = SD line")
ax.set_xlim(-3, 3); ax.set_ylim(-3, 3); ax.set_aspect("equal")
ax.set_xlabel(r"$z_X$"); ax.set_ylabel(r"$z_Y$"); ax.set_title(r"Theorem 3.20: tangency loci ($\rho=0.6$)")
ax.legend(fontsize=8, loc="upper left")
plt.tight_layout(); plt.show()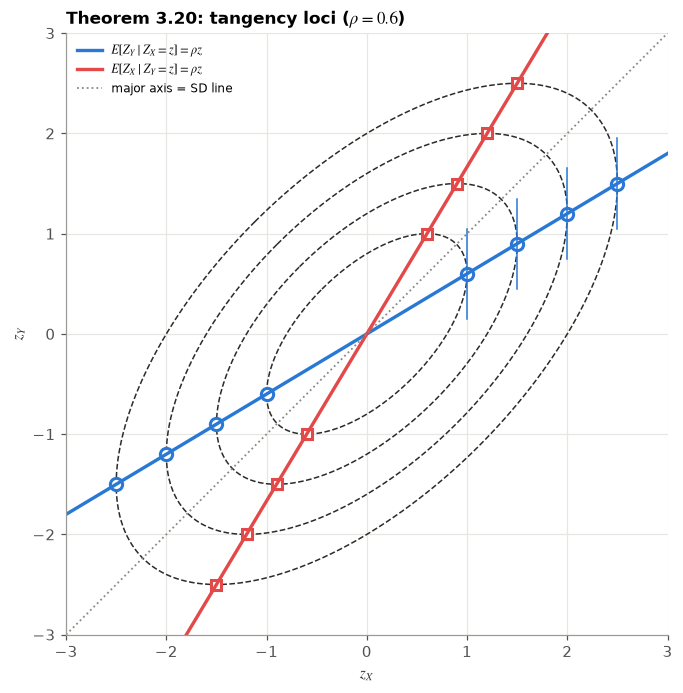
회귀의 오류 (regression fallacy). Kahneman의 비행교관 일화: 교관들은 "칭찬하면 다음 비행이 나빠지고 질책하면 좋아진다"고 믿었다. 그러나 두 번의 비행 성적이 같은 실력 에 잡음이 더해진 값 , 이면 는 이변량 정규이고
극단적인 성적 다음에는 아무 개입이 없어도 평균 쪽 성적이 나온다. 회귀는 원인이 필요 없는 현상이다(연습 3.15).
python
# 칭찬도 질책도 하지 않은 비행교관: 실력 T, 두 번의 비행 X, Y
TAU, NOISE = 1.0, 1.0
T = rng.normal(0, TAU, N_SIM)
X_f = T + rng.normal(0, NOISE, N_SIM)
Y_f = T + rng.normal(0, NOISE, N_SIM)
best, worst = X_f > np.quantile(X_f, 0.9), X_f < np.quantile(X_f, 0.1)
R = TAU**2 / (TAU**2 + NOISE**2)
print(f"top 10% on flight 1:    mean X = {X_f[best].mean():+.2f}  →  mean Y = {Y_f[best].mean():+.2f}   (theory R·mean X = {R*X_f[best].mean():+.2f})")
print(f"bottom 10% on flight 1: mean X = {X_f[worst].mean():+.2f}  →  mean Y = {Y_f[worst].mean():+.2f}   (theory {R*X_f[worst].mean():+.2f})")
print("아무도 칭찬하거나 질책하지 않았다.")
text
top 10% on flight 1:    mean X = +2.48  →  mean Y = +1.23   (theory R·mean X = +1.24)
bottom 10% on flight 1: mean X = -2.47  →  mean Y = -1.23   (theory -1.24)
아무도 칭찬하거나 질책하지 않았다.
📝 연습 3.14–3.15 (강의노트): 기울기의 순서(Galton: ), 시험–재시험 모형 — 비행교관의 결론은 무엇이 틀렸는가.
4. 코드 랩 — 정리를 알고리즘으로
Legend13 노트북의 흐름 그대로다. 논문 대신 정리를 보고 클래스를 직접 짜고, torchinfo.summary 대신 scipy와 대조하고, 마지막으로 시뮬레이션으로 정리 자체를 확인한다. 이 클래스는 6회 이후 mstat 모듈로 옮겨 계속 쓴다.
| 메서드 | 알고리즘 (강의노트 4절) | 근거 |
|---|---|---|
rvs |
한 번, 표본마다 | 정리 3.5 |
mahalanobis2 |
를 풀고 | |
logpdf |
정리 3.6, $ | |
conditional |
을 풀어 , Schur 보수 | 정리 3.13 |
원칙: 역행렬을 만들지 않는다. 을 직접 계산하면 느리고, 가 특이에 가까울 때 수치 오차가 커진다. Cholesky가 실패하면(반정치) 고유분해 로 샘플링만 한다.
python
class MVN:
    """다변량 정규 N_n(mu, Sigma) — numpy만으로 구현"""

    def __init__(self, mu, Sigma):
        self.mu = np.atleast_1d(np.asarray(mu, float))
        self.Sigma = np.atleast_2d(np.asarray(Sigma, float))
        self.n = self.mu.size
        assert self.Sigma.shape == (self.n, self.n) and np.allclose(self.Sigma, self.Sigma.T)
        try:
            self.L = np.linalg.cholesky(self.Sigma)            # Sigma = L L'  (양정치)
            self.singular = False
        except np.linalg.LinAlgError:                           # 반정치: A = V sqrt(Lambda)
            lam, V = np.linalg.eigh(self.Sigma)
            assert lam.min() > -1e-8 * max(1.0, lam.max()), "Sigma 는 반정치여야 한다"
            self.L = V * np.sqrt(np.clip(lam, 0, None))
            self.singular = True

    def rvs(self, size, rng):
        z = rng.standard_normal((size, self.n))
        return self.mu + z @ self.L.T                           # X = mu + A Z  (정리 3.5)

    def mahalanobis2(self, x):
        assert not self.singular, "특이 Sigma: 역행렬이 없다"
        d = np.atleast_2d(x) - self.mu
        u = np.linalg.solve(self.L, d.T)                        # L u = d  ->  u'u = d' Sigma^-1 d
        return np.sum(u**2, axis=0)

    def logpdf(self, x):
        assert not self.singular, "특이 Sigma 에는 밀도가 없다 (mgf 정의는 그대로 유효)"
        logdet = 2 * np.sum(np.log(np.diag(self.L)))
        return -0.5 * (self.n * np.log(2 * np.pi) + logdet + self.mahalanobis2(x))

    def marginal(self, idx):                                    # 따름정리 3.9, C = 선택행렬
        i = np.atleast_1d(idx)
        return MVN(self.mu[i], self.Sigma[np.ix_(i, i)])

    def conditional(self, idx, given, x_given):                 # 정리 3.13
        i, j = np.atleast_1d(idx), np.atleast_1d(given)
        S11 = self.Sigma[np.ix_(i, i)]
        S12 = self.Sigma[np.ix_(i, j)]
        S22 = self.Sigma[np.ix_(j, j)]
        B = np.linalg.solve(S22, S12.T).T                       # B = S12 S22^-1
        mu = self.mu[i] + B @ (np.atleast_1d(np.asarray(x_given, float)) - self.mu[j])
        S = S11 - B @ S12.T                                     # Schur 보수
        return MVN(mu, (S + S.T) / 2)                           # 반올림 비대칭 제거
4.1 대조 — torchinfo.summary 자리
조건부분포는 정리 3.13(공분산 블록)과 정리 3.15(정밀도행렬)라는 서로 다른 두 공식으로 계산해 맞춰 본다.
python
mu = np.array([1.0, -2.0, 0.5])
A = rng.normal(size=(3, 3))
Sigma = A @ A.T + 0.5 * np.eye(3)
mine, ref = MVN(mu, Sigma), stats.multivariate_normal(mu, Sigma)
x = ref.rvs(size=8, random_state=3)
sample = mine.rvs(N_SIM, rng)

Lam = np.linalg.inv(Sigma)                       # 정리 3.15: 정밀도행렬로 독립 검산
x2 = np.array([0.3, -0.7])
cond = mine.conditional(0, [1, 2], x2)
mu_prec = mu[0] - (Lam[0, 1:] @ (x2 - mu[1:])) / Lam[0, 0]

report({
    "logpdf  == scipy.stats.multivariate_normal": np.allclose(mine.logpdf(x), ref.logpdf(x)),
    "marginal([0, 2]).logpdf == scipy": np.allclose(
        mine.marginal([0, 2]).logpdf(x[:, [0, 2]]),
        stats.multivariate_normal(mu[[0, 2]], Sigma[np.ix_([0, 2], [0, 2])]).logpdf(x[:, [0, 2]])),
    "rvs: sample mean ~ mu (tol 0.03)": np.allclose(sample.mean(axis=0), mu, atol=0.03),
    "rvs: sample cov ~ Sigma (tol 3%)": np.allclose(np.cov(sample.T), Sigma, rtol=0.03, atol=0.03),
    "conditional variance == 1 / Lambda_11  (Thm 3.15)": np.isclose(cond.Sigma[0, 0], 1 / Lam[0, 0]),
    "conditional mean == precision-matrix formula": np.isclose(cond.mu[0], mu_prec),
})
print("\nshape check:", mine.rvs(4, rng).shape, mine.logpdf(x).shape, cond.mu.shape, cond.Sigma.shape)
text
  ✓  logpdf  == scipy.stats.multivariate_normal
  ✓  marginal([0, 2]).logpdf == scipy
  ✓  rvs: sample mean ~ mu (tol 0.03)
  ✓  rvs: sample cov ~ Sigma (tol 3%)
  ✓  conditional variance == 1 / Lambda_11  (Thm 3.15)
  ✓  conditional mean == precision-matrix formula

shape check: (4, 3) (8,) (1,) (1, 1)
4.2 정리 C를 시뮬레이션으로 — Galton의 '세로 기둥'
Galton은 중간부모 키가 같은 칸(세로 기둥)마다 자녀 키의 분포를 따로 보았다. 큰 표본에서 인 좁은 띠를 잘라 내면 그 안의 분포가 여야 한다. (띠 폭이 0이 아니어서 가 큰 띠에서는 표본 조건부 평균이 이론값보다 0.01쯤 안쪽에 나온다.)
python
RHO, H = 0.6, 0.05
biv = MVN([0, 0], [[1, RHO], [RHO, 1]])
big = biv.rvs(N_BIG, rng)

fig, axes = plt.subplots(1, 2, figsize=(12, 4.4), gridspec_kw=dict(width_ratios=[1, 1.25]))
ax, ax2 = axes
ax.scatter(*big[:4000].T, s=4, color=C["hist"], alpha=0.4, edgecolors="none")
ax.plot([-3.5, 3.5], [-3.5 * RHO, 3.5 * RHO], color=C["ink"], lw=1.2, ls="--", label=r"$\rho x$")
yy = np.linspace(-4, 4, 300)
for x0, col in zip([-1.5, 0.0, 1.5], [C["stat"], C["data"], C["assume"]]):
    strip = big[np.abs(big[:, 0] - x0) < H, 1]
    ax.axvspan(x0 - 3 * H, x0 + 3 * H, color=col, alpha=0.25)
    ax.plot(x0, strip.mean(), "o", color=col, ms=8, mec="white", mew=1.5)
    cd = biv.conditional(1, 0, x0)
    ax2.hist(strip, bins=60, density=True, histtype="step", lw=2, color=col, label=f"x0 = {x0:+.1f}")
    ax2.plot(yy, stats.norm.pdf(yy, cd.mu[0], np.sqrt(cd.Sigma[0, 0])), **THEORY)
    print(f"x0 = {x0:+.1f}: n = {strip.size:5d}   mean {strip.mean():+.3f} (theory {cd.mu[0]:+.3f})   var {strip.var():.3f} (theory {cd.Sigma[0, 0]:.3f})")
ax.set_aspect("equal"); ax.set_xlim(-3.5, 3.5); ax.set_ylim(-3.5, 3.5)
ax.set_xlabel("x"); ax.set_ylabel("y"); ax.set_title("vertical strips |x − x0| < 0.05"); ax.legend(fontsize=8, loc="upper left")
ax2.set_xlabel("y"); ax2.set_title(r"Y within each strip vs  $\mathcal{N}(\rho x_0,\ 1-\rho^2)$"); ax2.legend(fontsize=8, loc="upper left")
plt.tight_layout(); plt.show()
text
x0 = -1.5: n = 12894   mean -0.899 (theory -0.900)   var 0.628 (theory 0.640)
x0 = +0.0: n = 39969   mean -0.001 (theory +0.000)   var 0.641 (theory 0.640)
x0 = +1.5: n = 12872   mean +0.893 (theory +0.900)   var 0.631 (theory 0.640)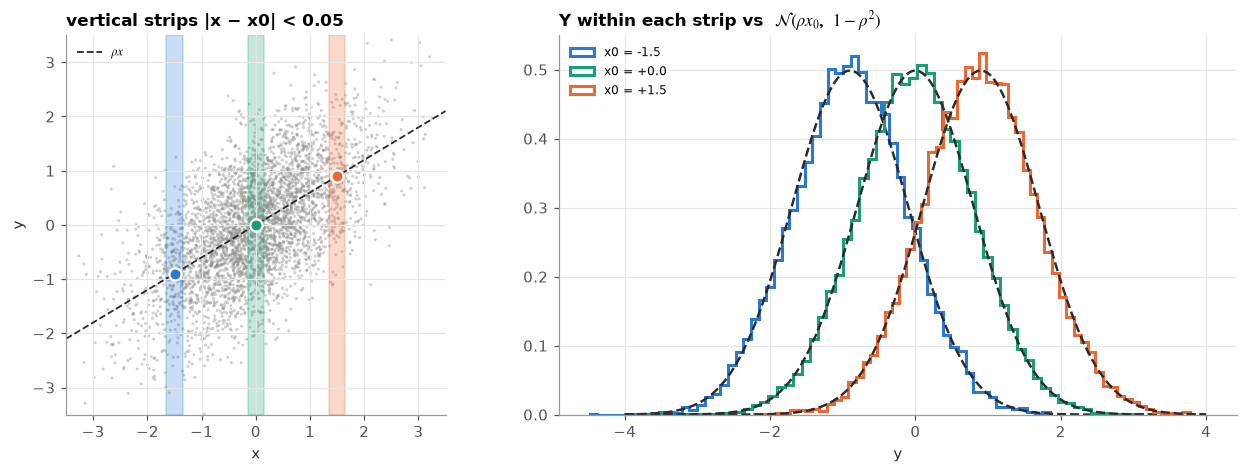
4.3 예제 3.16을 코드로 — 손계산 · 공식 · Monte Carlo
python
mu3 = np.array([1.0, 0.0, -1.0])
Sig3 = np.array([[4.0, 2.0, 0.0],
                 [2.0, 2.0, 1.0],
                 [0.0, 1.0, 2.0]])
G3 = MVN(mu3, Sig3)
cd3 = G3.conditional(0, [1, 2], [1.0, 0.0])
print("손계산:  X1 | (1, 0) ~ N(5/3, 4/3) =", (round(5/3, 4), round(4/3, 4)))
print("공식:    mean, var =", cd3.mu.round(4), cd3.Sigma.round(4).ravel())
print("정밀도:  4 * Sigma^-1 =\n", (4 * np.linalg.inv(Sig3)).round(6))

X3 = G3.rvs(N_BIG, rng)
box = np.all(np.abs(X3[:, 1:] - np.array([1.0, 0.0])) < 0.05, axis=1)
se = X3[box, 0].std() / np.sqrt(box.sum())
print(f"Monte Carlo ({box.sum():,} points in box): mean {X3[box, 0].mean():.3f} ± {2*se:.3f}, var {X3[box, 0].var():.3f}")

# 주변 독립, 조건부 종속: Corr(X1, X3) = 0 이지만 X2 근처에서는 음의 상관
near2 = np.abs(X3[:, 1] - 1.0) < 0.05
print(f"\nCorr(X1, X3) overall {np.corrcoef(X3[:, 0], X3[:, 2])[0, 1]:+.3f}   |  given X2 ≈ 1: {np.corrcoef(X3[near2, 0], X3[near2, 2])[0, 1]:+.3f}")
print(f"theory given X2: {-(4*np.linalg.inv(Sig3))[0, 2] / np.sqrt((4*np.linalg.inv(Sig3))[0, 0] * (4*np.linalg.inv(Sig3))[2, 2]):+.3f}  (= -Λ13 / sqrt(Λ11 Λ33) restricted to (X1,X3) | X2)")
text
손계산:  X1 | (1, 0) ~ N(5/3, 4/3) = (1.6667, 1.3333)
공식:    mean, var = [1.6667] [1.3333]
정밀도:  4 * Sigma^-1 =
 [[ 3. -4.  2.]
 [-4.  8. -4.]
 [ 2. -4.  4.]]
text
Monte Carlo (658 points in box): mean 1.688 ± 0.089, var 1.300

Corr(X1, X3) overall +0.001   |  given X2 ≈ 1: -0.574
theory given X2: -0.577  (= -Λ13 / sqrt(Λ11 Λ33) restricted to (X1,X3) | X2)
마지막 줄의 '이론값'은 엄밀히는 의 조건부 상관이다. 이는 블록에 정리 3.13을 쓰면 나오는데, 위에 찍은 는 나머지 전부()가 주어졌을 때의 편상관이다. 여기서는 나머지가 하나뿐이라 둘이 같다.
4.4 정리 D를 시뮬레이션으로 — Mahalanobis 제곱은
python
Q3 = G3.mahalanobis2(X3[:N_SIM])
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))
ax = axes[0]
ax.hist(Q3, bins=np.linspace(0, 16, 81), density=True, color=C["data"], label="Q simulated (n = 3)")
qq = np.linspace(0.01, 16, 300)
ax.plot(qq, stats.chi2.pdf(qq, 3), **THEORY, label=r"$\chi^2(3)$ density")
ax.set_xlabel("Q"); ax.set_title(r"$(\mathbf{X}-\mu)'\Sigma^{-1}(\mathbf{X}-\mu)$"); ax.legend(fontsize=8)
ax = axes[1]
probs = (np.arange(1, 200) - 0.5) / 199
ax.plot(stats.chi2.ppf(probs, 3), np.quantile(Q3, probs), "o", ms=3, color=C["data"], label="quantiles")
ax.plot([0, 15], [0, 15], **THEORY, label="y = x")
ax.set_xlabel(r"$\chi^2(3)$ quantile"); ax.set_ylabel("simulated quantile"); ax.set_title("Q–Q plot"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()

c2 = stats.chi2.ppf(0.95, 2)
inside = (biv.mahalanobis2(big[:N_SIM]) <= c2).mean()
print(f"95% ellipse (n = 2): c^2 = {c2:.3f} = -2 log 0.05 = {-2*np.log(0.05):.3f},  coverage simulated {inside:.4f}")
lam_g = np.linalg.eigvalsh(S)
print(f"Galton 95% ellipse: semi-axes {np.sqrt(c2 * lam_g)[::-1].round(2)} in,  area {np.pi * c2 * np.sqrt(np.linalg.det(S)):.1f} in^2")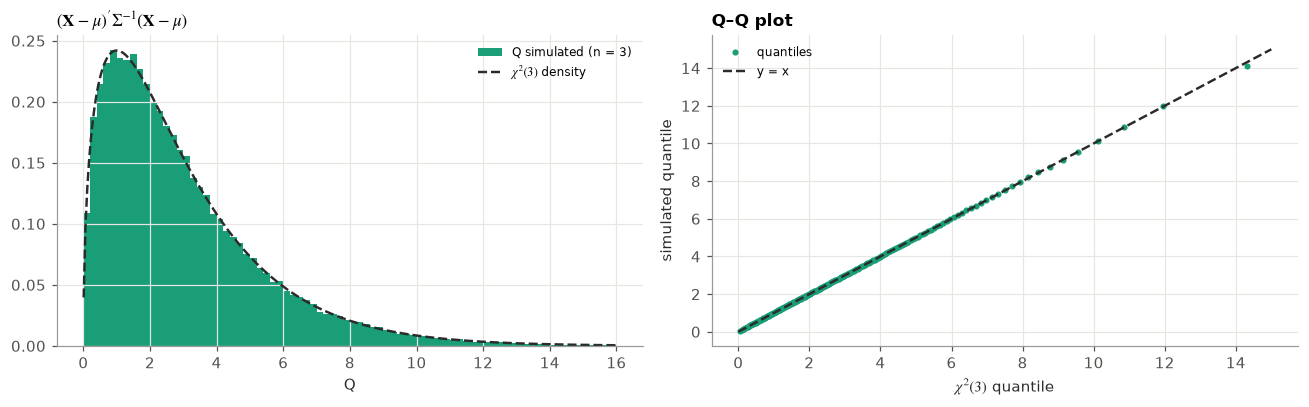
text
95% ellipse (n = 2): c^2 = 5.991 = -2 log 0.05 = 5.991,  coverage simulated 0.9489
Galton 95% ellipse: semi-axes [6.64 3.61] in,  area 75.2 in^2
4.5 Galton 데이터에 정리 C를 그대로 쓰기
(분모 )를 넣은 조건부 평균의 기울기 는 OLS 기울기 와 정확히 같다. 분모 이 약분되기 때문이다. 곧 이변량 정규의 MLE를 넣은 조건부 평균 = 최소제곱 직선이다. 13회에서 이것을 일반 선형모형으로 넓힌다.
python
G = MVN(m, S)                                   # Galton 자료의 MLE를 모수로
cond_at = lambda xv: G.conditional(1, 0, xv).mu[0]
slope_formula = cond_at(m[0] + 1) - cond_at(m[0])
slope_ols, icpt_ols = np.polyfit(galton.parent, galton.child, 1)
report({
    "conditional-mean slope == OLS slope (np.polyfit)": np.isclose(slope_formula, slope_ols),
    "conditional-mean intercept == OLS intercept": np.isclose(cond_at(0.0), icpt_ols),
    "Var(child | parent) == S_yy (1 - r^2)": np.isclose(G.conditional(1, 0, 68).Sigma[0, 0], S[1, 1] * (1 - rho**2)),
})

by_p = galton.groupby("parent").child.agg(["mean", "size"])
by_c = galton.groupby("child").parent.agg(["mean", "size"])
fig, axes = plt.subplots(1, 2, figsize=(12, 4.4))
for ax, tab, xl, yl, b, col, title, (mx, my) in [
        (axes[0], by_p, "mid-parent height", "mean child height", b_yx, C["stat"], "children of a given mid-parent", (m[0], m[1])),
        (axes[1], by_c, "child height", "mean mid-parent height", b_xy, C["key"], "mid-parents of a given child", (m[1], m[0]))]:
    ax.scatter(tab.index, tab["mean"], s=tab["size"] * 1.2, color=col, alpha=0.8, label="group means (area = count)")
    xs_ = np.array([tab.index.min(), tab.index.max()])
    ax.plot(xs_, my + b * (xs_ - mx), color=col, lw=2, label=f"slope {b:.2f}")
    ax.plot(xs_, my + (xs_ - mx), color=C["hist"], ls=":", lw=1.2, label="slope 1 (no regression)")
    ax.set_xlabel(xl + " (in)"); ax.set_ylabel(yl + " (in)"); ax.set_title(title); ax.legend(fontsize=8, loc="upper left")
plt.tight_layout(); plt.show()
text
  ✓  conditional-mean slope == OLS slope (np.polyfit)
  ✓  conditional-mean intercept == OLS intercept
  ✓  Var(child | parent) == S_yy (1 - r^2)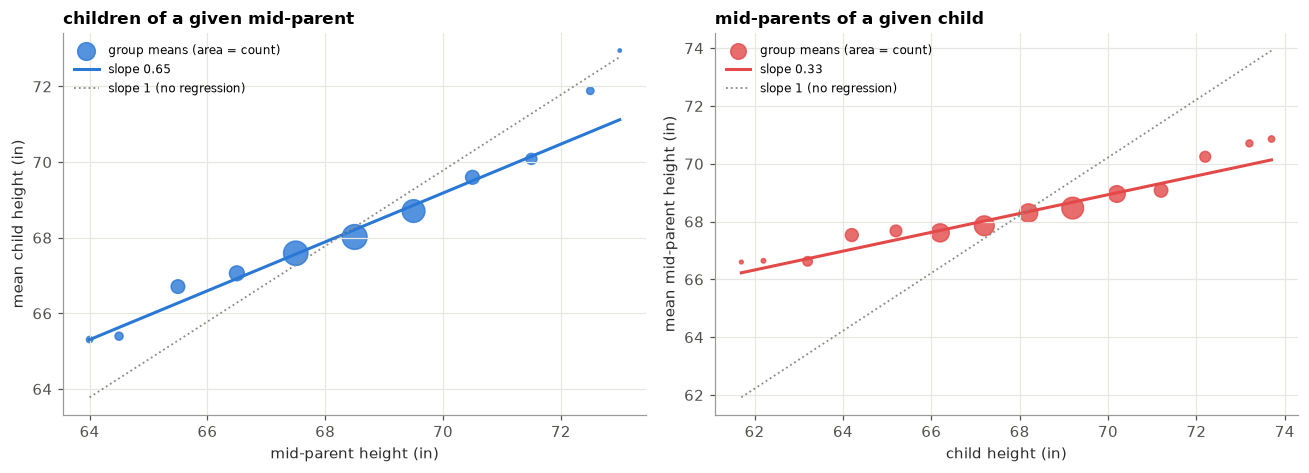
그림 읽기. 두 방향 모두 기울기가 1보다 작다. 기울기가 서로 다른(0.65와 0.33) 이유는 , 이고(곱은 ), 중간부모는 두 사람의 평균이라 분산이 자녀의 절반쯤이기 때문이다(예제 2.4).
4.6 코드 연습 — KL 발산 (강의노트 연습 4.2)
VAE 손실의 KL 항은 두 다변량 정규 사이의 KL이다(명제 6.2):
역행렬 없이: , 이차형식 , . 아래 함수를 채우면 다음 셀이 Monte Carlo 추정과 대조한다.
python
def mvn_kl(p0: MVN, p1: MVN) -> float:
    """KL(p0 || p1) — 여기를 채운다. 힌트: np.linalg.solve(p1.L, p0.L), np.diag(L)"""
    raise NotImplementedError
python
p0 = MVN([0.0, 1.0], [[1.0, 0.3], [0.3, 0.5]])
p1 = MVN([0.5, 0.0], [[2.0, -0.4], [-0.4, 1.0]])
xs_kl = p0.rvs(200_000, rng)
kl_mc = np.mean(p0.logpdf(xs_kl) - p1.logpdf(xs_kl))
try:
    print(f"your KL = {mvn_kl(p0, p1):.4f}    Monte Carlo = {kl_mc:.4f}")
except NotImplementedError:
    print(f"아직 구현 전. Monte Carlo 추정값 = {kl_mc:.4f} 에 맞춰 보라.")
text
아직 구현 전. Monte Carlo 추정값 = 0.8603 에 맞춰 보라.📝 연습 4.1–4.3 (강의노트): 예제 3.16을 코드로(위 4.3), KL 발산 구현(위 4.6), 아들과 딸을 나눈 회귀.
5. 부숴보기 — 가정을 하나씩 빼면
Legend13의 ablation study처럼, 정리의 가정을 하나씩 빼서 무엇이 무너지는지 본다.
5.1 '결합'을 빼면: 주변은 정규, 결합은 아니다
예제 5.1 (부호를 섞은 쌍). , , , . (i) 이므로 . (ii) . (iii) 그러나 이므로 : 종속. (iv) 는 확률 로 정확히 0이므로 정규가 아니다. 결합정규라면 정리 3.10()에 의해 정규여야 한다.
예제 5.2 (스위치 쌍). (), (). 대칭성으로 . 와 부분적분으로
따라서 이고 에서 무상관이다. 그런데 는 의 함수다.
python
c_star = optimize.brentq(lambda c: 2 * stats.norm.cdf(c) - 1 - 2 * c * stats.norm.pdf(c) - 0.5, 0.5, 3)
X = rng.standard_normal(N_SIM)
Y1 = rng.choice([-1, 1], N_SIM) * X
Y2 = np.where(np.abs(X) <= c_star, X, -X)

fig, axes = plt.subplots(1, 3, figsize=(13, 4))
for ax, Y, name in [(axes[0], Y1, "Y = S·X"), (axes[2], Y2, f"Y = ±X, switch at |x| = {c_star:.3f}")]:
    ax.scatter(X[:3000], Y[:3000], s=4, color=C["assume"], alpha=0.5, edgecolors="none")
    ax.set_aspect("equal"); ax.set_xlim(-3.5, 3.5); ax.set_ylim(-3.5, 3.5); ax.set_xlabel("X"); ax.set_ylabel("Y")
    ax.set_title(f"{name}\ncorr = {np.corrcoef(X, Y)[0,1]:+.3f}, KS p (Y normal) = {stats.kstest(Y, 'norm').pvalue:.2f}", fontsize=9)
ax = axes[1]
ax.hist(X + Y1, bins=np.linspace(-6, 6, 121), density=True, color=C["assume"])
ax.set_title(f"X + Y for Y = S·X:  P(X+Y = 0) = {(X + Y1 == 0).mean():.3f}", fontsize=9); ax.set_xlabel("X + Y")
plt.tight_layout(); plt.show()
print(f"c* = {c_star:.4f},   Cov(X^2, Y^2) for Y = S·X: {np.cov(X**2, Y1**2)[0, 1]:.3f}  (theory 2, 연습 5.1)")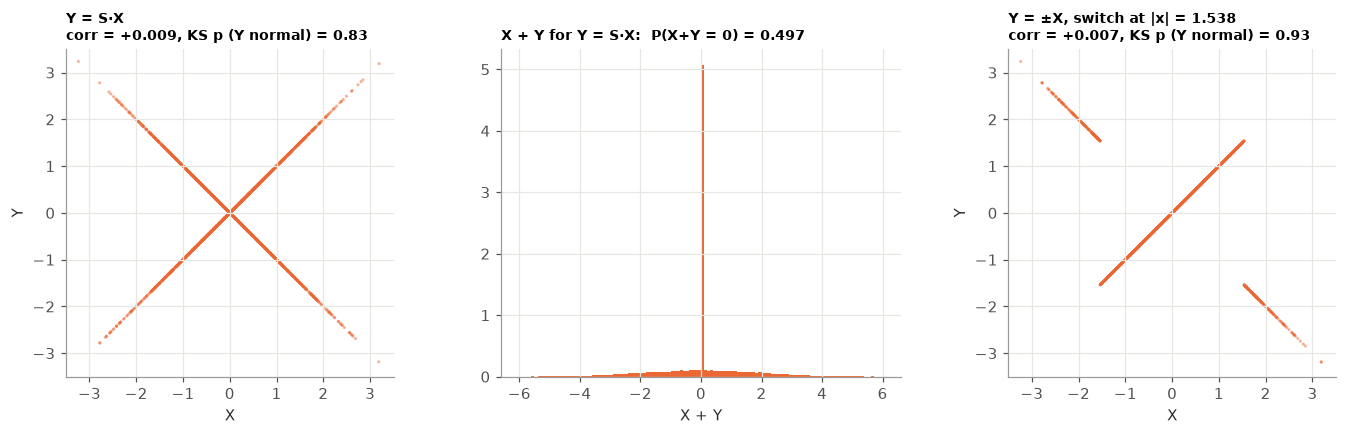
text
c* = 1.5382, Cov(X^2, Y^2) for Y = S·X: 1.978 (theory 2, 연습 5.1)그림 읽기. 두 경우 모두 와 는 각각 완벽한 표준정규이고(KS p값이 크다) 상관은 0이다. 그런데 점들은 타원이 아니라 선 위에 있다. 정리 B·C·D는 "각각 정규"가 아니라 "결합정규"라는 가정 위에 서 있다. "변수마다 히스토그램이 종 모양이니 다변량 정규"라고 말하는 것은 이 가정을 건너뛰는 일이다.
5.2 정규를 약하게: 오염된 정규
명제 5.3. 이면 숨은 지시변수 에 대한 반복기댓값으로
, 이면 분산 1.8, 첨도 (정규는 3). 같은 분산의 이변량 정규라고 착각하고 99% 타원을 그리면 실제로 밖에 떨어지는 비율은 정확히
이다(연습 5.2). 명목 1%의 네 배다.
python
EPS, SC = 0.1, 3.0
def contaminated(size, d=1):
    out = rng.standard_normal((size, d))
    out[rng.random(size) < EPS] *= SC
    return out.squeeze()

xc = contaminated(N_SIM)
kurt_theory = 3 * ((1 - EPS) + EPS * SC**4) / ((1 - EPS) + EPS * SC**2) ** 2
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
xx = np.linspace(-6, 6, 500)
sd_c = np.sqrt(1 + EPS * (SC**2 - 1))
mix_pdf = (1 - EPS) * stats.norm.pdf(xx) + EPS * stats.norm.pdf(xx, 0, SC)
axes[0].plot(xx, mix_pdf, color=C["assume"], label="contaminated")
axes[0].plot(xx, stats.norm.pdf(xx, 0, sd_c), **THEORY, label="normal, same variance")
axes[0].set_ylim(0, 0.5); axes[0].set_title("densities look alike"); axes[0].legend(fontsize=8, loc="upper left")
axes[1].semilogy(xx, mix_pdf, color=C["assume"]); axes[1].semilogy(xx, stats.norm.pdf(xx, 0, sd_c), **THEORY)
axes[1].set_ylim(1e-8, 1); axes[1].set_title("log scale: the tails differ")
probs = (np.arange(1, 400) - 0.5) / 399
axes[2].plot(stats.norm.ppf(probs), np.quantile(xc / xc.std(), probs), "o", ms=3, color=C["assume"])
axes[2].plot([-3, 3], [-3, 3], **THEORY)
axes[2].set_xlabel("normal quantile"); axes[2].set_ylabel("standardized sample quantile"); axes[2].set_title("Q–Q plot")
plt.tight_layout(); plt.show()

q99 = stats.chi2.ppf(0.99, 2)
xc2 = contaminated(N_SIM, d=2)
Qc = (xc2**2).sum(axis=1) / (1 + EPS * (SC**2 - 1))     # 같은 분산의 정규라고 '착각'한 Mahalanobis 제곱
exact = (1 - EPS) * np.exp(-1.8 * q99 / 2) + EPS * np.exp(-1.8 * q99 / (2 * SC**2))
print(f"kurtosis: simulated {stats.kurtosis(xc, fisher=False):.2f}, theory {kurt_theory:.2f}")
print(f"P(Q > chi2_0.99(2)): simulated {(Qc > q99).mean():.4f},  exact {exact:.4f},  nominal 0.0100")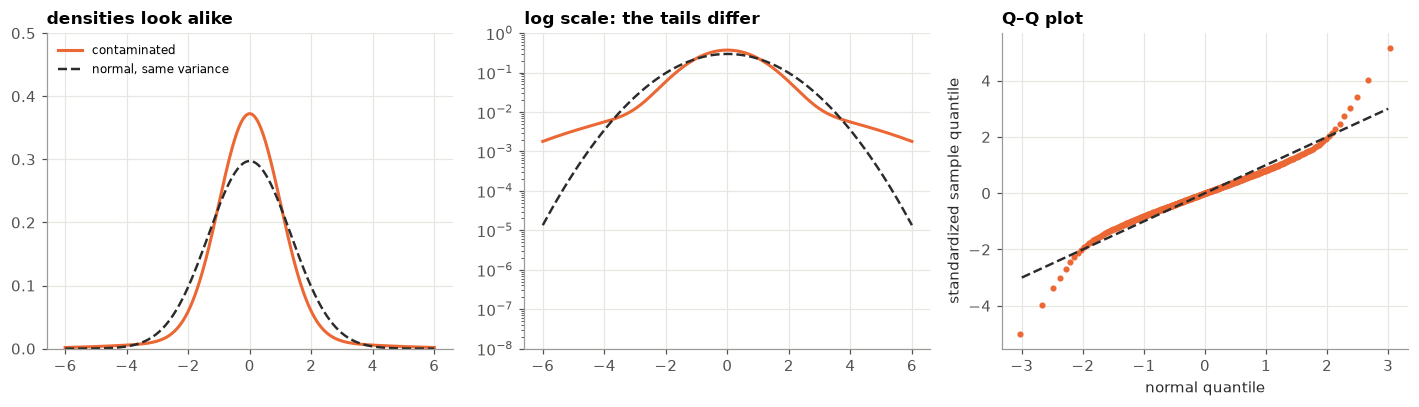
text
kurtosis: simulated 8.41, theory 8.33
P(Q > chi2_0.99(2)): simulated 0.0398,  exact 0.0400,  nominal 0.0100
5.3 한 집단이 아니면: 혼합과 Galton의 ×1.08
명제 5.4 (두 정규 혼합). 확률 로 , 로 이면 집단 지시변수 에 대한 전분산 공식으로
Galton이 딸의 키에 1.08을 곱하지 않았다면 자녀 키는 두 정규의 혼합(4회 5절)이다. GaltonFamilies(Galton의 공책에서 다시 옮긴 가족별 자료)로 이 손질이 무엇을 했는지 본다.
python
fam = load_histdata("GaltonFamilies")
male = fam.loc[fam.gender == "male", "childHeight"].to_numpy()
female = fam.loc[fam.gender == "female", "childHeight"].to_numpy()
pi_ = male.size / (male.size + female.size)

def decompose(f_scale):
    within = pi_ * male.var() + (1 - pi_) * (f_scale * female).var()
    between = pi_ * (1 - pi_) * (male.mean() - f_scale * female.mean()) ** 2
    return within, between

for label, k in [("raw", 1.0), ("daughters x 1.08", 1.08)]:
    w_, b_ = decompose(k)
    print(f"{label:17s}: within {w_:.2f} + between {b_:.2f} = total {w_ + b_:.2f}  (sd {np.sqrt(w_ + b_):.2f})")
print(f"ratio of means = {male.mean()/female.mean():.3f},  sd: sons {male.std():.2f}, daughters x 1.08 {1.08*female.std():.2f}")

raw = np.r_[male, female]; transmuted = np.r_[male, 1.08 * female]
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
edges = np.arange(55, 80.5, 1)
axes[0].hist(male, bins=edges, color=C["stat"], alpha=0.6, label="sons")
axes[0].hist(female, bins=edges, color=C["assume"], alpha=0.6, label="daughters")
axes[0].set_xlabel("height (in)"); axes[0].set_title("raw heights by sex"); axes[0].legend(fontsize=8)
probs = (np.arange(1, 200) - 0.5) / 199
for ax, data, title in [(axes[1], raw, "raw, pooled: a mixture"), (axes[2], transmuted, "daughters x 1.08, pooled")]:
    ax.plot(stats.norm.ppf(probs), (np.quantile(data, probs) - data.mean()) / data.std(), "o", ms=3, color=C["data"])
    ax.plot([-3, 3], [-3, 3], **THEORY)
    ax.set_xlabel("normal quantile"); ax.set_ylabel("standardized quantile")
    ax.set_title(f"{title}\nexcess kurtosis {stats.kurtosis(data):+.2f}", fontsize=9)
plt.tight_layout(); plt.show()
text
raw              : within 6.22 + between 6.57 = total 12.80  (sd 3.58)
daughters x 1.08 : within 6.67 + between 0.00 = total 6.67  (sd 2.58)
ratio of means = 1.080,  sd: sons 2.62, daughters x 1.08 2.54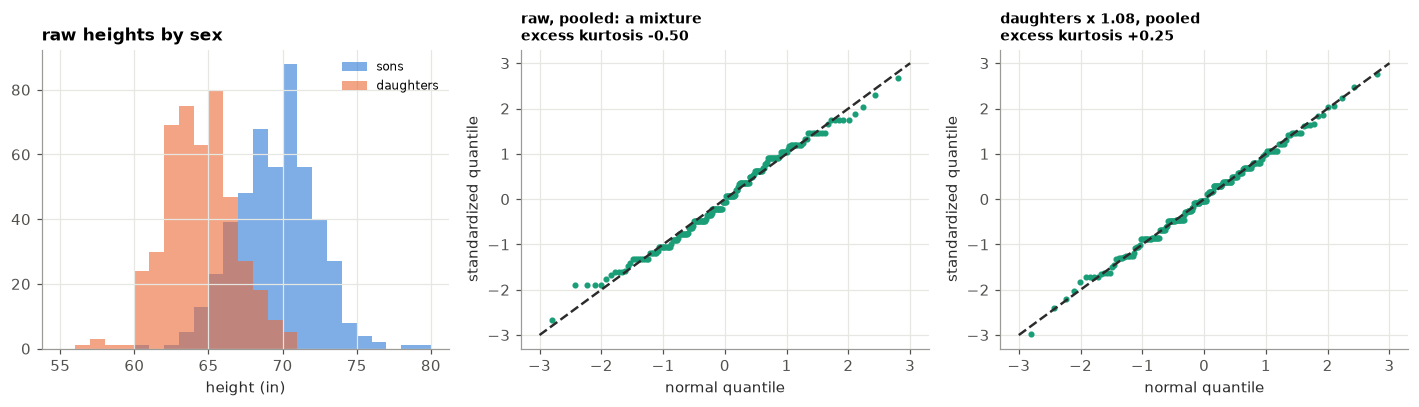
그림 읽기. 합친 분산의 절반 가까이가 성별의 평균 차이(집단 간 항)에서 온다. 1.08을 곱하면 그 항이 사라지고, 초과첨도도 (정규보다 납작)에서 로 0에 가까워진다. 봉우리가 둘로 갈라질 만큼 떨어져 있지 않아서 섞인 상태의 Q–Q 그림도 언뜻 직선에 가깝다. 눈으로 종 모양이라고 한 집단이라는 보장은 없다. 4회의 Pearson 게와 10회의 EM이 같은 구조를 다룬다.
5.4 가 특이하면 — 밀도는 없어도 정규다
명제 5.6. 이면 . 구성 이고, 차원 인 부분공간은 측도가 0이므로 밀도가 없다.
python
sing = MVN([0, 0], [[1, 2], [2, 4]])            # rank 1: X2 = 2 X1
pts = sing.rvs(5, rng)
print("singular:", sing.singular)
print("X2 / X1 =", (pts[:, 1] / pts[:, 0]).round(6), "   a = (2, -1): a'Σa =", np.array([2, -1]) @ sing.Sigma @ np.array([2, -1]))
try:
    sing.logpdf(pts)
except AssertionError as e:
    print("logpdf ->", e)
text
singular: True
X2 / X1 = [2. 2. 2. 2. 2.]    a = (2, -1): a'Σa = 0.0
logpdf -> 특이 Sigma 에는 밀도가 없다 (mgf 정의는 그대로 유효)
Cholesky가 실패하면 고유분해로 를 만들어 그대로 샘플링한다. 점들은 직선 위에만 있어 밀도는 없지만, mgf 로는 여전히 다. 정의를 mgf로 둔 이유가 여기서 드러난다.
📝 연습 5.1–5.4 (강의노트): 제곱의 공분산, 오염된 이변량 정규의 정확한 꼬리(0.0400), 혼합분산의 수치, 직선 위의 정규.
6. Beautiful insights — 정리 C는 어디에나 있다
6.1 Gaussian Process 회귀 = 정리 C 한 번
격자 위의 함수값 와 관측 을 함께 결합정규로 놓는다().
와 Schur 보수가 그대로 들어 있다. 관측점에서 멀어질수록 사후평균은 사전평균 0으로 회귀하고 사후분산은 사전분산으로 돌아간다. 위의 MVN.conditional을 고치지 않고 쓴다.
python
def rbf(a, b, ell=1.0, amp=1.0):
    return amp**2 * np.exp(-0.5 * (a[:, None] - b[None, :]) ** 2 / ell**2)

f_true = lambda s: np.sin(s) + 0.3 * s
s_grid = np.linspace(0, 10, 150)
s_obs = np.array([0.7, 2.1, 3.0, 5.2, 6.8, 7.5, 9.3])
NOISE = 0.15
y_obs = f_true(s_obs) + rng.normal(0, NOISE, s_obs.size)

s_all = np.r_[s_grid, s_obs]
K = rbf(s_all, s_all, ell=1.2, amp=1.5)
K[150:, 150:] += NOISE**2 * np.eye(s_obs.size)                  # 관측에는 잡음
joint = MVN(np.zeros(s_all.size), K)                             # (f_grid, y_obs) 결합정규
post = joint.conditional(np.arange(150), np.arange(150, 157), y_obs)   # 정리 3.13
prior = joint.marginal(np.arange(150))
sd = np.sqrt(np.clip(np.diag(post.Sigma), 0, None))

fig, axes = plt.subplots(1, 2, figsize=(13, 3.8), sharey=True)
for smp in prior.rvs(4, rng):
    axes[0].plot(s_grid, smp, color=C["hist"], lw=1.2)
axes[0].set_title("prior: f ~ N(0, K)"); axes[0].set_xlabel("s")
ax = axes[1]
ax.fill_between(s_grid, post.mu - 2 * sd, post.mu + 2 * sd, color=C["stat"], alpha=0.18, lw=0, label="±2 sd")
for smp in post.rvs(3, rng):
    ax.plot(s_grid, smp, color=C["stat"], lw=0.8, alpha=0.6)
ax.plot(s_grid, post.mu, color=C["stat"], lw=2, label="posterior mean = conditional mean")
ax.plot(s_grid, f_true(s_grid), **THEORY, label="true f")
ax.plot(s_obs, y_obs, "o", color=C["data"], ms=7, mec="white", mew=1.5, label="observations")
ax.set_title("posterior: f | y  (Theorem 3.13)"); ax.set_xlabel("s"); ax.legend(fontsize=8, loc="lower right")
plt.tight_layout(); plt.show()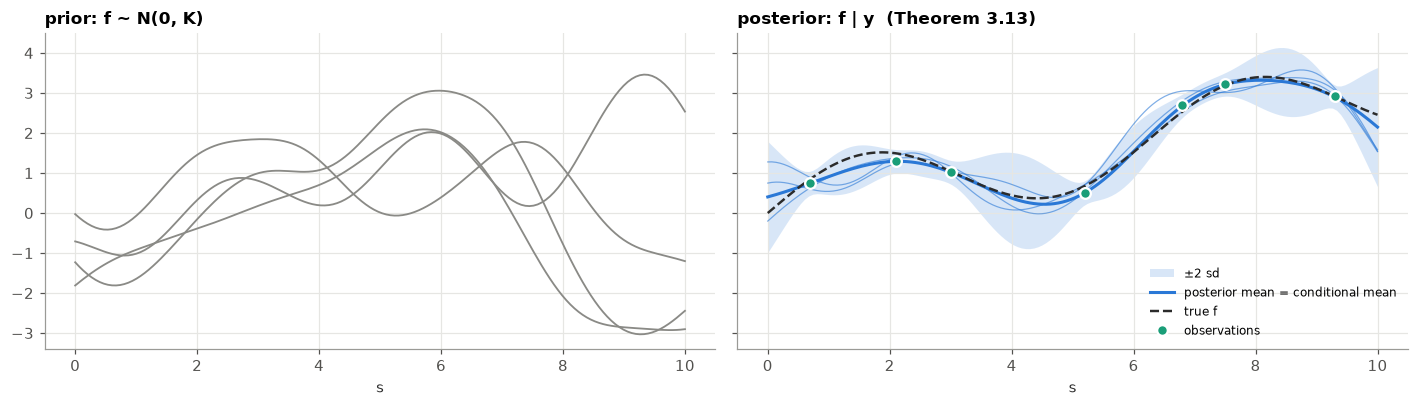
6.2 Pearson (1901): 회귀선 둘, 주성분 하나
Pearson은 1901년 On lines and planes of closest fit에서 물었다. 점들에 "가장 가까운" 직선은? 세로 거리를 최소화하면 , 가로 거리를 최소화하면 다.
명제 6.1. 단위벡터 가 정하는 직선 에 대해 . 따라서 수직 거리를 최소화하는 방향은 의 첫 고유벡터(제1 주성분)다.
증명. 이면 이고 기댓값은 . Rayleigh 몫의 최댓값은 .
주성분 축은 정리 D의 타원의 장축이다. 단위를 바꾸면 주성분은 바뀌지만 회귀선은 바뀌지 않는다(연습 6.3).
python
lam_g, V_g = np.linalg.eigh(S)
v1 = V_g[:, np.argmax(lam_g)]
slope_pc = v1[1] / v1[0]
jit = rng.uniform(-0.25, 0.25, size=XY.shape)                   # 칸 자료라 겹침을 흩뜨림

fig, ax = plt.subplots(figsize=(7, 7))
ax.scatter(*(XY + jit).T, s=6, color=C["data"], alpha=0.35, edgecolors="none")
xs_ = np.array([63, 74]); ys_ = np.array([61, 75])
ax.plot(xs_, m[1] + b_yx * (xs_ - m[0]), color=C["stat"], lw=2, label=f"E[child | parent]: slope {b_yx:.2f}")
ax.plot(xs_, m[1] + slope_pc * (xs_ - m[0]), color=C["ink"], lw=2, label=f"1st principal axis: slope {slope_pc:.2f}")
ax.plot(m[0] + b_xy * (ys_ - m[1]), ys_, color=C["key"], lw=2, label=f"E[parent | child]: slope {1/b_xy:.2f}")
ax.set_xlim(63, 74); ax.set_ylim(61, 75); ax.set_aspect("equal")
ax.set_xlabel("mid-parent (in)"); ax.set_ylabel("child (in)"); ax.set_title("three 'best' lines through Galton's data (Pearson 1901)")
ax.legend(fontsize=8, loc="upper left")
plt.tight_layout(); plt.show()

D_cm = np.diag([1.0, 2.54])                                     # child 를 cm 로
S_cm = D_cm @ S @ D_cm
l_cm = np.linalg.eigvalsh(S_cm)[-1]
print(f"child in cm:  regression slope {b_yx:.3f} → {S_cm[0,1]/S_cm[0,0]:.3f} (exactly ×2.54),  "
      f"PC slope {slope_pc:.3f} → {(l_cm - S_cm[0,0]) / S_cm[0,1]:.3f} (not {slope_pc*2.54:.3f})")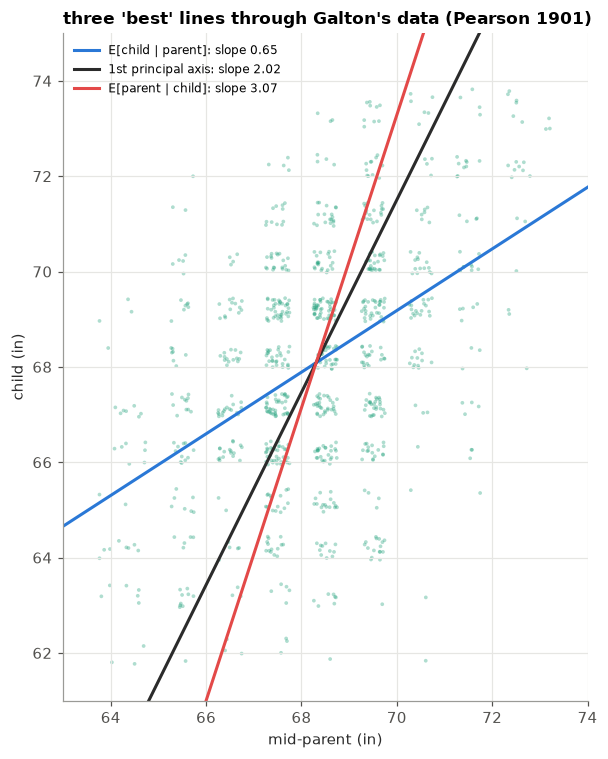
text
child in cm: regression slope 0.646 → 1.642 (exactly ×2.54), PC slope 2.019 → 7.327 (not 5.128)6.3 백색화와 BatchNorm
정리 A로 , 곧 타원을 원으로 만들 수 있다(백색화). BatchNorm은 좌표마다 평균과 표준편차만 나눈다(, ). 대각만 쓰는 셈이라 기울어진 타원은 그대로 남는다. 상관까지 없애는 Decorrelated BatchNorm(Huang et al., 2018)이 바로 이 백색화다.
python
raw2 = MVN([3, -1], [[4.0, 2.4], [2.4, 2.0]]).rvs(3000, rng)
mu_h, S_h = raw2.mean(axis=0), np.cov(raw2.T)
std2 = (raw2 - mu_h) / np.sqrt(np.diag(S_h))                       # BatchNorm (affine 없음)
lam_h, V_h = np.linalg.eigh(S_h)
white = (raw2 - mu_h) @ V_h @ np.diag(lam_h ** -0.5) @ V_h.T     # ZCA 백색화 Sigma^-1/2

fig, axes = plt.subplots(1, 3, figsize=(13, 4.2))
for ax, data, title in [(axes[0], raw2, "raw"), (axes[1], std2, "per-coordinate standardization (BatchNorm)"),
                        (axes[2], white, r"whitening $\hat\Sigma^{-1/2}(\mathbf{x}-\hat\mu)$")]:
    ax.scatter(*data.T, s=4, color=C["data"], alpha=0.4, edgecolors="none")
    cv = np.cov(data.T)
    ax.set_title(f"{title}\ncov = [[{cv[0,0]:.2f}, {cv[0,1]:.2f}], [{cv[1,0]:.2f}, {cv[1,1]:.2f}]]", fontsize=9)
    ax.set_aspect("equal")
for ax in axes[1:]:
    ax.set_xlim(-4.2, 4.2); ax.set_ylim(-4.2, 4.2)
plt.tight_layout(); plt.show()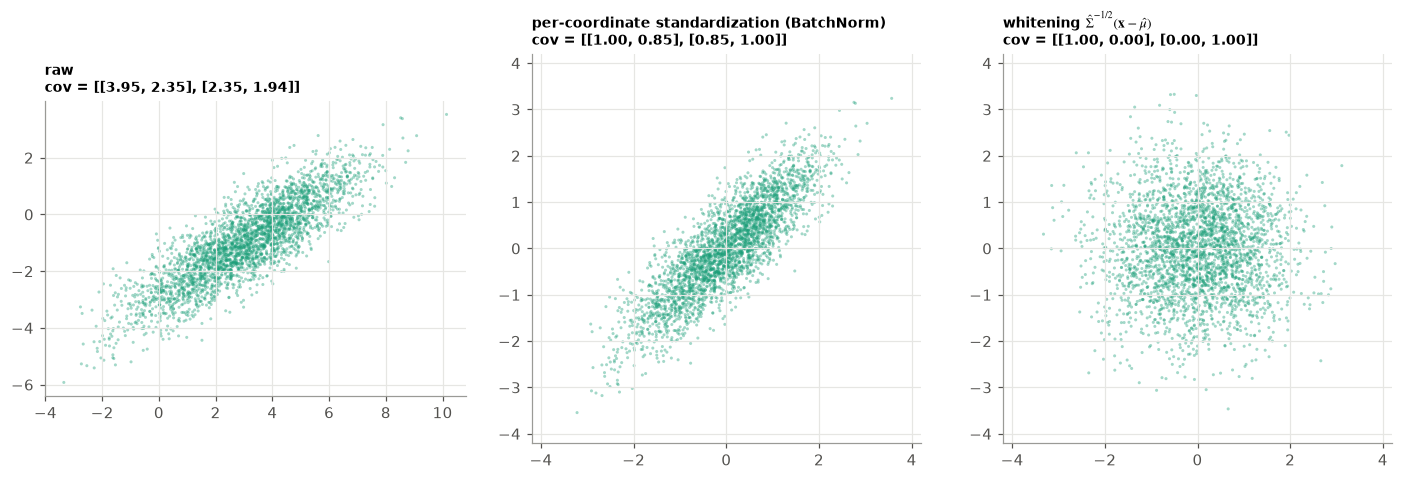
6.4 Reparameterization trick과 두 정규 사이의 KL
VAE의 인코더가 와 를 내면 잠재변수는 정리 3.5의 구성 그대로 뽑는다. 무작위성이 에만 있으므로 이고 역전파가 흐른다.
python
eps = torch.randn_like(mu)                              # 무작위성은 여기에만
z = mu + (L @ eps.unsqueeze(-1)).squeeze(-1)            # X = mu + A Z  (정리 3.5)
명제 6.2 (KL). .
증명. 에 정리 3.6을 넣고 를 쓰면 , .
, 이면 VAE 손실의 그 식 이 된다(연습 6.2). 구현은 §4.6.
📝 연습 6.1–6.3 (강의노트): 이차형식의 기댓값, VAE의 KL 항, 주성분의 기울기와 단위.
7. Stigler's law 카드 · 7 Pillars
Stigler의 명명 법칙: 어떤 과학 법칙도 처음 발견한 사람의 이름을 달고 있지 않다. (Stigler는 이 법칙조차 Merton이 먼저 말했다고 덧붙였다.)
| 이름 | 실제로 먼저 |
|---|---|
| 가우스(정규) 분포 | de Moivre (1733)가 이항의 근사로 먼저 얻었다 |
| Pearson 상관계수 | Galton (1888)이 개념과 이름을, Bravais (1846)가 이변량 정규의 그 모수를 먼저 썼다. Pearson(1896)도 Bravais를 인용했다 |
| 이변량 정규분포 | Galton의 질문에 Dickson이 답하기 전에 오차론에서 Laplace·Bravais 등이 이미 다뤘다 |
7 Pillars 지도에 칠할 칸 — Regression. Stigler(2016) 5장의 요지는 Galton의 통찰이 회귀는 두 방향이라는 것, 그리고 조건부분포로 생각하는 습관이 다변량 분석과 베이즈 추론의 출발점이 되었다는 것이다. 따름정리 2.2의 축소가 그 씨앗이고, 16회에서 Stein의 축소추정량이 바로 이 회귀임을 본다(Stigler 1990).
8. 정리 · 연습문제 지도 · 다음 회
| 식 | 증명의 핵심 | |
|---|---|---|
| de Moivre (정리 1.2) | Stirling + 전개 | |
| Gauss (정리 1.5) | 평균이 언제나 MLE 정규 | Cauchy 함수방정식 |
| 정규 혼합 (정리 2.1, 따름 2.2) | , | 반복기댓값, 완전제곱 |
| 안정 ⇒ 회귀 (명제 2.3) | 분산의 대수 | |
| 정의 3.4 | 구성 | |
| 정리 A (3.8) | mgf에 | |
| Cramér–Wold (3.10) | 결합정규 모든 정규 | |
| 정리 B (3.11) | 결합정규에서 독립 | mgf 분해 |
| 정리 C (3.13) | 또는 블록 분해 | |
| 정밀도 (3.15) | , | 블록 역행렬 |
| 정리 D (3.17) | 백색화 + | |
| 회귀 (3.19, 3.20) | 양방향, 회귀선 = 접점의 자취 | 정리 C, |
연습문제 지도 (강의노트, ★ 계산 · ★★ 증명 · ★★★ 도전, 풀이는 부록 A)
| 절 | 연습 | 이 노트북에서 확인하는 셀 |
|---|---|---|
| 0 복습 | 0.1 극좌표 야코비안 ★ · 0.2 전분산 공식 ★★ | — |
| 1.1 de Moivre | 1.1 3차 항 ★★ · 1.2 ★ · 1.3 Stirling 상수 ★★ | 연속성 보정 셀 |
| 1.2 Gauss | 1.4 Laplace MLE ★ · 1.5 로지스틱 ★★ · 1.6 정규 사전분포 ★★ | 로지스틱 셀 |
| 1.3 Quetelet | 1.7 표 계산 ★ · 1.8 Sheppard ★★ | Quetelet 셀 |
| 1.4 단변량 | 1.9 짝수 적률 ★ · 1.10 로그정규 ★ · 1.11 Mills 비 ★★ · 1.12 합성곱 ★★ · 1.13 적분형 de Moivre–Laplace 증명 ★★ · 1.14 Cauchy 함수방정식 증명 ★★ (유도형) | 네 가지 사실 셀 |
| 2 Galton | 2.1–2.2 quincunx ★ · 2.3–2.4 축소 ★/★★ · 2.5–2.6 중간부모 ★/★★ · 2.7 예측구간 ★ · 2.8–2.10 정리 2.1 · 따름정리 2.2 · 명제 2.3 증명 ★/★★ (유도형) | 2.2 · 2.3 · 2.4 셀 |
| 3.1–3.4 | 3.1–3.2 블록 행렬 ★/★★ · 3.3–3.4 밀도·사분면 ★/★★ · 3.5–3.6 선형결합 ★/★★ · 3.7 합과 차 ★ | 보조정리 3.3 셀 |
| 3.5 정리 C | 3.8–3.9 손계산 ★ · 3.10 최선의 예측 ★★ · 3.11 ★★★ | §4.3 |
| 3.6–3.7 | 3.12 Galton 타원 ★ · 3.13 Scheffé ★★ · 3.14 기울기 ★ · 3.15 시험–재시험 ★★ · 3.16 Cramér–Wold 증명 ★★ · 3.17 확률 타원 증명 ★ (유도형) | §4.4, 비행교관 셀 |
| 4 계산 | 4.1 예제 3.16 ★ · 4.2 KL 구현 ★★ · 4.3 아들과 딸 ★★ | §4.3, §4.6 |
| 5 부숴보기 | 5.1–5.4 ★/★★ | §5 셀들 |
| 6 insights | 6.1–6.3 ★/★★ | §6.2, §6.4 |
다음 회 (6회) — Student의 t와 신뢰구간 (1876 → 1937). Guinness 양조장의 Gosset은 표본 4개로, 도 모른 채 평균의 오차를 말해야 했다. 그 열쇠인 "정규표본에서 "는 오늘의 정리 B로 증명된다. 는 정리 A에 의해 결합정규이고 이기 때문이다.
9. 워크북 검산
워크북(05_normal_galton_workbook.pdf)의 문제는 손으로 먼저 푼다. 이 절은 다 푼 뒤에 쓴다.
check("A6a", "3/2")— 문항 번호와 손으로 구한 답을 넣으면 맞는지만 알려 준다. 정답은 보여 주지 않는다. 답은 수(3/2,1.5)나 식의 문자열("sqrt((1-rho)/pi)")로 넣는다. 소문항은"A6a"처럼 번호 뒤에 붙인다. 소수로 넣으면 상대오차 0.1%까지 맞다고 본다. 가 들어간 답은(1+erf(z/sqrt(2)))/2로 쓰거나 표에서 읽은 소수로 넣는다.- 시뮬레이션으로 한 번 더 — 확률이나 기댓값이 답인 문항은 아래에 시뮬레이션 함수를 정의해 두었다. 손으로 구한 값이 Monte Carlo 구간 안에 드는지 본다. 함수는 정의만 해 두었고 부르지 않았다. 답을 구하기 전에 부르면 답이 보인다.
증명 문제(B, C의 대부분)는 check()가 없다. 풀이판의 증명과 단계별로 맞춰 본다.
답 열쇠 셀 (내려받은 노트북에서 실행된다)
답 열쇠를 압축해 넣은 check() 정의 셀이다. 웹에서는 이 회차의 답 확인 페이지를 쓴다.
python
check()                 # 확인할 수 있는 문항 번호
check("A6a")            # 답을 넣지 않으면 쓰는 법을 알려 준다
text
확인할 수 있는 문항: A1a A1b A2a A2b A3a A3b A4a A4b A4c A4d A5a A5b A6a A6b A6c A7a A7b A8a A8b A8c A9a A9b A10a A10b A11a A11b A12a A12b A12c A13a A13b A14 C4c D1a D1b D2a D2c D3d D3e D3f D4d D4e
A6a: 아직 답을 넣지 않았다. 예: check('A6a', '3/8')
9.1 내 답을 모아 확인하기
푼 문항의 답을 아래 사전에 채우고 실행한다. None인 문항은 건너뛴다.
python
mine = {
    "A1a": None, "A1b": None, "A2a": None, "A2b": None, "A3a": None, "A3b": None,
    "A4a": None, "A4b": None, "A4c": None, "A4d": None, "A5a": None, "A5b": None,
    "A6a": None, "A6b": None, "A6c": None, "A7a": None, "A7b": None,
    "A8a": None, "A8b": None, "A8c": None, "A9a": None, "A9b": None,
    "A10a": None, "A10b": None, "A11a": None, "A11b": None,
    "A12a": None, "A12b": None, "A12c": None, "A13a": None, "A13b": None, "A14": None,
    "C4c": None,
    "D1a": None, "D1b": None, "D2a": None, "D2c": None,
    "D3d": None, "D3e": None, "D3f": None, "D4d": None, "D4e": None,
}
check_all(mine)
text
0/0 맞음9.2 시뮬레이션 함수
각 함수는 (추정값, 표준오차)를 돌려준다. 손으로 구한 값이 추정값 ± 3 × 표준오차 안에 들면 계산이 맞을 가능성이 높다. 정확한 검산은 check()가 한다.
| 함수 | 문항 | 시뮬레이션 |
|---|---|---|
sim_A1() |
A1(b) 이항분포의 구간 확률 | |
sim_A3(w) |
A3 | 독립 표준정규 둘 |
sim_A12() |
A12(c) 재시험에서 더 높을 확률 | 인 사람만 남기기 |
sim_A13(rho) |
A13(a) 사분면 확률 | 이변량 정규 (Cholesky) |
sim_D1(rho) |
D1(a) | 이변량 정규 |
sim_D2(n) |
D2(a) | 걸음 |
sim_D4(rho, c) |
D4(d) | 이변량 정규, 만 남기기 |
python
def _mean_se(v):
    v = np.asarray(v, dtype=float)
    return v.mean(), v.std(ddof=1) / np.sqrt(len(v))


def _biv(rho, n):
    """표준화 이변량 정규 n개: X = Z1, Y = rho Z1 + sqrt(1-rho^2) Z2 (Cholesky)"""
    z1, z2 = rng.standard_normal(n), rng.standard_normal(n)
    return z1, rho * z1 + np.sqrt(1 - rho**2) * z2


def sim_A1(n=N_SIM):
    s = rng.binomial(400, 0.5, n)
    return _mean_se((190 <= s) & (s <= 210))


def sim_A3(w=4.0, n=N_SIM):
    z = rng.standard_normal((n, 2))
    return _mean_se((z**2).sum(axis=1) > w)


def sim_A12(n=4_000_000, half_width=0.5):
    t = rng.normal(100, 10, n)
    x, y = t + rng.normal(0, 5, n), t + rng.normal(0, 5, n)
    keep = np.abs(x - 130) < half_width
    return _mean_se(y[keep] > 130)


def sim_A13(rho=0.5, n=N_SIM):
    x, y = _biv(rho, n)
    return _mean_se((x > 0) & (y > 0))


def sim_D1(rho=0.5, n=N_SIM):
    x, y = _biv(rho, n)
    return _mean_se(np.maximum(x, y))


def sim_D2(n_half=50, n=N_SIM):
    return _mean_se(rng.binomial(2 * n_half, 0.5, n) == n_half)


def sim_D4(rho=0.6, c=1.0, n=N_SIM):
    x, y = _biv(rho, 4 * n)
    return _mean_se(y[x > c])
python
# 자체 검사 (출력 없음): 시뮬레이션이 답 열쇠와 맞는지, check()가 답 열쇠의 값과 그 소수를 맞다고 하는지 확인한다.
def _close(sim, key, z=4.0, **pt):
    est, se = sim
    return abs(est - _value(key, **pt)) <= z * se + 1e-12

assert _close(sim_A1(), "A1b")
assert _close(sim_A3(4.0), "A3a")
assert _close(sim_A12(), "A12c", z=5.0)
assert _close(sim_A13(0.5), "A13a")
assert _close(sim_D1(0.5), "D1a", rho=0.5)
assert _close(sim_D2(200), "D2a", n=200)
assert _close(sim_D4(0.6, 1.0), "D4d")
for _k, _e in _WB.items():
    assert _same(_e, _e["value"])
    if not _e.get("vars") and "points" not in _e:
        assert _same(_e, float(sp.sympify(_e["value"])))