노트북은 예측 → 계산 → 대조 세 부분으로 고정한다. 새 개념은 도입하지 않는다. 본문에서 이미 유도한 것을 수치로 확인할 뿐이다.
1. 예측 (코드를 쓰기 전에)
아래 셋을 먼저 채운다. 계산하지 않는다.
3절의 6개월 표에서 상수만 넣은 단순회귀 기울기 과 까지 통제한 가운데 어느 쪽이 큰가. 그 차이의 부호는 의 부호와 같은가. 답의 근거는 (eq-w07-19)와 ·가 같은 방향으로 움직인다는 표의 관찰이다.
예측: ____
를 자기 자신에 10번 곱하면 원소가 바뀌는가. 와 고유값은 무엇인가. 답의 근거는 (eq-w07-11)과 "사영의 고유값은 1 아니면 0"이라는 멱등성의 귀결이다.
예측: ____
대신 원자료 를 에 회귀하면 계수와 잔차제곱합은 각각 어떻게 되는가. 답의 근거는 (eq-w07-17) 아래의 주석이다 — 무엇이 같고 무엇이 만큼 다른지.
예측: ____
2. 계산
패키지 호출로 답을 내지 않는다. 3절 6개월 표의 숫자부터 직접 쌓는다.
정규방정식은 np.linalg.solve로 풀고 lstsq와 회귀 패키지는 쓰지 않는다.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import font_manager

# 한국어 글꼴을 후보 목록에서 고른다
cands = ['Apple SD Gothic Neo', 'AppleGothic', 'NanumGothic', 'Noto Sans CJK KR', 'Malgun Gothic']
have = {f.name for f in font_manager.fontManager.ttflist}
for c in cands:
    if c in have:
        plt.rcParams['font.family'] = c
        break
plt.rcParams['axes.unicode_minus'] = False
np.set_printoptions(precision=4, suppress=True)
print('글꼴:', plt.rcParams['font.family'][0])
글꼴: Apple SD Gothic Neo
# 3절 6개월 표를 그대로 쌓는다 (단위 %/월)
x1 = np.array([2., -1., 3., 0., -2., 4.])    # 시장 초과수익률
x2 = np.array([1., 0., 2., -1., -1., 3.])    # 규모 요인 SMB
y = np.array([3., -1., 5., 0., -3., 6.])     # 주식 초과수익률
n = y.size
one = np.ones(n)

# 계획행렬과 정규방정식을 직접 쌓는다
X = np.column_stack([one, x1, x2])
XtX, Xty = X.T @ X, X.T @ y
beta = np.linalg.solve(XtX, Xty)

print('X.T @ X =\n', XtX)
print('det =', round(float(np.linalg.det(XtX)), 4))
print('X.T @ y =', Xty)
print('beta_hat =', beta)
print('분수 (6/37, 51/37, 7/37) =', np.array([6., 51., 7.]) / 37)
X.T @ X =
[[ 6. 6. 4.]
[ 6. 34. 22.]
[ 4. 22. 16.]]
det = 296.0
X.T @ y = [10. 52. 34.]
beta_hat = [0.1622 1.3784 0.1892]
분수 (6/37, 51/37, 7/37) = [0.1622 1.3784 0.1892]
# 통제 전 회귀 [1 x1] 과 보조회귀 Gamma 를 같은 방식으로 쌓는다
X1 = np.column_stack([one, x1])
b_short = np.linalg.solve(X1.T @ X1, X1.T @ y)
Gam = np.linalg.solve(X1.T @ X1, X1.T @ x2)   # x2 를 [1 x1] 에 회귀한 계수
move = Gam[1] * beta[2]

print(f'[예측 1] 통제 전 b1      = {b_short[1]:.4f}')
print(f'[예측 1] 통제 후 beta1   = {beta[1]:.4f}')
print(f'[예측 1] 차이 b1 - beta1 = {b_short[1] - beta[1]:.4f}')
print(f'[예측 1] Gamma_x1 * beta2 = {Gam[1]:.4f} * {beta[2]:.4f} = {move:.4f}')
print('[예측 1] 두 수의 부호가 같은가:',
      bool(np.sign(b_short[1] - beta[1]) == np.sign(move)))
[예측 1] 통제 전 b1 = 1.5000
[예측 1] 통제 후 beta1 = 1.3784
[예측 1] 차이 b1 - beta1 = 0.1216
[예측 1] Gamma_x1 * beta2 = 0.6429 * 0.1892 = 0.1216
[예측 1] 두 수의 부호가 같은가: True
# P 와 M 을 명시적으로 만든다
P = X @ np.linalg.solve(XtX, X.T)
M = np.eye(n) - P

# P 를 자기 자신에 거듭 곱해 P^10 을 쌓는다
P10 = P.copy()
for _ in range(9):
    P10 = P10 @ P

print('[예측 2] max|P @ P - P|  =', f'{np.abs(P @ P - P).max():.2e}')
print('[예측 2] max|P.T - P|    =', f'{np.abs(P.T - P).max():.2e}')
print('[예측 2] max|P^10 - P|   =', f'{np.abs(P10 - P).max():.2e}')
print('[예측 2] tr P =', round(float(np.trace(P)), 6))
print('[예측 2] 고유값 =', np.round(np.linalg.eigvalsh(P), 6))
[예측 2] max|P @ P - P| = 9.99e-16
[예측 2] max|P.T - P| = 3.33e-16
[예측 2] max|P^10 - P| = 8.33e-15
[예측 2] tr P = 3.0
[예측 2] 고유값 = [-0. 0. 0. 1. 1. 1.]
# 적합값과 잔차를 쌓아 직각 세 문장을 확인한다
yhat, e = P @ y, M @ y

print('X.T @ e =', np.round(X.T @ e, 10))
print('e * 37 =', np.round(e * 37, 6), '   (-4, 8, 12, 1, -8, -9)')
print(f'||Py||^2 = {yhat @ yhat:.4f},  ||My||^2 = {e @ e:.4f}')
print(f'합 = {yhat @ yhat + e @ e:.4f},  ||y||^2 = {y @ y:.4f}')
print('레버리지 diag(P) * 74 =', np.round(np.diag(P) * 74, 4))
print('tr P = k =', round(float(np.diag(P).sum()), 6))
X.T @ e = [ 0. 0. -0.]
e * 37 = [-4. 8. 12. 1. -8. -9.] (-4, 8, 12, 1, -8, -9)
||Py||^2 = 79.7297, ||My||^2 = 0.2703
합 = 80.0000, ||y||^2 = 80.0000
레버리지 diag(P) * 74 = [19. 39. 23. 59. 39. 43.]
tr P = k = 3.0
# 통제 블록 X2 = [1 x2] 로 M2 를 만들어 양쪽을 씻는다
X2 = np.column_stack([one, x2])
M2 = np.eye(n) - X2 @ np.linalg.solve(X2.T @ X2, X2.T)
xt, yt = M2 @ x1, M2 @ y
den, num = xt @ xt, xt @ yt
b_fwl = num / den

print('x1_tilde =', xt)
print('y_tilde  =', yt)
print(f'분모 = {den:.4f},  분자 = {num:.4f},  몫 = {b_fwl:.6f}')
print('전체 회귀 beta1 =', round(float(beta[1]), 6),
      ' 같은가:', bool(np.isclose(b_fwl, beta[1])))
print('두 회귀의 잔차가 같은가:', bool(np.allclose(yt - xt * b_fwl, e)))
x1_tilde = [ 0.55 -1.1 0.2 1.25 -0.75 -0.15]
y_tilde = [ 0.65 -1.3 0.6 1.75 -1.25 -0.45]
분모 = 3.7000, 분자 = 5.1000, 몫 = 1.378378
전체 회귀 beta1 = 1.378378 같은가: True
두 회귀의 잔차가 같은가: True
# y_tilde 대신 원자료 y 를 x1_tilde 에 회귀해 계수와 잔차제곱합을 비교한다
P2y = y - yt                     # P2 y = y - M2 y
b_raw = (xt @ y) / den
r_tilde = yt - xt * b_fwl
r_raw = y - xt * b_raw

print(f'[예측 3] 계수: y_tilde 회귀 {b_fwl:.6f} vs y 회귀 {b_raw:.6f}')
print('[예측 3] 계수가 같은가:', bool(np.isclose(b_fwl, b_raw)), ' 51/37 =', round(51 / 37, 6))
print(f'[예측 3] 잔차제곱합: y_tilde 회귀 {r_tilde @ r_tilde:.4f},  y 회귀 {r_raw @ r_raw:.4f}')
print(f'[예측 3] 차이 {r_raw @ r_raw - r_tilde @ r_tilde:.4f} = ||P2 y||^2 = {P2y @ P2y:.4f}')
[예측 3] 계수: y_tilde 회귀 1.378378 vs y 회귀 1.378378
[예측 3] 계수가 같은가: True 51/37 = 1.378378
[예측 3] 잔차제곱합: y_tilde 회귀 0.2703, y 회귀 72.9703
[예측 3] 차이 72.7000 = ||P2 y||^2 = 72.7000
# 예측 항목별 대조 수치를 한 표로 모은다
rows = [
    ('1  통제 전 b1', f'{b_short[1]:.4f}'),
    ('1  통제 후 beta1', f'{beta[1]:.4f}'),
    ('1  차이 / Gamma*beta2', f'{b_short[1] - beta[1]:.4f} / {move:.4f}'),
    ('2  max|P^10 - P|', f'{np.abs(P10 - P).max():.2e}'),
    ('2  tr P', f'{np.trace(P):.4f}'),
    ('2  고유값', f'{np.round(np.linalg.eigvalsh(P), 4)}'),
    ('3  계수 y_tilde / y', f'{b_fwl:.4f} / {b_raw:.4f}'),
    ('3  잔차제곱합 y_tilde / y', f'{r_tilde @ r_tilde:.4f} / {r_raw @ r_raw:.4f}'),
]
print('항목                        값')
print('-' * 52)
for k, v in rows:
    print(f'{k:<28}{v}')
항목 값
----------------------------------------------------
1 통제 전 b1 1.5000
1 통제 후 beta1 1.3784
1 차이 / Gamma*beta2 0.1216 / 0.1216
2 max|P^10 - P| 8.33e-15
2 tr P 3.0000
2 고유값 [-0. 0. 0. 1. 1. 1.]
3 계수 y_tilde / y 1.3784 / 1.3784
3 잔차제곱합 y_tilde / y 0.2703 / 72.9703
# 그림 2의 합성 자료(seed 7)를 쌓는다
rng = np.random.default_rng(7)
m = 60
z2 = rng.normal(0, 1, m)
z1 = 0.8 * z2 + rng.normal(0, 0.6, m)
yy = 1 + z1 + 2 * z2 + rng.normal(0, 0.5, m)
o = np.ones(m)

Zs = np.column_stack([o, z1])
bs = np.linalg.solve(Zs.T @ Zs, Zs.T @ yy)          # 통제 전
Z2 = np.column_stack([o, z2])
N2 = np.eye(m) - Z2 @ np.linalg.solve(Z2.T @ Z2, Z2.T)
zt, ytil = N2 @ z1, N2 @ yy
b_av = (zt @ ytil) / (zt @ zt)                      # 통제 후

Zf = np.column_stack([o, z1, z2])
bf = np.linalg.solve(Zf.T @ Zf, Zf.T @ yy)
print(f'통제 전 기울기 {bs[1]:.4f},  통제 후 기울기 {b_av:.4f},  전체 회귀 beta1 {bf[1]:.4f}')
통제 전 기울기 2.6223, 통제 후 기울기 1.0968, 전체 회귀 beta1 1.0968
# 통제 전·후 산점도를 나란히 그린다
fig, (a1, a2) = plt.subplots(1, 2, figsize=(9.2, 3.8))

a1.scatter(z1, yy, s=14, color='0.25')
g1 = np.linspace(z1.min(), z1.max(), 2)
a1.plot(g1, bs[0] + bs[1] * g1, color='tab:blue')
a1.set_xlabel('$x_1$ (원자료)')
a1.set_ylabel('$y$')
a1.set_title(f'통제 전 — 기울기 {bs[1]:.2f}', fontsize=11)

a2.scatter(zt, ytil, s=14, color='0.25')
g2 = np.linspace(zt.min(), zt.max(), 2)
a2.plot(g2, b_av * g2, color='tab:red')
a2.axhline(0, lw=0.6, color='0.6')
a2.axvline(0, lw=0.6, color='0.6')
a2.set_xlabel(r'$\tilde x_1 = M_2 x_1$')
a2.set_ylabel(r'$\tilde y = M_2 y$')
a2.set_title(f'통제 후 — 기울기 {b_av:.2f}', fontsize=11)

fig.tight_layout()
plt.show()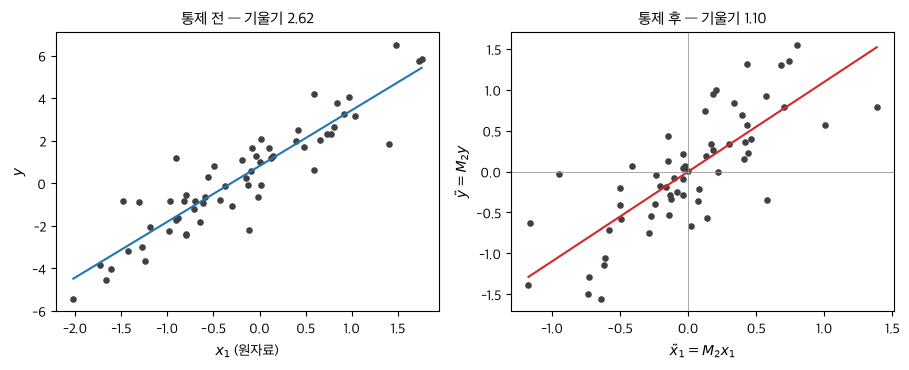
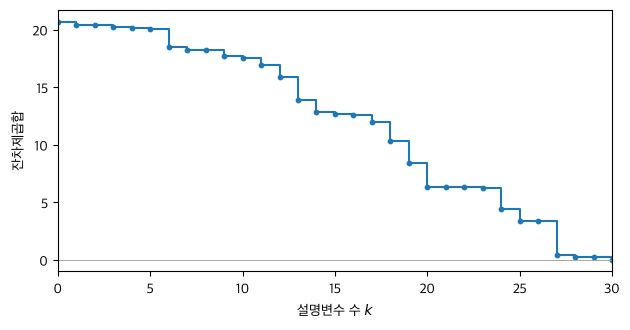
# 열을 하나씩 더하며 잔차제곱합을 쌓는다 (k -> n 극단)
rng = np.random.default_rng(1)
q = 30
yk = rng.normal(0, 1, q)
Zc = rng.normal(0, 1, (q, q))
rss = [float(yk @ yk)]
for k in range(1, q + 1):
    Xk = Zc[:, :k]
    Pk = Xk @ np.linalg.solve(Xk.T @ Xk, Xk.T)
    rss.append(float(yk @ (yk - Pk @ yk)))
rss = np.array(rss)
print(f'RSS(0) {rss[0]:.3f},  RSS(15) {rss[15]:.3f},  RSS(29) {rss[29]:.4f},  RSS(30) {rss[30]:.2e}')

fig, ax = plt.subplots(figsize=(6.4, 3.4))
ax.step(np.arange(q + 1), rss, where='post', color='tab:blue')
ax.scatter(np.arange(q + 1), rss, s=10, color='tab:blue')
ax.axhline(0, lw=0.6, color='0.6')
ax.set_xlabel('설명변수 수 $k$')
ax.set_ylabel('잔차제곱합')
ax.set_xlim(0, q)
ax.set_ylim(-1, rss[0] * 1.05)
fig.tight_layout()
plt.show()
RSS(0) 20.675, RSS(15) 12.636, RSS(29) 0.2103, RSS(30) 8.32e-14
3. 대조
예측과 계산이 어긋난 지점을 적는다. 어느 쪽이 틀렸는지 판정한다.
| 예측 | 결과 | 어긋남 | 원인 |
|---|---|---|---|
| 1 | |||
| 2 | |||
| 3 |
본문 확인: 어긋났으면 1은 (eq-w07-19), 2는 (eq-w07-11), 3은 (eq-w07-17)로 돌아간다.